optimizer distributed-training communication-efficiency gradient-compression sparsification momentum
DeMo: Decoupled Momentum Optimization
通过解耦动量更新和结构化稀疏化,将分布式训练通信量降低高达85倍
DeMo: Decoupled Momentum Optimization
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DeMo: Decoupled Momentum Optimization |
| 作者 | Bowen Peng, Lizhang Chen, Baiyu Su, Jeffrey Quesnelle, Diederik P. Kingma, Qiang Liu |
| 机构 | Krea AI, University of Texas at Austin |
| 论文 | arXiv:2411.19870 |
| 代码 | github.com/bloc97/DeMo |
| 发布 | 2024-11-29 (v1), 2026-02-06 (v2) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
大规模语言模型训练依赖同步数据并行(DDP),但全精度梯度 All-Reduce 造成严重通信瓶颈。对于前沿模型,每步通信量可达 TB 级别,要求昂贵的高带宽互连(NVLink、InfiniBand)和地理共置集群,极大增加了成本并限制了可扩展性。
解决方案概述
DeMo 提出了一种即插即用的优化器替代方案,可与任何基于动量的优化器(SGD、Muon 等)结合使用,通过三项关键修改将通信量降低 1-2 个数量级:
- 解耦本地动量更新:不再同步梯度,而是让每个 worker 独立维护动量缓冲区,同步压缩后的动量
- 结构化张量压缩:对动量张量进行分块 → 正交变换(DCT)→ top-k 稀疏化
- 动量减法作为误差反馈:重用动量缓冲区作为未通信信息的累加器,无需额外内存
核心洞察:梯度同步和动量同步在理论上是等价的(线性性),但动量经过压缩后通信量可大幅降低。
三、技术架构
整体流程图
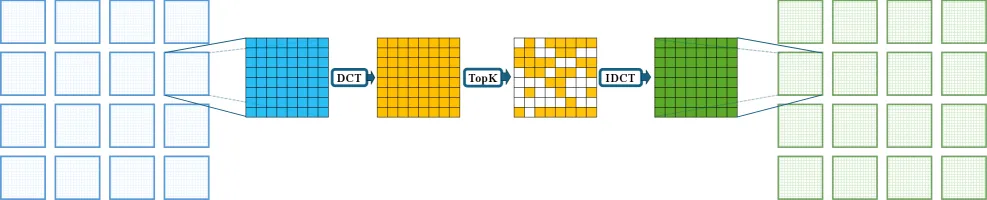
DeMo 的压缩流水线包含三个阶段:
- 张量分块(Tensor Chunking):将动量张量 M 分割为大小为 s×s 的块
- 分块线性投影(Blockwise Linear Projection):对每个块应用 DCT 变换
- Top-k 稀疏化:在频域中选择最大的 k 个系数
核心公式
标准随机优化问题:
解耦本地动量更新(核心创新):
其中 β 是动量系数,每个 worker 独立维护自己的动量缓冲区。
张量分块:
给定动量张量 M ∈ ℝ^{n₀×…×n_{d-1}},将每个维度因式分解为 n_i = c_i · s_i,分割为块:
分块线性投影:
对于 2D 张量简化为:
Top-k 稀疏化:
只保留 k 个最大幅值的系数,其余置零。
动量重建与参数更新:
其中 ϕ(·) 是基础优化器的变换(SGD: ϕ(M)=M, Signum: ϕ(M)=sign(M), Muon: ϕ(M)=M(M^TM+εI)^{-1/2})
动量减法(误差反馈):
α ∈ (0,1] 是动量减法系数,控制已通信信息的衰减。
算法伪代码
| 步骤 | 操作 |
|---|---|
| 1 | 初始化参数 X₀ 和全局动量 M₀ ← 0 |
| 2 | for t = 1, 2, … |
| 3 | 各 worker 独立计算梯度 G_t^i |
| 4 | 本地更新动量:M_t^i = β·M_{t-1}^i + (1-β)·G_t^i |
| 5 | 分块 + DCT 变换 + Top-k 稀疏化 |
| 6 | All-Gather 稀疏化后的动量 |
| 7 | 逆变换重建动量 M_t^* |
| 8 | 参数更新:X_{t+1} = X_t - η_t(ϕ(M_t^*) + λ·X_t) |
| 9 | 动量减法:M_t^i ← M_t^i - α·重建动量 |
复杂度分析
| 操作 | 计算复杂度 | 内存开销 |
|---|---|---|
| 无分块投影 | O(N³) | O(N²) |
| 分块投影(C²块) | O(N³/C) | O(N²/C²) |
| DCT 变换 | O(N log N) | O(N) |
| Top-k 选择 | O(N log k) | O(k) |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 解耦动量同步 | 将梯度 All-Reduce 替换为动量压缩同步 | 线性性保证等价性,压缩后通信量大幅降低 |
| 结构化张量压缩 | DCT + Top-k 组合,利用梯度频域稀疏性 | 实验验证 DCT 优于随机正交投影(Figure 3) |
| 动量减法误差反馈 | 重用动量缓冲区作为误差累加器,无需额外内存 | 消融实验验证 α=0.2 最优(Figure 4) |
| 拓扑无关性 | 不依赖特定网络拓扑,可跨数据中心训练 | 支持以太网等低带宽互连 |
五、代码实现分析
- 代码仓库:github.com/bloc97/DeMo
- 实现框架:基于 PyTorch,集成到 OLMo 训练框架
- 代码量:约 200 行核心实现(DeMo 优化器类)
- 集成方式:
- 实现
DeMo优化器类 - 禁用 PyTorch DDP 的默认梯度同步
- 无需修改模型代码
- 实现
六、实验结果
实验设置
| 配置 | 值 |
|---|---|
| 模型 | OLMo-300M (320M 参数), OLMo-1B (1.18B 参数) |
| 数据集 | Dolma v1.5 |
| 训练量 | 100B tokens |
| GPU | 64 × NVIDIA H100 |
| 全局 batch size | 2048 |
| 序列长度 | 2048 |
| 默认分块大小 | s=64 (64×64 块) |
| 默认动量系数 | β=0.999 |
| 默认减法系数 | α=0.2 |
下游任务评估
| 优化器 / k | HellaSwag ↑ | ARC-Easy ↑ | PIQA ↑ | 通信量 (MB/step) |
|---|---|---|---|---|
| OLMo-300M | ||||
| DeMo k=32 | 0.37 | 0.46 | 0.67 | 29.9 |
| DeMo k=16 | 0.38 | 0.50 | 0.67 | 14.9 |
| DeMo k=8 | 0.38 | 0.47 | 0.67 | 7.49 |
| DeMo k=4 | 0.37 | 0.47 | 0.67 | 3.74 |
| DeMo k=2 | 0.36 | 0.46 | 0.65 | 1.87 |
| DeMo k=1 | 0.35 | 0.45 | 0.65 | 0.93 |
| AdamW-DDP | 0.35 | 0.46 | 0.65 | 636.9 |
| OLMo-1B | ||||
| DeMo k=32 | 0.48 | 0.55 | 0.70 | 110.32 |
| DeMo k=16 | 0.47 | 0.53 | 0.70 | 55.16 |
| DeMo k=8 | 0.47 | 0.52 | 0.69 | 27.58 |
| DeMo k=4 | 0.45 | 0.52 | 0.70 | 13.79 |
| DeMo k=2 | 0.44 | 0.51 | 0.69 | 6.89 |
| DeMo k=1 | 0.41 | 0.52 | 0.69 | 3.44 |
| AdamW-DDP | 0.43 | 0.51 | 0.68 | 2416.6 |
关键发现:
- 300M 模型:DeMo k=8 将通信量降低 85 倍(7.5 MB vs 637 MB),精度无损
- 1B 模型:DeMo k=16 降低 44 倍(55 MB vs 2417 MB),HellaSwag 和 PIQA 还优于 AdamW
训练损失对比
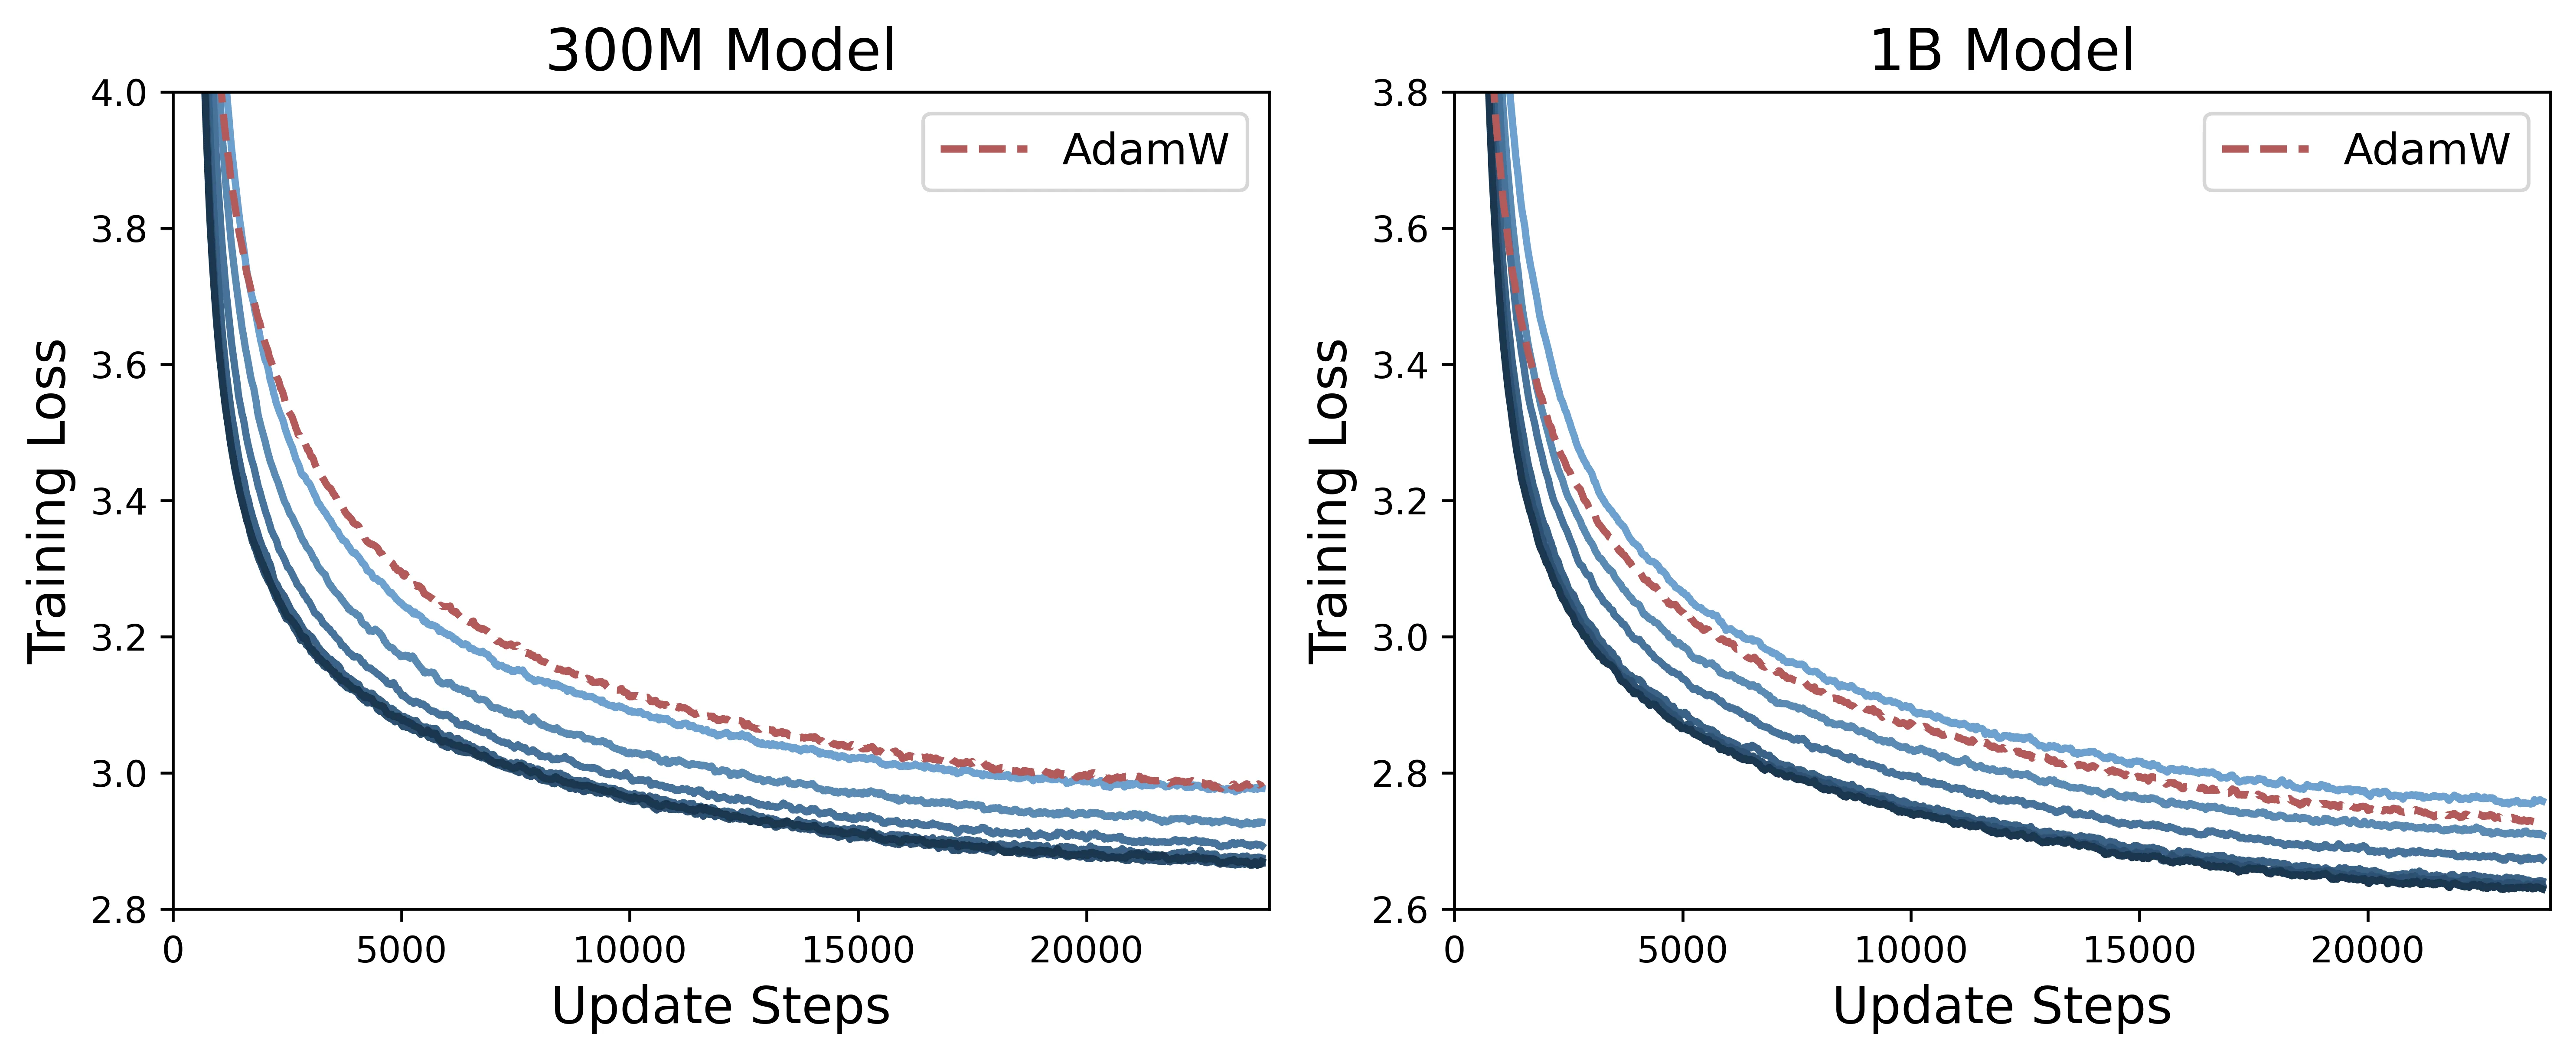
- k=2 即可超越 AdamW 基线
- k 越大收益递减,但通信成本增加
- 300M 和 1B 模型趋势一致
消融实验
线性变换选择:
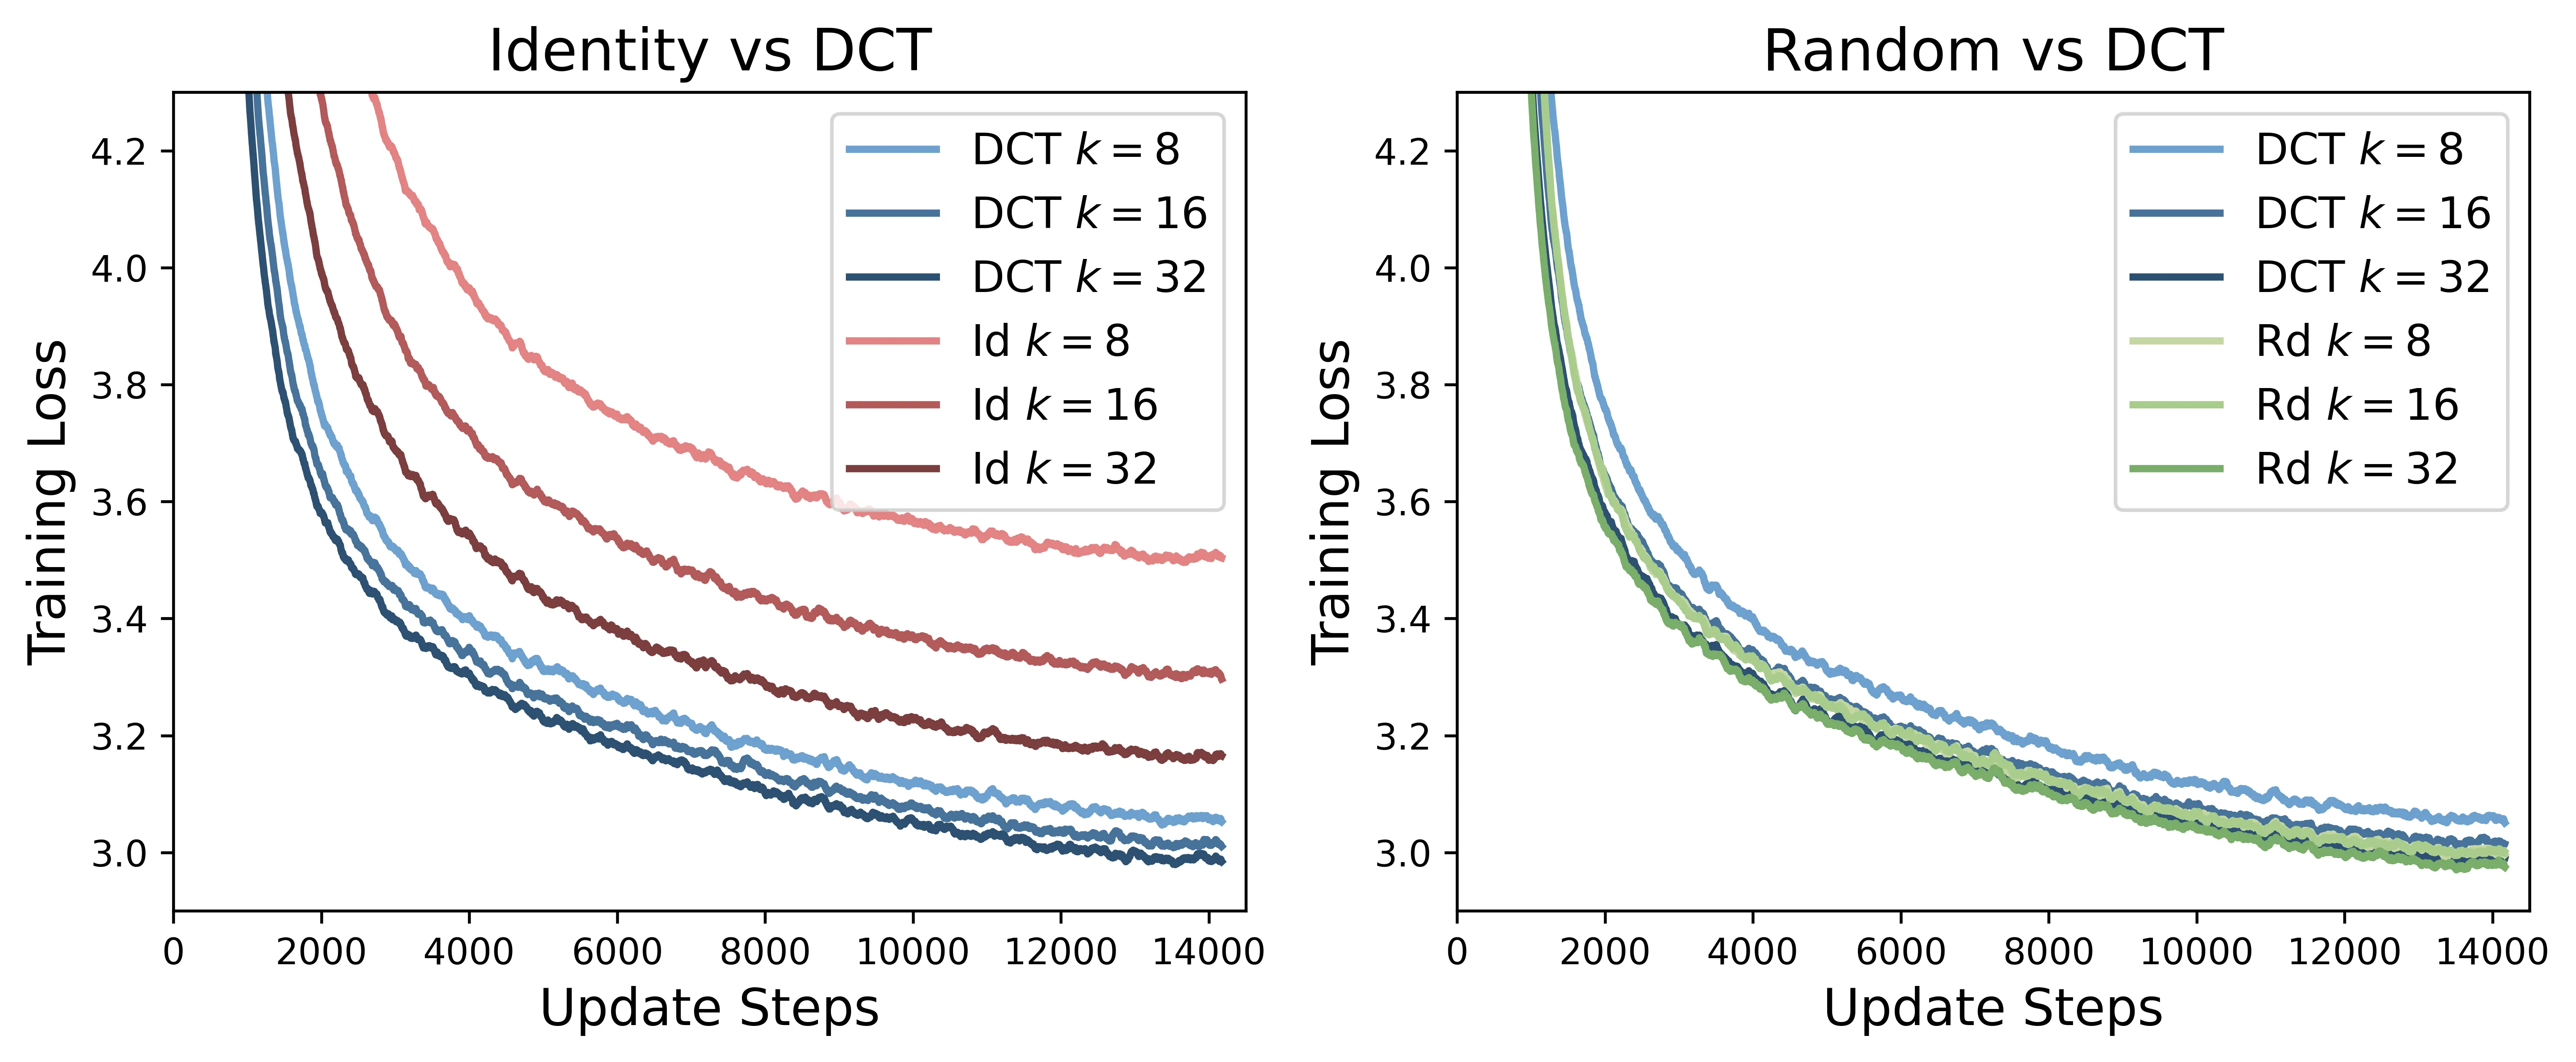
| 变换方法 | 效果 |
|---|---|
| 恒等映射(无变换) | 性能最差 |
| DCT | 性能最优 |
| 随机正交投影 | 介于两者之间 |
动量减法系数 α 的影响:
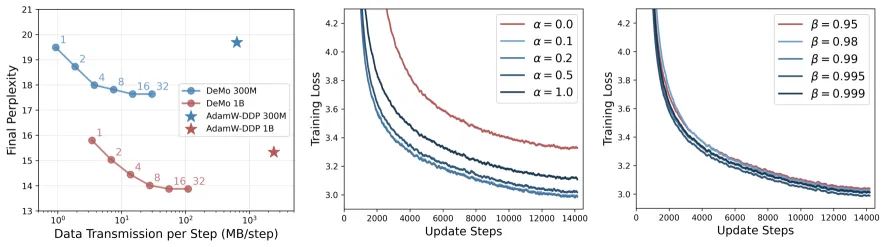
| α 值 | 效果 |
|---|---|
| 0.0(无减法) | 性能退化严重,相同元素被重复选择 |
| 0.2 | 最优性能,渐进演化 top-k 元素 |
| 1.0(完全减法) | 性能次优 |
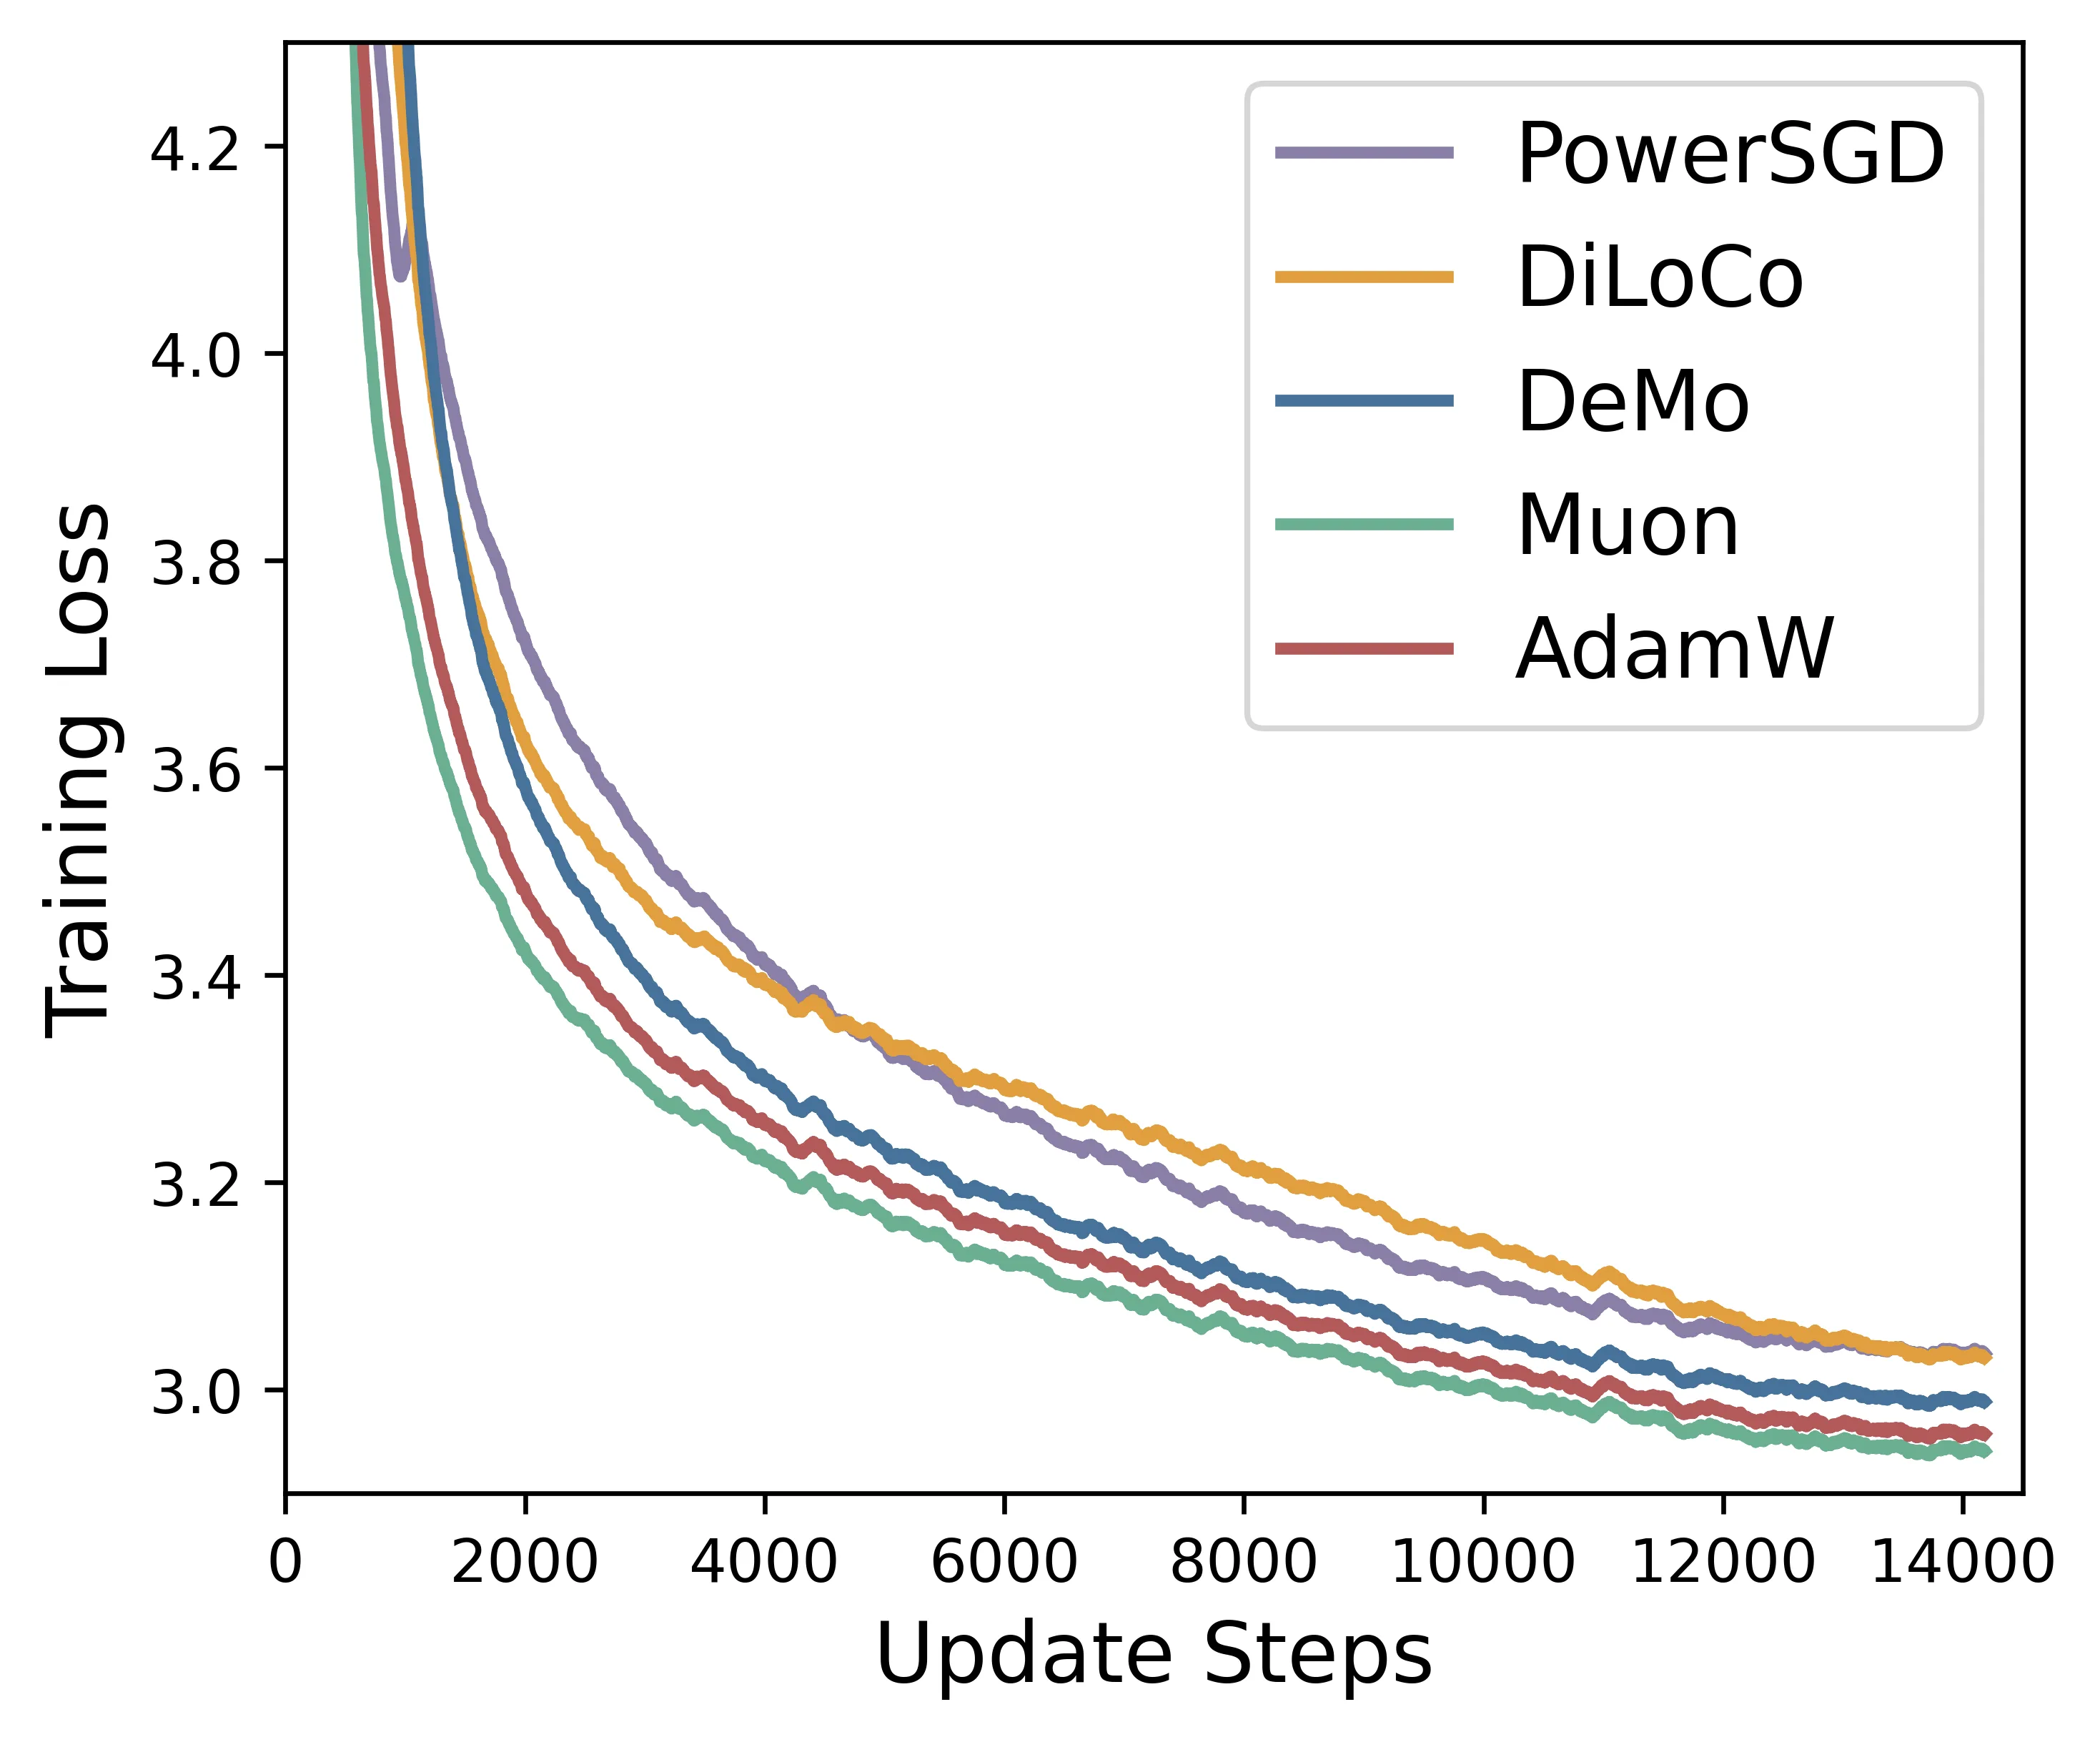
与其他优化器对比:
| 优化器 | 特点 | DeMo 优势 |
|---|---|---|
| AdamW | 标准 DDP,通信量最大 | DeMo 降低 85x |
| Muon | 动量优化器 | DeMo 可与其结合 |
| DiLoCo | 分层优化 | DeMo 更简单,无需多机协调 |
| PowerSGD | 低秩近似 | DeMo 使用稀疏化,更灵活 |
压缩比与 Perplexity 关系:
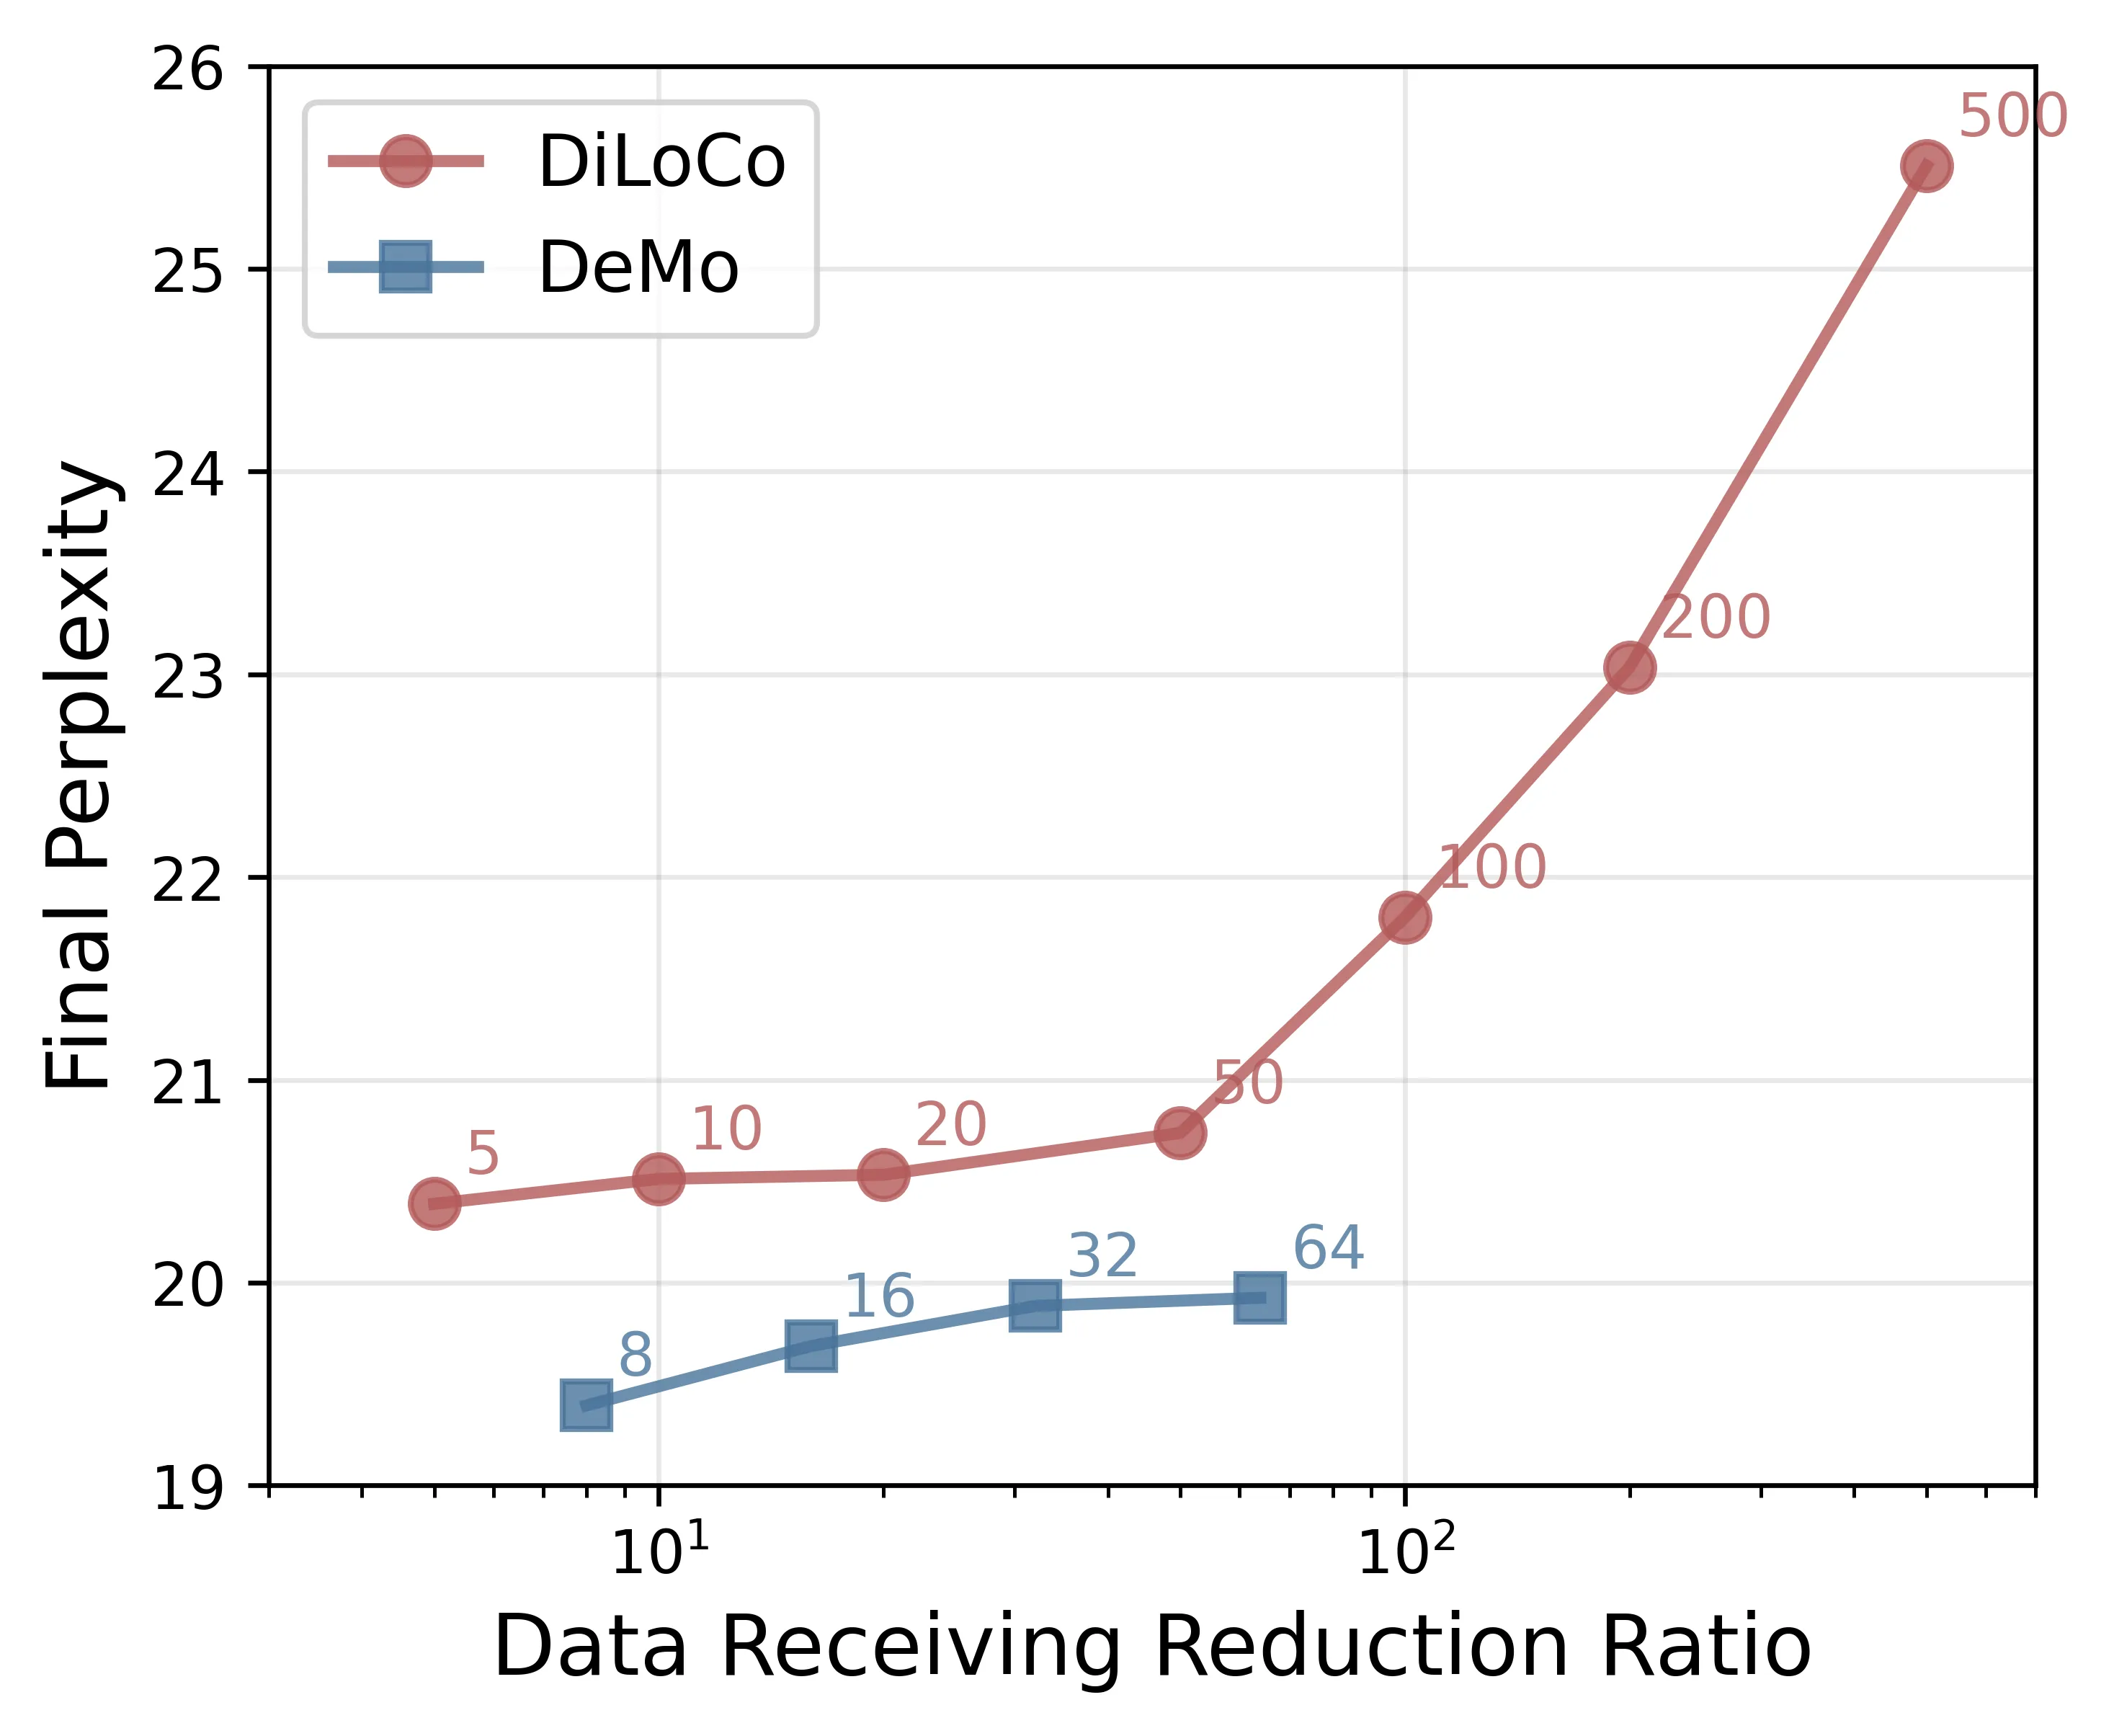
- DeMo 在相同压缩比下始终优于 DiLoCo
- 高压缩比下性能差距更明显
七、相关工作
| 方法 | 类型 | 压缩方式 | 与 DeMo 对比 |
|---|---|---|---|
| PowerSGD | 低秩近似 | 随机投影 | DeMo 使用 DCT,更稳定 |
| QSGD | 量化 | 标量量化 | DeMo 结合稀疏化,压缩比更高 |
| Deep Gradient Compression | 稀疏化 | 随机 top-k | DeMo 使用结构化 DCT,更高效 |
| DiLoCo | 分层优化 | 内/外层分离 | DeMo 更简单,无需多机协调 |
| 1-bit Adam | 量化 | 二值化 | DeMo 不需要特殊通信原语 |
八、总结
核心贡献
- 提出 DeMo 优化器:通过解耦动量更新和结构化压缩,将分布式训练通信量降低 1-2 个数量级
- 结构化压缩流水线:分块 + DCT + Top-k 组合,利用梯度频域稀疏性实现高效压缩
- 动量减法误差反馈:创新性地重用动量缓冲区作为误差累加器,零额外内存开销
- 拓扑无关性:不依赖特定网络拓扑,支持跨数据中心和以太网训练
- 即插即用:可与任何基于动量的优化器结合,最小化代码修改
技术影响
- 降低训练成本:使低带宽互连(以太网)也能进行大规模 LLM 训练
- 扩展训练基础设施:支持跨数据中心的分布式训练
- 简化系统设计:无需复杂的通信拓扑优化
- 开源实现:提供完整代码和配置,便于复现和集成
局限性
- 超参数敏感:k、α、β、s 等参数需要针对不同模型调优
- 验证规模有限:仅在 300M 和 1B 参数模型上验证,未扩展到 10B+
- 动态稀疏性:固定 top-k 可能不是最优策略,自适应稀疏化可能更好
- 理论分析基础:收敛性分析基于标准假设,实际大规模训练可能有偏差
九、参考资源
- 论文: arXiv:2411.19870
- 代码: github.com/bloc97/DeMo
- 实验复现: anonymous.4open.science/r/DeMo-D3F1
- 相关工作:
- PowerSGD (Vogels et al., 2019) - 低秩梯度压缩
- DiLoCo (Douillard et al., 2023) - 分层分布式优化
- Muon (Jordan et al., 2024) - 动量优化器
- Deep Gradient Compression (Lin et al., 2018) - 梯度稀疏化
- 1-bit Adam (Tang et al., 2021) - 量化通信