Marconi: Prefix Caching for the Era of Hybrid LLMs
Marconi为混合架构LLM提出高效前缀缓存机制,支持注意力层和非注意力层的统一缓存管理。
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | Marconi: Prefix Caching for the Era of Hybrid LLMs |
| arXiv ID | 2411.19379 |
| 发表会议 | MLSys 2025 (camera-ready) |
| 提交日期 | 2024年11月28日 |
| 最后更新 | 2025年4月10日 |
| 作者 | Rui Pan, Zhuang Wang, Zhen Jia, Can Karakus, Luca Zancato, Tri Dao, Yida Wang, Ravi Netravali |
1.2 摘要
混合模型(Hybrid Models)将 Attention 层的语言建模能力与 Recurrent 层(如状态空间模型 SSM)的效率相结合,在大语言模型(LLM)服务中支持长上下文场景方面获得了广泛关注。然而,这些模型的独特属性给前缀缓存(Prefix Caching)等互补效率优化带来了挑战。最显著的问题是,SSM 层使用原地状态更新(in-place state updates),这使得无法回滚缓存条目以表示序列的部分前缀,只能进行精确匹配的缓存命中。这导致每个序列产生大量(大型)缓存条目,其中大部分重用机会有限。
Marconi 是首个支持混合 LLM 高效前缀缓存的系统。其核心创新在于新颖的准入和淘汰策略,这些策略不仅基于最近性,还基于以下两点更明智地评估潜在缓存条目:
- 跨不同命中场景分类法的重用可能性预测
- 命中带来的计算节省相对于内存占用的比例
在多种工作负载和混合模型上,Marconi 实现了高达 34.4 倍的 token 命中率提升(71.1% 或 617ms 的 TTFT 降低),相比最先进的前缀缓存系统。
1.3 核心贡献
| 贡献 | 描述 |
|---|---|
| 首个混合 LLM 前缀缓存系统 | Marconi 是第一个专门为混合模型设计的前缀缓存系统 |
| 智能准入策略 | 基于前缀重用场景分类法,只缓存高重用可能性的 SSM 状态 |
| FLOP 感知淘汰策略 | 综合考虑最近性和计算节省效率的新型淘汰策略 |
| 基数树管理 | 使用基数树统一管理 KVs 和 SSM 状态 |
二、核心思想
2.1 问题背景
混合模型的兴起
混合模型将 Attention 层和 SSM 层交错组合,通常每 6-10 个 SSM 层配一个 Attention 层。这种设计平衡了:
- Attention 层:强大的召回和上下文学习能力,但计算复杂度为 O(L²)
- SSM 层:高效的推理性能,计算复杂度为 O(L),内存占用固定
前缀缓存的挑战
前缀缓存通过缓存和重用公共前缀的模型状态来跳过冗余计算。然而,在混合模型中面临独特挑战:
SSM 状态的三个关键属性:
| 属性 | 描述 | 影响 |
|---|---|---|
| 固定大小 | SSM 状态大小与序列长度无关 | 短序列的缓存效率低 |
| 原地更新 | 状态递归更新,无法回滚表示前缀 | 只能精确匹配命中 |
| 大体积 | 比单个 token 的 KVs 大 10-100 倍 | 快速耗尽缓存空间 |
核心困境
最大化重用机会需要细粒度的状态检查点(如每 256 个 token),但这会导致:
- 缓存利用率低下:大量低效用的 SSM 状态从未被重用(仅 0.4% 的 SSM 状态被重用,而 KVs 的重用率为 25%)
- 高内存使用:单个 10K token 序列消耗 17.4 GB(7B 模型),是同等 Transformer 的 3.3 倍
2.2 核心洞察
Marconi 的核心洞察是:尽管无法完美预测未来请求的前缀重用模式,但通过分析前缀重用场景的分类法,可以充分估计重用潜力。
前缀重用场景分类:
- 纯输入前缀(Purely Input):来自先前输入序列的前缀部分,如系统提示、指令、少样本示例等。通常跨多个请求共享。
- 输入输出混合前缀(Input and Output):由先前输入和输出 token 组成的前缀,如对话历史、过去的环境交互等。
三、技术架构
3.1 系统架构概览
Marconi 的架构基于以下核心组件:
┌─────────────────────────────────────────────────────────┐
│                    Marconi 系统架构                       │
├─────────────────────────────────────────────────────────┤
│  ┌──────────────┐  ┌──────────────┐  ┌──────────────┐  │
│  │  基数树管理   │  │  准入策略    │  │  淘汰策略    │  │
│  │  (Radix Tree) │  │  (Admission) │  │  (Eviction)  │  │
│  └──────────────┘  └──────────────┘  └──────────────┘  │
│         │                  │                  │         │
│         ▼                  ▼                  ▼         │
│  ┌─────────────────────────────────────────────────┐   │
│  │              统一缓存管理                        │   │
│  │    KVs + SSM 状态的联合存储与检索                │   │
│  └─────────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────────┘
3.2 缓存准入策略
推测性插入(Speculative Insertion)
在预填充每个序列之前,Marconi 执行推测性插入以检查输入 token 的预填充段是否会在基数树中创建中间节点:
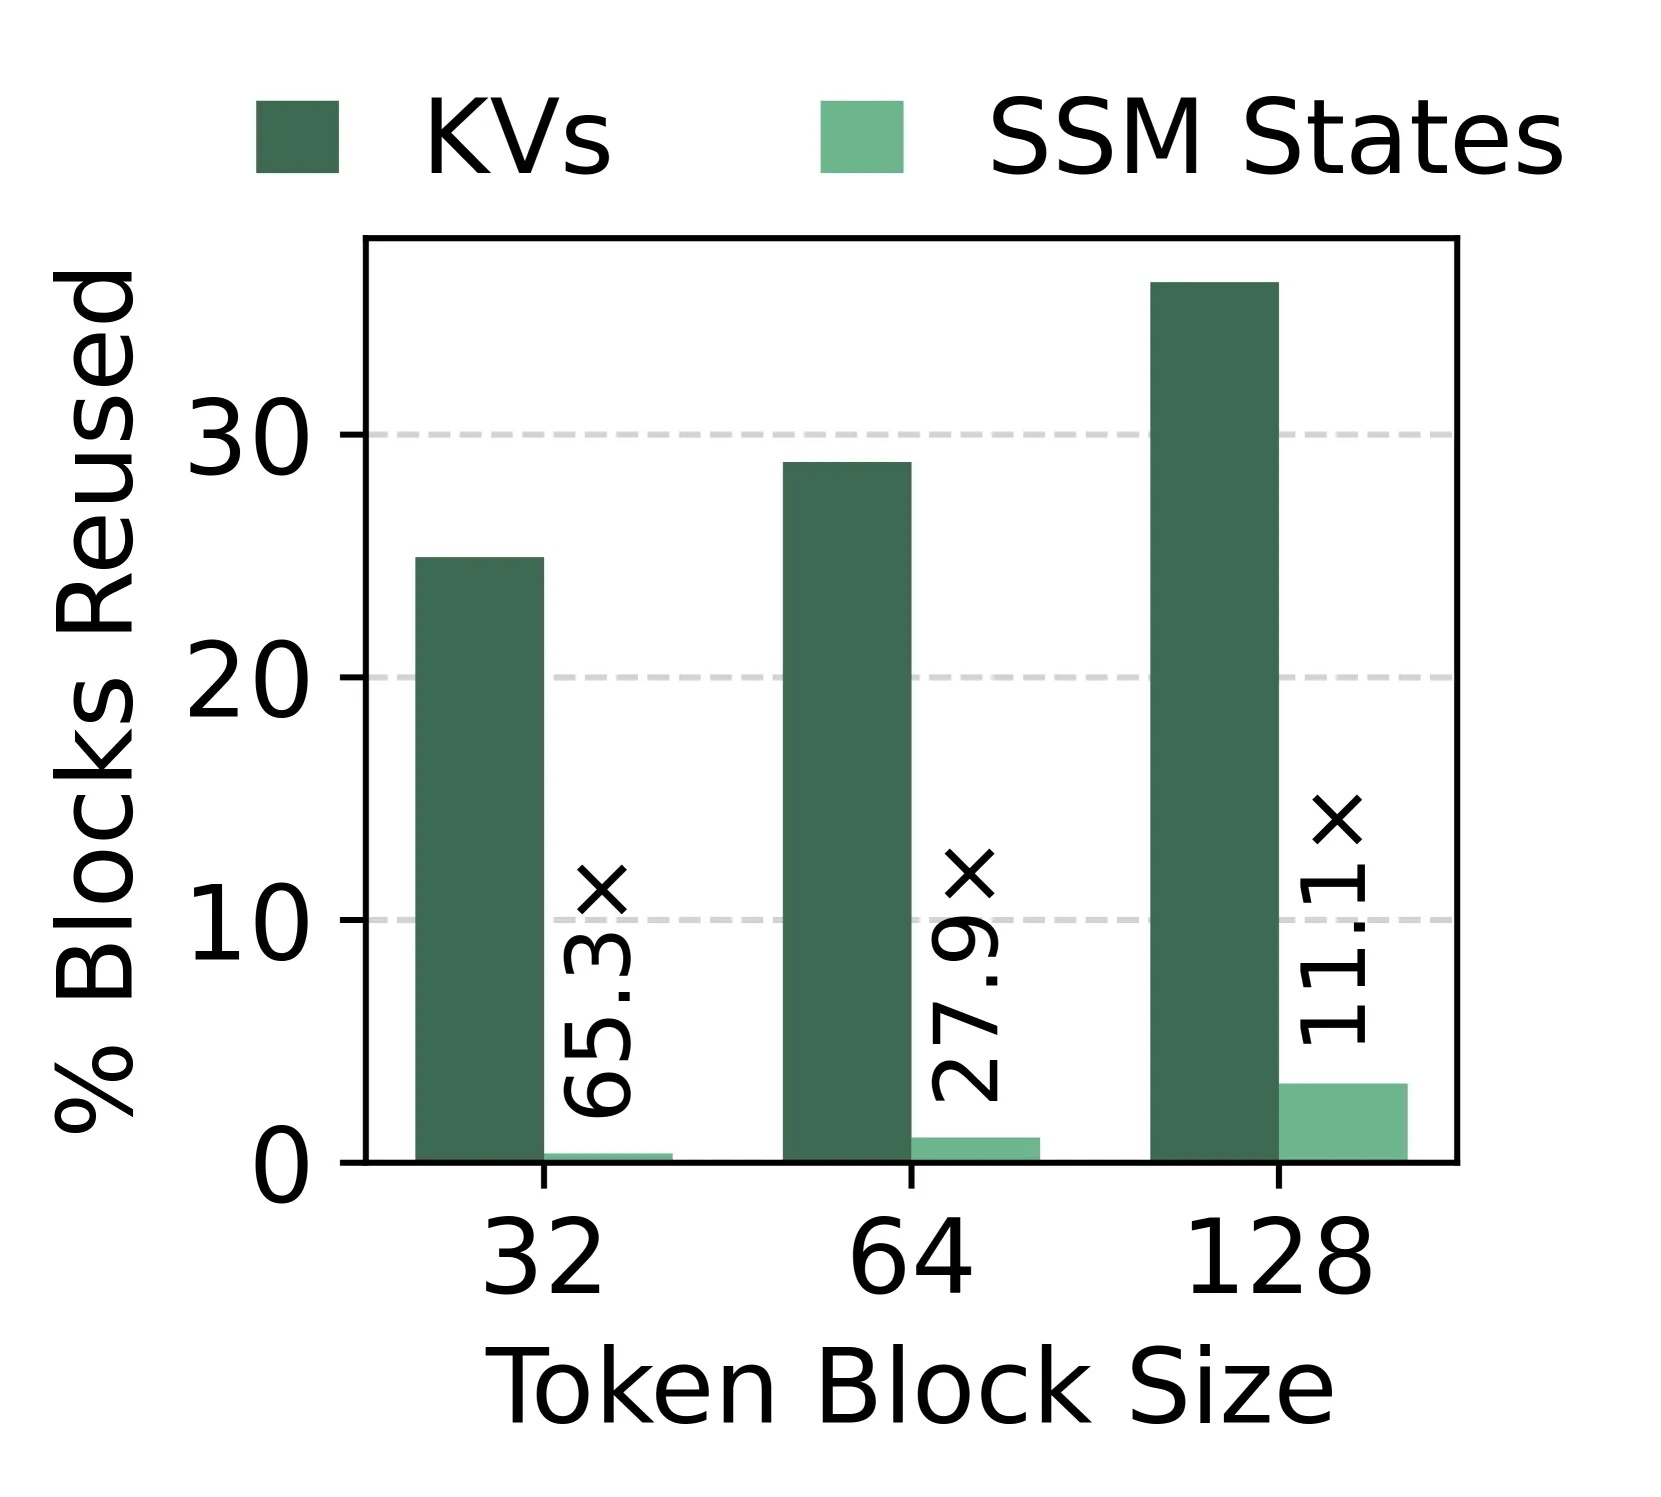 图 4:Marconi 执行推测性插入以检查序列的预填充段是否创建中间节点。如果是,则在分支点检查 SSM 状态。最后解码 token 的状态在任何情况下都会被检查点。
准入决策逻辑
| 场景 | 策略 | 原因 |
|---|---|---|
| 纯输入前缀 | 在第二次出现时识别并缓存 | 通常跨多个请求共享,第三次出现即可受益 |
| 输入输出前缀 | 只缓存最后解码 token 的 SSM 状态 | 对话通常从最后 token 继续,而非中间分支 |
SSM 状态获取方法
方法一:分块状态传递支持的模型
- 输入序列被分成块来计算块内状态
- 缓存前缀中倒数第二个块的状态
- 示例:100 token 序列,块大小 32,缓存 token 64 的状态
方法二:不支持分块状态传递的模型
- 执行两遍预填充获取精确状态
- 第一遍预填充前 80 个 token 生成前缀状态
- 第二遍从前缀状态开始预填充剩余 20 个 token
3.3 基数树管理
Marconi 使用基数树统一管理不同类型的模型状态:
                    根节点
                   /      \
          [前缀 A]          [前缀 B]
         /        \              \
    [子前缀 A1]  [子前缀 A2]    [子前缀 B1]
         |           |              |
    ┌────┴────┐  ┌───┴───┐    ┌────┴────┐
    │KVs+SSM │  │KVs+SSM│    │KVs+SSM │
    │ 状态   │  │ 状态  │    │ 状态   │
    └─────────┘  └───────┘    └─────────┘
关键设计决策:
- 每条边关联其表示的 token 的 KVs,以及表示边中最后一个 token 之前所有 token 的 SSM 状态
- 节点表示序列的分支点
- 有多个子节点的节点表示”纯输入”前缀
- 只有一个子节点的节点可能表示”输入输出”前缀
四、核心创新
4.1 FLOP 感知淘汰策略
FLOP 效率指标
Marconi 提出了一个新的指标——FLOP 效效率(FLOP Efficiency),用于衡量重用前缀缓存条目时每单位内存实现的计算节省:
不同层类型的 FLOP 效率
| 层类型 | 每层 FLOPs | 每层状态大小(字节) | FLOPs/字节 | 7B 模型 FLOPs/字节 |
|---|---|---|---|---|
| Attention | 8LD² + 4L²D | 4LD | L + 2D | L + 8192 |
| MLP | 16LD² | N/A | N/A | N/A |
| SSM | 12LD² + 16LDN + 10L | 2DN | L·(6D/N + 8 + 5/DN) | 200L |
其中:L = 序列长度,D = 模型维度,N = 状态/特征维度
效用评分公式
Marconi 计算每个基数节点 n 的效用评分 S(n):
其中:
recency(n):节点的最近访问时间戳flop_efficiency(n):节点的 FLOP 效率α:平衡参数,控制最近性和 FLOP 效率的权重
α 参数调优机制:
- 启动时设置 α = 0(退化为 LRU)
- 第一次淘汰后,获取基数树快照
- 进入引导期(5× 第一次淘汰前看到的请求数)
- 异步启动网格搜索,在 CPU 核心上并行化
- 选择最大化命中率的 α 值
FLOP 效率随序列长度的变化
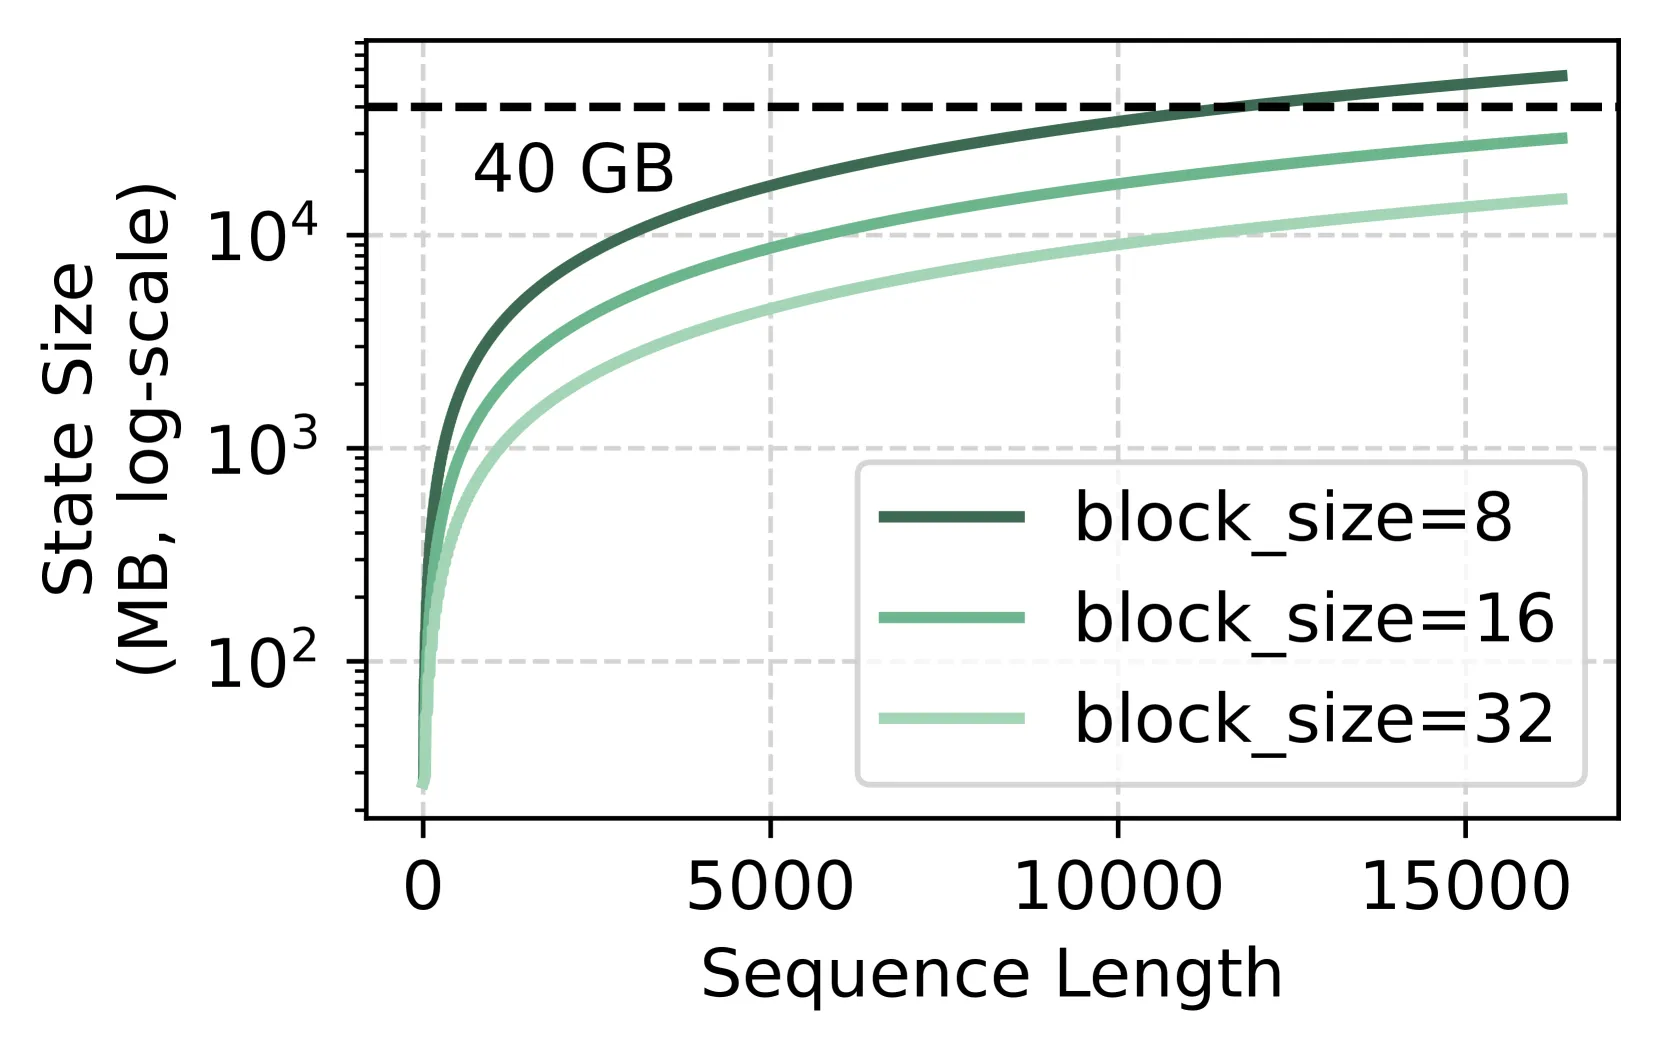 图 5:不同 7B 模型的模型状态 FLOP 效率随序列长度的变化。SSM 层比例越高,FLOP 效率增长越陡峭。
4.2 实现细节
淘汰策略特殊处理
| 场景 | 处理方式 |
|---|---|
| 只有一个子节点的中间节点 | 可被考虑淘汰(释放 SSM 状态,KVs 被子节点吸收) |
| 有多个子节点的节点 | 通常不被淘汰(除非变陈旧) |
| 缓存命中时 | 只更新被访问节点的时间戳(不更新祖先节点) |
与现有系统的对比
| 特性 | vLLM+ | SGLang+ | Marconi |
|---|---|---|---|
| SSM 状态管理 | 细粒度检查点 | 细粒度检查点 | 智能准入 |
| 淘汰策略 | LRU | LRU | FLOP 感知 |
| 基数树使用 | 否 | 是 | 是(增强) |
| 推测性插入 | 否 | 否 | 是 |
五、实验结果
5.1 实验设置
基准系统
| 基准 | 描述 |
|---|---|
| Vanilla inference | 无前缀缓存的基线 |
| vLLM+ | 扩展支持混合模型的 vLLM,块大小 32 |
| SGLang+ | 扩展支持混合模型的 SGLang,使用智能准入但 LRU 淘汰 |
工作负载
| 数据集 | 特点 | 序列长度分布 |
|---|---|---|
| LMSys | 多轮对话,输出较长(可达数千 token) | 中等宽度 |
| ShareGPT | 多轮对话,输出简洁(数十至数百 token) | 较短,主要 <2K token |
| SWE-Bench | 代理工作负载,软件工程任务 | 宽分布,从数百到数万 token |
模型配置
- 主要结果:7B 混合模型,{4, 24, 28} {Attention, SSM, MLP} 层
- TTFT 分析:Jamba-1.5-Mini(12B 活跃/52B 总参数),状态维度 128
- 硬件:AWS p4d.24xlarge,8× A100-40GB GPU
5.2 端到端结果
Token 命中率提升
| 工作负载 | vs vLLM+ | vs SGLang+ |
|---|---|---|
| LMSys | 4.5× | 1.4-1.6× |
| ShareGPT | 7.3× | - |
| SWE-Bench | 34.4× | 最高 219.7% (P95) |
TTFT 延迟降低
| 工作负载 | vs Vanilla (P95 TTFT) | vs vLLM+ (P95 TTFT) | vs SGLang+ (P95 TTFT) |
|---|---|---|---|
| LMSys | 36.9% (281.4 ms) | 36.1% (275.4 ms) | 17.2% (131.1 ms) |
| ShareGPT | 73.2% (106.3 ms) | 71.1% (103.3 ms) | 12.8% (18.5 ms) |
| SWE-Bench | 46.8% (617.0 ms) | 46.8% (617.0 ms) | 24.7% (325.7 ms) |
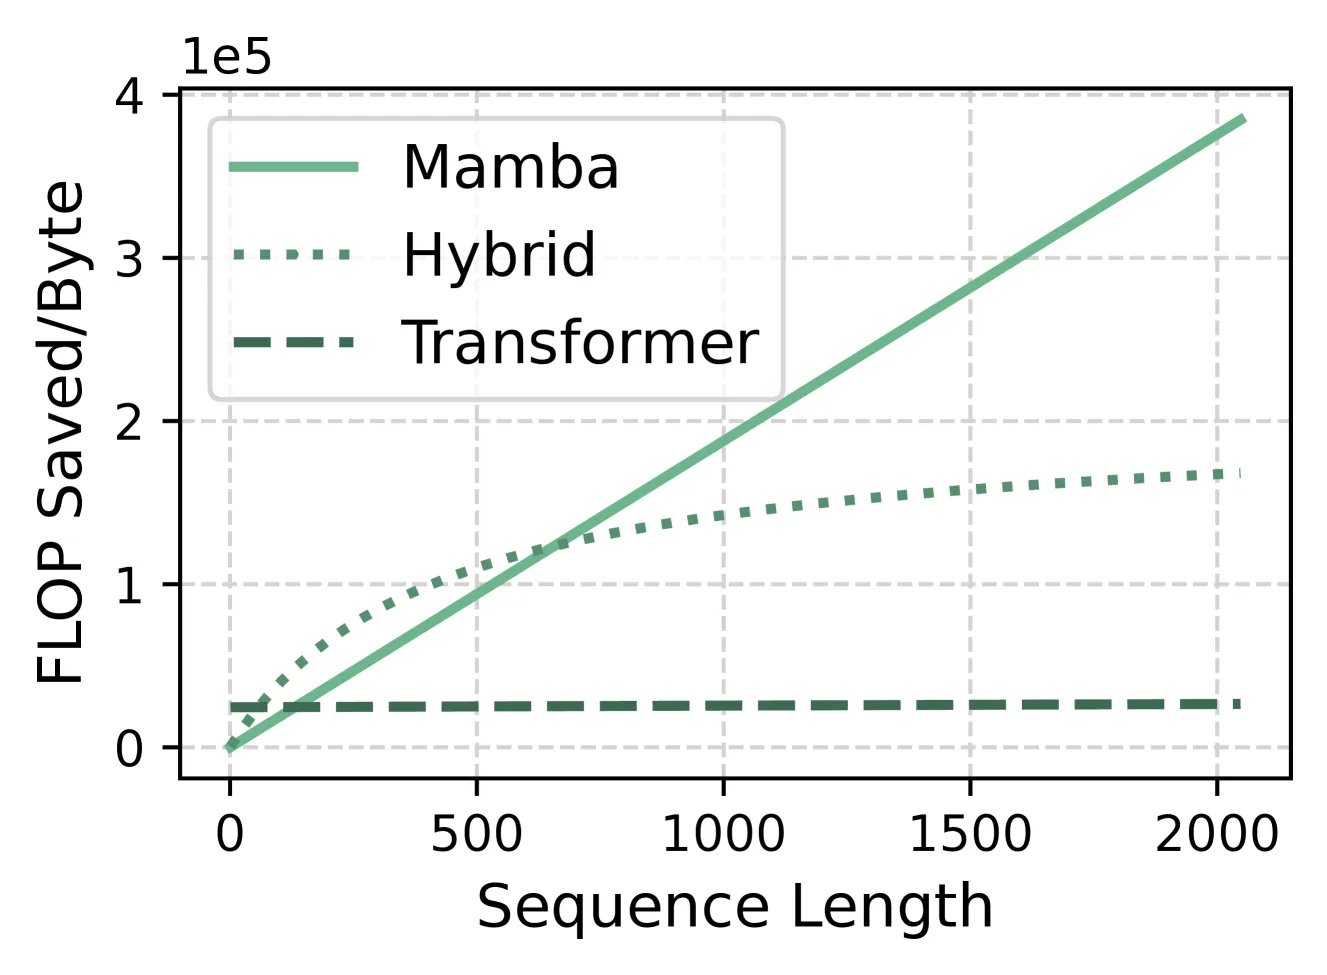 图 7:与 vLLM+ 的对比。Marconi 的智能缓存准入利用有限的缓存空间保留更高效用的状态,显著提升 token 命中率。
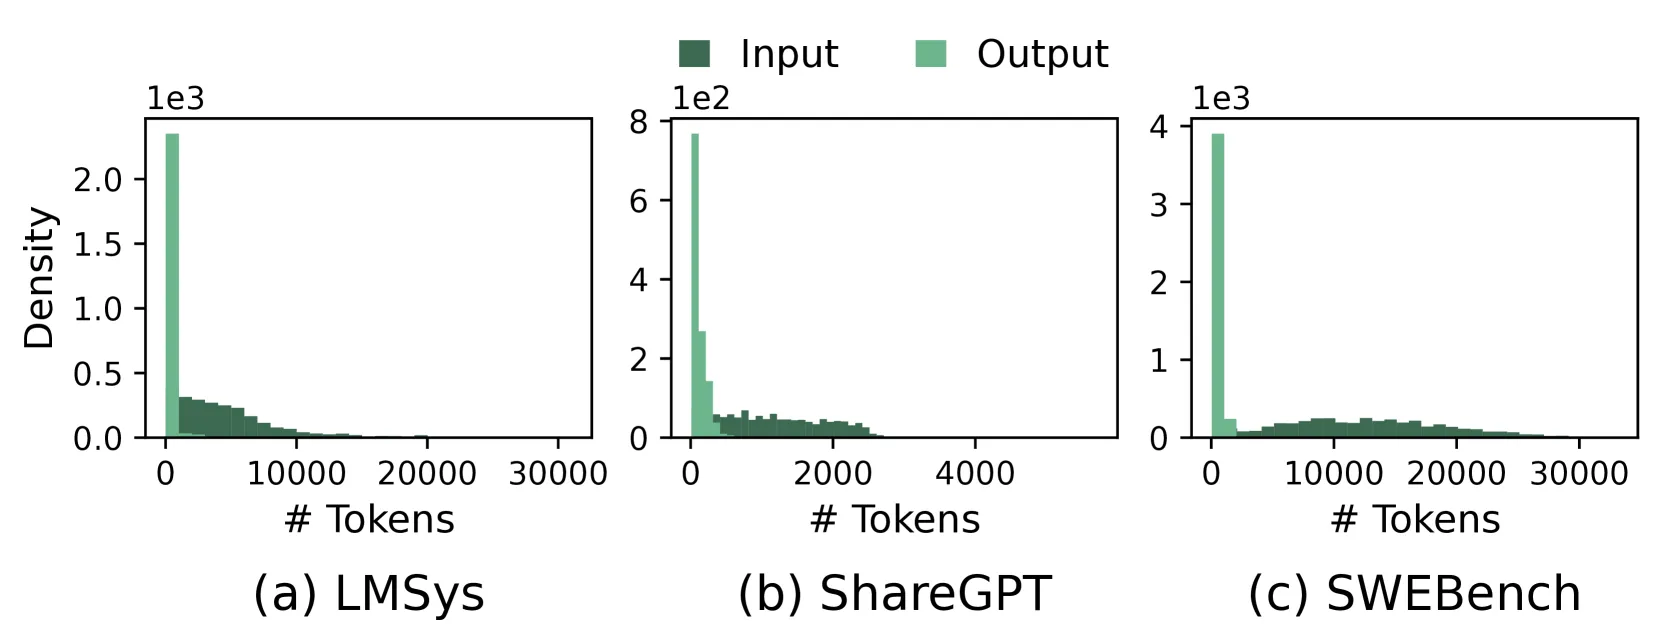 图 8:与 SGLang+ 的对比。Marconi 平衡最近性和 FLOP 效率,显著提升 token 命中率,尤其在长上下文工作负载中。
5.3 FLOP 感知淘汰的细粒度分析
按序列长度的命中率差异
- 短序列 (<7K token):Marconi 命中率略低(最多 -3.0%)
- 长序列 (>7K token):Marconi 命中率显著提高(最多 +25.5%)
- 整体 FLOP 节省:相比 SGLang+ 提升 90.3%
TTFT 分布影响
- P5 TTFT:Marconi 略差 6.3%(绝对值仅 2.1ms)
- P50 TTFT:Marconi 降低 13.4%(74.2 ms)
- P95 TTFT:Marconi 降低 22.0%(274.9 ms)
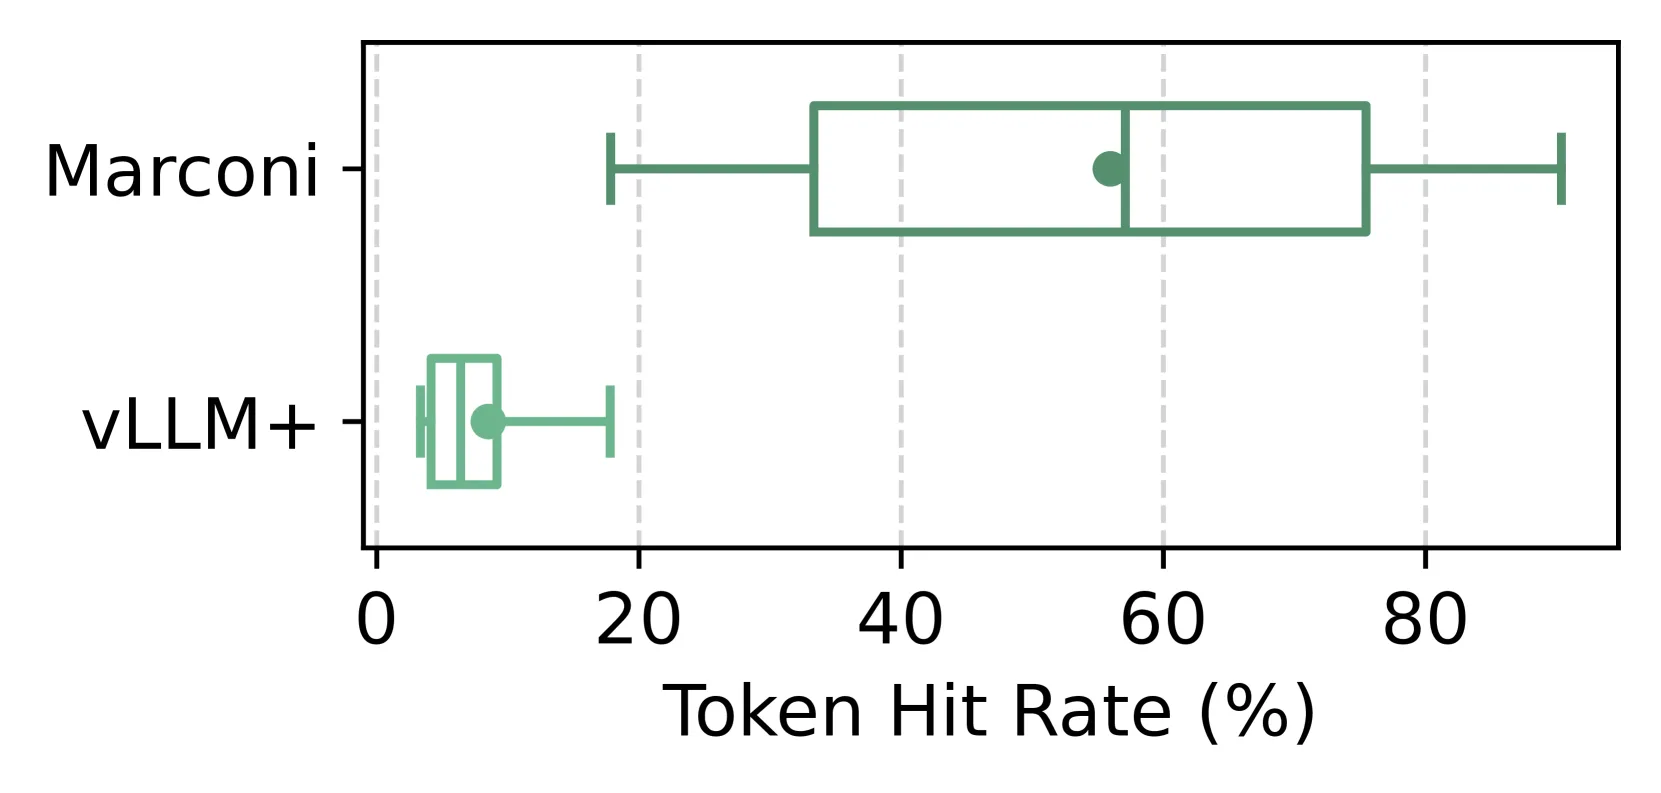 图 10:FLOP 感知淘汰的细粒度分析。Marconi 为长序列实现更高命中率,同时牺牲部分短序列的命中率。
5.4 微基准测试与消融研究
缓存竞争影响
| 缓存大小 | 竞争程度 | vs SGLang+ 改进 |
|---|---|---|
| 60 GB | 高 | 24.3% |
| 80 GB | 中高 | 51.5% |
| 100 GB | 中等 | 68.3% |
| 120 GB | 中低 | 30.0% |
| 140 GB | 低 | 10.0% |
关键发现:中等竞争时改进最显著,此时淘汰决策最为关键。
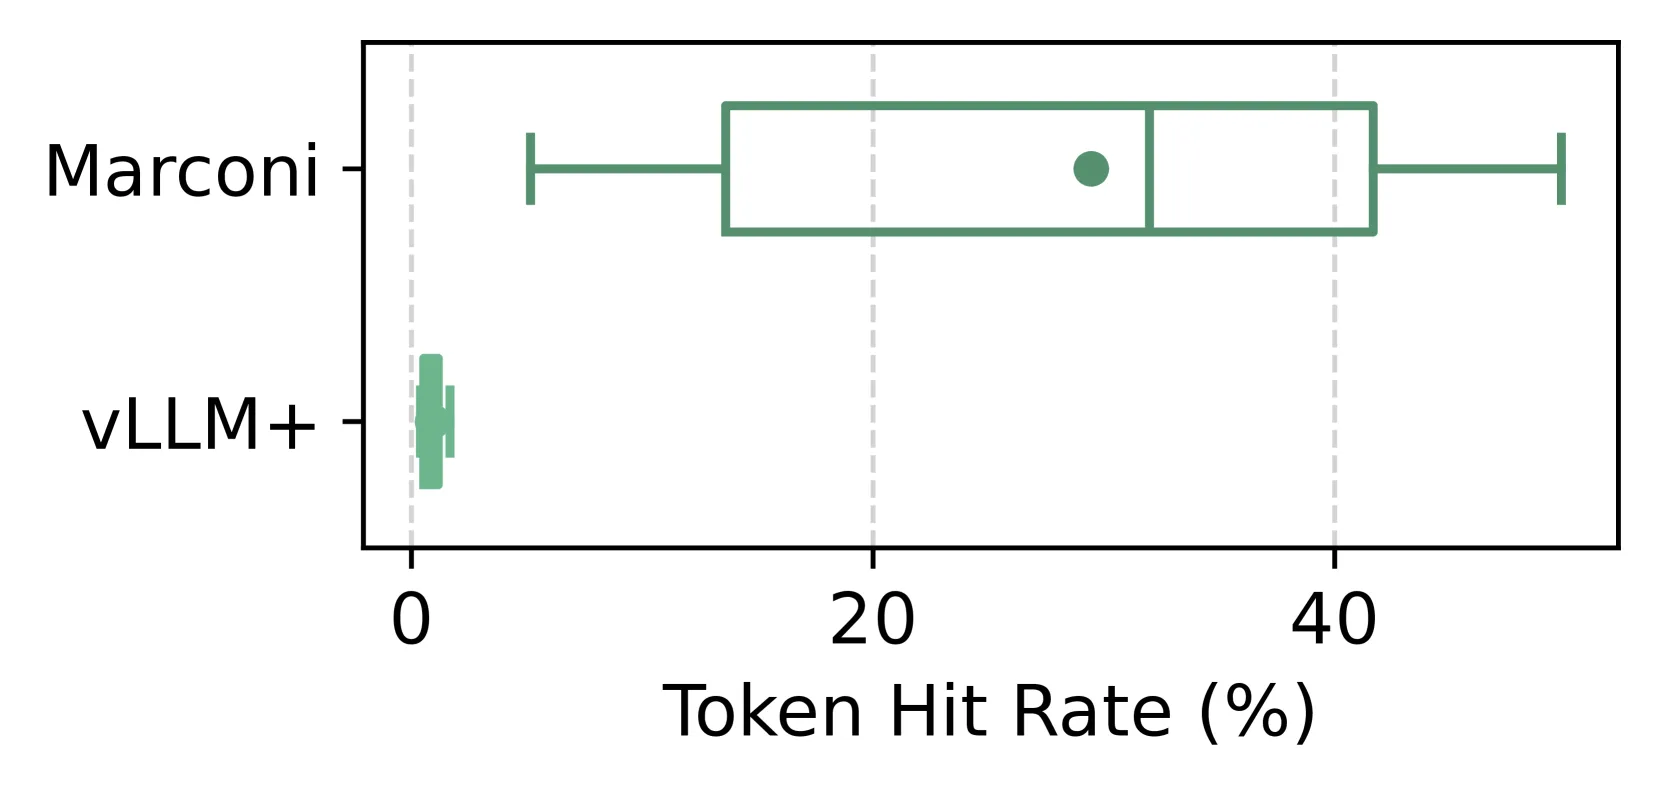 图 11:缓存竞争对 FLOP 感知淘汰收益的影响。
模型架构影响
层组成变化:
| Attention:SSM 比例 | vs vLLM+ | vs SGLang+ |
|---|---|---|
| 1:2 | 13.5% | 5.8% |
| 1:4 | 66.6% | 26.0% |
| 1:8 | 2.6× | 59.7% |
| 纯 Transformer | 相同 | 相同 |
SSM 状态维度变化:
| 状态维度 | 模型类型 | vs vLLM+ |
|---|---|---|
| 16 | Mamba1 | 5.7× |
| 128 | Mamba2 | 35.4× |
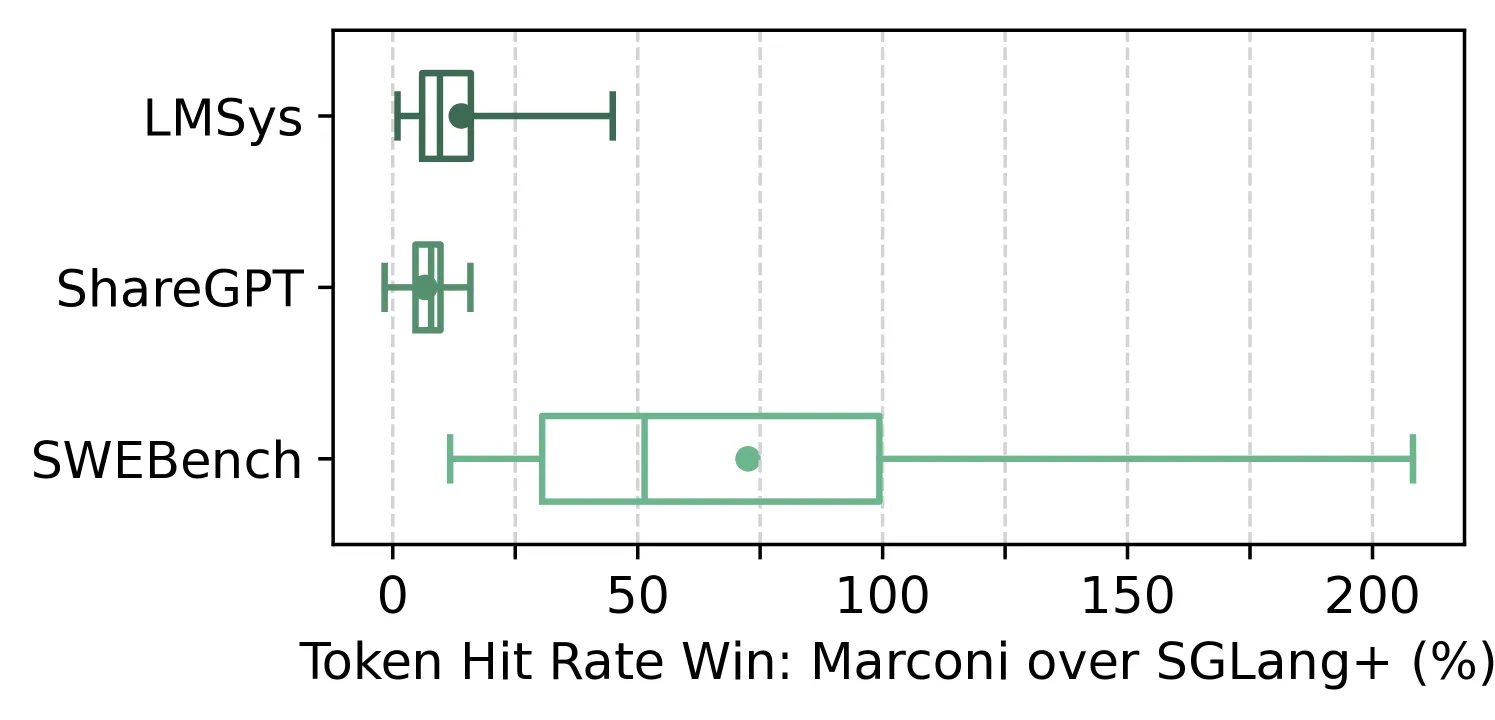 图 12:模型架构对 Marconi 性能的影响。SSM 层比例越高、状态维度越大,Marconi 改进越显著。
请求到达模式影响
| 参数 | 变化 | 命中率 | 相对改进 |
|---|---|---|---|
| 会话到达率 | 0.5 → 2/秒 | 48.7% → 43.0% | 1.4× → 1.6× |
| 请求间隔 | 5s → 10s | 25.9% → 24.1% | - |
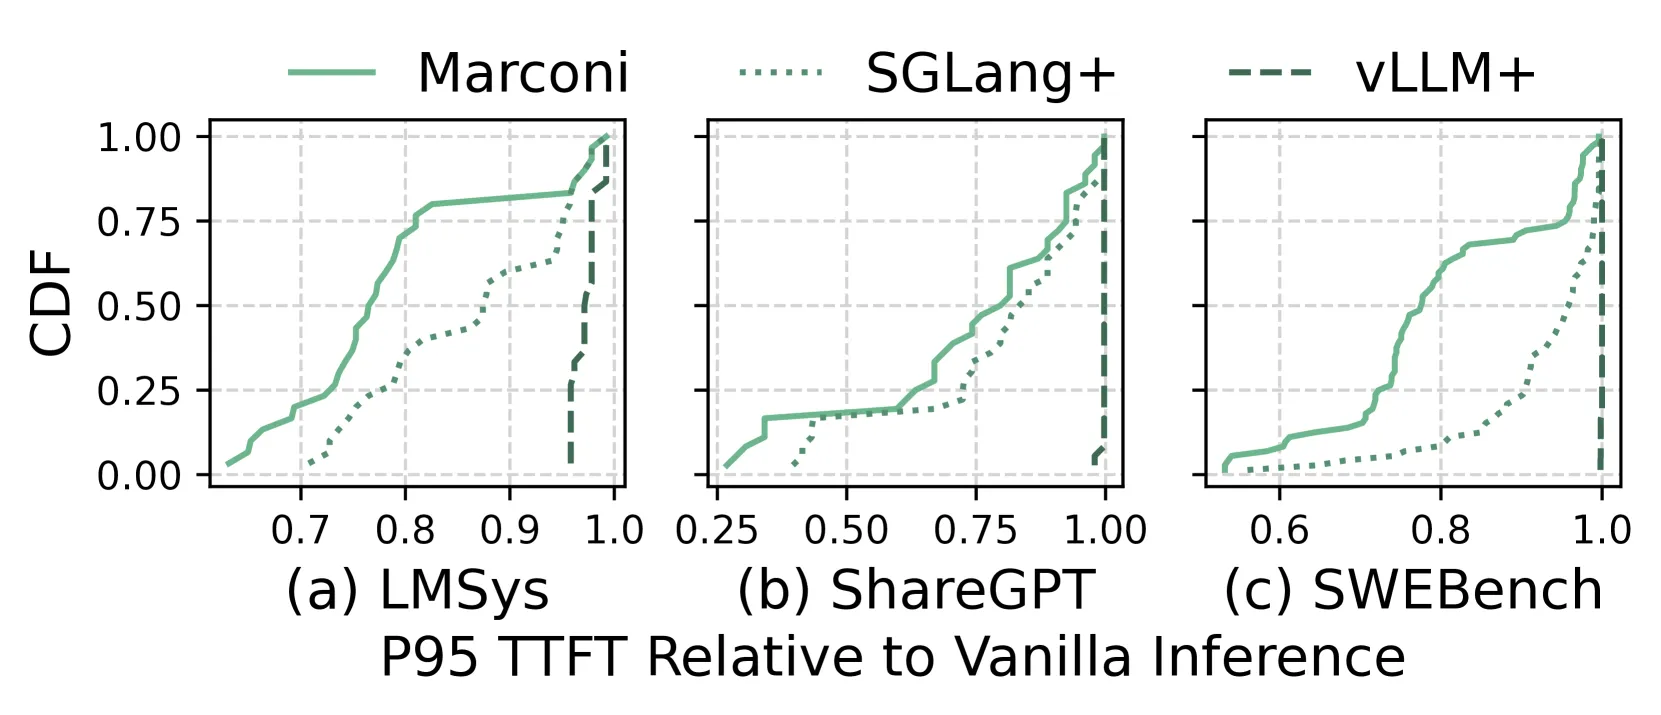 图 13:请求到达模式对 Marconi 性能的影响。
六、相关工作
6.1 混合/循环子二次模型
| 模型 | 特点 |
|---|---|
| RWKV | 循环神经网络的 Transformer 时代复兴 |
| RetNet | 保留网络,Transformer 的继承者 |
| GLA | 门控线性注意力 |
| Griffin | 门控线性循环与局部注意力混合 |
| RecurrentGemma | 高效开放语言模型 |
| xLSTM | 扩展长短期记忆 |
| TTT | 测试时训练 |
| DeltaNet | Delta 规则线性 Transformer |
| B’MOJO | 混合状态空间实现 |
| Jamba | Transformer-Mamba 混合模型(最大 398B 参数) |
| Zamba | 紧凑的 7B SSM 混合模型 |
关键观察:尽管这些模型有不同的状态更新规则,但都递归更新(大型)模型状态。Marconi 评估的是 Mamba/SSM 作为代表性架构,但其设计可扩展支持所有带循环层的混合模型。
6.2 前缀缓存系统
| 系统 | 主要特点 | 局限性 |
|---|---|---|
| InferCept | 优化多轮聊天场景的 KVs 重用 | 仅支持 Transformer |
| CachedAttention | 分层缓存利用内存/存储介质 | 仅支持 Transformer |
| Pensieve | 维护分层缓存 | 仅支持 Transformer |
| Preble | 集群级有状态缓存,请求路由 | 仅支持 Transformer |
| PromptCache | 模块化注意力重用 | 近似导致精度下降 |
| CacheBlend | 缓存知识融合 | 近似导致精度下降 |
| vLLM | PagedAttention 内存管理 | 不支持混合模型前缀缓存 |
| SGLang | 基数树前缀缓存 | 不支持混合模型,使用 LRU 淘汰 |
Marconi 的独特之处:
- 智能准入:只缓存高重用可能性的 SSM 状态
- FLOP 感知淘汰:考虑计算节省效率
- 统一管理:KVs 和 SSM 状态在同一基数树中管理
6.3 其他 LLM 推理优化
| 优化技术 | 与混合模型的关系 |
|---|---|
| 连续批处理 | SSM 层更容易实现,无需序列维度 |
| 分页内存管理 | SSM 状态固定大小无需分页,KVs 仍需分页 |
| 分块预填充 | 需要专用内核 |
| FlashAttention | 层特定优化 |
七、总结
7.1 核心成果
Marconi 是首个为混合模型设计的前缀缓存系统,通过以下创新解决了混合 LLM 前缀缓存的独特挑战:
- 智能准入策略:基于前缀重用场景分类法,只缓存高重用可能性的 SSM 状态
- FLOP 感知淘汰策略:综合考虑最近性和计算节省效率,优化缓存利用率
- 统一基数树管理:在同一树结构中管理 KVs 和 SSM 状态
7.2 性能提升
| 指标 | 提升范围 |
|---|---|
| Token 命中率 | 4.5-34.4× |
| P95 TTFT 降低 | 36.1-71.1% (103.3-617.0 ms) |
| FLOP 节省 | 最高 90.3% |
7.3 适用场景
Marconi 在以下场景表现最佳:
- 长上下文序列
- 高 SSM 层比例的混合模型
- 大 SSM 状态维度
- 中等至高缓存竞争
7.4 未来方向
- 扩展到更多循环架构:支持 RWKV、RetNet、GLA 等
- 集群级优化:跨 GPU 的分布式前缀缓存
- 动态 α 调优:在线自适应调整 FLOP 效率权重
- 与其他优化协同:与连续批处理、分块预填充等结合
八、参考资源
8.1 论文链接
| 资源 | 链接 |
|---|---|
| arXiv 页面 | https://arxiv.org/abs/2411.19379 |
| PDF 下载 | https://arxiv.org/pdf/2411.19379 |
| HTML 版本 | https://arxiv.org/html/2411.19379v1 |
8.2 关键图表
| 图表 | 文件 | 描述 |
|---|---|---|
| 图 1 | x1.png | 混合模型概述 |
| 图 2 | x2.png | 前缀缓存重用示意图 |
| 图 3 | x3.png | 细粒度缓存的问题分析 |
| 图 4 | x4.png | 推测性插入机制 |
| 图 5 | x5.png | FLOP 效率对比 |
| 图 6 | x6.png | 工作负载序列长度分布 |
| 图 7 | x7.png | 与 vLLM+ 的端到端对比 |
| 图 8 | x8.png | 与 SGLang+ 的对比 |
| 图 9 | x9.png | P95 TTFT 分布 |
| 图 10 | x10.png | FLOP 感知淘汰细粒度分析 |
| 图 11 | x11.png | 缓存竞争影响分析 |
| 图 12 | x12.png | 模型架构影响分析 |
| 图 13 | x13.png | 请求到达模式影响 |


8.3 相关代码与工具
| 工具 | 描述 | 链接 |
|---|---|---|
| vLLM | 高效 LLM 服务引擎 | https://github.com/vllm-project/vllm |
| SGLang | 高效 LLM 编程框架 | https://github.com/sgl-project/sglang |
| Mamba | 选择性状态空间模型 | https://github.com/state-spaces/mamba |
| Jamba | Transformer-Mamba 混合模型 | https://github.com/AI21Labs/Jamba |
8.4 引用格式
@article{pan2024marconi,
  title={Marconi: Prefix Caching for the Era of Hybrid LLMs},
  author={Pan, Rui and Wang, Zhuang and Jia, Zhen and Karakus, Can and Zancato, Luca and Dao, Tri and Wang, Yida and Netravali, Ravi},
  journal={arXiv preprint arXiv:2411.19379},
  year={2024}
}
文档生成时间:2026-05-30 分析来源:arXiv:2411.19379v1