Understanding GEMM Performance and Energy on NVIDIA Ada Lovelace: A Machine Learning-Based Analytical Approach
基于机器学习的 NVIDIA Ada Lovelace GEMM 性能和能耗分析
Understanding GEMM Performance and Energy on NVIDIA Ada Lovelace: A Machine Learning-Based Analytical Approach
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Understanding GEMM Performance and Energy on NVIDIA Ada Lovelace: A Machine Learning-Based Analytical Approach |
| 作者 | 未在摘要中明确列出 |
| 机构 | 未明确 |
| 论文 | arXiv:2411.16954 |
| 代码 | GPPerf (开源) |
| 发布 | 2024年11月 |
| 许可 | 未明确 |
| 硬件平台 | NVIDIA GeForce RTX 4070 (Ada Lovelace) |
二、核心思想
问题定义
GPU 内核性能优化是现代高性能计算的关键挑战,特别是随着应用对计算资源利用效率要求的提高。NVIDIA Ada Lovelace 架构(如 RTX 4070)具有 504.2 GB/s 峰值内存带宽和 29.15 TFLOPS 理论峰值性能,性能优化复杂性显著增加。
解决方案概述
本文提出基于机器学习的 GEMM 性能预测框架,结合两种方法:
- 自定义 tiled 矩阵乘法内核: 用于基础分析,研究 tile 大小对性能的影响
- NVIDIA CUTLASS 库: 用于全面性能数据收集,覆盖 16,128 种 GEMM 配置
预测模型: 使用 Random Forest 多输出回归,预测运行时间、功耗和能效。
核心性能
- 运行时预测: R² = 0.98,平均误差 15.57%
- 功耗预测: R² = 0.78,中位误差 5.42%
- 优化收益: 最优 tile 大小可提升性能 3.2×,降低功耗 22%
三、技术架构
Roofline 性能模型
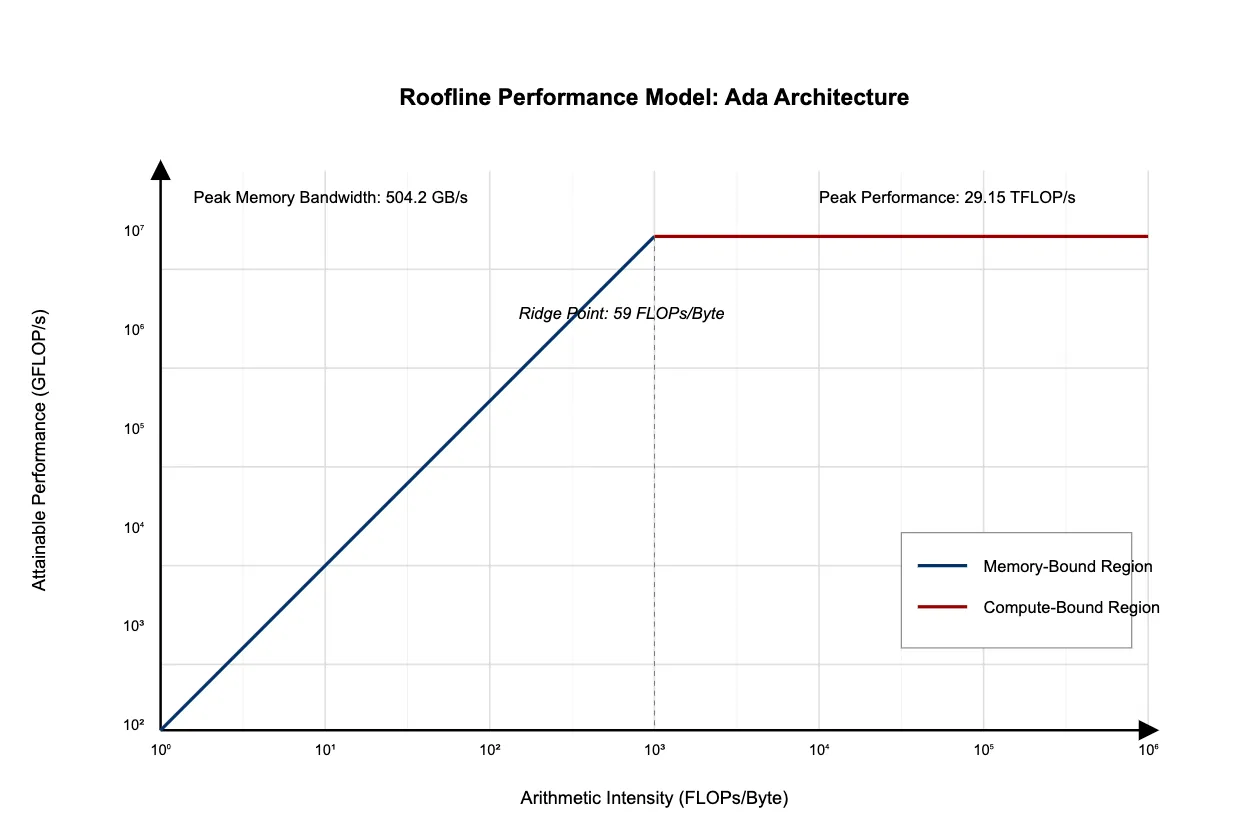
Figure 1: Ada 架构的 Roofline 性能模型
关键参数:
- 峰值内存带宽: 504.2 GB/s
- 理论峰值性能: 29.15 TFLOPS
- Ridge point: 59 FLOPs/Byte(内存受限 vs 计算受限的转折点)
性能区域:
- 内存受限区域: 算术强度 < 59 FLOPs/Byte
- 计算受限区域: 算术强度 > 59 FLOPs/Byte
核心公式
算术强度:
内存效率:
Roofline 上界:
Tiled 矩阵乘法内核
CUDA 内核结构:
__global__ void op_mm_kernel(float *a, float *b, float *c,
                              int M, int N, int K, int tile_size) {
    extern __shared__ float shared_mem[];
    float* As = shared_mem;
    float* Bs = shared_mem + tile_size * tile_size;

    float r = 0.0f;
    int row = threadIdx.y;
    int col = threadIdx.x;

    for (int k = 0; k < (K + tile_size - 1) / tile_size; k++) {
        // 加载到共享内存
        // 执行计算
    }
}
Tile 大小影响:
- Block 大小 = tile_size × tile_size
- 共享内存 = 2 × block_size × sizeof(float)
- Grid 大小随矩阵维度和 tile 大小变化
SM 占用率分析
| Tile 大小 | 每 SM 最大活跃 Block 数 | 说明 |
|---|---|---|
| 1 | 高 | 但利用率极低(每 warp 仅 1 线程) |
| 4 | 中 | 改善但仍受限 |
| 8 | 中 | 平衡点 |
| 16 | 24 | 最佳平衡 |
| 32 | 1 | 共享内存限制 |
四、实验结果
Tiled 矩阵乘法运行时
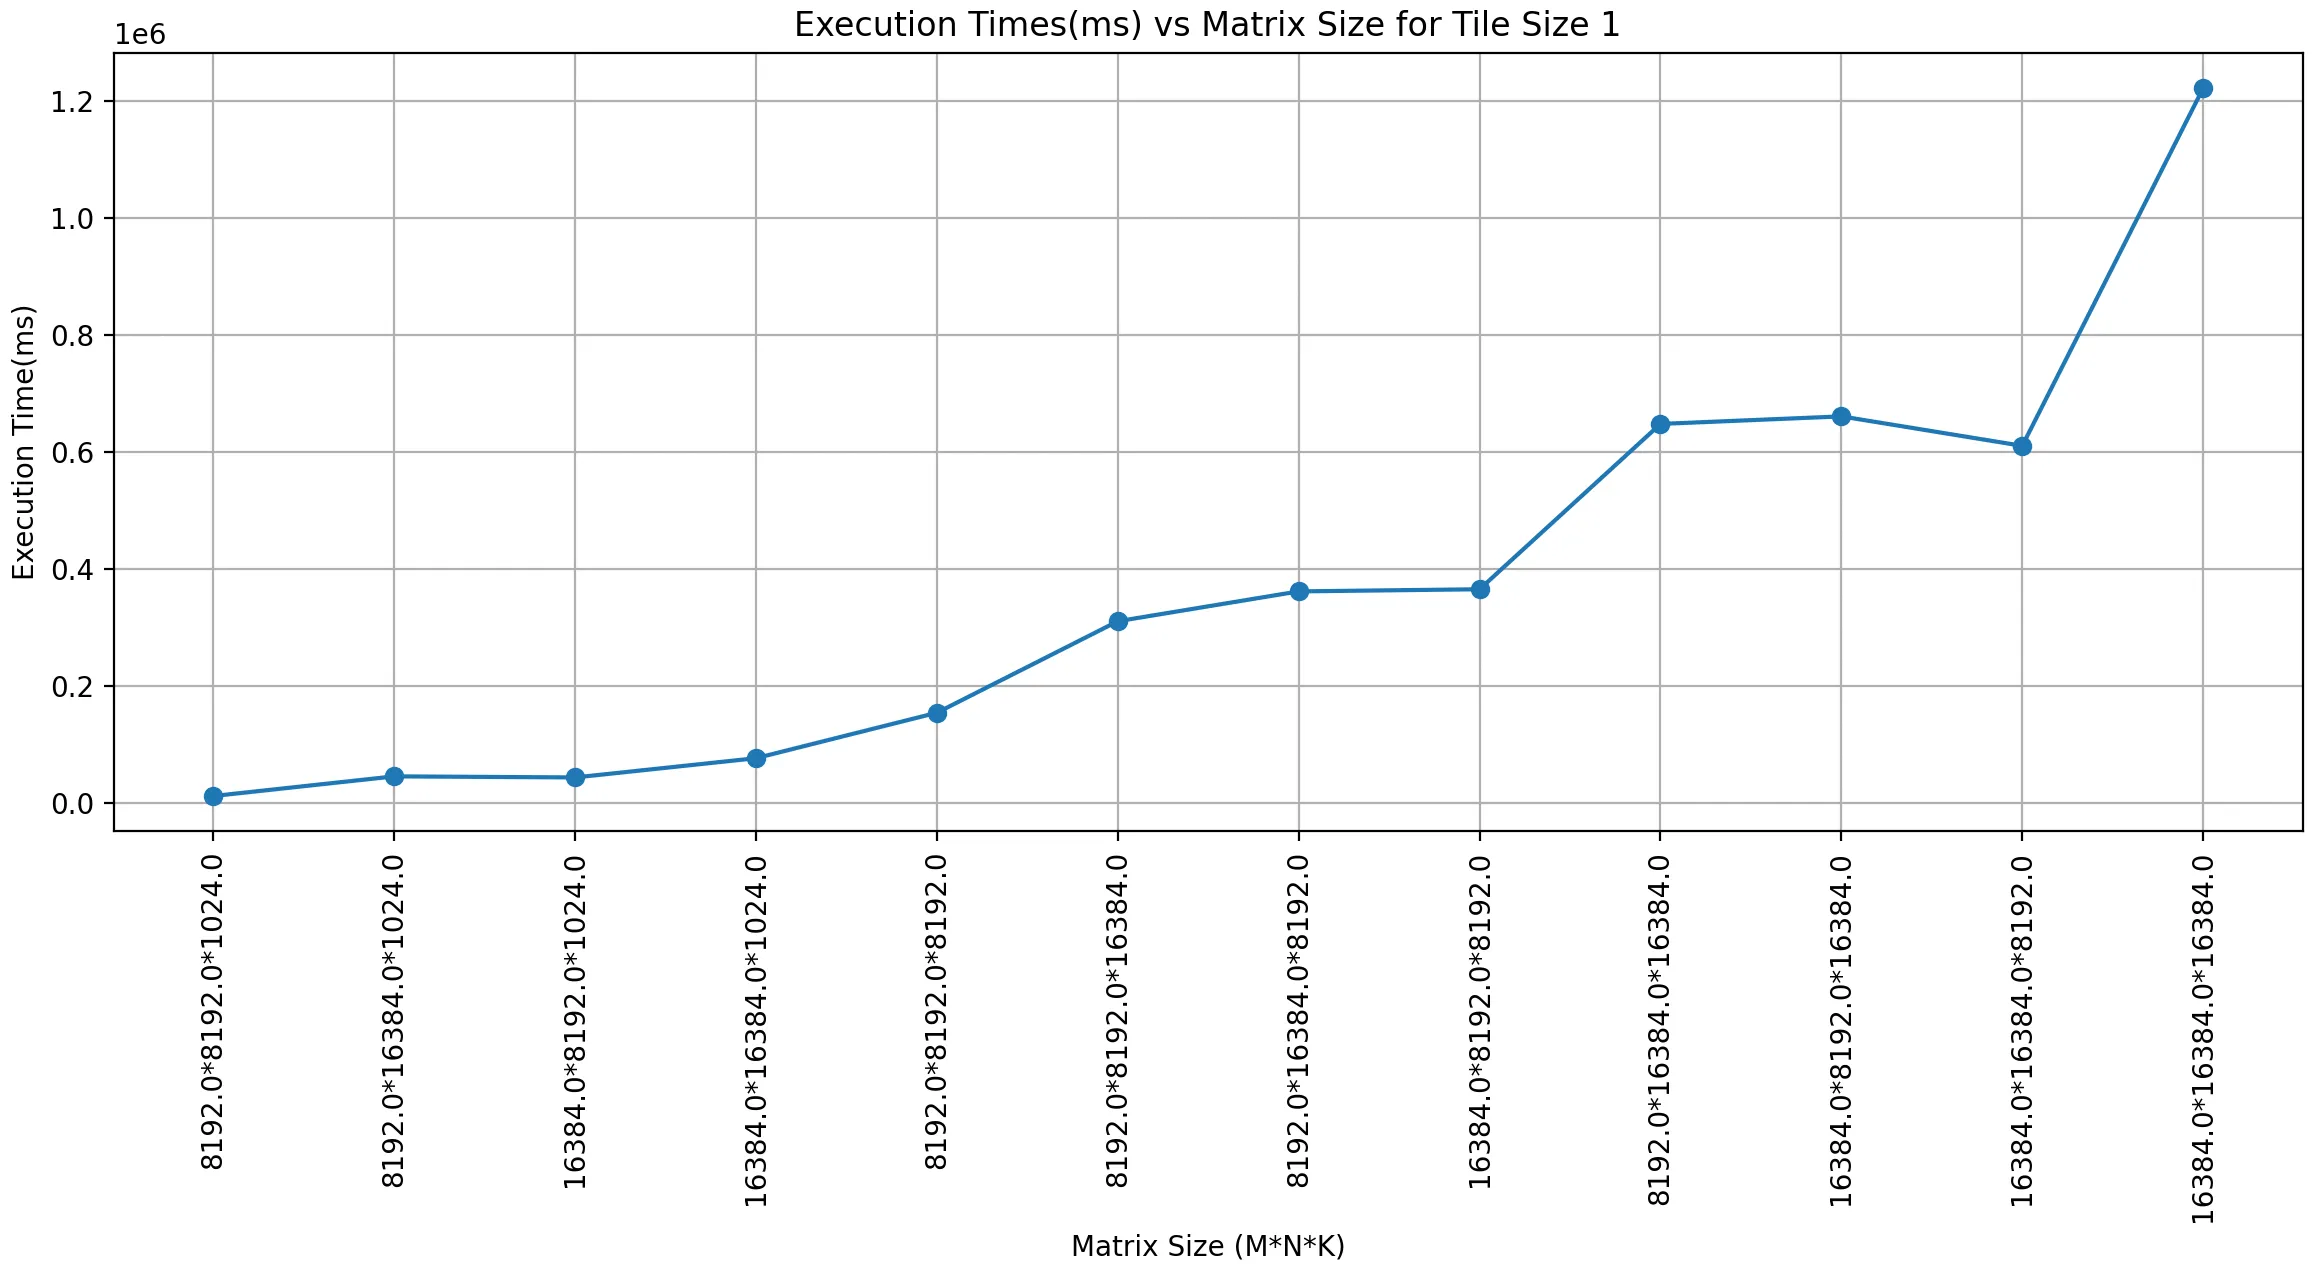
Figure 2: Tile=1 的运行时(最慢配置)
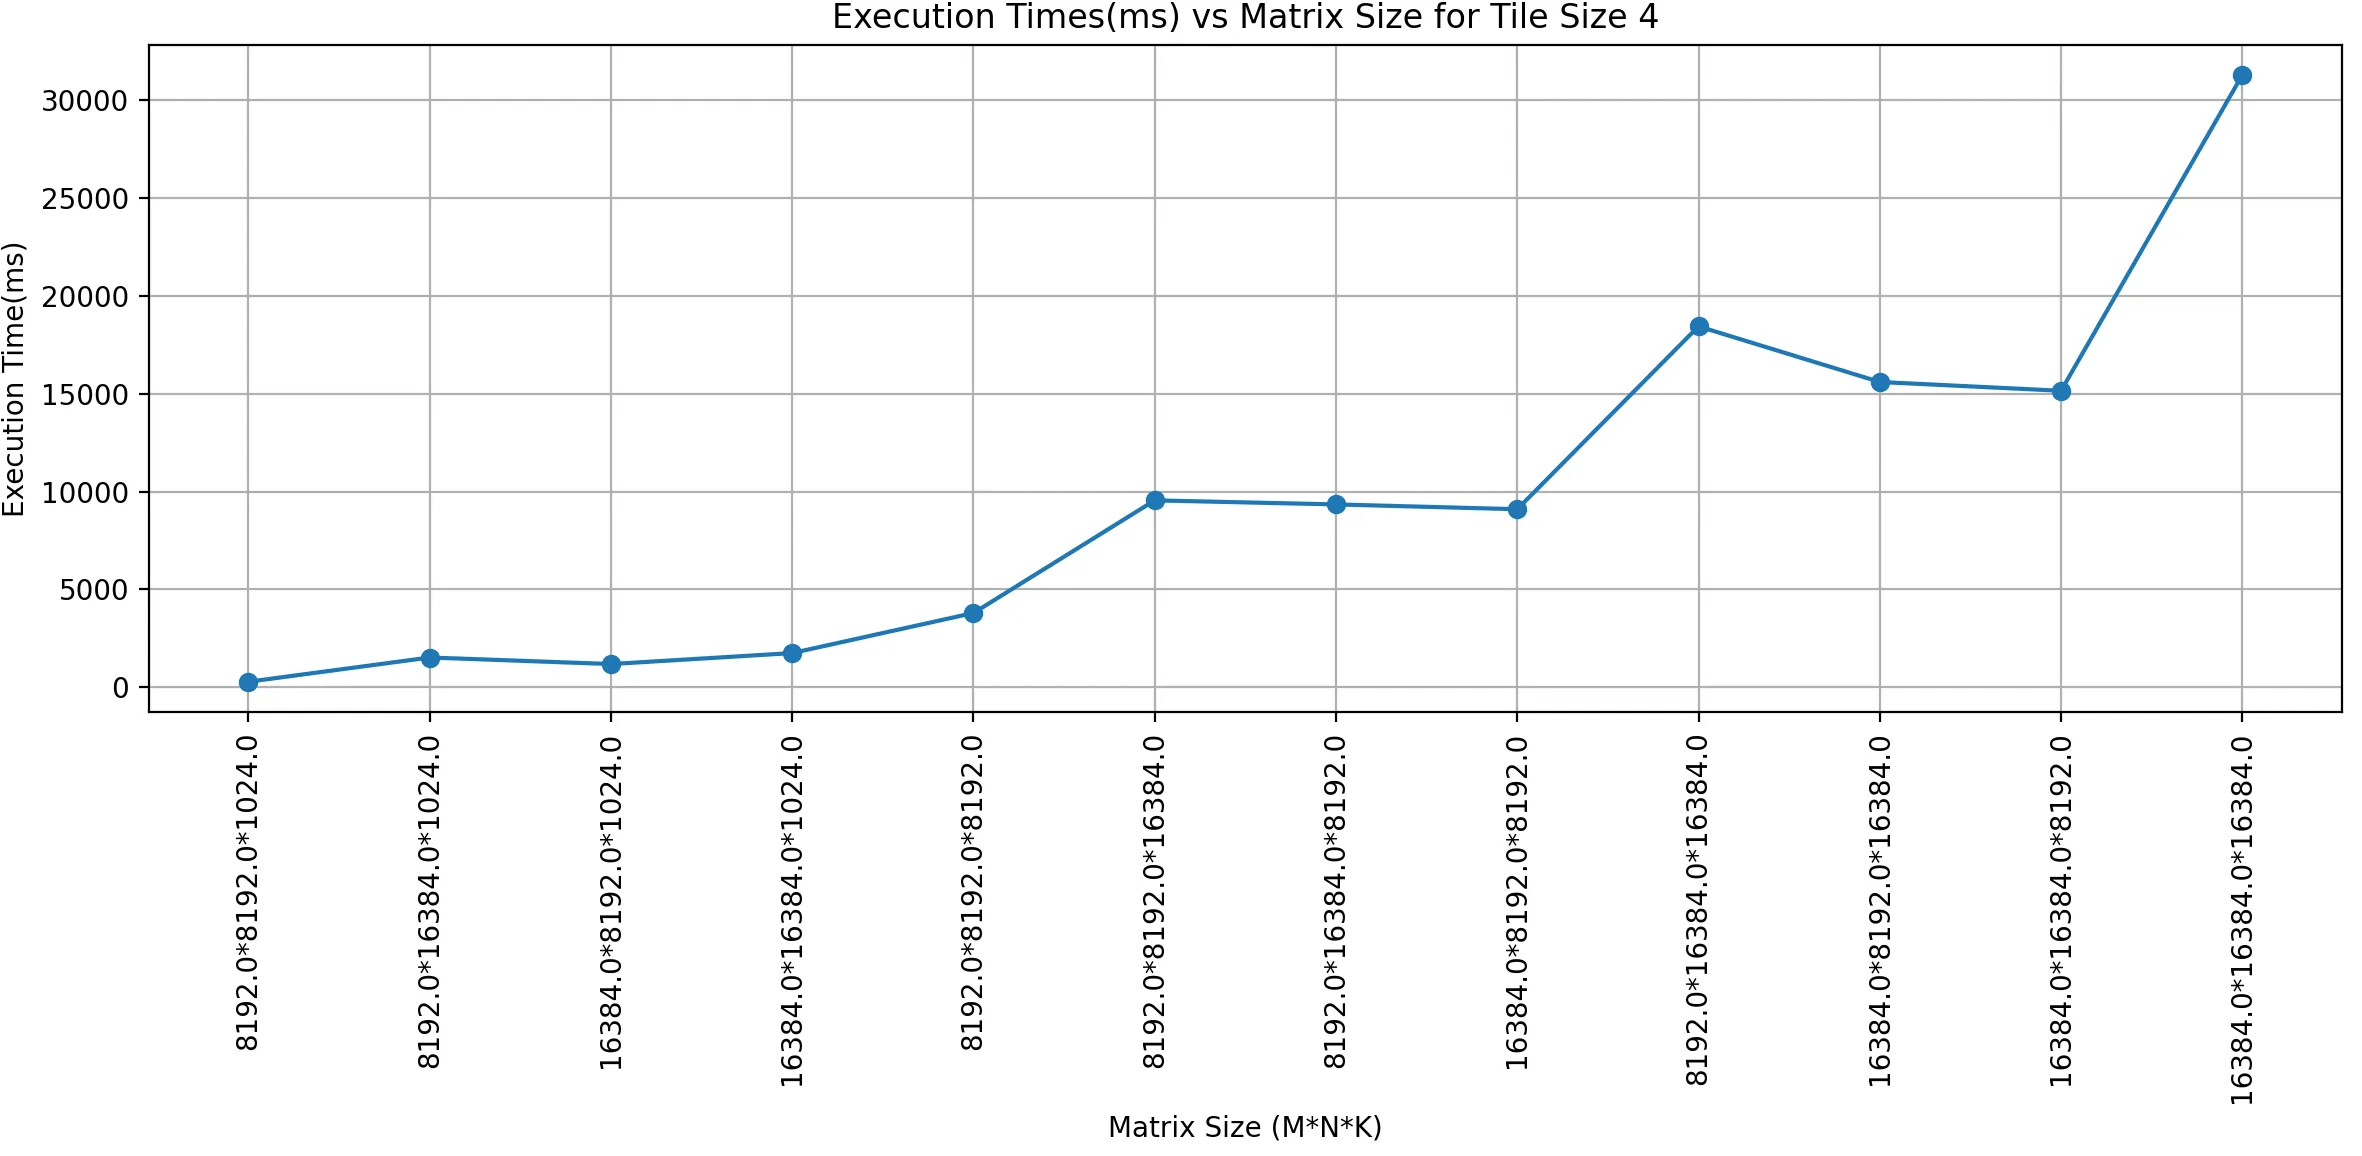
Figure 3: Tile=4 的运行时
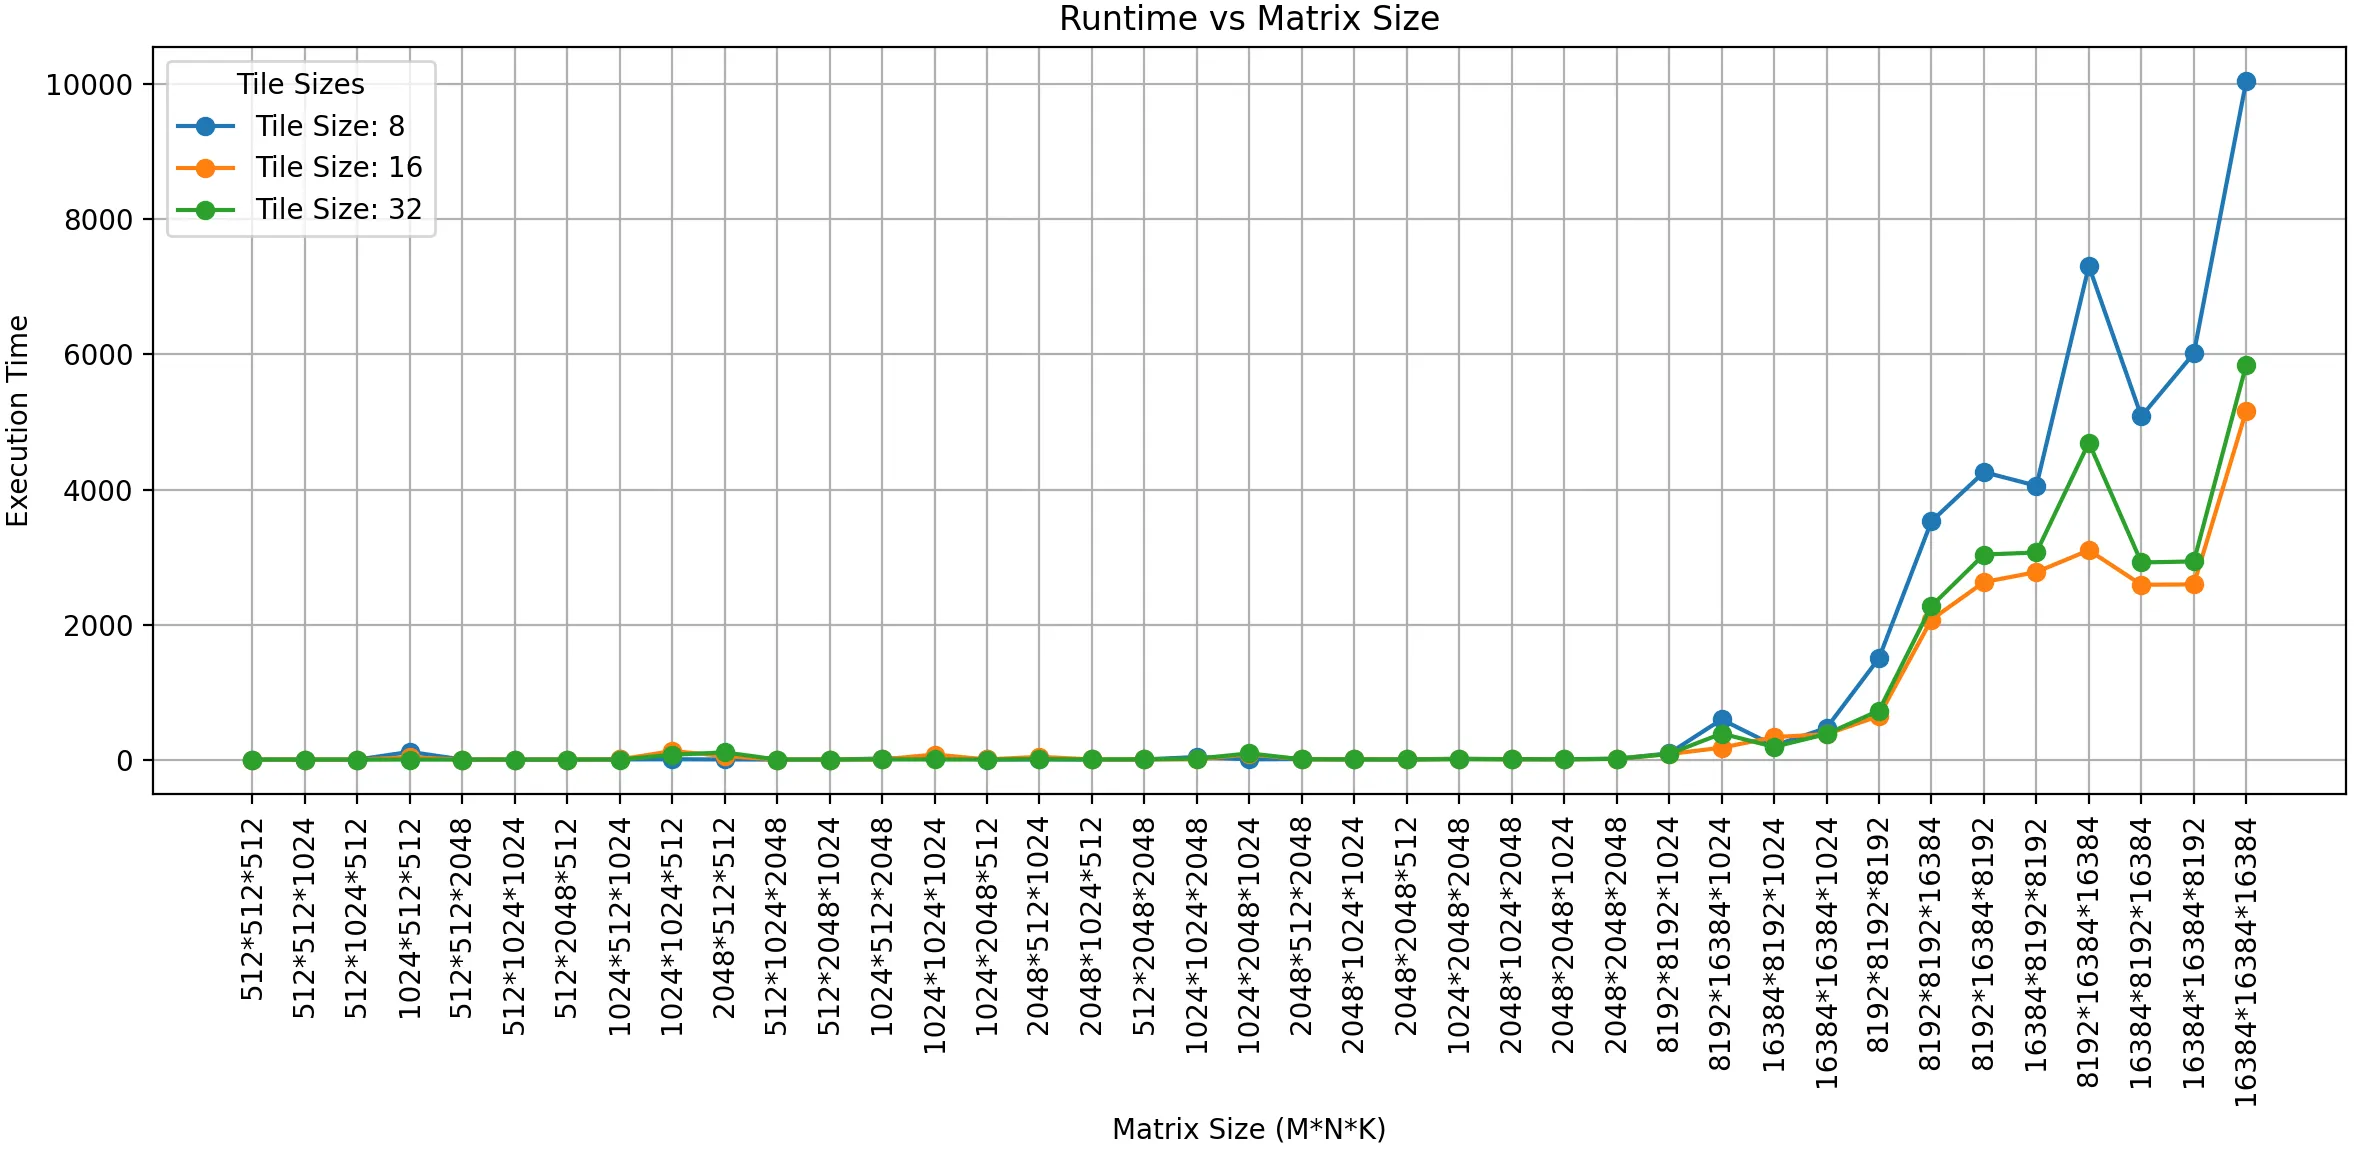
Figure 4: Tile=8,16,32 的运行时
关键观察:
- 运行时随矩阵大小增加而增加
- 运行时随 tile 大小增加而减少(直到 tile=16 达到平台)
- Tile=1 极慢:每 warp 仅 1 线程工作,SP 利用率极低
- Tile=16 后不再改善:内存访问瓶颈已解决,共享内存限制成为新瓶颈
功耗分析
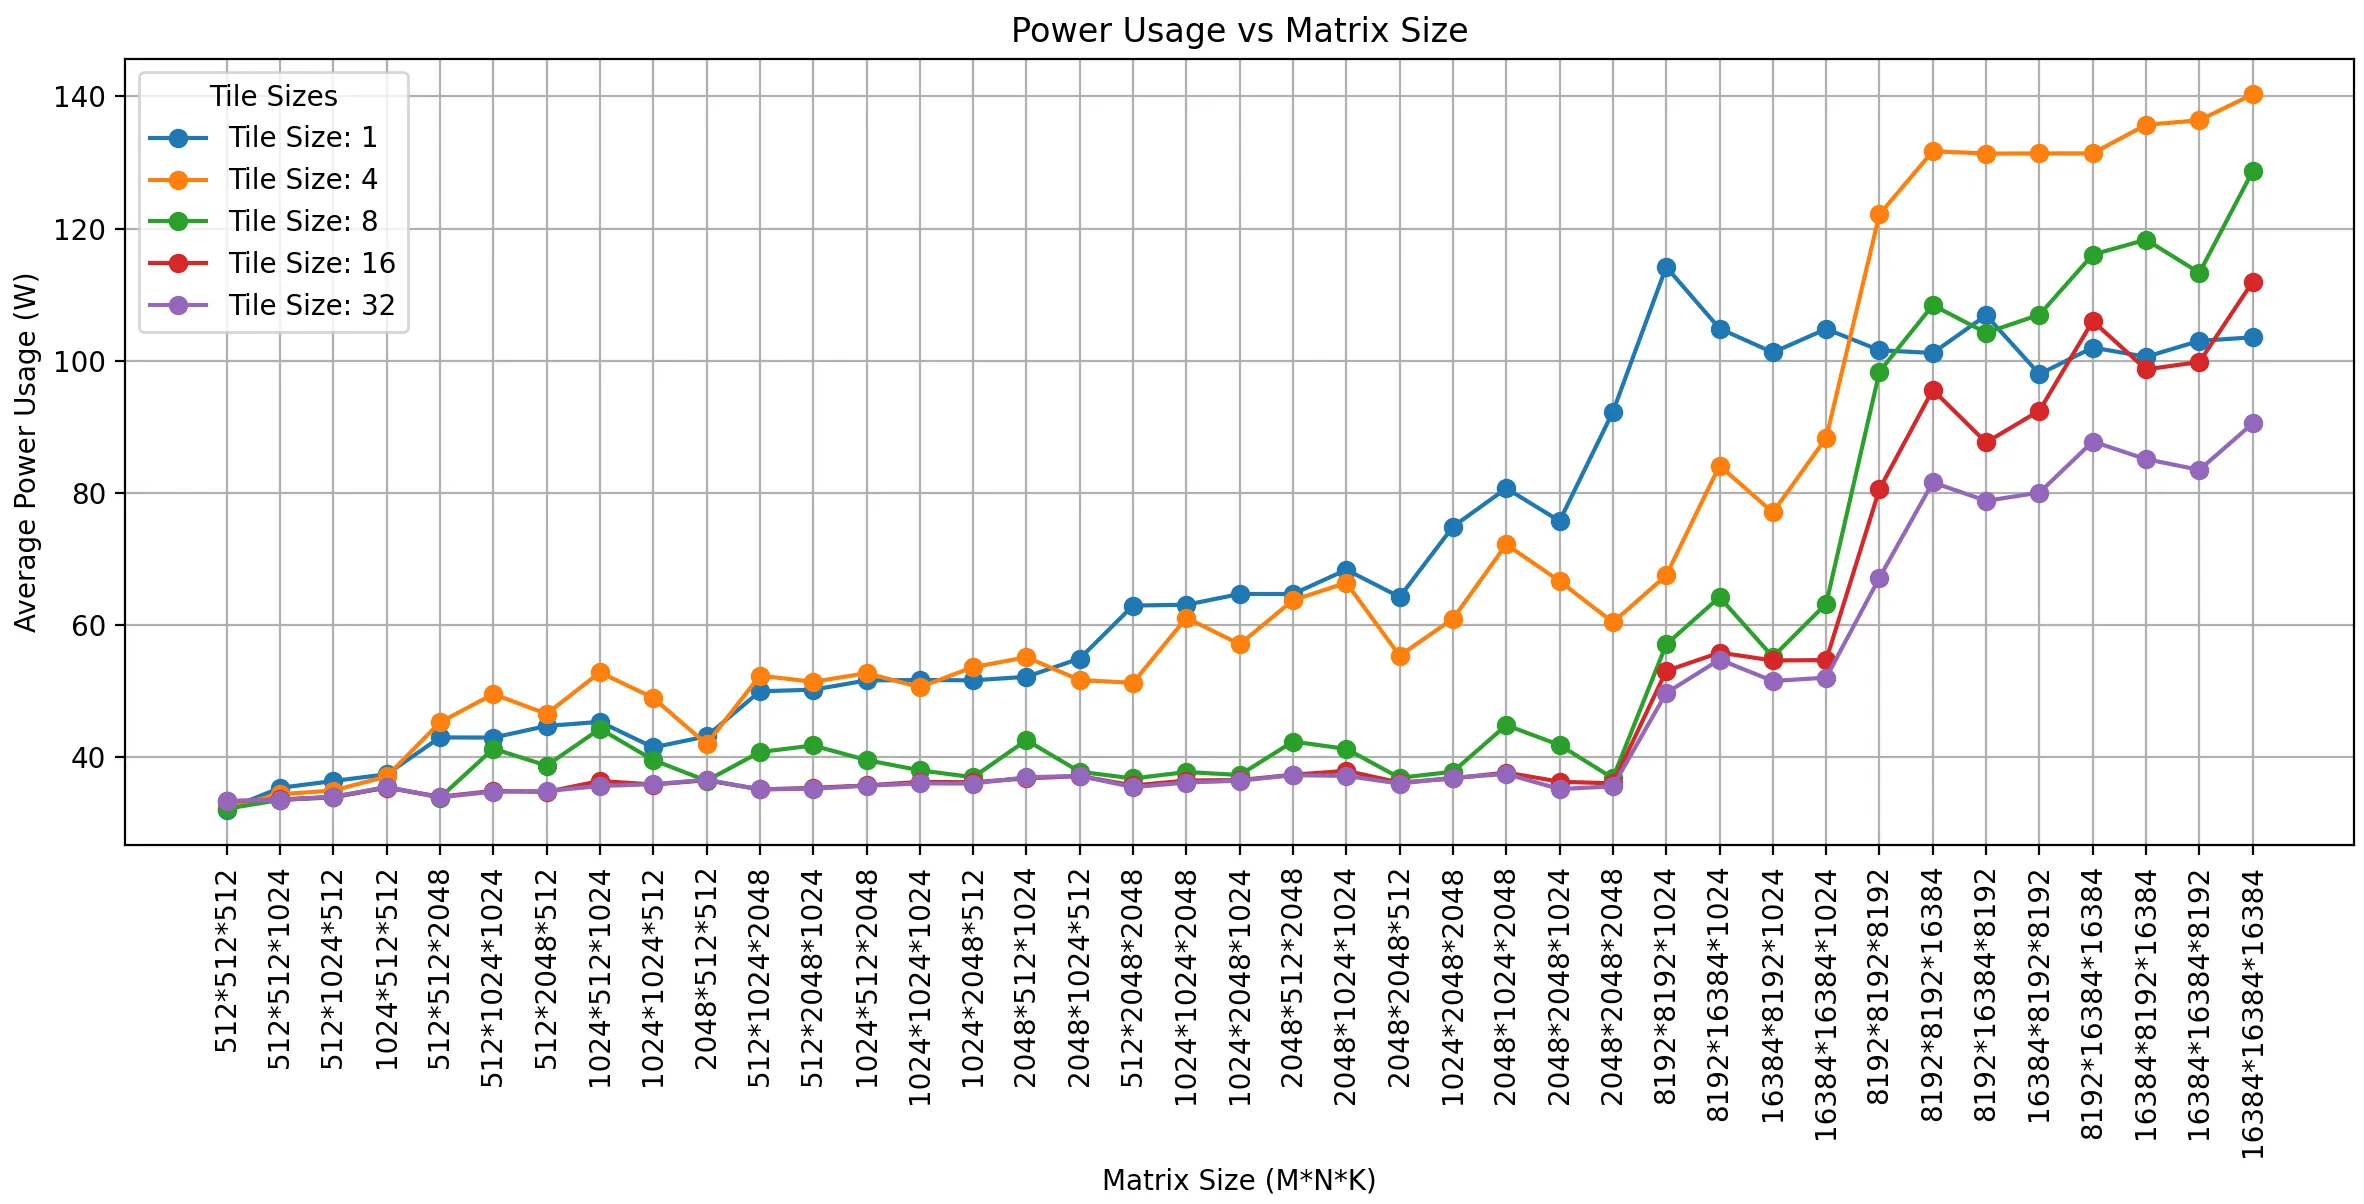
Figure 5: 不同 tile 大小下的功耗
关键发现:
- 更大 tile 大小 → 更低功耗
- 小 tile (1,4): 频繁调度 block,功耗高
- 大 tile (16,32): 减少 grid 大小,最小化空闲 SP 时间
优化收益: 最优 tile 大小可降低功耗 22%
相关性分析
| 相关性 | 系数 | 说明 |
|---|---|---|
| M×N×K vs 运行时 | r=0.98 | 强相关 |
| M×N vs 功耗 | r=0.80 | 中等相关 |
| K vs 功耗 | 较弱 | 输出维度影响更大 |
洞察: 优化矩阵分区策略应优先考虑输出维度以提高功耗效率
机器学习预测
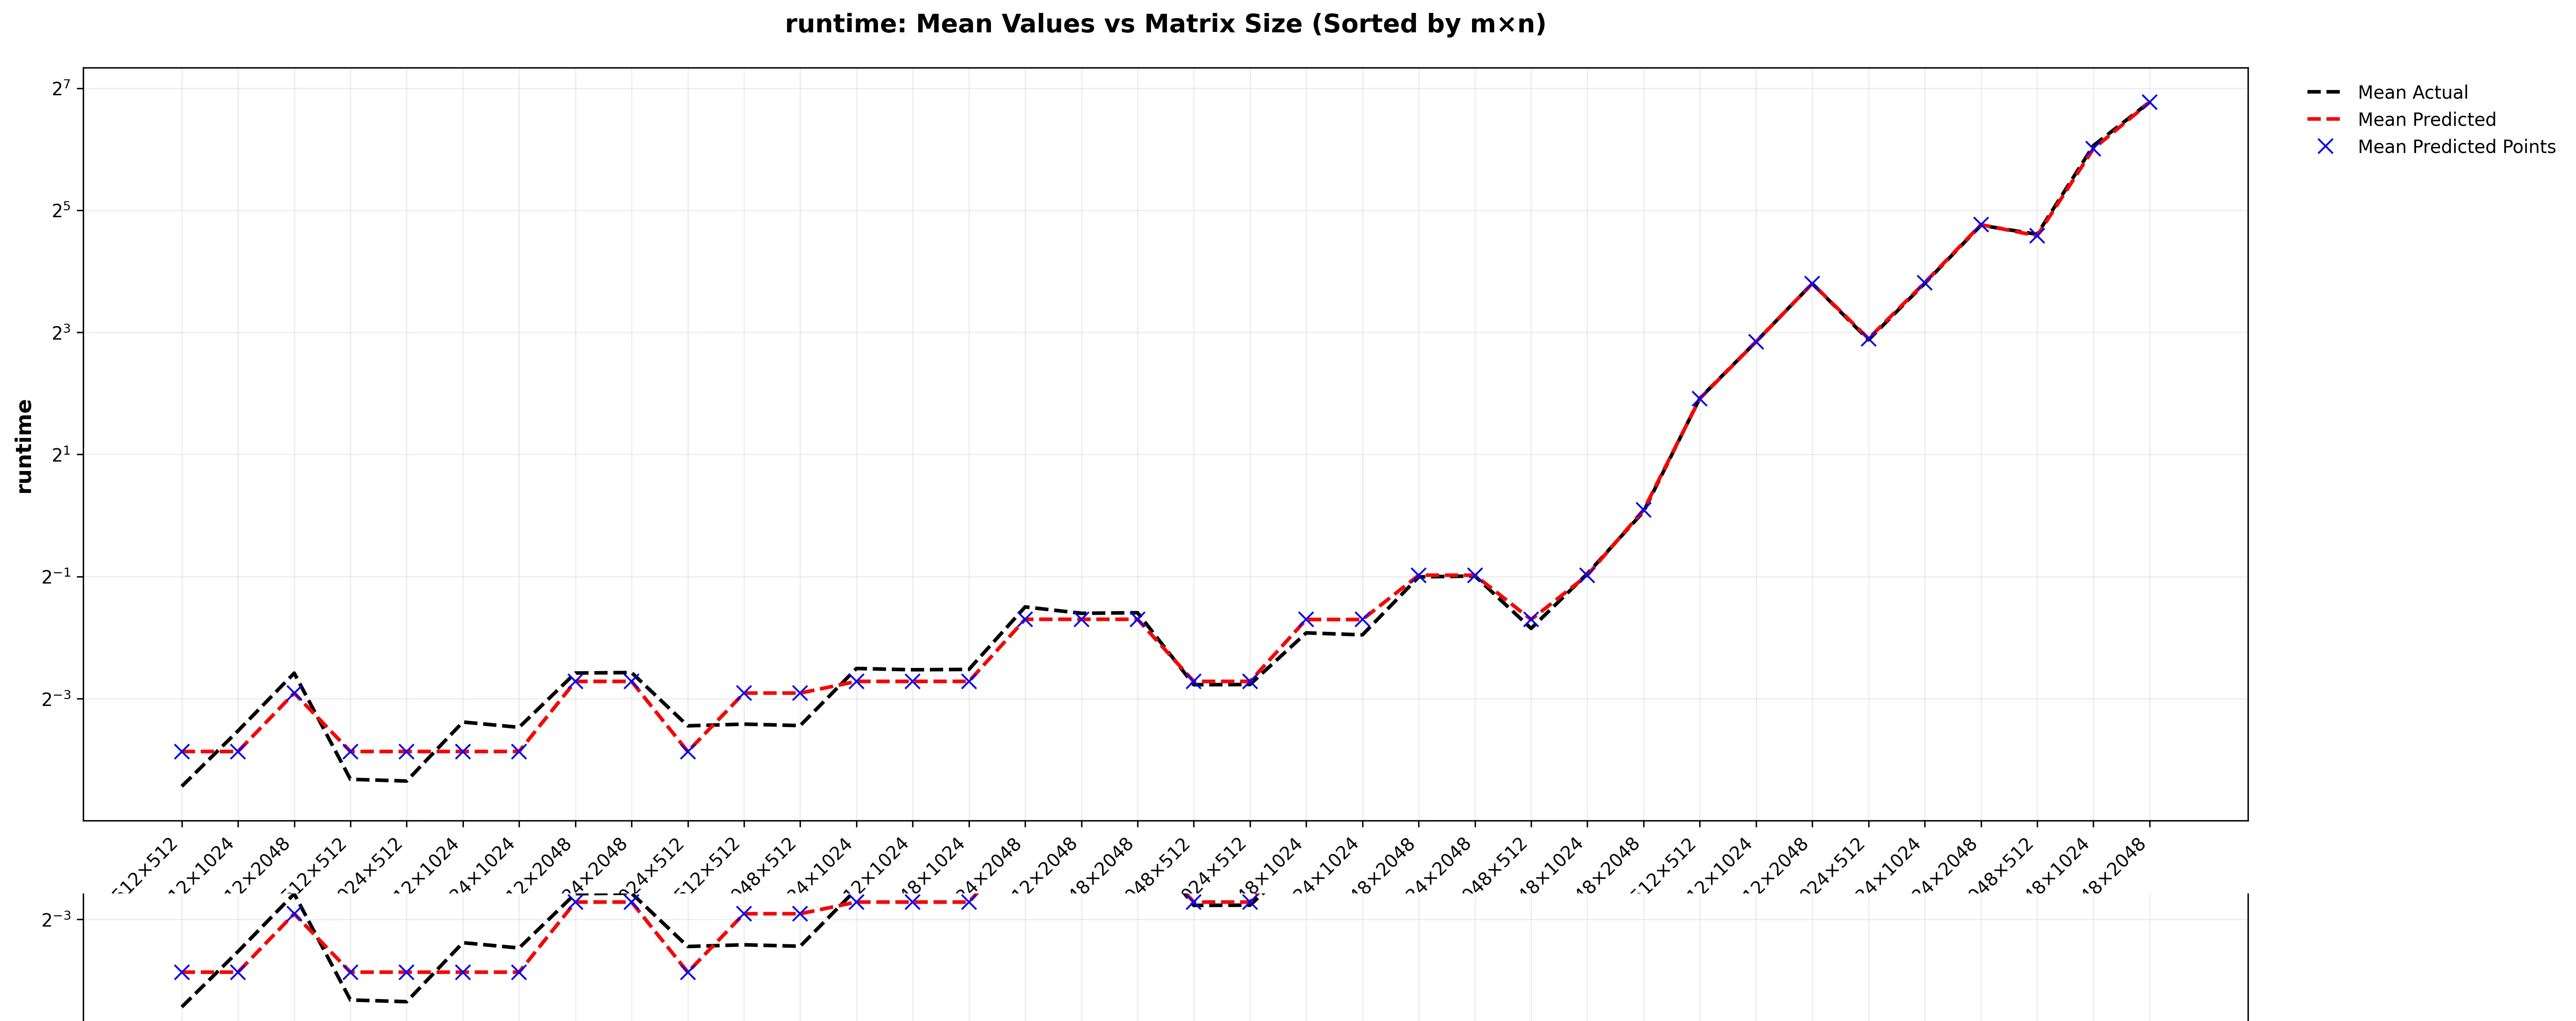
Figure 7: 运行时预测精度
预测模型性能:
| 指标 | 运行时 | 功耗 | 能耗 |
|---|---|---|---|
| R² 分数 | 0.98 | 0.78 | - |
| 平均误差 | 15.57% | - | - |
| 中位误差 | - | 5.42% | - |
CUTLASS 综合分析
数据规模: 16,128 种 GEMM 配置
- 多种矩阵尺寸
- 多种线程块配置
- 多种内存访问模式
Random Forest 多输出回归:
- 同时预测运行时间、功耗、能耗
- 跨矩阵尺寸的稳健扩展行为
五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 双层分析方法 | 自定义内核 + CUTLASS 库 | 基础分析 + 全面覆盖 |
| ML 性能预测 | Random Forest 多输出回归 | R²=0.98 运行时预测 |
| Tile 大小优化 | 系统性研究 tile 大小影响 | 3.2× 性能提升 |
| 能耗分析 | 同时考虑性能和功耗 | 22% 功耗降低 |
| 开源框架 | GPPerf 工具包 | 可复现研究 |
六、关键发现
1. Tile 大小优化提升功耗效率
- 更大 tile → 更高效资源利用 → 更低功耗
- 小 tile (1,4): 频繁调度,功耗高
- 最优 tile=16: 性能和功耗的最佳平衡
2. 矩阵大小对性能指标的影响
- 运行时: 由总计算量 (M×N×K) 主导 (r=0.98)
- 功耗: 由输出维度 (M×N) 主导 (r=0.80)
- 优化启示: 功耗优化应关注输出维度
3. 共享内存约束
- Tile=16: 占用率从 24 降至 6 blocks/SM
- Tile=32: 降至 1 block/SM
- 实际约束: 共享内存限制了 tile 大小的上界
4. 最优配置
| 配置 | 性能提升 | 功耗降低 |
|---|---|---|
| Tile=16 (最优) | 3.2× | 22% |
| Tile=32 | 较少改善 | 更低功耗 |
七、总结
核心贡献
- 分析框架: 结合自定义内核和 CUTLASS 的双层分析方法
- ML 预测模型: Random Forest 实现高精度性能预测
- Tile 优化: 发现 tile=16 是最佳平衡点
- 能耗洞察: 矩阵分区应优先考虑输出维度
- 开源工具: GPPerf 框架可复现
技术影响
- 内核优化: 指导 tile 大小选择
- 性能预测: 无需运行即可预测性能
- 能效优化: 同时优化性能和功耗
- 架构理解: 深入理解 Ada Lovelace 特性
局限性
- 仅测试 RTX 4070(Ada Lovelace)
- 预测模型特定于该架构
- 未考虑跨 GPU 泛化
八、参考资源
- 论文: arXiv:2411.16954
- PDF: arXiv PDF
- HTML: arXiv HTML
- 代码: GPPerf
- 硬件: NVIDIA GeForce RTX 4070 (Ada Lovelace)
- 软件: CUDA 12.2, CUTLASS