DiffServe: Efficiently Serving Text-to-Image Diffusion Models with Query-Aware Model Scaling
基于查询感知模型扩展的文本到图像扩散模型高效服务系统
DiffServe: Efficiently Serving Text-to-Image Diffusion Models with Query-Aware Model Scaling
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DiffServe: Efficiently Serving Text-to-Image Diffusion Models with Query-Aware Model Scaling |
| 作者 | Sohaib Ahmad, Qizheng Yang, Haoliang Wang, Ramesh K. Sitaraman, Hui Guan |
| 机构 | University of Massachusetts Amherst |
| 论文 | arXiv:2411.15381 |
| 代码 | GitHub |
| 发布 | 2024年11月 (v1), 2025年5月 (v2) |
| 领域 | 分布式、并行与集群计算 (cs.DC) |
摘要
基于扩散模型的文本到图像生成因其能够根据文本提示生成高质量、逼真的图像而日益流行。然而,由于其计算密集型特性和查询需求的变化,高效服务这些模型面临挑战。本文通过查询感知模型扩展(Query-Aware Model Scaling)同时解决这两个问题。核心思想是构建模型级联(Model Cascade),使简单查询可以由更轻量的扩散模型处理,而不会损害图像生成质量。基于这一概念,开发了端到端的文本到图像扩散模型服务系统 DiffServe,该系统自动从可用的扩散模型变体构建模型级联,并根据需求波动动态分配资源。实验评估表明,与最先进的模型服务系统相比,DiffServe 实现了高达 24% 的响应质量提升,同时保持 19-70% 的更低延迟违规率。
二、核心思想
问题定义
高效服务文本到图像扩散模型面临两个主要挑战:
- 计算密集型:高质量扩散模型计算量大,限制服务吞吐量。例如,Stable Diffusion XL 相比 SDv1.5 实现 30% 的图像质量提升,但推理时间增加约 3.6 倍
- 需求变化:工作负载在一天中显著波动,静态资源分配导致资源浪费或性能下降
解决方案概述
查询感知模型扩展的核心概念:
- 模型级联:构建轻量-重量模型对,查询首先由轻量模型处理
- 判别器:训练 ML 模型评估生成图像质量,决定是否需要转发到重量模型
- 动态资源分配:根据需求变化动态调整置信度阈值、批大小和模型部署
Figure 1: (a) 独立扩散模型与级联模型的质量-延迟权衡;(b) 不同判别器设计的比较;(c) 简单/困难查询分布。
关键观察:
- 20-40% 的简单查询可由轻量模型处理而不损害质量
- 基于 CLIP Score 和 PickScore 的判别器不如随机分类器,表明这些指标在级联场景中的局限性
- 包含轻量模型输出的混合结果可能产生更低的 FID,因为更平衡多样的图像表示
三、技术架构
系统架构
Figure 2: DiffServe 系统架构:(1) 客户端查询发送到负载均衡器;(2) 负载均衡器将查询路由到具有轻量模型和判别器的 worker;(3) 如果判别器置信度超过阈值则返回响应,否则转发到重量模型 worker;(4) 控制器定期收集运行时统计信息并重新分配资源。
核心组件
| 组件 | 功能描述 |
|---|---|
| Controller(控制器) | 管理系统资源,使用 Resource Manager 为每个 worker 分配模型变体、设置批大小和置信度阈值 |
| Model Repository(模型仓库) | 管理扩散模型变体的注册和托管,包括级联使用的判别器 |
| Load Balancer(负载均衡器) | 位于数据路径上,将查询路由到运行轻量扩散模型的 worker |
| Workers(工作节点) | 执行托管的模型变体,处理本地队列中的查询 |
数据路径与控制路径
数据路径:
- 客户端发送查询到负载均衡器
- 负载均衡器路由到轻量模型 worker
- 判别器评估生成图像质量
- 如果置信度 >= 阈值,返回响应;否则转发到重量模型 worker
控制路径:
- 控制器定期收集 worker 运行时信息
- 更新模型执行配置文件
- 根据队列长度和需求重新分配资源
四、核心创新
创新点 1:基于对抗训练的判别器设计
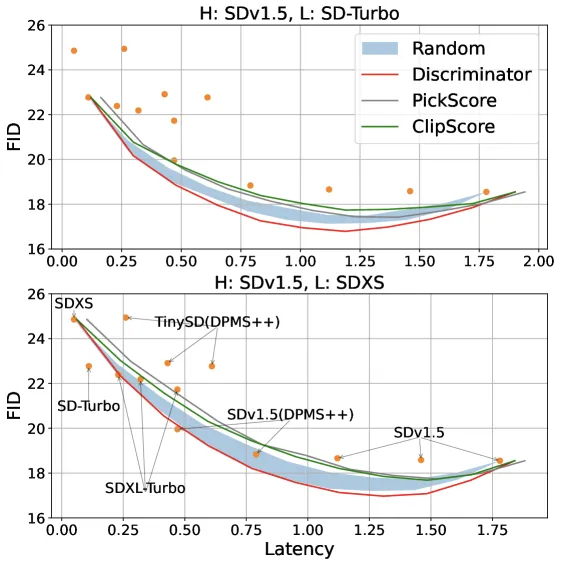
Figure 3: 判别器的训练和推理路径。‘Real’ 指来自真实世界高质量数据集的图像,‘Fake’ 指由轻量和重量扩散模型生成的图像。
设计思路:
- 训练 ML 模型区分扩散模型生成的图像与真实图像
- 复训练后的模型可作为判别器:高质量图像更接近真实图像分布,获得更高置信度分数
- 使用 EfficientNet 作为判别器架构,计算复杂度远低于扩散模型
训练细节:
| 要素 | 描述 |
|---|---|
| 训练数据 | 真实图像(MSCOCO、DiffusionDB)+ 生成图像(轻量和重量模型) |
| 标签 | 真实图像标记为 ‘real’,生成图像标记为 ‘fake’ |
| 推理输出 | Softmax 值(0-1),表示图像属于 ‘real’ 类的概率 |
| 架构选择 | EfficientNet(A100 上 10ms),优于 ResNet(2ms)和 ViT(5ms) |
级联机制:
- 设置置信度阈值 t
- 如果判别器置信度 >= t,返回轻量模型输出
- 如果置信度 < t,转发到重量模型
创新点 2:基于 MILP 的资源分配算法
优化目标:在满足延迟 SLO 的前提下,最大化置信度阈值(即响应质量)
约束条件:
-
延迟约束:
e(b₁) + q(b₁) + e(b₂) + q(b₂) ≤ L其中 e(.) 为执行延迟,q(.) 为排队延迟,b₁/b₂ 为批大小
-
吞吐量约束:
D·(1-f(t))/e(b₁) ≥ D·λ
D·f(t)/e(b₂) ≥ D·λ
x₁ + x₂ ≤ S
其中 f(t) 为置信度阈值 t 下延迟到重量模型的查询比例
-
排队延迟估计:使用 Little’s Law
W = L/λ
求解方式:
- 使用 MILP 求解器(如 Gurobi)
- 平均求解时间约 10ms
- 不在查询服务的关键路径上
- 使用指数加权移动平均估计查询需求 D
- 过度供应因子 λ = 1.05
五、实验结果
实验设置
| 配置 | 描述 |
|---|---|
| Cascade 1 | SD-Turbo (轻量) → SDv1.5 (重量),512×512 |
| Cascade 2 | SDXS (轻量) → SDv1.5 (重量),512×512 |
| Cascade 3 | LCM-LoRA (轻量) → SDXL (重量),1024×1024 |
| 数据集 | MS-COCO 2017 (Cascade 1-2), DiffusionDB (Cascade 3) |
| 工作负载 | Microsoft Azure Functions trace |
| 硬件 | 16 个 A100-80G GPU |
基线对比
| 方法 | 描述 |
|---|---|
| Clipper-Light | 所有查询路由到轻量模型 |
| Clipper-Heavy | 所有查询路由到重量模型 |
| Proteus | 动态模型选择,但随机路由(不考虑查询复杂度) |
| DiffServe-Static | 使用级联但静态资源配置(峰值供应) |
静态工作负载结果
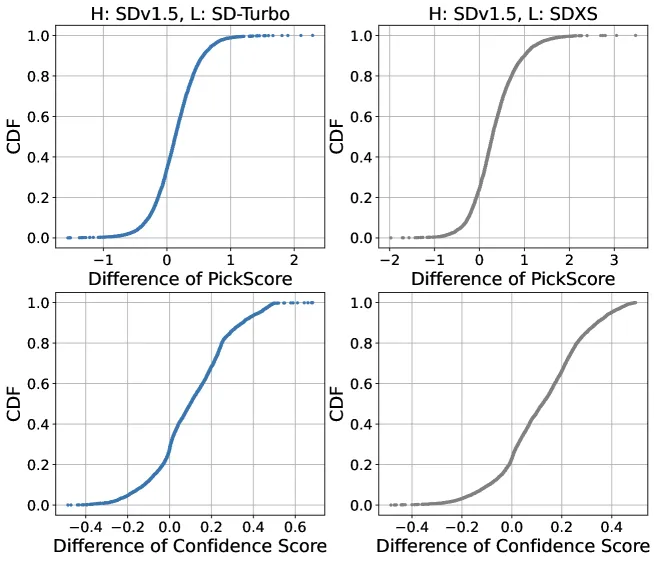
Figure 4: 静态工作负载性能比较。DiffServe 在 FID 和 SLO 违规之间提供帕累托最优权衡(左下曲线)。
关键发现:
- DiffServe 提供 FID 和 SLO 违规之间的帕累托最优权衡
- Clipper-Light SLO 违规最低但质量差
- Clipper-Heavy 质量好但 SLO 违规高(45.10%-74.11%)
- Proteus 质量低于 DiffServe-Static(约 11%)
- DiffServe 甚至在 FID 上优于 Clipper-Heavy,因为轻量模型对 20-40% 查询提供类似或更好质量
真实世界动态工作负载结果
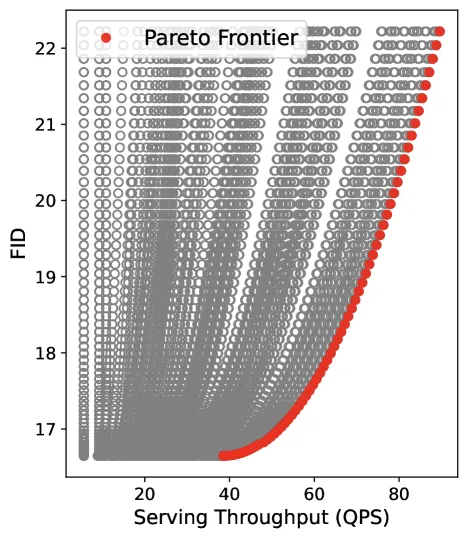
Figure 5: Cascade 1 的真实世界工作负载性能比较。DiffServe 将质量提升高达 23.4%,同时保持低 SLO 违规。
关键发现:
- 非峰值期间:DiffServe 显著提升质量(高达 23.4%),同时保证极低 SLO 违规
- 峰值期间:保持低 SLO 违规,通过智能使用重量模型
- 相比 Proteus:质量提升高达 20%(因其考虑查询复杂度)
- 相比 DiffServe-Static:SLO 违规降低高达 70%(因其适应需求变化)
测试床结果
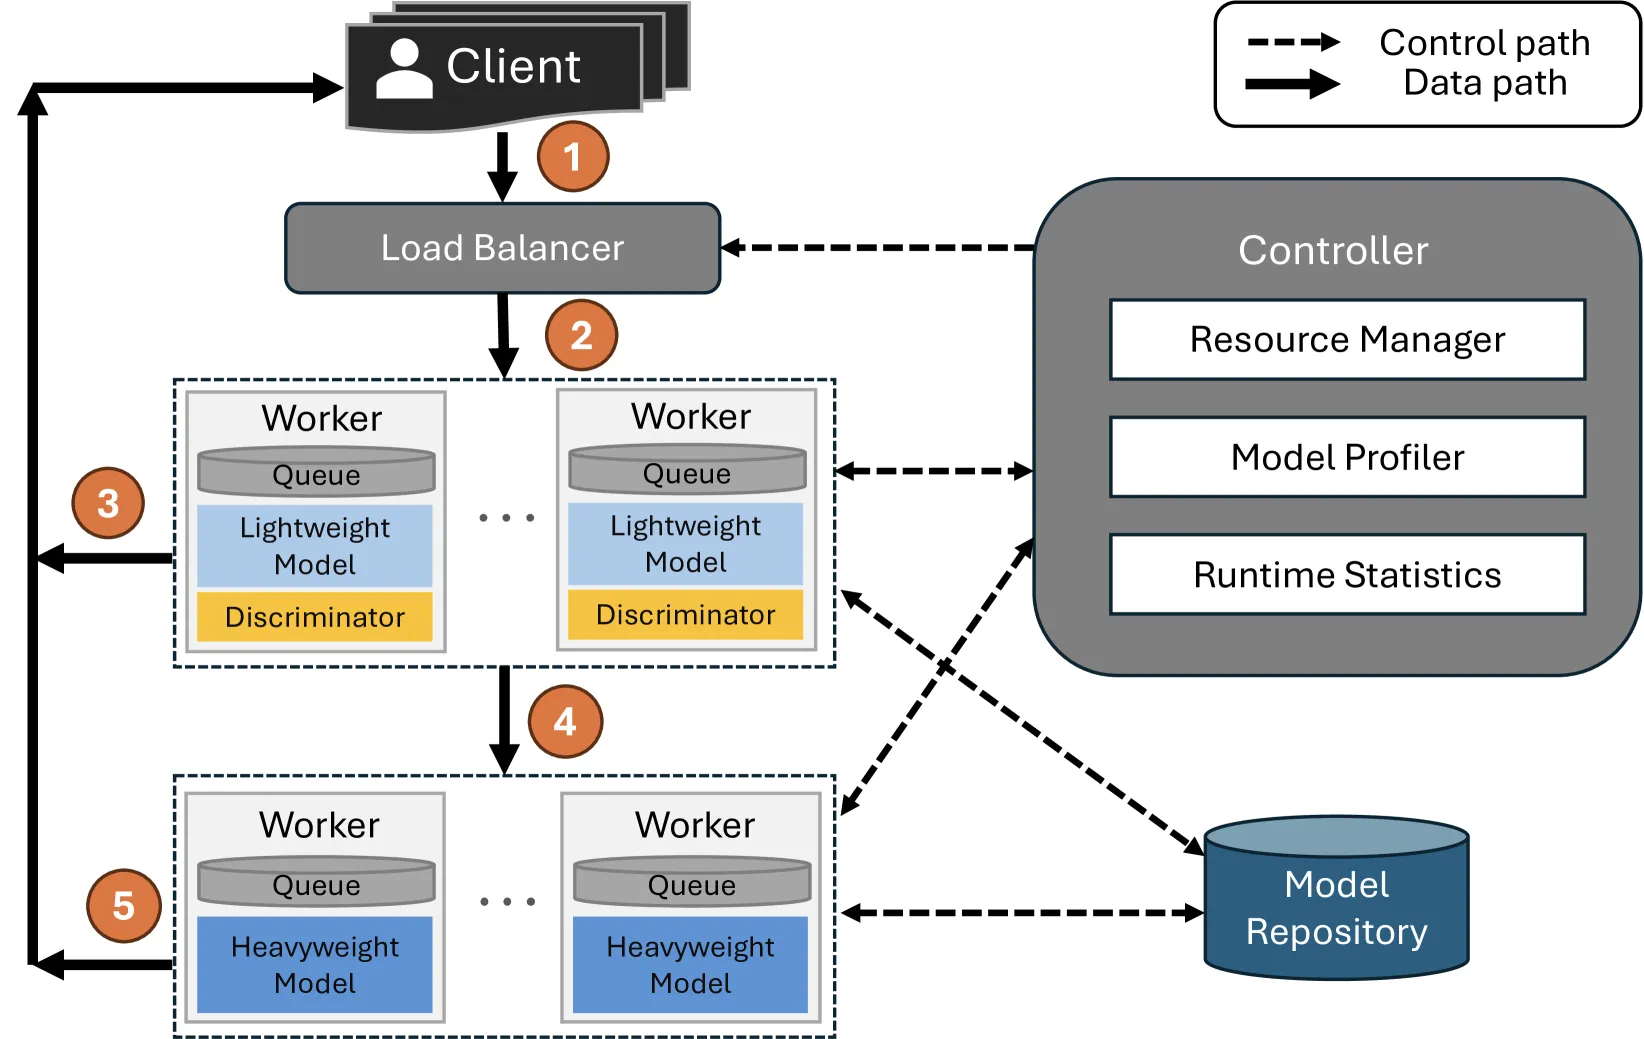
Figure 6: 测试床上的方法比较。DiffServe 在 Cascade 2 和 3 上平均 FID 降低 6%-24%。
关键结果:
- Cascade 2:平均 FID 降低 6%-24%
- Cascade 3:平均 FID 降低 8%-15%
- SLO 违规:相比基线降低 1.4×-26×
判别器比较
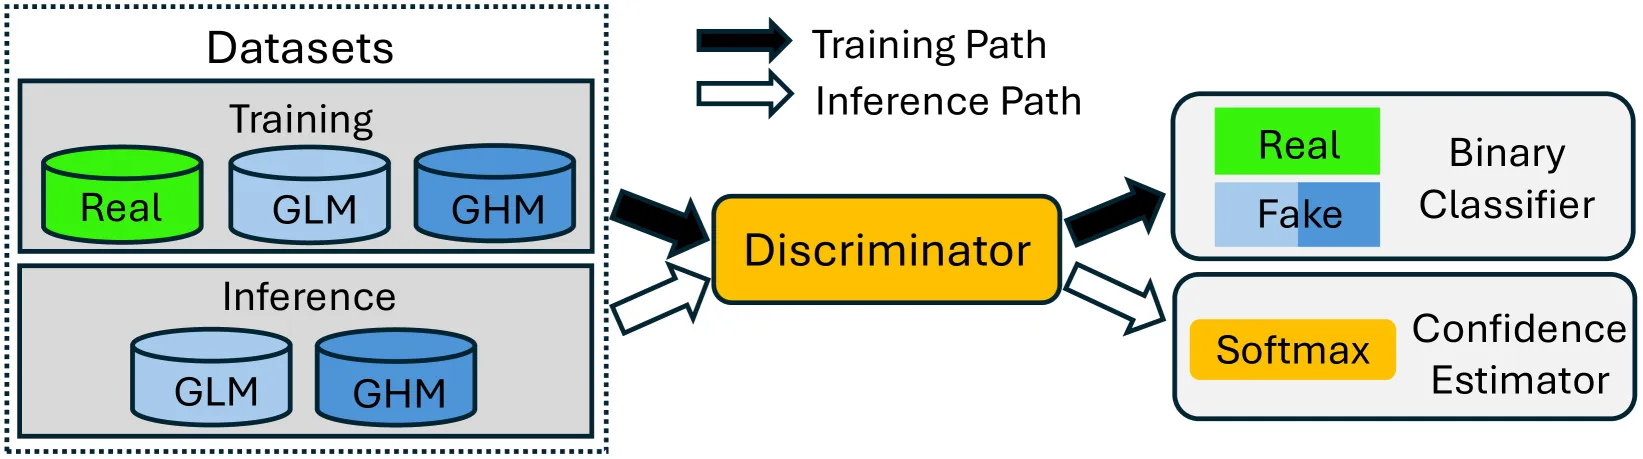
Figure 7: 判别器比较。使用真实图像训练的 EfficientNet 在给定延迟要求下实现最低 FID,优于所有替代方案。
判别器变体比较:
| 判别器 | 训练数据 | A100 延迟 | 性能 |
|---|---|---|---|
| EfficientNet w GT | 真实图像 | 10ms | 最优 |
| ResNet w GT | 真实图像 | 2ms | 次优 |
| ViT w GT | 真实图像 | 5ms | 中等 |
| EfficientNet w/o GT | 无真实图像 | 10ms | 较差 |
资源分配消融研究
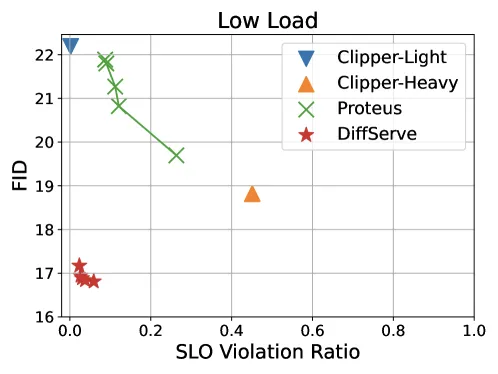
Figure 8: DiffServe 资源分配算法的性能。DiffServe 将 SLO 违规降低 20%,质量提升 19%。
消融结果:
| 变体 | 描述 | 影响 |
|---|---|---|
| Static threshold | 固定置信度阈值 | 质量损失高达 19% |
| AIMD batching | 启发式批大小调整 | SLO 违规显著增加 |
| No queuing model | 启发式排队延迟估计 | 质量损失高达 12% |
SLO 敏感性分析
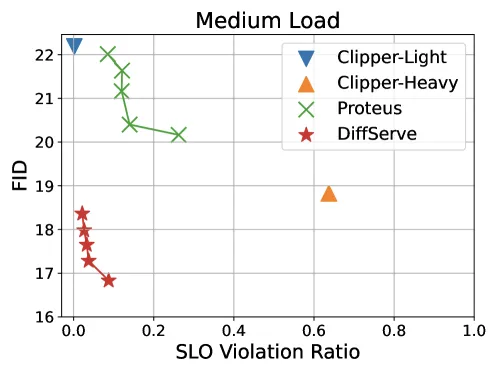
Figure 9: SLO 对性能的影响。DiffServe 在广泛 SLO 值范围内保证低 SLO 违规和高质量。
六、相关工作
模型服务系统
| 类别 | 代表系统 | 特点 |
|---|---|---|
| 通用服务 | SageMaker, Triton, TensorFlow Serving, TorchServe | 用户指定模型,系统处理资源管理 |
| 专用优化 | Clipper, Proteus | 针对特定场景优化 |
| DiffServe | - | 查询感知的模型级联 + 动态资源分配 |
级联推理
- CascadeBERT / Tabi:级联预训练语言模型,使用校准置信度分数
- 视频分类:CNN 模型级联,自适应决策
- 视觉-语言模型:级联用于高效推理
管道服务
- InferLine:通过扩展硬件最小化推理服务成本
- VideoStorm / Scrooge / Llama / Nexus:视频分析管道优化
- DiffServe 差异:专注于级联模型,同时优化质量和延迟
七、总结
主要贡献
- 查询感知模型扩展:构建扩散模型级联,优化服务效率
- 对抗训练判别器:利用 ML 模型区分真实/生成图像,实现准确的查询路由
- MILP 资源分配:将资源配置问题形式化为混合整数线性规划
- 端到端系统实现:在 DiffServe 中实现并验证所有技术
关键优势
| 优势 | 量化指标 |
|---|---|
| 质量提升 | 高达 24% FID 改善 |
| SLO 违规降低 | 19-70% 低于基线 |
| 动态适应 | 响应需求波动,非峰值质量提升高达 23.4% |
| 系统开销低 | MILP 求解约 10ms,判别器推理约 10ms |
| 可扩展性 | 可扩展到更长管道和更高分辨率 |
局限性与未来工作
- 中间输出重用:轻量模型输出可作为重量模型的起点,但引入额外复杂性
- 预测性路由器:基于查询文本直接路由(无需先执行轻量模型)仍有挑战
- 多级级联:当前主要验证两级级联,更长管道需要更多研究
八、参考资源
论文与代码
- 论文:arXiv:2411.15381
- HTML 版本:arXiv HTML
- 代码仓库:GitHub - DiffServe
- DOI:10.5281/zenodo.14984970
关键模型与数据集
| 模型/数据集 | 用途 |
|---|---|
| SD-Turbo | 轻量扩散模型(1 步推理) |
| SDXS | 轻量扩散模型(减少通道和步骤) |
| LCM-LoRA | 轻量扩散模型(LoRA 微调) |
| SDv1.5 / SDXL | 重量扩散模型 |
| EfficientNet | 判别器架构 |
| MS-COCO 2017 | 评估数据集 |
| DiffusionDB | 评估数据集 |
相关工具
- HuggingFace Diffusers:扩散模型推理框架
- Gurobi:MILP 求解器
- NVIDIA A100:实验 GPU 硬件
实验复现
硬件要求:
- CPU 服务器:10 核心,16G RAM(控制器、负载均衡器等)
- GPU 服务器:多个 A100-40G/80G 或 L40s(至少 4 个,论文使用 16 个)
软件要求:
- Linux OS
- Conda 环境 (Python 3.8)
- 约 15GB 磁盘空间下载模型
运行时间:
- 准备时间:约 30 分钟
- 每个级联管道实验:约 10 分钟
引用信息
@article{ahmad2024diffserve,
  title={DiffServe: Efficiently Serving Text-to-Image Diffusion Models with Query-Aware Model Scaling},
  author={Ahmad, Sohaib and Yang, Qizheng and Wang, Haoliang and Sitaraman, Ramesh K. and Guan, Hui},
  journal={arXiv preprint arXiv:2411.15381},
  year={2024}
}