MoE-Lightning: High-Throughput MoE Inference on Memory-constrained GPUs
基于CPU-GPU-I/O流水线调度的高吞吐量MoE推理系统
MoE-Lightning: High-Throughput MoE Inference on Memory-constrained GPUs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MoE-Lightning: High-Throughput MoE Inference on Memory-constrained GPUs |
| 作者 | Shiyi Cao, Shu Liu, Tyler Griggs, Peter Schafhalter, Xiaoxuan Liu, Ying Sheng, Joseph E. Gonzalez, Matei Zaharia, Ion Stoica |
| 机构 | UC Berkeley, Stanford |
| 论文 | arXiv:2411.11217 |
| 代码 | - |
| 发布 | 2024-11-18 |
| 领域 | 分布式计算 (cs.DC), 人工智能 (cs.AI), 机器学习 (cs.LG) |
二、核心思想
问题定义
Mixture of Experts (MoE) 模型通过稀疏激活的专家子网络来提升模型容量,无需成比例增加推理计算量。然而,MoE 模型的内存需求巨大——例如 Mixtral 8x22B 的专家 FFN 参数需要超过 256 GB 内存,是同等 FLOPs 密集模型的 4-5 倍。这使得 MoE 模型在没有高端 GPU 的情况下难以部署。
解决方案概述
MoE-Lightning 提出了一种高吞吐量的 MoE 批量推理系统,核心创新包括:
- CGOPipe:一种新颖的 CPU-GPU-I/O 流水线调度策略,通过分页权重实现高资源利用率
- HRM (Hierarchical Roofline Model):一种基于层次化屋顶模型的性能模型,帮助找到比现有系统更高吞吐量的调度策略
核心结果:在单个 T4 GPU (16GB) 上,MoE-Lightning 实现了比最先进 offloading 系统高达 10.3× 的吞吐量提升,且仅需 2-3× 更少的 CPU 内存即可达到理论吞吐量上限。
三、技术架构
MoE 模型架构
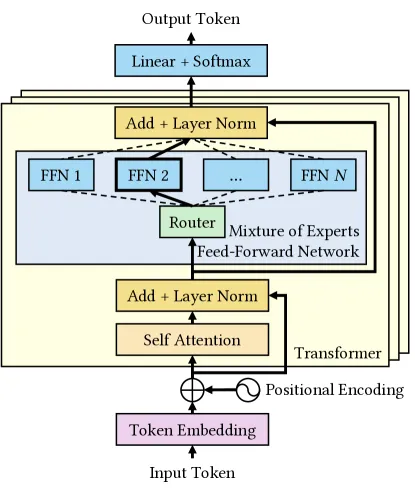
MoE 模型在 Transformer 层中将标准 FFN 替换为多个专家 FFN,通过门控网络选择 top-k 个专家处理每个 token。这种设计允许模型在不增加推理计算量的情况下扩展参数规模。
层次化屋顶模型 (HRM)
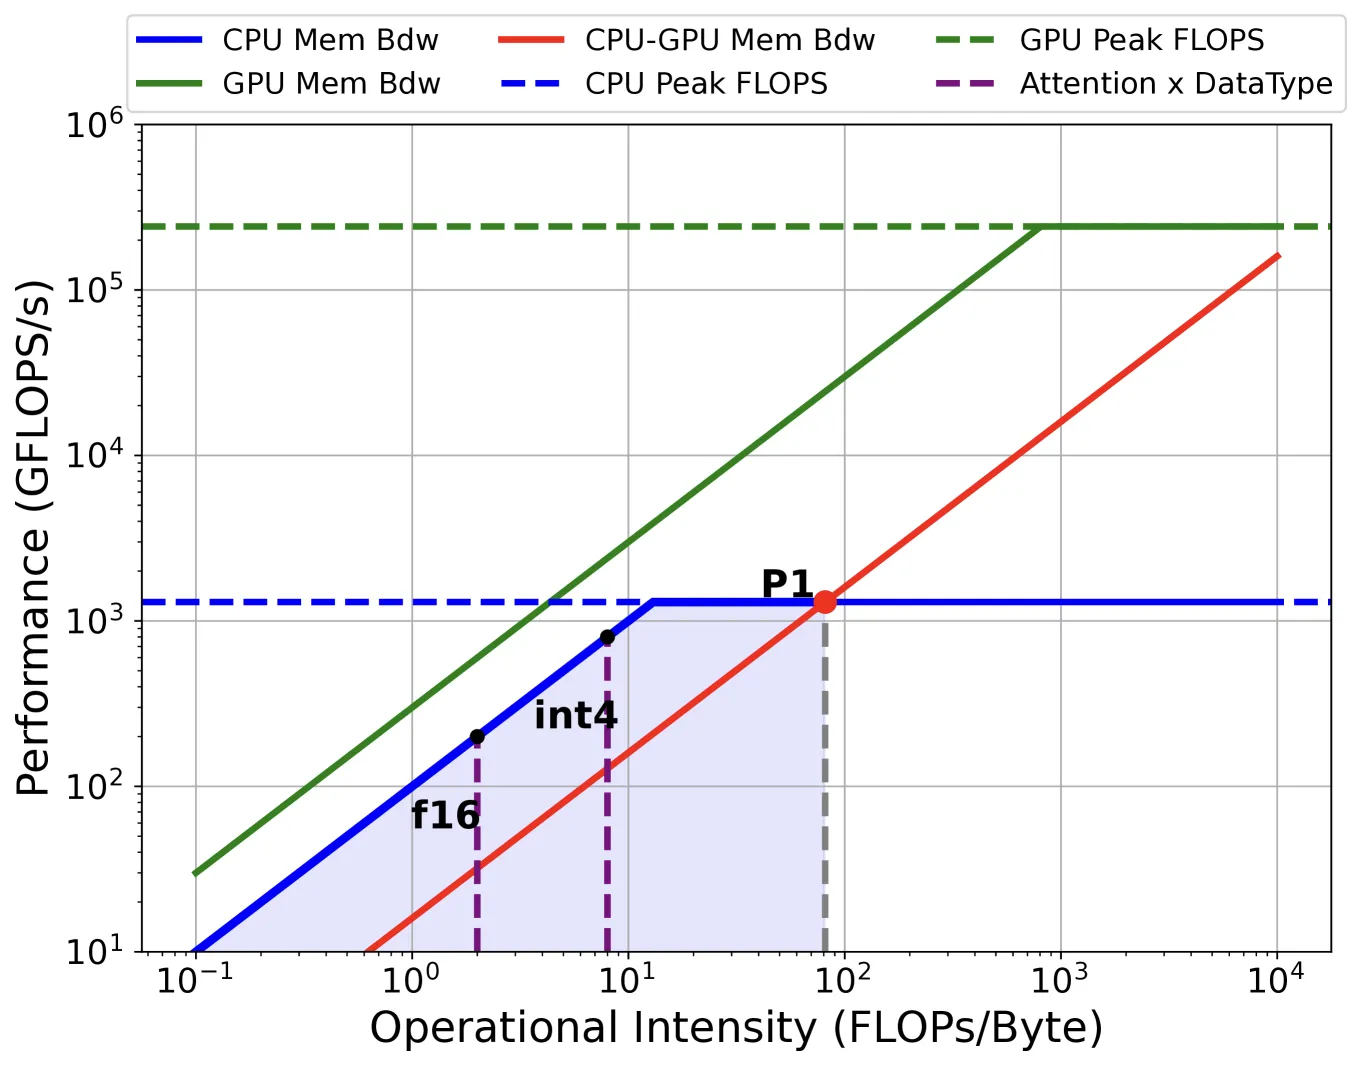
HRM 是对经典屋顶模型的扩展,用于分析多级内存层次结构下的性能瓶颈。
经典屋顶模型公式:
- 内存上限:P ≤ B_peak × I (Eq. 1)
- 计算上限:P ≤ P_peak (Eq. 2)
- 转折点:I̅ = P_peak / B_peak (Eq. 3)
HRM 三层性能约束:
对于计算任务 x 在内存层级 i 上执行,数据来自层级 j:
- 计算上限:P_x^i ≤ P_peak^i (Eq. 4)
- 内存上限 (本级):P_x^i ≤ B_peak^i × I_x^i (Eq. 5)
- 内存上限 (跨级):P_x^i ≤ B_peak^{j,i} × I_x^j (Eq. 6)
综合性能上限:
关键转折点:
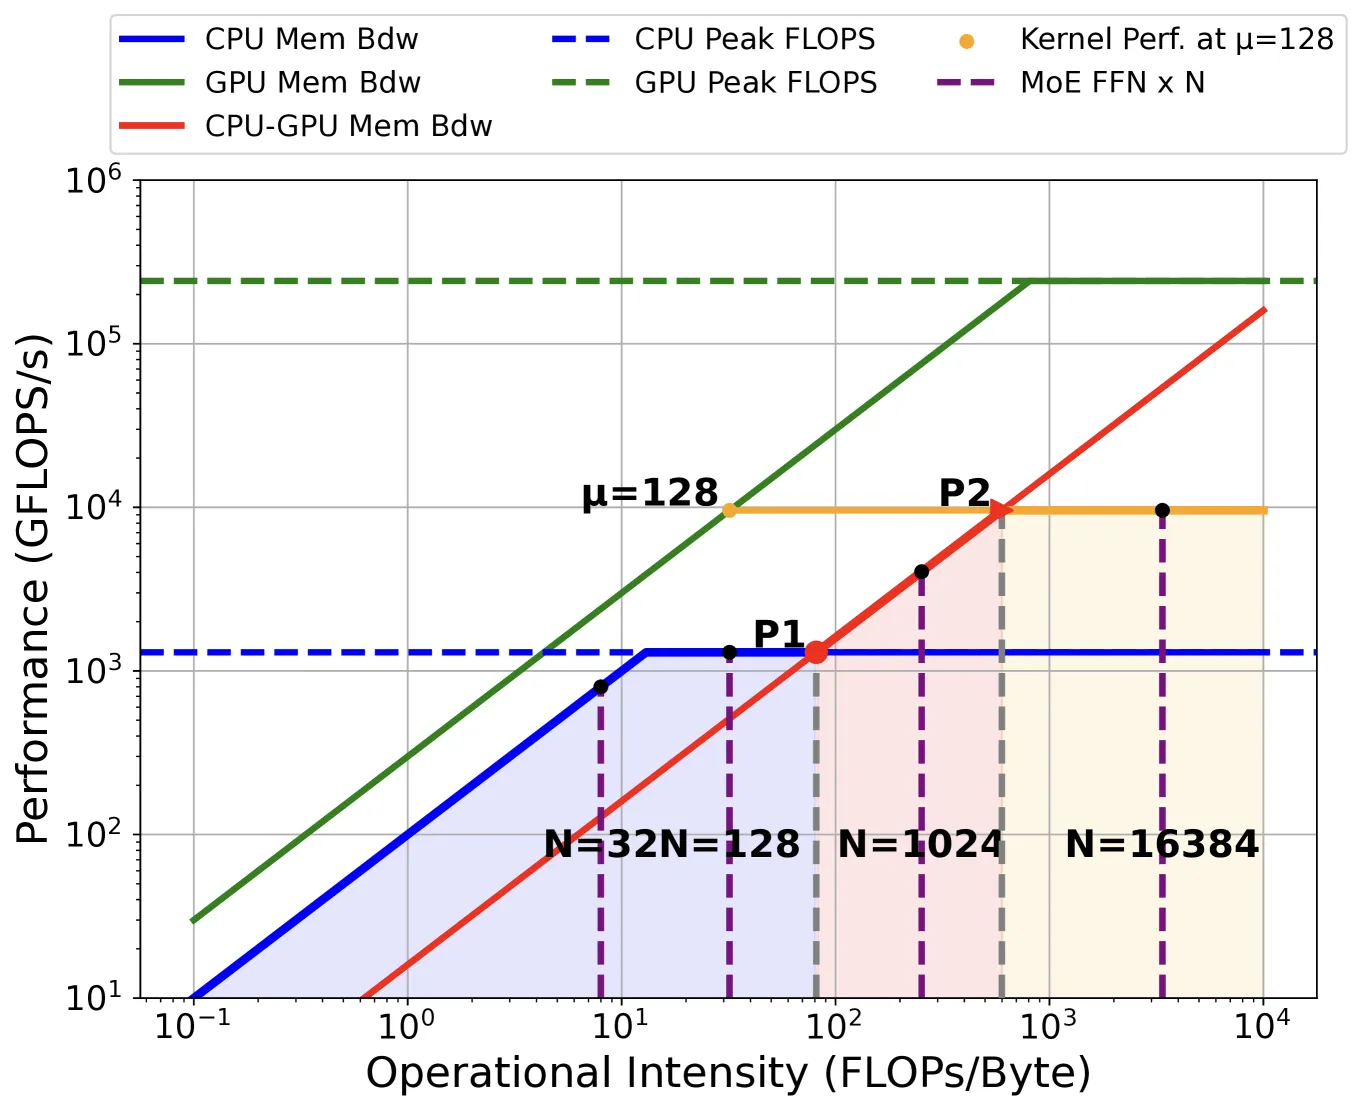
- P1 (Eq. 9):I̅_x^j = min(P_peak^j, B_peak^j × I_x^j) / B_peak^{j,i} — 低于此值时,从层级 j 传输数据到 i 不划算
- P2 (Eq. 10):I̅_x^j = min(P_peak^i, B_peak^i × I_x^i) / B_peak^{j,i} — 低于此值时,计算受限于 CPU-to-GPU 带宽
- 平衡点 (Eq. 11):B_peak^i × I_x^i = B_peak^{j,i} × I_x^j — 达到峰值性能的条件
关键发现:
- Attention 操作强度与 batch size 无关,GQA 的操作强度较低,建议在 CPU 上执行 attention
- MoE FFN 操作强度随 batch/micro-batch size 增加(更多计算 per 权重访问)
CGOPipe 流水线调度
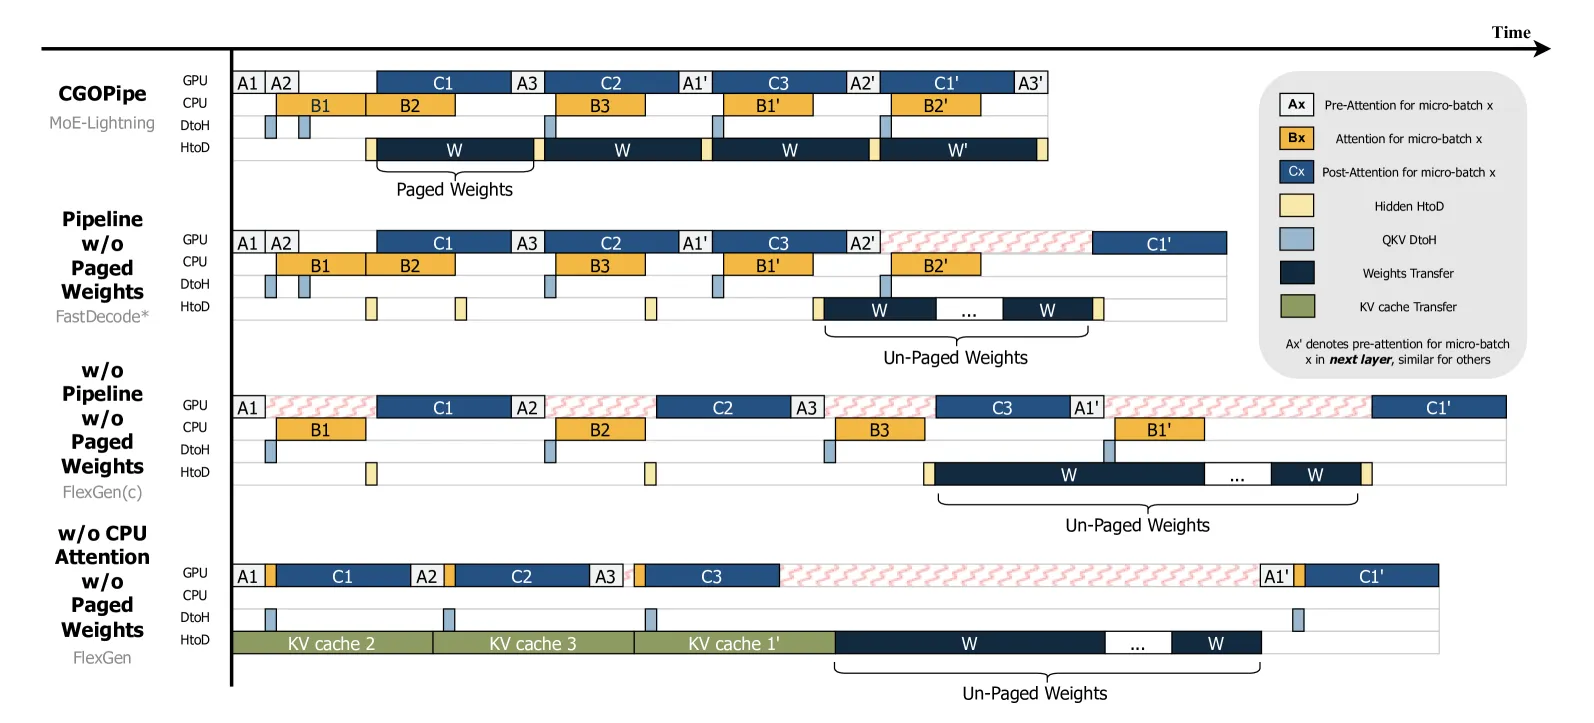
CGOPipe 的核心设计包括:
CPU Attention:根据 HRM 分析,将 attention 计算放在 CPU 上执行更高效。
权重分页方案:将权重分块为 n 个页面(n = micro-batch 数量),交错传输中间结果和分页权重。
四种数据传输类型:
| 传输 | 方向 | 说明 |
|---|---|---|
| D1 (QKV DtoH) | GPU→CPU | QKV 投影后的中间结果 |
| D2 (Hidden HtoD) | CPU→GPU | CPU attention 后的隐藏状态 |
| D3 (Weights) | CPU→GPU | 下一层的权重 |
| D4 (KV Cache) | CPU→GPU | 下一个 micro-batch 的 KV cache |
关键洞察:将权重分块为 n 页并交错传输,避免 D2 长时间阻塞,显著提高 I/O 利用率。
内存管理
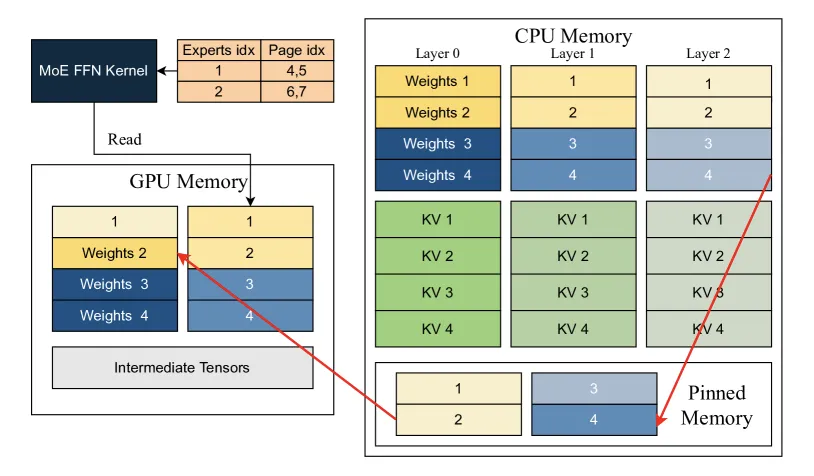
- 使用 2× sizeof(W_L) 的权重缓冲区实现权重预取重叠
- 通过 pinned memory 进行权重传输
- 请求按输入长度降序排列,分配到 micro-batch 时将最长请求放入 token 数最少的 micro-batch
硬件配置
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| CGOPipe | CPU-GPU-I/O 流水线调度,权重分页交错传输 | 消除流水线气泡,提高 I/O 利用率 |
| HRM | 层次化屋顶模型,扩展经典 Roofline 到多级内存 | 近零开销支持不同模型/硬件/工作负载 |
| CPU Attention | 将 attention 计算放在 CPU 上执行 | GQA 操作强度低,CPU attention 比 KV cache 传输快 3-4× |
| 自适应策略搜索 | 基于 HRM 的 MILP 优化,离线生成最优策略 | 不到一分钟生成策略,适应不同硬件配置 |
五、实验结果
实验设置
- 模型:Mixtral 8x7B, Mixtral 8x22B, DBRX
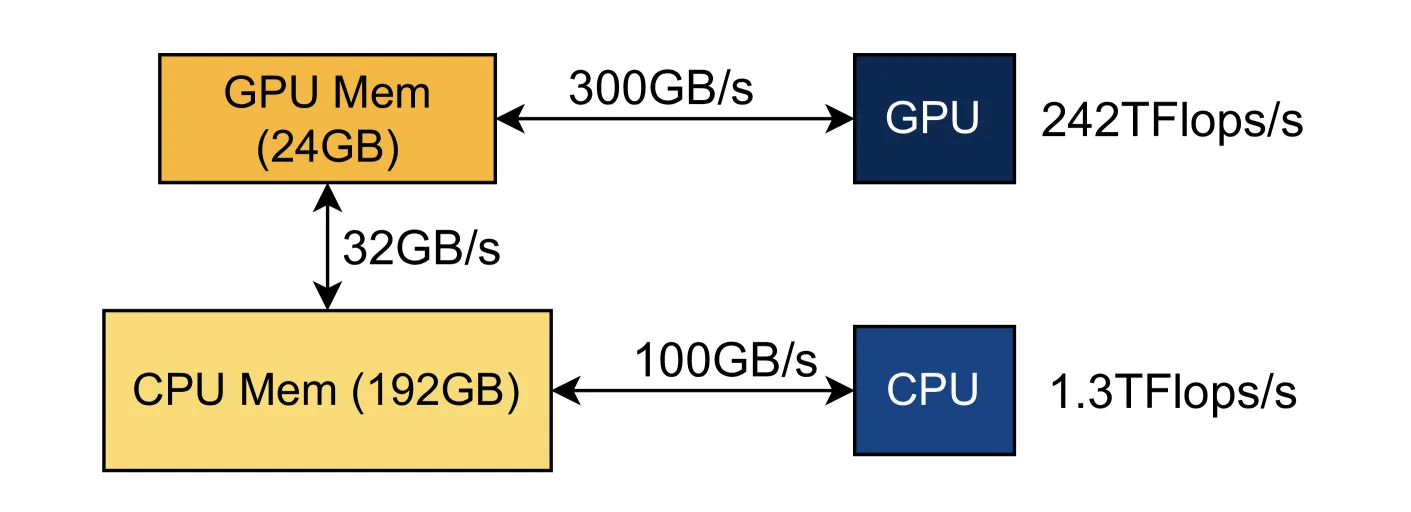
- 硬件:L4, T4, 2×T4, 4×T4 GPU
- 基线:FlexGen, FlexGen(c) (带 CPU attention), DeepSpeed Zero-Inference
- 工作负载:MTBench, HELM benchmark, synthetic reasoning
端到端结果
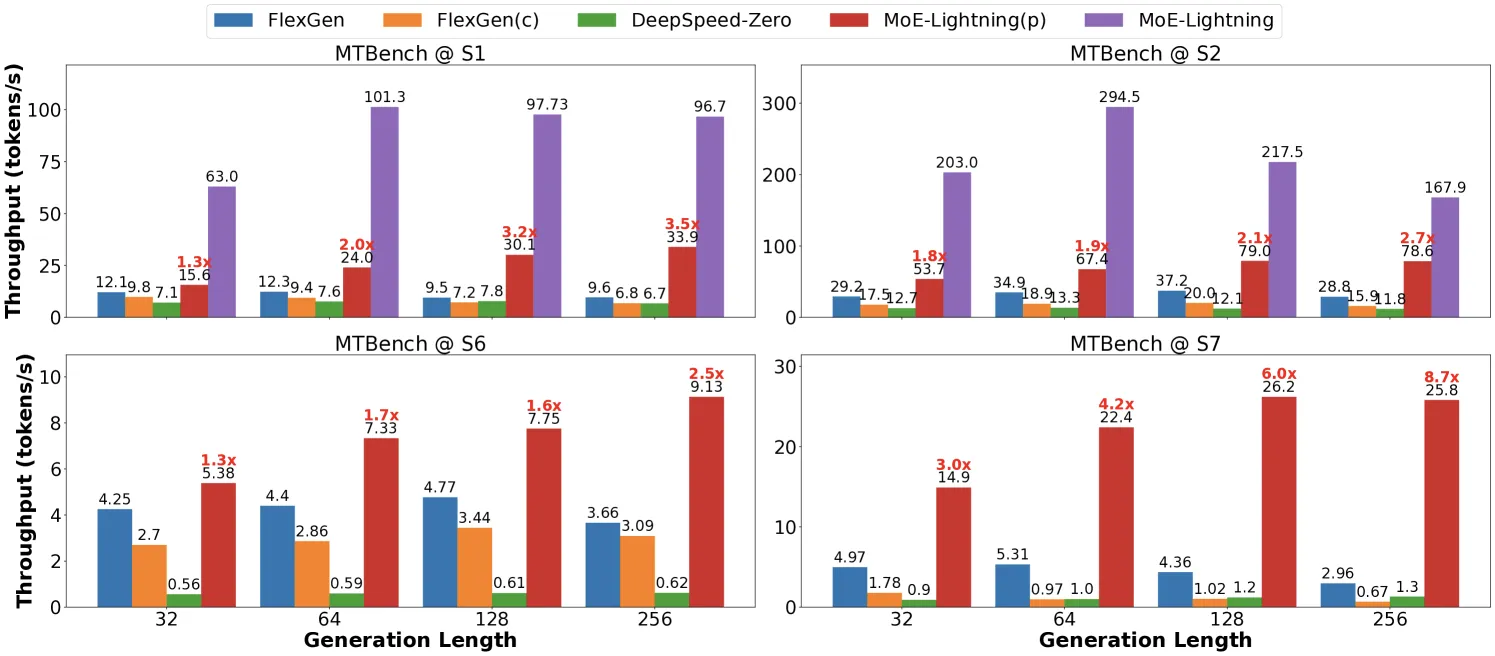
| 指标 | MoE-Lightning vs 基线 |
|---|---|
| 单 GPU 吞吐量提升 (无 padding) | 10.3× |
| 单 GPU 吞吐量提升 (有 padding) | 3.5× |
| vs FlexGen | 3.5× |
| vs FlexGen(c) | 5× |
| vs DeepSpeed | 6.7× |
MoE-Lightning 在长生成长度下避免了吞吐量下降,得益于 CGOPipe 的高效资源利用。
张量并行扩展
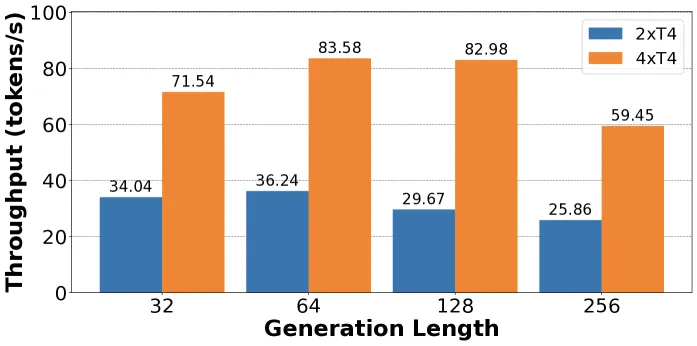
| 配置 | 吞吐量提升 |
|---|---|
| 4×T4 vs 2×T4 | 2.77-3.38× (超线性扩展) |
| DBRX 2→4 GPU | 2.1-2.8× |
- DeepSpeed 展示线性扩展但 batch size 较小
- FlexGen 因 pipeline parallelism 增加 CPU 峰值内存而无法扩展
DBRX 结果
- 2 GPU → 4 GPU:2.1-2.8× 提升
- 无 request padding 时系统不再受限于 GPU 内存容量
六、消融实验
优化器策略对比
| 配置 | μ | N | 吞吐量 (token/s) | 提升 |
|---|---|---|---|---|
| FlexGen (原始策略) | 8 | 1112 | 9.5 | 1× |
| FlexGen (MoE-Lightning 策略) | 36 | 504 | 16.816 | 1.77× |
| FlexGen (策略 + 更大 N) | 36 | 1116 | 20.654 | 2.17× |
| MoE-Lightning (pipeline) | 36 | 504 | 30.12 | 3.17× |
CPU Attention vs MoE FFN vs KV 传输
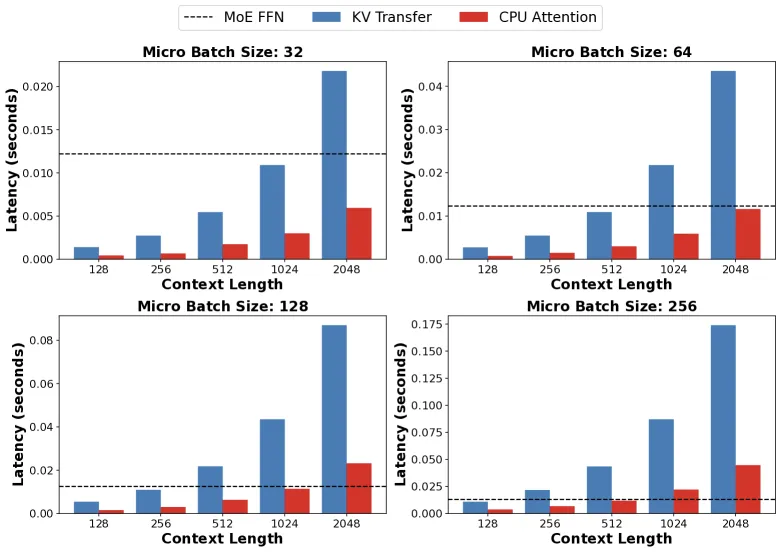
- CPU attention kernel 比 KV cache 传输快 3-4×
- MoE FFN 延迟在不同 micro-batch size 下变化不大(decode 阶段为内存受限)
- 随着 micro-batch size 和上下文长度增加,CPU attention 最终成为瓶颈
策略随硬件变化
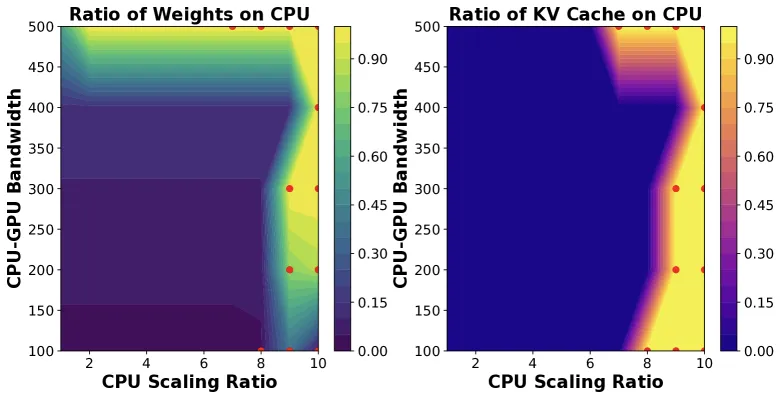
- 在 2×A100-80G 上运行 Mixtral 8x7B 时,随 CPU-to-GPU 带宽增加,更多权重被 offload 到 CPU
- KV cache offloading 与 CPU 缩放比例相关
七、相关工作
| 方法 | 特点 | MoE-Lightning 优势 |
|---|---|---|
| FlexGen | GPU-CPU offloading,固定策略 | 自适应策略搜索,10.3× 吞吐量 |
| DeepSpeed Zero-Inference | 分布式推理 | 单 GPU 更高效,超线性扩展 |
| MoE-I2 (2411.01016) | 专家间剪枝 + 低秩分解 | 无需修改模型,即插即用 |
| FineMoE (2502.05370) | 专家 offloading + Expert Map | 无需语义搜索,纯系统优化 |
八、总结
核心贡献
- CGOPipe:CPU-GPU-I/O 流水线调度策略,通过权重分页实现高资源利用率
- HRM:层次化屋顶模型,支持不同模型/硬件/工作负载的性能分析
- 深入的性能分析:识别 MoE 模型在不同场景下的性能瓶颈区域
技术影响
- 使 MoE 模型在消费级 GPU 上变得可访问
- 为 LLM 推理系统的性能建模提供了新的理论框架
- 启发了 CPU-GPU 异构计算的调度策略设计
局限性
- 主要针对离线批量推理场景,未针对在线服务优化
- 需要离线运行 MILP 优化器生成策略
- 未考虑动态负载变化的在线适应
九、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 吞吐量 vs CPU 内存对比 | results-throughput-memory.png |
| Figure 2 | MoE 架构图 | moe-architecture.png |
| Figure 3 | L4 硬件配置 | hardware-config-l4.png |
| Figure 4 | HRM - GQA Attention 分析 | hrm-gqa-attention.png |
| Figure 5 | HRM - MoE FFN 分析 | hrm-moe-ffn.png |
| Figure 6 | 调度策略对比 | scheduling-strategies.png |
| Figure 7 | 端到端实验结果 | end-to-end-results.png |
| Figure 8 | 张量并行扩展 | tensor-parallelism.png |
| Figure 9 | 延迟对比分析 | latency-comparison.png |
| Figure 10 | 策略随硬件变化 | policy-changes.png |
| Figure 11 | 内存管理示意 | memory-management.png |