SageAttention2: Efficient Attention with Thorough Outlier Smoothing and Per-thread INT4 Quantization
使用 INT4 线程级量化和 FP8 矩阵乘加速注意力计算,配合 Q+K 平滑与两级累加策略保持精度
SageAttention2: Efficient Attention with Thorough Outlier Smoothing and Per-thread INT4 Quantization
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SageAttention2: Efficient Attention with Thorough Outlier Smoothing and Per-thread INT4 Quantization |
| 作者 | Jintao Zhang*, Haofeng Huang*, Pengle Zhang, Jia Wei, Jun Zhu, Jianfei Chen (* 同等贡献) |
| 机构 | Tsinghua University |
| 论文 | arXiv:2411.10958 |
| 代码 | https://github.com/thu-ml/SageAttention |
| 发表 | ICML 2025 |
| 发布 | 2024-11-17 (v1), 2025-10-01 (v7) |
二、核心思想
问题定义
量化在 Transformer 的线性层中已被广泛应用,但在注意力计算中的加速应用仍然有限。SageAttention 将 量化为 INT8、 使用 FP16 累加器,存在两个局限:
- W1: INT8 Matmul 的速度仅为 INT4 的一半
- W2: FP16 累加器仅在 RTX 4090/3090 上提供加速,在其他 GPU(L20、H100 等)上无效
解决方案概述
SageAttention2 的核心方案是将 量化为 INT4、 量化为 FP8 (E4M3),并提出三项精度增强技术:
- Q+K 平滑:消除 Q 和 K 中的通道异常值,使 INT4 量化更准确
- 线程级 INT4 量化:基于 PTX MMA 指令内存布局,每个 GPU 线程对应一个量化尺度,精度接近 token 级量化但无额外开销
- 两级累加策略:发现 FP8 矩阵乘的 FP32 累加器实际只有 22 位有效精度(FP22),使用 FP32 缓冲区累积 FP22 结果以恢复精度
两种变体
| 变体 | Q,K 量化 | , V 量化 | 适用平台 |
|---|---|---|---|
| SageAttn2-4b | INT4 per-thread | FP8 per-block/channel | RTX4090, L20, A100 等 |
| SageAttn2-8b | INT8 per-thread | FP8 per-block/channel | Hopper (H100/H20) 等无 INT4 Tensor Core 的平台 |
三、技术架构
整体工作流
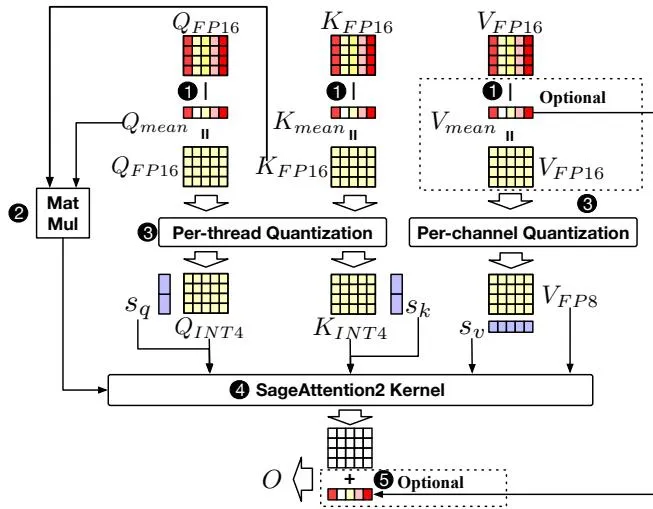
流程步骤:① 平滑 Q, K, V → ② GEMV 计算 → ③ 线程级量化 Q,K 和通道级量化 V → ④ 执行 SageAttention2 kernel → ⑤ 校正输出
核心公式
Q+K 平滑(Equation 2):
其中 、 是沿 token 维度的均值。
平滑后的 分解:
其中 通过 GEMV 计算, 是 softmax 不变偏置。
线程级量化(Equation 8):
基于 PTX mma.m16n8k64 指令的内存布局:
- 共享一个量化尺度
- 和 共享一个量化尺度
这使得每个 GPU 线程在反量化时仅使用单个尺度值,避免了 per-token 量化的向量点积开销。
FP8 量化 :
由于 ,使用静态尺度 量化到 E4M3。V 按通道量化以应对通道异常值。
FP22 累加器修复(两级累加):
R_ij = Matmul_FP8(P_ij_quantized, V_j_quantized)  // FP22 精度
O_ij = diag(exp(m_{i,j-1} - m_{ij})) * O_{i,j-1} + R_ij  // FP32 累加
R_ij 在寄存器中以 FP22 精度计算(对小批量 足够),然后以 FP32 高精度累积到 O_ij。
可选 V 平滑:
当 V 存在通道偏差时:,最终输出 。因为 每行和为 1,所以 。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Q+K Smoothing | 减去 Q 和 K 的 token 维度均值 | 消除异常值,提升 INT4 精度 |
| Per-thread Quantization | 基于 PTX MMA 内存布局的量化分组 | 32× 和 4× 于 per-block 更细粒度 |
| FP8 E4M3 for | 静态尺度量化 | |
| Per-channel FP8 for V | 按通道量化 V 应对异常值 | 每通道独立尺度 |
| Two-level Accumulation | FP22 MMA + FP32 缓冲 | 修复 FP22 精度损失 |
| Optional V Smoothing | 减去 V 的通道均值 | 仅在 V 有通道偏差时有效 |
前向传播算法(Algorithm 1)
预处理: K = K - mean(K), (δ_V, V̂) = ψ_V(V)   // 按通道
分割 Q 为 T_m 个块 {Q_i}; 分割 K,V 为 T_n 个块 {K_j},{V_j}
for i = 1 to T_m do
    q̄_i = mean(Q_i), (δ_Q, Q̂_i) = ψ_Q(Q_i - q̄_i)  // 线程级
    for j in [1, T_n] do
        (δ_K, K̂_j) = ψ_K(K_j)  // 线程级
        S_ij = Matmul_INT4(Q̂_i, K̂_j) + GEMV(q̄_i, K̂_j^T)  // INT4 + FP8
        m_ij, P̃_ij, l_ij = OnlineSoftmax(...)
        O_ij(FP22) = Matmul_FP8(P̃_ij*448, V̂_j)
        O_ij(FP32) = diag(exp(...)) * O_{i,j-1}(FP32) + O_ij(FP22)
    end for
    O_i = O_{i,T_n}(FP32) / 448 * δ_V / l_i,T_n
end for
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| Q+K 联合平滑 | SageAttention 仅平滑 K,本文发现 Q 也有显著异常值,联合平滑 CosSim 从 98% 提升到 99.46% | Table 4, CogvideoX 全层平均 |
| INT4 线程级量化 | 首次将注意力量化到 INT4,利用 PTX MMA 内存布局实现 token 级精度无额外开销 | Table 6, CosSim 99.45% vs per-block 98.03% |
| FP8 用于 | 替代 SageAttention 的 FP16,Tensor Core 速度翻倍 | Table 7, E4M3 CosSim 99.44% vs FP16 99.45% |
| 发现 FP22 累加器 | 首次发现 NVIDIA mma.f32.f8.f8.f32 的 FP32 累加器实际只有 22 位有效精度 | 实验验证:1 sign + 8 exp + 13 mantissa |
| 两级累加策略 | 用 FP32 缓冲区累积 FP22 结果,将误差限制在 block 范围内 | 首次将两级累加应用于注意力计算 |
五、实验结果
端到端指标对比(Table 2)
文本生成 — Llama3.1 (8B)
| 方法 | WikiText↓ | Lambda↑ | MMLU↑ | Longbench↑ |
|---|---|---|---|---|
| Full-Precision | 6.013 | 0.815 | 0.635 | 49.40 |
| SageAttention | 6.017 | 0.812 | 0.634 | 49.55 |
| SageAttn2-4b | 6.256 | 0.798 | 0.607 | 48.79 |
| SageAttn2-8b | 6.019 | 0.811 | 0.634 | 49.59 |
SageAttn2-8b 几乎零损失,SageAttn2-4b 有微小降级但仍远优于其他基线。
视频生成 — CogvideoX (1.5-5B)
| 方法 | CLIPSIM↑ | CLIP-T↑ | VQA-a↑ | VQA-t↑ | FScore↑ |
|---|---|---|---|---|---|
| Full-Precision | 0.1778 | 0.9979 | 70.231 | 70.928 | 2.507 |
| FlashAttn3-fp8 | 0.1562 | 0.9918 | 6.531 | 2.181 | ✘ |
| SageAttn2-4b | 0.1721 | 0.9978 | 57.729 | 52.989 | 2.884 |
| SageAttn2-8b | 0.1775 | 0.9980 | 69.492 | 74.415 | 2.487 |
FlashAttn3(fp8) 在视频生成上完全失败(FScore 为 ✘),而 SageAttn2-8b 几乎无损。
图像生成 — Flux (schnell)
| 方法 | FID↓ | sFID↓ | CLIP↑ | IR↑ |
|---|---|---|---|---|
| Full-Precision | 10.960 | 16.648 | 26.180 | 1.009 |
| SageAttention | 10.944 | 16.641 | 26.171 | 1.008 |
| SageAttn2-4b | 10.577 | 17.497 | 26.141 | 0.998 |
| SageAttn2-8b | 10.927 | 16.723 | 26.175 | 1.009 |
SageAttn2-4b 在 FID 上甚至优于全精度!
内核速度对比(Figure 5)
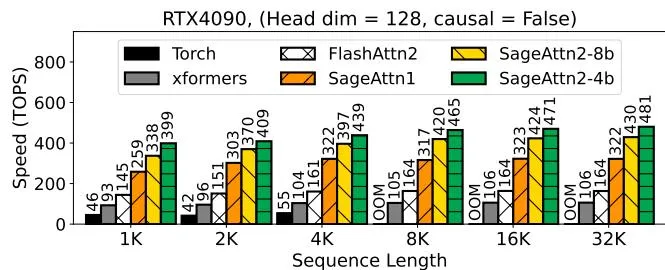
RTX4090 (head_dim=128):
- SageAttn2-4b 比 FlashAttention2 快约 3×,比 xformers 快约 4.5×
- SageAttn2-8b 比 FlashAttention2 快约 2.7×,比 xformers 快约 4×
- 峰值 481 TOPS (RTX4090)
多 GPU 加速比汇总(Table 9):
| 方法 | 3090 | 4090 | A100 | L40 | L20 | H100 | H20 |
|---|---|---|---|---|---|---|---|
| FlashAttention2 | 1.00× | 1.00× | 1.00× | 1.00× | 1.00× | 1.00× | 1.00× |
| SageAttention1 | 1.97× | 1.96× | 1.37× | 1.45× | 1.24× | 1.53× | 1.52× |
| SageAttention2 | ✘ | 2.93× | ✘ | 2.60× | 2.46× | 2.61× | 3.12× |
精度分析
不同平滑方法(Table 4):
| 方法 | CosSim↑ | Relative L1↓ | RMSE↓ |
|---|---|---|---|
| None | 80.04% | 0.3906 | 0.2223 |
| Smooth K | 98.07% | 0.1493 | 0.0743 |
| Smooth Q | 98.30% | 0.1250 | 0.0712 |
| Smooth Q+K | 99.46% | 0.0648 | 0.0334 |
不同量化粒度(Table 6):
| 方法 | CosSim↑ | Relative L1↓ | RMSE↓ |
|---|---|---|---|
| Per-token | 99.45% | 0.0649 | 0.0335 |
| Per-thread | 99.45% | 0.0622 | 0.0313 |
| Per-block | 98.03% | 0.1492 | 0.0744 |
| Per-tensor | 97.15% | 0.1800 | 0.0865 |
Per-thread 精度与 per-token 几乎相同,且远优于 per-block。
不同数据类型(Table 7):
| CosSim↑ | Relative L1↓ | RMSE↓ | |
|---|---|---|---|
| INT8 | 77.05% | 0.5618 | 0.5044 |
| E5M2 | 99.20% | 0.0905 | 0.0903 |
| E4M3 | 99.44% | 0.0683 | 0.0347 |
| FP16 | 99.45% | 0.0649 | 0.0335 |
E4M3 精度与 FP16 非常接近。
端到端延迟(Table 8)
| 模型 | GPU | 原始 | SageAttn2-8b | SageAttn2-4b |
|---|---|---|---|---|
| CogvideoX (2B) | RTX4090 | 86s | 54s | 52s |
| CogvideoX (1.5-5B) | RTX4090 | 1040s | 577s | 555s |
| HunyuanVideo | L20 | 2221s | 1486s | 1435s |
| Mochi | L20 | 2336s | 1316s | 1190s |
| Llama3.1 (48K) | RTX4090 | 9.2s | 5.7s | 5.6s |
| Llama3.1 (100K) | L20 | 39.9s | 25.4s | 23.2s |
技术开销分析(Table 18)
| 技术 | TOPS | 开销 |
|---|---|---|
| 基础 Attention (INT4+FP8) | 284 | — |
| + Per-thread quantization | 283 | 0.35% |
| + Two-level accumulation | 283 | 0% |
| + Smoothing Q | 273 | 3.7% |
三项技术的总开销仅约 4%,可忽略不计。
长上下文实验(Table 14, Figure 19)
在 Llama-3-262k (8B) 上,序列长度达 262K tokens:
- SageAttention2 在 InfiniBench 所有子任务上保持全精度性能
- FlashAttention3(fp8) 在 Retr.KV 任务上从 0.4→7.0 大幅下降
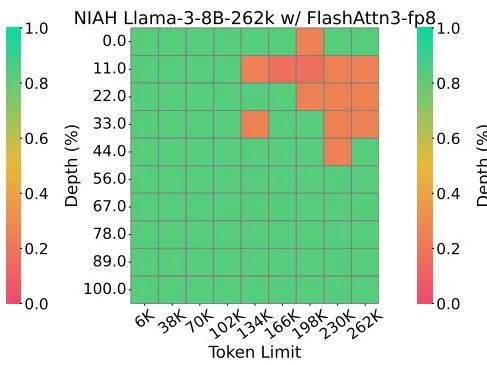
可视化对比
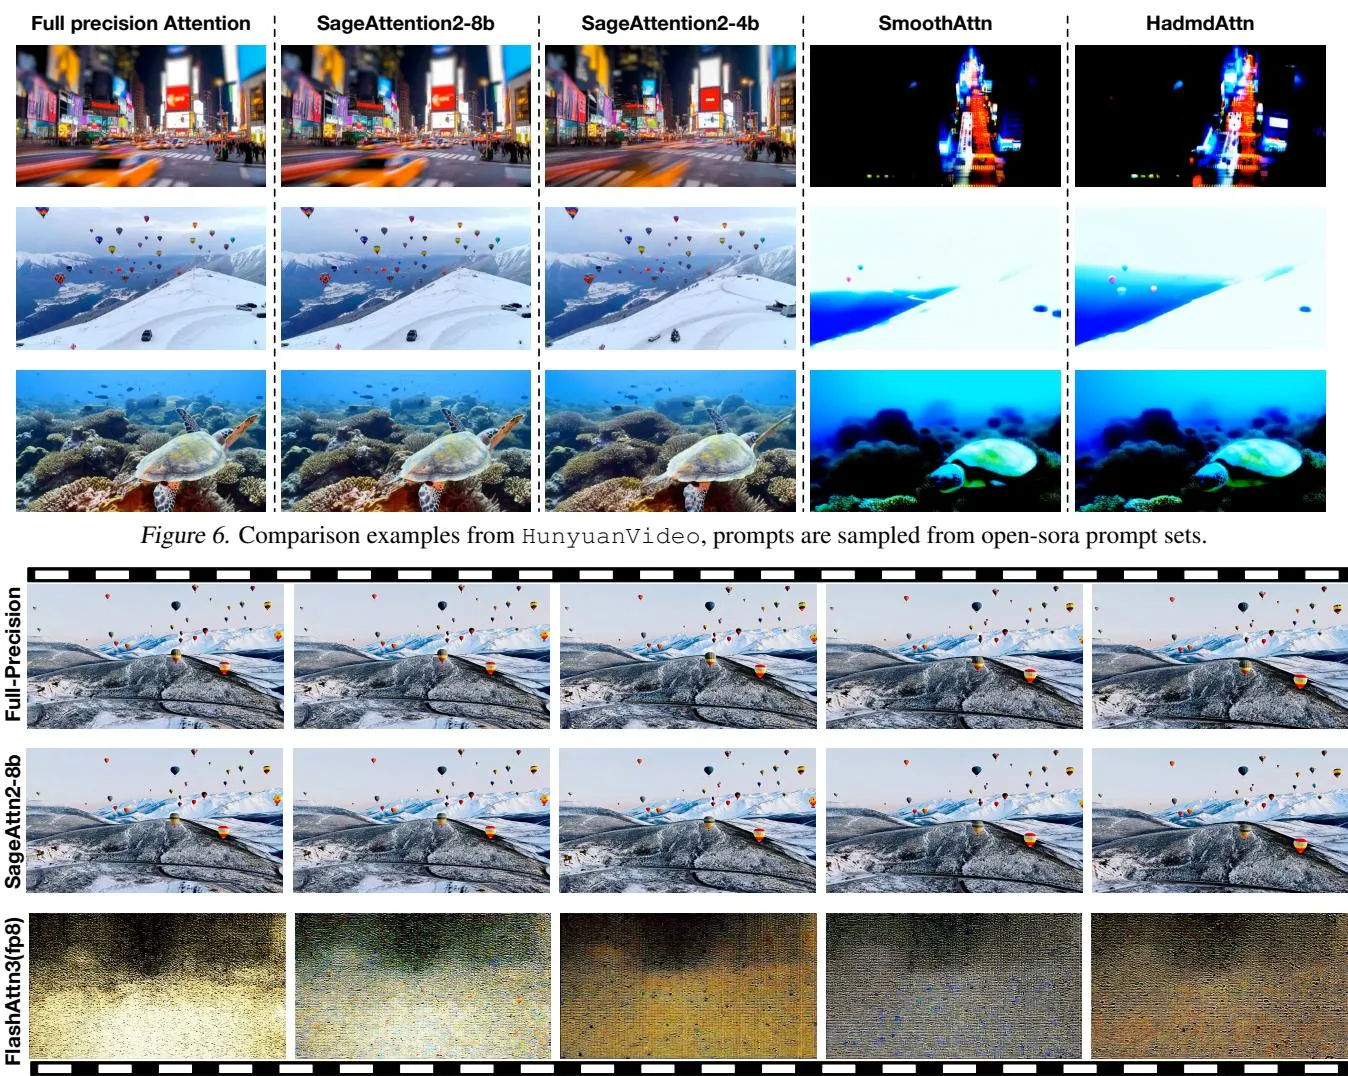 SageAttn2-8b 与 FlashAttention3 在 CogvideoX-1.5 上的对比 — FlashAttn3(fp8) 产生严重模糊。
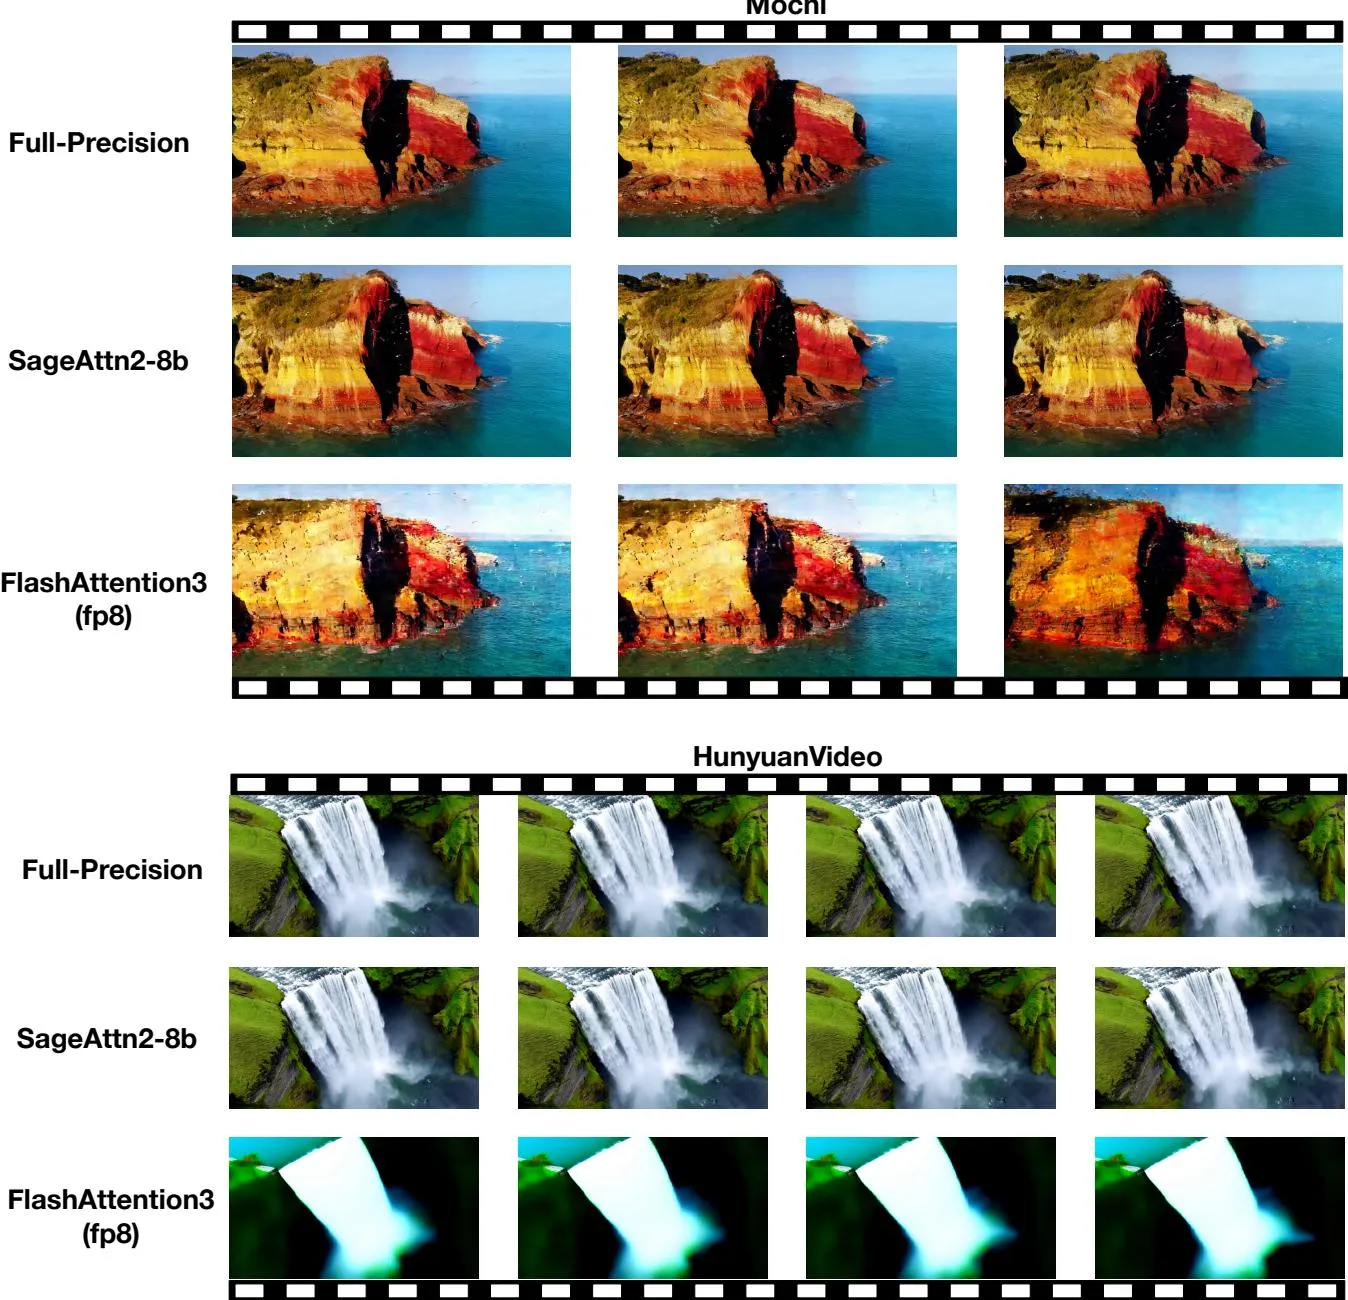 SageAttn2-8b 在 Mochi 和 HunyuanVideo 上无明显质量损失。
平滑效果可视化
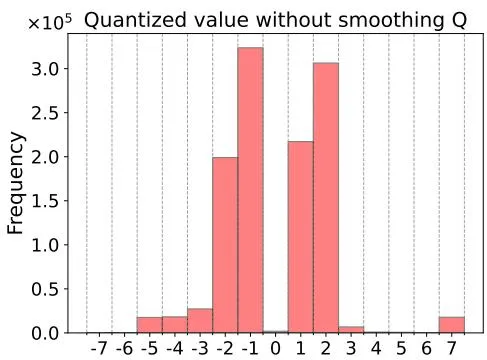 平滑后 INT4 量化范围被更均匀、充分地利用。
六、消融研究
各技术开销(Table 18, Table 19)
| 量化粒度 | TOPS | 相对 per-tensor 开销 |
|---|---|---|
| Per-tensor | 286 | — |
| Per-block | 284 | 0.7% |
| Per-thread | 283 | 1.0% |
| Per-token | 268 | 6.3% |
Per-token 量化有 6.3% 的性能下降,而 per-thread 仅 1.0%,证明 per-thread 是精度和速度的最佳平衡。
V 平滑的收益(Appendix Table 10)
| 平滑 V | CosSim↑ | Relative L1↓ | RMSE↓ |
|---|---|---|---|
| × | 98.25% | 0.1980 | 0.2387 |
| √ | 99.75% | 0.0406 | 0.0773 |
V 平滑在 V 有通道偏差时显著提升精度。
七、相关工作
| 方向 | 代表工作 | SageAttention2 的区别 |
|---|---|---|
| FlashAttention 系列 | FA1/2/3 (Dao et al.) | 不改变精度,纯系统优化 |
| SageAttention (v1) | Zhang et al., 2025c | INT8 per-block + FP16,仅平滑 K |
| SmoothQuant | Xiao et al., 2023 | 激活-权重间权衡,不适用于 QK^T |
| QuARoT | Ashkboos et al., 2024 | Hadamard 旋转 + INT4,精度差 |
| QServe | Lin et al., 2025 | W4A8KV4,系统级共设计 |
| FlashAttention3-fp8 | Shah et al., 2024 | 仅 Hopper,视频生成质量降级 |
八、总结
核心贡献
- INT4 线程级量化:首次将注意力 Q,K 量化到 INT4,基于 PTX MMA 内存布局实现 token 级精度无额外开销
- Q+K 联合平滑:发现 Q 也存在显著异常值,联合平滑后 CosSim 达 99.46%
- FP8 用于 PV:替代 FP16,利用 Tensor Core 实现速度翻倍,E4M3 精度接近 FP16
- 发现 FP22 累加器:首次揭示 mma.f32.f8.f8.f32 的 FP32 累加器仅有 22 位有效精度
- 两级累加策略:FP22 MMA + FP32 缓冲,将误差限制在 block 范围内
- 跨模型零损失加速:覆盖 LLM、视频生成、图像生成、音频、图像分类五大领域
性能总结
| 对比对象 | RTX4090 | L20 | H100/H20 |
|---|---|---|---|
| vs FlashAttention2 | 3× | — | — |
| vs xformers | 4.5× | — | — |
| vs FlashAttention3(fp8) | — | — | 速度匹配,精度远优 |
| vs SageAttention1 | 1.5× | 1.7× | 1.7× |
局限性
- 主要在 NVIDIA Ada/Hopper 架构验证,AMD GPU 未测试
- 训练场景未涉及,仅验证推理加速
- INT4 变体在 Hopper 上不可用(缺乏 INT4 Tensor Core 支持),需使用 INT8 变体
- SageAttn2-4b 在视频生成上有轻微质量降级(VA/VQA 略低于 8b 版本和全精度)
九、参考资源
- arXiv: 2411.10958
- GitHub: https://github.com/thu-ml/SageAttention
- SageAttention v1: arXiv:2410.02367
- FlashAttention-2: arXiv:2307.08691
- FlashAttention-3: arXiv:2411.10148
- SmoothQuant: arXiv:2211.10438