Minder: Faulty Machine Detection for Large-scale Distributed Model Training
面向大规模分布式模型训练的故障机器检测系统,基于LSTM-VAE无监督异常检测与机器级相似性分析,实现秒级故障响应。
Minder: Faulty Machine Detection for Large-scale Distributed Model Training
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Minder: Faulty Machine Detection for Large-scale Distributed Model Training |
| 作者 | Yangtao Deng, Xiang Shi, Zhuo Jiang, Xingjian Zhang, Lei Zhang, Zhang Zhang, Bo Li, Zuquan Song, Hang Zhu, Gaohong Liu, Fuliang Li, Shuguang Wang, Haibin Lin, Jianxi Ye, Minlan Yu |
| 机构 | ByteDance |
| 论文 | arXiv:2411.01791 |
| 代码 | - |
| 发布 | 2024年11月 |
| 许可 | - |
二、核心思想
问题定义
大规模分布式模型训练(如LLM训练、多模态训练)需要同时在数千台机器上运行。当机器发生意外故障时,训练任务会完全停止,需要人工介入排查故障机器。根据作者在生产环境中的经验,一个训练任务平均每天可能遇到两次故障,手动诊断可能导致数小时的停机。
核心挑战:
- 故障频率高:大规模训练任务频繁遭遇故障,机器规模越大故障率越高
- 手动审查耗时:人工审查故障原因耗时且劳动密集
- 故障类型多样:网络故障、GPU故障、内存故障、存储故障等,无单一指标可覆盖所有类型
- 监控数据噪声大:原始监控指标包含大量抖动和噪声
解决方案概述
本文提出Minder,一个用于分布式训练任务的自动故障机器检测系统,基于四个关键设计选择:
- 机器级相似性:利用分布式训练中各机器计算/存储/通信负载均衡的特性,故障机器的监控指标会表现出与正常机器的显著差异
- 异常连续性检查:过滤突发抖动,只关注持续一段时间的异常模式
- 逐指标模型训练:为每个监控指标独立训练LSTM-VAE模型,避免多指标混合导致的误判
- 指标优先级排序:使用决策树对指标进行优先级排序,优先通过高优先级指标快速检测故障
实验结果:
- 已在ByteDance生产环境部署超过一年
- 精度0.904,F1分数0.893
- 平均响应时间3.6秒
三、技术架构
问题动机
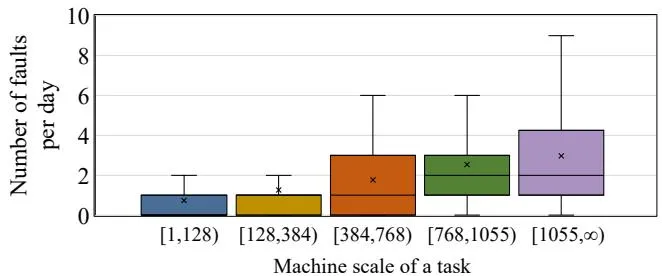
Figure 1: 不同机器规模大小的任务故障频率。
关键观察:机器规模越大,故障频率越高。大规模训练任务(数千台机器)每天可能遭遇多次故障,故障检测对训练效率至关重要。
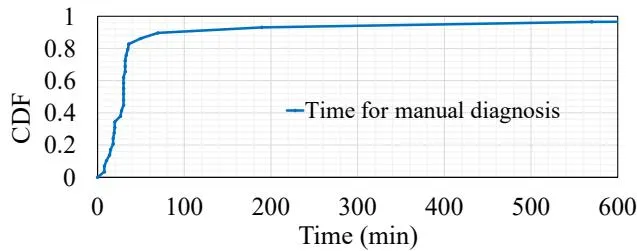
Figure 2: 七个月内的任务诊断时间。
关键发现:手动诊断耗时数小时,故障导致训练任务长时间停机。自动检测可以显著减少诊断时间。
故障模式分析
PFC tx packet rate模式:
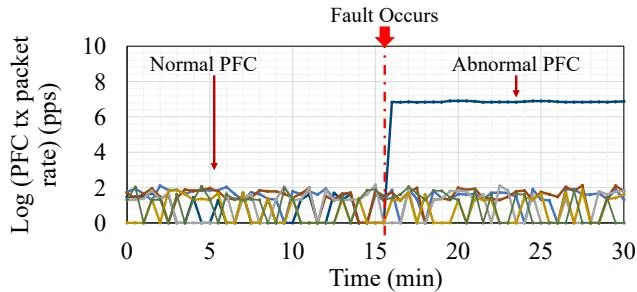
Figure 3: 故障发生前后每台机器的PFC tx packet rate模式。
关键观察:
- 在PCIe降级故障示例中,所有机器的初始PFC Tx Packet Rate模式高度一致
- 故障机器的监控数据会显示出与正常机器的显著差异
- 这种差异为故障检测提供了机会
- 该原理可扩展到其他监控指标
异常持续时间:
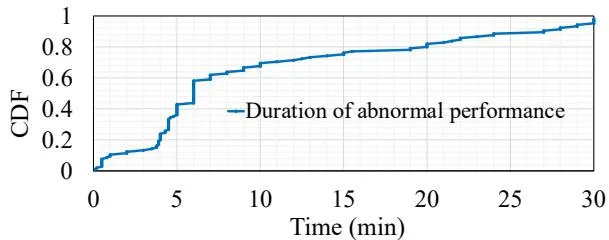
Figure 4: 故障后异常性能的持续时间。
关键发现:
- 异常在故障后持续一段时间(非瞬时消失)
- 持续时间因故障类型而异
- 可以利用持续时间特征进行故障分类和过滤突发抖动
系统架构
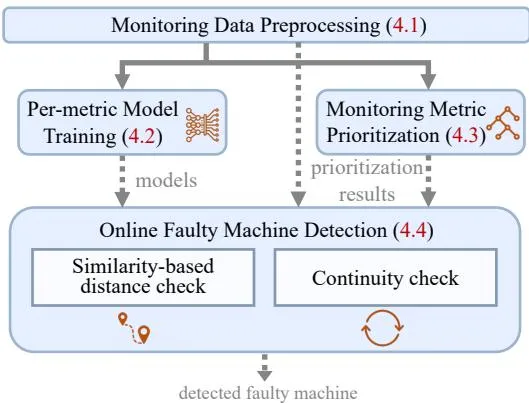
Figure 5: Minder的系统架构。
系统流程:
| 阶段 | 组件 | 说明 |
|---|---|---|
| 预处理 | 数据对齐与归一化 | 对齐采样点,Min-Max归一化 |
| 模型训练 | 逐指标LSTM-VAE训练 | 为每个监控指标独立训练模型 |
| 指标排序 | 决策树优先级排序 | 按故障敏感度对指标排序 |
| 在线检测 | 实时故障机器检测 | 使用训练好的模型和排序结果 |
核心技术
LSTM-VAE模型
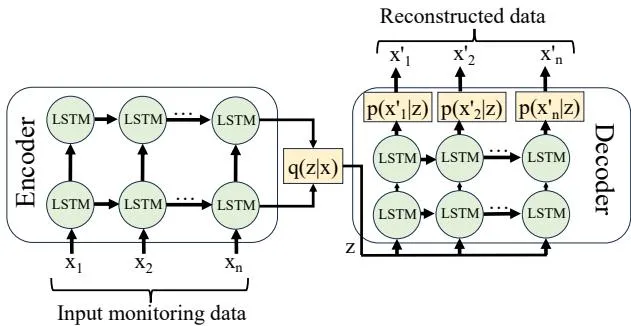
Figure 6: Minder的LSTM-VAE结构。
模型设计:
- LSTM:捕获时间序列数据中的时序依赖
- VAE:学习正常行为的潜在表示,用于去噪和重构
- 异常检测:重构误差超过阈值时判定为异常
为什么选择无监督学习:
- 不同于监督学习方法,Minder使用无监督学习+相似性距离检查
- 原因:故障类型多样,无法预先枚举所有故障类型
- 标签数据稀缺,难以获取足够的故障样本
- VAE可以学习正常数据分布,将异常数据重构为不同的潜在表示
数学公式:
其中:
- 第一项是重构损失(Reconstruction Loss)
- 第二项是KL散度正则化(KL Divergence Regularization)
- 控制正则化强度
模型参数:
hidden_size: 4latent_size: 8lstm_layer: 1- 时间窗口长度 : 8
决策树排序
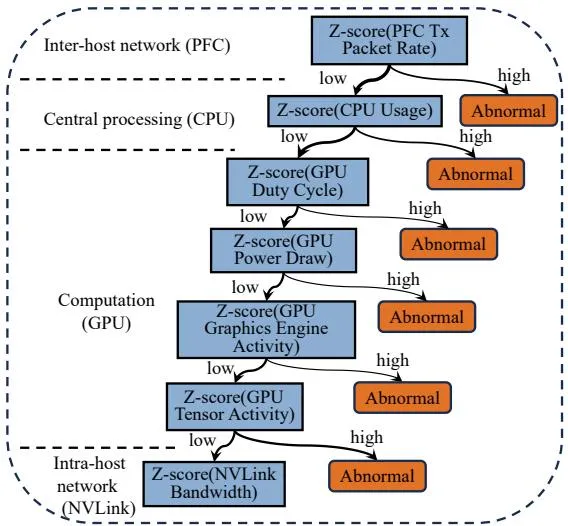
Figure 7: 用于优先级排序的决策树的前7层。
排序策略:
- 使用决策树对可疑机器进行优先级排序
- 考虑多个特征指标的故障敏感度
- 优先处理最可能的故障机器
- 高优先级指标可以快速检测故障,减少检测延迟
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 机器级相似性 | 利用分布式训练负载均衡特性 | DP/PP/TP下各机器指标相似 |
| 逐指标模型 | 为每个监控指标独立训练LSTM-VAE | 避免多指标混合误判 |
| 无监督检测 | 不依赖故障标签,使用相似性距离 | 适用于未知故障类型 |
| 指标优先级 | 决策树排序,优先使用高敏感度指标 | 减少检测延迟 |
| 异常连续性 | 过滤突发抖动,关注持续异常 | 降低误报率 |
五、实验结果
实验配置
部署环境:
- ByteDance生产环境部署超过一年
- 监控每日分布式训练任务
- 每个任务涉及多达数千台机器
故障类型(Table 1):
- 网络故障(NIC、交换机)
- GPU故障(GPU错误、ECC错误)
- 内存故障
- PCIe降级故障
- 存储故障
性能分析
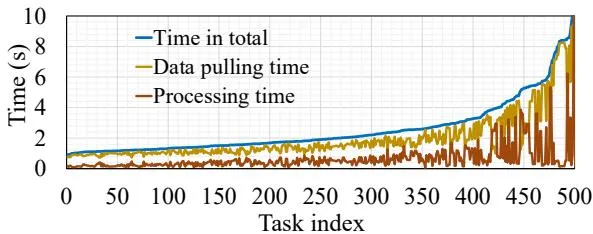
Figure 8: Minder一次调用的总数据处理时间。
关键结果:
- 数据处理时间在秒级
- 满足实时检测需求
- 计算开销可接受
基线比较
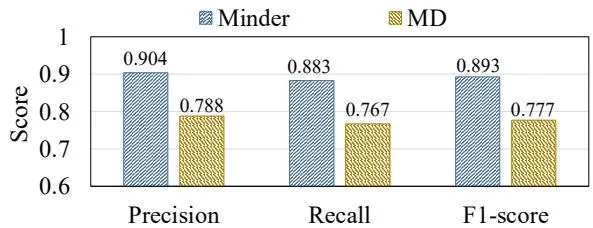
Figure 9: 与基线算法MD的比较。
关键结果:
- Minder显著优于基线算法MD [30, 46]
- 精度0.904,F1分数0.893
- 误报率低
故障类型准确率
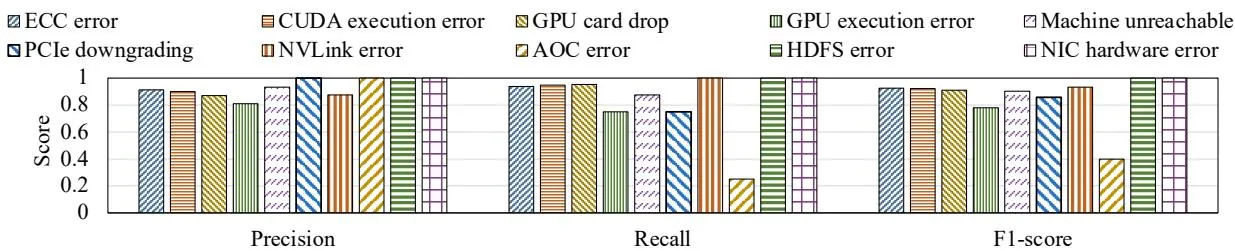
Figure 10: 不同故障类型的准确率。
关键发现:
- 对不同故障类型都有较高准确率
- 网络故障检测准确率最高
- GPU故障检测仍有提升空间
故障生命周期准确率
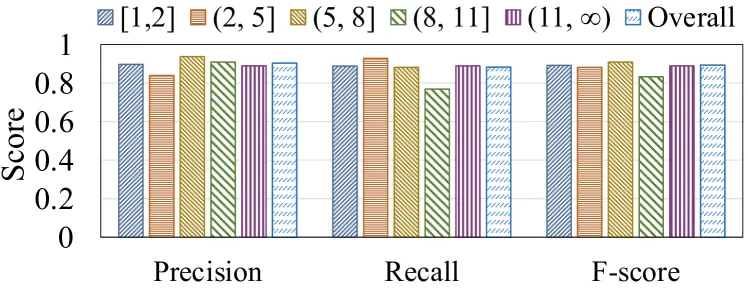
Figure 11: 故障生命周期不同阶段的准确率。
消融实验
指标选择比较:
Figure 12: 不同指标选择的比较。
关键发现:
- 不同指标对故障检测的贡献不同
- 组合多个指标可以提高准确率
- 指标选择对性能有显著影响
模型选择比较:
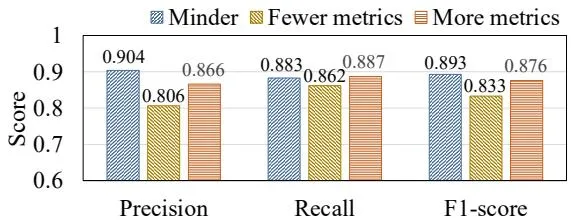
Figure 13: 不同模型选择的比较。
关键发现:
- LSTM-VAE模型表现最佳
- 时序建模对故障检测至关重要
- VAE的异常检测能力有效
连续性检查:
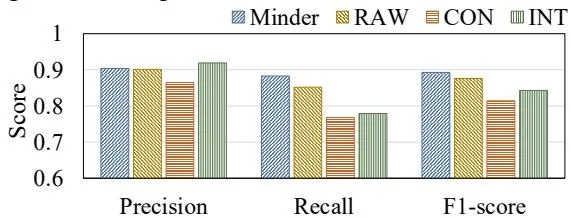
Figure 14: 有无连续性检查的准确率对比。
距离度量比较:
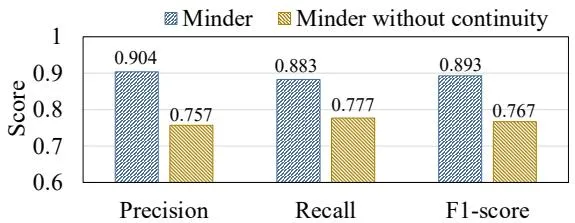
Figure 15: 不同距离度量的比较。
补充实验
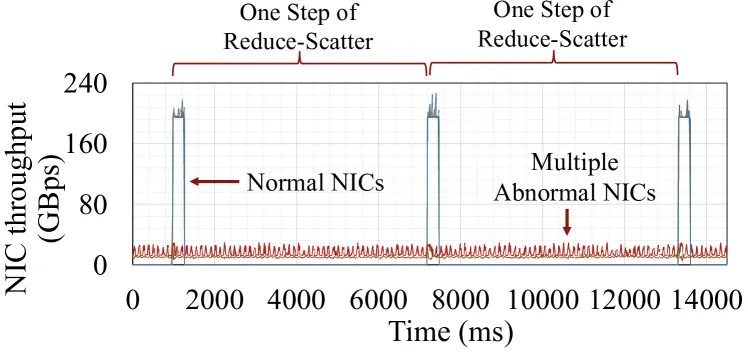
Figure 16: PCIe降级故障注入后所有机器的毫秒级NIC吞吐量。
六、相关工作
故障检测
| 方法 | 关键特性 | 本文对比 |
|---|---|---|
| 手动审查 | 人工检查故障日志 | 自动化替代 |
| 统计方法 | 基于统计阈值 | 深度学习方法 |
| 监督学习 | 需要故障标签 | 无监督方法 |
| 单一指标 | 依赖特定指标 | 多指标组合 |
异常检测
| 方法 | 关键特性 | 本文对比 |
|---|---|---|
| 自编码器 | 重构误差检测 | LSTM-VAE扩展 |
| 时序模型 | 捕获时序依赖 | LSTM组件 |
| 集成方法 | 多模型组合 | 逐指标独立模型 |
七、总结
核心贡献
-
Minder系统:提出自动故障机器检测系统,已部署ByteDance生产环境超过一年
-
机器级相似性:利用分布式训练负载均衡特性,通过机器间距离检测故障
-
LSTM-VAE模型:结合时序建模和无监督异常检测,实现高精度故障检测
-
实时响应:平均3.6秒内响应故障,显著减少停机时间
-
生产验证:精度0.904,F1分数0.893,在大规模生产环境中验证
技术影响
- 训练效率:显著减少分布式训练的故障停机时间
- 自动化:替代耗时的人工审查过程
- 可靠性:提高大规模分布式训练的系统可靠性
- 成本节约:减少故障导致的计算资源浪费
局限性
- 故障类型:某些故障类型检测仍有提升空间
- 指标依赖:依赖特定的监控指标
- 环境特异性:可能需要针对不同环境调整阈值
- 新故障类型:对未知故障类型的泛化能力有待验证
八、参考资源
- 论文: https://arxiv.org/abs/2411.01791
- LSTM-VAE: 时序异常检测模型
- 分布式训练: 大规模模型训练系统