Context Parallelism for Scalable Million-Token Inference
用于可扩展百万Token推理的上下文并行技术
Context Parallelism for Scalable Million-Token Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Context Parallelism for Scalable Million-Token Inference |
| 作者 | Amy Yang, Jingyi Yang, Aya Ibrahim, Xinfeng Xie, Bangsheng Tang, Grigory Sizov, Jeremy Reizenstein, Jongsoo Park, Jianyu Huang |
| 机构 | Meta (原匿名提交,v3版本公开) |
| 论文 | arXiv:2411.01783 |
| 代码 | 未开源(系统实现论文) |
| 发布 | 2024年11月4日 (v1),2025年4月21日修订 (v3) |
| 许可 | 未明确 |
| 领域 | cs.DC (分布式、并行与集群计算), cs.AI, cs.LG |
二、核心思想
问题定义
现代大语言模型(LLM)如Llama3 405B在处理长上下文推理时面临严重的延迟挑战。在单台H100 GPU主机(8块GPU)上:
- 处理128K上下文需要约60秒
- 处理1M上下文需要约1200秒(20分钟)
这使得实时交互式长上下文推理几乎不可用。现有的并行化方法(如张量并行TP)在跨节点扩展时受限于高昂的通信开销。
解决方案概述
本文提出**上下文并行(Context Parallelism, CP)**技术,通过沿序列长度维度分布输入token到多个GPU上,实现长上下文推理的近线性延迟缩放。核心创新包括:
-
两种无损精确Ring Attention变体:
- Pass-KV:传递Key和Value张量(适合高KV缓存未命中率场景)
- Pass-Q:传递Query张量(适合低KV缓存未命中率场景)
-
运行时启发式算法:根据KV缓存命中率动态选择最优算法
-
负载均衡分片:支持变长输入的均衡计算和内存分配
关键成果:
- 128个H100 GPU上实现1M上下文预填充仅需77秒
- 93%并行化效率,63% FLOPS利用率
- 128K上下文预填充仅需3.8秒
三、技术架构
整体框架图
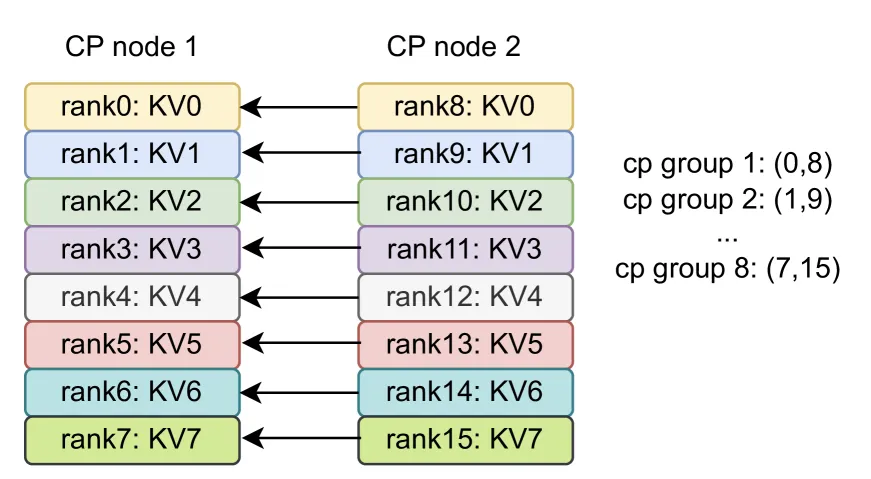
图1:跨节点上下文并行与节点内张量并行(CP2配置)
CP的核心思想是在节点间使用上下文并行(沿序列维度分片),在节点内使用张量并行(TP8),形成混合并行策略。
并行策略对比
| 特性 | 张量并行 (TP) | 上下文并行 (CP) |
|---|---|---|
| 分片维度 | 模型权重(行/列) | 输入序列长度 |
| 通信操作 | AllReduce | SendRecv |
| 通信层 | 线性层 | 注意力层 |
| 通信量(每Transformer块) | ||
| 参数分片 | (不分片) | |
| 内存效率 | 低(权重分片) | 高(KV缓存分片) |
其中:为序列长度,为头维度,为注意力头数,为KV头数,为TP组大小,为模型参数大小。
关键优势:对于Llama3 405B(128个Query头,8个KV头),CP通信KV头的消息大小比TP通信Query头小16倍。
三阶段推理模型
论文将LLM在线推理分为三个阶段:
- 全预填充(Full Prefill):初始提示的完整因果注意力计算
- 部分预填充(Partial/Persistent KV Prefill):后续提示利用已缓存的KV
- 解码(Decode):自回归生成,逐token输出
核心公式
注意力计算形状(GQA模型):
其中 为已缓存KV长度, 为新输入长度。
Ring Pass-KV算法:每个CP rank持有Q的分片和KV的分片。在 轮循环中,KV分片在ring中传递,每个rank计算本地Q与接收到的KV的部分注意力。
Ring Pass-Q算法:每个CP rank持有完整KV和Q的分片。在 轮循环中,Q分片在ring中传递,最后通过All2All合并部分注意力结果。
Pass-KV vs Pass-Q选择条件(Algorithm 1):
条件1:KV缓存未命中率 > (如Llama3为12.5%)时,选择Pass-KV
条件2:当SendRecv通信可被注意力计算隐藏时,选择Pass-KV
否则选择Pass-Q
Ring算法通信模型
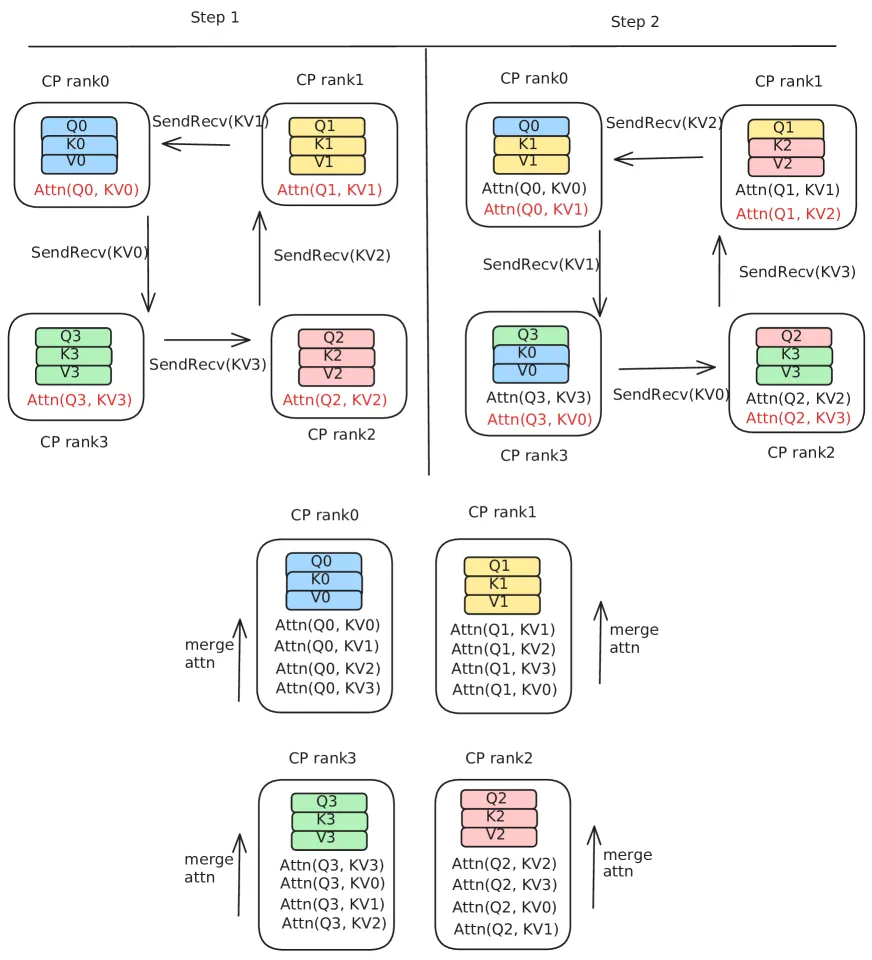
图3:Ring Pass-KV和Pass-Q算法的通信模式
对于Pass-KV,总通信量为 ,可与注意力计算重叠。
对于Pass-Q,总通信量包括ring中的SendRecv和最后的All2All合并。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Pass-KV Ring Attention | 传递KV张量而非Q,利用GQA减少通信量 | Llama3 405B:16x通信量减少 |
| Pass-Q Ring Attention | 传递Q张量,适合低缓存未命中率场景 | 缓存未命中率<5%时优于Pass-KV |
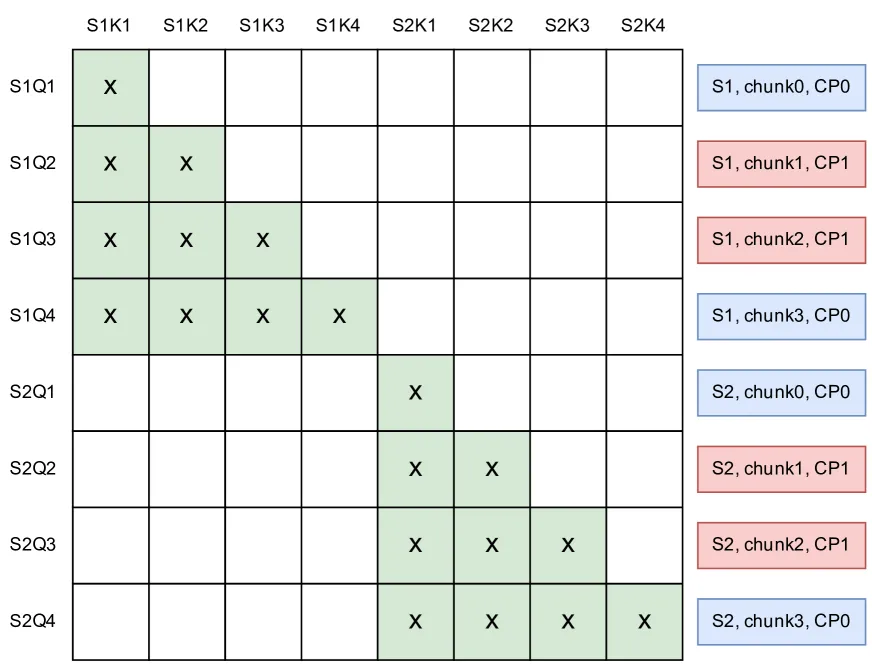
| 负载均衡分片 | 变长输入的均衡分配策略 | 支持批处理中不同长度的请求 |
| 运行时启发式选择 | 根据KV缓存命中率动态选择算法 | 实验验证5%为切换阈值 |
| 持久化KV缓存支持 | 多轮对话的KV缓存持久化 | 线性延迟与缓存未命中率成正比 |
| 解码阶段CP | Ring Pass-Q用于解码阶段 | 适合解耦的prefill-decode架构 |
负载均衡分片策略
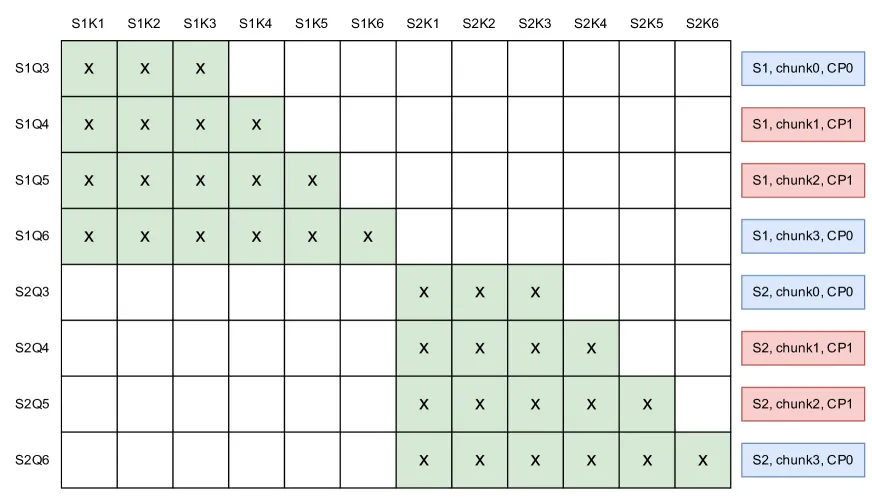
图2:Load Balanced Sharding策略
传统均匀分片在变长输入下导致负载不均衡。本文提出的分片策略确保:
- 每个CP rank的计算量近似相等
- KV缓存内存分布均衡
- 支持批处理中不同长度的请求
五、代码实现分析
本文为系统实现论文,未开源代码。但从论文中可提取以下实现细节:
硬件配置
| 配置项 | 详情 |
|---|---|
| 平台 | Meta Grand Teton (8x H100 GPU/节点) |
| GPU | Nvidia H100, 96GB HBM2e, 2.4 TB/s峰值带宽 |
| 节点间互联 | GTT: RDMA 400 Gb/s/GPU; GTI: TCP/IP 100 Gb/s/GPU |
| 节点内互联 | NVLink全连接 |
软件栈
| 组件 | 选择 |
|---|---|
| 模型 | Llama3 405B (FP8行量化) |
| 注意力内核 | Flash Attention 3 (prefill), Flash Decoding (decode, 256 splits) |
| 并行策略 | TP8(节点内)+ CP(节点间) |
| 通信 | 8-way SendRecv ring |
| 解码优化 | CUDA Graphs |
关键实现细节
- KV Head分组:每个CP通信组对应一个KV head,组内包含各节点上持有相同KV head的GPU
- Ring通信:8-way SendRecv实现ring通信(见Figure 5)
- Merge Attention:Pass-Q算法结束后的All2All合并步骤
- CUDA Graphs:解码阶段使用CUDA Graphs避免内核启动开销
六、实验结果
基准测试:预填充延迟缩放
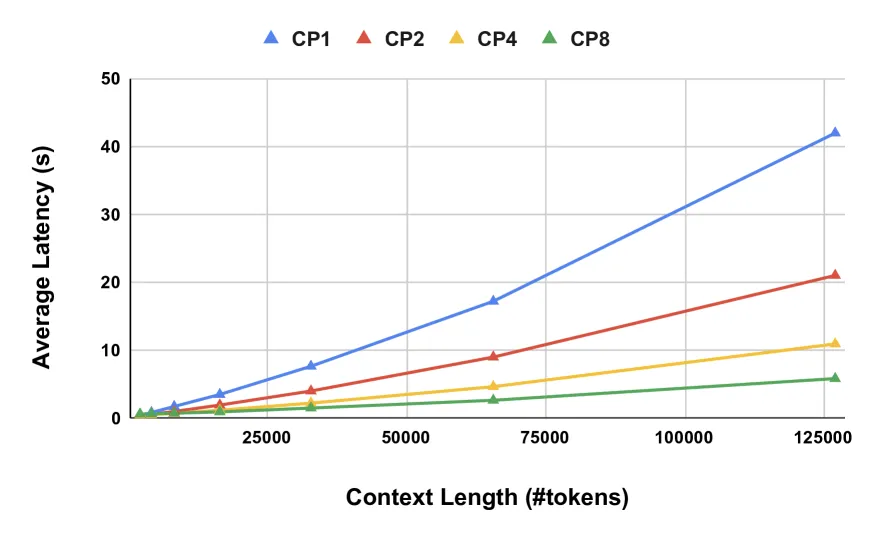
图6:Llama3 405B Pass-KV全预填充延迟
| 配置 | 128K延迟 | 缩放效率 |
|---|---|---|
| CP1 (单节点) | ~42s | 基准 |
| CP2 (2节点) | ~21s | ~2x |
| CP4 (4节点) | ~11s | ~4x |
| CP8 (8节点) | ~5.85s | ~7x |
关键发现:
- GTT(RDMA)和GTI(TCP)均展示良好的可扩展性
- GTI即使在~3GB/s带宽下仍能重叠通信与计算
- CP8在GTT上实现128K预填充5.85秒
CP vs TP多节点对比
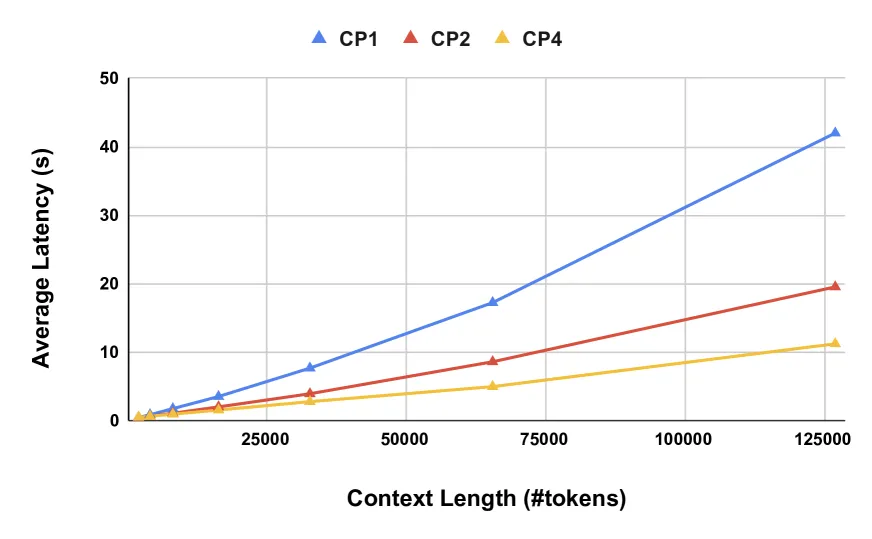
图7:上下文并行 vs 多节点张量并行的缩放比率
| 节点数 | CP缩放比率 | TP缩放比率 | CP优势 |
|---|---|---|---|
| 2 | ~1.85x | ~1.7x | 15% |
| 4 | ~3.6x | ~2.5x | 44% |
| 8 | ~7.2x | ~3.6x | 100% |
关键发现:TP的AllReduce延迟随节点数增加显著增长,而CP的SendRecv可被计算隐藏。在8节点时,CP比TP快100%。
百万Token缩放
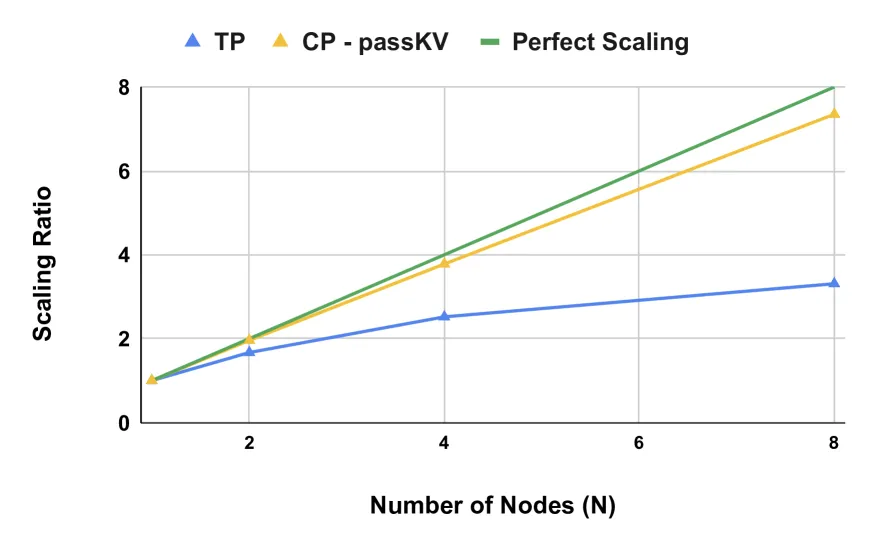
图8:128K-1M上下文的TTFT(CP8和CP16)
| 配置 | 128K TTFT | 512K TTFT | 1M TTFT |
|---|---|---|---|
| CP8 | ~7s | ~45s | ~185s |
| CP16 | ~3.8s | ~20s | ~77s |
关键性能指标(1M上下文,CP16):
- TTFT: 77秒
- 并行化效率: 93%(502 TF/sec per H100 vs 540 TF/sec单GPU Flash Attention基准)
- FLOPS利用率: 63%(考虑H100峰值FLOPS)
Pass-KV vs Pass-Q性能对比
| 缓存未命中率 | Pass-KV (ms) | Pass-Q (ms) | 最优选择 |
|---|---|---|---|
| 1.00% | 1023 | 899 | Pass-Q |
| 2.50% | 1110 | 1046 | Pass-Q |
| 3.25% | 1299 | 1280 | Pass-Q |
| 5.00% | 1306 | 1302 | 接近 |
| 10.00% | 2081 | 2205 | Pass-KV |
| 20.00% | 3353 | 3617 | Pass-KV |
| 50.00% | 6845 | 7368 | Pass-KV |
| 100.00% | 11462 | 12361 | Pass-KV |
切换阈值:约5%缓存未命中率(T=6400,P=121600)
解码性能
| 配置 | 128K TTFT | 128K TTIT |
|---|---|---|
| TP8 | 42010ms | 46.26ms |
| CP2+TP8 | 21042ms | 60.23ms |
| TP16 | 29917ms | 39.52ms |
| CP4+TP8 | 10950ms | 71.31ms |
关键发现:
- CP显著改善prefill延迟,但解码延迟略有退化
- 解码阶段CP的退化主要来自:1) padding开销 2) 通信延迟增长
- 建议使用解耦的prefill-decode架构分别优化
七、相关工作
长上下文推理方法分类
| 类别 | 方法 | 特点 |
|---|---|---|
| 新模型架构 | Munkhdalai et al. (2024) | 预训练阶段引入长上下文组件 |
| 后训练修改 | Xiao et al. (2023) | 修改预训练模型支持更长上下文 |
| 系统优化 | 本文方法 | 保持模型架构,优化注意力计算 |
相关系统优化工作
| 方法 | 论文 | 与本文关系 |
|---|---|---|
| Ring Attention | Liu et al. (2023) | 本文基础,但原工作聚焦训练 |
| Striped Attention | Brandon et al. (2023) | Ring Attention的改进,针对因果掩码 |
| Flash Attention | Dao et al. (2022), Dao (2023) | 注意力内核优化,与CP互补 |
| Flash Decoding | - | 解码阶段注意力优化 |
| KV-Runahead | Cho et al. (2024) | 并行KV缓存生成 |
| KVQuant | Hooper et al. (2024) | KV缓存量化,减少内存 |
与其他并行策略关系
本文方法可与以下技术结合使用:
- 张量并行(TP):节点内使用TP8分片模型权重
- 流水线并行(PP):可结合用于更大模型
- KV缓存量化:进一步减少内存占用
- GQA/MQA:减少KV头数,降低CP通信量
八、总结
核心贡献
- 首个公开的推理场景上下文并行系统实现
- 两种无损精确Ring Attention变体:Pass-KV和Pass-Q,覆盖全预填充、持久化KV预填充和解码场景
- 运行时启发式算法:根据KV缓存命中率动态选择最优算法
- 负载均衡分片策略:支持变长输入的均衡分配
- 128 GPU上实现1M上下文77秒预填充:93%并行化效率
技术影响
- 使百万Token实时推理成为可能:从20分钟降至77秒
- 降低硬件门槛:在中等带宽的商业数据中心(TCP)也能良好扩展
- 系统级优化可叠加:与模型架构创新和算法增强无缝集成
- 为解耦架构提供基础:CP更适合prefill阶段,建议与解码阶段分离
局限性
- 解码阶段性能退化:CP在解码阶段的TTIT比单节点更高,需要解耦架构优化
- 内存开销:CP不分片模型权重,相比TP有更高内存消耗
- 精确注意力的二次复杂度:超过1M token后,精确注意力的二次计算成本将成为瓶颈
- 未开源实现:论文为系统实现论文,代码未公开
未来方向
论文指出,随着上下文窗口增长到1M以上,精确注意力的效用将递减。未来方向包括:
- 结合近似检索算法从超长上下文中提取信息子集
- 将CP的处理能力与近似算法结合,约束1M+上下文的处理延迟
九、参考资源
论文链接
- arXiv: https://arxiv.org/abs/2411.01783
- PDF: https://arxiv.org/pdf/2411.01783
- HTML: https://arxiv.org/html/2411.01783v3
关键引用
- Ring Attention: Liu et al. (2023) - “Ring attention with blockwise transformers for near-infinite context”
- Flash Attention: Dao et al. (2022) - “FlashAttention: Fast and memory-efficient exact attention with IO-awareness”
- Flash Attention 2: Dao (2023) - “FlashAttention-2: Faster attention with better parallelism and work partitioning”
- Flash Attention 3: Shah et al. (2024) - Flash Attention 3
- GQA: Ainslie et al. (2023) - “GQA: Training generalized multi-query transformer models from multi-head checkpoints”
- Striped Attention: Brandon et al. (2023) - “Striped Attention: Faster Ring Attention for Causal Transformers”
- KVQuant: Hooper et al. (2024) - “KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization”
相关模型
- Llama 3: Touvron et al. (2023a; b); Llama Team (2024)
- Gemini: Gemini Team (2023; 2024)
- GPT-4: Achiam et al. (2023)
工具与框架
- Flash Attention 3: 用于prefill阶段的注意力内核
- Flash Decoding: 用于decode阶段的注意力优化(256 splits)
- CUDA Graphs: 解码阶段的内核启动优化
- FBGEMM: PyTorch的FP8行量化实现