ShadowKV: KV Cache in Shadows for High-Throughput Long-Context LLM Inference
通过低秩Key缓存和CPU卸载Value缓存实现高吞吐量长上下文LLM推理
ShadowKV: KV Cache in Shadows for High-Throughput Long-Context LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ShadowKV: KV Cache in Shadows for High-Throughput Long-Context LLM Inference |
| 作者 | Hanshi Sun, Li-Wen Chang, Wenlei Bao, Size Zheng, Ningxin Zheng, Xin Liu, Harry Dong, Yuejie Chi, Beidi Chen |
| 机构 | ByteDance Seed、Carnegie Mellon University |
| 论文 | https://arxiv.org/abs/2410.21465 |
| 代码 | https://github.com/ByteDance-Seed/ShadowKV |
| 发布 | 2024年10月28日 |
| 许可 | 未明确 |
二、核心思想
问题定义
长上下文LLM推理面临KV缓存的双重瓶颈:
- 内存瓶颈:KV缓存随序列长度线性增长,占用大量GPU显存,限制batch size
- 带宽瓶颈:每生成一个token都需要访问整个KV缓存,导致低吞吐量
现有方法的局限:
- KV驱逐策略(H2O、StreamingLLM):信息丢失,多轮对话中性能下降
- 动态稀疏注意力(Quest、Loki):保留全部KV缓存,内存占用不减
- CPU卸载(InfiniGen):PCIe传输延迟高,预取选择不准确
解决方案概述
ShadowKV基于两个关键观察设计:
观察1:Pre-RoPE Keys具有极低秩特性
- Pre-RoPE keys的奇异值衰减最快,可实现6倍压缩且不损失精度
- 低秩子空间在同一序列内共享,但跨序列不共享
- SVD开销随序列长度增加而相对降低
观察2:Post-RoPE Keys具有空间局部性
- 大多数chunk的平均值可作为landmarks近似注意力分数
- 异常chunk仅占0.2-0.3%,可静态存储在GPU上
- KV缓存具有时间局部性,命中率超过60%
三、技术架构
整体框架图
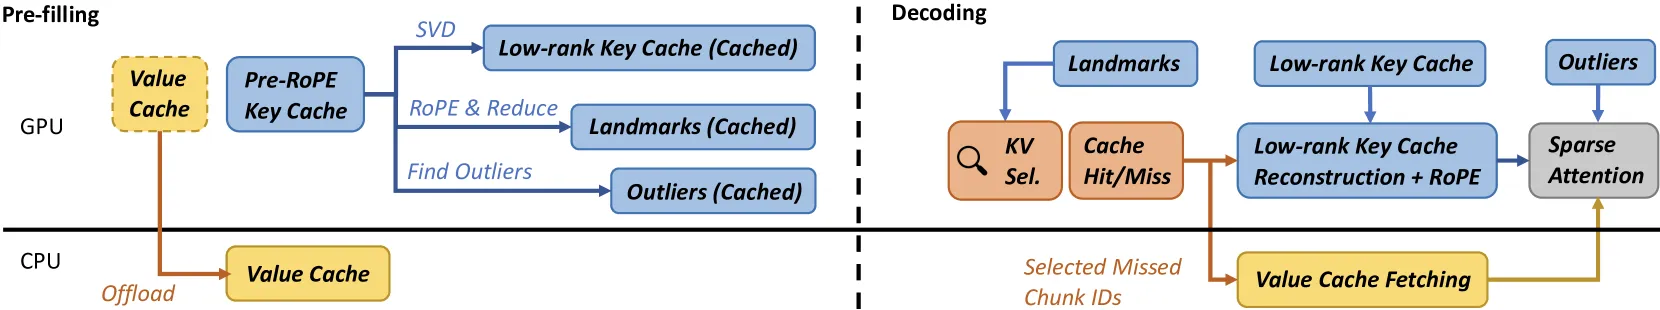
系统流程:
-
Pre-filling阶段:
- 对pre-RoPE key cache进行SVD低秩分解
- 将value cache卸载到CPU
- 计算post-RoPE key chunks的均值作为landmarks
- 检测并存储异常chunks(outliers)
-
Decoding阶段:
- 使用landmarks计算近似注意力分数
- 选择top-k chunk索引
- 并行:从CPU获取value cache + 从低秩投影重建key cache
- 使用缓存策略减少60%的数据移动
核心公式
低秩子空间相似度度量:
其中 是Frobenius内积, 是秩为 的截断SVD投影矩阵。
等效带宽公式:
其中:
- = 序列长度
- = chunk大小
- = 选择的chunk数
- = 异常chunk数
- = 缓存命中率
- = GPU内存带宽 (A100: 2 TB/s)
- = PCIe带宽 (31.5 GB/s)
示例计算:C=8, S=128K, K=256, O=48时,等效带宽达到7.2 TB/s,是A100内存带宽的3.6倍。
算法细节
Algorithm 1: Pre-filling
输入:,SVD秩 ,chunk大小 ,异常chunk数
- SVD分解:
- 计算chunk均值:
- 计算chunk内余弦相似度:
- 检测异常:
- 卸载value到CPU,存储landmarks
Algorithm 2: Decoding
输入:
- 计算chunk注意力分数:
- 选择top-k chunks:
- 并行操作:
- 从CPU获取value:
- 重建key:
- 拼接并计算注意力:
关键参数
| 参数 | 值 | 说明 |
|---|---|---|
| Chunk大小 | 8 | 平衡精度和batch size |
| SVD秩 | 160 | pre-RoPE key压缩秩 |
| 异常chunk数 | 48 | 静态存储在GPU上 |
| 稀疏预算 | 1.56% | 选择的KV对比例 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Pre-RoPE Keys低秩特性 | 发现pre-RoPE keys比其他组件低秩得多 | 奇异值分布分析,6倍压缩无精度损失 |
| Landmark近似 | chunk均值可有效近似注意力分数 | 空间局部性分析,0.2-0.3%异常chunk |
| 等效带宽理论 | 形式化分析ShadowKV的性能优势 | 7.2 TB/s等效带宽,3.6×GPU带宽 |
| 流水线重叠 | key重建与value获取并行执行 | CUDA多流实现,2×延迟减少 |
| 时间局部性缓存 | 利用相邻解码步骤的KV重叠 | 60%数据移动减少 |
五、实验结果
准确性评估
RULER基准(128K上下文)
| 方法 | Llama-3-8B-1M | GLM-4-9B-1M | Llama-3.1-8B |
|---|---|---|---|
| 全注意力 | 86.68 | 86.82 | 85.53 |
| Loki | 9.33 | 28.57 | 35.52 |
| Loki (V) | 24.46 | 54.65 | 58.29 |
| InfiniGen | 70.13 | 67.60 | 59.27 |
| InfiniGen (V) | 78.31 | 72.91 | 68.76 |
| Quest | 82.03 | 77.86 | 76.29 |
| Quest (V) | 83.99 | 81.47 | 79.72 |
| ShadowKV | 86.88 | 85.62 | 83.57 |
LongBench基准
| 方法 | Llama-3-8B-1M | GLM-4-9B-1M | Llama-3.1-8B |
|---|---|---|---|
| 全注意力 | 39.86 | 48.24 | 48.96 |
| Loki | 15.78 | 32.35 | 27.02 |
| Quest | 36.65 | 41.52 | 44.80 |
| ShadowKV | 39.94 | 47.89 | 48.13 |
吞吐量评估
| 模型 | 上下文 | 全注意力 | ShadowKV | 增益 | 全注意力(无限) |
|---|---|---|---|---|---|
| Llama-3-8B-1M | 60K | 160.62 (8) | 455.14 (48) | 2.83× | 273.07 |
| Llama-3-8B-1M | 122K | 80.77 (4) | 239.51 (24) | 2.97× | 134.30 |
| Llama-3-8B-1M | 244K | 40.37 (2) | 119.01 (12) | 2.95× | 67.15 |
| Llama-3.1-8B | 60K | 160.93 (8) | 472.77 (48) | 2.94× | 273.07 |
| Llama-3.1-8B | 122K | 80.78 (4) | 245.90 (24) | 3.04× | 134.30 |
| GLM-4-9B-1M | 60K | 241.05 (12) | 615.89 (50) | 2.56× | 436.91 |
| Yi-9B-200K | 60K | 204.81 (10) | 544.36 (42) | 2.66× | 364.09 |
关键发现:
- 支持高达6×更大batch size
- 吞吐量提升最高3.04×
- 甚至超越假设无限GPU内存的无限batch size性能
消融实验
稀疏预算影响:
- 1.56%稀疏预算即可保持全注意力精度
- 在大多数任务上甚至略微超越全注意力
Chunk大小选择:
- 增大chunk size允许更大batch size
- 超过8时精度下降
- chunk命中率保持约60%
Pre-RoPE Key秩选择:
- 秩增加到约160时精度趋于稳定
- 某些任务上低秩近似甚至表现更好
多轮对话能力
在Multi-turn NIAH基准上:
- SnapKV从第二轮开始性能显著下降
- ShadowKV在多轮对话中保持精度
与MInference兼容性
与高效pre-filling方法MInference结合:
- RULER 8K-256K上下文平均分:82.04(vs 全注意力81.98)
- 证明ShadowKV与pre-filling加速技术兼容
六、相关工作
| 论文 | 方法 | 与ShadowKV的区别 |
|---|---|---|
| StreamingLLM | 保留attention sinks和最近KV | 信息丢失,不适合多轮对话 |
| H2O | 基于累积注意力分数的驱逐 | 无法恢复被驱逐的token |
| SnapKV | 使用prompt局部窗口选择重要token | 第一轮选择后无法更新 |
| Quest | 按页选择,近似最高注意力 | 保留全部KV,内存不减 |
| Loki | PCA降维选择token | 依赖校准数据集 |
| InfiniGen | SVD预定义投影预取 | prompt无关的预取不准确 |
| KIVI | 2-bit量化keys和values | 正交方法,可与ShadowKV结合 |
七、总结
核心贡献
- 发现pre-RoPE keys的低秩特性:比其他组件低秩得多,可实现6倍压缩
- 设计高效的存储策略:低秩key cache + CPU卸载value cache + GPU存储landmarks和outliers
- 提出准确的KV选择方法:利用landmarks选择1.56%的稀疏KV对
- 实现等效带宽优化:理论7.2 TB/s,实际3.04×吞吐量提升
- 广泛验证:在6个模型、3个基准上验证有效性
技术影响
- 为长上下文LLM推理提供实用的高吞吐量解决方案
- 发现pre-RoPE keys的低秩特性对后续KV缓存优化研究有指导意义
- 等效带宽分析框架可推广到其他KV缓存优化方法
局限性
- 主要针对decode阶段优化,pre-filling仍需完整计算
- 需要对每个序列进行在线SVD分解
- 对于非常短的序列,优化收益有限