EPS-MoE: Expert Pipeline Scheduler for Cost-Efficient MoE Inference
针对MoE模型的专家流水线调度器,通过计算通信重叠实现推理吞吐量提升
EPS-MoE: Expert Pipeline Scheduler for Cost-Efficient MoE Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | EPS-MoE: Expert Pipeline Scheduler for Cost-Efficient MoE Inference |
| 作者 | Yulei Qian, Fengcun Li, Xiangyang Ji, Xiaoyu Zhao, Jianchao Tan, Kefeng Zhang, Xunliang Cai |
| 机构 | 未明确标注 |
| 论文 | arXiv:2410.12247 |
| 发布 | 2024-10-16 (v1), 2025-01-03 (v2) |
| 领域 | 计算与语言 (cs.CL) |
二、核心思想
问题定义
Mixture-of-Experts (MoE) 模型在大型语言模型中广泛应用,但其推理效率面临挑战:
- GEMM操作效率问题:GroupGemm在小batch size下效率不如DenseGemm
- 通信开销:多GPU并行计算引入的All2All通信成为瓶颈
- 单一并行策略局限:单纯的EP、DP、TP或简单组合难以达到最优吞吐量
核心发现
关键洞察:
- GroupGemm vs DenseGemm权衡:在token数量较少时,DenseGemm比GroupGemm更高效
- 通信计算重叠机会:通信和计算可以流水线化重叠执行
- 专家粒度优势:细粒度MoE模型(如DeepSeekV2)更适合专家流水线
解决方案概述
EPS-MoE 是一个专家流水线调度器,通过以下创新提升MoE推理效率:
- 动态GEMM选择:根据负载动态选择GroupGemm或DenseGemm
- 专家流水线并行:将MoE FFN计算流水线化
- 计算通信重叠:将All2All通信与专家计算重叠执行
核心结果:
- DeepSeekV2:从100K提升到121.8K tokens/s (+21.8%)
- Mixtral (vllm):从71.84K提升到94.89K tokens/s (+32.2%)
- DBRX (vllm):从37.23K提升到56.74K tokens/s (+52.4%)
三、技术架构
权重划分策略
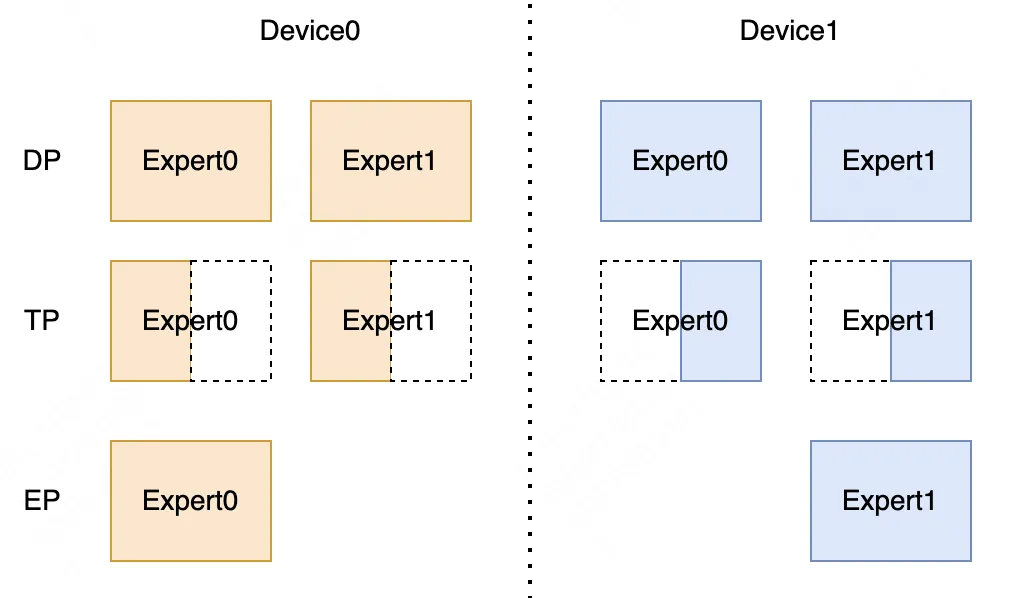
三种并行策略对比:
| 策略 | 权重划分 | 特点 |
|---|---|---|
| DP (数据并行) | 每个GPU完整副本 | 最小通信,重复存储 |
| TP (张量并行) | 按列/行切分权重 | 适合Attention,需AllReduce |
| EP (专家并行) | 按专家切分 | 适合MoE,需All2All |
MoE架构分析
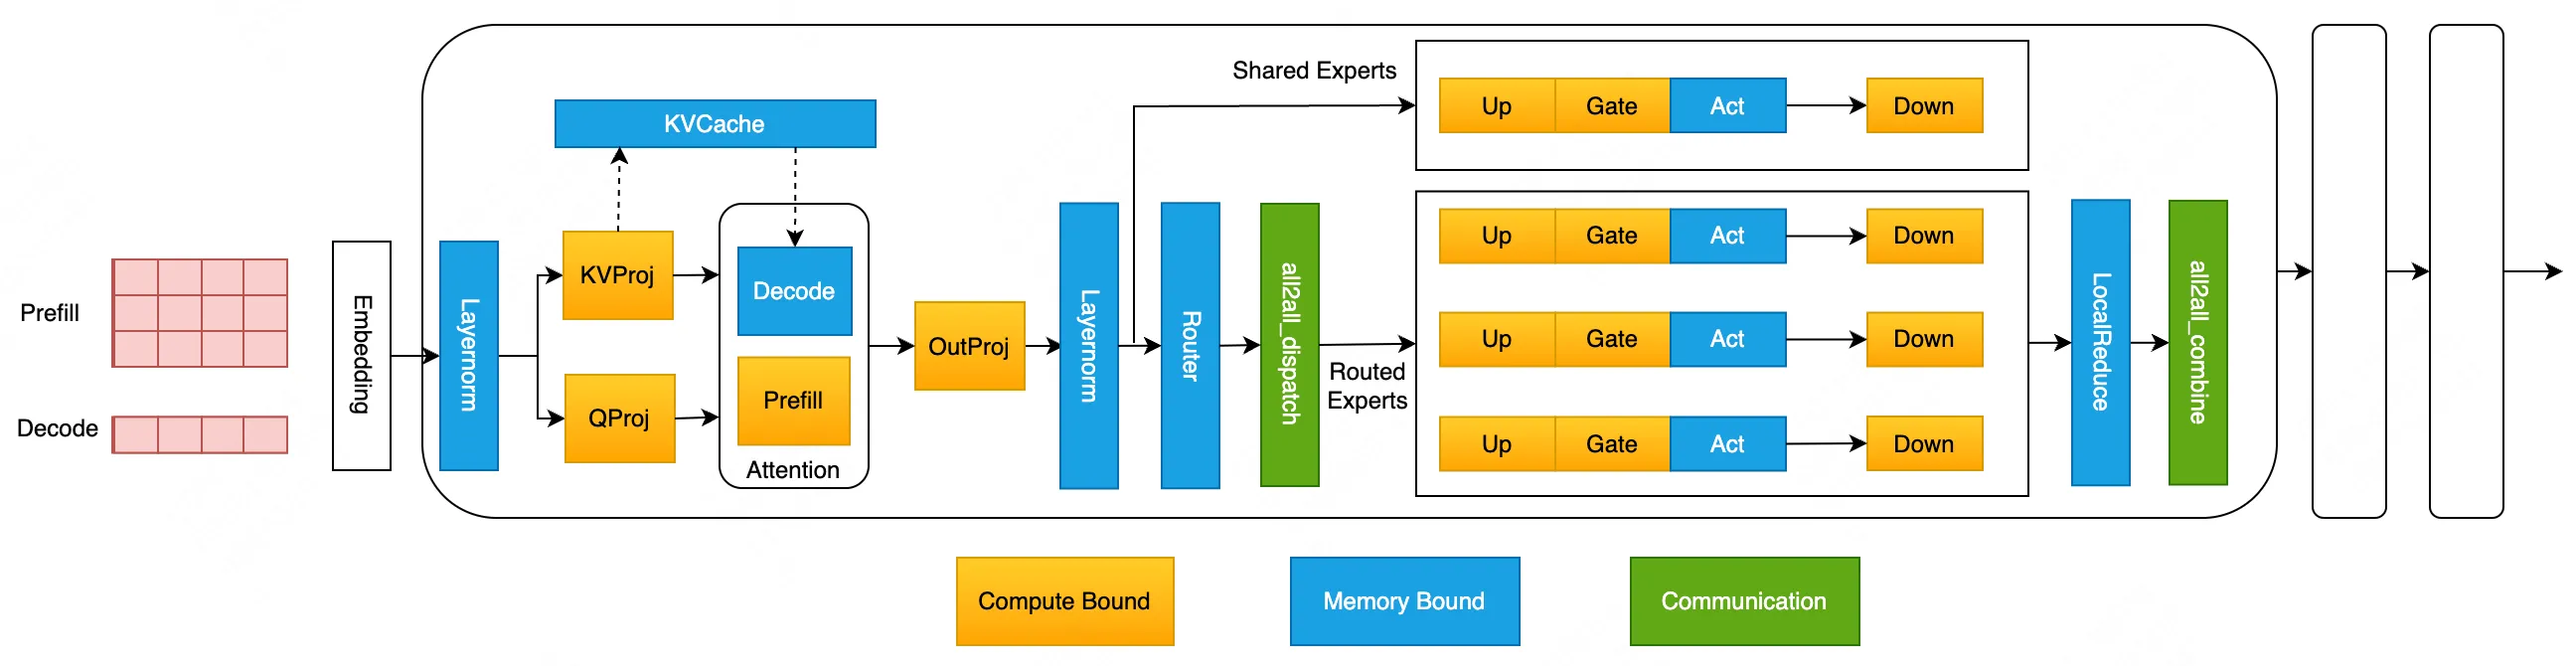
MoE推理瓶颈:
- 计算Bound:GEMM操作(Gate、Up、Down矩阵)
- 内存Bound:LayerNorm、激活函数、TopK门控
- 通信Bound:All2All通信
GPU资源视角
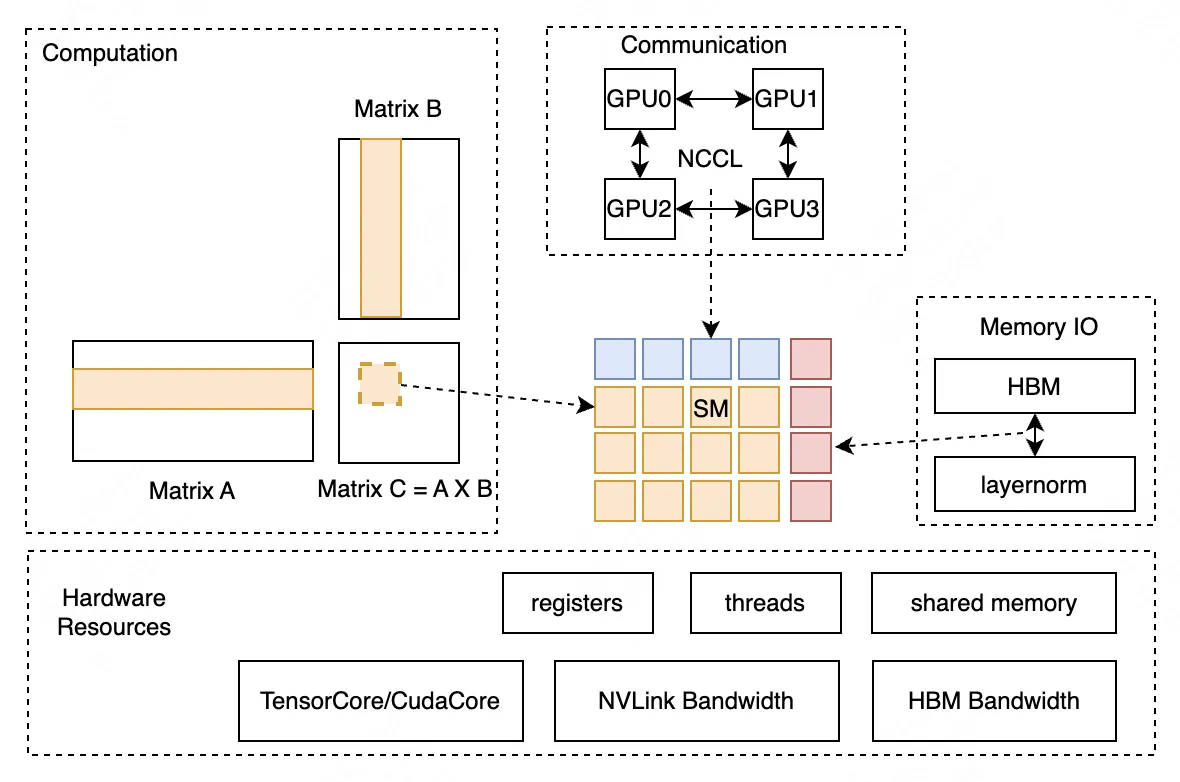
关键观察:
- 不同类型的kernel对SM(Streaming Multiprocessor)的需求不同
- 通信kernel仅需10-20个SM即可达到最优性能
- 内存Bound kernel也存在类似特性
GroupGemm vs DenseGemm
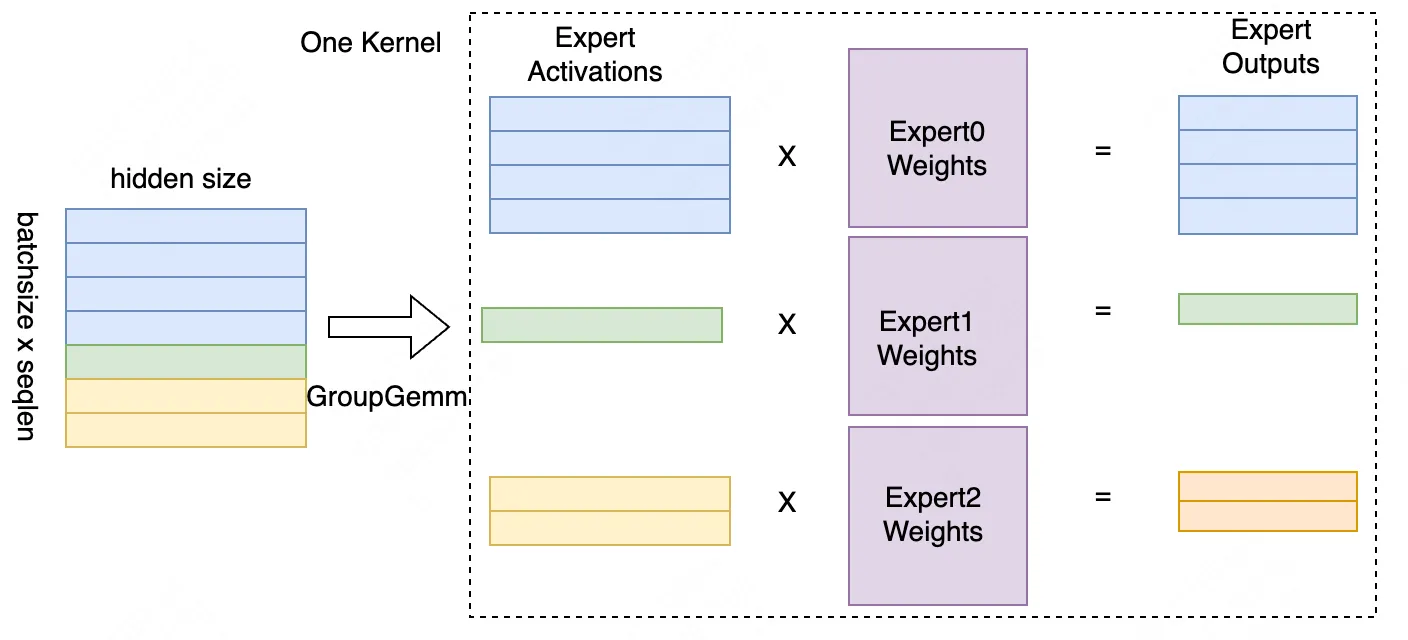
GroupGemm特点:
- 所有专家的矩阵乘法在单个kernel中完成
- 适合大batch size场景
DenseGemm特点:
- 将多个小batch拼接成大batch执行
- 在小batch size下效率更高
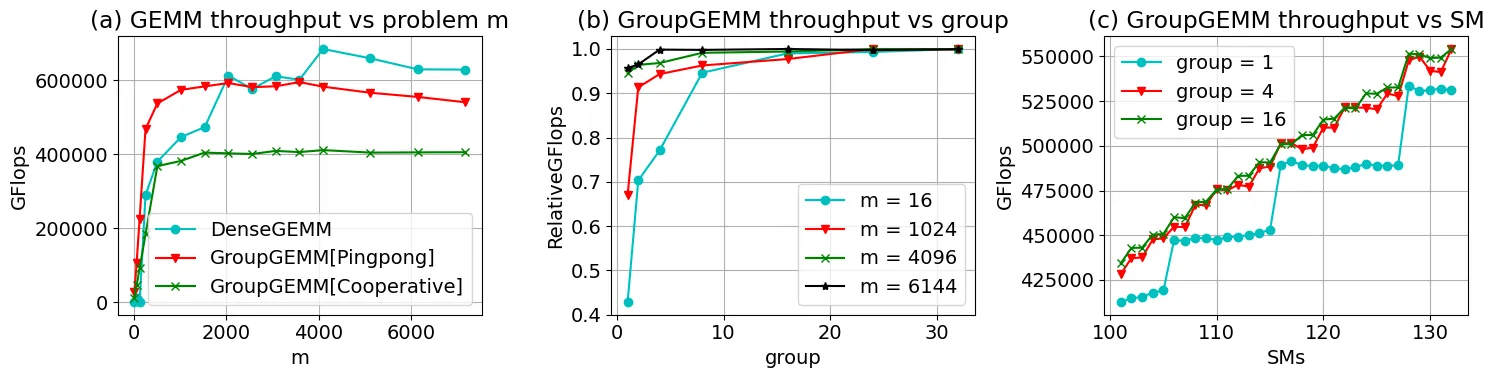
性能对比:
- 在小输入时,DenseGemm吞吐量更高
- 在大输入时,GroupGemm效率更优
- 存在一个交叉点,需要动态选择
通信与计算分析
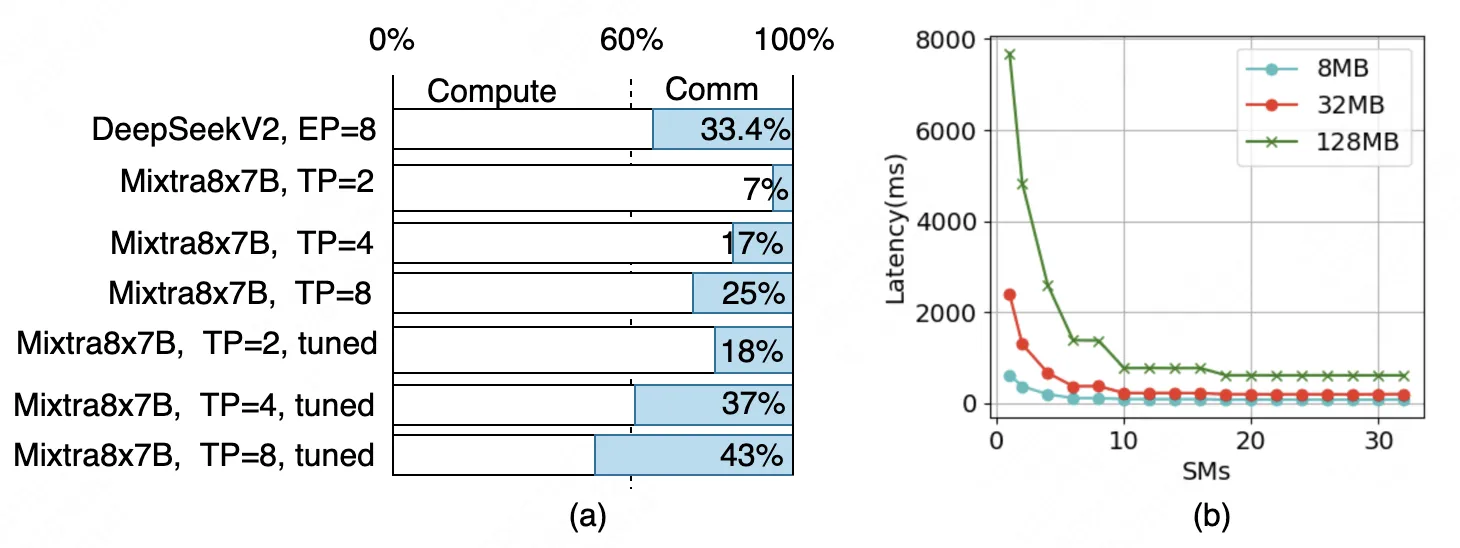
All2All通信特性:
- 10-20个SM即可达到最优延迟
- 增加更多SM不会显著改善性能
- 为计算通信重叠提供了机会
专家流水线调度器
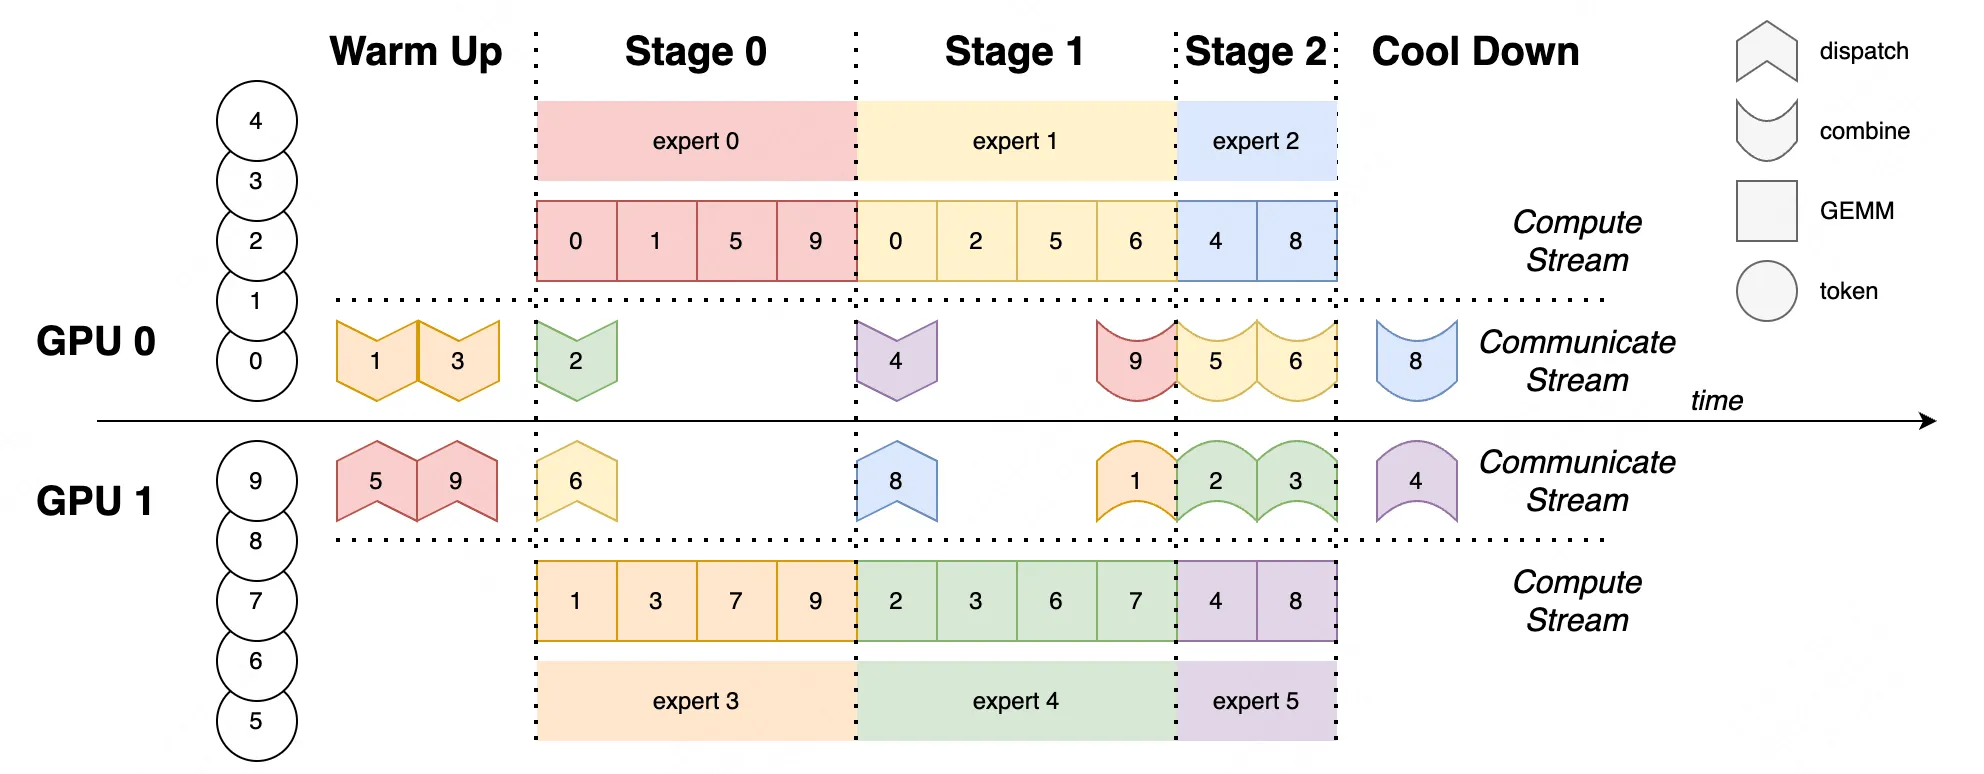
核心设计:
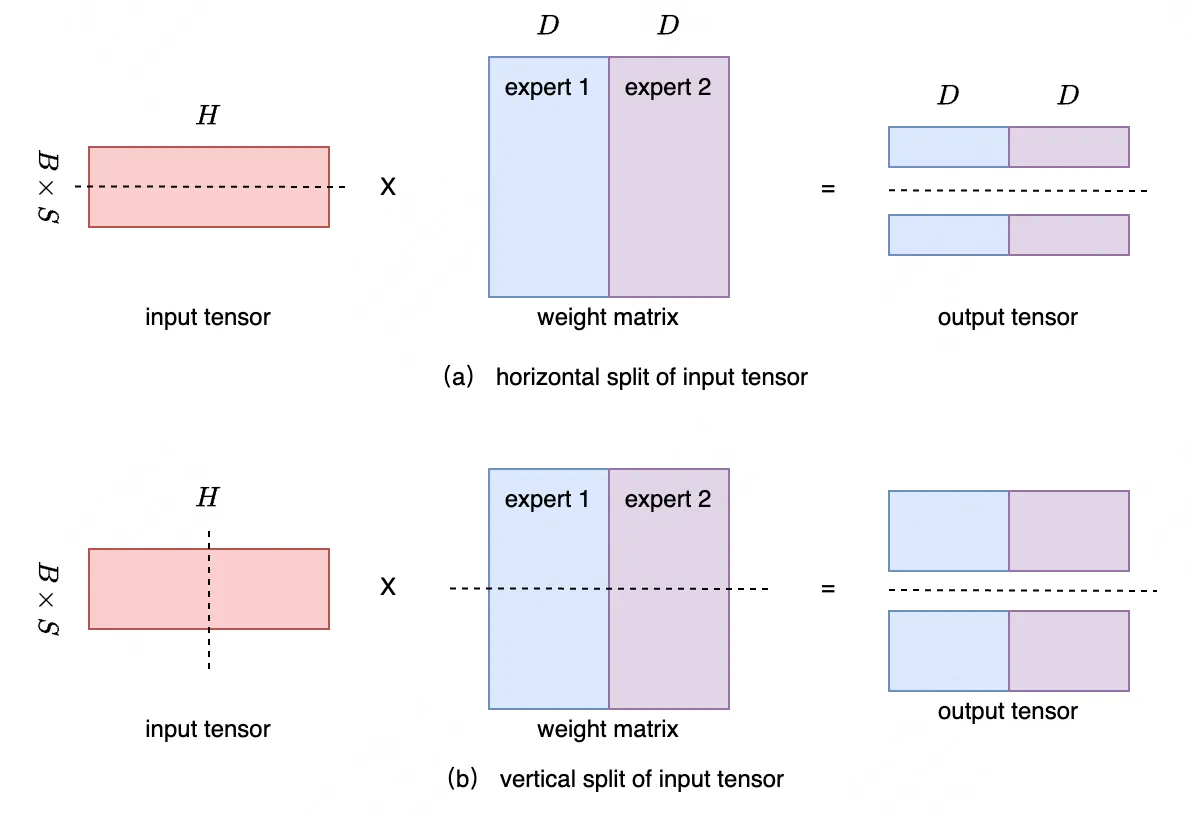
-
水平切分(Horizontal Split):
- 按行切分输入tensor
- 权重按专家切分
- I/O数据量:V(a) = m·P₀ + E·W + m·P₁
-
垂直切分(Vertical Split):
- 按列切分输入tensor
- 权重按列切分
- I/O数据量:V(b) = m·P₀ + E·W + N·m·P₁
关键优势:水平切分的I/O数据量远小于垂直切分。
计算通信重叠
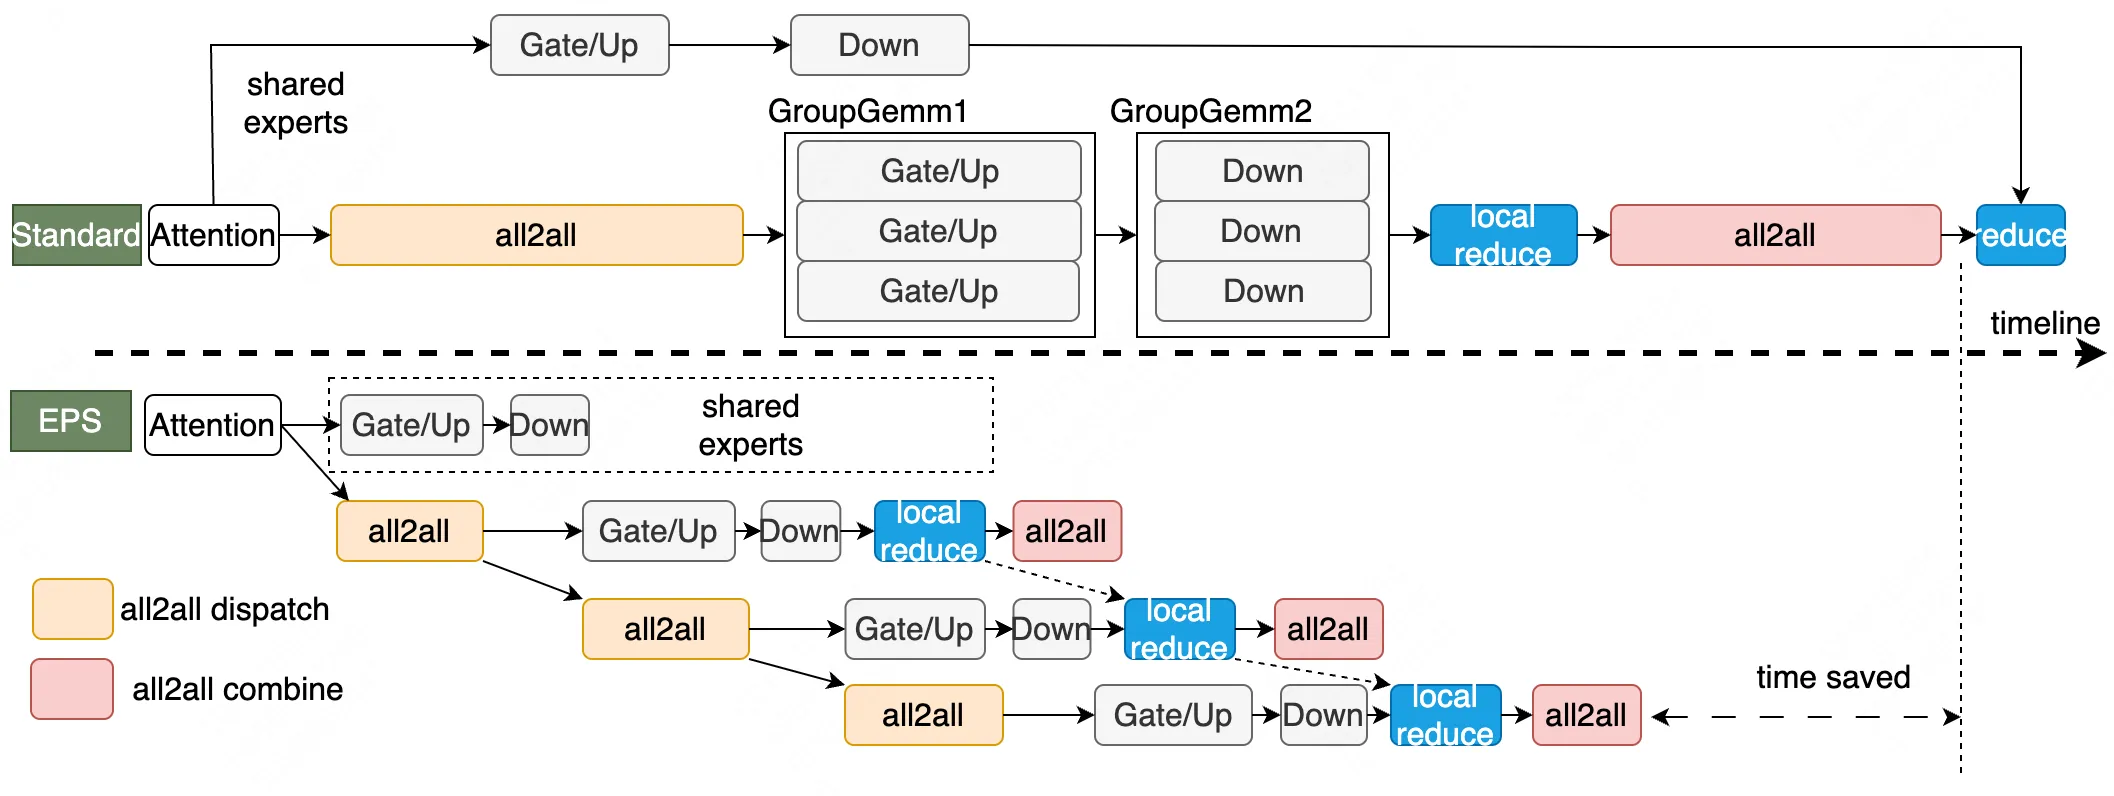
重叠策略:
- 当一个token的所有专家计算完成后,立即启动下一轮All2All通信
- LocalReduce是内存Bound操作,可以与通信重叠
- 通信仅需少量SM,剩余SM可用于计算
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 动态GEMM选择 | 根据token数量选择GroupGemm或DenseGemm | GEMM性能分析实验 |
| 专家流水线并行 | 将MoE FFN计算流水线化 | I/O数据量分析 |
| 计算通信重叠 | All2All通信与专家计算重叠 | 通信SM需求实验(10-20个即可) |
| 并行策略优化 | DP+EP或TP+EP替代传统TP+TP | 内存访问量分析 |
五、实验结果
实验设置
测试平台:
- 8×H800-80GB SXM(DeepSeekV2、DBRX)
- 4×H800-80GB SXM(Mixtral 8x7B)
测试模型:
- DeepSeekV2:细粒度MoE(160个专家,topk=6)
- Mixtral 8x7B:粗粒度MoE(8个专家,topk=2)
- DBRX:中等粒度MoE(16个专家,topk=4)
- Snowflake Arctic:并行结构MoE
DeepSeekV2结果
Prefill吞吐量提升:
| Pipeline Number | 1K seq | 2K seq | 4K seq | 8K seq |
|---|---|---|---|---|
| PN=1 (无流水线) | +11.83% | +11.02% | +6.77% | +5.13% |
| PN=5 | +21.81% | +20.53% | +16.89% | +12.75% |
| PN=20 | +21.27% | +18.05% | +10.00% | +11.60% |
关键发现:
- 在2K序列长度下达到最大**21.81%**提升
- DeepSeekV2基准已很高(100K tokens/s),提升显著
Mixtral 8x7B和DBRX结果
Mixtral 8x7B TTFT降低:
| 配置 | 2K seq | 4K seq | 8K seq | 16K seq |
|---|---|---|---|---|
| TP+EP | -13.7% | -9.5% | -8.9% | -8.3% |
| PN=1 | -17.7% | -18.9% | -18.5% | -15.7% |
| PN=2 | -21.7% | -22.7% | -21.8% | -17.7% |
DBRX TTFT降低:
| 配置 | 0.5K seq | 1K seq | 2K seq | 4K seq |
|---|---|---|---|---|
| TP+EP | -19.8% | -21.8% | -24.4% | -25.1% |
| PN=1 | -22.0% | -24.2% | -25.3% | -25.7% |
| PN=2 | -25.3% | -28.7% | -30.0% | -30.3% |
关键发现:
- DBRX(更多专家、更大topk)获益更大
- PN=2比PN=1额外提升约4.8%
- 从TP+TP切换到TP+EP贡献了约8-13%提升
Snowflake Arctic结果
| 配置 | 2K seq | 4K seq |
|---|---|---|
| PN=4 | -0.26% | -0.57% |
| PN=8 | -1.26% | -0.96% |
分析:对于已有并行结构的模型,收益主要来自GroupGemm到DenseGemm的切换。
GEMM性能对比
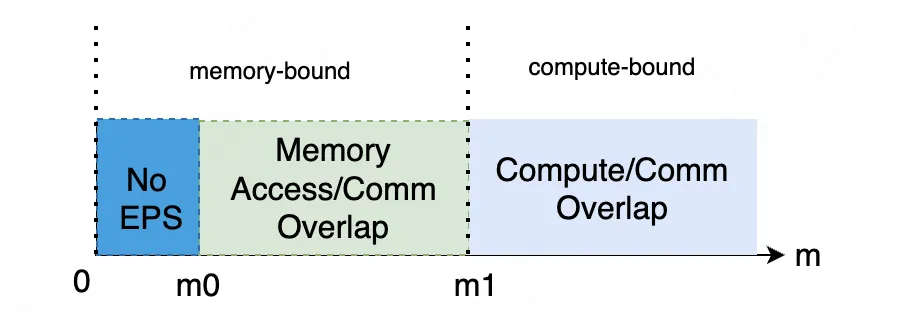
不同配置下的性能差异:
- 512×5120×1536:小规模,DenseGemm优势明显
- 2048×5120×1536:中等规模,性能差异缩小
- 512×5120×14336:大规模,GroupGemm开始占优
六、相关工作
| 方法 | 特点 | EPS-MoE优势 |
|---|---|---|
| Nanoflow | 细粒度batch流水线 | 专门针对MoE优化 |
| vLLM | TP+TP并行 | DP+EP或TP+EP更优 |
| DeepSeekV2官方 | 高效推理基准 | 进一步提升21.8% |
| Mooncake | 分离式PD服务 | 专注于MoE优化 |
七、总结
核心贡献
- 专家流水线调度器:将MoE FFN计算流水线化,实现计算通信重叠
- 动态GEMM选择:根据负载在GroupGemm和DenseGemm间动态切换
- 并行策略优化:为不同类型MoE模型设计最优并行方案
- 显著性能提升:最高**52.4%**预填充吞吐量提升(DBRX)
技术影响
- 为MoE模型推理提供了新的优化范式
- 细粒度MoE模型(如DeepSeekV2)更适合专家流水线
- 与现有推理框架(如vLLM)可无缝集成
- 为分离式PD服务架构提供了参考
局限性
- 主要优化预填充阶段,对解码阶段优化有限
- 对已有并行结构的模型(如Snowflake Arctic)收益较小
- 需要特定硬件支持(NVLink等高速互联)
- 未探索与其他优化技术(如量化、剪枝)的结合
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | DP/TP/EP权重划分策略 | figure1-weight-partition.png |
| Figure 2 | MoE架构分析 | figure2-moe-architecture.png |
| Figure 3 | GPU资源视图 | figure3-gpu-resources.png |
| Figure 4 | GroupGemm演示 | figure4-groupgemm.png |
| Figure 5 | GEMM性能分析 | figure5-gemm-profiling.png |
| Figure 7 | 通信计算分析 | figure7-comm-compute.png |
| Figure 8 | 专家流水线调度器 | figure8-expert-pipeline.png |
| Figure 9 | 切分方法对比 | figure9-split-methods.png |
| Figure 10 | GEMM性能对比 | figure10-benefit-range.png |