DuoAttention: Efficient Long-Context LLM Inference with Retrieval and Streaming Heads
通过区分检索头和流式头,同时优化长上下文LLM推理的内存和计算效率
DuoAttention: Efficient Long-Context LLM Inference with Retrieval and Streaming Heads
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DuoAttention: Efficient Long-Context LLM Inference with Retrieval and Streaming Heads |
| 作者 | Zhenglun Kong, Peiyan Dong, Xiaolong Ma, et al. (Song Han, et al.) |
| 机构 | MIT, Harvard |
| 论文 | arXiv:2410.10819 |
| 发布 | 2024年10月14日 |
二、核心思想
DuoAttention通过识别LLM注意力头的功能分化(检索头 vs 流式头),对不同类型头采用不同的KV缓存策略,在保持长上下文能力的同时显著降低内存和计算开销。
关键发现
-
注意力头的功能分化:只有少数”检索头”(Retrieval Heads)需要完整的KV缓存来处理长距离依赖;大多数”流式头”(Streaming Heads)只关注近期token和注意力汇聚点(attention sinks)
-
优化驱动的头识别:通过可训练的门控值 直接测量压缩KV缓存对模型输出的影响,比基于注意力分数的方法更准确
-
混合注意力机制:检索头使用完整注意力,流式头使用流式注意力(仅保留sink和recent tokens),两者输出通过门控值加权混合
-
量化兼容:与8-bit权重和4-bit KV缓存量化完全兼容,可将Llama-3-8B的上下文容量扩展至3.3M tokens
三、技术架构
整体框架
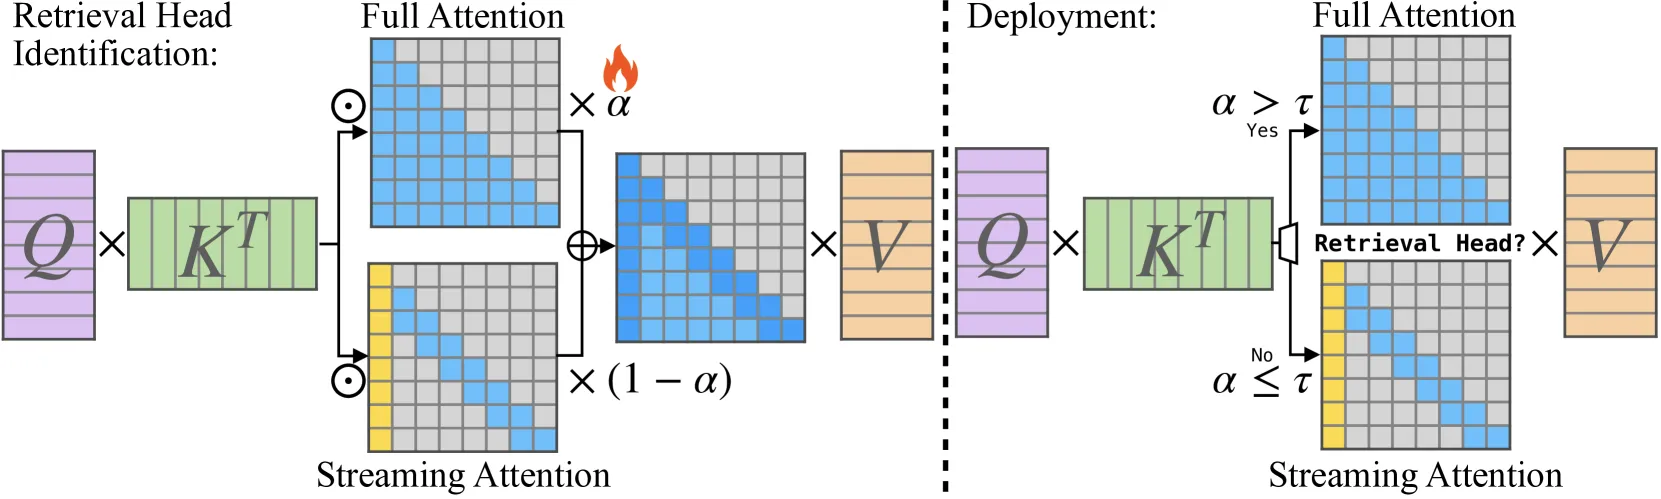
DuoAttention的核心是将注意力头分为两类:
- 检索头:,保留完整KV缓存,执行全注意力
- 流式头:,仅保留sink和recent tokens,执行流式注意力
注意力模式分析
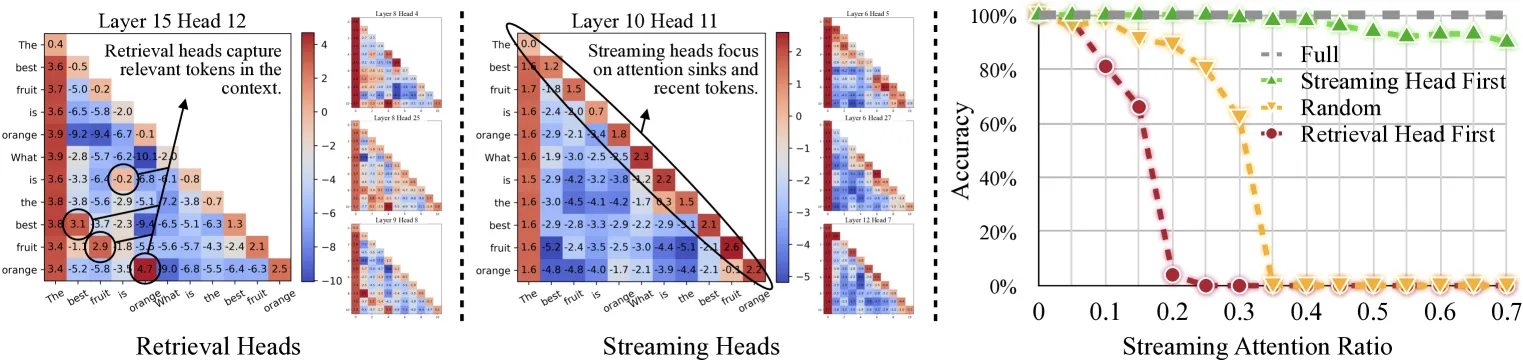
以句子”The best fruit is orange. What is the best fruit? Orange.”为例:
- 检索头:解码”orange”时高亮上下文中首次出现的”orange”,展现出长距离检索能力
- 流式头:主要关注近期token和初始token(attention sinks),不关注中间历史token
核心公式
混合注意力计算:
其中:
是Λ形掩码,仅允许注意力到初始tokens(sinks)和最近tokens。
蒸馏损失:
仅在最后 个passkey token上计算损失,聚焦于长距离检索能力的保持。
正则化损失:
促使更多头趋向流式注意力(),实现稀疏化。
总损失:
检索头识别
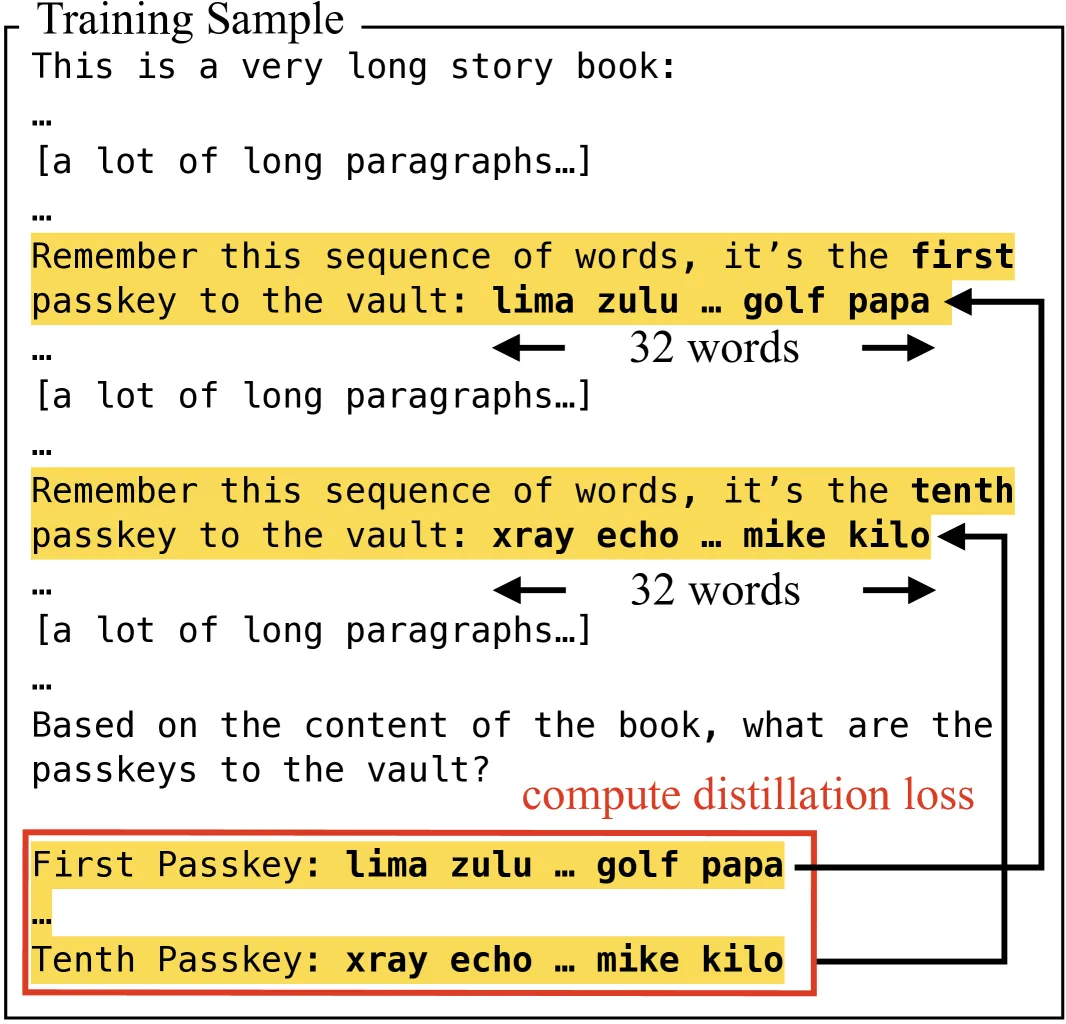
优化驱动识别(区别于基于注意力分数的方法):
- 为每个KV头初始化门控值
- 使用合成passkey检索数据集训练门控值(LLM参数冻结)
- 门控值收敛后,根据阈值 二值化:
合成数据集设计:
- 在长文本中嵌入10个随机生成的32词passkey
- 询问模型检索特定passkey
- 覆盖50个长度区间(1000 tokens到模型最大长度)
优化优势:
- 训练参数仅 个浮点数(如Llama-2-7B: 32×32 = 1024个)
- 2000步即可收敛
- 8×A100 GPU即可完成
推理流程
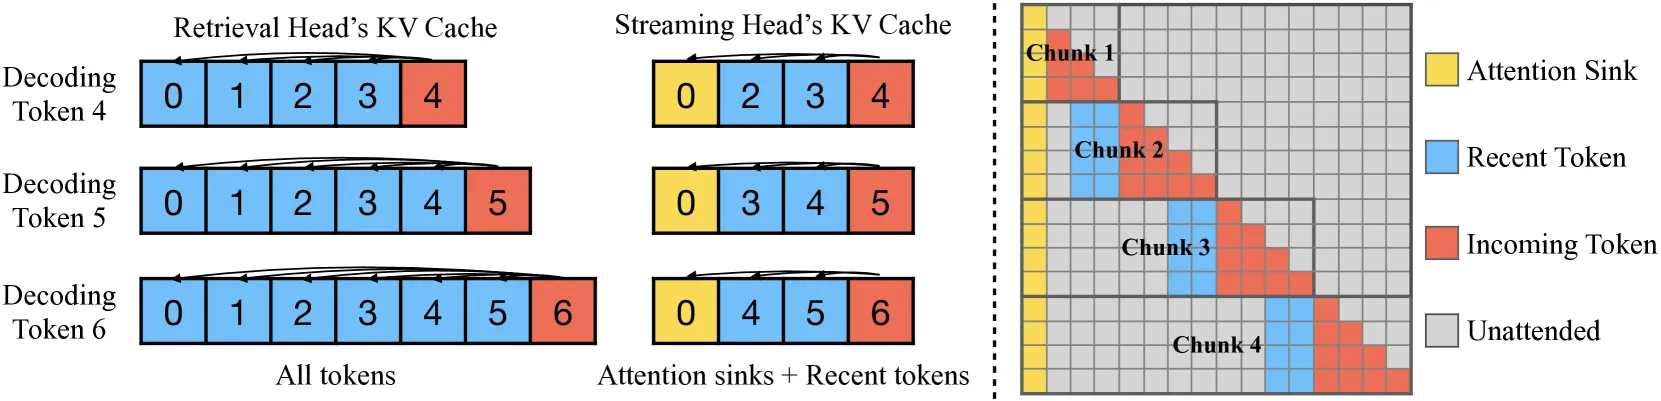
解码阶段:
- 为每层维护两个KV缓存:检索头缓存(完整)和流式头缓存(仅sink+recent)
- 新token的Q、K、V沿头维度分割,分别计算
- 结果沿头维度拼接后进行输出投影
预填充阶段:
- 兼容chunked pre-filling
- 流式头的预填充可在线性时间和恒定内存内完成
- 检索头使用标准FlashAttention
模型部署优化
权重重排序:部署前根据头类型重排Q、K、V投影权重的输出通道,将检索头和流式头分组为连续块,便于高效切片和拼接操作。
批量处理友好:设计适合批量操作,可在大batch size服务场景中进一步提升效率。
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 检索头/流式头二分法 | 识别功能分化的注意力头 | 精准分配计算资源 |
| 优化驱动识别 | 基于输出影响而非注意力分数 | 比FastGen、RazorAttention更准确 |
| 合成数据集 | 专门设计的passkey检索任务 | 有效激发长距离检索能力 |
| 混合注意力 | 全注意力+流式注意力加权 | 无缝集成,无需架构修改 |
| 量化兼容 | 与8-bit/4-bit量化组合 | 最大化内存节省 |
与现有方法对比
| 方法 | 加速解码 | 加速预填充 | 无需训练 | 无需预计算 | 保持长上下文 |
|---|---|---|---|---|---|
| H2O | ✓ | ✗ | ✓ | ✓ | ✗ |
| StreamingLLM | ✓ | ✗ | ✓ | ✓ | ✗ |
| TOVA | ✓ | ✗ | ✓ | ✓ | ✗ |
| FastGen | ✓ | ✗ | ✓ | ✗ | 部分 |
| MInference | ✗ | ✓ | ✓ | ✗ | ✓ |
| DuoAttention | ✓ | ✓ | ✗* | ✓ | ✓ |
*DuoAttention需要轻量级门控值优化(非模型微调)
五、实验结果
评估设置
| 项目 | 配置 |
|---|---|
| 模型 | Llama-2-7B-32K-Instruct, Llama-3-8B-Instruct-Gradient-1048k, Mistral-7B-v0.2 |
| 长上下文基准 | Needle-in-a-Haystack (NIAH), LongBench |
| 短上下文基准 | MMLU, MBPP, MT-Bench |
| 硬件 | NVIDIA A100 GPU |
| 检索头比例 | Llama-2-7B: 25%, Llama-3-8B: 50% |
Needle-in-a-Haystack
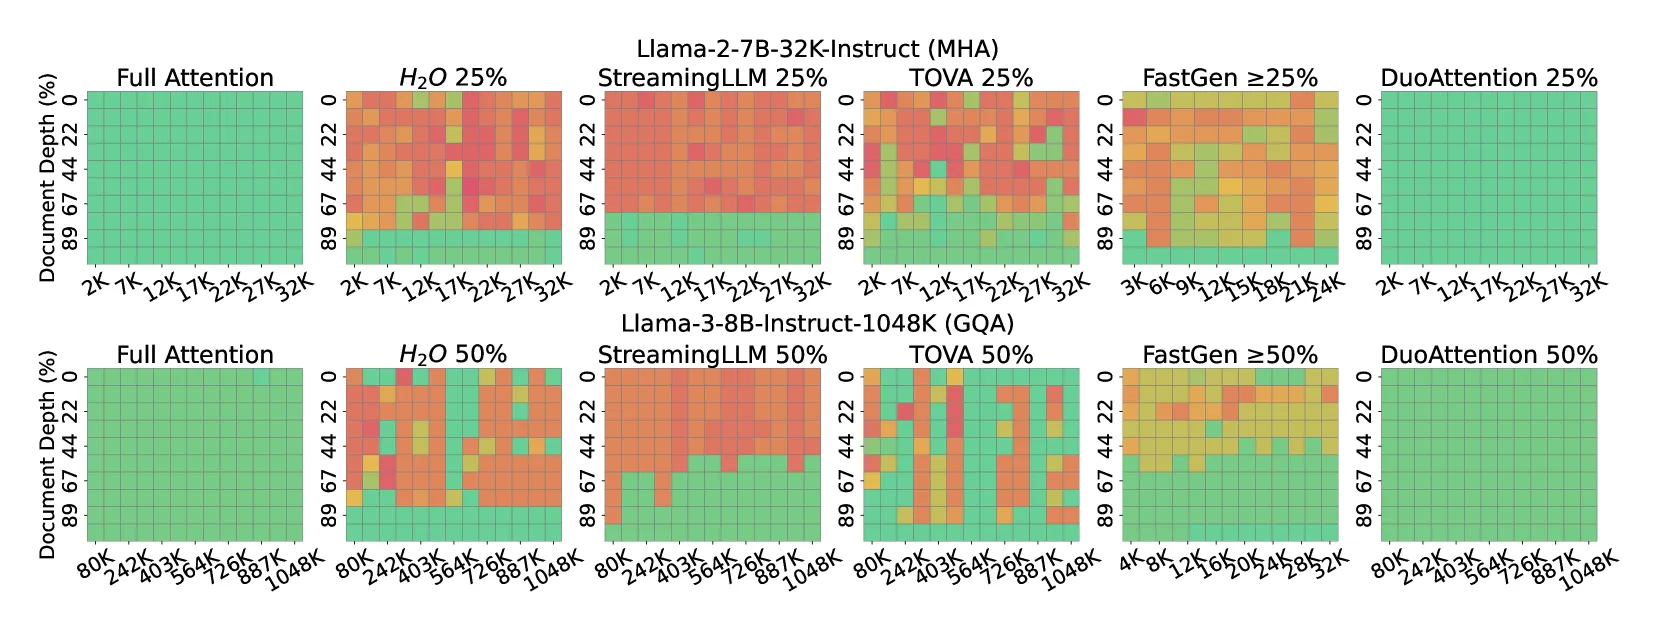
- DuoAttention:25%全注意力比例下,在各种深度和上下文长度下保持接近100%准确率
- H2O、TOVA、StreamingLLM:在不同深度和长度下均出现显著失败
- 关键原因:DuoAttention保留了检索头的完整KV缓存
LongBench评估
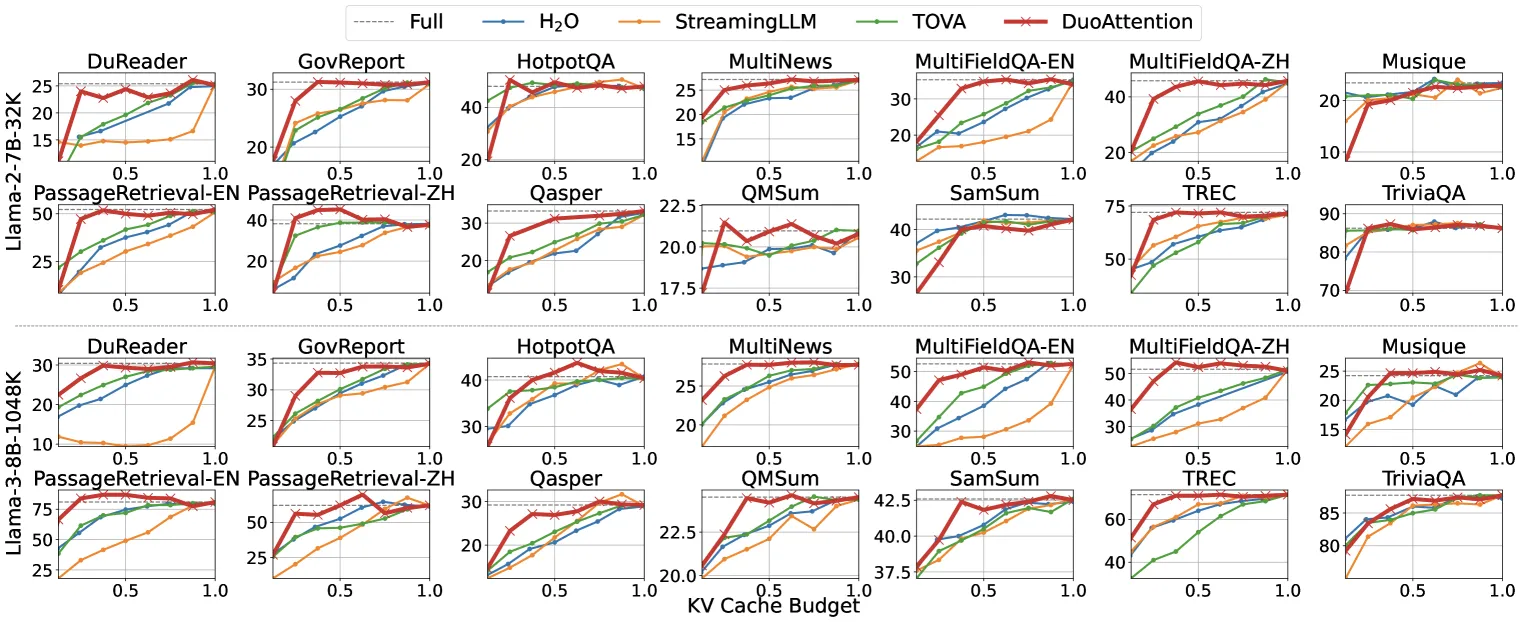
在14个LongBench任务上:
- DuoAttention在大多数任务上实现了KV预算与精度的最佳权衡
- 使用25% KV预算(MHA)和50% KV预算(GQA)时,性能接近全注意力
- 与H2O、TOVA、StreamingLLM相比,在相同KV预算下精度更高
短上下文基准
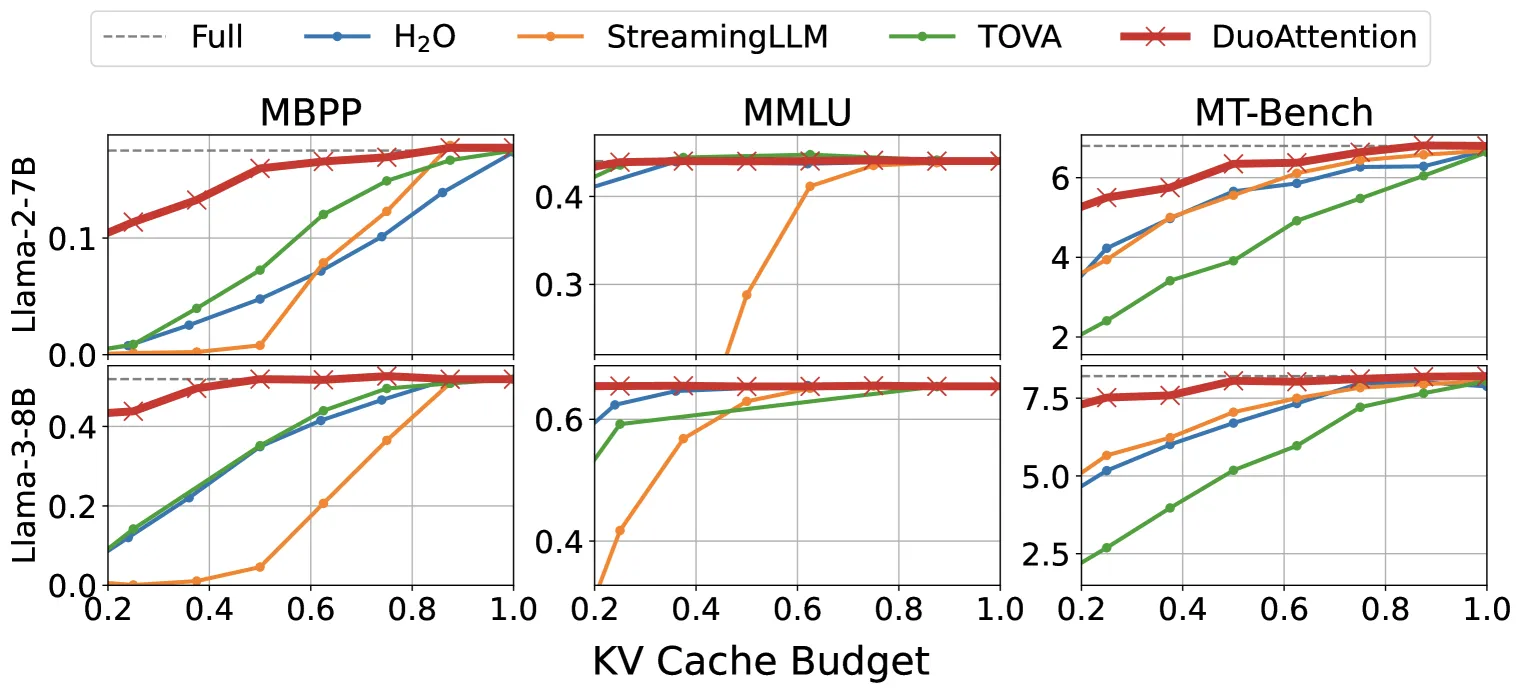
Table 1: Llama-3-70B短上下文结果
| 方法 | KV预算 | MMLU | MBPP | MT-Bench |
|---|---|---|---|---|
| Full Attention | 100% | 73.6 | 55.8 | 8.25 |
| StreamingLLM | 13% | 68.5 | 48.6 | 7.20 |
| H2O | 13% | 69.7 | 45.4 | 7.25 |
| DuoAttention | 13% | 72.7 | 55.4 | 8.05 |
DuoAttention在短上下文任务上显著优于所有基线,最接近全注意力性能。
解码性能
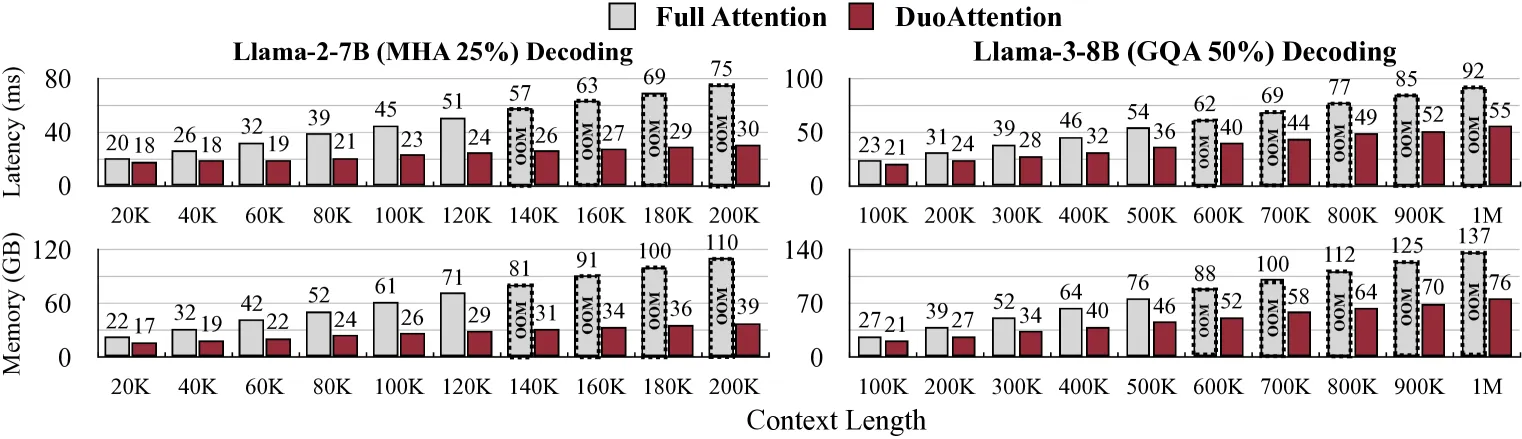
- 延迟:DuoAttention的解码速度随上下文长度线性增长,但斜率更平缓
- MHA模型(Llama-2-7B):最高2.18×加速
- GQA模型(Llama-3-8B):最高1.50×加速
- 内存:内存使用显著降低,改善幅度接近检索头比例的倒数
预填充性能
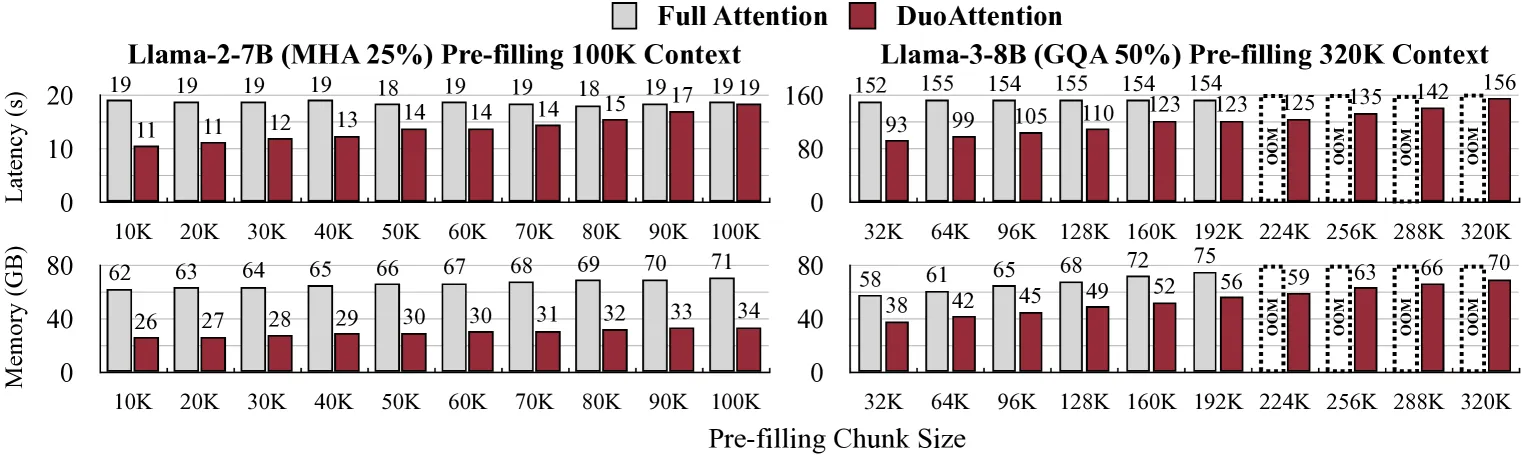
- 延迟:
- MHA模型:最高1.73×加速
- GQA模型:最高1.63×加速
- 内存:
- MHA模型:最高2.38×降低
- GQA模型:最高1.53×降低
- 加速效果随预填充chunk size减小而增强
KV预算与精度权衡
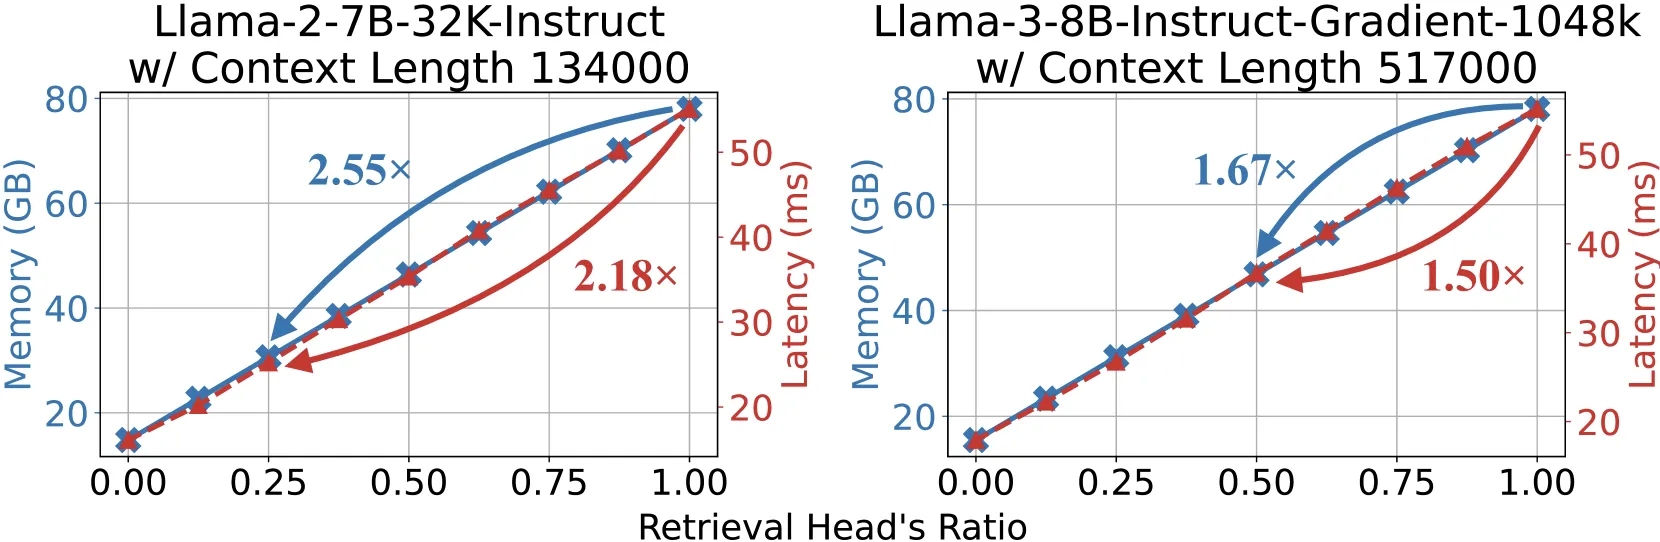
- 解码延迟和内存随检索头比例线性降低
- 精度在较大比例范围内保持稳定
- 提供灵活的精度-效率权衡选择
量化组合
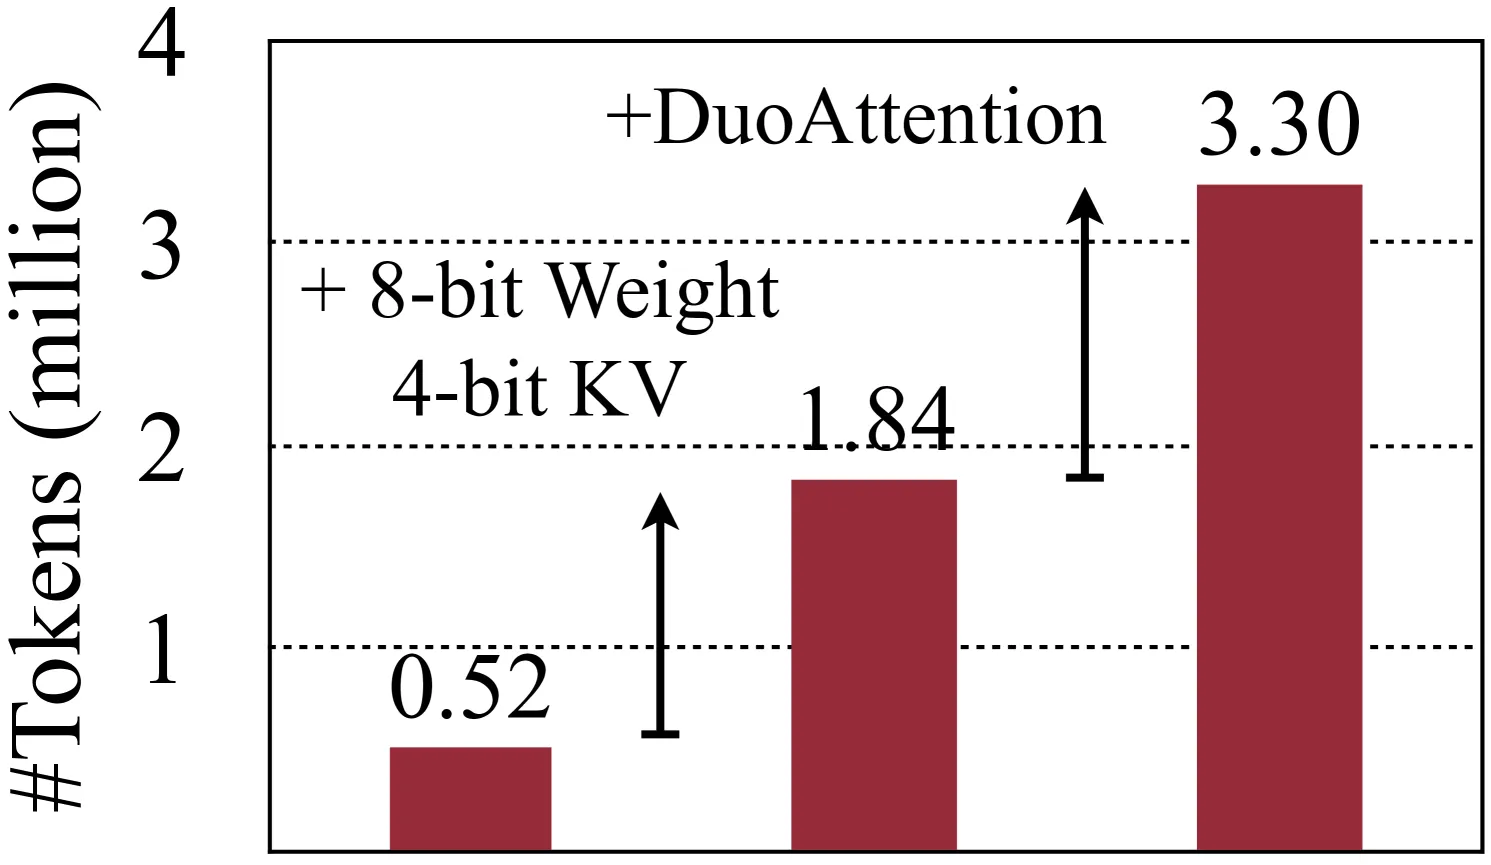
结合8-bit权重和4-bit KV缓存量化:
- Llama-3-8B单卡A100可处理330万tokens
- 相比标准FP16全注意力部署,容量提升6.4倍
- 精度损失可忽略
消融实验
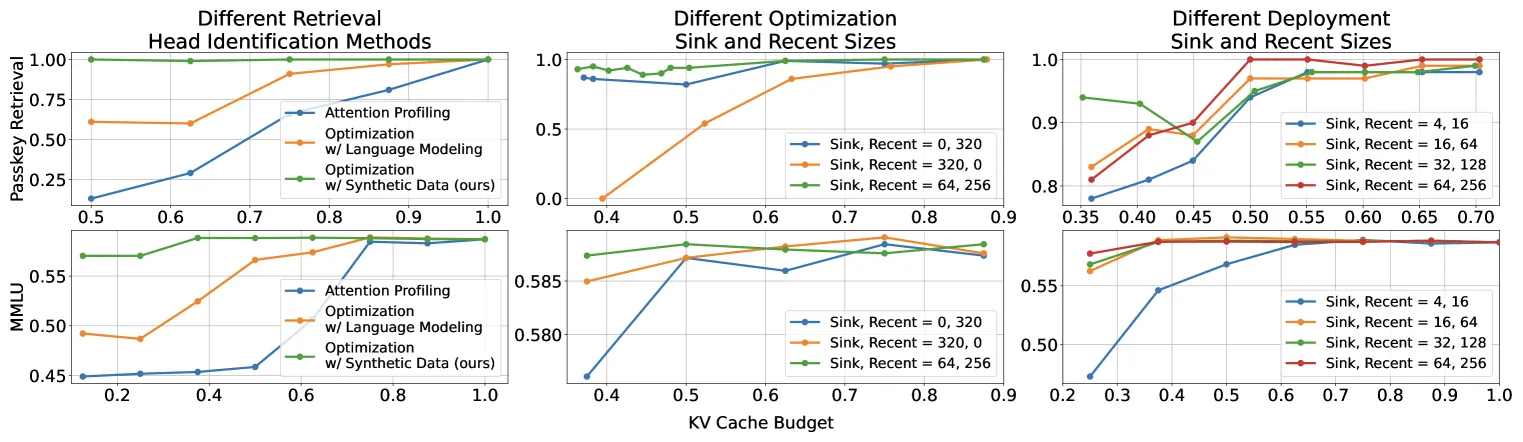
1. 检索头识别方法对比:
- 优化驱动方法 >> 注意力分数分析(FastGen、RazorAttention)
- 合成数据集 >> 自然语言建模目标
2. sink + recent注意力组合:
- 仅使用sink或仅使用recent注意力均不足以有效识别检索头
- 两者组合是最优选择
3. sink/recent token数量:
- 性能在16个sink tokens和64个recent tokens时达到平台
- 进一步增加收益边际
六、相关工作
| 方向 | 代表工作 | DuoAttention优势 |
|---|---|---|
| 架构修改 | GQA, MQA, Linear Attention | 无需重新训练,保持长上下文能力 |
| KV缓存压缩 | H2O, TOVA, StreamingLLM | 同时加速预填充和解码 |
| 预填充加速 | MInference | 同时优化解码和内存 |
| 头分类 | FastGen, RazorAttention | 基于输出影响的更准知识别 |
| 量化 | QServe, KIVI | 完全兼容,可组合使用 |
| 系统优化 | vLLM, FlashAttention | 互补,可叠加优化效果 |
七、总结
核心贡献
- 提出检索头/流式头二分法,揭示LLM注意力头的功能分化
- 设计优化驱动的检索头识别方法,使用合成数据集和可训练门控值
- 实现混合注意力机制,检索头使用全注意力,流式头使用流式注意力
- 同时优化解码和预填充的延迟与内存
- 与量化技术完全兼容,实现3.3M tokens单卡部署
技术影响
- 为KV缓存压缩提供了新的视角:不是压缩所有头,而是区分对待
- 优化驱动的识别方法比基于启发式的方法更可靠
- 已在主流开源模型(Llama-2、Llama-3、Mistral)上验证有效性
- 为百万级上下文部署提供了实用解决方案
局限性
- 需要轻量级训练过程(2000步,8×A100)
- 合成数据集的设计需要针对特定任务
- 检索头比例需要根据模型架构调整(MHA vs GQA)
- 当前主要在7B-70B规模模型上验证