PipeFill: Using GPUs During Bubbles in Pipeline-parallel LLM Training
PipeFill利用流水线并行训练中的气泡时间执行额外计算任务,提升GPU利用率。
PipeFill: Using GPUs During Bubbles in Pipeline-parallel LLM Training
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | PipeFill: Using GPUs During Bubbles in Pipeline-parallel LLM Training |
| arXiv ID | 2410.07192 |
| 作者 | Daiyaan Arfeen, Zhen Zhang, Xinwei Fu, Gregory R. Ganger, Yida Wang |
| 提交日期 | 2024-09-23 |
| 会议 | Under review by MLSys Conference |
| 许可证 | CC BY 4.0 |
1.2 摘要
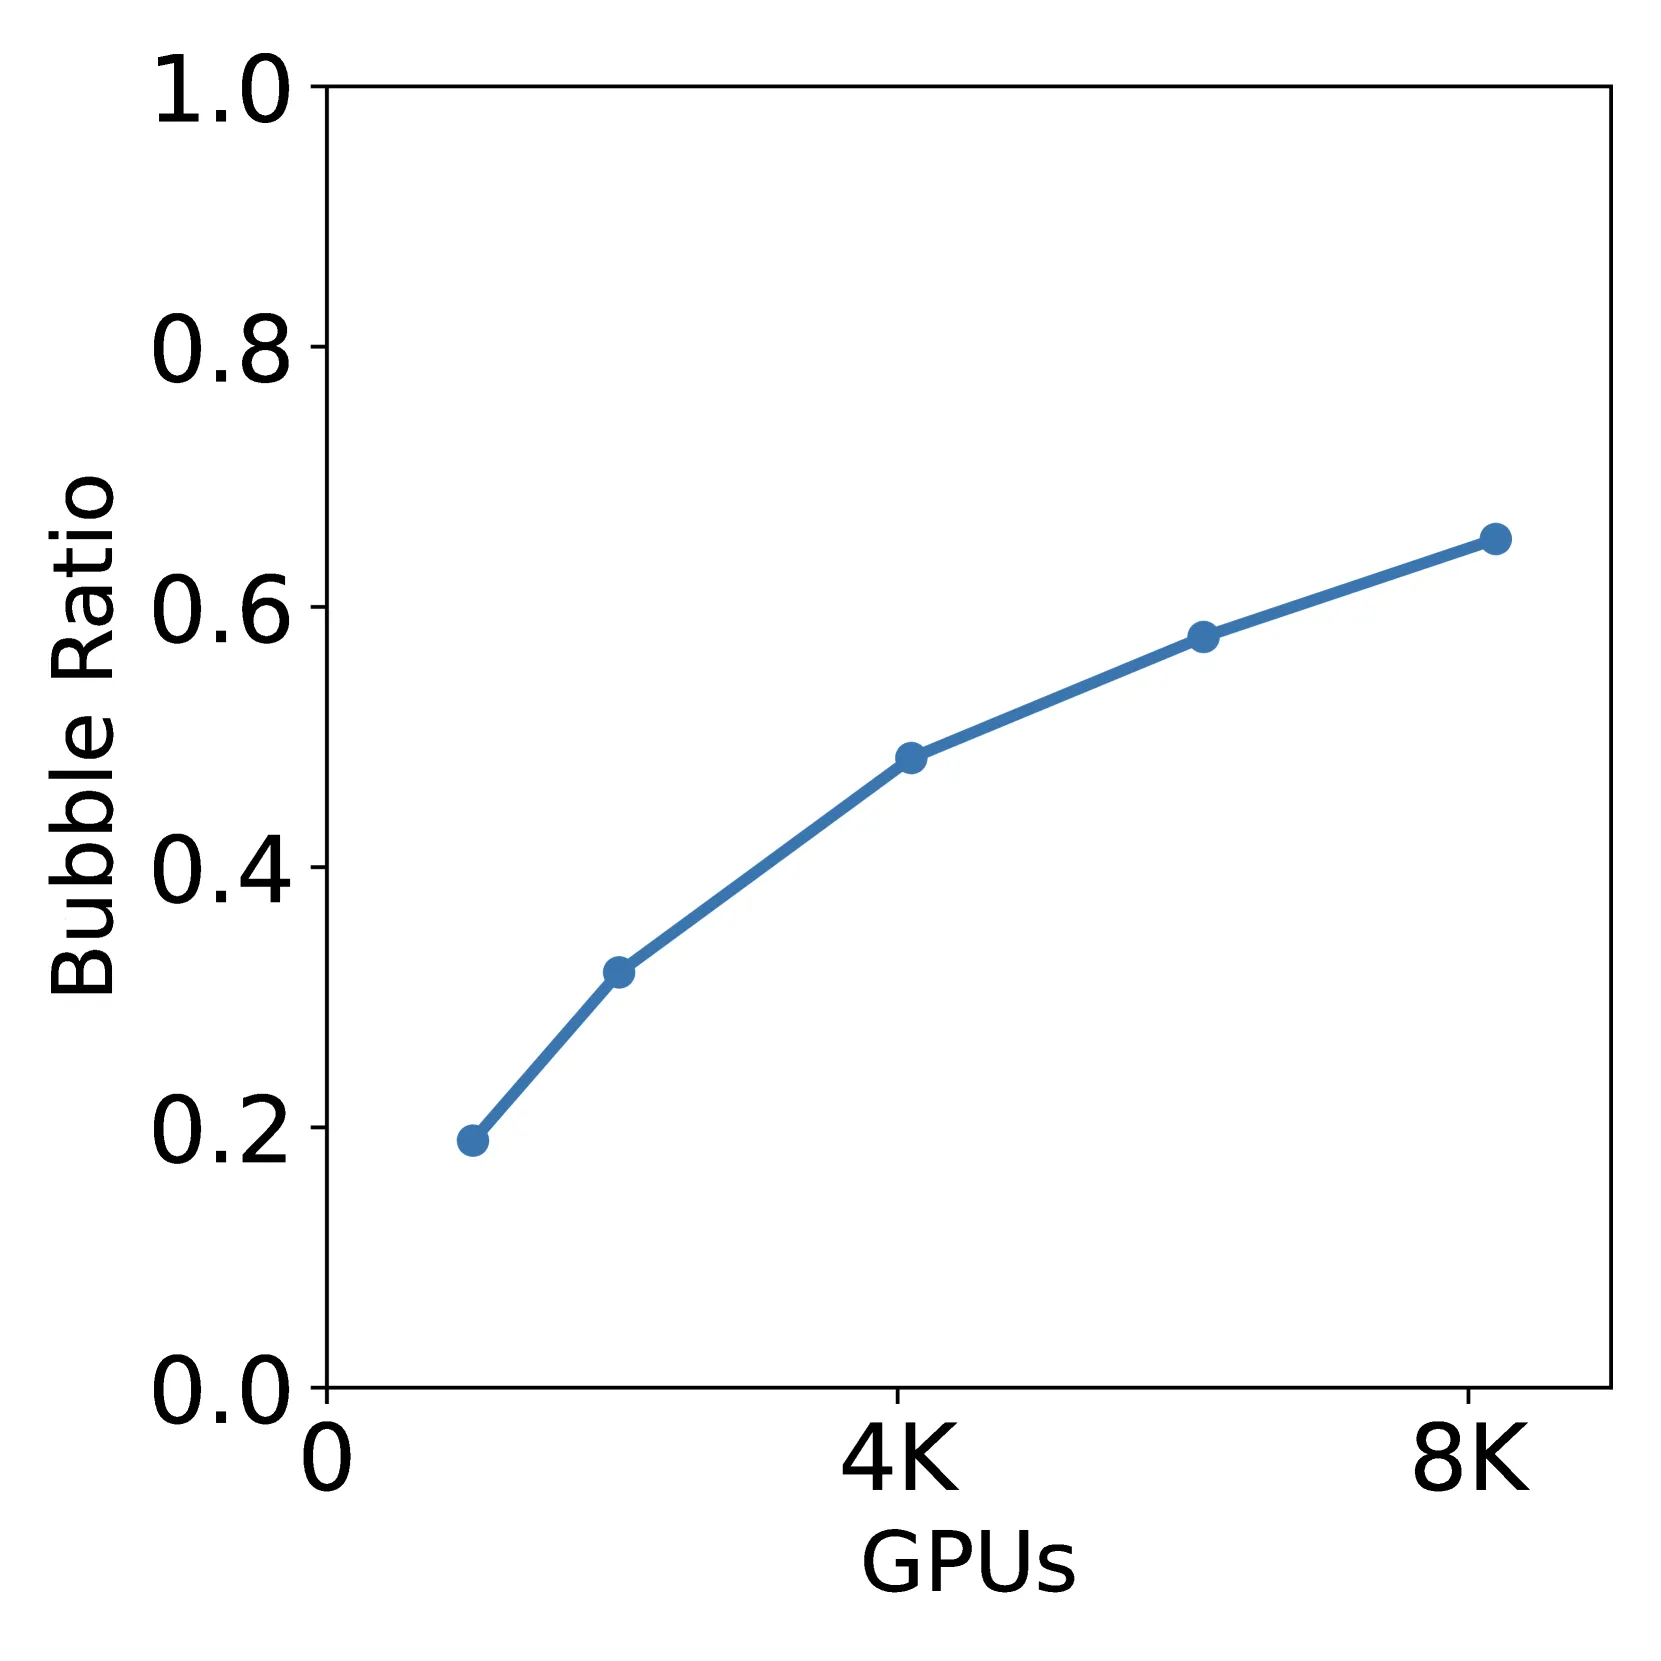
训练具有数十亿参数的深度神经网络(DNN)通常涉及流水线并行(PP)执行。然而,PP 模型训练可能会低效地使用 GPU,尤其是在大规模情况下,由于流水线气泡导致的 GPU 空闲时间通常占训练作业 GPU 分配的 15-30%,甚至可超过 60%。
为提高 PP 模型训练的 GPU 利用率,本文介绍了 PipeFill,它用其他待处理作业的执行来填充流水线气泡。通过利用气泡 GPU 时间,PipeFill 减少了与大规模模型训练扩展相关的 GPU 利用率损失。实验表明,PipeFill 可将大规模 LLM 训练中 GPU 的整体利用率提高最多 63%,训练作业仅减速 <2%,即使在低规模 LLM 训练中也能获得 5-15% 的利用率提升。对于 8K GPU 上的大规模 LLM 训练,63% 的利用率提升相当于额外完成多达 2.6K GPU 等量的工作。
二、核心思想
2.1 问题背景
在流水线并行训练中,流水线气泡(Pipeline Bubbles) 是导致 GPU 利用率低下的主要原因:
- 气泡产生原因:流水线必须在每个 minibatch 之前完全排空并重新启动,导致各 GPU 的空闲时间
- 气泡比例公式:
(p-1)/(m+p-1)p= 流水线级数(pipeline stages)m= 微批次(microbatches)数量
- 规模化问题:
- 从 1K GPU 扩展到 8K GPU 时,训练时间从 82 天减少到 26 天
- 但 GPU 利用率下降超过 60%
2.2 关键洞察
核心思想:在流水线气泡期间执行与主训练作业无关的独立作业(fill jobs),而不是尝试解决训练作业内部的数据依赖问题。
与现有工作(如 PipeFisher、Bamboo)不同,这些工作尝试用依赖于训练作业的计算来填充气泡,而 PipeFill 使用完全独立的作业来填充气泡,包括推理作业和训练作业。
2.3 面临的挑战
| 挑战 | 描述 |
|---|---|
| 内存管理 | GPU 内存主要被主训练作业占用,如何在气泡期间为填充作业分配内存? |
| 上下文切换 | 如何确保填充作业不影响主训练作业的性能? |
| 作业调度 | 面对异构特征的众多气泡,如何有效调度以满足用户目标? |
三、技术架构
3.1 系统总览
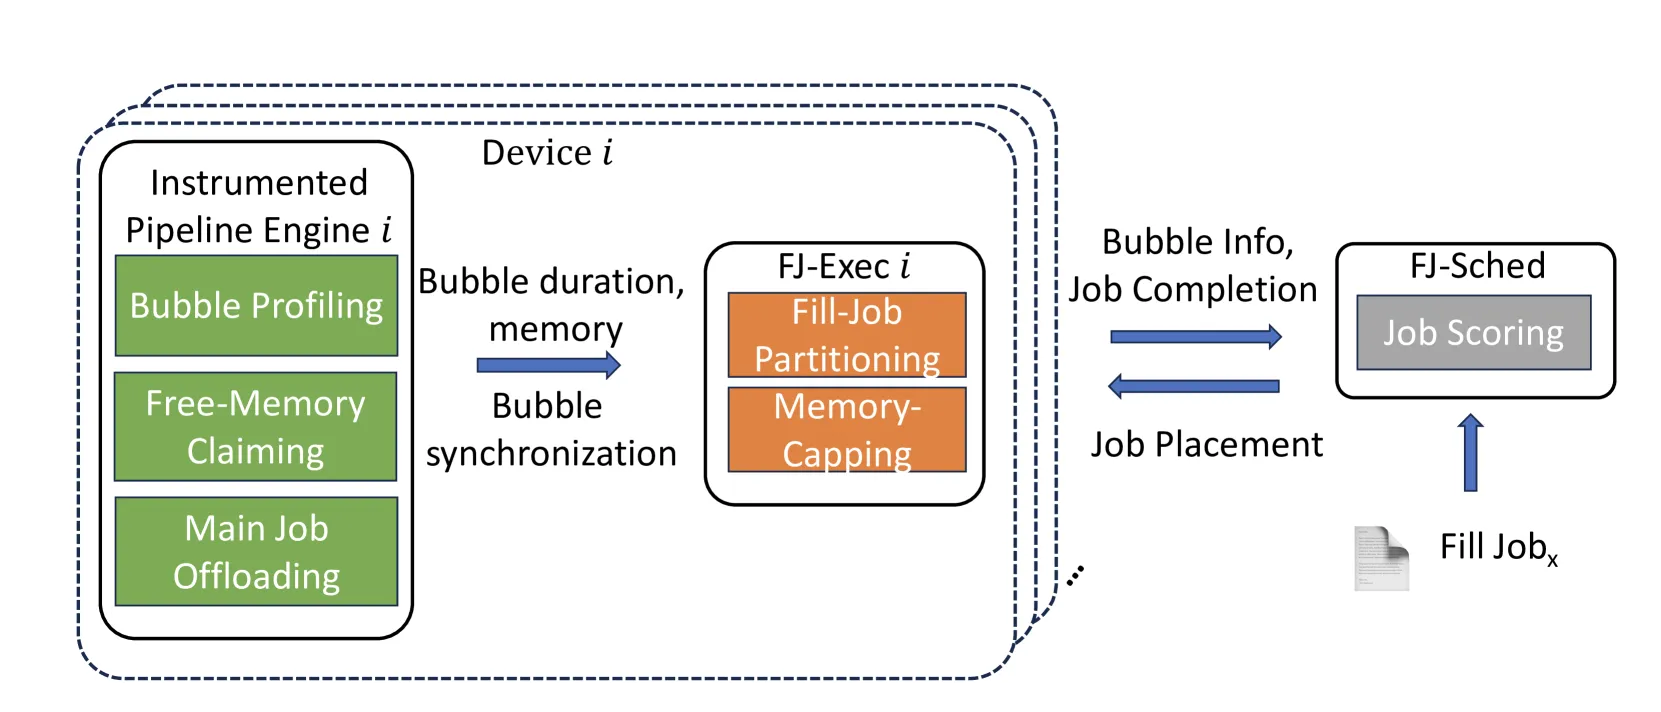
PipeFill 由三个主要组件构成:
┌─────────────────────────────────────────────────────────────┐
│                    PipeFill 系统架构                          │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│  ┌──────────────┐    ┌──────────────┐    ┌──────────────┐   │
│  │ Instrumented │    │   Fill Job   │    │ Fill Job     │   │
│  │   Pipeline   │───>│   Executor   │<───│  Scheduler   │   │
│  │    Engine    │    │              │    │              │   │
│  └──────────────┘    └──────────────┘    └──────────────┘   │
│         │                   │                   │           │
│         v                   v                   v           │
│  ┌──────────────────────────────────────────────────────┐  │
│  │                     GPU Device                       │  │
│  │  ┌─────────────────┐  ┌─────────────────────────┐    │  │
│  │  │  Main Job       │  │  Fill Jobs              │    │  │
│  │  │  (LLM Training) │  │  (Inference/Training)   │    │  │
│  │  └─────────────────┘  └─────────────────────────┘    │  │
│  └──────────────────────────────────────────────────────┘  │
└─────────────────────────────────────────────────────────────┘
3.2 组件详解
3.2.1 流水线引擎(Pipeline Engine)
功能:
- 插入流水线气泡指令(Pipeline Bubble Instructions) 标记气泡的开始和结束
- 测量气泡期间可用内存
- 在气泡开始时通知 Executor 执行填充作业
气泡特征描述:
- 在主训练作业开始时进行 profiling
- 逐步增加等待时间直到观察到主作业吞吐量下降
- 使用
torch.cuda.memory_allocated()确定可用内存
3.2.2 执行器(Executor)
功能:
- 为填充作业创建执行计划
- 选择批处理大小并对计算图进行分区
- 在气泡期间执行填充作业的图分区
核心算法(Algorithm 1: Partition fill job onto bubbles):
# 伪代码
def partition_fill_job(bubble_durations, bubble_memory, fill_job_graph):
    # 1. 复制图以最大化执行时间(不超过总气泡时间)
    F_prime = replicate_graph(fill_job_graph, bubble_durations)

    # 2. 贪心打包图节点到气泡中
    partitions = []
    for each bubble:
        partition = []
        while can_fit(next_node, bubble):
            partition.append(next_node)
        partitions.append(partition)

    return partitions
3.2.3 调度器(Scheduler)
功能:
- 接受用户定义的调度策略
- 将填充作业调度到设备的气泡上
- 计算填充作业在任何设备上的吞吐量/处理时间
支持的调度策略:
| 策略 | 公式 | 优化目标 |
|---|---|---|
| Shortest-Job-First (SJF) | f(j,s,i) = 1/min(j.proc_times) | 最小化平均作业完成时间 |
| Makespan-Minimizing | f(j,s,i) = 1/max(j.proc_times[i], s.rem_times) | 最小化最大忙碌时间 |
| Deadline-Aware | 组合多种策略 | 满足截止时间要求 |
四、核心创新
4.1 流水线气泡指令(Pipeline Bubble Instructions)
# 流水线引擎中的气泡指令示例
class PipelineBubbleInstruction:
    def __init__(self):
        self.bubble_duration = None  # 气泡持续时间
        self.free_memory = None      # 可用内存

    def execute(self):
        # 1. 释放临时内存缓冲区
        torch.cuda.empty_cache()

        # 2. 等待主作业卸载完成
        wait_for_offloading()

        # 3. 通知 Executor 开始执行
        signal_executor()
4.2 主作业内存卸载(Main Job Offloading)
为了增加填充作业可用的内存,PipeFill 支持将主作业的优化器状态(如 Adam 的动量估计)卸载到 CPU 内存:
- 卸载时机:与前向传播执行重叠
- 加载时机:与梯度同步重叠
- 效果:无性能影响的情况下释放大量内存
4.3 填充作业执行计划算法
填充作业执行面临的关键约束:
- 内存约束:只能使用约 25% 的 GPU 内存
- 时间约束:每个气泡只能执行有限时间
- 中断约束:气泡结束时必须中断执行
解决方案:
- 使用 ZeRO-Offload / ZeRO-Infinity 进行 CPU 卸载
- 激活检查点(Activation Checkpointing)
- 动态批处理大小调整
4.4 与现有方法的对比
| 特性 | PipeFill | PipeFisher | Bamboo | AntMan | Muri |
|---|---|---|---|---|---|
| 填充作业类型 | 独立作业 | 依赖作业(K-FAC) | 依赖作业(冗余计算) | 推理作业 | 多作业 |
| 适用范围 | 通用 LLM 训练 | K-FAC 优化 | 容错训练 | 弹性训练 | 通用 |
| 内存管理 | 动态卸载 | 无 | 无 | 内存上限 | 无 |
| 上下文切换 | 精确控制 | 固定 | 固定 | 内核级 | 无 |
| 调度策略 | 可配置 | 固定 | 固定 | 优先级 | 固定 |
五、实验结果
5.1 实验设置
| 配置项 | 物理集群 | 模拟器 |
|---|---|---|
| 硬件 | 16x AWS p3.16xlarge (128 V100 GPUs) | 事件驱动模拟器 |
| 主作业 | 5B 参数 LLM, 16级流水线 | 40B 参数 LLM, 8路张量并行 + 16级流水线 |
| GPU | NVIDIA Tesla V100 (16GB HBM, 125 TFLOPS) | 同左 |
| 序列长度 | 2048 tokens | 同左 |
| 微批次大小 | 2 | 同左 |
| 总 minibatch 大小 | 1024 | 同左 |
| 调度算法 | GPipe(默认) | GPipe / 1F1B |
5.2 填充作业模型
| 模型 | 参数量 | 类型 | 任务类型 |
|---|---|---|---|
| EfficientNet | 117M | CNN | CV |
| BERT-base | 109M | Transformer | NLP |
| BERT-large | 334M | Transformer | NLP |
| Swin-large | 779M | Vision Transformer | CV |
| XLM-Roberta-XL | 2.8B | Transformer | NLP |
5.3 核心结果
5.3.1 GPU 利用率提升
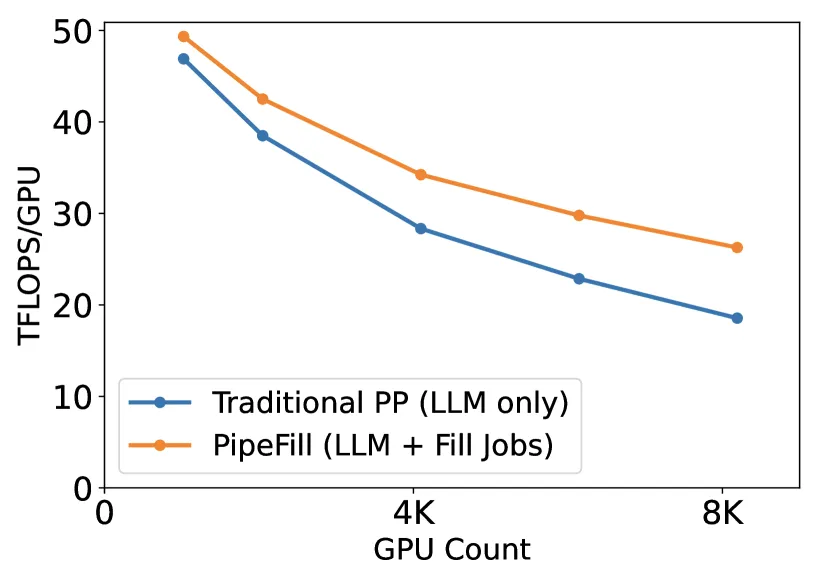
| GPU 数量 | 无 PipeFill 利用率 | 有 PipeFill 利用率 | 提升幅度 |
|---|---|---|---|
| 1K | ~85% | ~90% | +5% |
| 2K | ~65% | ~75% | +10% |
| 4K | ~40% | ~75% | +35% |
| 8K | ~35% | ~80% | +45% |
| 8K (仅推理) | ~35% | ~98% | +63% |
5.3.2 模拟器结果
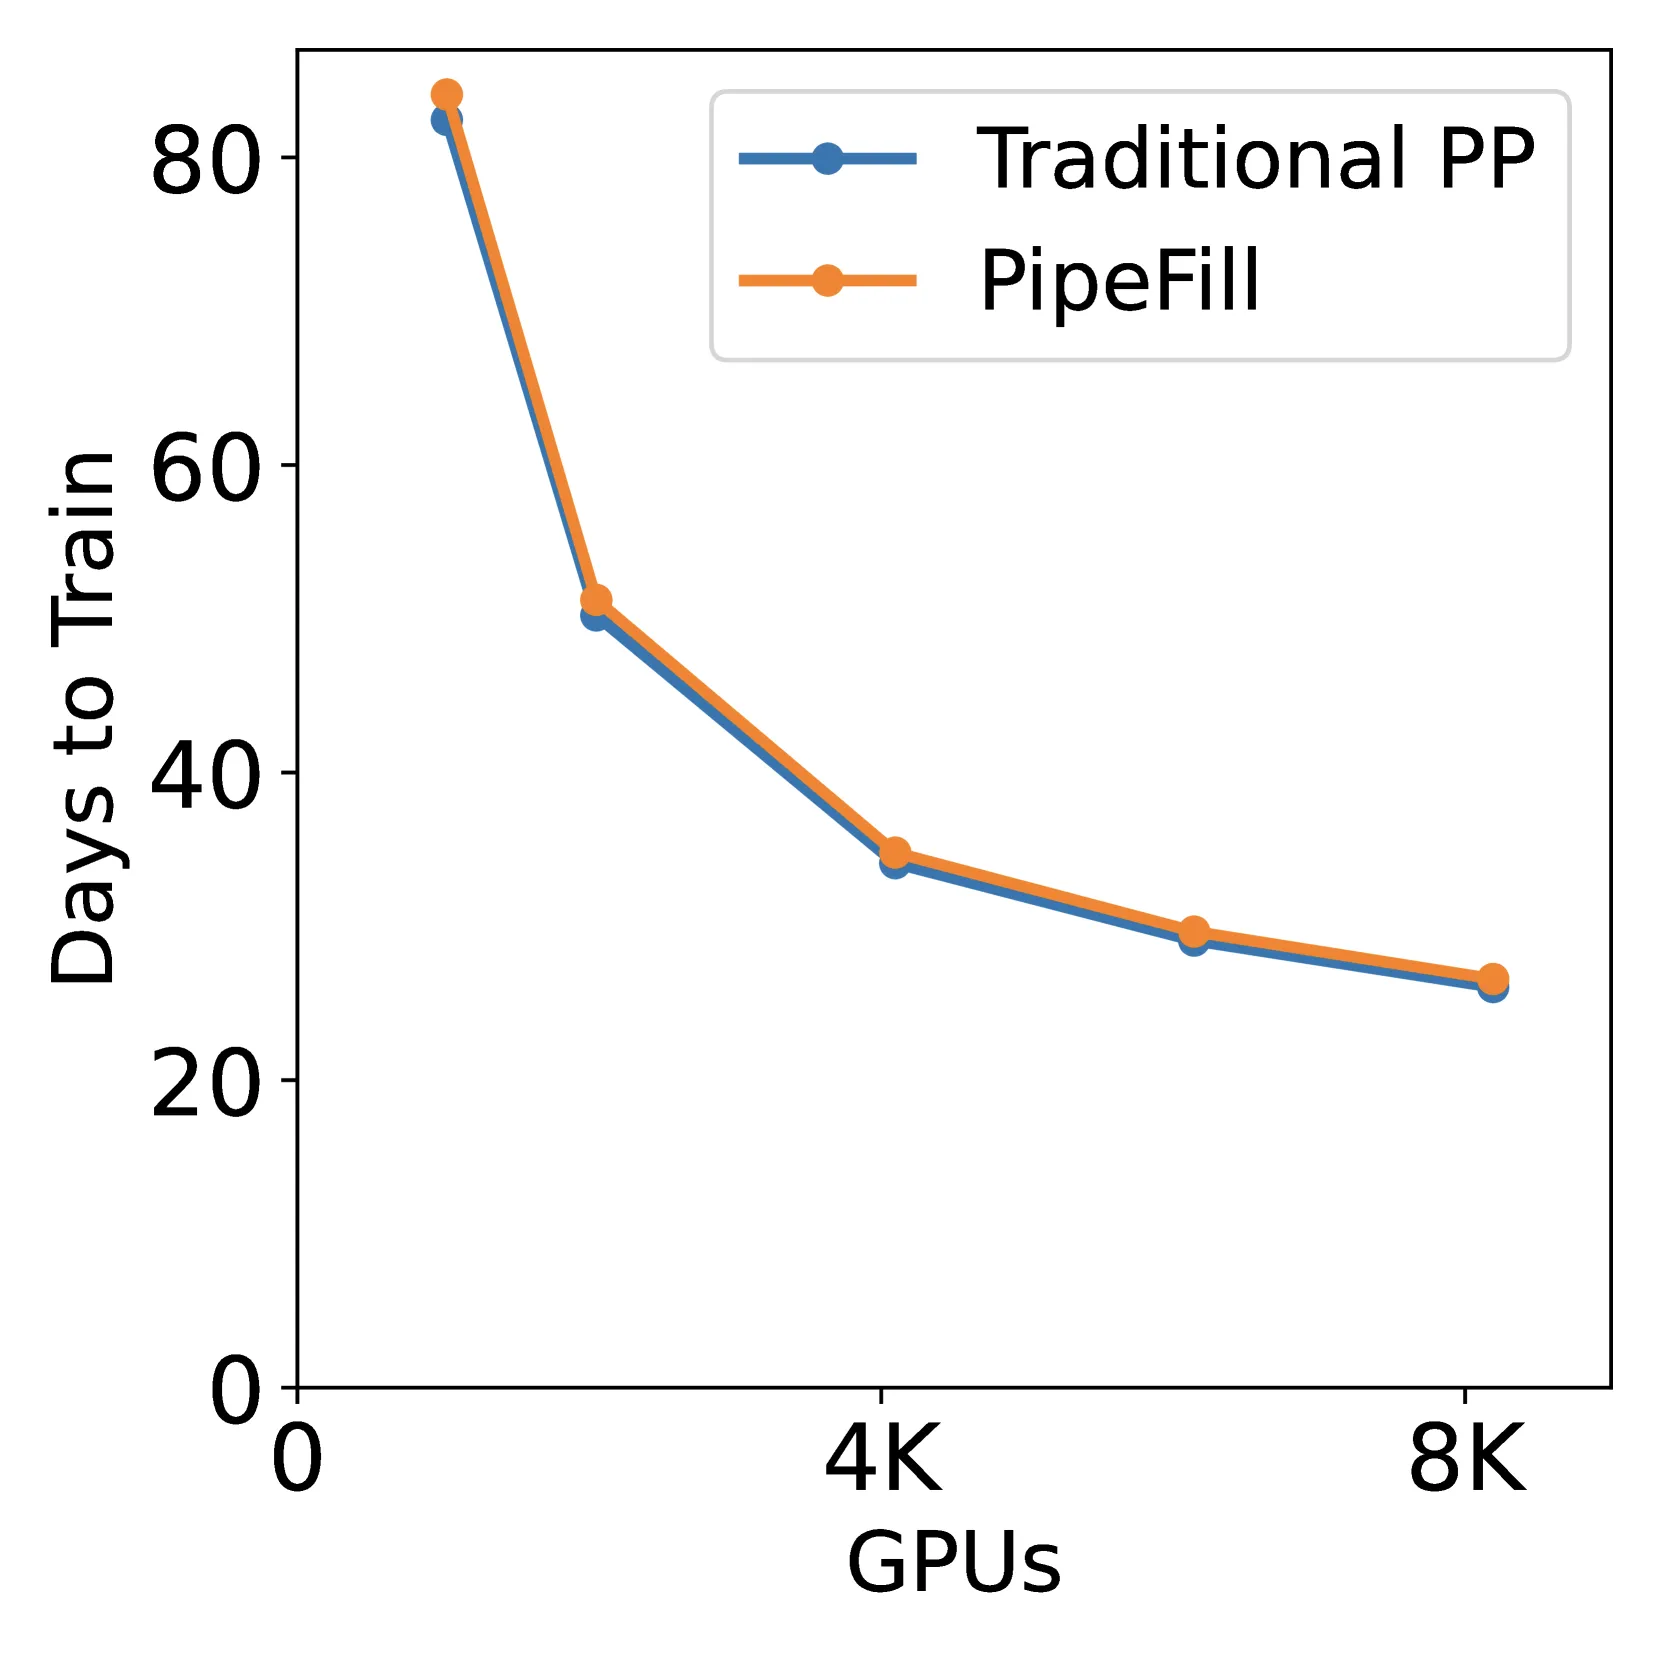
关键发现:
- 在 4K GPU 时,PipeFill 可获得传统 2K GPU 流水线并行 89% 的 GPU 利用率
- 在 8K GPU 时,可获得传统 4K GPU 流水线并行 92% 的 GPU 利用率
- 使用仅 BERT 推理作业时,8K GPU 可超过传统 4K GPU 的 GPU 利用率 6.5%
5.3.3 物理集群验证
验证结果:
- 填充 68% 气泡持续时间时,主作业仅减速 <2%
- 回收的 TFLOPS 与模拟器预测值误差 <5%
- 主作业开销与填充作业类型无关,仅与填充的气泡比例相关
5.3.4 等效 GPU 节省
| 主作业 GPU 数 | 气泡比例 | 填充作业混合 | 节省 GPU 数 |
|---|---|---|---|
| 2K | ~40% | 混合 | 200-300 |
| 4K | ~55% | 混合 | 600-900 |
| 8K | ~65% | 混合 | 1500-2000 |
| 8K | ~65% | 仅推理 | 2000-2600 |
5.4 填充作业特性分析
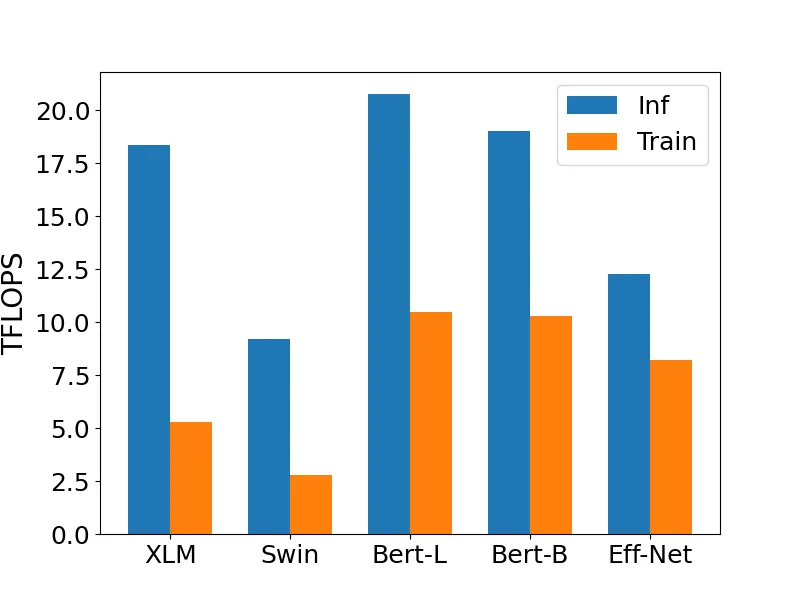
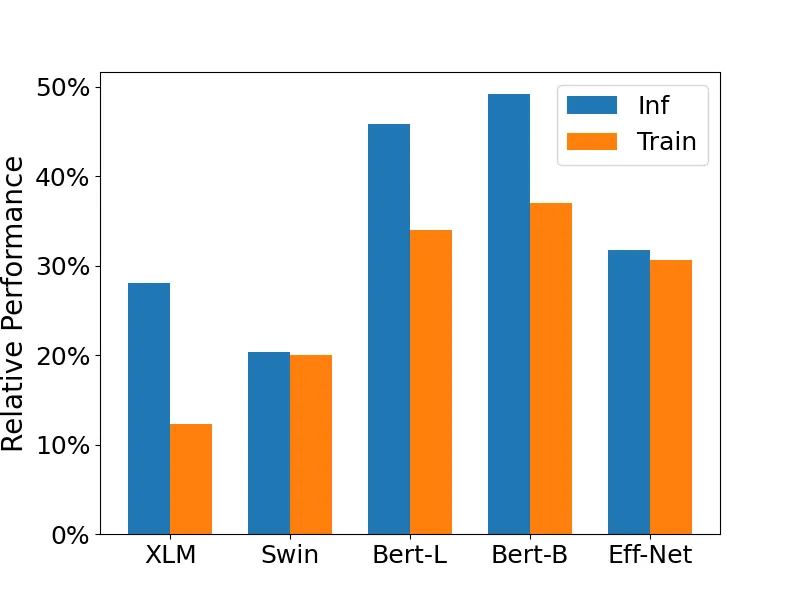
关键发现:
- 推理作业 > 训练作业:推理作业内存需求低,可使用更高的批处理大小
- 大模型训练性能差:激活占用大,需要 CPU 卸载
- CNN 模型表现差:EfficientNet/Swin 的激活尺寸大,受限于内存
- 减速幅度:大多数填充作业经历约 30% 的独占执行减速
5.5 敏感性分析
5.5.1 调度算法对比
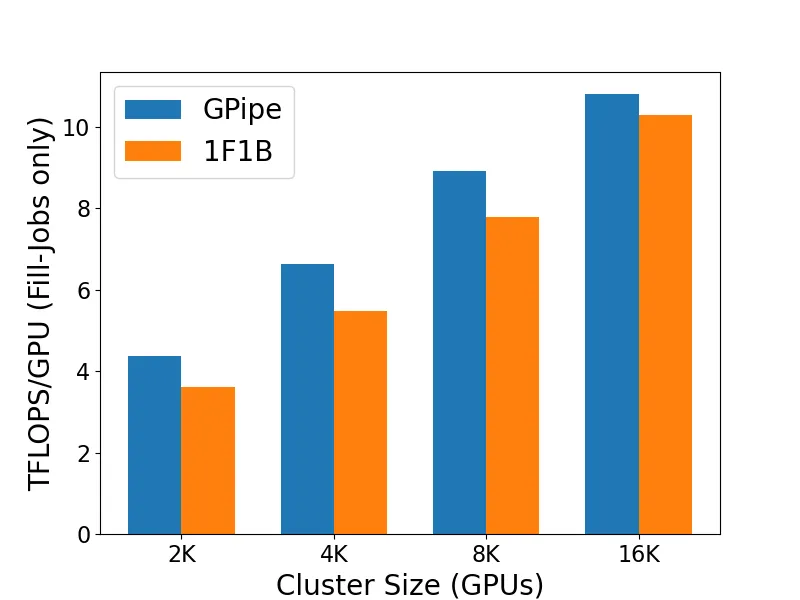
| 调度算法 | 小规模差异 | 大规模差异 |
|---|---|---|
| GPipe vs 1F1B | GPipe 高 20% | 差异缩小到 5% |
5.5.2 调度策略对比
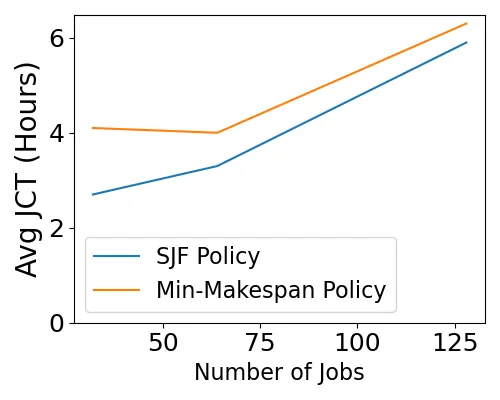
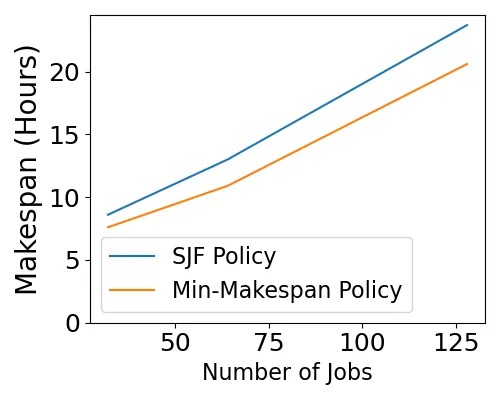
| 策略 | 优势场景 |
|---|---|
| SJF | 低负载,最小化平均 JCT |
| Makespan-Minimizing | 高负载,最小化最大忙碌时间 |
5.5.3 气泡大小和可用内存
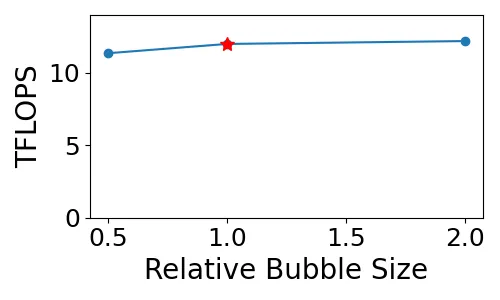
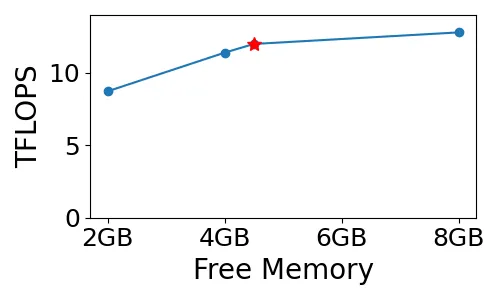
发现:
- 气泡大小缩小 50% 导致 TFLOPS 仅下降 5.3%
- 内存从 2GB 增加到 4GB 提升 30% TFLOPS
- 内存从 4GB 增加到 8GB 仅提升 12.2% TFLOPS(收益递减)
六、相关工作
6.1 流水线优化
| 方法 | 思路 | 局限性 |
|---|---|---|
| Chimera | 双向流水线减少气泡 | 增加内存开销,不适用于大 LLM |
| Megatron-3D | 交错流水线 | 要求微批次数是流水线级数的倍数 |
| Alpa/FlexFlow/Dapple | 搜索最优分区配置 | 无法消除气泡 |
| Bamboo | 冗余计算实现容错 | 仅适用于 spot 实例 |
| PipeFisher | K-FAC 二阶优化 | 仅适用于 K-FAC 优化 |
6.2 资源共享
| 方法 | 思路 | 局限性 |
|---|---|---|
| AntMan | 弹性扩缩容 | 未专门处理流水线气泡 |
| Salus | 多作业共享 GPU | 未考虑流水线特性 |
| PipeSwitch | 训练/推理时间共享 | 仅适用于推理低谷期 |
| REEF | 内核级抢占 | 未处理大模型训练 |
| PilotFish | 利用云游戏空闲资源 | 场景特定 |
| Muri | 多资源交错 | 假设所有作业能放入内存 |
6.3 高效内核
| 方法 | 贡献 |
|---|---|
| FlashAttention | 通过分块计算提高注意力效率 |
| TVM/Ansor/NVFuser | 计算融合提高占用率 |
与 PipeFill 的关系:正交,PipeFill 可与这些技术结合使用。
七、总结
7.1 主要贡献
- 概念创新:首次提出用独立作业填充流水线气泡的思想
- 系统实现:设计并实现了完整的 PipeFill 系统
- 调度算法:提出了将填充作业分配到气泡并配置执行的方法
- 实验验证:证明 PipeFill 可显著提高 GPU 利用率而不损害训练效率
7.2 关键成果
| 指标 | 结果 |
|---|---|
| GPU 利用率提升 | 最高 63%(大规模 LLM 训练) |
| 主作业减速 | <2% |
| 低规模提升 | 5-15% |
| 8K GPU 等效节省 | 最多 2.6K GPU |
7.3 意义与影响
PipeFill 为大规模 LLM 训练提供了一种正交的优化方法,可以与现有的流水线优化、高效内核等技术结合使用。在生成式 AI 爆炸式增长和底层 DNN 训练成本高昂的背景下,PipeFill 提供了关键的效率提升。
7.4 局限性与未来方向
- 填充作业类型限制:仅支持非延迟敏感的训练和批量推理作业
- 内存约束:填充作业仅能使用约 25% 的 GPU 内存
- 硬件依赖:CPU-GPU 带宽影响卸载效率(可通过 PCIe Gen5/NVLink-C2C 改善)
- 调度复杂性:需要为不同场景配置合适的调度策略
八、参考资源
8.1 论文链接
- arXiv: https://arxiv.org/abs/2410.07192
- PDF: https://arxiv.org/pdf/2410.07192
- HTML: https://arxiv.org/html/2410.07192v1
8.2 关键引用
@article{arfeen2024pipefill,
  title={PipeFill: Using GPUs During Bubbles in Pipeline-parallel LLM Training},
  author={Arfeen, Daiyaan and Zhang, Zhen and Fu, Xinwei and Ganger, Gregory R. and Wang, Yida},
  journal={arXiv preprint arXiv:2410.07192},
  year={2024}
}
8.3 相关工具与框架
| 工具/框架 | 用途 |
|---|---|
| DeepSpeed | PipeFill 的实现基础 |
| ZeRO-Offload | 优化器状态 CPU 卸载 |
| ZeRO-Infinity | 梯度/激活/参数卸载 |
| PyTorch | 深度学习框架 |
8.4 下载的图表
所有图表已保存至 docs/figures/pipefill/ 目录:
| 文件名 | 描述 |
|---|---|
fig1_gpu_utilization.png | GPU 利用率随 GPU 数量变化 |
fig2_pipeline_parallelism.png | 流水线并行与数据并行结合示意图 |
fig3_system_overview.png | PipeFill 系统架构总览 |
fig4_simulator_results.png | 模拟器结果(训练时间/气泡比例/利用率) |
fig5_physical_cluster_tflops.png | 物理集群 TFLOPS 验证 |
fig6_simulator_validation.png | 模拟器与物理集群对比验证 |
fig7a_fill_job_tflops.png | 不同填充作业的 TFLOPS |
fig7b_fill_job_slowdown.png | 不同填充作业的减速比例 |
fig8_gpipe_vs_1f1b.png | GPipe 与 1F1B 调度对比 |
fig9a_sched_jct.png | 调度策略对 JCT 的影响 |
fig9b_sched_makespan.png | 调度策略对 Makespan 的影响 |
fig10a_bubble_size.png | 气泡大小敏感性分析 |
fig10b_free_memory.png | 可用内存敏感性分析 |
分析日期:2026-05-30