TidalDecode: Fast and Accurate LLM Decoding with Position Persistent Sparse Attention
Position persistent sparse attention leveraging spatial coherence of high-attention tokens across Transformer layers for 2.1× decoding speedup
TidalDecode: Fast and Accurate LLM Decoding with Position Persistent Sparse Attention
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TidalDecode: Fast and Accurate LLM Decoding with Position Persistent Sparse Attention |
| 作者 | Lijie Yang, Zhihao Zhang, Zhuofu Chen, Zikun Li, Zhihao Jia |
| 机构 | (作者机构未在摘要页明确列出) |
| 论文 | https://arxiv.org/abs/2410.05076 |
| 发布 | 2024-10-07 (v1) |
| 许可 | CC BY-SA 4.0 |
二、核心思想
问题定义
LLM 推理分为两个阶段:
- Prefilling:计算所有输入 token 的 KV cache
- Decoding:逐个生成 token,访问不断增长的 KV cache
KV cache 大小随序列长度线性增长。以 LLaMA2-7B 为例,128K 上下文 + FP16 精度:
这造成了巨大的内存压力,使解码阶段成为内存受限的瓶颈。
现有稀疏注意力机制解决此问题但有两大局限:
- 无法可靠识别最相关的 token:驱逐-based 方法(H2O, TOVA, StreamingLLM)可能丢弃关键 token;选择-based 方法(Quest)的 token 选择本身可能比完整注意力更耗时
- 忽视跨层的空间连贯性:逐层独立选择 token 导致性能下降和巨大的 token 选择开销
解决方案概述
本文提出 TidalDecode——一种基于**位置持久稀疏注意力(Position Persistent Sparse Attention, PPSA)**的快速精准 LLM 解码算法。
核心洞察:高注意力分数的 token 在连续 Transformer 层间表现出强烈的空间连贯性。因此,只需在少数层执行完整注意力来选择 top-k token,其余层复用这些预选 token 进行稀疏注意力。
TidalDecode 在每个解码步使用三种类型的注意力层:
- 初始层的完整注意力(避免早期性能下降)
- 完整注意力 + token 选择(初始层后立即执行 + 中间层执行)
- PPSA(所有其余层仅加载预选 token)
仅需两次 token 选择层即可实现高质量生成,将稀疏注意力的 token 选择开销大幅降低,LLaMA 解码延迟最高降低 2.1×。
三、技术架构
整体框架图
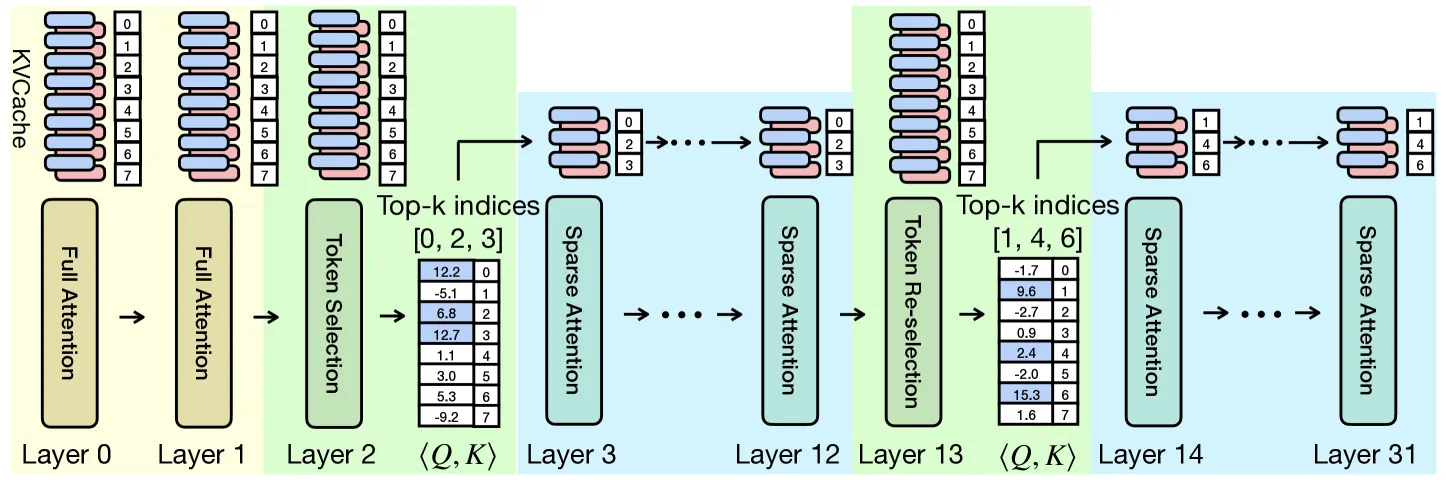
TidalDecode 的解码步骤:
┌──────────────────────────────────────────────────────────────────┐
│  Decoding Step in TidalDecode                                    │
├──────────────────────────────────────────────────────────────────┤
│                                                                  │
│  Layer 0:  Full Attention (no token selection)                   │
│  Layer 1:  Full Attention (no token selection)                   │
│  Layer 2:  Full Attention + Token Selection → top-k tokens       │
│  Layer 3..middle-1:  PPSA (reuse selected tokens)                │
│  Layer middle: Full Attention + Token Selection → top-k tokens   │
│  Layer middle+1..end:  PPSA (reuse selected tokens)              │
│                                                                  │
│  Key Insight: Tokens with highest attention scores              │
│  exhibit strong spatial coherence across consecutive layers      │
│                                                                  │
└──────────────────────────────────────────────────────────────────┘
空间连贯性证据
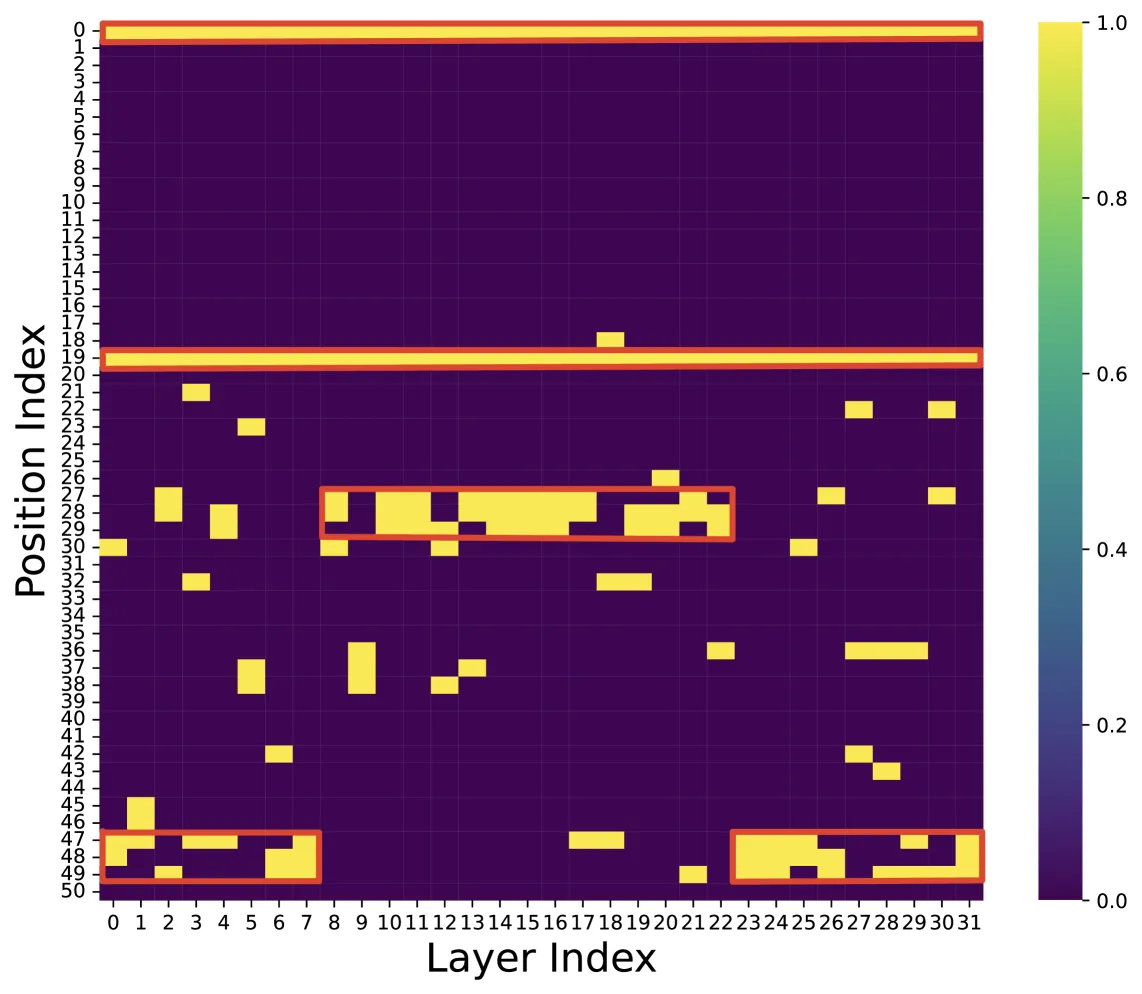
Figure 1 展示了 LLaMA3-8B-Instruct 在 “magic number” 提示测试下,连续层间被选中 token 的强空间连贯性——同一组 token 在多层中持续具有高注意力分数。
Position Persistent Sparse Attention (PPSA)
标准注意力公式:
PPSA 的核心改进:不在每层每头独立选择 token,而是复用前一 token 选择层的同一组 token。这大幅降低了逐层选择的运行时开销。
计算复杂度对比:
| 方法 | Token 选择频率 | 每层开销 |
|---|---|---|
| Quest | 每层选择 | O(L · N · k) |
| TidalDecode | 仅 2 次/步 | O(2 · N · k + (L-2) · k) |
其中 L 为层数,N 为序列长度,k 为 token 预算。
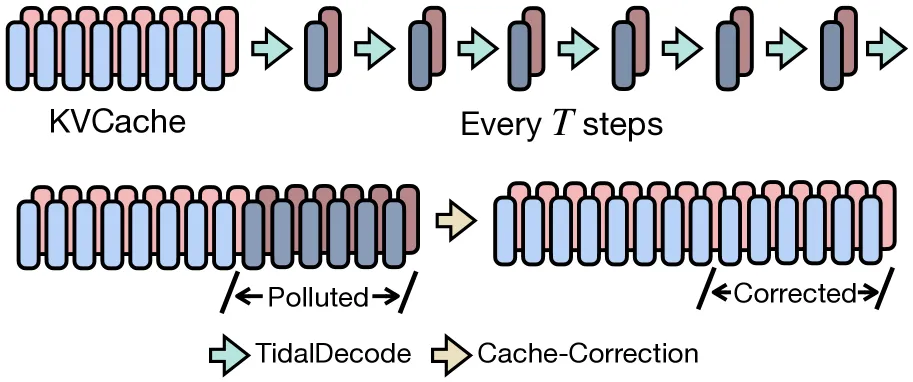
KV Cache Correction
TidalDecode 包含 KV Cache Correction 机制(详见附录算法),用于在稀疏注意力下保持生成质量。
Token 选择层敏感性分析
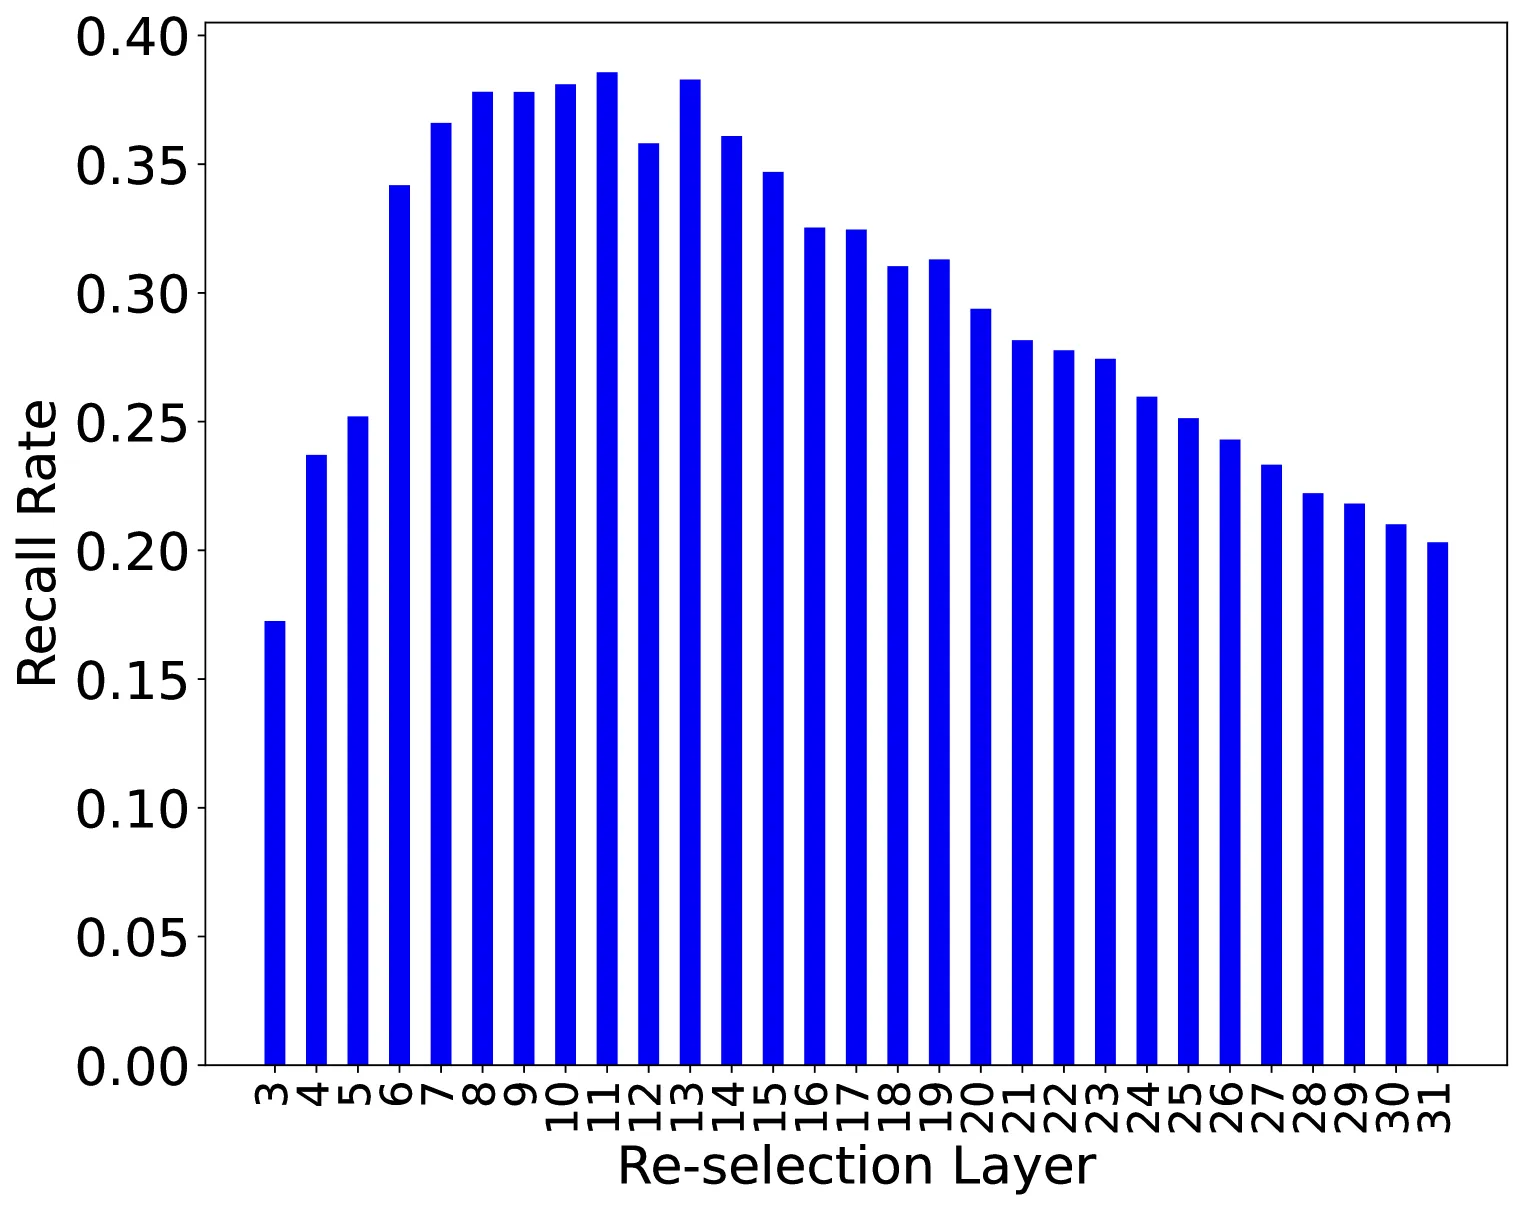
Figure 4 展示了:
- (a) 连续层间最高注意力 token 的重叠率——相邻层共享大量关键 token
- (b) 不同重选层选择的召回率——存在清晰的最优层峰值
关键发现:最优重选层在不同任务间一致,但在不同模型族间有差异。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| PPSA | 位置持久稀疏注意力,跨层复用 token | Figure 1 热力图显示强空间连贯性 |
| 双次 token 选择 | 仅需初始层 + 中间层各选择一次 | 2 次选择是必要且充分的 |
| KV Cache Correction | 补偿稀疏注意力导致的精度损失 | Perplexity 评估验证 |
| 模型族级最优层发现 | 最优重选层在同一模型族的不同任务间一致 | LLaMA-2 和 LLaMA-3 族的敏感性分析 |
五、实验结果
Needle-in-the-Haystack 评估
LongChat-7b-v1.5-32k (10K 上下文):
| 方法 | K=32 | K=64 | K=128 | K=256 | K=512 |
|---|---|---|---|---|---|
| H2O | 0% | 1% | 1% | 1% | 3% |
| TOVA | 0% | 1% | 1% | 3% | 8% |
| StreamingLLM | 1% | 1% | 1% | 3% | 5% |
| Quest | 65% | 99% | 99% | 99% | 100% |
| TD+L7 (Ours) | 73% | 92% | 98% | 99% | 100% |
TidalDecode 在 K=512 时达到完全准确率,在低预算(K=64)时也达到 92%。
LLaMA-3-70B (10K 上下文),TD+L14:
| 方法 | K=256 |
|---|---|
| Quest | 98% |
| TD+L14 | 100% |
Perplexity 评估
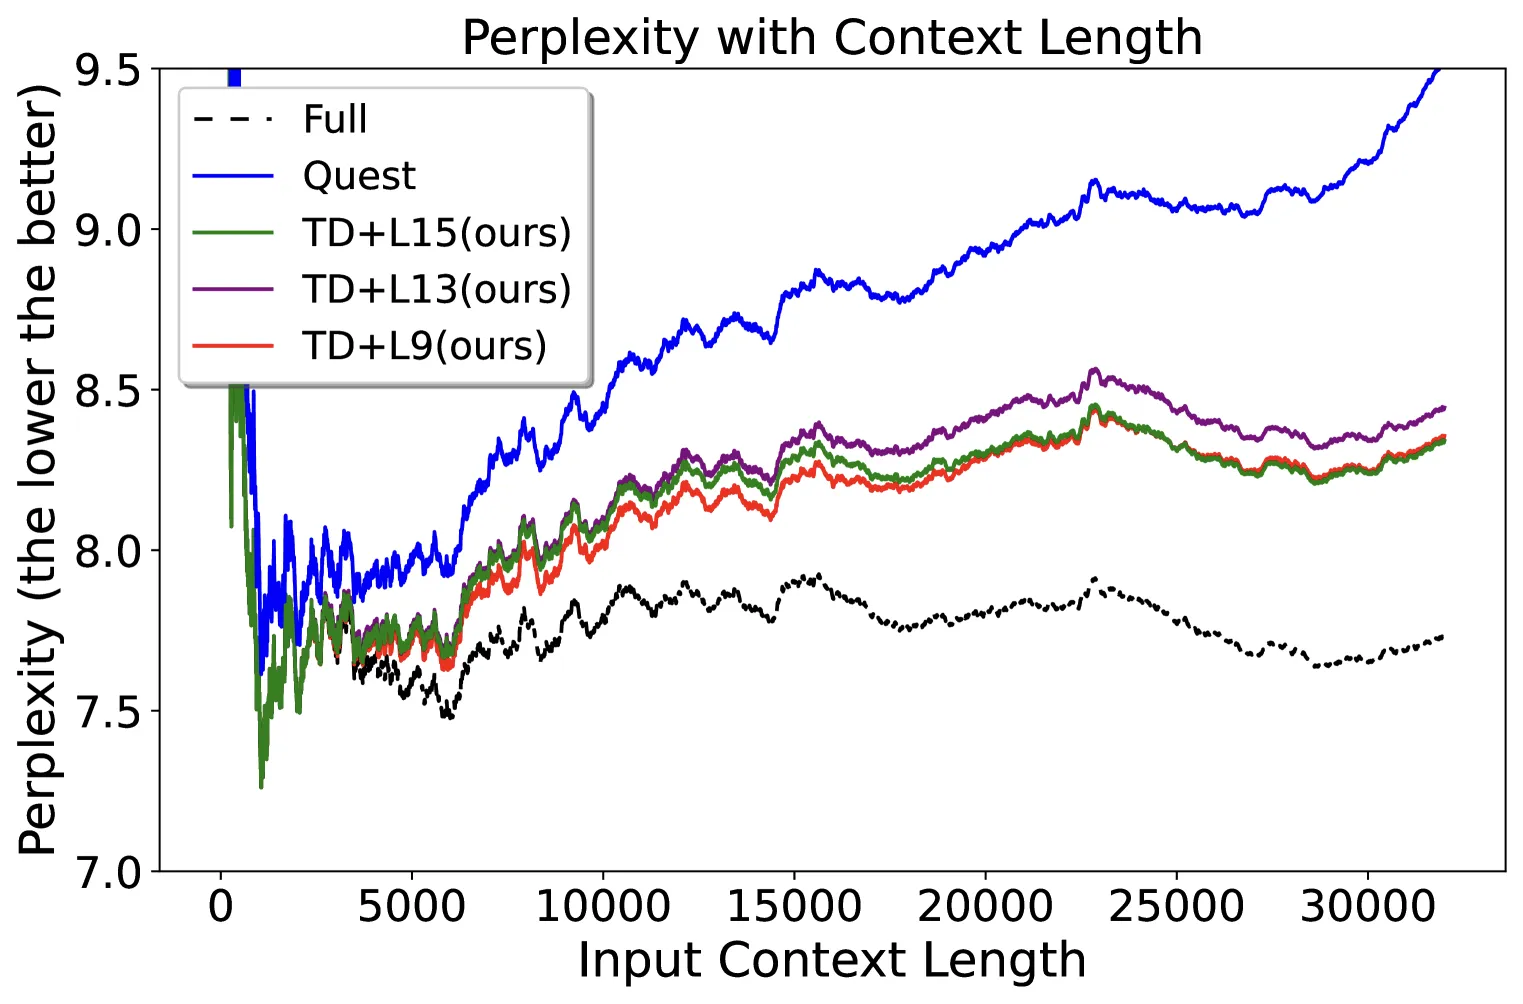
在 PG-19 数据集上(0-32K token),TidalDecode 的 perplexity 显著优于 Quest,尤其在 token 预算较低时(2048, 4096)。
长上下文 LongBench 评估
在 8 个 LongBench 数据集上(LLaMA-3-8B-Gradient, K=4096):
- TidalDecode 优于 Quest
- 在平均得分上超过完整注意力基线
效率评估
端到端延迟(LLaMA-2-7B):
| 上下文长度 | TidalDecode 加速比 |
|---|---|
| 10K | 2.1× |
| 32K | ~1.8× |
| 100K | ~1.5× |
关键发现:
- TidalDecode 的注意力核(稀疏注意力)显著快于完整注意力和 Quest 的 token 选择注意力
- 稀疏注意力同时避免了完整注意力计算 AND 逐层 token 选择开销
- 在 100K 上下文中仍保持有效加速
注意力延迟分解(Figure 7-8):
- Full Attention: 基线
- Quest: 额外 token 选择注意力开销
- TidalDecode: 仅 2 次 token 选择 + 稀疏注意力(最快)
模型族最优重选层
| 模型 | 最优重选层 |
|---|---|
| LLaMA-2-7B-LongChat | L7 |
| LLaMA-2-7B-Yarn | L7 |
| LLaMA-3-8B | L14 |
| LLaMA-3.1-8B | L14 |
重要发现:同一模型族内的最优层是一致的,跨任务也一致。
六、与现有方法对比
| 方法 | 策略 | Token 选择频率 | 开销 | 精度 |
|---|---|---|---|---|
| H2O | 驱逐-based | 无(固定策略) | 低 | 差(<3%) |
| TOVA | 驱逐-based | 无 | 低 | 差(<8%) |
| StreamingLLM | 驱逐-based | 无 | 低 | 差(<5%) |
| Quest | 选择-based | 每层 | 高(top-k 比 full attn 还慢) | 好 |
| TidalDecode | PPSA | 仅 2 次 | 低 | 好 |
七、总结
核心贡献
- TidalDecode 框架:位置持久稀疏注意力,利用高注意力 token 的跨层空间连贯性
- 双次 token 选择:仅需初始层 + 中间层各选择一次,必要且充分
- PPSA 设计:复用预选 token,消除逐层选择开销
- Needle-in-the-Haystack SOTA:在 K=512 时达到 100% 准确率,优于 Quest
- 2.1× 端到端加速:在 LLaMA-2-7B 上,10K-100K 上下文范围
- 最优层一致性发现:同一模型族内最优重选层跨任务一致
技术影响
- 为长上下文 LLM 推理提供了一种简单但有效的稀疏注意力方案
- 消除了逐层 token 选择的运行时开销
- 为未来的稀疏注意力设计提供了理论洞察:空间连贯性是 key
局限性
- 仅评估了 LLaMA 系列和 LongChat 模型,未扩展到其他架构
- 最优重选层需要经验确定(虽有规律可循)
- 在极端高稀疏度(k << 256)下的表现未充分探索
八、参考资源
- arXiv: https://arxiv.org/abs/2410.05076
- License: CC BY-SA 4.0
- 评估模型: LLaMA-2-7B, LLaMA-3-8B, LLaMA-3-70B, LLaMA-3.1-8B, LongChat-7b-v1.5-32k
- 评估数据集: Needle-in-the-Haystack, PG-19, LongBench (8 数据集)
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 空间连贯性热力图 | spatial-coherence.png |
| Figure 2 | 解码步骤概览 | decoding-overview.png |
| Figure 4 | Token 重叠率与召回率 | token-overlap.png |
| Figure 5 | Perplexity 评估 | perplexity.png |
| Figure 6 | 端到端延迟 | latency.png |