SageAttention: Accurate 8-Bit Attention for Plug-and-play Inference Acceleration
使用 INT8 量化注意力计算 + K 平滑 + FP16 累加器的即插即用推理加速方法
SageAttention: Accurate 8-Bit Attention for Plug-and-play Inference Acceleration
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SageAttention: Accurate 8-Bit Attention for Plug-and-play Inference Acceleration |
| 作者 | Jintao Zhang, Jia Wei, Haofeng Huang, Pengle Zhang, Jun Zhu, Jianfei Chen |
| 机构 | Tsinghua University |
| 论文 | arXiv:2410.02367 |
| 代码 | https://github.com/thu-ml/SageAttention |
| 发表 | ICLR 2025 |
| 发布 | 2024-10-03 (v1), 2025-10-01 (v9) |
二、核心思想
问题定义
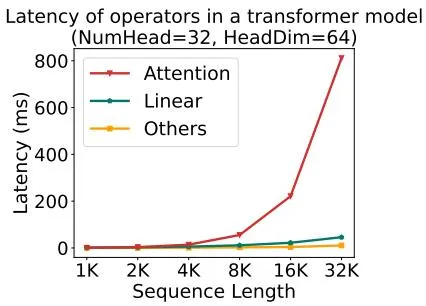
Transformer 架构中,注意力计算复杂度为 O(N²),而线性变换仅为 O(N)。当处理长序列时(视频生成中 N 可达 17K+,LLM 预填充中 N 可达 128K),注意力成为主要耗时组件。现有量化方法主要集中在线性层优化,注意力仍保持高精度(FP16)。
直接对注意力矩阵 Q, K, P, V 进行 8-bit 量化面临两大挑战:
- C1: K 矩阵存在显著的通道级异常值(channel-wise outliers),导致量化精度损失严重
- C2: 简单将 (P, V) 量化为 INT8 不能在所有场景下保证 PV 乘积的准确性
此外,FlashAttention3 的 FP8 版本仅适用于 Hopper 架构,且精度显著低于本文方法。
解决方案概述
SageAttention 是一种即插即用的训练后量化(post-training quantization)方法,核心方案:
- 将 Q, K 量化为 INT8 per-block
- 对 K 进行平滑处理(减去 token 维均值)消除通道异常值
- 使用 per-block INT8(静态尺度 ),V 使用 per-channel INT8
- PV 乘法使用 FP16 累加器(而非 INT8),既提升精度又获得 2× 加速
- 提出自适应量化策略,根据每层精度选择最快的 kernel
三、技术架构
整体工作流
注意力延迟占比
数据分布观察
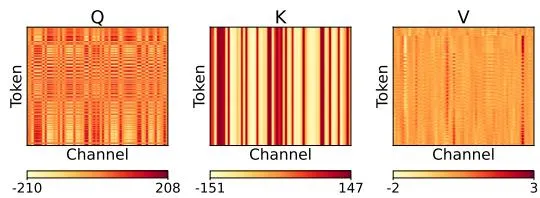 CogVideo 中的 QKV 分布 — K 显示显著通道级异常值
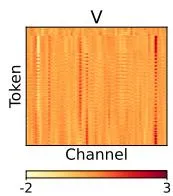 Unidiffuser 中的 QKV 分布
模糊效果对比
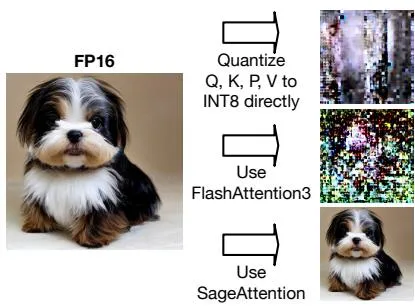 直接 INT8 量化产生完全模糊图像,SageAttention 保持质量
核心公式
K 矩阵平滑(Equation 6):
其中 是形状为 的平均 key。
关键性质:该变换不改变注意力分数,因为:
量化注意力公式(Equations 4-5):
动态量化(Equation 3):
静态尺度:由于 ,最大值为 1,可分配单一静态尺度 ,精度等价于 per-token 量化。
四种 Kernel 实现(Table 6)
| Kernel | Q,K 量化 | V | 特点 | |
|---|---|---|---|---|
| SAGEAttn-T | per-token, INT8 | FP16, FP16 Accum | FP16, FP16 Accum | 最快精度最低 |
| SAGEAttn-B (Algorithm 1) | per-block, INT8 | FP16, FP16 Accum | FP16, FP16 Accum | 主推荐,精度足够 |
| SAGEAttn-vT | per-token, INT8 | per-block, INT8 | per-channel, INT8 | 最快,需验证精度 |
| SAGEAttn-vB | per-block, INT8 | per-block, INT8 | per-channel, INT8 | 部分层可用 |
Algorithm 1: SAGEAttn-B
输入: Q(FP16), K(FP16), V(FP16) ∈ R^(N×d), 块大小 b_q, b_kv

预处理: K = K - mean(K)                          // 减去 token 均值

量化: (δ_Q, Q̂) = ψ_Q(Q/√d), (δ_K, K̂) = ψ_K(K)   // INT8 per-block

分割 Q̂ 为 T_m = N/b_q 个块 {Q̂_i}, K̂,V 为 T_n = N/b_kv 个块 {K̂_j},{V_j}

for i in [1, T_m] do                              // 外层在 SM 上并行
    加载 Q̂_i 和 δ_Q[i] 到 SM
    for j in [1, T_n] do
        加载 K̂_j, V_j, 和 δ_K[j] 到 SM
        S_i^j = Matmul(Q̂_i, K̂_j^T) × δ_Q[i] × δ_K[j]
        m_i^j = max(m_i^{j-1}, rowmax(S_i^j))
        P̃_i^j = exp(S_i^j - m_i^j)
        l_i^j = e^{m_i^{j-1} - m_i^j} · l_i^{j-1} + rowsum(P̃_i^j)
        O_i^j = diag(e^{m_i^{j-1} - m_i^j}) · O_i^{j-1}
                  + Matmul(P̃_i^j.to(FP16), V_j, Accum_type=FP16)
    end for
    O_i = diag(l_i^{T_n})^{-1} · O_i^{T_n}
    写入 O_i
end for
融合技巧
- ROPE + 量化融合:在 ROPE 结果从共享内存写入全局内存前执行量化,避免量化 IO 开销
- 系数融合:将 乘到 Q 上再量化,而非留在注意力层
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| K 矩阵平滑 | 减去 K 的 token 维度均值,消除通道异常值 | Table 18, CosSim 从 30-62%→99%+ |
| INT8 per-block for Q,K | 选择 INT8 而非 FP8,RTX4090 上快 2× | Table 2, INT8 CosSim 99.70% > E4M3 99.94% |
| FP16 累加器 for PV | 替代 INT8 PV,用 FP16 accumulator 保持精度 | Table 3-5, FP16 累加器无精度损失且快 2× |
| 自适应量化 | 根据每层 CosSim 选择最快 kernel | Table 11, CogvideoX 速度提升 11.7% |
| 即插即用 | 无需训练,替换原始注意力实现即可 | 跨 5 类模型零额外训练 |
五、实验结果
量化方法对比(Table 1)
| 量化 (Q,K) | 平滑 K | Llama WikiText↓ | CogVideo FScore↑ | Unidiffuser FID↓ | UltraPixel FID↓ | TIMM Acc↑ |
|---|---|---|---|---|---|---|
| Full-Precision | — | 5.823 | 3.768 | 163.33 | 179.78 | 84.79% |
| Per-token | × | 5.824 | 1.924 | 221.18 | 193.36 | 84.21% |
| Per-token | √ | 5.824 | 3.734 | 166.52 | 179.79 | 84.74% |
| Per-block | × | 5.825 | 2.014 | 229.08 | 195.67 | 84.18% |
| Per-block | √ | 5.824 | 3.718 | 166.93 | 179.98 | 84.76% |
| FlashAttn3 (quant) | — | 5.850 | 3.394 | 394.13 | 383.61 | 84.70% |
关键发现:
- 平滑 K 后所有量化方法精度大幅提升
- FlashAttn3(fp8) 在图像生成上 FID 极差(394.13 vs 163.33)
- Per-block + 平滑 K 达到最佳综合性能
数据类型精度对比(Table 2-3)
平均精度(Cos Sim):
| Q,K | P̃,V | Cos Sim↑ | Rel L1↓ | RMSE↓ |
|---|---|---|---|---|
| INT8 | E4M3 | 99.94% | 0.0345 | 3.53e-3 |
| INT8 | E5M2 | 99.81% | 0.0572 | 6.11e-3 |
| INT8 | INT8 | 99.70% | 0.1035 | 6.82e-3 |
| E4M3 | E4M3 | 99.81% | 0.0607 | 5.93e-3 |
最差精度(Cos Sim):
| Q,K | P̃,V | Cos Sim↑ |
|---|---|---|
| INT8 | E4M3 | 76.36% |
| INT8 | E5M2 | 78.98% |
| INT8 | INT8 | 56.40% |
| FP16 | FP16 | 99.99% |
这证明了使用 FP16 累加器存储 PV 结果的必要性——INT8 在某些层的精度仅 56%。
累加器类型对比(Table 4-5)
| 累加器 | Cos Sim↑ (avg) | Rel L1↓ | RMSE↓ | Cos Sim↑ (worst) |
|---|---|---|---|---|
| FP32 | 99.98% | 0.0156 | 2.94e-3 | 99.84% |
| FP16 | 99.98% | 0.0156 | 2.94e-3 | 99.84% |
FP16 累加器与 FP32 完全相同的精度,但速度快 2×。
内核精度(Table 9)
| Attention | Cos Sim↑ | Rel L1↓ | RMSE↓ |
|---|---|---|---|
| SAGEAttn-T | 1.0 | 0.019 | 6.8e-4 |
| SAGEAttn-B | 1.0 | 0.021 | 7.3e-4 |
| SAGEAttn-vT | 99.9% | 0.064 | 0.065 |
| SAGEAttn-vB | 98.9% | 0.138 | 0.067 |
端到端指标对比(Table 8)
Llama2 (7B)
| 模型 | 注意力 | WikiText↓ | Lambda↑ | MMLU↑ |
|---|---|---|---|---|
| Llama2 | Full-Precision | 5.823 | 0.886 | 0.46 |
| Llama2 | SageAttention | 5.824 | 0.887 | 0.46 |
CogvideoX
| 模型 | 注意力 | CLIPSIM↑ | CLIP-T↑ | VQA-a↑ | VQA-t↑ | FScore↑ |
|---|---|---|---|---|---|---|
| CogvideoX | Full-Precision | 0.1837 | 0.9976 | 68.962 | 75.925 | 3.7684 |
| CogvideoX | SageAttention | 0.1836 | 0.9976 | 68.839 | 75.037 | 3.8339 |
Unidiffuser
| 模型 | 注意力 | FID↓ | sFID↓ | CLIP↑ | IR↑ |
|---|---|---|---|---|---|
| Unidiffuser | Full-Precision | 163.33 | 145.08 | 0.3152 | 0.1609 |
| Unidiffuser | SageAttention | 166.49 | 143.18 | 0.3154 | 0.1521 |
UltraPixel
| 模型 | 注意力 | FID↓ | sFID↓ | CLIP↑ | IR↑ |
|---|---|---|---|---|---|
| UltraPixel | Full-Precision | 179.78 | 141.35 | 0.3132 | 0.6169 |
| UltraPixel | SageAttention | 179.79 | 141.63 | 0.3131 | 0.6110 |
TIMM (ImageNet)
| 模型 | 注意力 | ImageNet↑ | Sketch↑ | ImageNet-r↑ |
|---|---|---|---|---|
| TIMM | Full-Precision | 84.79% | 45.32% | 59.55% |
| TIMM | SageAttention | 84.74% | 45.78% | 60.32% |
Llava1.6
| 模型 | 注意力 | TextVQA↑ | POPE↑ | VQAv2↑ |
|---|---|---|---|---|
| Llava1.6 | Full-Precision | 60.25% | 86.45% | 77.55% |
| Llava1.6 | SageAttention | 60.09% | 86.44% | 77.47% |
结论:平均退化仅 0.2%,部分任务甚至超越全精度。
内核速度对比
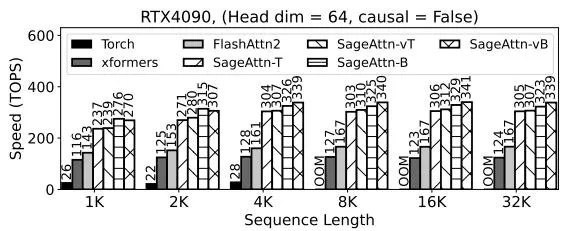
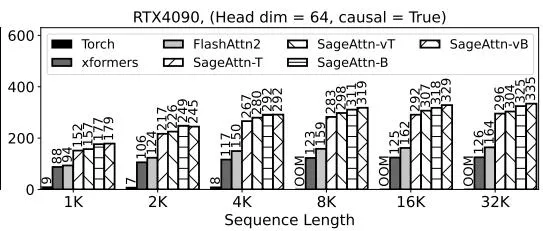
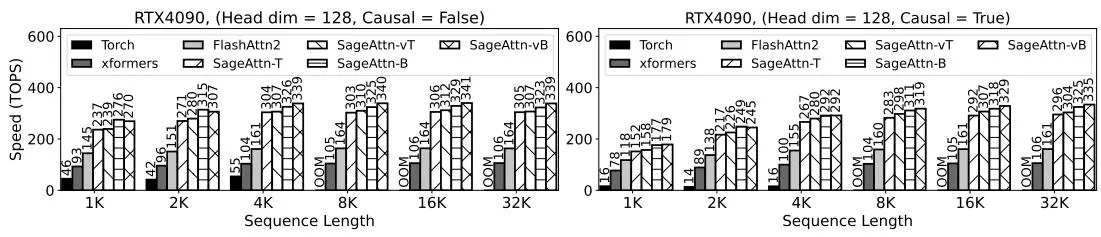
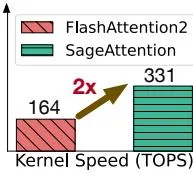
RTX4090 峰值:341 TOPS(headdim=64),比 FlashAttention2 快约 2×,比 xformers 快约 2.9×。
RTX3090 速度对比
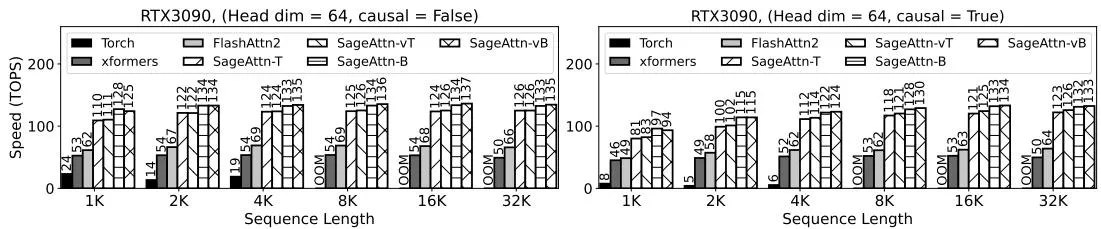
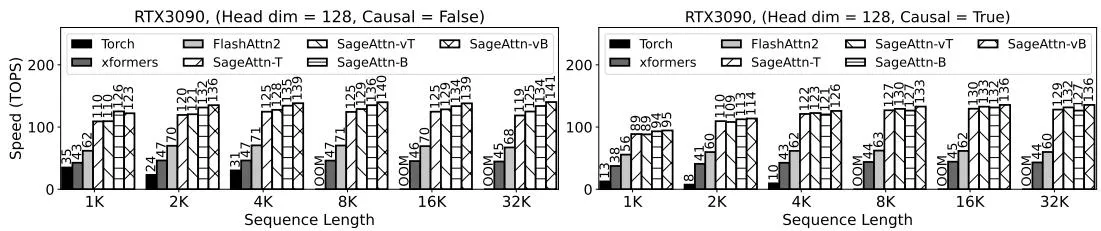
真实模型加速比(Table 7)
| 模型 | Q,K,V 形状 | 原始注意力 | SageAttention | 加速比 |
|---|---|---|---|---|
| CogvideoX | (2, 30, 17776, 64) | 163.37 | 327.57 | 2.01× |
| Llama2 | (4, 32, 1536, 128) | 130.99 | 231.74 | 1.77× |
| UltraPixel | (2, 32, 7285, 64) | 152.03 | 325.18 | 2.14× |
| Unidiffuser | (4, 24, 1105, 64) | 105.68 | 246.93 | 2.34× |
| TIMM | (12, 64, 197, 64) | 18.91 | 111.41 | 5.89× |
平均加速比:2.83×(vs 原始注意力),2.1×(vs FlashAttention2),2.7×(vs xformers)。
平滑 K 的开销(Table 10)
| 模型 | Smooth K | TOPS↑ |
|---|---|---|
| CogvideoX | × | 327.57 |
| CogvideoX | √ | 327.52 |
| UltraPixel | × | 325.18 |
| UltraPixel | √ | 324.56 |
平滑 K 的开销 <0.2%。
自适应量化收益(Table 11)
| Attention | 模型 | CLIPSIM↑ | TOPS↑ | 模型 | MMLU↑ | TOPS↑ |
|---|---|---|---|---|---|---|
| SAGEAttn-T | CogvideoX | 0.1827 | 292.17 | Llama2 | 0.46 | 208.59 |
| SageAttention | CogvideoX | 0.1835 | 327.57 | Llama2 | 0.46 | 231.74 |
自适应策略在无损指标情况下提升速度 11.7%。
消融:平滑 K 的效果(Table 18)
| 量化类型 | 平滑 K | Cosine Sim↑ | Rel L1↓ | RMSE↓ |
|---|---|---|---|---|
| Per-token | × | 62.24% | 1.187 | 0.294 |
| Per-token | √ | 99.47% | 0.045 | 0.031 |
| Per-block | × | 30.60% | 1.286 | 0.464 |
| Per-block | √ | 99.31% | 0.072 | 0.035 |
| FlashAttn3 (quant) | — | 26.76% | 2.535 | 0.538 |
可视化对比
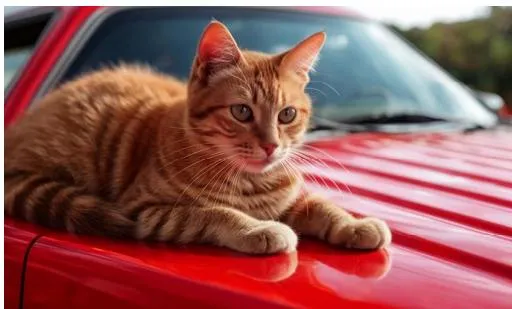 UltraPixel 全精度生成 (2560×1536)
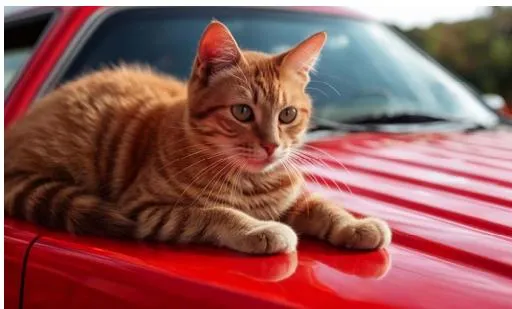 UltraPixel SageAttention 生成 — 质量一致
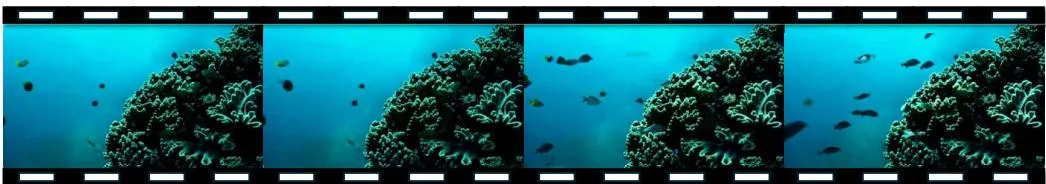 Open-Sora 全精度视频 (720×1280)
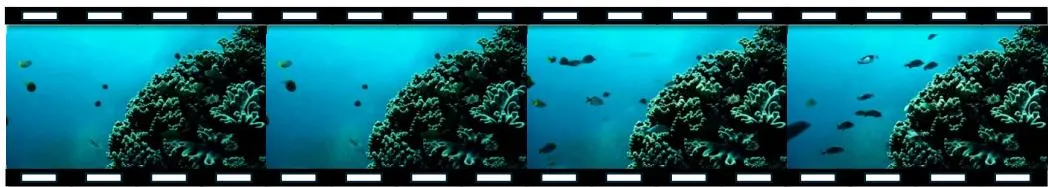 Open-Sora SageAttention 视频 — 完全一致
六、相关工作
| 方向 | 代表工作 | SageAttention 的区别 |
|---|---|---|
| 稀疏注意力 | Swin Transformer, Twins, AttentioNSinks, InfLLM, MoA, Minference | 仅适用于特定场景,省略的计算不一定无用 |
| 线性注意力 | Linformer, Performer, MetaFormer, LinearAttention | 降低复杂度到 O(N),但标准注意力仍占主导 |
| Kernel 优化 | xformers, FlashAttention-1/2/3 | FA3 仅限 Hopper 架构且精度低 |
| 量化 | I-bert (INT8 all), AWQ (W4A16), Q-diffusion (W8A8), ViDiT-Q | 均聚焦线性层,未覆盖注意力 |
七、总结
核心贡献
- 首次系统研究注意力量化可行性:分析了 INT8/FP8/E4M3/E5M2 等不同数据类型的精度表现
- K 矩阵平滑:以 <0.2% 开销将 CosSim 从 30-62% 提升到 99%+
- FP16 累加器:替代 INT8 PV 乘法,达到 FP32 精度且快 2×
- 自适应量化:根据每层精度自动选择最快 kernel,速度提升 12%
- 跨领域验证:覆盖 LLM (Llama2)、视频生成 (CogvideoX)、图像生成 (Unidiffuser, UltraPixel)、图像分类 (TIMM)、VQA (Llava1.6)
性能总结
| 对比对象 | RTX4090 | RTX3090 |
|---|---|---|
| vs FlashAttention2 | ~2.1× | ~1.9× |
| vs xformers | ~2.7× | — |
| vs 原始注意力 | ~2.83× | ~2.7× |
| 峰值性能 | 341 TOPS (headdim=64) | — |
局限性
- 主要在 NVIDIA Ada/Hopper 架构验证(RTX4090, 3090),其他 GPU 平台未全面测试
- 仅验证推理加速,未涉及训练场景
- INT8 per-block 在极端异常值场景下可能需要回退到 SAGEAttn-T(per-token)
- 当前版本基于 Triton 实现,未覆盖 CUDA 原生优化上限
八、参考资源
- arXiv: 2410.02367
- GitHub: https://github.com/thu-ml/SageAttention
- SageAttention2: arXiv:2411.10958
- FlashAttention-2: arXiv:2307.08691
- FlashAttention-3: arXiv:2407.08608
- SmoothQuant: arXiv:2211.10438