EC-DiT: Scaling Diffusion Transformers with Adaptive Expert-Choice Routing
使用自适应专家选择路由扩展扩散 Transformer
EC-DiT: Scaling Diffusion Transformers with Adaptive Expert-Choice Routing
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | EC-DiT: Scaling Diffusion Transformers with Adaptive Expert-Choice Routing |
| 作者 | Wenyan Cong, Han Zhang, Zechen Liu, Haotian Bai, Bowen Shi, Xuan Su, Zizheng Pan, Yifan Niu, Zhi-Qi Cheng, Qi Kong |
| 机构 | ByteDance |
| 论文 | arXiv:2410.02098 |
| 代码 | 未公开 |
| 发布 | 2024年10月2日 |
| 主题 | cs.CV |
二、核心思想
问题定义
现有 DiT (Diffusion Transformer) 模型在扩展到更大规模时面临挑战:
- 计算同质性: 所有 token 分配相同计算量,但不同图像区域需要不同计算
- 局部上下文: Token-choice 路由无法利用扩散过程的全局信息
- 负载均衡: Token-choice 路由需要额外的辅助损失来平衡负载
解决方案概述
EC-DiT 是一种使用专家选择路由 (Expert-Choice Routing) 的 MoE 扩散 Transformer:
- 自适应计算分配: 利用全局信息优化计算资源分配
- 异构计算: 根据文本-图像复杂度分配不同计算量
- 扩展到 97B 参数: 最大模型达到 97.21B 参数
核心性能
| 指标 | 数值 |
|---|---|
| 最大参数量 | 97.21B (64 experts) |
| GenEval 分数 | 71.68%(SOTA) |
| 计算开销增加 | <30% |
| 推理速度 | 竞争力 |
三、技术架构
整体框架图
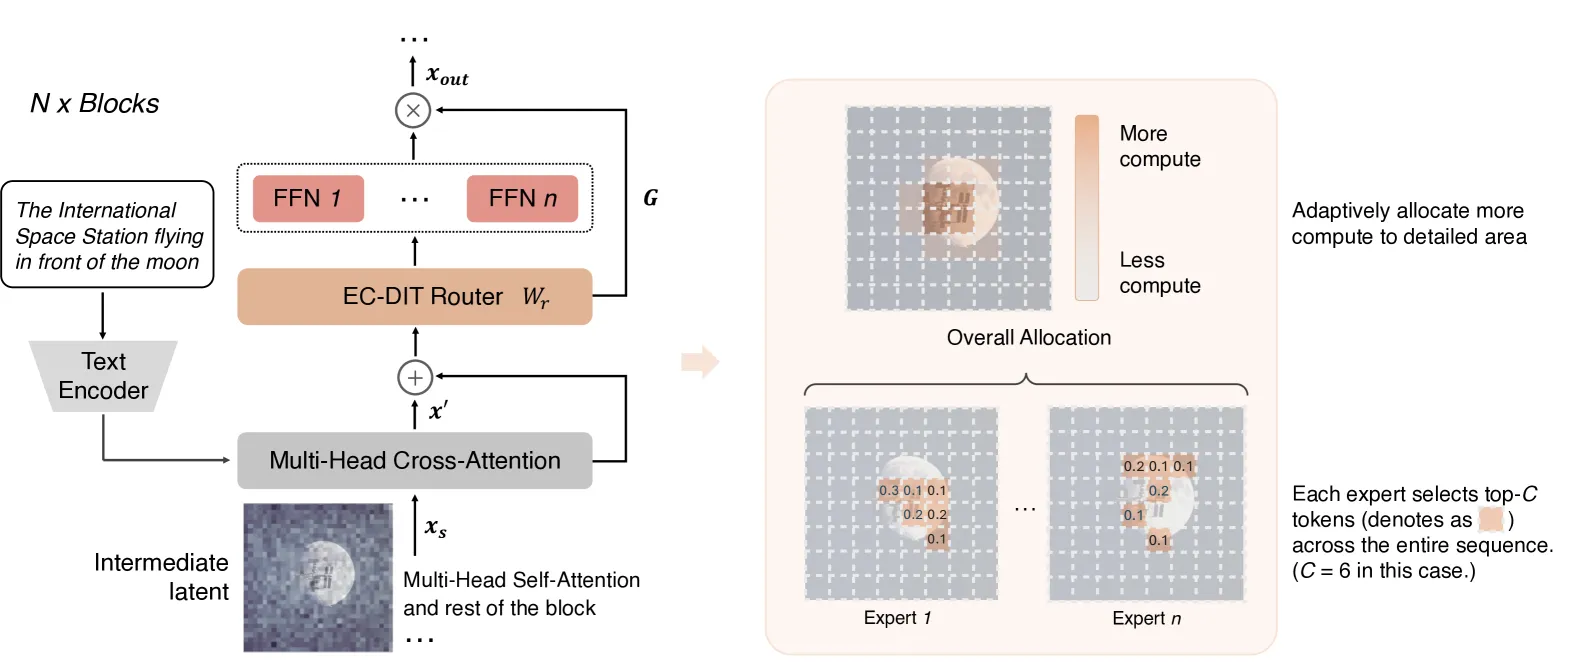
Figure 2: EC-DiT 架构。路由器利用整个序列的信息自适应地将最合适的 token 路由到每个专家。通过这种异构路由,更多计算分配给细节丰富的图像区域(如空间站和月球),而较少计算用于渲染背景。
核心公式
Token-Choice vs Expert-Choice 路由
Token-Choice 路由(传统方法):
- 每个 token 选择 top-k 专家
- 计算分配均匀
- 需要负载均衡损失
Expert-Choice 路由(本文方法):
- 每个专家选择 top-k token
- 计算分配自适应
- 天然负载均衡
Expert-Choice 路由公式
给定输入 ,路由器生成 token-专家亲和力分数张量 :
其中 是路由器权重。
容量因子
设置容量因子 ,确保每个专家处理固定数量的 token:
模型配置
| 配置 | Dense 参数 | EC-DiT 8E | EC-DiT 16E | EC-DiT 32E | EC-DiT 64E |
|---|---|---|---|---|---|
| XL | 1.47B | 2.51B | 3.70B | 6.08B | - |
| XXL | 2.35B | 4.87B | 7.73B | 13.47B | - |
| 3XL | 4.50B | 10.74B | 17.87B | 32.15B | - |
| M | 8.03B | - | - | - | 97.21B |
激活参数: EC-DiT 模型的激活参数与对应 Dense 模型相近(如 EC-DiT-3XL-32E 激活 5.18B vs Dense-3XL 4.50B)。
训练细节
| 项目 | 配置 |
|---|---|
| 数据 | ~1.2B 文本-图像对 |
| 分辨率 | 256×256 |
| Patch 大小 | 2 |
| 序列长度 | 128(使用 0.5 masking ratio) |
| 批量大小 | 4096 |
| 优化器 | RMSProp with momentum |
| 学习率 | 1e-4 |
| Warmup | 20K steps |
| 训练步数 | 800K steps |
| 硬件 | v4/v5p TPUs |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Expert-Choice 路由 | 专家选择 token 而非 token 选择专家 | 天然负载均衡,自适应计算分配 |
| 全局上下文利用 | 利用扩散过程的全局信息 | 非自回归,可访问整个序列 |
| 异构计算分配 | 前景/背景分配不同计算量 | 可视化验证 |
| 扩展到 97B | 64 专家,最大 MoE DiT | GenEval SOTA 71.68% |
五、实验结果
GenEval 评估
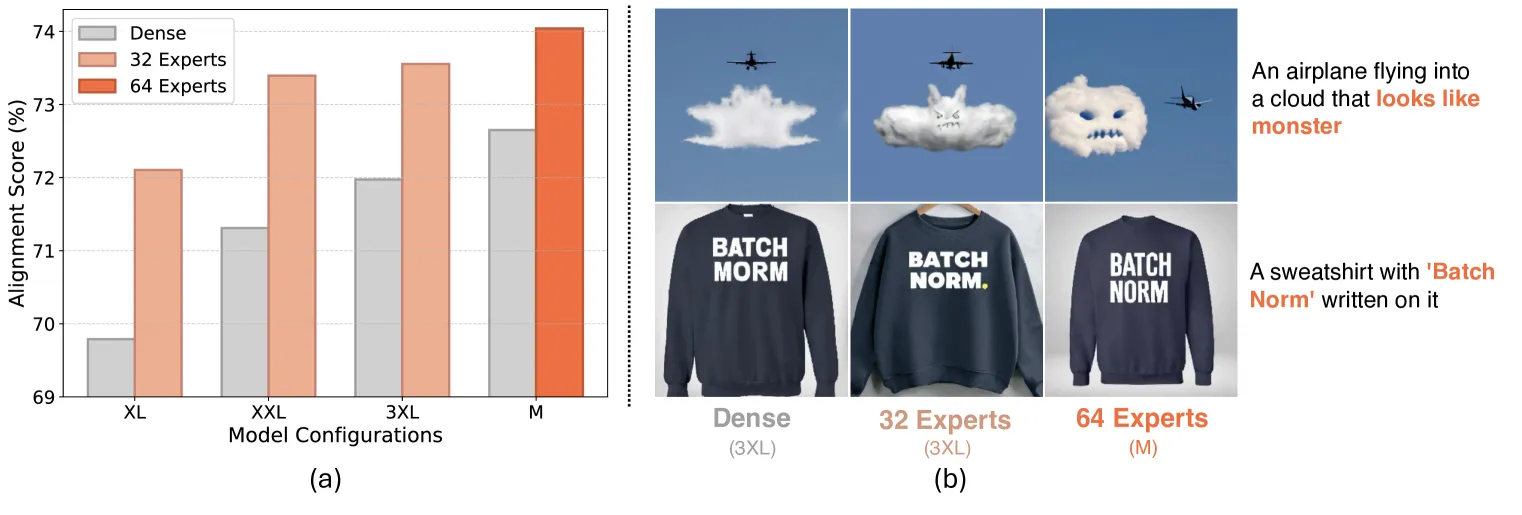
Figure 1: EC-DiT 性能。(a) 四个模型配置下,EC-DiT 始终表现出优越性能。
| 模型 | Overall | Single obj. | Two obj. | Counting | Colors | Position | Color attr. |
|---|---|---|---|---|---|---|---|
| SD v1.5 | 43.00 | 97.00 | 38.00 | 35.00 | 76.00 | 4.00 | 6.00 |
| SD v2.1 | 50.00 | 98.00 | 51.00 | 44.00 | 85.00 | 7.00 | 17.00 |
| SDXL | 55.00 | 98.00 | 74.00 | 39.00 | 85.00 | 15.00 | 23.00 |
| DALL-E 3 | 67.00 | 96.00 | 87.00 | 47.00 | 83.00 | 43.00 | 45.00 |
| SD3 | 68.00 | 98.00 | 84.00 | 66.00 | 74.00 | 40.00 | 43.00 |
| SD3 w/ DPO | 71.00 | 98.00 | 89.00 | 73.00 | 83.00 | 34.00 | 47.00 |
| Dense-3XL | 68.92 | 99.69 | 86.00 | 69.41 | 81.67 | 20.58 | 56.19 |
| EC-DiT-3XL-32E | 70.91 | 99.64 | 87.88 | 72.53 | 83.84 | 21.19 | 60.40 |
| EC-DiT-M-64E | 71.68 | 99.84 | 88.67 | 73.69 | 85.77 | 21.33 | 60.80 |
关键结果:
- EC-DiT-M-64E 达到 71.68% GenEval 分数,超越 SD3 w/ DPO (71.00%)
- 在大多数子任务上达到最佳
- 即使在较低分辨率 (256×256) 下也超越 SD3 (512×512)
DSG 评估
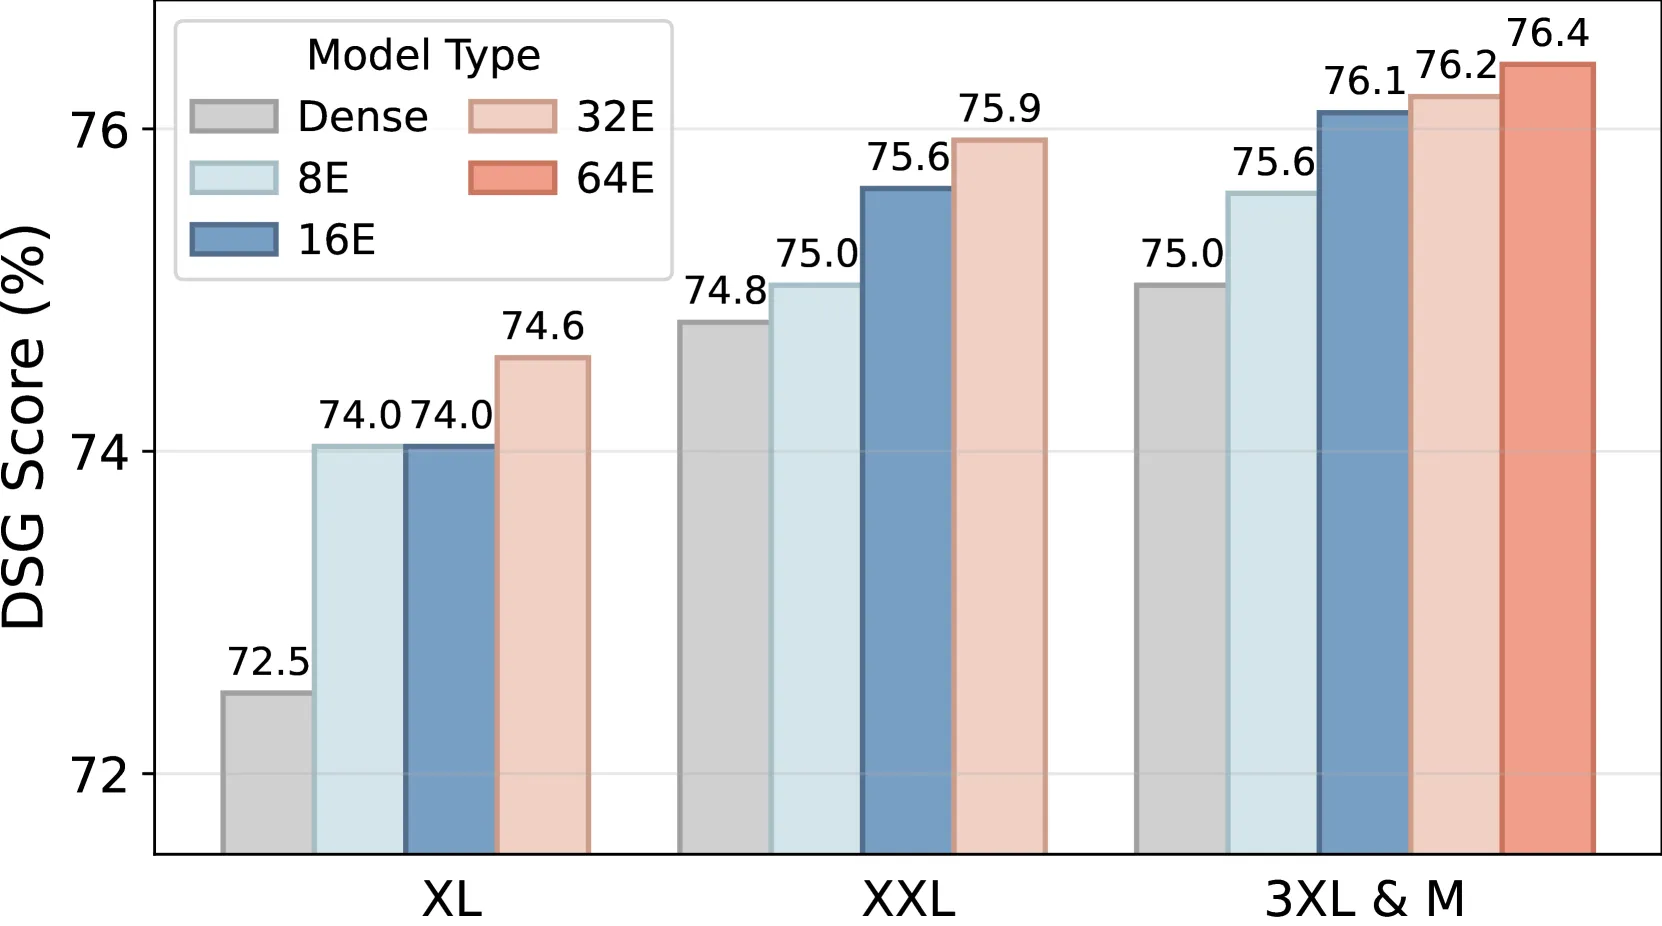
Figure 3: DSG 比较。使用 EC-DiT 扩展提升性能。
训练收敛
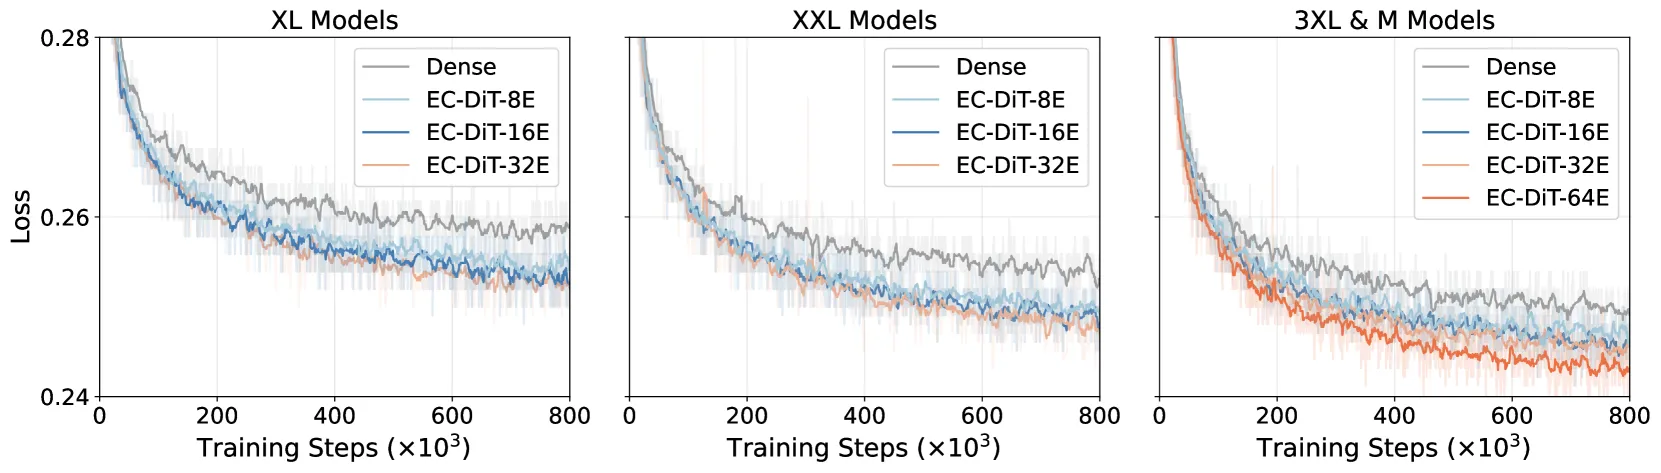
Figure 9: EC-DiT 训练损失。结果显示 Dense 模型和稀疏 EC-DiT 之间存在明显的损失差距。
关键发现:
- EC-DiT 收敛更快
- 更多专家 → 更好的收敛
- 计算开销增加 <30%
FID vs CLIP Score
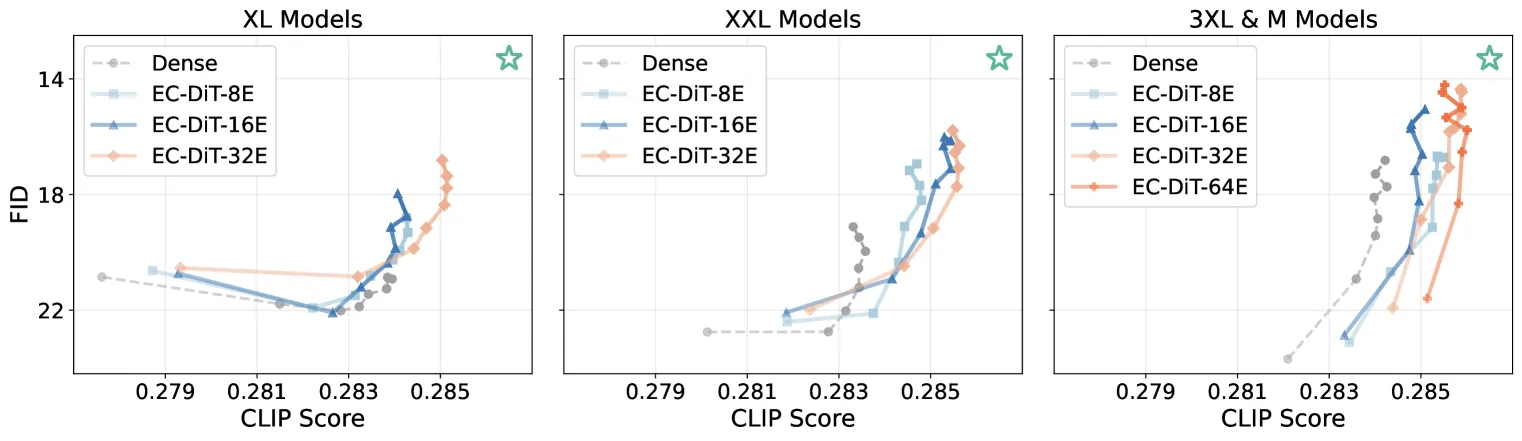
Figure 8: 训练过程中的 FID vs CLIP Score 曲线。越靠近右上角 (☆) 越好。
关键发现:
- EC-DiT 在 FID 和 CLIP Score 上都优于 Dense 模型
- 更多专家 → 更好的图像质量
推理效率
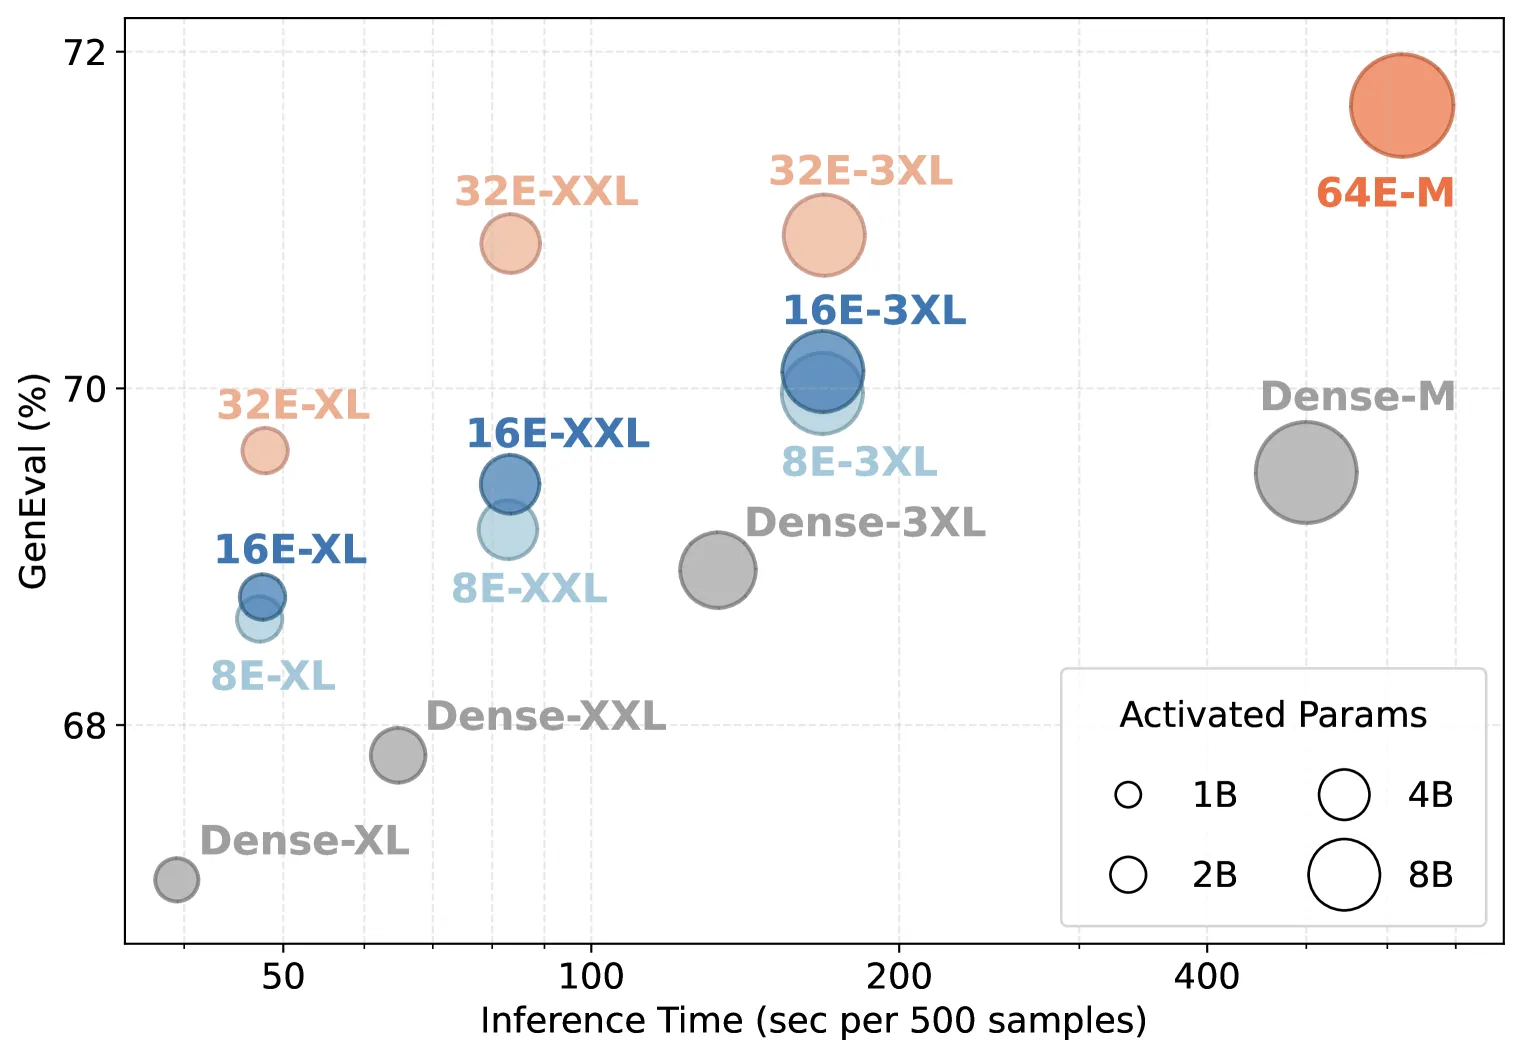
Figure 4: 推理时效率。圆圈大小与总激活参数成正比。
关键结果:
- EC-DiT 保持竞争性的推理速度
- 激活参数与 Dense 模型相近
- 更多专家不显著增加推理时间
自适应计算分配可视化
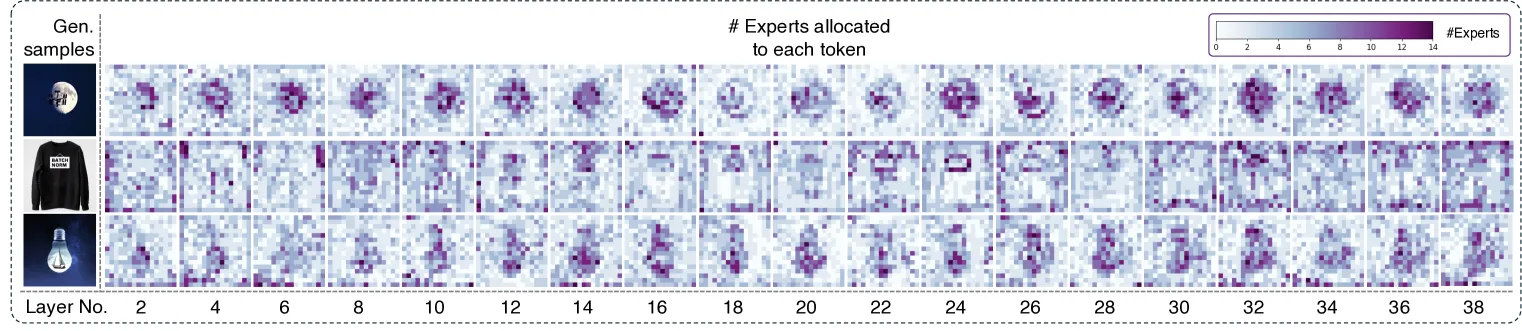
Figure 6a: 去噪步骤 t=40 时每个稀疏层的分配。
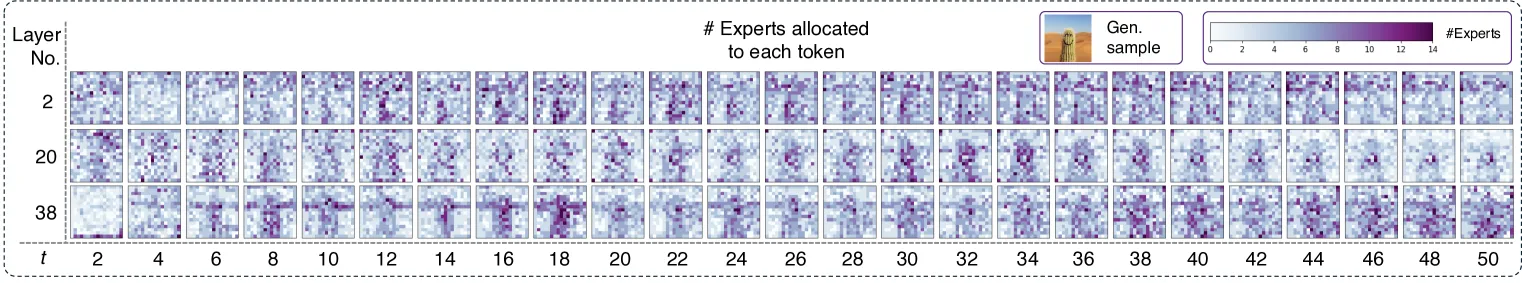
Figure 6b: 每个去噪时间步 t 的分配。
关键发现:
- 前景区域获得更多计算(如空间站、月球)
- 背景区域获得较少计算
- 不同去噪步骤分配不同:早期步骤(语义理解)分配更多计算
六、与现有方法对比
| 方面 | SD3 | Dense DiT | Token-Choice MoE | EC-DiT |
|---|---|---|---|---|
| 路由策略 | - | - | Token-Choice | Expert-Choice |
| 计算分配 | 均匀 | 均匀 | 均匀 | 自适应 |
| 负载均衡 | - | - | 需要辅助损失 | 天然均衡 |
| 最大参数 | 8B | 8B | ~30B | 97B |
| GenEval | 68.00% | 68.92% | ~69% | 71.68% |
| 推理速度 | 基线 | 基线 | 略慢 | 竞争性 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| SD3 | SOTA 基线,EC-DiT 超越其 GenEval 分数 |
| PixArt-α | DiT 基线,EC-DiT 提供更好的扩展性 |
| SDXL | 扩散模型基线,EC-DiT 在对齐上更优 |
| Token-Choice MoE | 传统 MoE 路由,EC-DiT 提供更好的替代方案 |
| DALL-E 3 | 商业模型,EC-DiT 在 GenEval 上超越 |
八、总结
核心贡献
- Expert-Choice 路由: 首次将专家选择路由应用于扩散 Transformer
- 自适应计算分配: 利用全局信息优化计算资源分配
- 97B 参数扩展: 最大 MoE DiT 模型,GenEval SOTA
- 异构计算: 前景/背景分配不同计算量
技术影响
- DiT 扩展: 为 DiT 提供高效的扩展方法
- MoE 应用: 证明 Expert-Choice 路由在扩散模型中的有效性
- 文本-图像对齐: GenEval 71.68% 为新 SOTA
- 计算效率: <30% 计算开销增加实现显著性能提升
局限性
- 仅在 256×256 分辨率上验证
- 代码和模型未公开
- 未探索更高分辨率 (512×512, 1024×1024)
- 未与最新模型 (如 FLUX, SDXL Turbo) 比较
九、参考资源
- 论文: arXiv:2410.02098
- 主题: cs.CV
- 页数: 约 20 页, 10 图, 12 表