Training Ultra Long Context Language Model with Fully Pipelined Distributed Transformer
提出全流水线分布式Transformer架构,支持超长上下文语言模型的高效训练。
Training Ultra Long Context Language Model with Fully Pipelined Distributed Transformer
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | Training Ultra Long Context Language Model with Fully Pipelined Distributed Transformer |
| arXiv ID | 2408.16978 |
| 发表时间 | 2024年8月30日 (v1),2025年5月13日 (v2) |
| 会议 | MLSys 2025 |
| 作者 | Jinghan Yao, Sam Ade Jacobs, Masahiro Tanaka, Olatunji Ruwase, Hari Subramoni, Dhabaleswar K. Panda |
| 代码 | DeepSpeed PR #6462 |
1.2 摘要
具有长上下文能力的大语言模型(LLMs)对于自然语言处理和计算生物学中的复杂任务至关重要,如文本生成和蛋白质序列分析。然而,直接在极长上下文上训练LLMs需要大量的GPU资源和更多的内存,导致更高的成本和更大的复杂性。通过下游微调或适配引入长上下文能力的替代方法会带来显著的设计限制。
本文提出了全流水线分布式Transformer (Fully Pipelined Distributed Transformer, FPDT),用于以极高的硬件效率高效训练长上下文LLMs。对于GPT和Llama模型,与当前最先进的解决方案相比,在相同硬件上实现了16倍的序列长度提升。通过专用的序列块流水线设计,现在可以在仅4个GPU上训练具有200万序列长度的8B LLM,同时保持超过55%的MFU。FPDT与现有训练技术无关,并被证明在不同LLM模型上都能高效工作。
2.1 问题背景
随着GPT-4、Claude和Gemini等LLMs的快速发展,对扩展上下文窗口以处理更长输入序列的需求日益增长。长上下文能力对于以下应用至关重要:
- 文档分析:处理整个法律文档或科学论文
- 长篇内容生成:撰写书籍或详细报告
- 对话式AI:维护连贯且上下文相关的长期对话
- 复杂推理任务:医疗保健、气候和金融领域
2.2 现有方法的局限性
| 方法 | 问题 |
|---|---|
| Megatron-SP | 训练7B模型256K上下文需要32+ A100 80G GPU |
| DeepSpeed Ulysses | 训练1.2B GPT模型1M上下文需要64 A100 GPU |
| RoPE外推 | 性能会随着序列长度增加而崩溃 |
| FlashAttention | 虽然将内存复杂度从O(N²)降到O(N),但常数因子仍然很大 |
2.3 核心目标
FPDT旨在解决以下关键挑战:
- 内存瓶颈:随着序列长度增加,激活内存和中间缓冲区成比例增长
- 硬件效率:在有限GPU资源下实现超长上下文训练
- 通用性:与现有训练技术正交组合
3.1 整体架构
FPDT基于DeepSpeed Ulysses序列并行,结合以下关键技术:
graph TB
    A[输入序列] --> B[序列分块]
    B --> C[QKV投影]
    C --> D[Alltoall通信]
    D --> E[分布式注意力计算]
    E --> F[FFN层]
    F --> G[输出]

    H[GPU HBM] <--> I[CPU主机内存]
    E <--> I
3.2 关键组件
3.2.1 序列分块流水线
FPDT将输入序列分割为多个块(chunk),每个块的大小为原始序列的1/u:
| 符号 | 含义 |
|---|---|
[b, s_local, h_global, d] | 非注意力操作的张量形状 |
[b, s_global, h_local, d] | 分布式注意力的张量形状 |
u | 分块数量 |
T_i | 第i个序列块 |
3.2.2 流水线调度流程
对于每个块 T_i:
  1. QKV投影: c_i -> q_i, k_i, v_i
  2. Alltoall通信: 分散头、收集序列
  3. 注意力计算: 使用因果掩码
  4. KV缓存: 将 k_i^, v_i^ 卸载到主机内存
  5. 前一块获取: 从主机内存获取之前的KV块
  6. 在线注意力更新: 逐步更新注意力输出
3.2.3 双缓冲设计
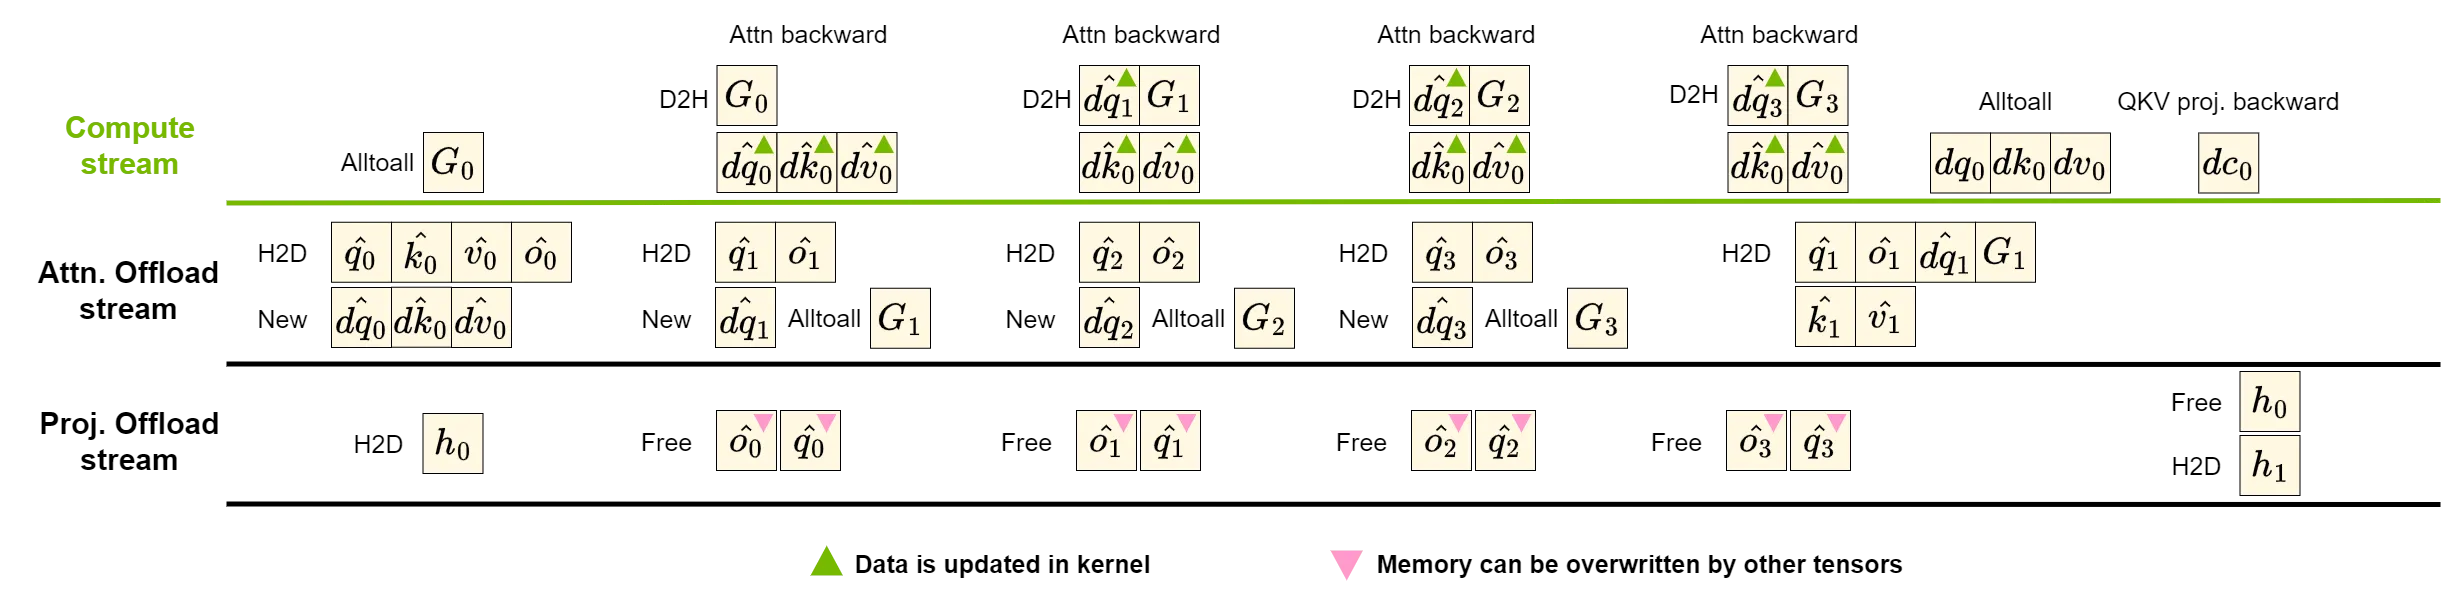
双缓冲设计利用多个CUDA流,在反向传播期间将大部分卸载操作与注意力梯度计算重叠:
- 计算流:执行注意力梯度计算
- 通信流:执行数据预取和卸载
- 重叠:几乎所有的预取操作与计算重叠
3.3 序列重排
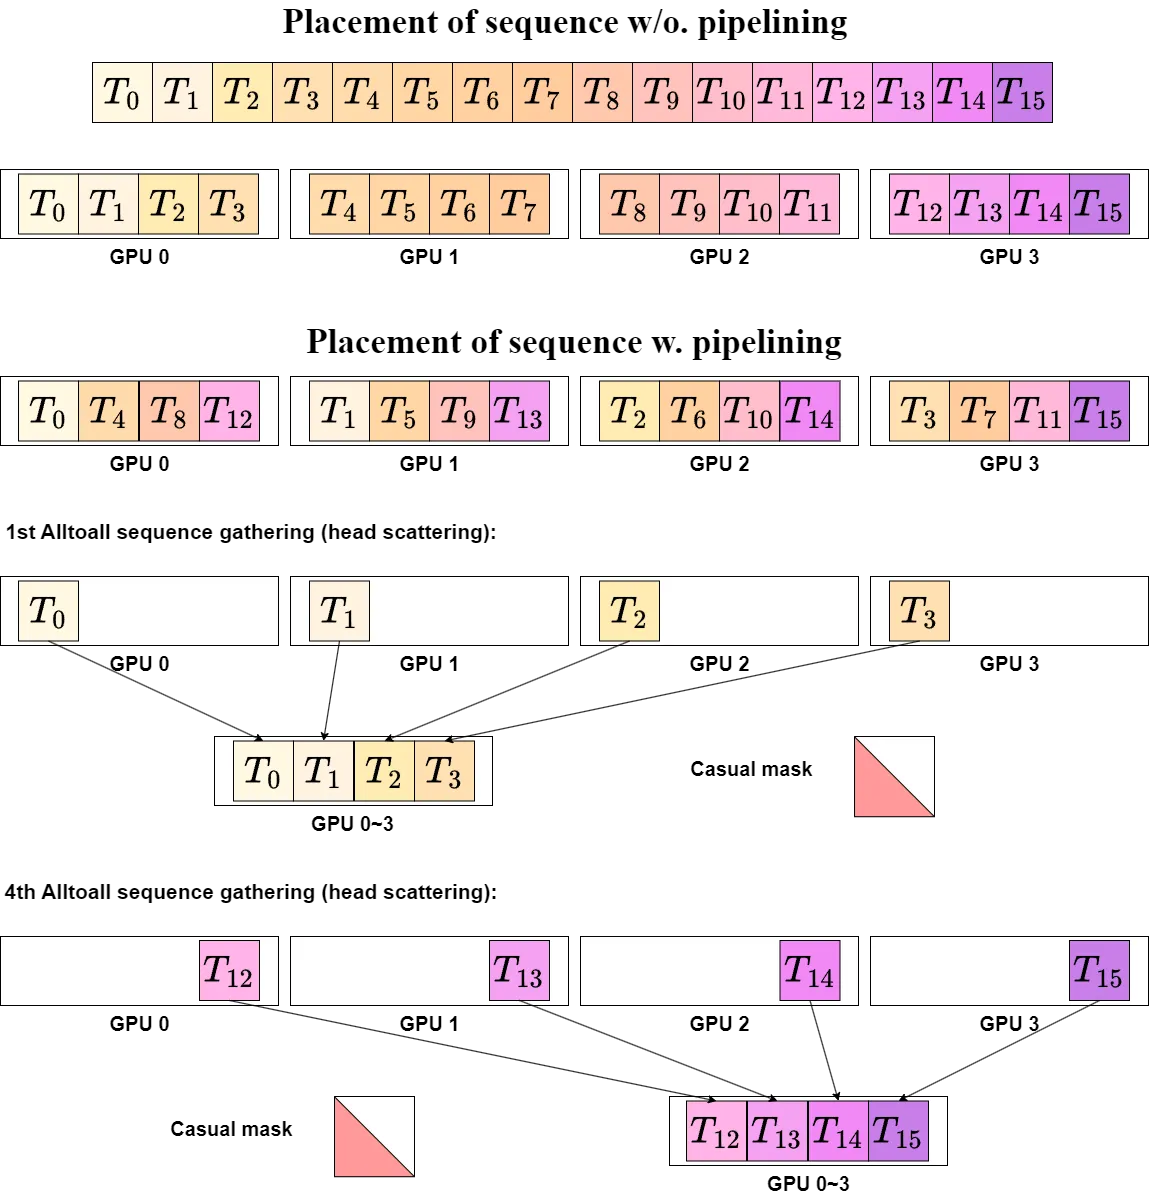
由于分块Alltoall操作,需要对序列进行重排以保持因果掩码的有效性:
- 对角线因果掩码在每个块Alltoall操作后保持有效
- NVLINK负载均衡通过数据布局实现
- 标签相应重排,损失计算仍然匹配
4.1 内存分析与优化
4.1.1 Transformer块的内存占用
| 操作 | 前向传播 | 反向传播 |
|---|---|---|
| Hidden | Nd | 2Nd |
| QKV投影 | 3Nd | 6Nd |
| Alltoall | 4Nd | 8Nd |
| 注意力 | 4Nd | 8Nd |
| FFN | 4Nd | - |
| 其他操作 | 3Nd | - |
关键发现:
- QKV投影将内存占用增加3倍
- Alltoall通信需要接收缓冲区,异步通信时需要6Nd内存
- FlashAttention反向传播需要8Nd内存
4.1.2 内存优化策略
- 序列分块:将内存占用降低为原来的1/u
- 主机内存卸载:将KV缓存卸载到CPU
- 双缓冲重叠:隐藏通信延迟
4.2 与现有技术的正交组合
| 技术 | 组合方式 |
|---|---|
| DeepSpeed ZeRO-3 | 分区所有参数、梯度和优化器状态 |
| PyTorch FSDP | 完全分片数据并行 |
| FlashAttention | 作为注意力计算的后端 |
| 激活检查点 | 可选组合使用 |
4.3 与相关方法的对比
| 方法 | 通信模式 | 内存效率 | 硬件要求 |
|---|---|---|---|
| Megatron-SP | All-gather/Reduce-scatter | 中等 | 高(32+ GPU) |
| Ring Attention | 多步通信 | 中等 | 中等 |
| DeepSpeed Ulysses | All-to-all | 高 | 中等(64 GPU) |
| MsT | - | 中等(仅MLP) | 低 |
| MEMO | Tensor并行 | 中等 | 中等 |
| FPDT | All-to-all + 卸载 | 极高 | 极低(4 GPU) |
5.1 最大上下文长度支持
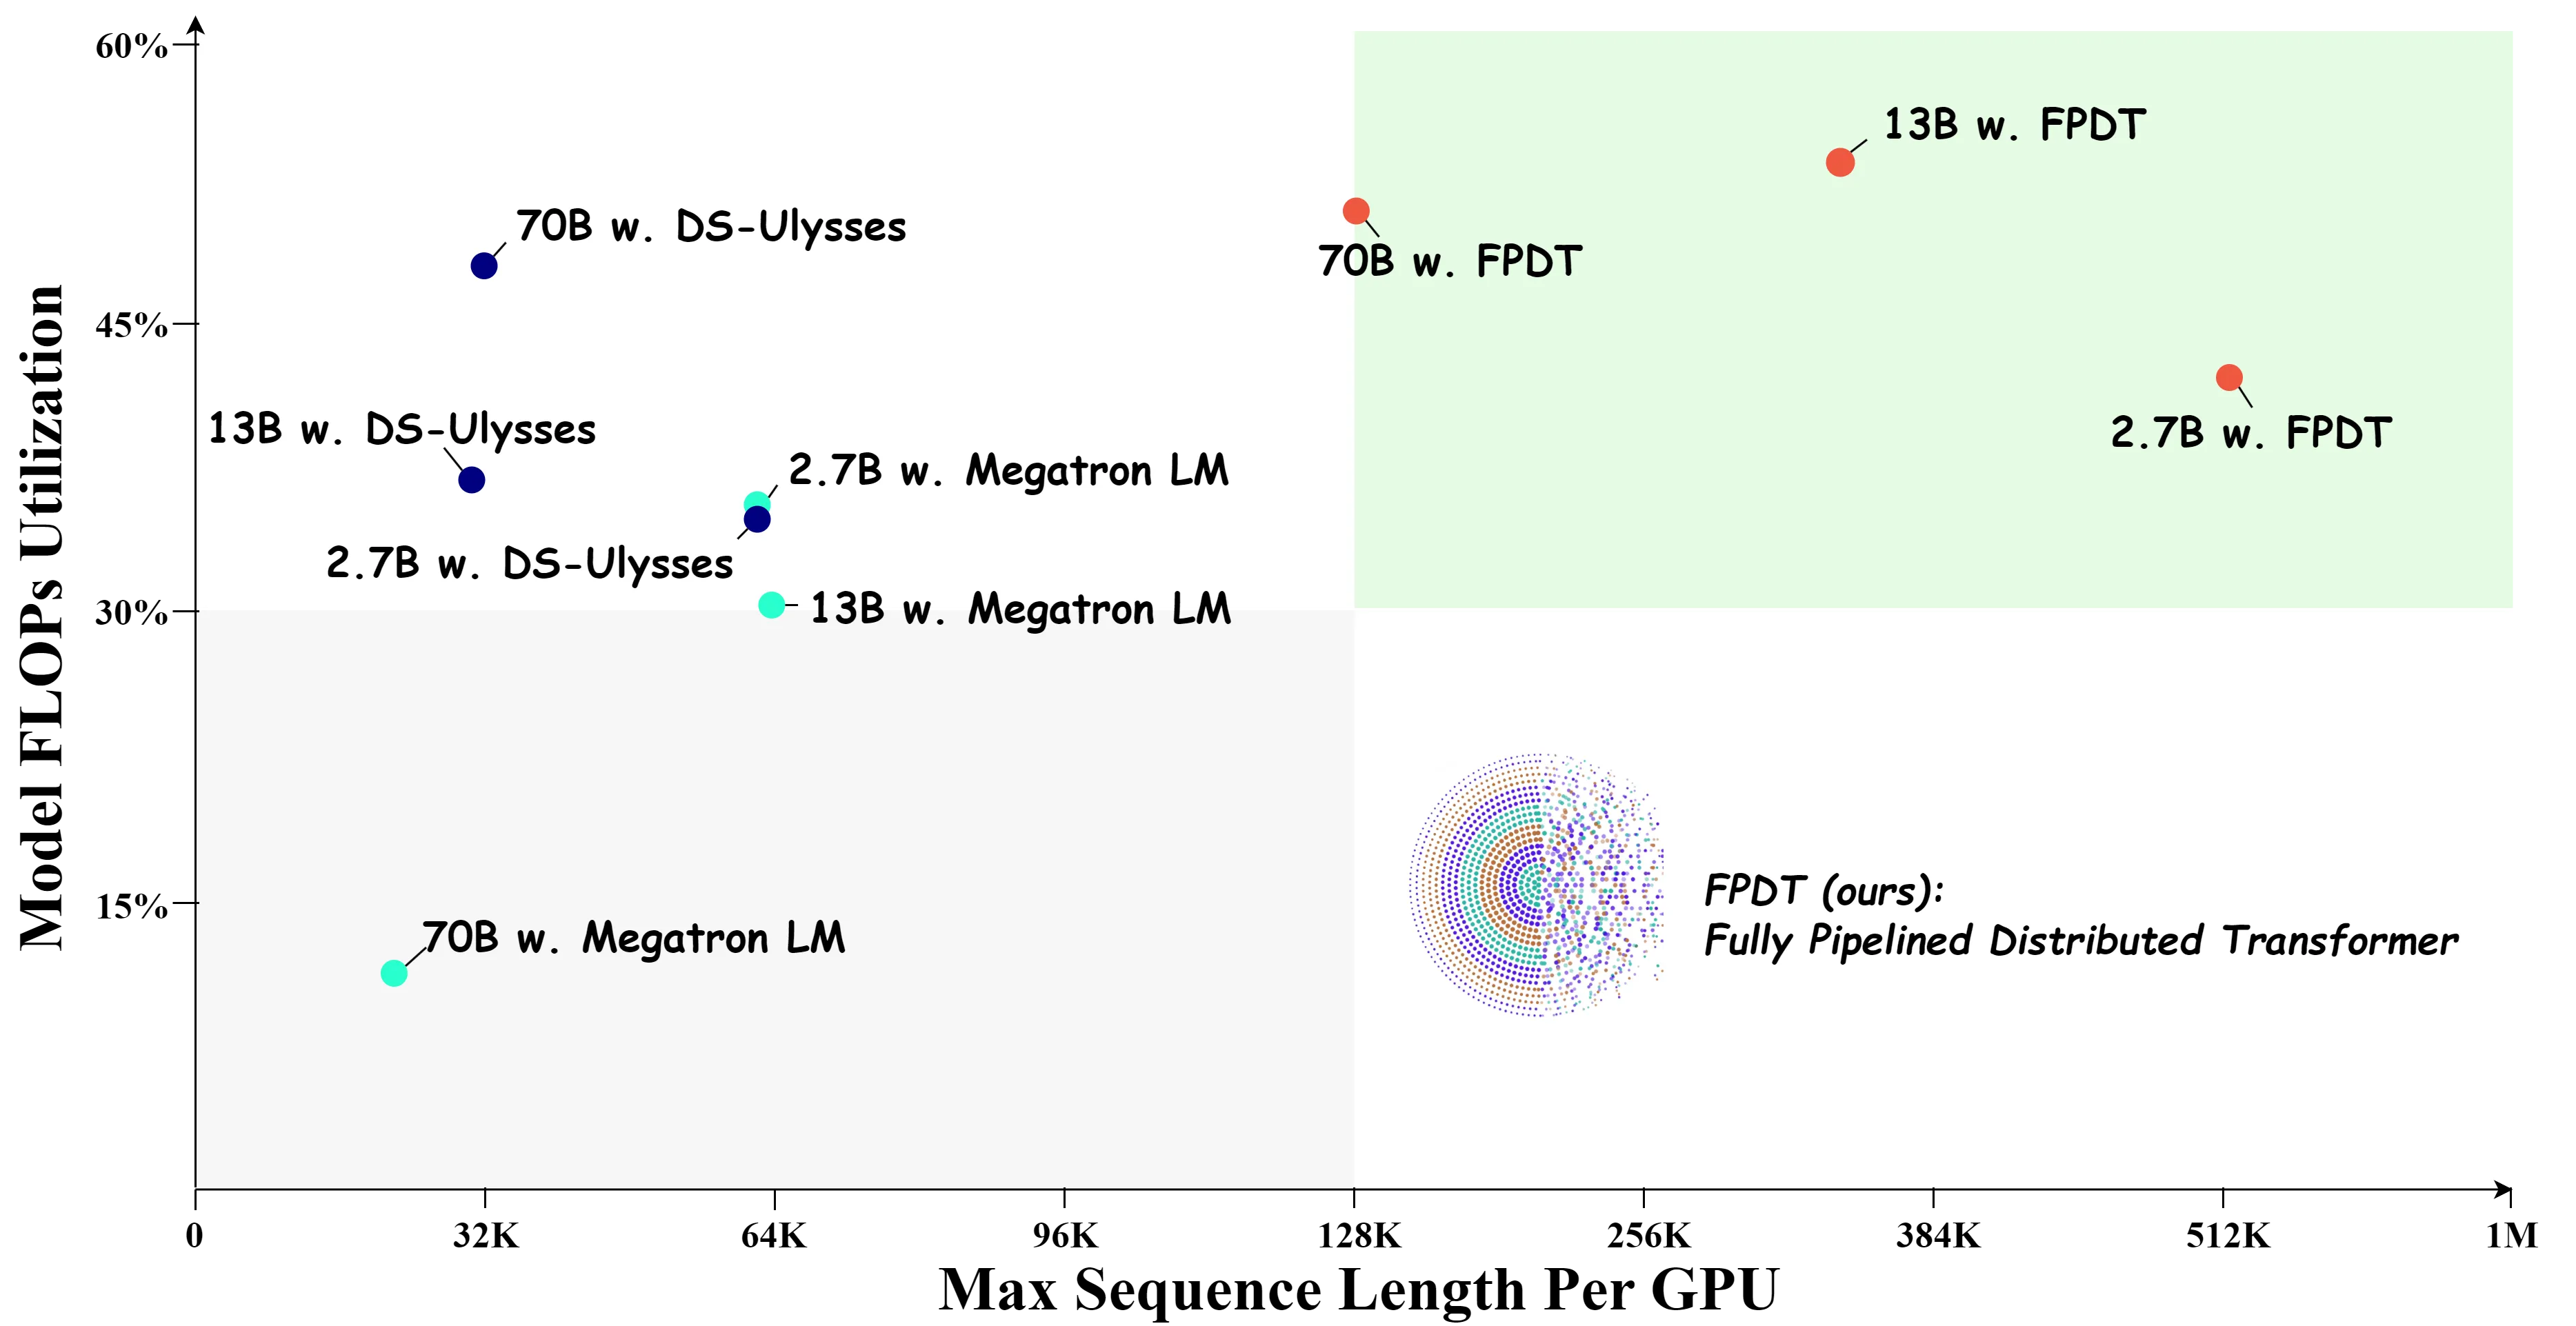
Table 1: FPDT支持的最大上下文长度
| 模型规模 | A100 40G (1 GPU) | A100 40G (2 GPU) | A100 40G (4 GPU) | A100 40G (8 GPU) | A100 80G (4 GPU) | A100 80G (8 GPU) | A100 80G (16 GPU) | A100 80G (32 GPU) |
|---|---|---|---|---|---|---|---|---|
| 2.7B | 128K | 512K | 2M | 4M | 4M | 8M+ | 8M+ | 8M+ |
| 8B | - | - | - | 1M | 2M | 4M | 8M+ | 8M+ |
| 13B | - | - | - | 256K | 512K | 3M | 4M | 8M+ |
| 30B | - | - | - | - | - | 1M | 3M | 4M |
| 70B | - | - | - | - | - | - | 1M | 4M |
注:+表示只测试到该长度,-表示模型本身无法放入GPU内存。
5.2 性能对比
5.2.1 关键性能指标
| 模型 | GPU数量 | 最大序列长度 | MFU |
|---|---|---|---|
| GPT 2.7B | 2 GPU | 512K | >55% |
| GPT 6.7B | 4 GPU | 1M | >55% |
| Llama 8B | 4 GPU | 2M | >55% |
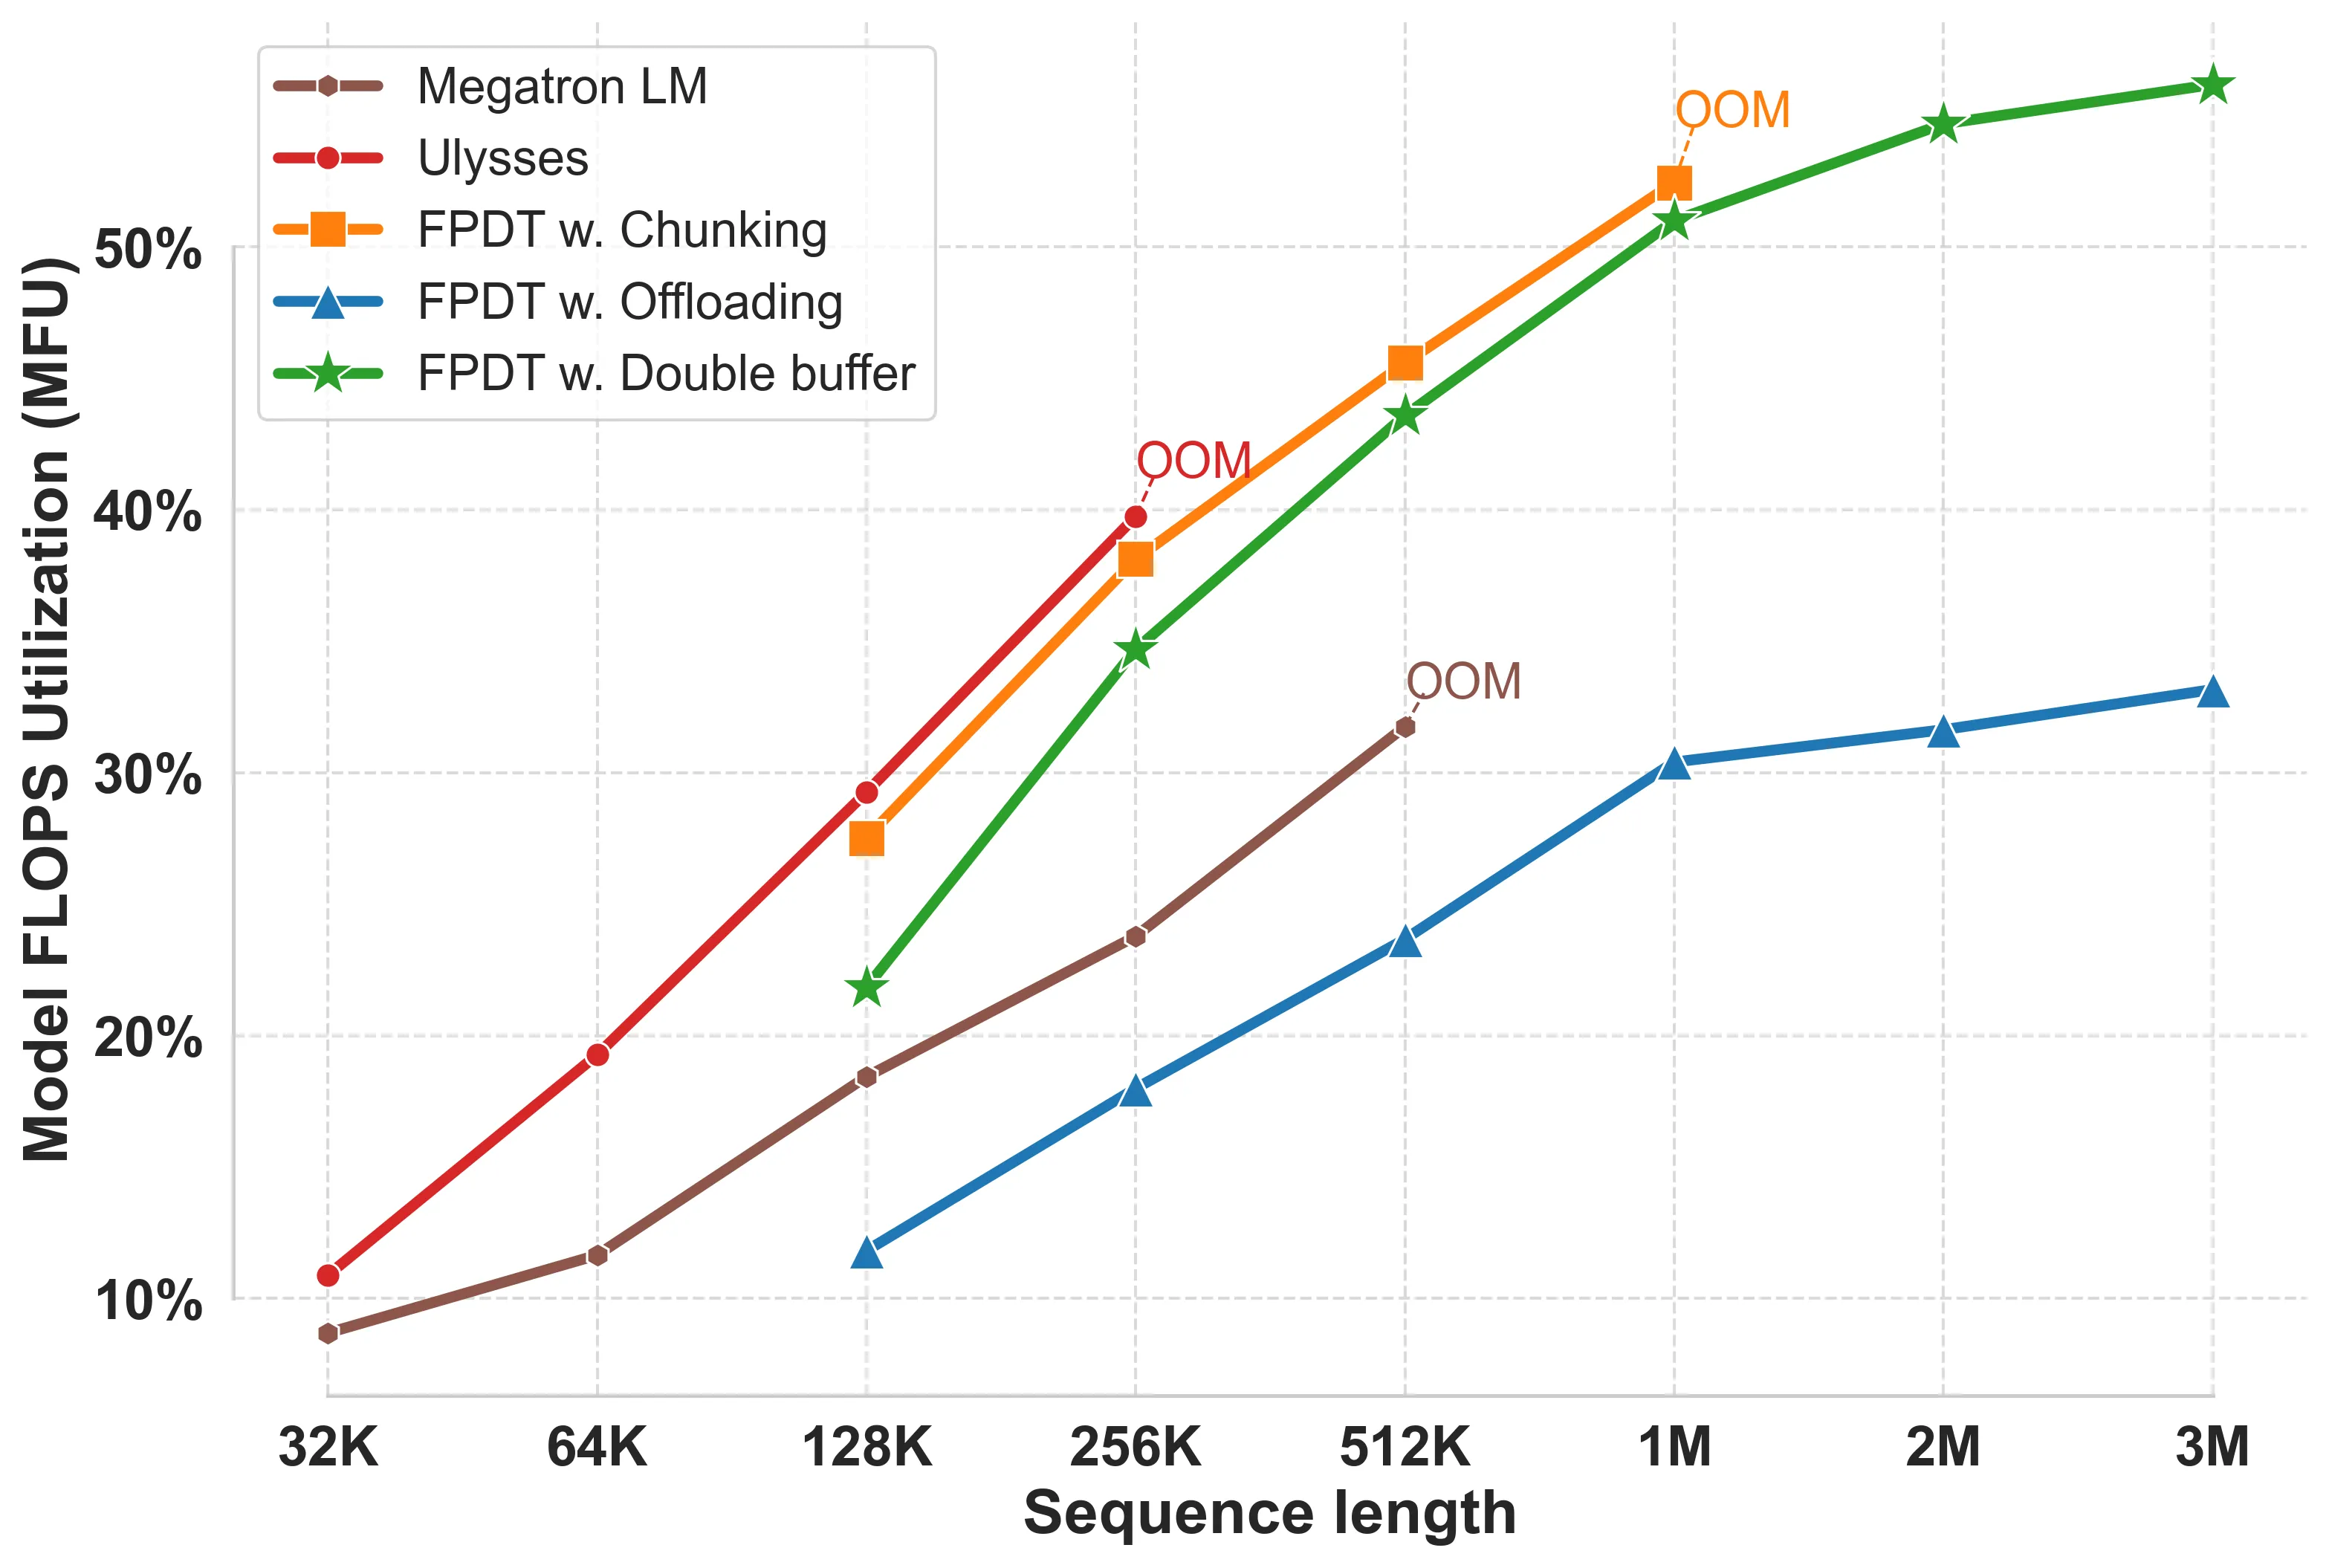
| GPT 13B | 8 GPU | 3M | >55% |
| Llama 70B | 32 GPU | 4M | >55% |
5.2.2 与现有方案对比
| 对比维度 | 现有方案 | FPDT | 提升倍数 |
|---|---|---|---|
| 7B模型256K上下文 | 32 GPU (Megatron-SP) | 4 GPU | 8x |
| 1.2B模型1M上下文 | 64 GPU (Ulysses) | 4 GPU | 16x |
| 8B模型2M上下文 | 不可行 | 4 GPU | - |
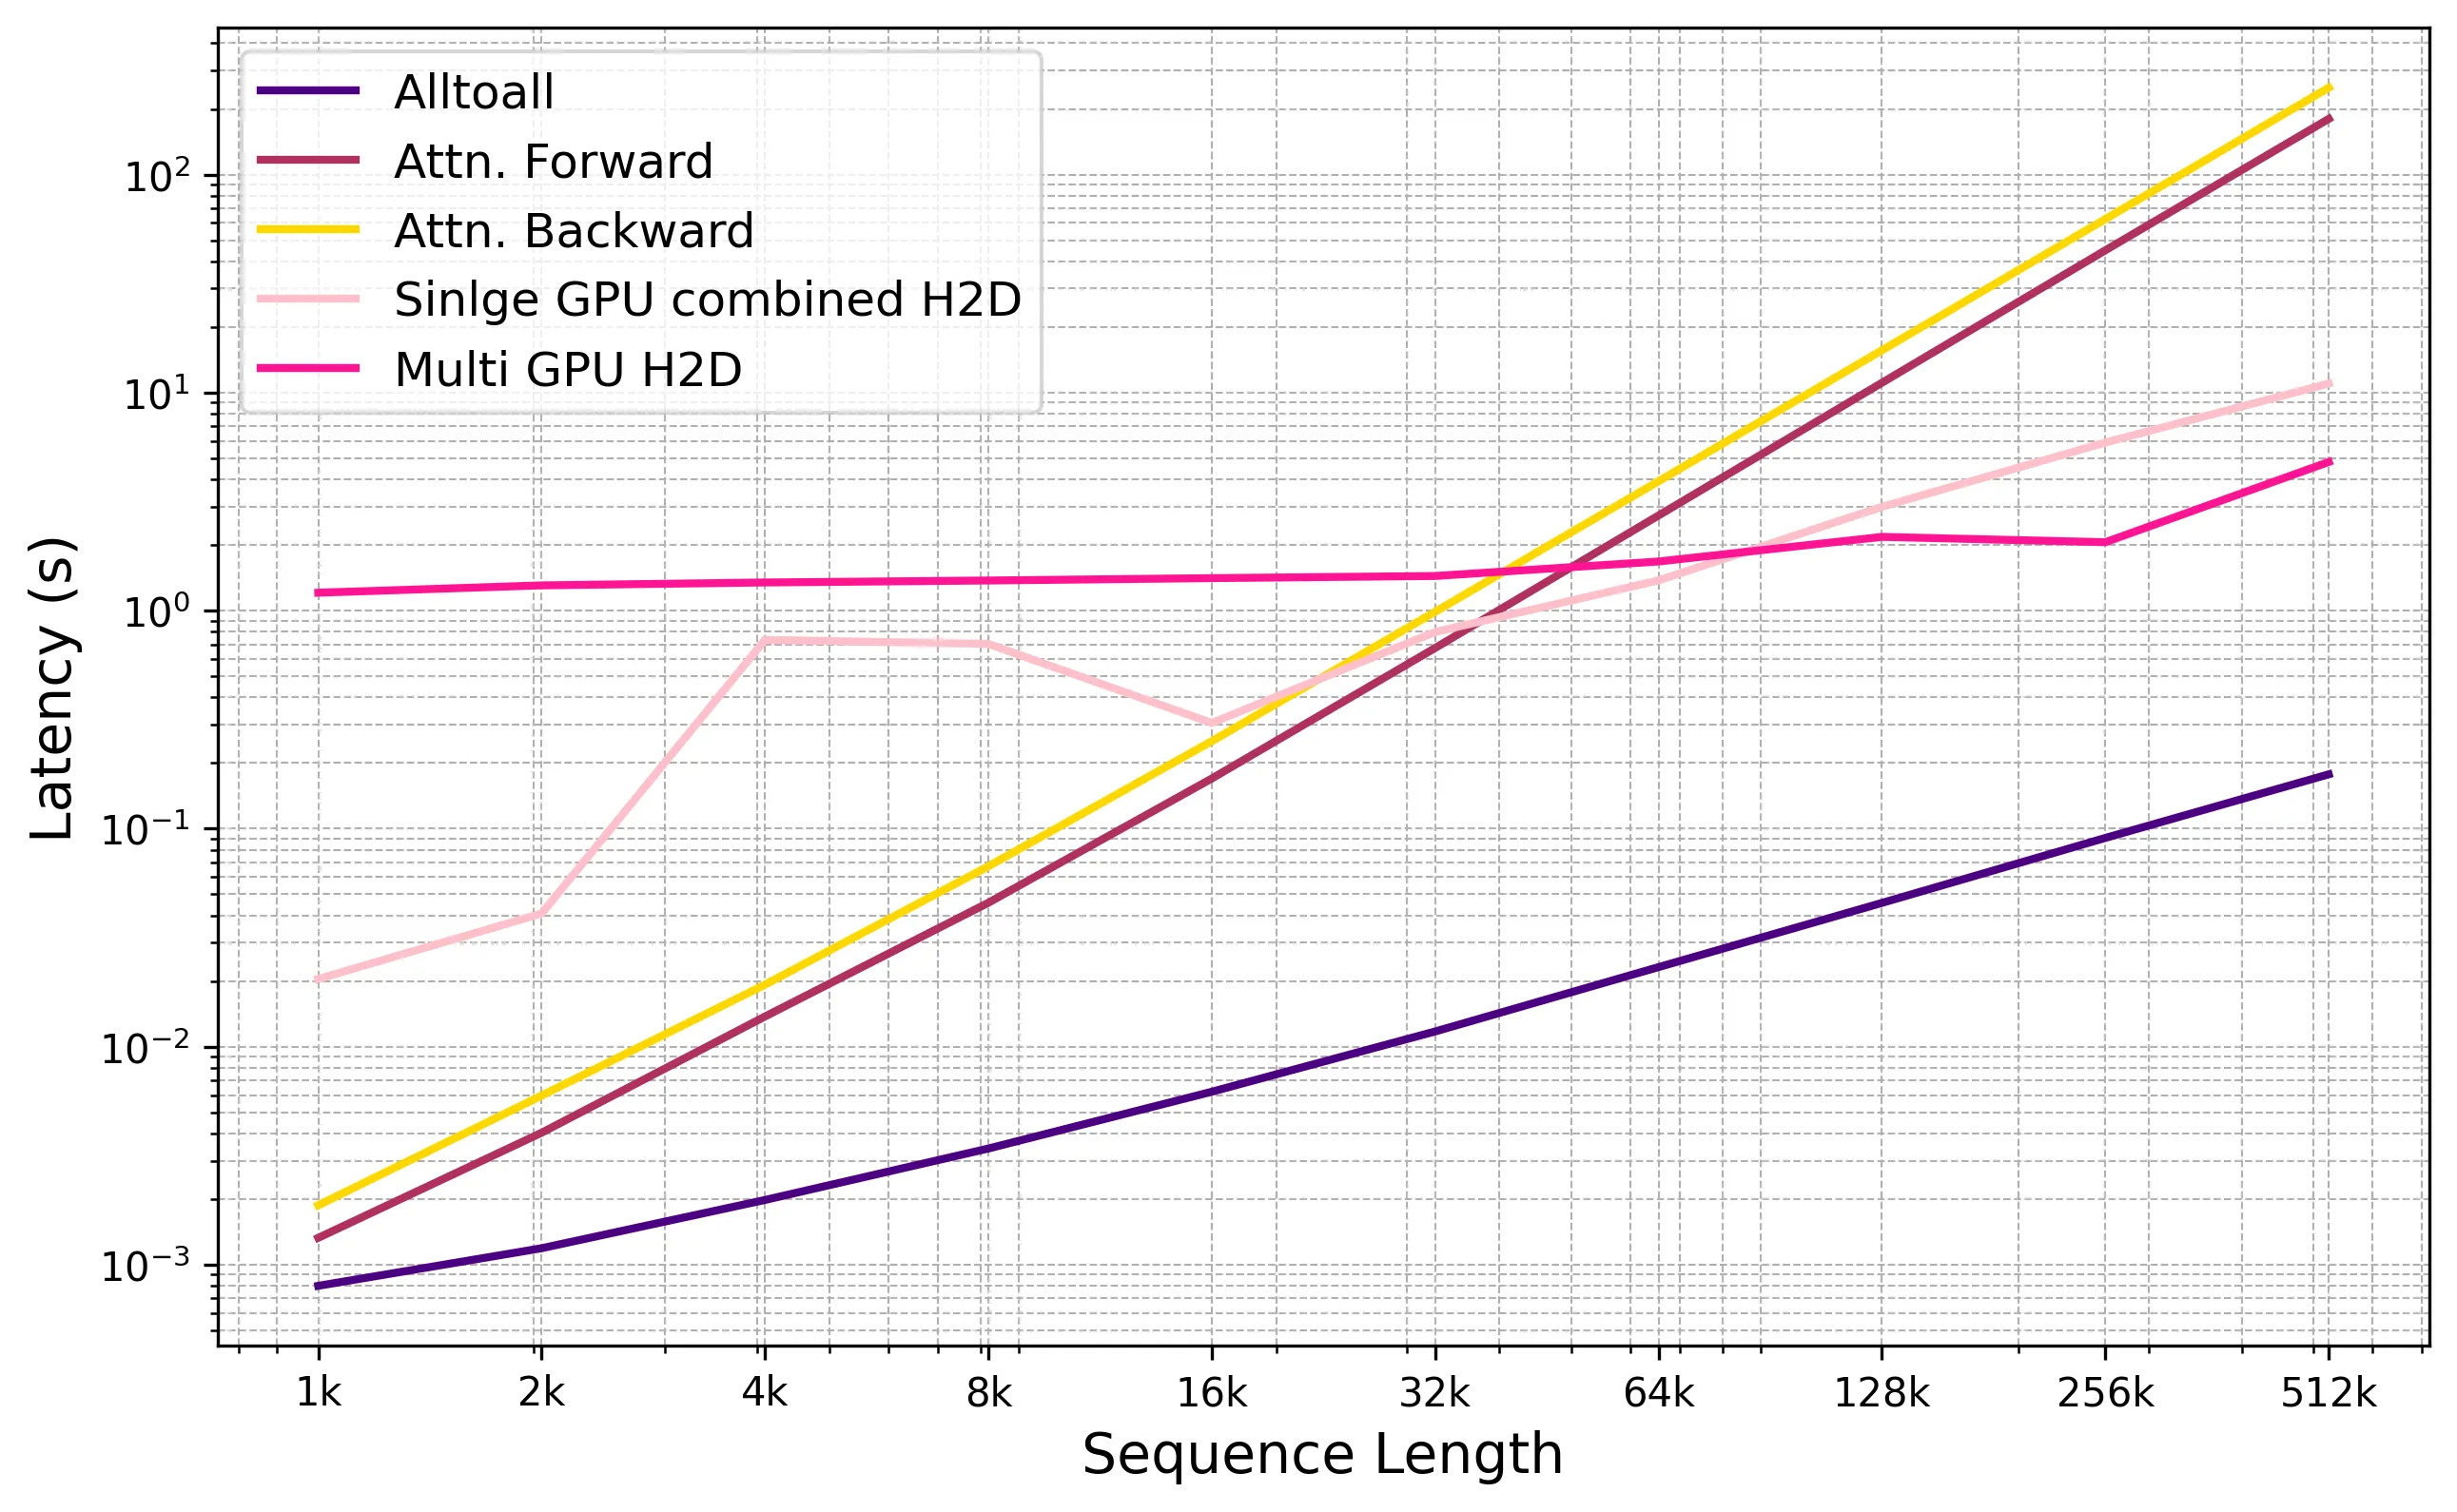
5.3 序列块大小权衡
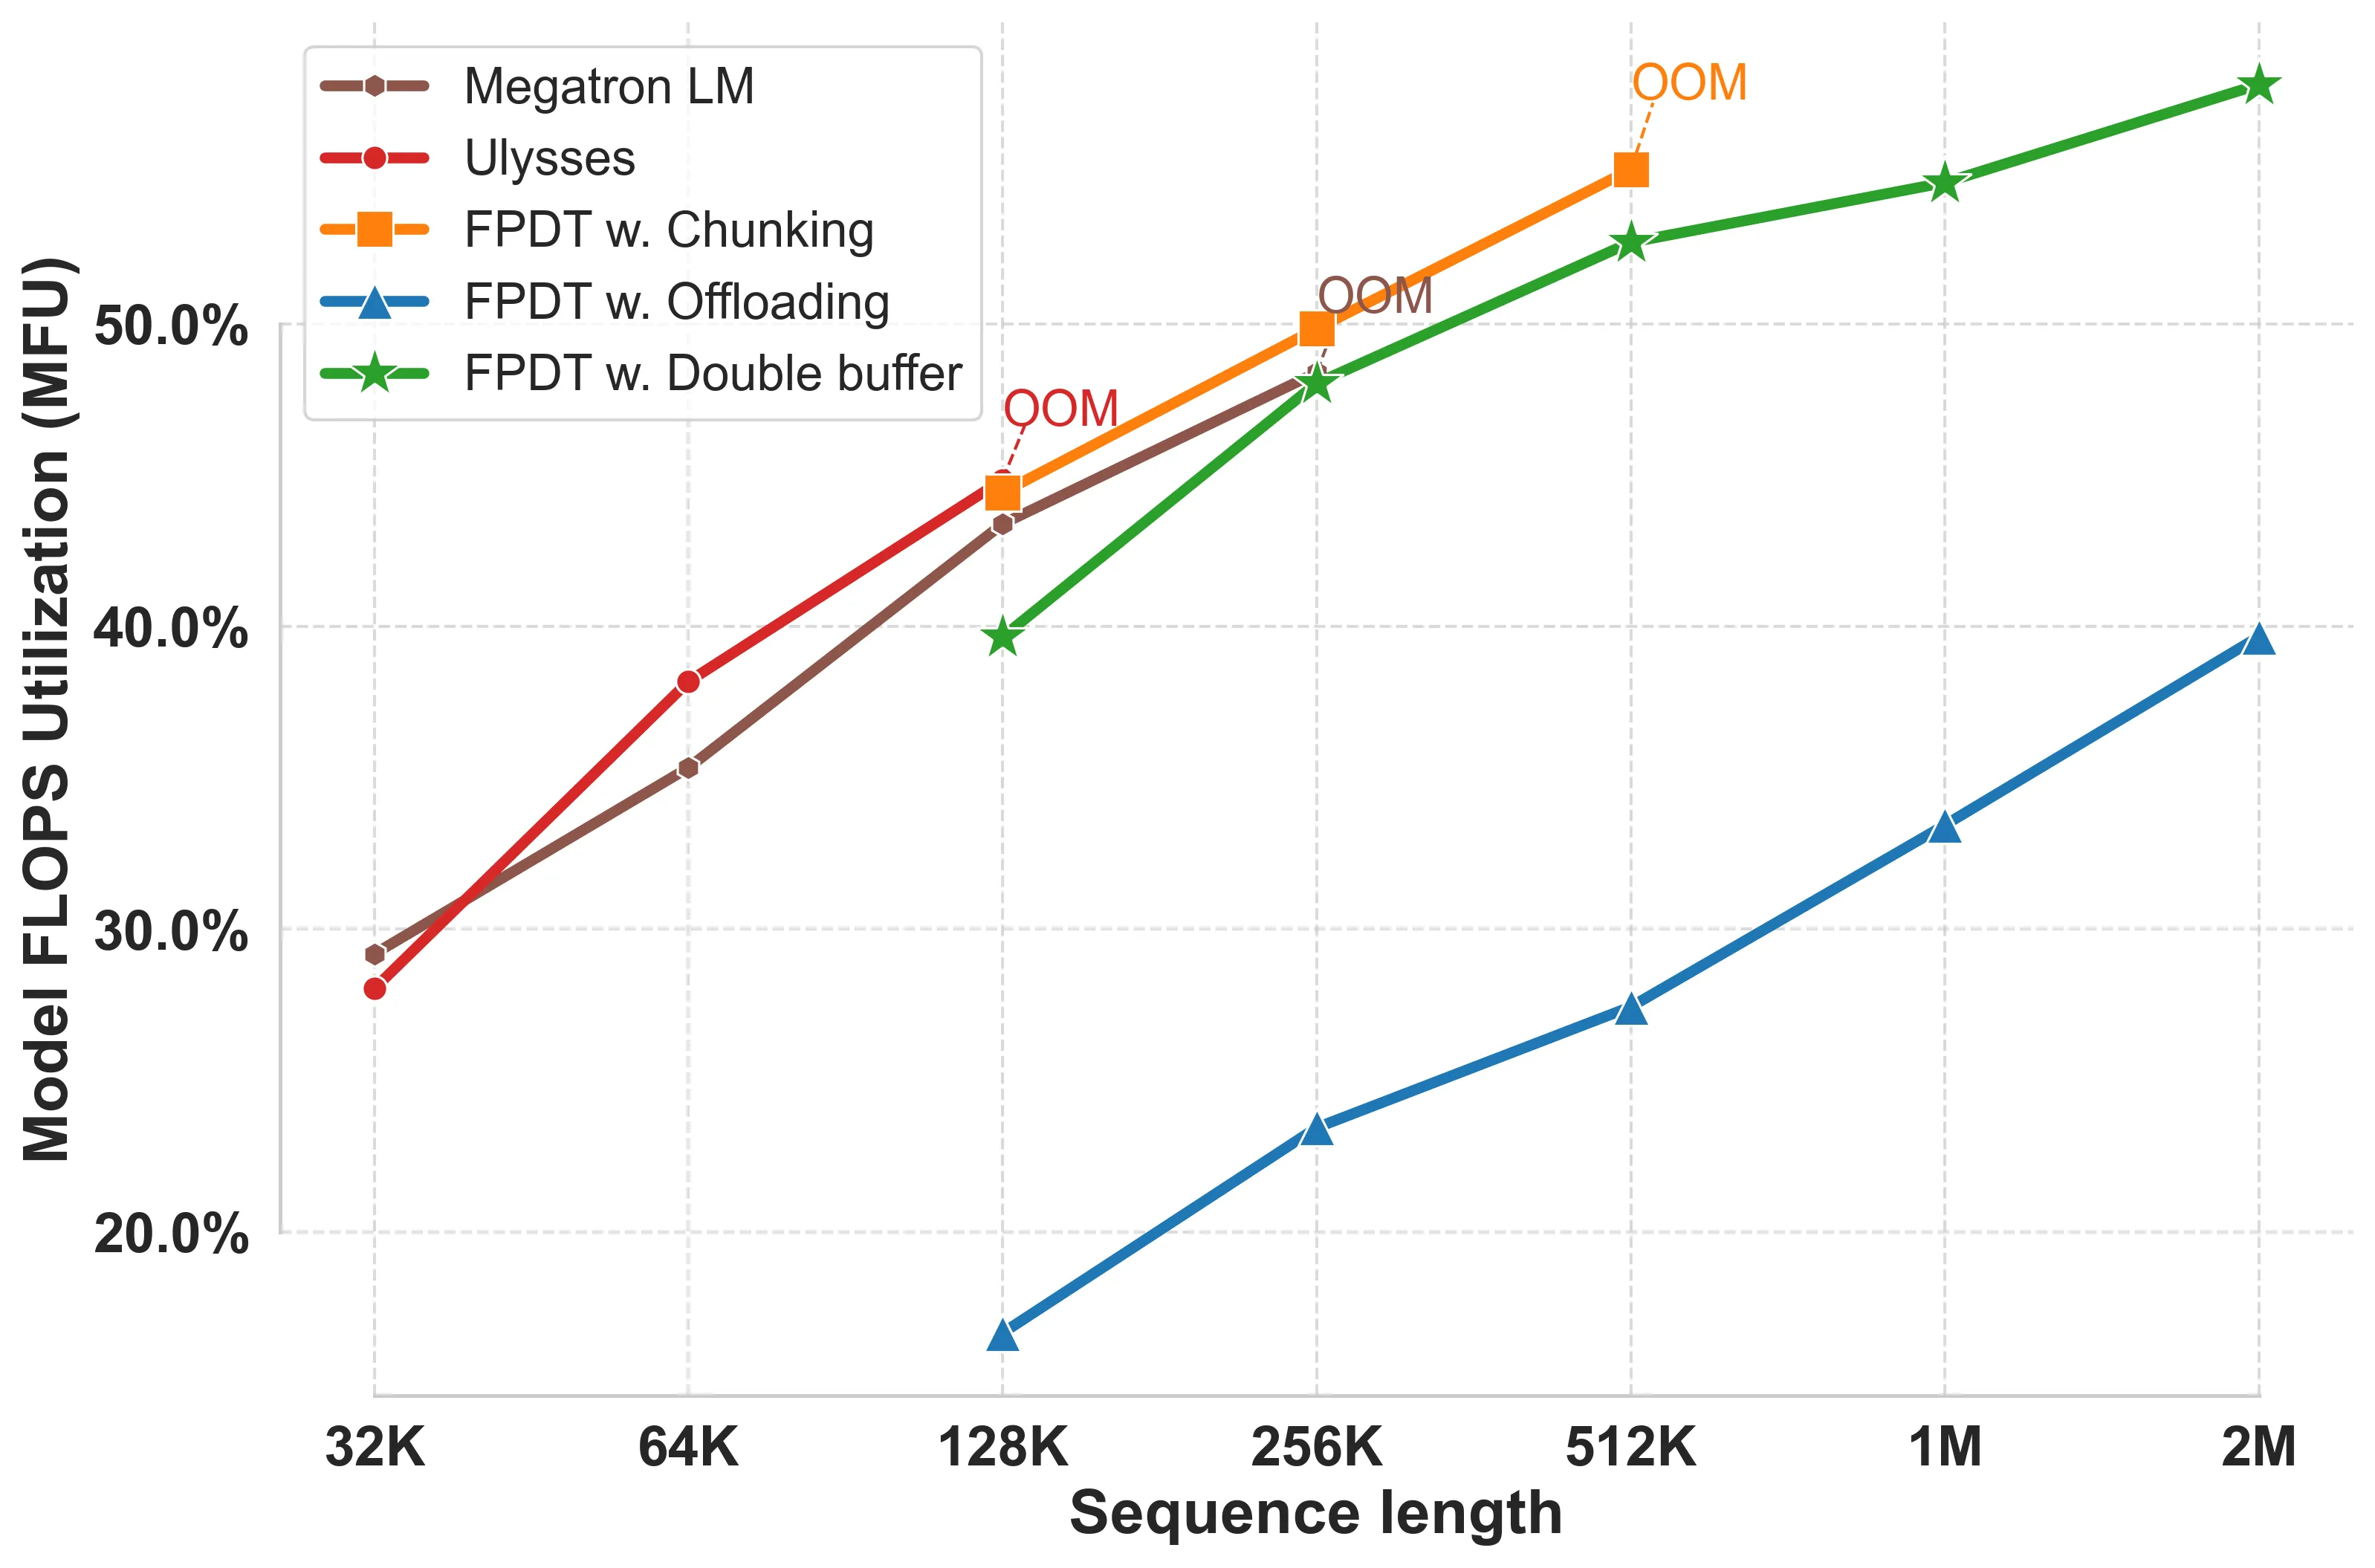
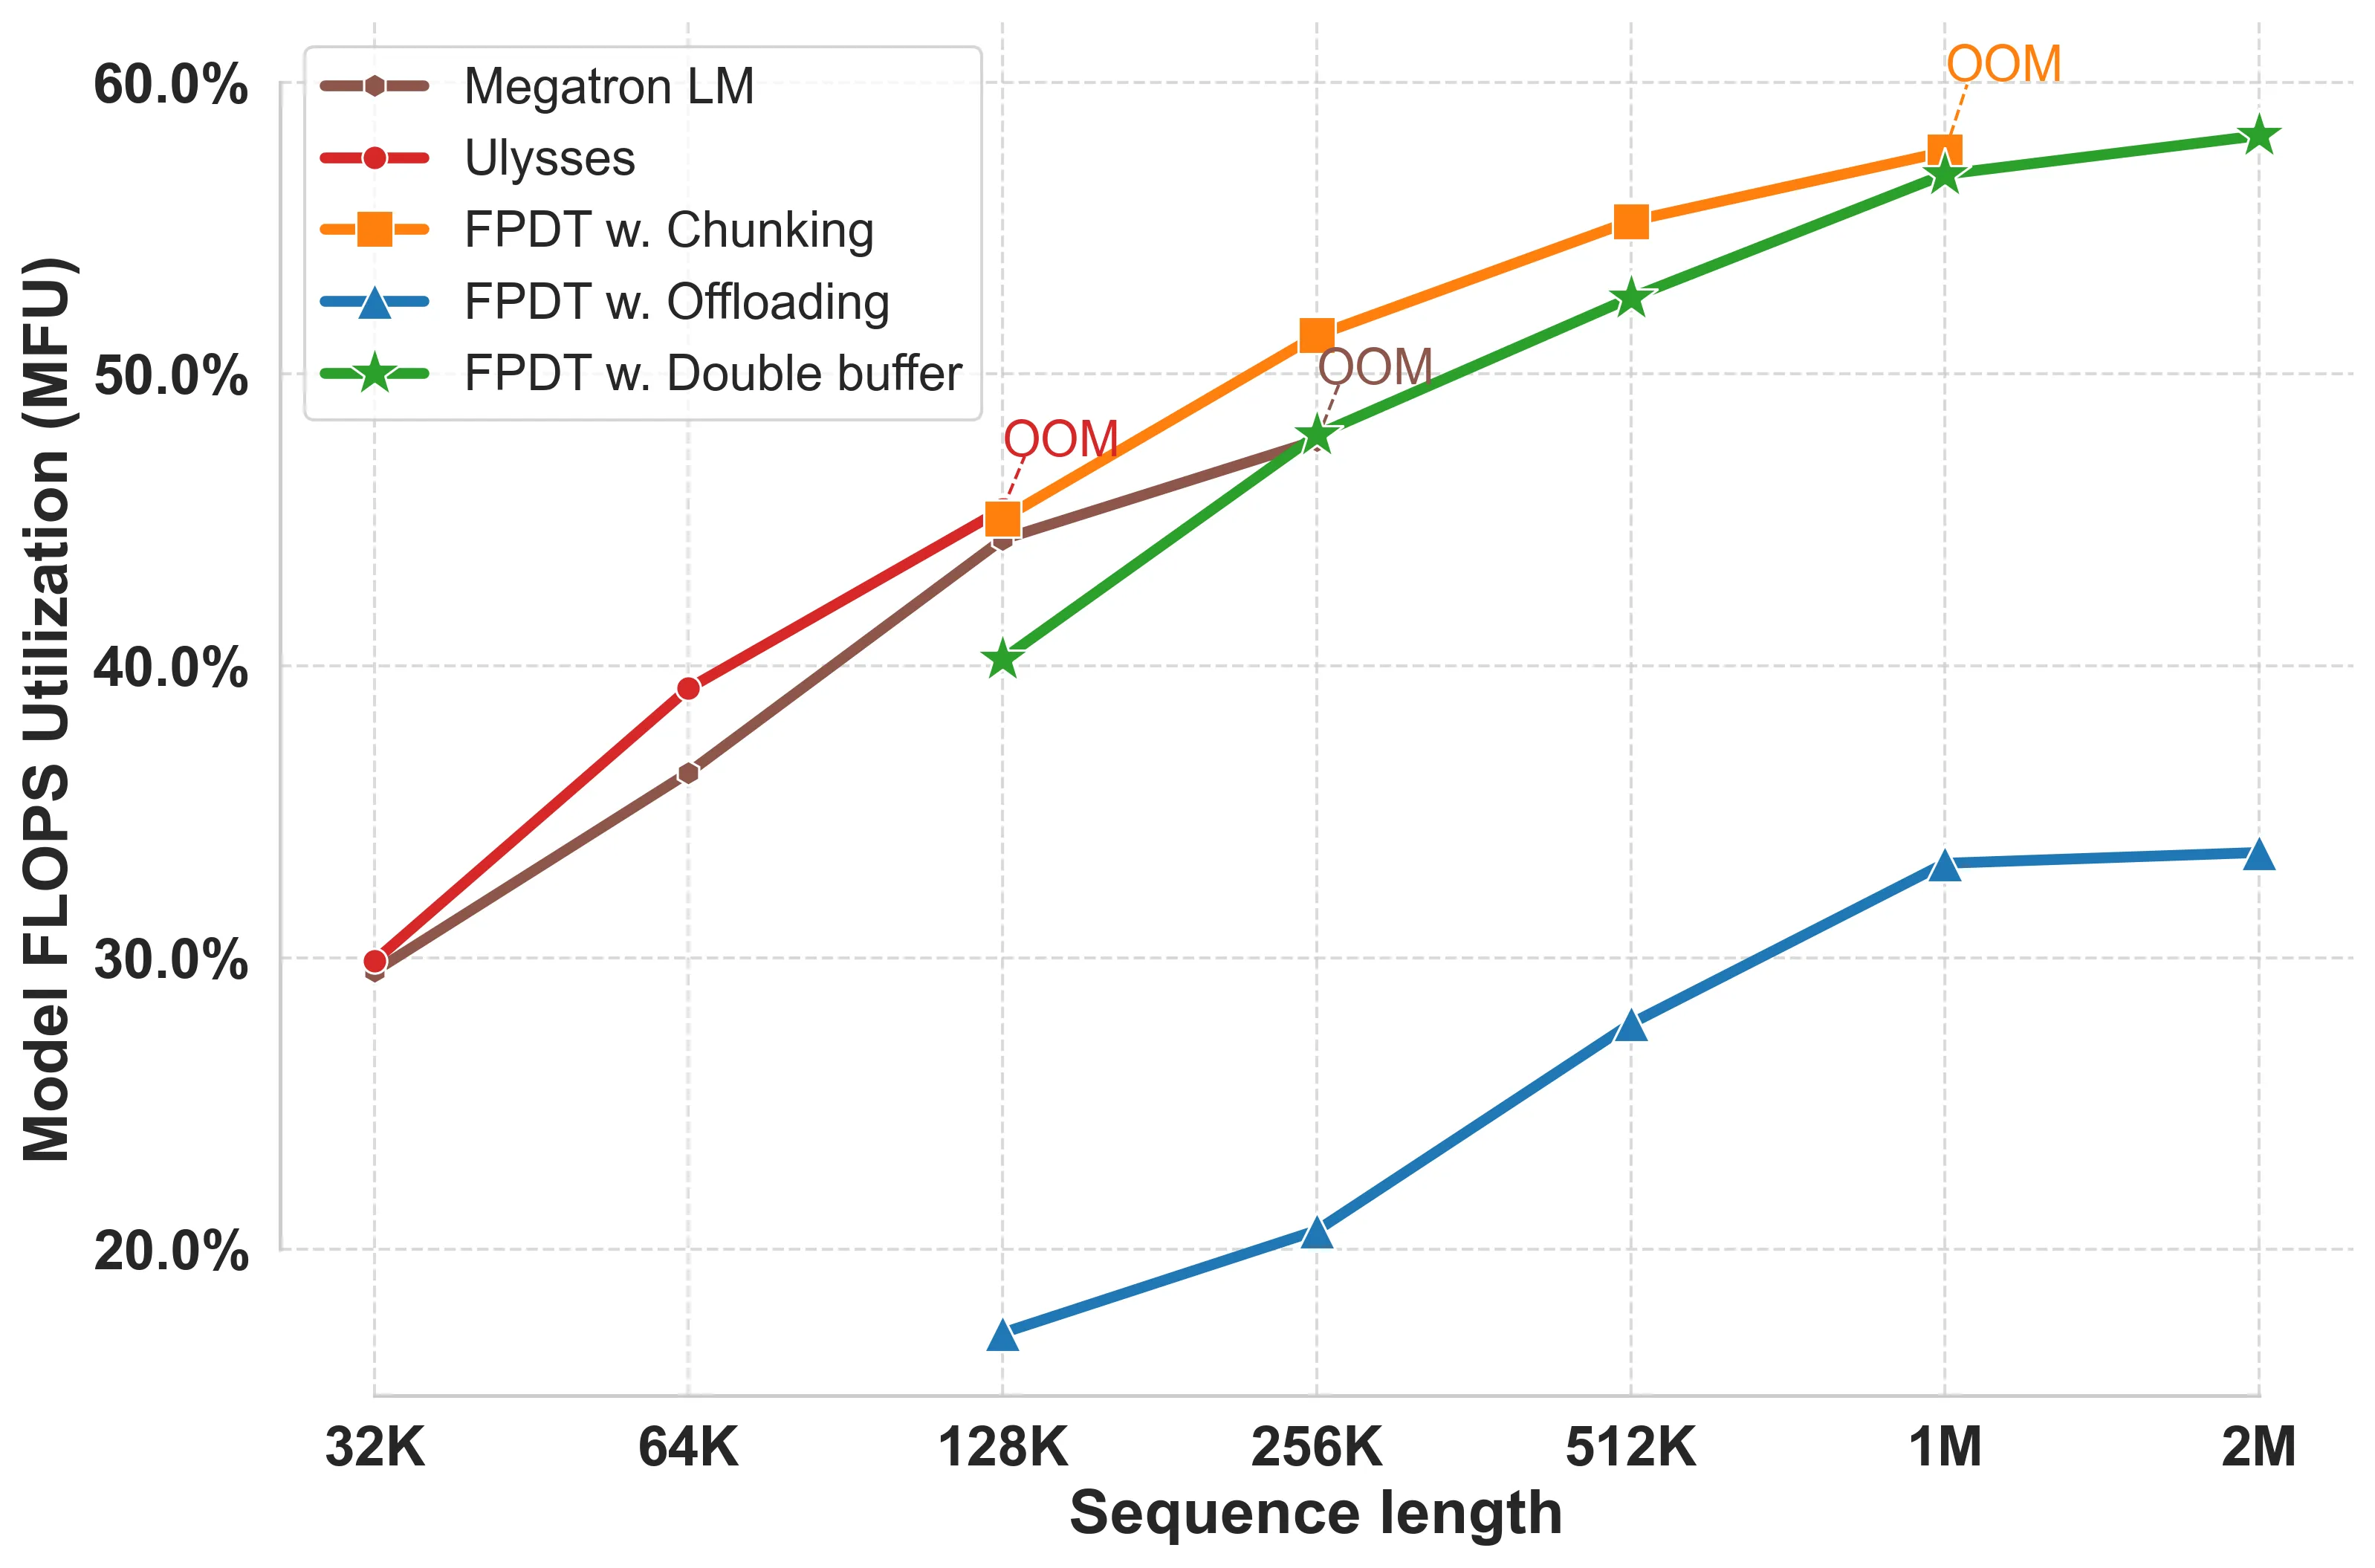
块大小的选择需要平衡:
- 较小块:更低内存占用,更多通信开销
- 较大块:更高内存占用,更少通信开销
5.4 收敛性评估
FPDT在训练过程中保持了与标准训练相当的收敛性,损失曲线正常下降。
6.1 内存高效Transformer
| 方法 | 技术 | 内存复杂度 |
|---|---|---|
| FlashAttention | 在线softmax | O(N) |
| 低秩近似 | 矩阵分解 | O(N) |
| 核方法 | 近似注意力 | O(N) |
| 稀疏注意力 | 选择性计算 | O(N) |
| 局部+全局上下文 | 混合注意力 | O(N) |
6.2 长上下文训练方法
| 方法 | 核心思想 | 优势 | 局限性 |
|---|---|---|---|
| Megatron-SP | 张量并行+序列并行 | 成熟稳定 | 硬件要求高 |
| BPT | 块并行Transformer | 内存高效 | 需要仔细调参 |
| Ring Attention | 环形通信 | 可扩展性强 | 依赖设备数量 |
| DeepSpeed Ulysses | All-to-all通信 | 通信效率高 | 部署复杂 |
| MsT | MLP分块 | 简单 | 未解决注意力内存 |
| MEMO | 主机内存卸载 | 内存效率高 | 需要整数规划 |
6.3 FPDT的定位
FPDT综合了多种技术的优势:
- 继承FlashAttention的块计算思想
- 采用DeepSpeed Ulysses的All-to-all通信
- 引入主机内存卸载和流水线设计
- 实现极低硬件要求下的超长上下文训练
7.1 主要贡献
-
端到端内存分析:识别了Transformer训练中的内存峰值,特别是QKV投影和Alltoall通信的内存开销
-
全流水线设计:基于DeepSpeed Ulysses设计了专用的序列块流水线,实现近零开销的训练流程
-
双缓冲机制:利用多个CUDA流重叠计算和通信,隐藏卸载延迟
-
极低硬件要求:
- 8B模型可在4个GPU上训练200万序列
- 70B模型可在32个GPU上训练400万序列
- 相比现有方案实现16倍提升
-
通用性:与DeepSpeed ZeRO、PyTorch FSDP正交组合,适用于GPT、Llama等模型
7.2 技术亮点
| 特性 | 描述 |
|---|---|
| 内存效率 | 序列分块降低内存占用为1/u |
| 计算效率 | 保持>55%的MFU |
| 通信效率 | 双缓冲重叠通信与计算 |
| 通用性 | 支持多种模型架构 |
| 易用性 | 集成到DeepSpeed框架 |
7.3 应用场景
- 超长文档处理:法律文档、科学论文、书籍
- 长对话系统:多轮对话、客服系统
- 基因组学:蛋白质序列分析
- 代码理解:大型代码库分析
7.4 未来方向
论文提到的未来工作方向:
- 进一步优化通信模式
- 支持更多模型架构
- 探索与MoE模型的结合
- 优化推理阶段的长上下文支持
8.1 论文链接
- arXiv: https://arxiv.org/abs/2408.16978
- PDF: https://arxiv.org/pdf/2408.16978
- HTML: https://arxiv.org/html/2408.16978v1
8.2 代码资源
- DeepSpeed集成: https://github.com/microsoft/DeepSpeed/pull/6462
8.3 关键图表
| 图表 | 描述 | 路径 |
|---|---|---|
| Figure 1 | MFU和最大上下文长度对比 | figures/ultra-long-context/intro.png |
| Figure 2 | DeepSpeed Ulysses分布式注意力 | figures/ultra-long-context/ulysses.png |
| Figure 4 | 带卸载的分布式注意力设计 | figures/ultra-long-context/distributed_attention_with_offloading.png |
| Figure 5 | 带获取和卸载的分布式注意力 | figures/ultra-long-context/distributed_attention_with_fo.png |
| Figure 6 | 序列块重排 | figures/ultra-long-context/sequence_shuffle.png |
| Figure 7 | 双缓冲设计 | figures/ultra-long-context/db_pipeline.png |
| 性能对比 | 时间对比 | figures/ultra-long-context/compare_time.png |
| 6.7B性能 | 4GPU配置 | figures/ultra-long-context/6.7b_4gpu.png |
| 8B性能 | 4GPU配置 | figures/ultra-long-context/llama_8b_4gpu.png |
| 13B性能 | 8GPU配置 | figures/ultra-long-context/13b_8gpu.png |
8.4 相关论文
| 论文 | 主题 | 关系 |
|---|---|---|
| FlashAttention (Dao et al., 2022) | 内存高效注意力 | 基础技术 |
| DeepSpeed Ulysses (Jacobs et al., 2023) | 序列并行 | 基础架构 |
| Megatron-SP (Korthikanti et al., 2023) | 序列并行 | 对比方法 |
| Ring Attention (Liu et al., 2023) | 环形通信 | 对比方法 |
| BPT (Liu & Abbeel, 2024) | 块并行 | 相关工作 |
| MsT (Luo et al., 2024) | MLP分块 | 对比方法 |
| MEMO (Zhao et al., 2024) | 内存卸载 | 对比方法 |
8.5 引用格式
@article{yao2024training,
  title={Training Ultra Long Context Language Model with Fully Pipelined Distributed Transformer},
  author={Yao, Jinghan and Jacobs, Sam Ade and Tanaka, Masahiro and Ruwase, Olatunji and Subramoni, Hari and Panda, Dhabaleswar K.},
  journal={arXiv preprint arXiv:2408.16978},
  year={2024}
}