[论文精读] Efficient Training of LLMs on Distributed Infrastructures: A Survey
分布式 LLM 训练系统与基础设施的深度技术分析
[论文精读] Efficient Training of LLMs on Distributed Infrastructures: A Survey
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Efficient Training of Large Language Models on Distributed Infrastructures: A Survey |
| 作者 | Jiangfei Duan, Shuo Zhang, Zerui Wang, Lijuan Jiang, Wenwen Qu, Qinghao Hu, Guoteng Wang, Qizhen Weng, Hang Yan, Xingcheng Zhang, Xipeng Qiu, Dahua Lin, Yonggang Wen, Xin Jin, Tianwei Zhang, Peng Sun |
| 机构 | 南洋理工大学、香港中文大学、北京大学、上海人工智能实验室、华为、腾讯、清华大学 |
| 论文 | arXiv:2407.20018 |
| 发布 | 2024-07-29 |
| 许可 | arXiv 非独占分发许可 |
| 引用数 | 500+ 篇参考文献 |
| 关键词 | LLM 训练, 分布式系统, 并行策略, 计算优化, 通信优化, 内存优化, 可靠性 |
二、问题背景与动机
2.1 LLM 训练的规模挑战
大语言模型(LLMs)的成功建立在其前所未有的规模之上:
| 模型 | 参数量 | GPU 数量 | 训练时间 | 训练数据 |
|---|---|---|---|---|
| LLaMA-3 405B | 405B | 16K H100 | 54 天 | 15T tokens |
| GPT-3 | 175B | 1024 A100 | ~34 天 | 300B tokens |
| PaLM | 540B | 6144 TPUv4 | ~64 天 | 780B tokens |
| BLOOM | 176B | 384 A100 | 117 天 | 366B tokens |
核心挑战:这些挑战集中在三个维度——可扩展性(Scalability)、效率(Efficiency)、可靠性(Reliability)(简称 “SER”)。
2.2 SER 框架详解
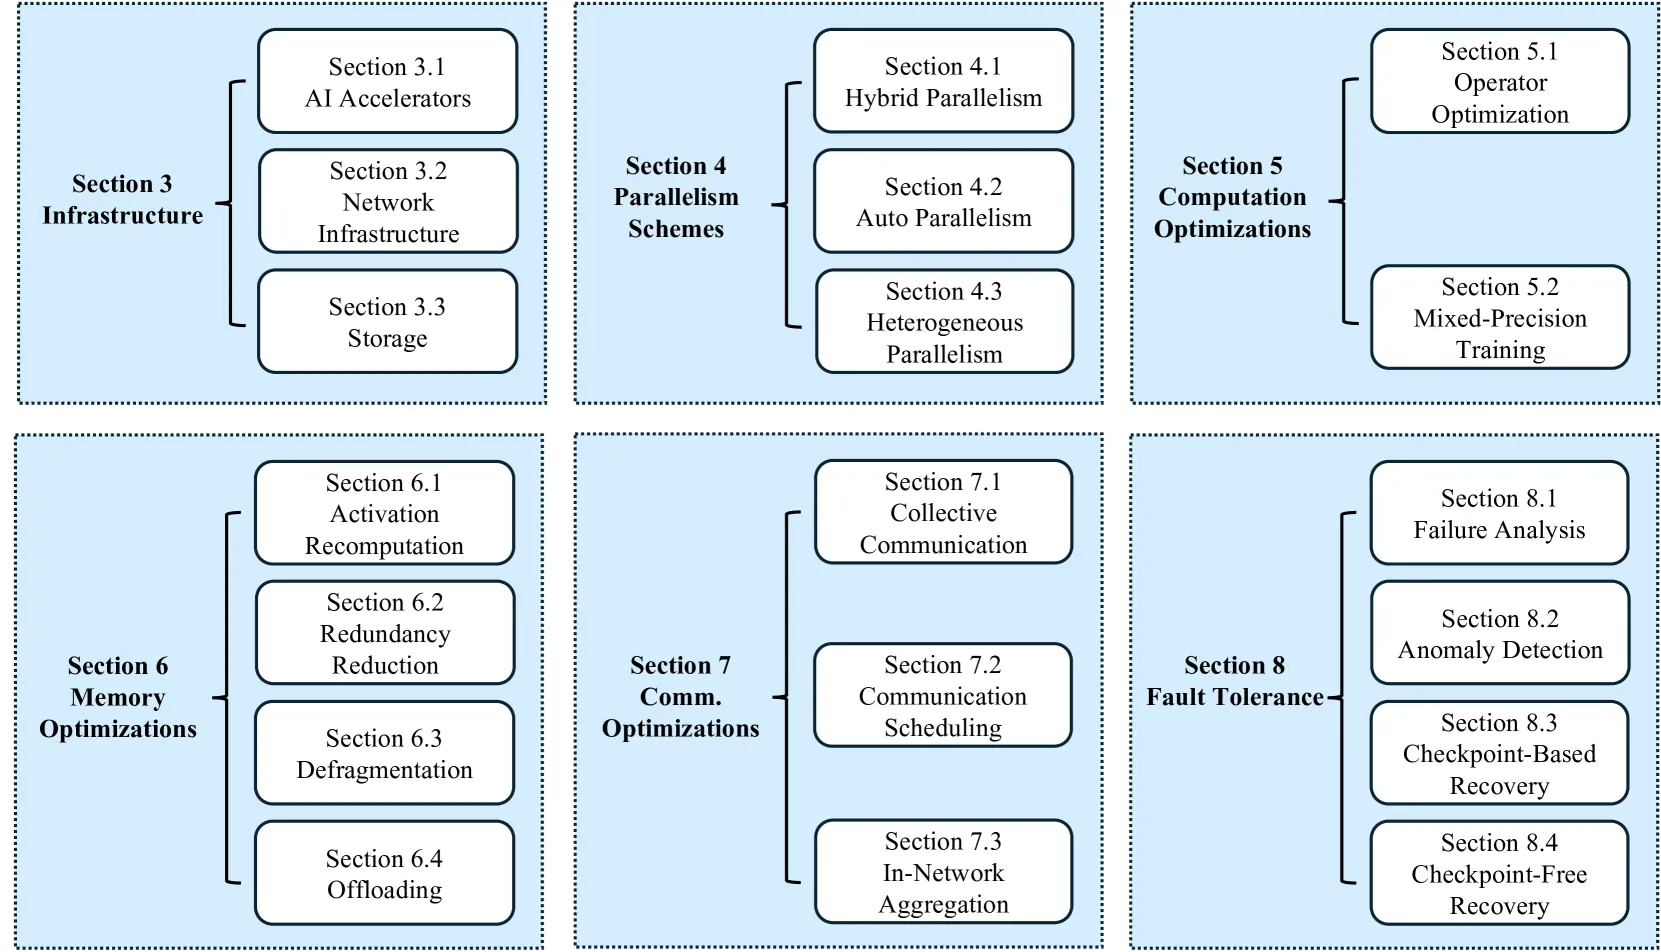
可扩展性(Scalability)
硬件可扩展性:
- 构建可扩展基础设施:大规模 GPU/AI 加速器集群
- 高性能网络:连接数万设备
- 分布式存储:处理 PB 级数据和检查点
系统可扩展性:
- 设计可扩展并行策略
- 通信算法实现近线性扩展
- 在数千加速器上保持模型精度
效率(Efficiency)
计算效率:
- 最大化 Model FLOPs Utilization (MFU)
- MFU = 实际 FLOPs / 硬件峰值 FLOPs
- 典型 MFU:40-50%(Megatron-LM on A100)
通信效率:
- 减少 All-Reduce 通信开销
- 通信-计算重叠
- 梯度压缩和量化
内存效率:
- 激活检查点
- 参数分片
- CPU/SSD 卸载
可靠性(Reliability)
故障类型:
- 硬件故障:GPU、网络、存储
- 软件故障:NaN/Inf 损失、梯度爆炸
- 环境故障:电力中断、冷却系统故障
容错机制:
- 检查点策略:异步检查点、增量检查点
- 弹性训练:支持动态增减 GPU
- 热备节点:快速替换故障设备
2.3 LLM 训练工作负载特性
1. 同构模型架构:
- 所有主流 LLM 均基于 Transformer
- 架构统一性为系统优化提供机会
2. 前所未有的规模:
- 数千亿参数,TB 级训练数据
- 需要分布式训练
- 训练持续数周至数月
3. 专业化软件优化:
- Megatron-LM:混合并行
- DeepSpeed:状态分片优化器
- Alpa:自动并行
三、基础设施层详解
3.1 AI 加速器
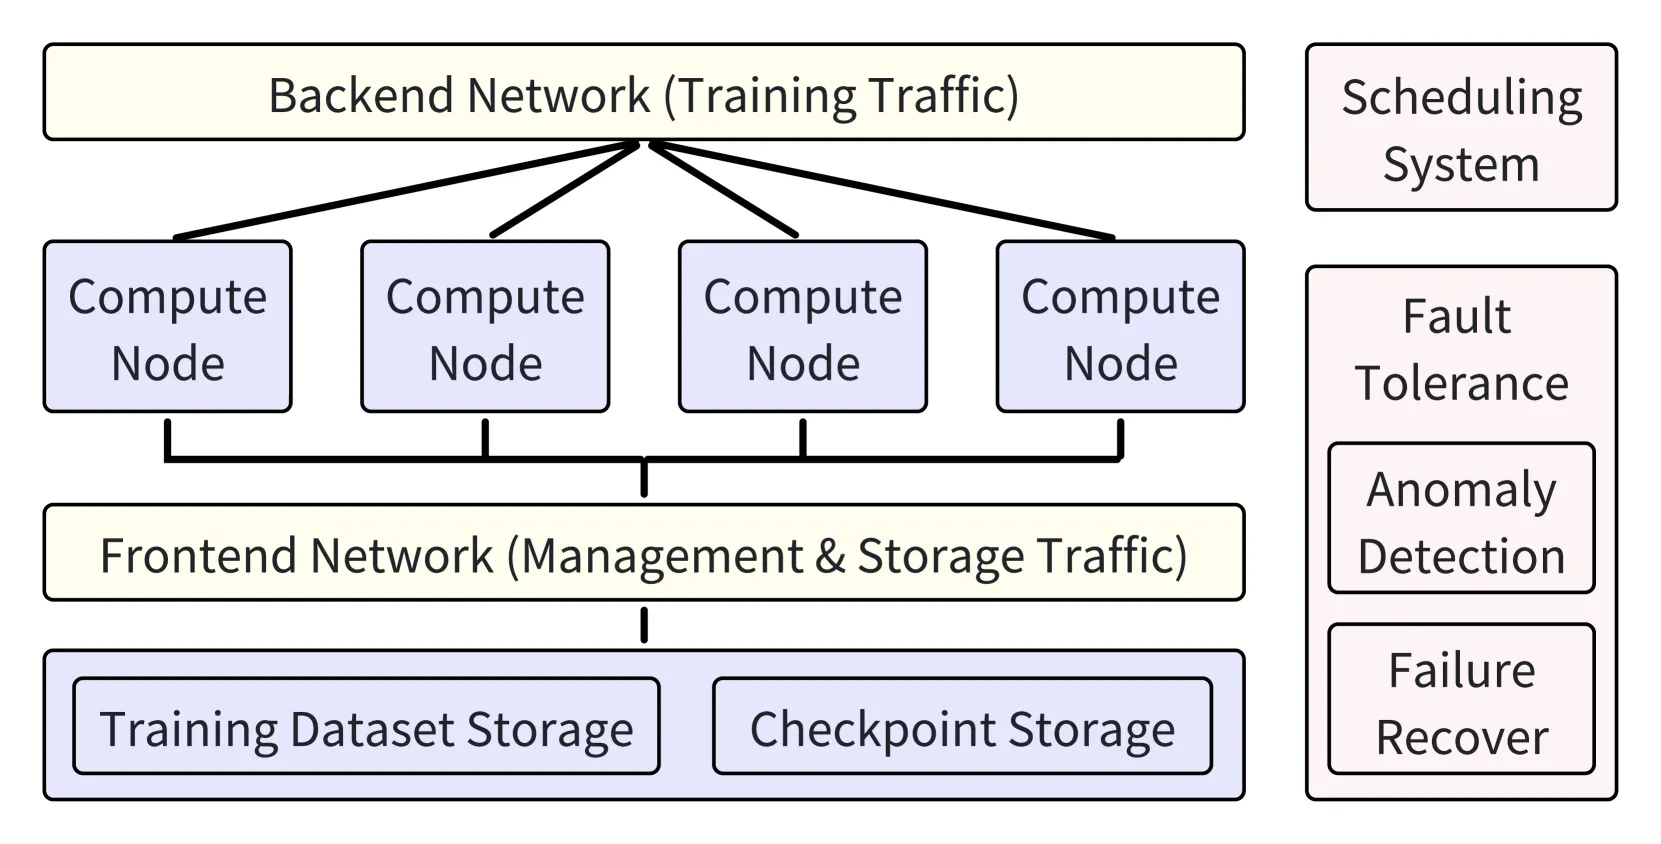
NVIDIA GPU 架构演进
| 架构 | 代表产品 | 关键特性 | HBM 带宽 |
|---|---|---|---|
| Ampere | A100 | FP16/BF16, 312 TFLOPS | 2 TB/s |
| Hopper | H100 | FP8, Transformer Engine, 1979 TFLOPS | 3.35 TB/s |
| Blackwell | B200 | FP4, 4.5 PFLOPS | 8 TB/s |
GPU 架构细节:
- Streaming Multiprocessors (SM):每个 SM 包含多个核心
- 共享内存:线程间数据交换
- 高带宽内存 (HBM):加速数据传输
- Tensor Cores:专用矩阵运算单元
其他 AI 加速器
| 加速器 | 机构 | 关键特性 | 适用场景 |
|---|---|---|---|
| AMD MI250X | AMD | 64 GB HBM, 191.5 TFLOPS FP16 | Frontier 超算 |
| GAUDI2 | Intel | 2 矩阵乘法引擎 | GPT-3 175B 训练 |
| TPUv4 | 4096 芯片, 60% 峰值效率 | 大规模训练 | |
| Graphcore IPU | Graphcore | 64 Bow-class, 22 petaFLOPS | GPT-3 训练 |
| Cerebras CS-2 | Cerebras | 850K 处理核心, 晶圆级加速器 | 开源模型训练 |
3.2 网络基础设施
芯片间通信拓扑
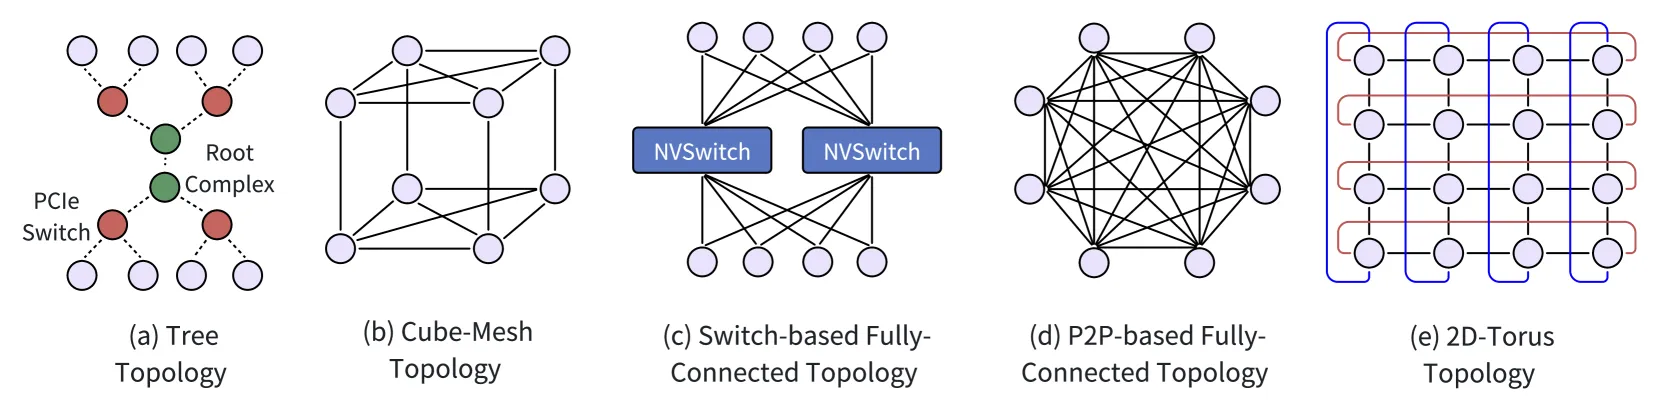
| 拓扑类型 | 代表技术 | 带宽 | 特点 |
|---|---|---|---|
| 树状 (Tree) | PCIe | 16-64 GB/s | 层级结构,可扩展性有限 |
| Cube-Mesh | NVLink-1.0 | 160 GB/s 双向 | 4 GPU 平面网格,8 GPU 立方体 |
| 全连接 (Switch) | NVSwitch | 900 GB/s | 8 GPU 全连接,最低延迟 |
| 全连接 (P2P) | Infinity Fabric | 100+ GB/s | AMD GPU 互连 |
| 2D-Torus | TPUv2/v3 | 可变 | Google TPU 架构 |
节点间通信技术
| 技术 | 带宽 | 特点 |
|---|---|---|
| InfiniBand EDR | 100 Gbps | 专用网络,高成本 |
| InfiniBand HDR | 200 Gbps | HPC 环境主流 |
| InfiniBand NDR | 400 Gbps | 最新一代 |
| RoCE-v2 | 25-100 Gbps | 基于以太网,成本较低 |
| GPUDirect-RDMA | 可变 | 绕过 CPU,直接 GPU 通信 |
大规模集群网络拓扑
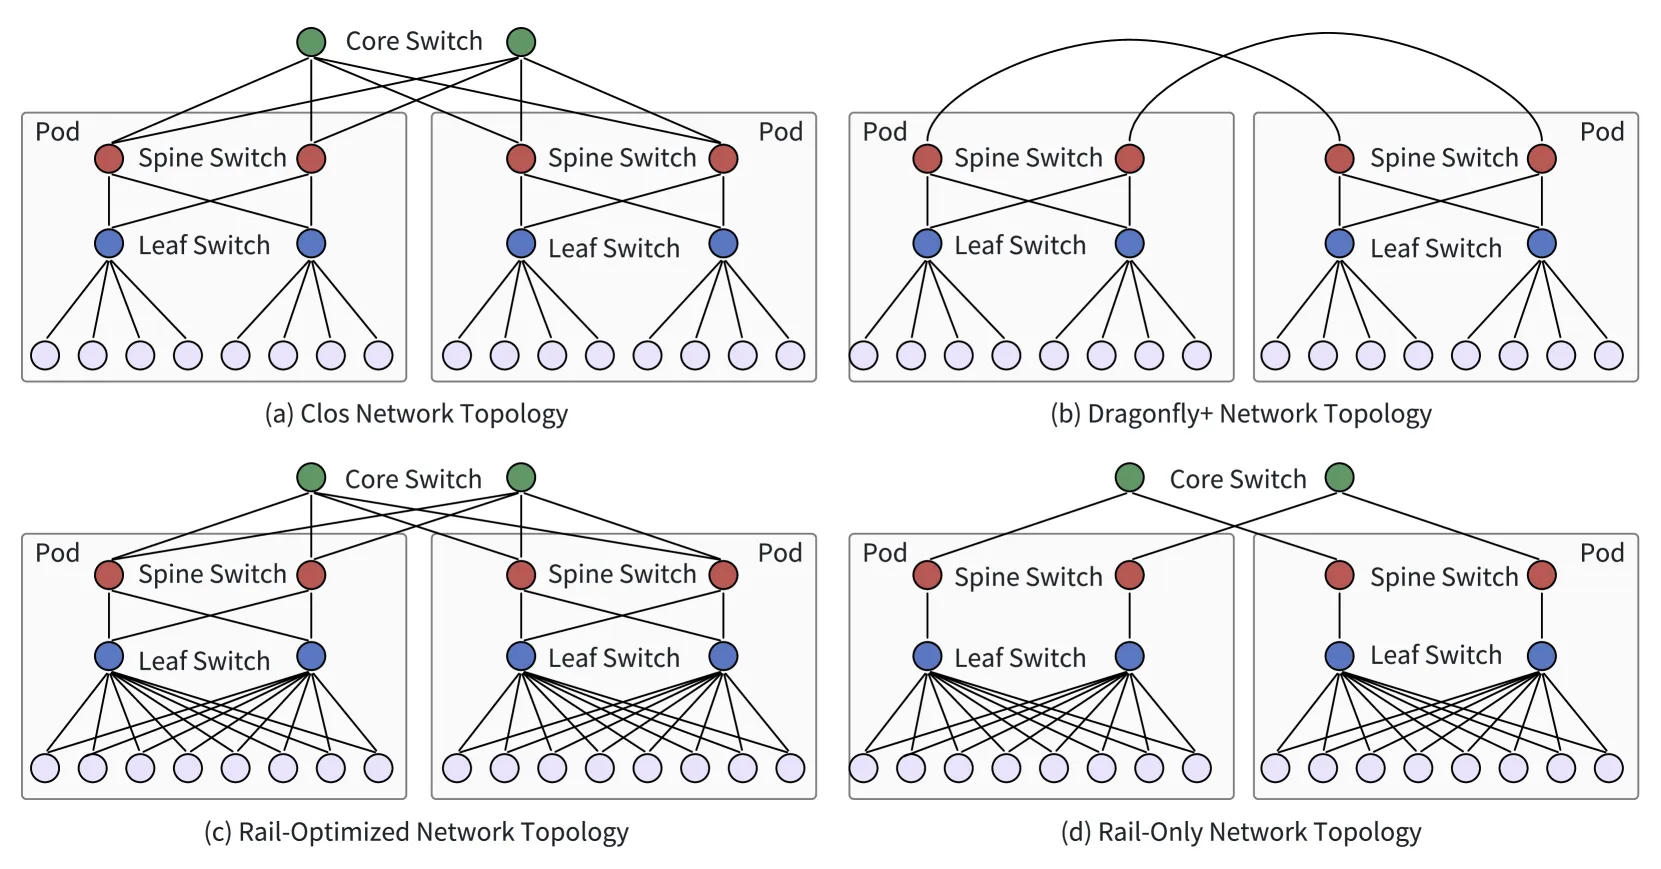
| 拓扑类型 | 代表实现 | 特点 |
|---|---|---|
| Clos (Fat-Tree) | Meta LLaMA-3 集群 | 任意通信,7:1 过载比 |
| Dragonfly+ | Microsoft Azure | 减少跳数,低成本 |
| Rail-Optimized | NVIDIA DGX | GPU 直连叶子交换机 |
| Rail-Only | ByteDance | 简化拓扑,高带宽 |
Meta LLaMA-3 集群架构:
- 24,000 GPU
- 8 个 Pod,全带宽互连
- 核心层 7:1 过载比
- 支持 LLaMA-3 405B 训练
负载均衡与拥塞控制
LLM 训练流量特征:
- 少量大象流(elephant flows)
- 周期性网络突发(梯度同步)
- 每个计算节点连接数少
负载均衡策略:
| 策略 | 原理 | 适用场景 |
|---|---|---|
| ECMP | 哈希均衡路径 | 传统 HPC |
| E-ECMP | 扩展字段哈希 | LLaMA-3 训练 |
| Packet Spraying | 包级分散 | 需要乱序处理 |
| Ethereal | 贪婪路径分配 | 大规模集群 |
拥塞控制协议:
| 协议 | 特点 |
|---|---|
| PFC (Priority Flow Control) | 以太网标准 |
| DCQCN | 数据中心增强 |
| HPCC | 高精度拥塞控制 |
| EQDS | 自适应队列管理 |
| MLTCP | 机器学习优化 TCP |
3.3 存储系统
检查点存储
| 系统 | 机构 | 特点 |
|---|---|---|
| Tectonic | Meta | 分布式文件系统,支持数千 GPU |
| HDFS | ByteDance | 集中式检查点维护 |
| Ceph | 开源 | 对象存储,易扩展 |
检查点大小估算:
- 70B 参数模型:~980 GB
- 405B 参数模型:~5.7 TB
- 需要高写入带宽
训练数据存储
| 系统 | 类型 | 特点 |
|---|---|---|
| Lustre | 并行文件系统 | HPC 主流 |
| GPFS | 并行文件系统 | IBM 产品 |
| BeeGFS | 并行文件系统 | 开源,易部署 |
数据规模:
- LLaMA-3:15T tokens(~30 TB)
- 数据预处理:原始数据 > 100x 最终数据
- WanJuan-CC:68B 文档 → 1T tokens(2 TB)
数据缓存
| 系统 | 功能 |
|---|---|
| Alluxio | 从 HDFS/对象存储缓存 |
| JuiceFS | 分布式缓存 |
| Quiver | GPU 直接访问缓存 |
3.4 集群调度
工作负载调度
| 调度器 | 类型 | 特点 |
|---|---|---|
| Gavel | 异构感知 | 跨 GPU 世代优化 |
| FGD | 作业打包 | 细粒度 GPU 共享 |
| Pollux | 自适应缩放 | 动态调整 GPU 数量 |
| Crius | LLM 专用 | 混合并行 + 硬件亲和性 |
| Hydro | 超参数调优 | 缩小模型搜索,融合训练 |
| Acme | 工作流调度 | LLM 开发全流程 |
资源调度
| 资源类型 | 调度系统 | 特点 |
|---|---|---|
| 网络 | Cassini | 通信阶段交错 |
| 网络 | HIRE | 网络内计算调度 |
| 存储 | SiloD | 数据缓存 + 远程 I/O 联合分配 |
| CPU/内存 | Synergy | CPU 核心优化分配 |
| 能耗 | EnvPipe | 流水线气泡节能 |
| 能耗 | Zeus | 批大小 + GPU 功率优化 |
| 能耗 | Perseus | 时间-能耗 Pareto 前沿 |
四、并行策略层详解
4.1 混合并行
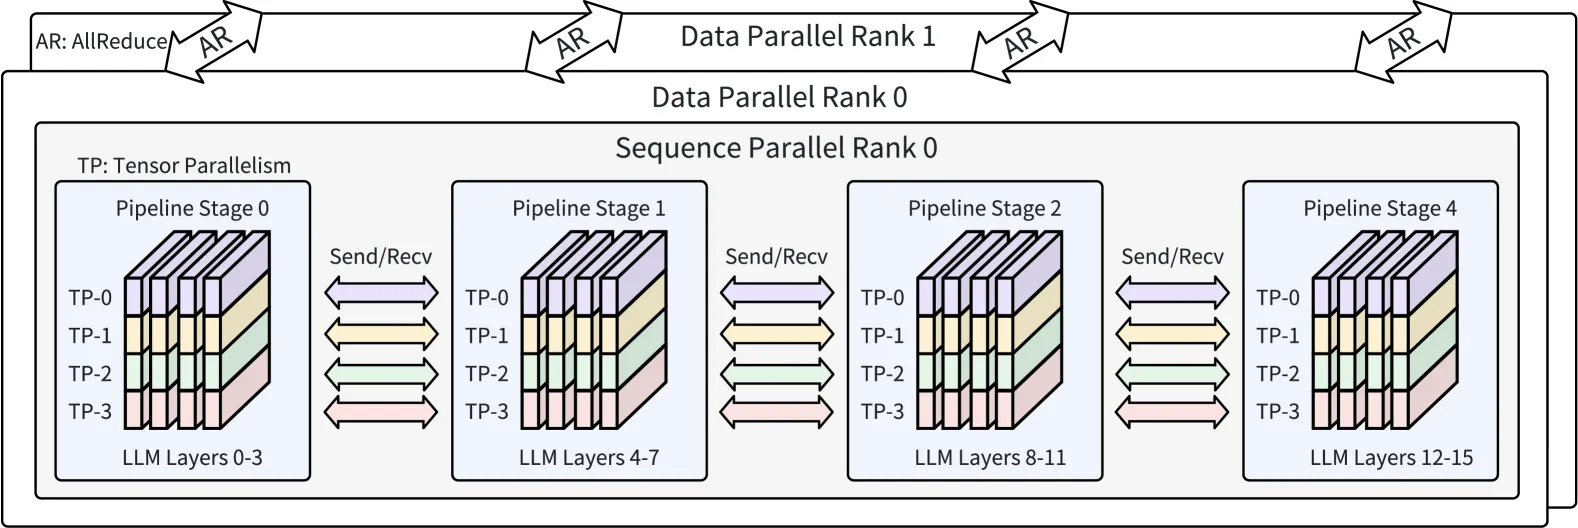
3D 并行 = 数据并行 + 张量并行 + 流水线并行
数据并行 (DP)
基本原理:
- 每个 GPU 持有完整模型副本
- 数据沿 batch 维度分片
- All-Reduce 聚合梯度
分片策略:
| 策略 | 分片因子 F | 通信量 | 内存占用 | 代表系统 |
|---|---|---|---|---|
| 完全复制 (F=1) | 1 | AllReduce: 2×model_size | 完整模型 | PyTorch-DDP, Horovod |
| ZeRO-1 | W | ReduceScatter + AllGather | 优化器状态分片 | ZeRO |
| ZeRO-2 | W | 同上 | +梯度分片 | ZeRO |
| ZeRO-3 | W | 同上 | +参数分片 | ZeRO-3, FSDP |
| MiCS | W | 可变 | 部分分片 | MiCS |
通信操作详解:
- All-Reduce:所有 GPU 聚合梯度,通信量 2×(N-1)/N × model_size
- ReduceScatter:每个 GPU 得到部分聚合结果,通信量 (N-1)/N × model_size
- AllGather:每个 GPU 收集完整参数,通信量 (N-1)/N × model_size
张量并行 (TP)
基本原理:
- 层内参数张量分片
- 通信中间激活张量(小于参数/梯度)
- 适合节点内高带宽互连(NVLink)
分片维度:
| 维度 | 方法 | 特点 |
|---|---|---|
| 1-D | Megatron-LM | 列切分 + 行切分,2 次 AllReduce |
| 2-D | Optimus | SUMMA 算法,减少通信 |
| 2.5-D | Tesseract | 通信-内存权衡 |
| 3-D | 3-D TP | 进一步优化 |
Megatron-LM 1-D TP 详解:
- MLP:第一个矩阵列切分,第二个矩阵行切分
- Attention:Q/K/V 按头分片
- 每层 2 次 AllReduce
流水线并行 (PP)
基本原理:
- 模型层分段,每段映射到一组 GPU
- 微批次流水线执行
- 适合跨节点低带宽互连
调度策略对比:
| 策略 | 气泡率 | 内存需求 | 特点 |
|---|---|---|---|
| GPipe | (P-1)/M | 高 | 全前向 + 全后向 |
| PipeDream (1F1B) | (P-1)/M | 中 | 交替前向/后向 |
| Interleaved 1F1B | (P-1)/(M×V) | 中 | 虚拟阶段交错 |
| Zero Bubble | ~0 | 高 | 气泡消除 |
| DynaPipe | 自适应 | 自适应 | 动态调整 |
内存不平衡问题:
- 前阶段需要保存更多微批次
- 后阶段内存需求较低
解决方案:
- V-Shape:非均匀层分配
- AdaPipe:自适应内存分配
- Chimera:双向流水线
序列并行 (SP)
基本原理:
- 输入数据沿序列维度分片
- 每个 GPU 处理序列的一部分
- 支持超长序列训练(百万级 token)
挑战:
- 注意力计算复杂度 O(n²)
- KV 通信开销
- 因果掩码导致负载不均衡
代表方法:
| 方法 | 原理 | 特点 |
|---|---|---|
| Ring Self-Attention | 环形通信 KV | 最早提出 |
| Megatron-SP | 与 TP 结合 | 减少冗余计算 |
| DeepSpeed-Ulysses | 序列分片 | 高效通信 |
| Context Parallel | 上下文并行 | Meta 实现 |
| LoongTrain | 长序列优化 | 选择性检查点 |
专家并行 (EP)
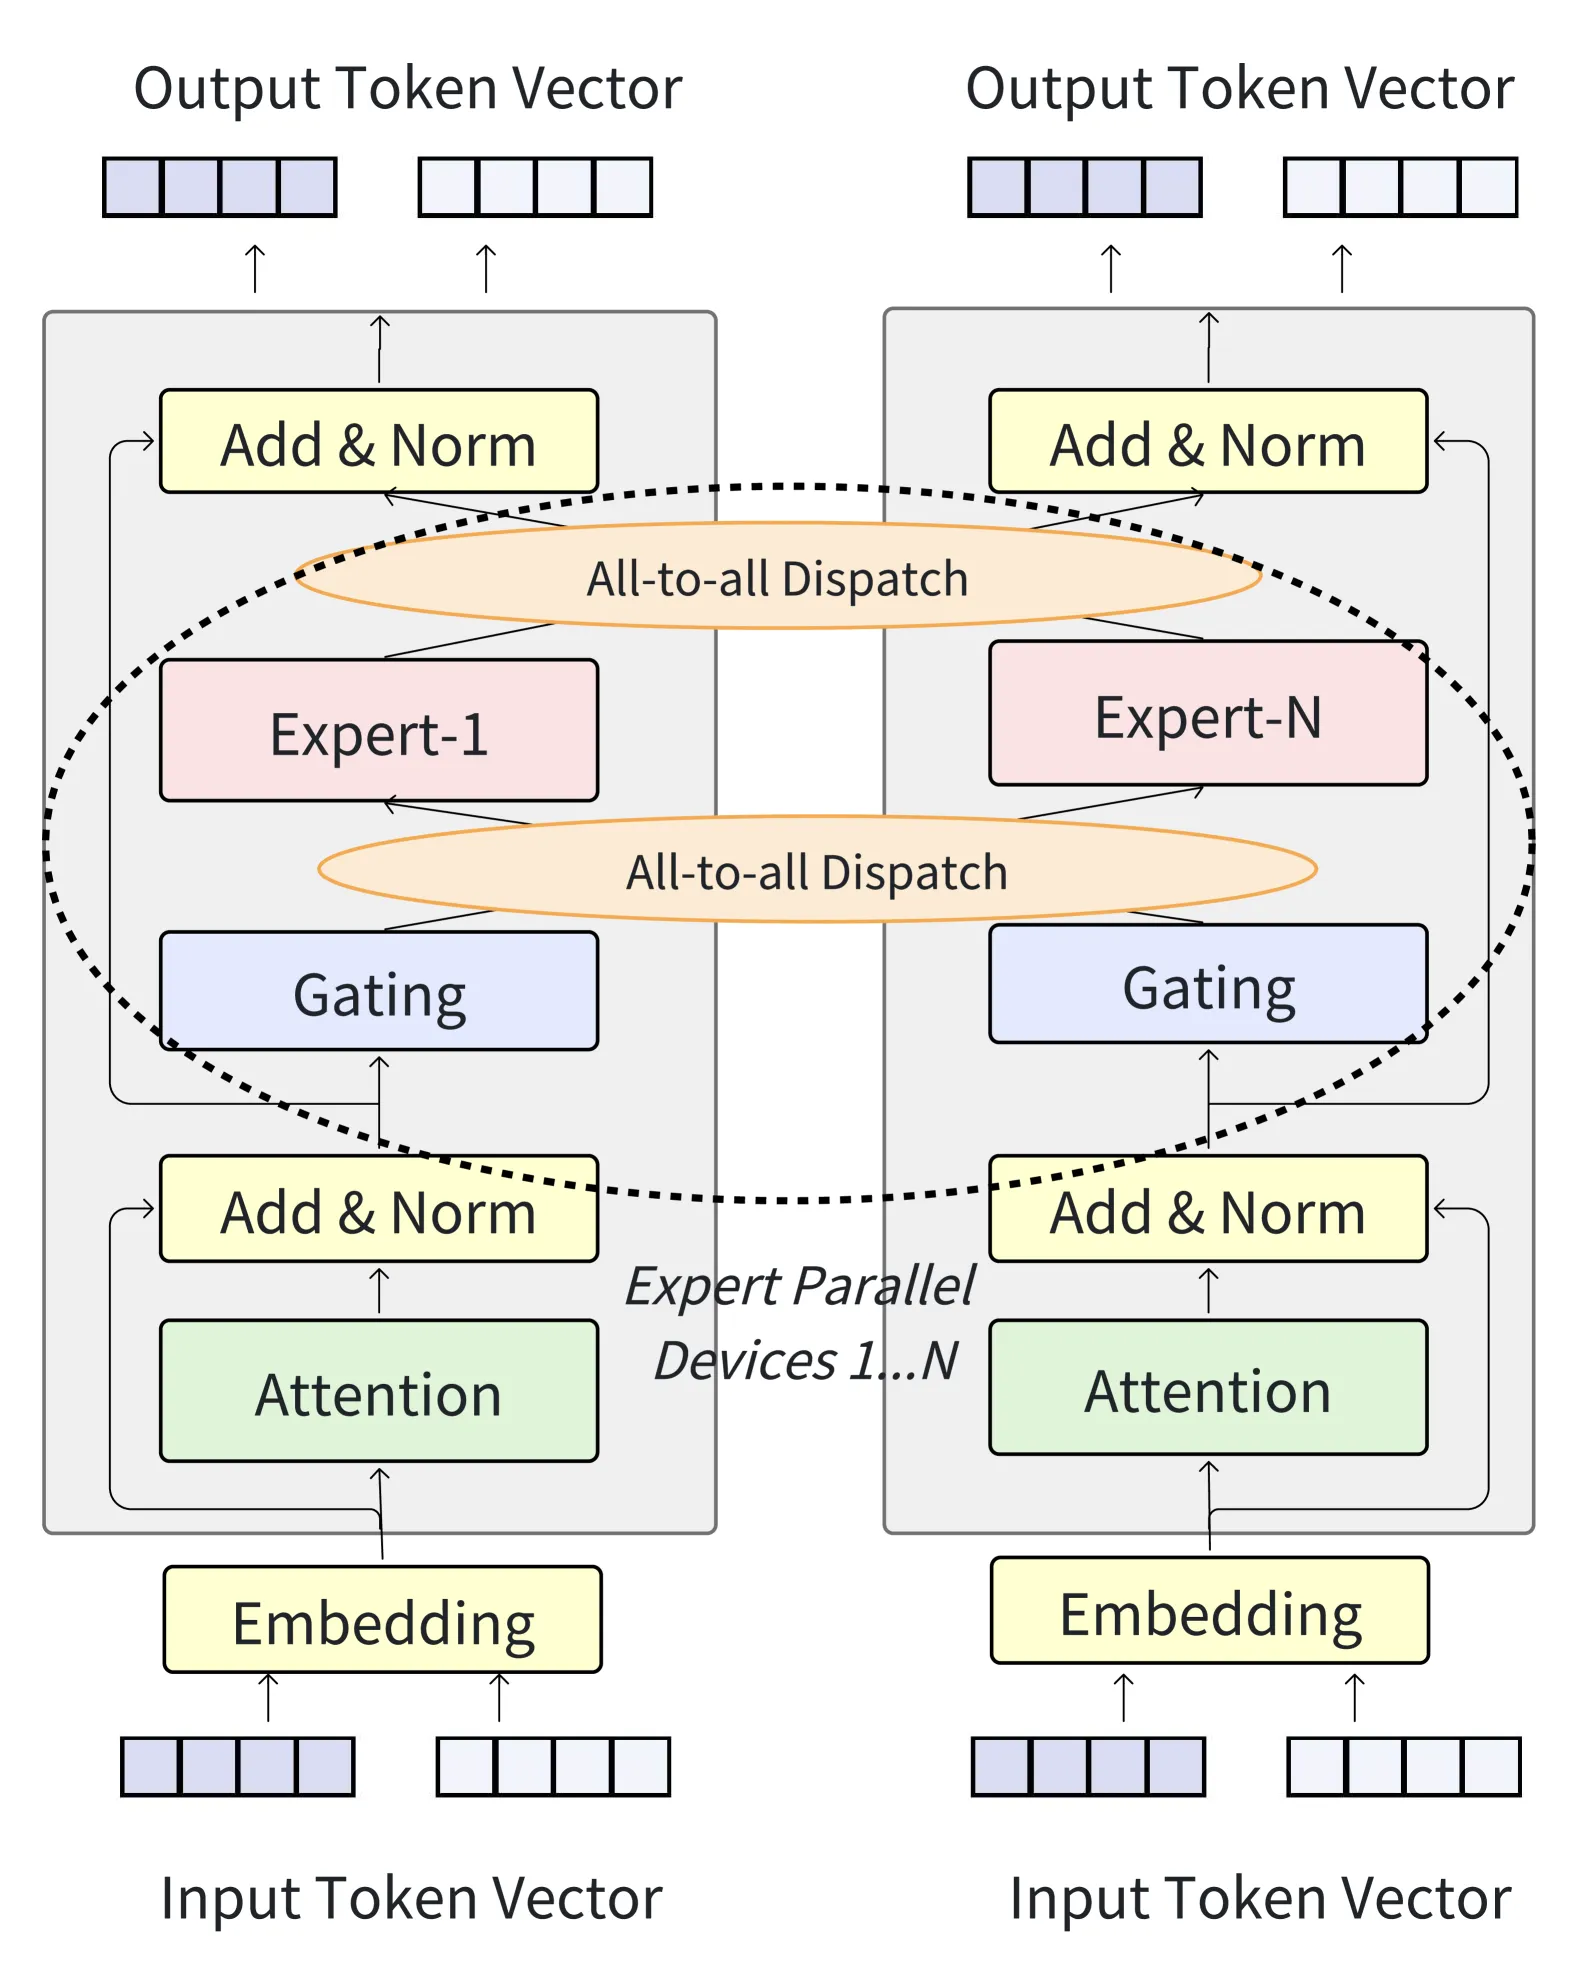
MoE 架构:
- 多个专家网络处理不同数据子集
- 门控网络路由 token 到专家
- All-to-All 通信协作
稀疏激活:
- GShard:top-2 路由
- Switch Transformer:top-1 路由
- DeepSpeed-MoE:共享专家 + 分层专家
通信优化:
- PipeMoE:流水线专家并行
- ScheMoE:调度优化
- FasterMoE:拓扑感知通信
4.2 自动并行
通用框架
| 框架 | 搜索空间 | 算法 |
|---|---|---|
| PipeDream | DP + PP | 动态规划 |
| DAPPLE | DP + PP | 分析模型 + DP |
| AutoPipe | PP | 模拟器 + 启发式 |
| OptCNN | 所有维度 | 分析性能模型 |
| Alpa | DP + TP + PP | 层级化搜索 |
Transformer 专用框架
| 框架 | 特点 |
|---|---|
| DeepSpeed-Autotuning | 自动调优系统参数 |
| Galvatron | 动态规划 DP + TP + PP |
| Merak | 非侵入式自动并行 |
| Colossal-AI | 统一接口,模块化 |
| Galvatron-BMW | 扩展 ZeRO + 激活重计算 |
4.3 异构并行
异构硬件
| 系统 | 特点 |
|---|---|
| HetPipe | 虚拟工作分区,异步 DP |
| AccPar | 灵活张量分片,平衡计算 |
| Whale | 统一抽象,图优化 |
| AMP | 异构感知性能模型 |
| Pathways | 分片数据流,异步执行 |
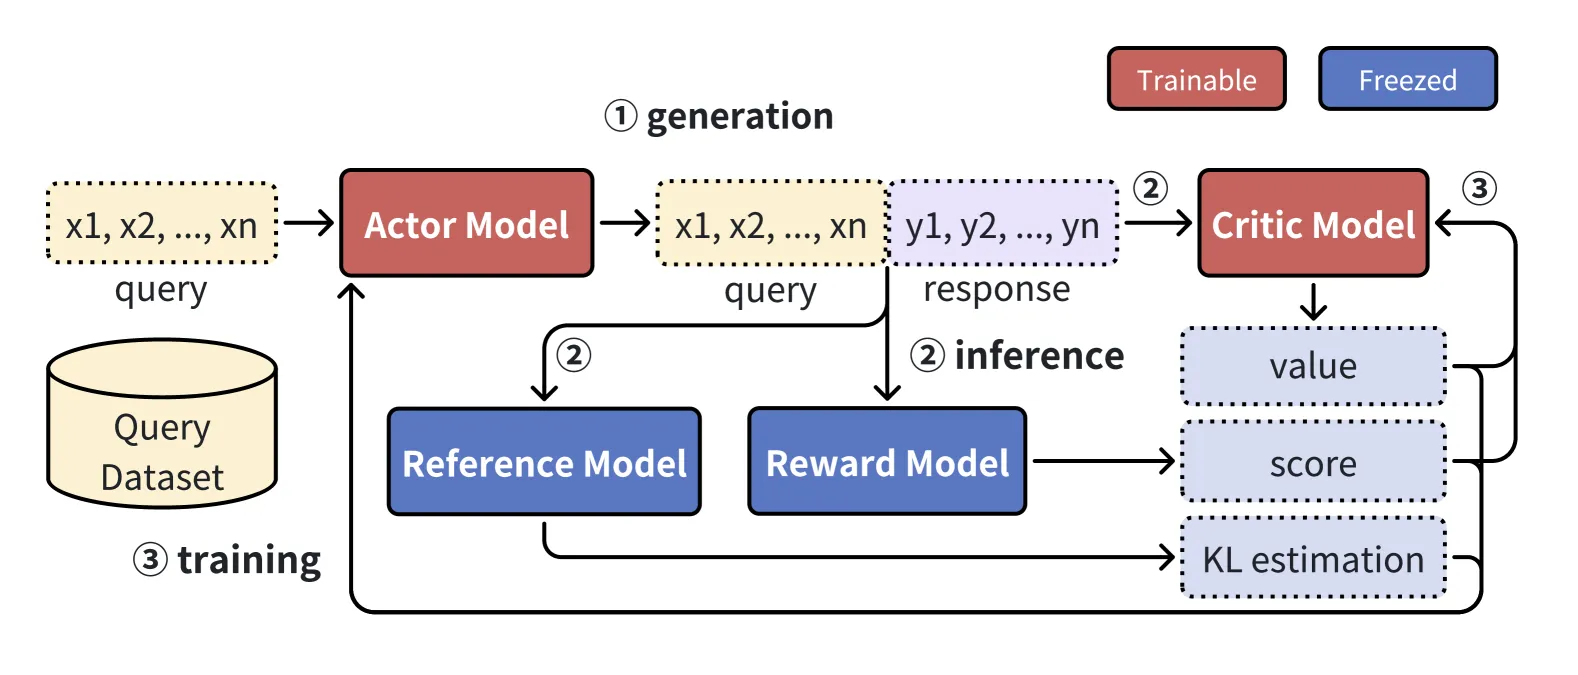
异构模型(RLHF)
RLHF 训练流程:
- 阶段 1:监督微调(SFT)
- 阶段 2:奖励模型训练
- 阶段 3:PPO 训练
PPO 训练的模型异构性:
- 推理过程:Actor 生成回复
- 训练过程:Actor + Critic 更新权重
- 涉及 4 个模型:Actor, Critic, Reward Model, Reference Model
优化策略:
- 模型并行:每个模型独立分片
- 流水线并行:推理和训练流水线化
- 资源共享:动态分配 GPU 资源
五、计算优化详解
5.1 算子优化
注意力算子优化
标准注意力:
计算复杂度:O(n²d),内存复杂度:O(n² + nd)
FlashAttention 系列:
| 版本 | 核心技术 | 加速比 | 内存节省 |
|---|---|---|---|
| FlashAttention | IO-aware, 分块计算 | 2-4x | 5-20x |
| FlashAttention-2 | 优化并行,减少非矩阵乘法 | 2x vs FA1 | 同上 |
| FlashAttention-3 | H100 优化,FP8 支持 | 1.5-2x vs FA2 | 同上 |
FlashAttention 原理:
- 将 Q/K/V 分块加载到 SRAM
- 在 SRAM 中计算注意力
- 避免 n×n 注意力矩阵物化
- IO 复杂度从 O(n²) 降至 O(n²d²/M)(M 为 SRAM 大小)
编译器自动优化
| 编译器 | 层级 | 特点 |
|---|---|---|
| Halide | 算子级 | 调度原语,数据局部性 |
| TVM | 算子级 | 自动调优,多后端 |
| Roller | 算子级 | 搜索空间优化 |
| Triton | 算子级 | C 语言,层级化 tiling |
| ALCOP | 算子级 | 自动加载-计算流水线 |
| XLA | 图级 | 算子融合,JIT 编译 |
| TorchInductor | 图级 | PyTorch 生态 |
| Chimera | 图级 | 自动算子融合 |
5.2 混合精度训练
16 位浮点
| 格式 | 位数 | 动态范围 | 精度 | 适用场景 |
|---|---|---|---|---|
| FP16 | 16 | 5-6 位指数 | 10 位尾数 | 通用训练 |
| BF16 | 16 | 8 位指数 | 7 位尾数 | 大范围值 |
| TF32 | 19 | 8 位指数 | 10 位尾数 | Ampere+ |
FP16 混合精度训练:
- 前向/后向:FP16 计算
- 权重更新:FP32 累加
- Loss Scaling:防止梯度下溢
8 位及以下浮点
| 格式 | 位数 | 特点 |
|---|---|---|
| FP8 (E4M3) | 8 | 4 位指数,3 位尾数 |
| FP8 (E5M2) | 8 | 5 位指数,2 位尾数 |
| FP4 | 4 | 极低精度,Blackwell 支持 |
FP8 训练技术:
- 分块计算:保持精度
- 随机舍入:权重更新
- 混合格式:前向/后向使用不同格式
- Loss Scaling:数值稳定性
低比特定点
| 格式 | 位数 | 特点 |
|---|---|---|
| INT8 | 8 | Jetfire,WMMA 张量核心 |
| INT4 | 4 | Xi et al.,Hadamard 变换 |
| 1-bit | 1 | BitNet,二值权重 |
| 1.58-bit | 1.58 | BitNet b1.58,三值权重 {-1, 0, 1} |
六、内存优化详解
6.1 激活重计算
静态驱逐
| 方法 | 原理 | 特点 |
|---|---|---|
| Checkmate | 混合整数线性规划 | 最优计划,但扩展性差 |
| Selective Checkpointing | 选择性丢弃注意力激活 | FlashAttention 使用 |
| DistFlashAttn | 重计算感知检查点 | 在 FlashAttention 输出处检查点 |
| LoongTrain | selective-checkpoint++ | 长序列优化 |
动态驱逐
| 方法 | 原理 | 特点 |
|---|---|---|
| DTR | 动态阈值 | 实时决策 |
| MegTaiChi | 内存感知调度 | 动态重计算 |
| Coop | 协作重计算 | 多 GPU 协作 |
6.2 冗余减少
完全分片
| 系统 | 分片内容 | 通信模式 |
|---|---|---|
| ZeRO | 优化器状态 + 梯度 + 参数 | ReduceScatter + AllGather |
| FSDP | 同上 | PyTorch 原生 |
部分分片
| 系统 | 特点 |
|---|---|
| ZeRO++ | 分层分片,量化通信 |
| MiCS | 主从分片,减少通信 |
| PaRO | 参数感知分片 |
| RTP | 远程张量流水线 |
| AMSP | 自适应混合分片 |
6.3 碎片整理
基于张量的碎片整理
| 系统 | 原理 |
|---|---|
| ROAM | 运行时内存分配优化 |
| ZeRO-R | ZeRO 扩展,碎片整理 |
| MegTaiChi | 内存感知调度 |
基于 VMM 的碎片整理
| 系统 | 原理 |
|---|---|
| GMLake | GPU 内存池化 |
| Expandable Segments | 可扩展内存段 |
6.4 卸载
CPU 卸载
| 类型 | 系统 | 特点 |
|---|---|---|
| 静态 | L2L | 层到层卸载 |
| 静态 | ZeRO-Offload | 优化器状态卸载 |
| 静态 | Elixir | 预测性卸载 |
| 动态 | TSPLIT | 动态张量分片 |
| 动态 | PatrickStar | 动态内存管理 |
| 动态 | Mobius | 内存-计算重叠 |
SSD 卸载
| 系统 | 特点 |
|---|---|
| ZeRO-Infinity | NVMe SSD 卸载 |
| Angel-PTM | 分布式 SSD 卸载 |
| Smart-Infinity | 智能 SSD 管理 |
| Fuyou | 快速 SSD 访问 |
七、通信优化详解
7.1 梯度压缩
| 方法 | 压缩方式 | 压缩比 | 特点 |
|---|---|---|---|
| PowerSGD | 低秩近似 | 10-50x | 随机投影 |
| QSGD | 标量量化 | 4-32x | 均匀量化 |
| Top-k | 稀疏化 | 10-100x | 选择性传输 |
| 1-bit Adam | 二值化 | 32x | 特殊 All-Reduce |
| DeMo | DCT + Top-k | 85x | 动量压缩 |
7.2 通信-计算重叠
| 系统 | 技术 |
|---|---|
| DeepSpeed | 异步流水线 |
| Megatron-LM | 梯度分桶 |
| ZeRO-Offload | CPU-GPU 重叠 |
7.3 拓扑感知通信
| 系统 | 技术 |
|---|---|
| Tutel | 专家并行优化 |
| FasterMoE | 拓扑感知路由 |
| Alpa | 跨设备优化 |
八、可靠性详解
8.1 故障检测
| 方法 | 检测内容 |
|---|---|
| 心跳检测 | GPU/网络状态 |
| 异常损失监控 | NaN/Inf 损失 |
| 梯度监控 | 梯度爆炸/消失 |
8.2 弹性训练
| 系统 | 特点 |
|---|---|
| TorchElastic | 动态增减 GPU |
| BaiduPipe | 流水线弹性 |
| 1F1B 弹性 | 微批次重调度 |
8.3 容错机制
| 机制 | 实现 |
|---|---|
| 异步检查点 | 后台保存,不阻塞训练 |
| 增量检查点 | 只保存变化部分 |
| 梯度修复 | 冗余计算,纠错码 |
| 热备节点 | 快速替换故障设备 |
九、相关工作对比
综述对比
| 综述 | 重点 | 本文差异 |
|---|---|---|
| Wan et al. (2024) | 模型和数据高效方法 | 本文聚焦系统和基础设施 |
| Liu et al. (2024) | 训练和推理部署 | 本文专注于训练阶段 |
| Xu et al. (2024) | 资源高效策略 | 本文更全面覆盖基础设施 |
| Liang et al. (2023) | 自动并行(通用 DNN) | 本文专注于 LLM |
关键系统对比
| 系统 | 类型 | 关键特性 | MFU |
|---|---|---|---|
| Megatron-LM | 训练框架 | TP + DP, 大规模优化 | 40-50% |
| DeepSpeed | 训练框架 | ZeRO 优化器, 异步训练 | 35-45% |
| Colossal-AI | 训练框架 | 自动并行, 模块化设计 | 30-40% |
| Alpa | 自动并行 | 层级化搜索, 跨设备优化 | 可变 |
| FlashAttention | 算子优化 | IO-aware, 分块计算 | - |
十、总结
核心贡献
- 建立 SER 分析框架:首次从可扩展性、效率、可靠性三个维度系统性分析 LLM 训练挑战
- 完整基础设施技术栈:从 AI 加速器到集群调度的全面梳理
- 并行策略分类体系:建立混合/自动/异构并行的完整分类法
- 优化技术整合:统一视角梳理计算、通信、内存三维优化
- 可靠性挑战分析:系统性分析故障检测、弹性训练、容错恢复
技术影响
- 研究指导:为 LLM 训练系统研究提供全面的技术路线图
- 工程实践:为大规模训练集群的设计和优化提供参考
- 未来方向:指出异构硬件、长序列训练、可靠性保障等关键挑战
局限性
- 时效性:综述截止于 2024 年中,未覆盖 2024-2025 年最新进展(如 DeMo、FlashAttention-3)
- 深度限制:覆盖面广但某些技术细节深度有限
- 实验缺失:未进行独立实验验证,依赖已有工作的实验结果
- 生态覆盖:主要关注 NVIDIA 生态,对其他硬件平台的实践细节较少
- 算法层面:未深入讨论训练算法优化(如学习率调度、数据增强)
未来研究方向
- 异构硬件训练:混合 GPU/TPU/CPU 的高效训练
- 长序列训练:百万级 token 的高效注意力
- 跨数据中心训练:地理分布式训练
- 可靠性保障:大规模集群的容错机制
- 绿色训练:能耗优化和碳排放控制
- MoE 优化:稀疏模型的高效训练
- 低比特训练:FP8/FP4/1-bit 的实用化
十一、参考资源
- 论文: arXiv:2407.20018
- 关键系统:
- Megatron-LM (NVIDIA) - 大规模训练框架
- DeepSpeed (Microsoft) - ZeRO 优化器
- Colossal-AI (HPC-AI Tech) - 自动并行
- FlashAttention (Tri Dao) - 高效注意力内核
- Alpa (UC Berkeley) - 自动并行搜索
- FSDP (PyTorch) - 完全分片数据并行
- 开源项目:
- Hugging Face Transformers
- PyTorch Distributed
- OLMo (Allen AI) - 开源语言模型框架