Efficient Training of Large Language Models on Distributed Infrastructures: A Survey
分布式基础设施上大规模语言模型高效训练的全面综述,涵盖基础设施、并行策略、计算通信优化与系统可靠性
Efficient Training of Large Language Models on Distributed Infrastructures: A Survey
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Efficient Training of Large Language Models on Distributed Infrastructures: A Survey |
| 作者 | Jiangfei Duan, Shuo Zhang, Zerui Wang, Lijuan Jiang, Wenwen Qu, Qinghao Hu, Guoteng Wang, Qizhen Weng, Hang Yan, Xingcheng Zhang, Xipeng Qiu, Dahua Lin, Yonggang Wen, Xin Jin, Tianwei Zhang, Peng Sun |
| 机构 | 南洋理工大学、香港中文大学、北京大学、上海人工智能实验室、华为、腾讯、清华大学 |
| 论文 | arXiv:2407.20018 |
| 代码 | 无公开代码 |
| 发布 | 2024-07-29 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
大语言模型(LLMs)的成功建立在其前所未有的规模之上,但训练这些模型对分布式系统和基础设施提出了巨大挑战。例如,LLaMA-3 的预训练需要约 54 天、使用 16K 个 H100-80GB GPU 在 Meta 的生产集群上完成。这些挑战集中在三个核心维度——可扩展性(Scalability)、效率(Efficiency)、可靠性(Reliability)(简称 “SER”)。
解决方案概述
本综述系统性地梳理了分布式 LLM 训练的高效训练系统和基础设施,涵盖四大维度:
- 基础设施层:AI 加速器、网络互连、存储系统、集群调度
- 并行策略层:混合并行(数据/张量/流水线/序列/专家并行)、自动并行、异构并行
- 优化层:计算优化(算子/混合精度)、通信优化(压缩/重叠)、内存优化(分片/卸载/检查点)
- 可靠性层:故障检测、弹性训练、容错恢复
核心观点:高效 LLM 训练需要系统性地协同优化计算、通信、内存和可靠性,而非孤立地优化单一维度。
三、技术架构
整体框架图
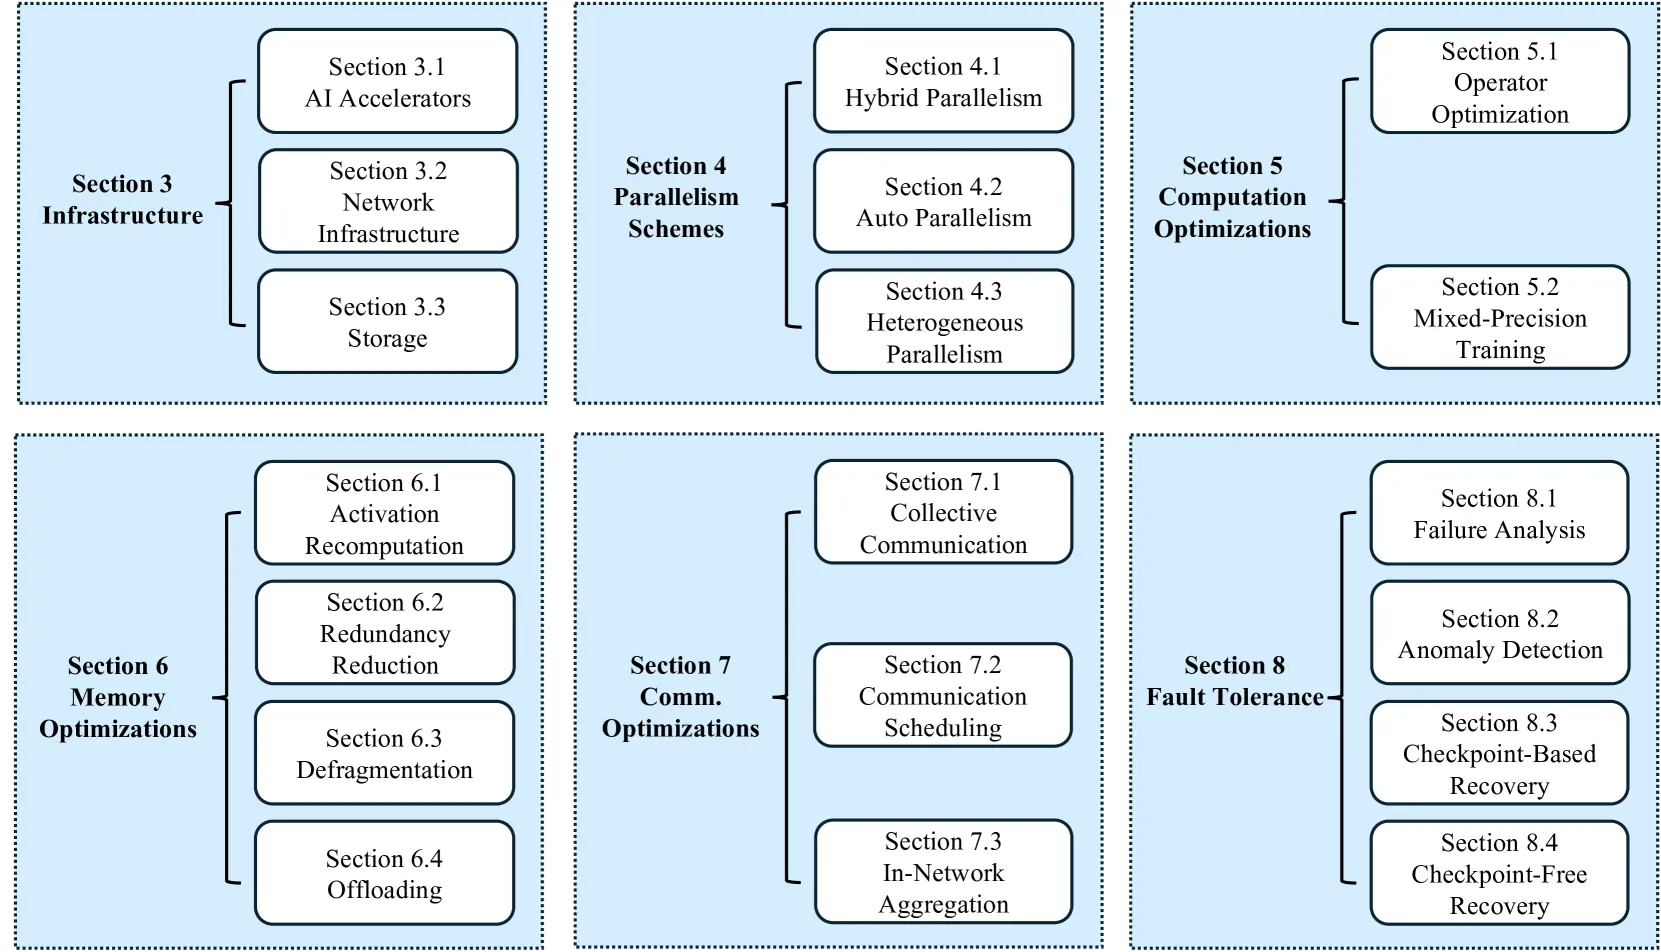
本综述将 LLM 训练的高效系统分为四个相互关联的维度:
Transformer 架构背景
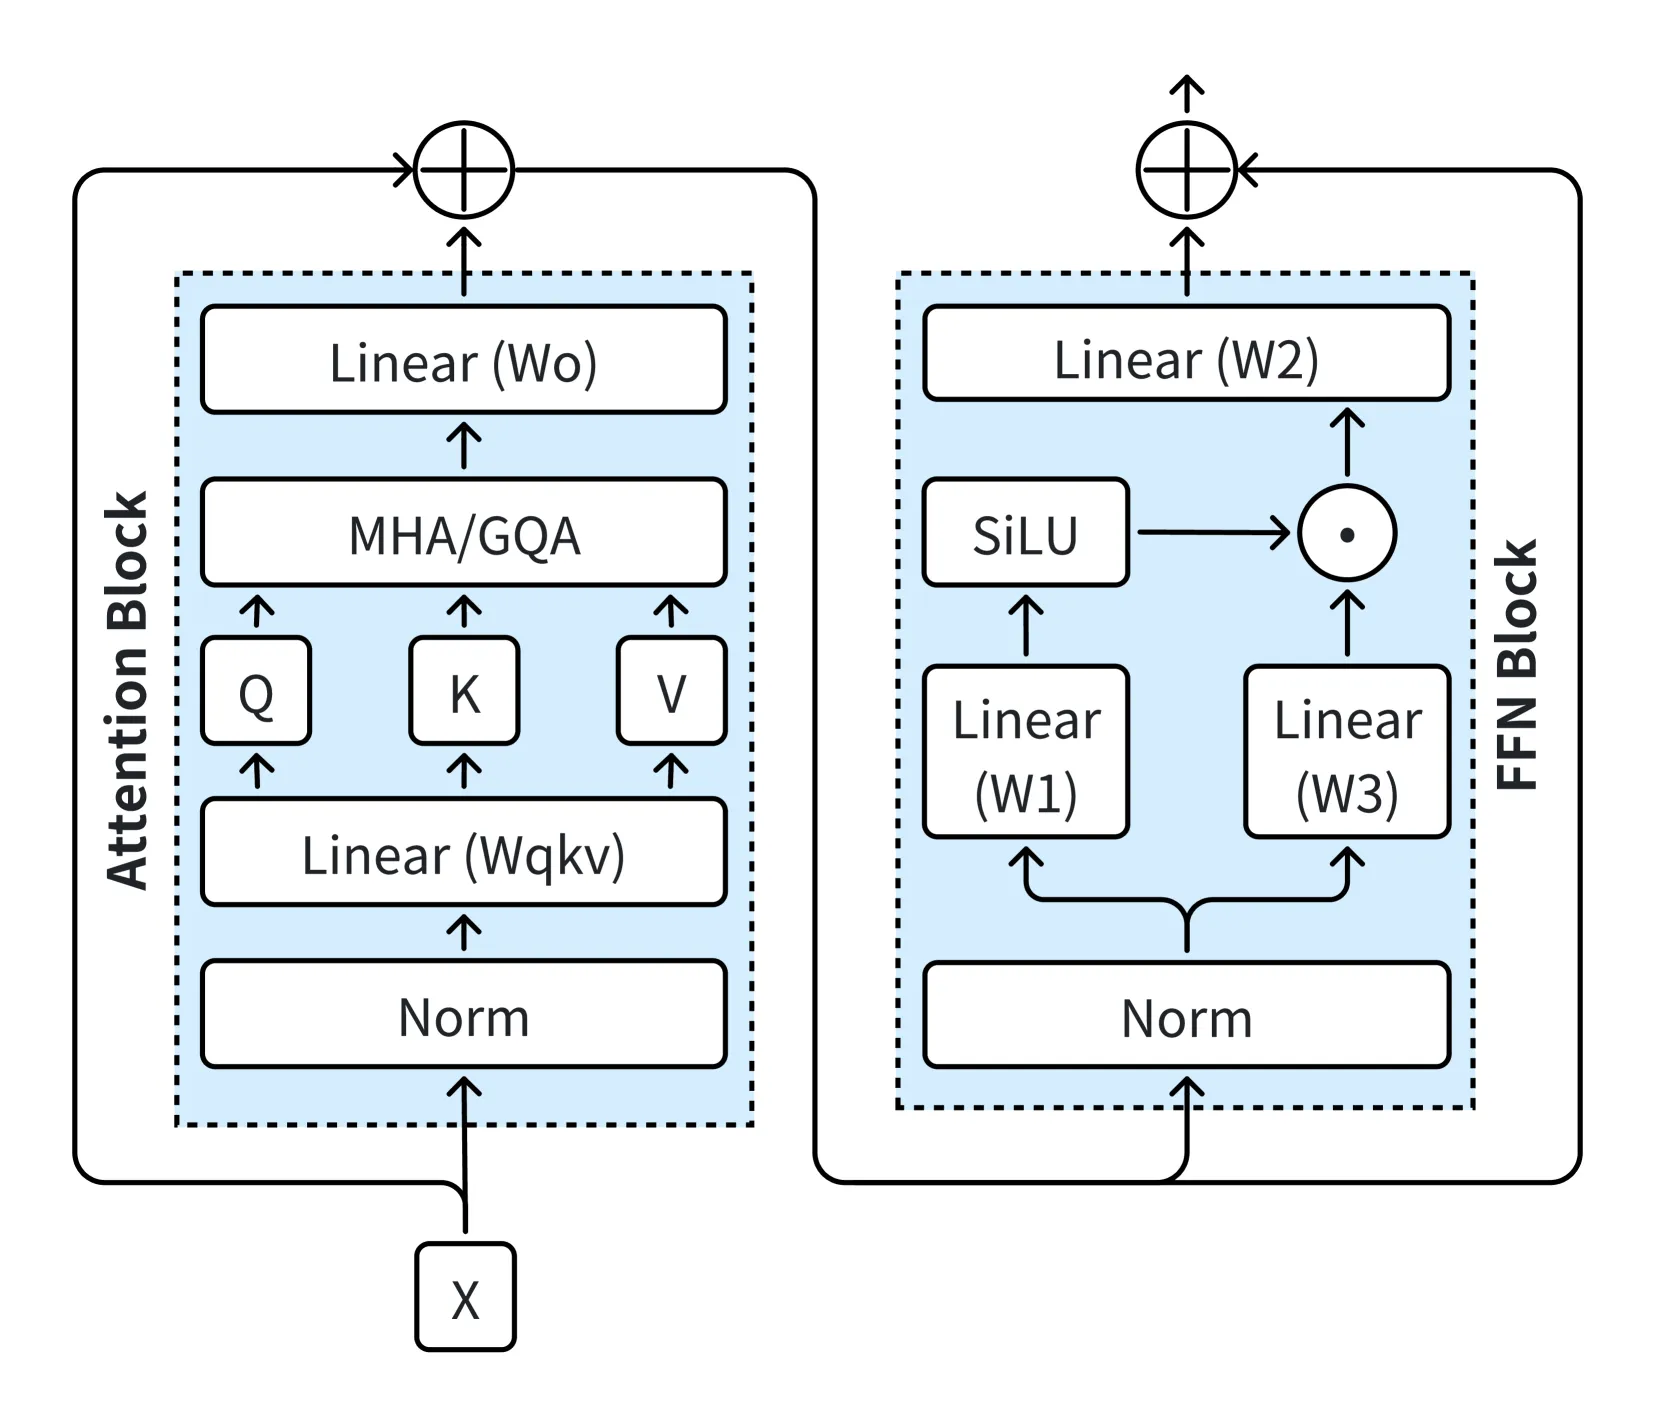
当前主流 LLM 基于 Transformer 架构,核心组件包括:
- 注意力机制:
- FFN 模块:通常使用 SwiGLU 激活函数
- 关键瓶颈:注意力计算复杂度 ,内存消耗
基础设施层
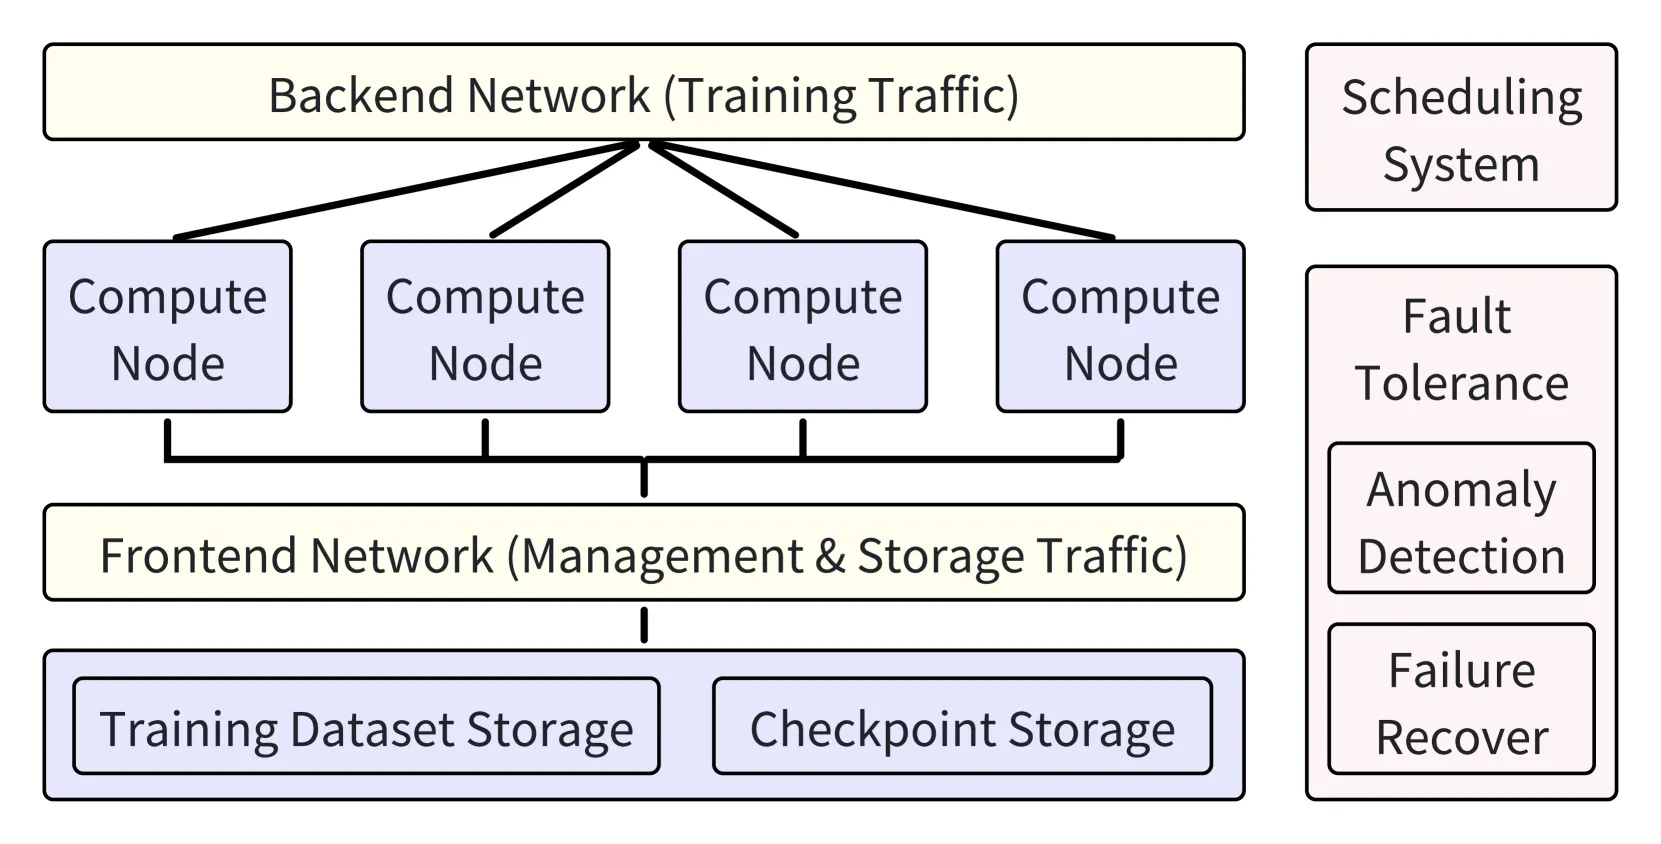
AI 加速器:
| 类型 | 代表产品 | 关键特性 |
|---|---|---|
| NVIDIA GPU | Ampere (A100), Hopper (H100), Blackwell | FP8/FP4 支持, NVLink/NVSwitch |
| AMD GPU | MI250X, MI300X | ROCm 生态, HBM3 |
| Google TPU | TPUv4, TPUv5 | 4096 芯片, 60% 峰值效率 |
| 其他 | GAUDI, Graphcore IPU, Cerebras CS-2 | 异构架构 |
网络拓扑:
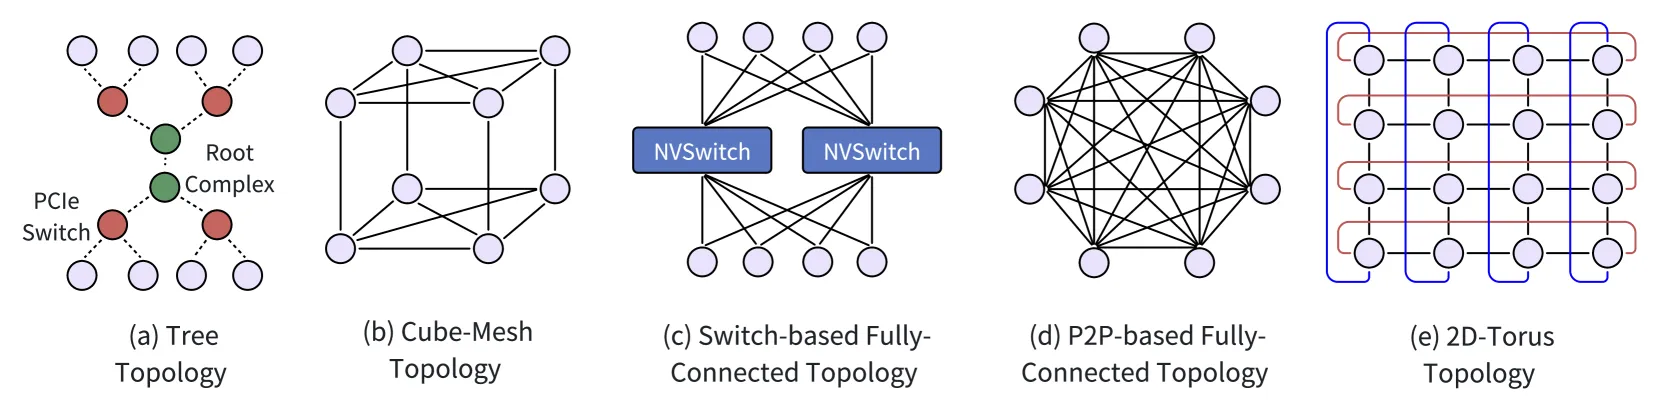
芯片间通信拓扑:树状、Cube-Mesh、全连接(NVSwitch)、2D-Torus。
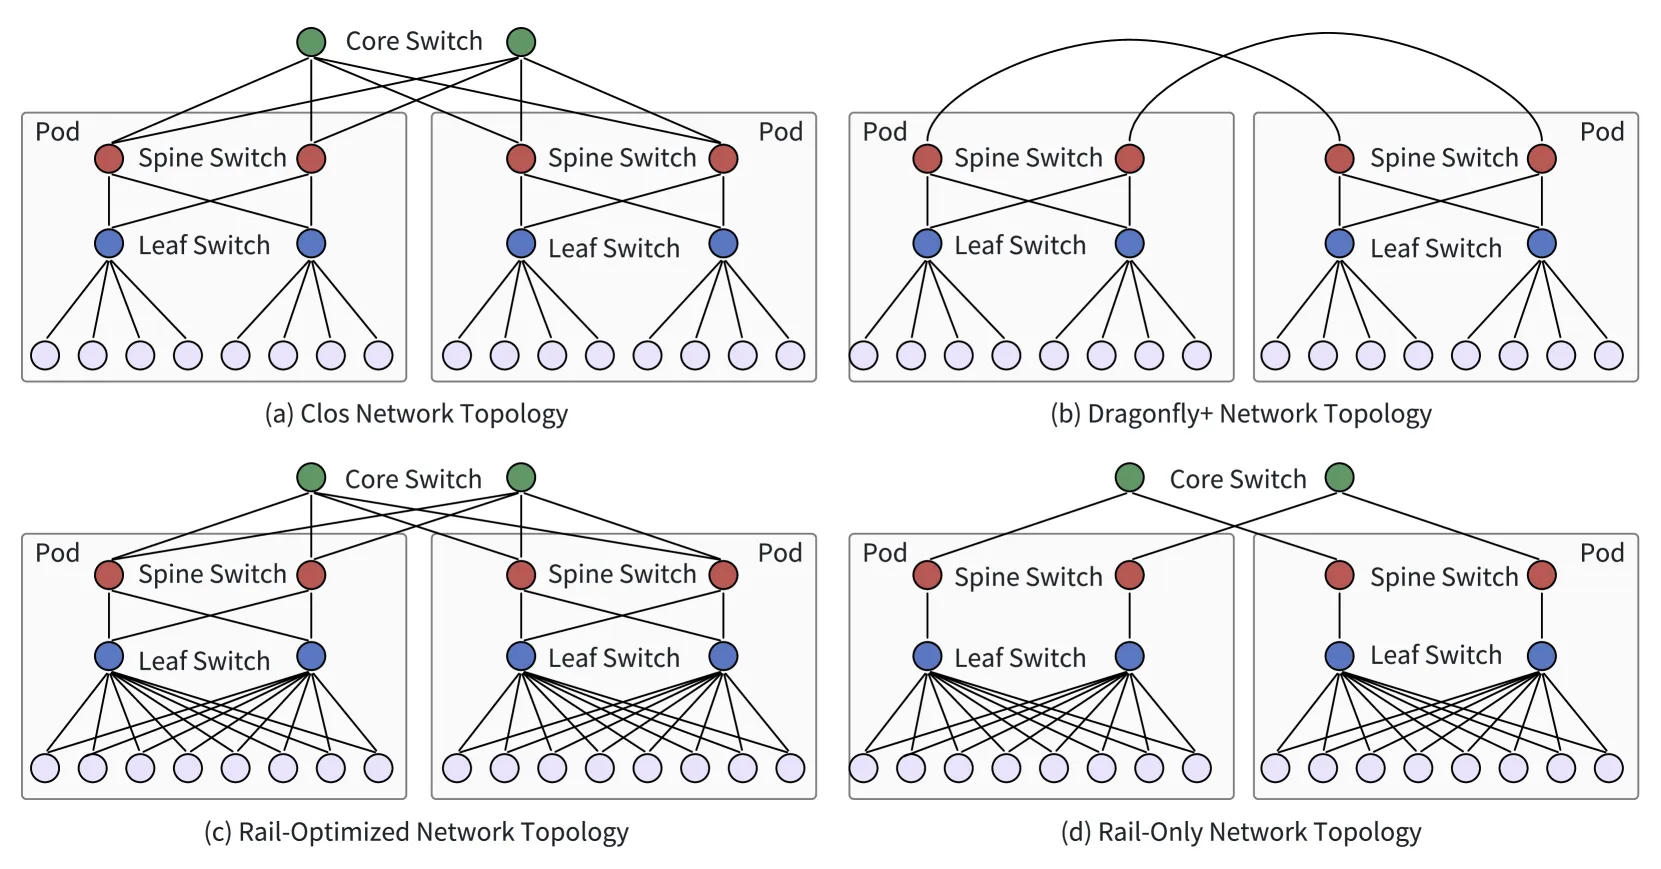
大规模集群网络拓扑:Clos (Fat-Tree)、Dragonfly+、Rail-Optimized、Rail-Only。
存储系统:
- 检查点存储:Tectonic (Meta), HDFS (ByteDance), Ceph 对象存储
- 训练数据:Lustre, GPFS, BeeGFS 并行文件系统
- 数据加载:LLaMA-3 训练数据超 15T tokens(~30 TB)
集群调度:
- 工作负载调度:异构感知 (Gavel)、作业打包 (FGD)、自适应缩放 (Pollux)
- 资源调度:网络 (Cassini)、存储 (SiloD)、CPU/内存 (Synergy)
并行策略层
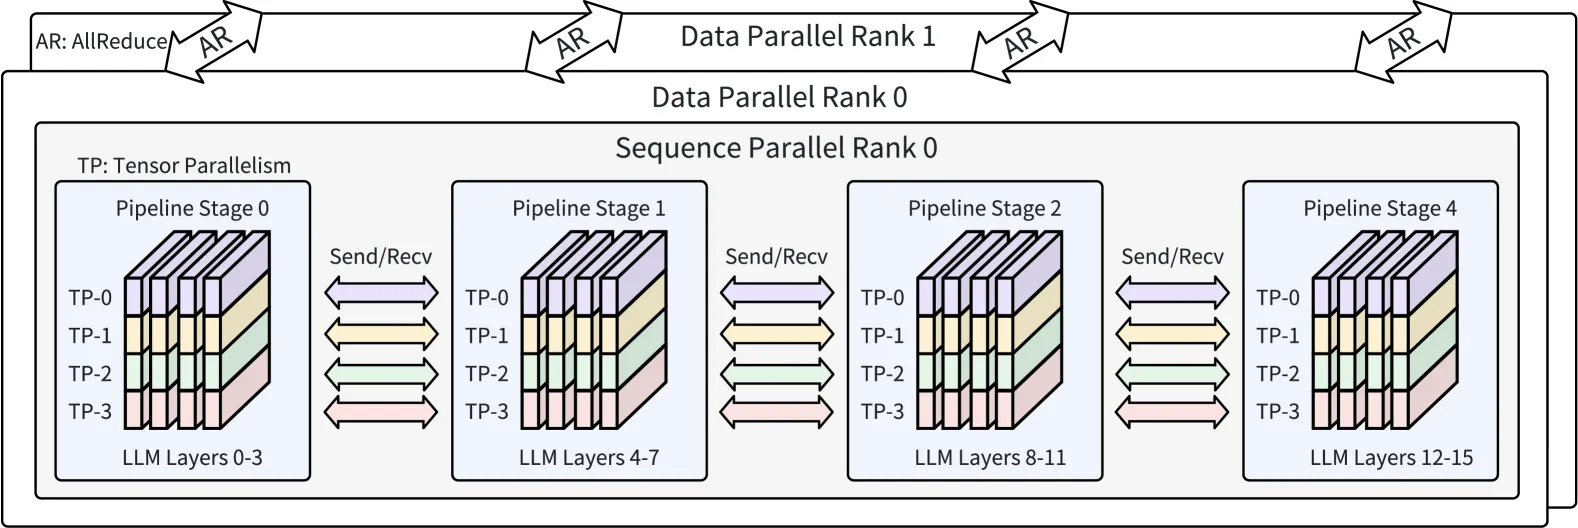
数据并行 (DP):
| 策略 | 分片因子 F | 通信量 | 内存占用 |
|---|---|---|---|
| 完全复制 (F=1) | 1 | AllReduce: | 完整模型 |
| ZeRO-1 | W | ReduceScatter + AllGather | 优化器状态分片 |
| ZeRO-2 | W | 同上 | +梯度分片 |
| ZeRO-3 | W | 同上 | +参数分片 |
张量并行 (TP):
- 分片维度:1-D (Megatron-LM), 2-D (Optimus), 2.5-D (Tesseract), 3-D
- 通信:AllReduce 跨 NVLink
- 适用场景:节点内高带宽互连
流水线并行 (PP):
- 调度策略:GPipe, PipeDream (1F1B), Interleaved 1F1B, Zero Bubble
- 核心问题:流水线气泡(GPU 空闲时间)、内存不平衡
- 解决方案:DynaPipe (自适应气泡), V-Shape (内存平衡)
序列并行 (SP):
- 目标:支持超长序列训练(百万级 token)
- 方法:Ring Self-Attention, Megatron-SP, USP
- 优势:减少激活内存,避免通信开销
专家并行 (EP):
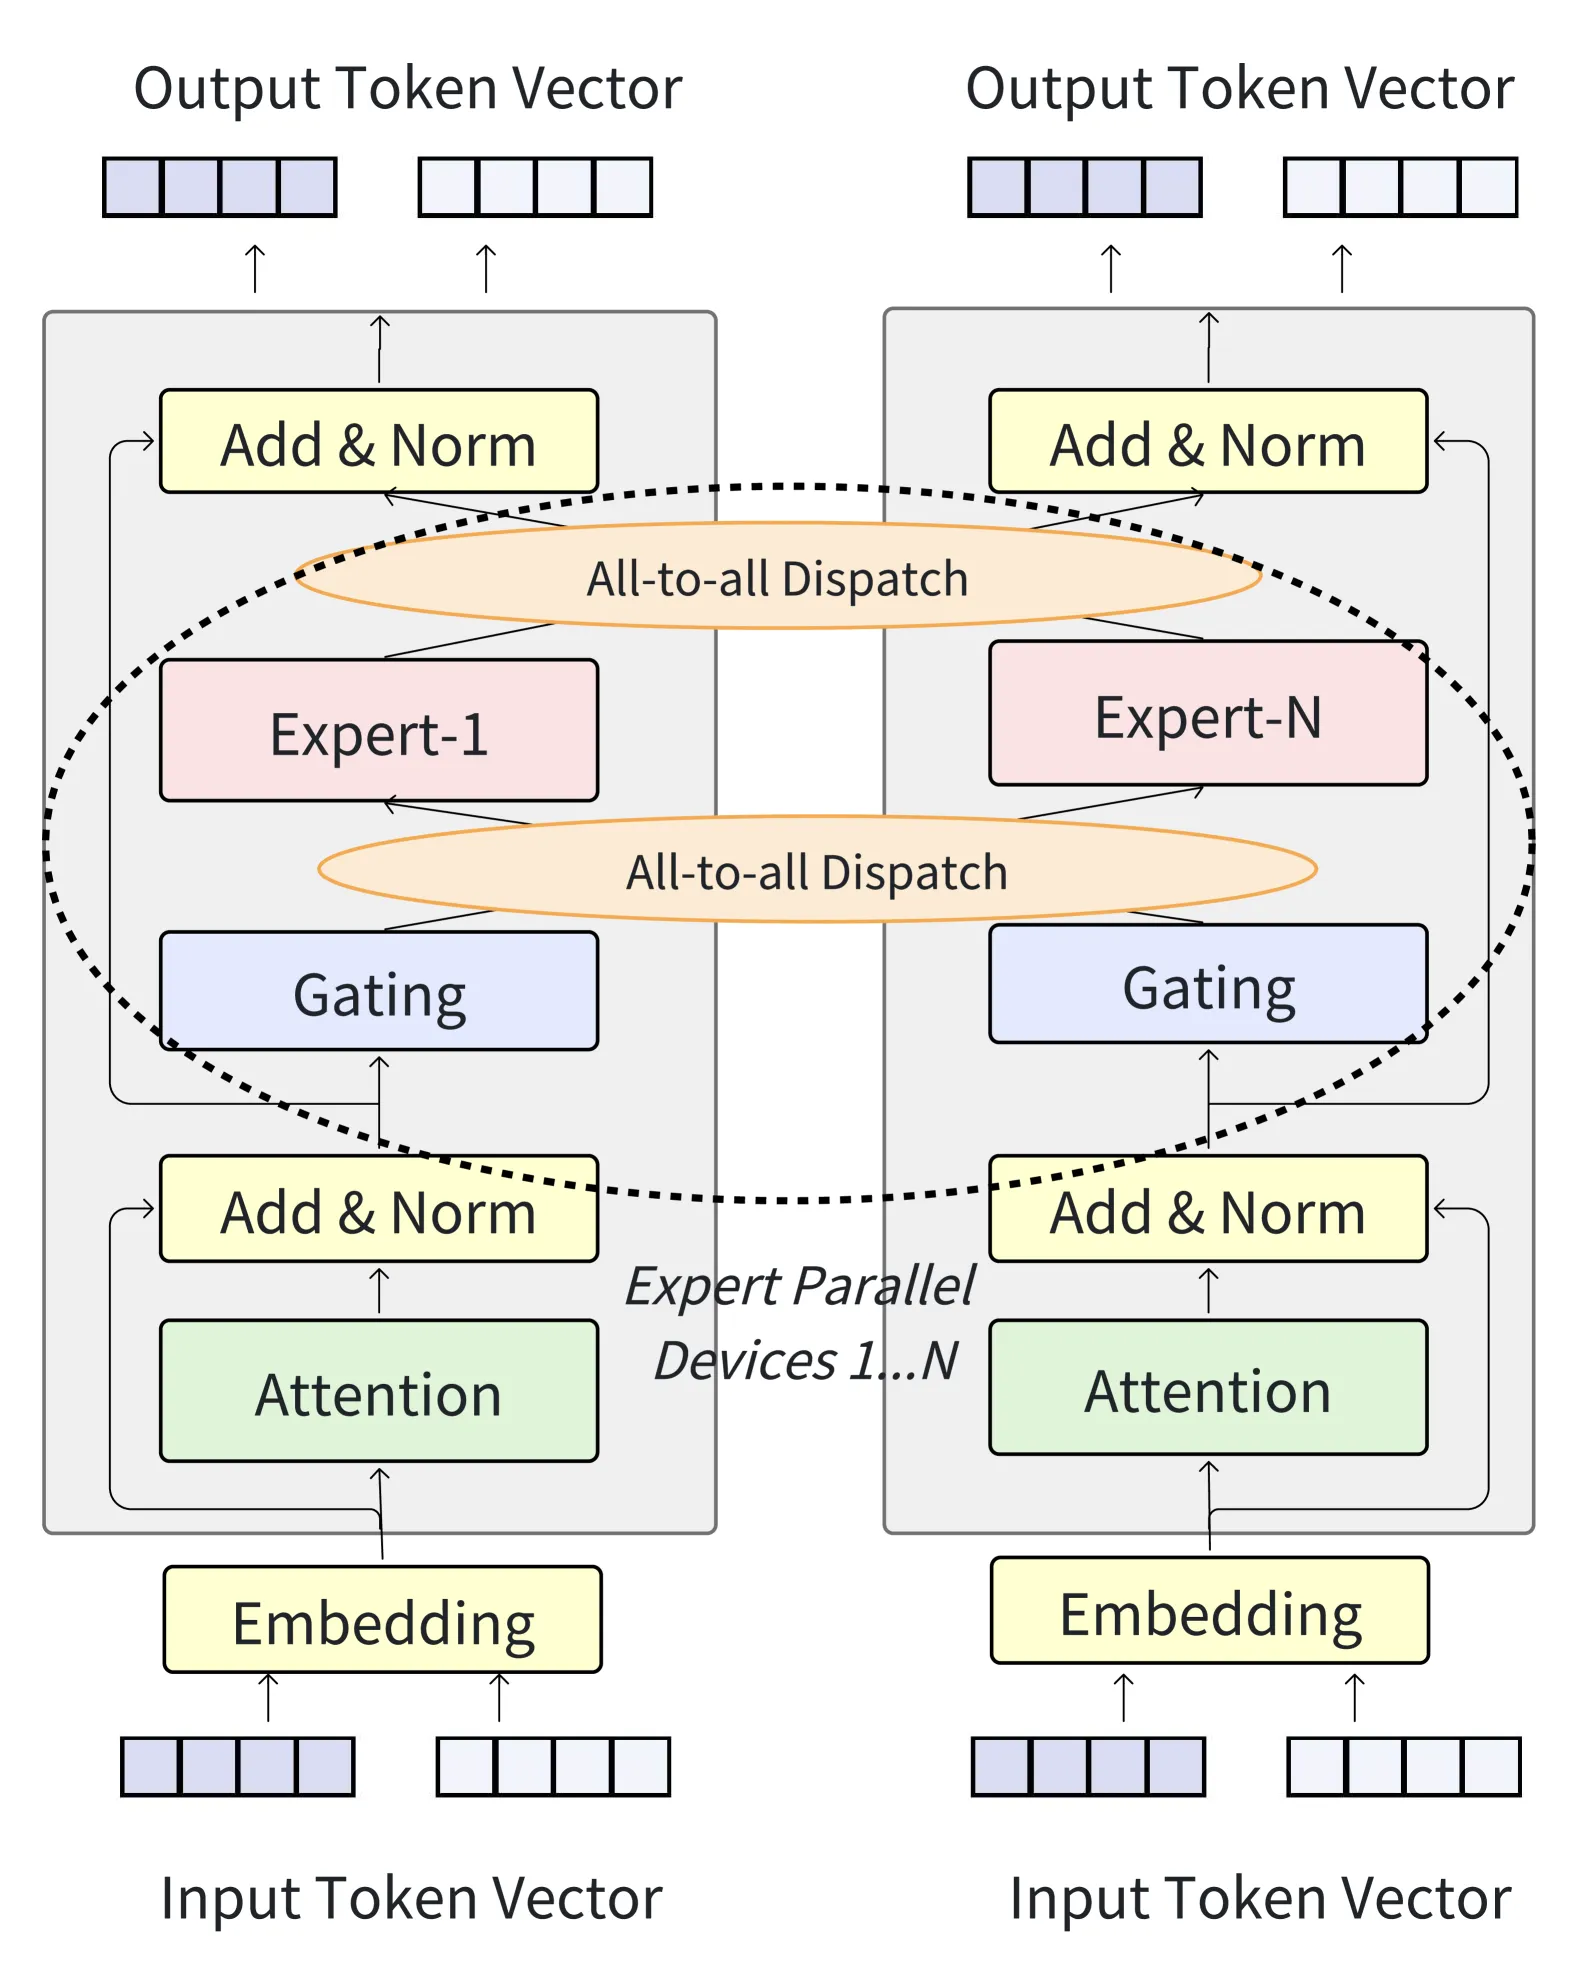
MoE 架构通过稀疏激活实现总参数量与计算成本解耦,专家分布在不同设备上,通过 All-to-All 通信协作。
自动并行:
- 通用框架:PipeDream, DAPPLE, Alpa
- Transformer 专用:DeepSpeed-Autotuning, Galvatron, Merak, Colossal-AI
- 搜索策略:动态规划、强化学习、分层搜索
异构并行:
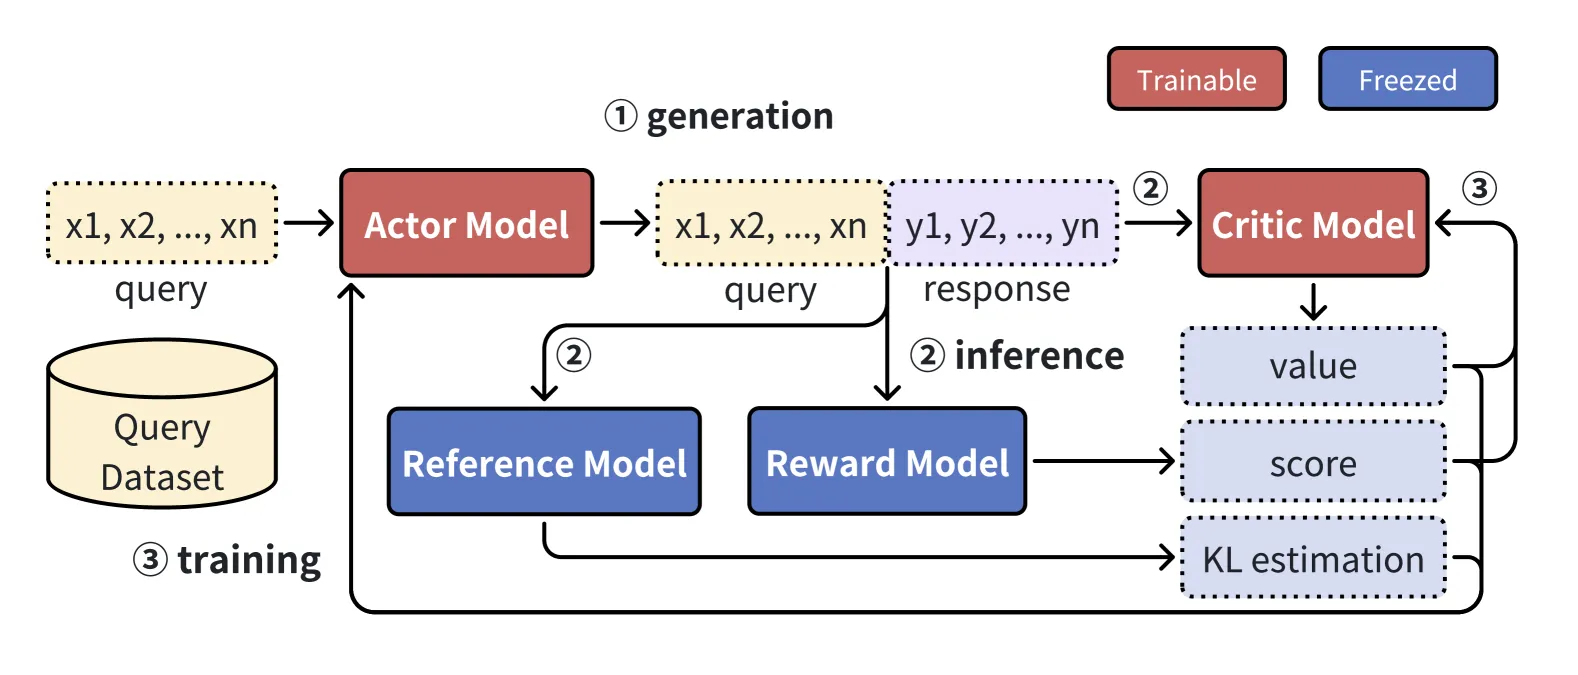
RLHF 训练涉及异构模型(Actor, Critic, Reward Model, Reference Model),需要协调多个模型的推理和训练。
优化层
计算优化:
| 优化方向 | 代表工作 | 核心技术 |
|---|---|---|
| 注意力内核 | FlashAttention 1/2/3 | IO-aware, 分块计算, 硬件感知 |
| 编译器 | TVM, Triton, ALCOP | 算子融合, 自动调优 |
| 混合精度 | FP16/BF16/FP8/INT4 | Loss Scaling, 动态精度 |
通信优化:
| 优化方向 | 代表工作 | 核心技术 |
|---|---|---|
| 梯度压缩 | PowerSGD, QSGD | 量化 + 低秩近似 |
| 通信-计算重叠 | DeepSpeed, Megatron | 异步流水线 |
| 拓扑感知 | Tutel, FasterMoE | 通信拓扑优化 |
内存优化:
| 优化方向 | 代表工作 | 核心技术 |
|---|---|---|
| 激活检查点 | GPipe, Selective Recompute | 重计算替代存储 |
| CPU 卸载 | ZeRO-Infinity, FlexFlow | 参数/优化器状态卸载 |
| 非均匀卸载 | Zero-Offload-Memory | 智能分片策略 |
可靠性层
故障类型与检测:
- 硬件故障:GPU、网络、存储
- 软件故障:NaN/Inf 损失、梯度爆炸
- 检测方法:心跳检测、异常损失监控
弹性训练:
- 1F1B 弹性:支持动态增减 GPU
- Checkpoint-Load:故障恢复后从检查点重启
- 代表系统:TorchElastic, BaiduPipe
容错机制:
- 检查点策略:异步检查点、增量检查点
- 梯度修复:冗余计算、纠错码
- 热备节点:快速替换故障设备
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| SER 框架 | 首次提出可扩展性-效率-可靠性的三维分析框架 | 系统性文献综述,涵盖 500+ 篇参考文献 |
| 并行策略分类法 | 建立混合/自动/异构并行的完整分类体系 | 覆盖 DP/TP/PP/SP/EP 及其组合 |
| 基础设施全景 | 从芯片到集群的完整基础设施技术栈梳理 | NVIDIA/AMD/TPU 硬件对比 + 网络拓扑分析 |
| 优化技术整合 | 计算/通信/内存三维优化技术的统一视角 | FlashAttention、ZeRO、梯度压缩等技术对比 |
| 可靠性挑战分析 | 系统性分析 LLM 训练可靠性问题及解决方案 | 故障类型分类 + 弹性训练机制 |
五、代码实现分析
- 无公开代码:本论文为综述性质,未提供开源实现
- 涵盖系统:DeepSpeed, Megatron-LM, Colossal-AI, Alpa, FSDP 等主流训练框架
- 实现语言:主要基于 PyTorch 生态,部分框架支持 JAX/TensorFlow
六、实验结果
基准测试
本综述未进行独立实验,而是系统性地梳理和对比已有工作的实验结果。
典型 LLM 训练规模对比:
| 模型 | 参数量 | GPU 数量 | 训练时间 | 训练数据 |
|---|---|---|---|---|
| LLaMA-3 405B | 405B | 16K H100 | 54 天 | 15T tokens |
| GPT-3 | 175B | 1024 A100 | ~34 天 | 300B tokens |
| BLOOM | 176B | 384 A100 | 117 天 | 366B tokens |
| PaLM | 540B | 6144 TPUv4 | ~64 天 | 780B tokens |
关键性能指标
MFU(Model FLOPs Utilization)对比:
| 系统 | MFU | 硬件 | 模型 |
|---|---|---|---|
| Megatron-LM | 40-50% | A100 | GPT-3 |
| DeepSpeed | 35-45% | A100 | 各种规模 |
| Colossal-AI | 30-40% | A100 | BLOOM |
通信开销分析:
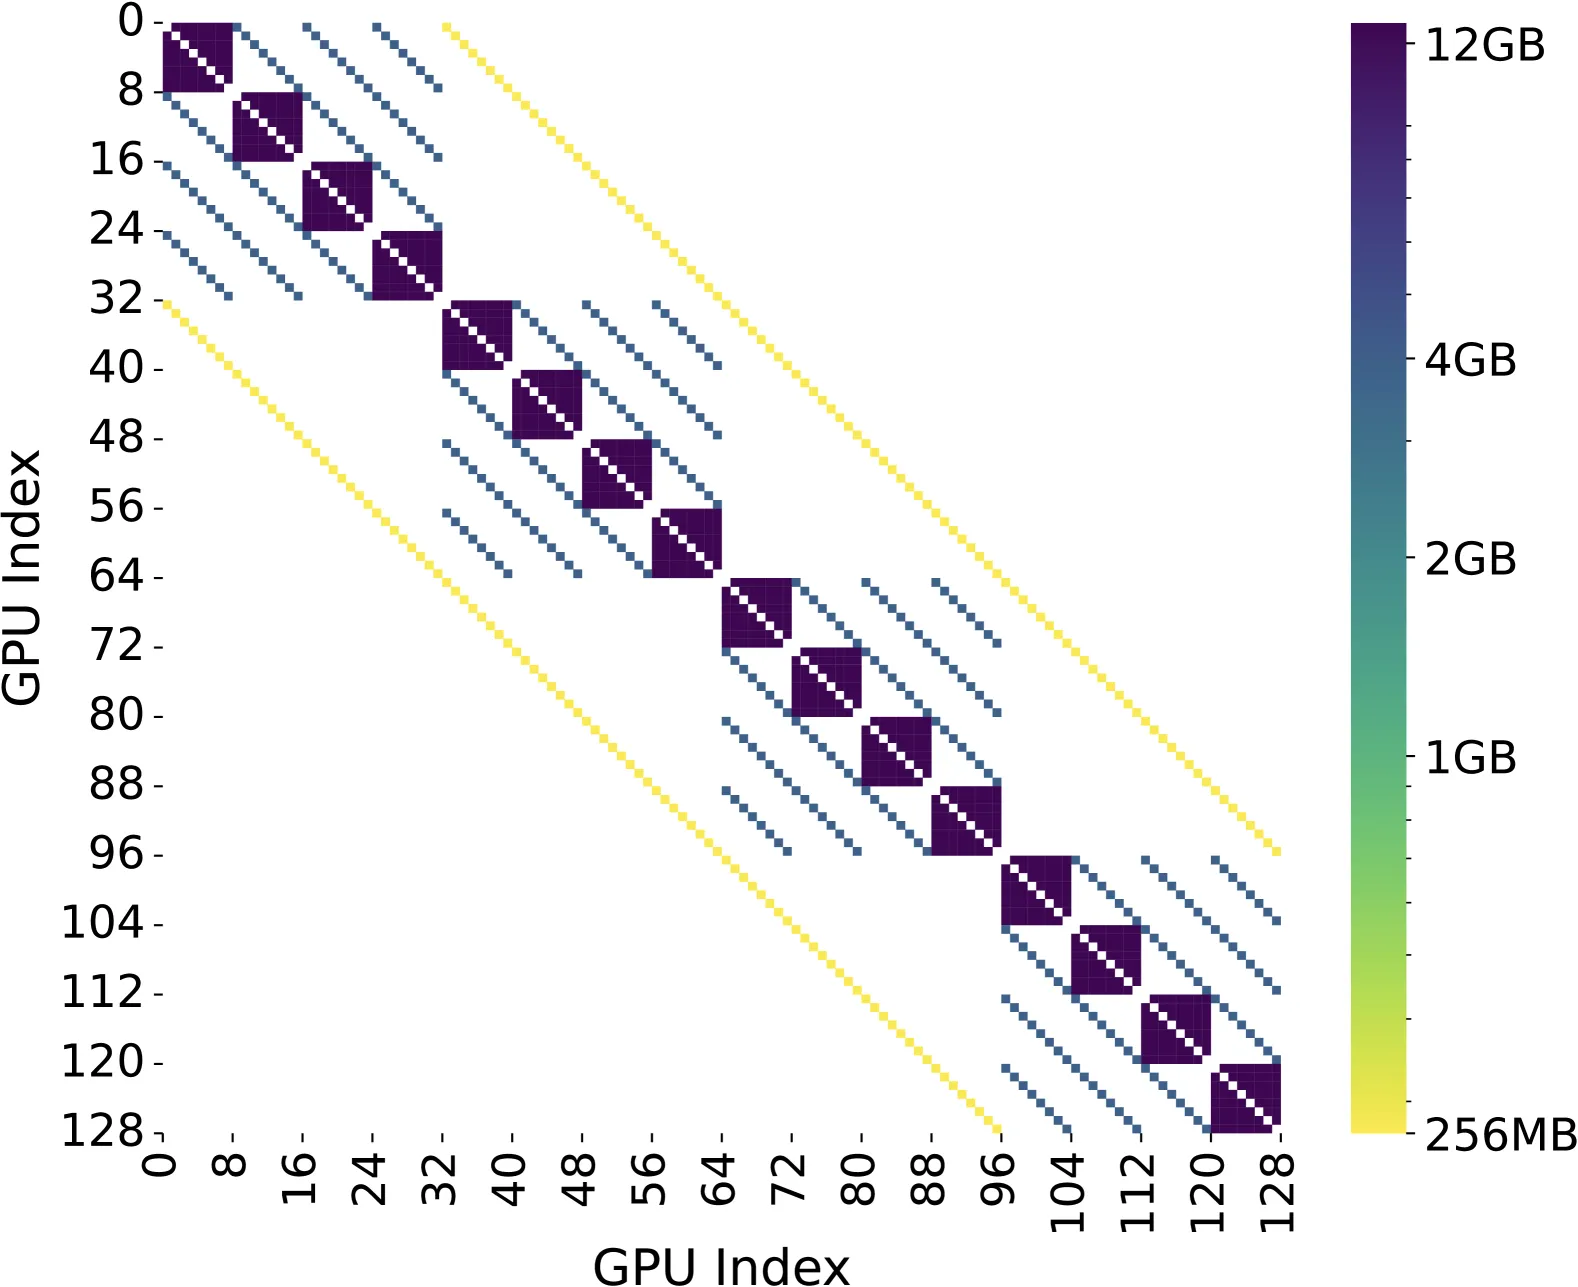
InternLM-2 102B 使用 128 GPU 训练的通信流量分析:
- TP 通信:NVSwitch 全连接拓扑,密集方块模式
- DP/ZeRO-1 通信:跨节点 32×32 矩阵中的对角线
- PP 通信:相对较小,形成两条黄色线条
优化技术对比
| 技术 | 加速比 | 内存节省 | 通信减少 |
|---|---|---|---|
| FlashAttention | 1.5-3x | 5-20x | - |
| ZeRO-3 | 1.2x | 4-8x | - |
| 梯度压缩 | - | - | 2-10x |
| 重计算 | 0.7x (开销) | 3-5x | - |
七、相关工作
综述对比
| 综述 | 重点 | 本文差异 |
|---|---|---|
| Wan et al. (2024) | 模型和数据高效方法 | 本文聚焦系统和基础设施 |
| Liu et al. (2024) | 训练和推理部署 | 本文专注于训练阶段 |
| Xu et al. (2024) | 资源高效策略 | 本文更全面覆盖基础设施 |
相关系统
| 系统 | 类型 | 关键特性 |
|---|---|---|
| Megatron-LM | 训练框架 | TP + DP, 大规模优化 |
| DeepSpeed | 训练框架 | ZeRO 优化器, 异步训练 |
| Colossal-AI | 训练框架 | 自动并行, 模块化设计 |
| Alpa | 自动并行 | 层级化搜索, 跨设备优化 |
| FlashAttention | 算子优化 | IO-aware, 分块计算 |
八、总结
核心贡献
- 建立 SER 分析框架:首次从可扩展性、效率、可靠性三个维度系统性分析 LLM 训练挑战
- 完整基础设施技术栈:从 AI 加速器到集群调度的全面梳理
- 并行策略分类体系:建立混合/自动/异构并行的完整分类法
- 优化技术整合:统一视角梳理计算、通信、内存三维优化
- 可靠性挑战分析:系统性分析故障检测、弹性训练、容错恢复
技术影响
- 研究指导:为 LLM 训练系统研究提供全面的技术路线图
- 工程实践:为大规模训练集群的设计和优化提供参考
- 未来方向:指出异构硬件、长序列训练、可靠性保障等关键挑战
局限性
- 时效性:综述截止于 2024 年中,未覆盖 2024-2025 年最新进展
- 深度限制:覆盖面广但某些技术细节深度有限
- 实验缺失:未进行独立实验验证,依赖已有工作的实验结果
- 生态覆盖:主要关注 NVIDIA 生态,对其他硬件平台的实践细节较少
九、参考资源
- 论文: arXiv:2407.20018
- 相关综述:
- Wan et al. (2024) - Efficient LLM advances
- Liu et al. (2024) - LLM training and inference deployment
- Xu et al. (2024) - Resource-efficient LLM strategies
- 关键系统:
- Megatron-LM (NVIDIA) - 大规模训练框架
- DeepSpeed (Microsoft) - ZeRO 优化器
- Colossal-AI (HPC-AI Tech) - 自动并行
- FlashAttention (Tri Dao) - 高效注意力内核
- Alpa (UC Berkeley) - 自动并行搜索
- 开源项目: