Scaling Diffusion Transformers to 16 Billion Parameters (DiT-MoE)
使用稀疏 MoE 扩展扩散 Transformer 到 16.5B 参数
Scaling Diffusion Transformers to 16 Billion Parameters (DiT-MoE)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scaling Diffusion Transformers to 16 Billion Parameters |
| 作者 | Zhengcong Fei, Mingyuan Fan, Changqian Yu, Debang Li, Junshi Huang |
| 机构 | Kunlun Inc. |
| 论文 | arXiv:2407.11633 |
| 代码 | GitHub |
| 发布 | 2024年7月16日 |
| 主题 | cs.CV |
二、核心思想
问题定义
扩散 Transformer (DiT) 在扩展到更大规模时面临计算成本过高的问题。现有方法(如 Stable Diffusion 3)参数量超过 8B,训练和推理成本高昂。密集模型中每个样本都需要使用所有参数处理,导致扩展成本线性增长。
解决方案概述
DiT-MoE 是 DiT 的稀疏版本,通过混合专家 (MoE) 架构实现高效扩展:
- 共享专家路由: 额外的共享专家捕获通用知识,减少专家间冗余
- 专家级平衡损失: 确保负载均衡,防止部分专家过度使用
- 稀疏激活: 16.5B 总参数中仅激活 3.1B,大幅降低推理成本
核心性能
| 指标 | 数值 |
|---|---|
| 最大参数量 | 16.5B (G/2-16E2A) |
| 激活参数 | 3.1B |
| ImageNet 512×512 FID | 1.80 (SOTA) |
| ImageNet 256×256 FID | 2.28 |
| 推理加速 | 约 2× vs 同等性能密集模型 |
三、技术架构
整体框架图
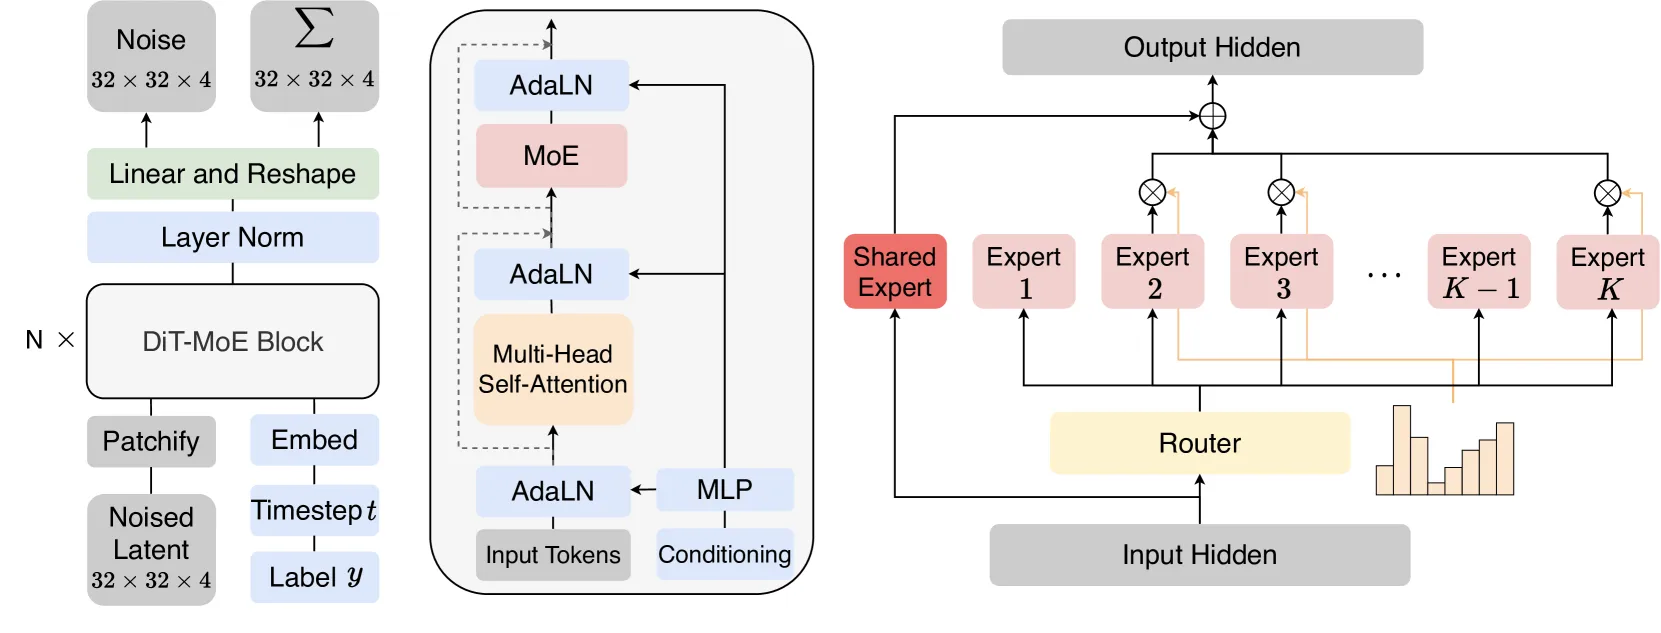
Figure 2: DiT-MoE 架构概览。DiT-MoE 基于 DiT 构建,由插入 MoE 的 Transformer 块组成。将 MLP 替换为稀疏激活的 MLP 混合体。右图展示了共享专家策略的 MoE 层集成细节。
核心公式
扩散模型前向过程
其中 , 是高斯噪声。
条件扩散模型目标
其中 是条件索引或其连续嵌入。
MoE 层定义
其中 是层输入, 是专家 的函数, 是路由函数。
专家级平衡损失
其中:
- : 专家级平衡因子 (默认 0.005)
- : 图像 patch 序列长度
- : 指示函数,图像 token 选择专家
- : token 对专家的概率分布
模型配置
| 配置 | 总参数 | 激活参数 | Block 数 | 隐藏维度 | Head 数 | GFlops |
|---|---|---|---|---|---|---|
| S/2-8E2A | 199M | 71M | 12 | 384 | 6 | 15.43 |
| S/2-16E2A | 369M | 71M | 12 | 384 | 6 | 15.44 |
| B/2-8E2A | 795M | 286M | 12 | 768 | 12 | 61.68 |
| L/2-8E2A | 2.8B | 1.0B | 24 | 1024 | 16 | 219.26 |
| XL/2-8E2A | 4.1B | 1.5B | 28 | 1152 | 16 | 323.74 |
| G/2-16E2A | 16.5B | 3.1B | 40 | 1408 | 16 | 690.94 |
命名规则: DiT-MoE L/2-8E2A 表示 Large 配置,patch size , 专家, 激活专家。
训练细节
| 项目 | 配置 |
|---|---|
| 数据集 | ImageNet (1,281,167 训练图像,1000 类) |
| 分辨率 | 256×256 和 512×512 |
| 数据增强 | 仅水平翻转 |
| 训练迭代 | 500K, 1M, 7M |
| 批量大小 | 1024 |
| 优化器 | AdamW,无权重衰减 |
| 学习率 | 1e-4 (恒定) |
| EMA 衰减 | 0.9999 |
| 硬件 | Nvidia A100 GPU |
| VAE | 预训练 SD VAE (下采样因子 8) |
| 扩散参数 | ,线性方差调度 到 |
| 共享专家数 | |
| 平衡因子 |
合成数据训练
- 使用 SDXL 和 SD3-Medium 生成约 5M 张 512×512 图像
- 提示模板: “[image class], in a natural and realistic style.”
- 真实数据与合成数据比例: 1:5
- 使用 CLIP 相似度过滤高质量样本
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 共享专家路由 | 额外 个共享专家处理所有 token | 捕获通用知识,减少冗余 |
| 专家级平衡损失 | 基于指示函数和概率分布的平衡损失 | 最优 |
| 专家特化分析 | 从类别、空间位置、时间步三维度分析 | 发现深层 MoE 更均匀,早期步骤更集中 |
| 16.5B 参数扩展 | G/2-16E2A 配置,仅激活 3.1B | FID 1.80 (512×512 SOTA) |
五、实验结果
消融实验
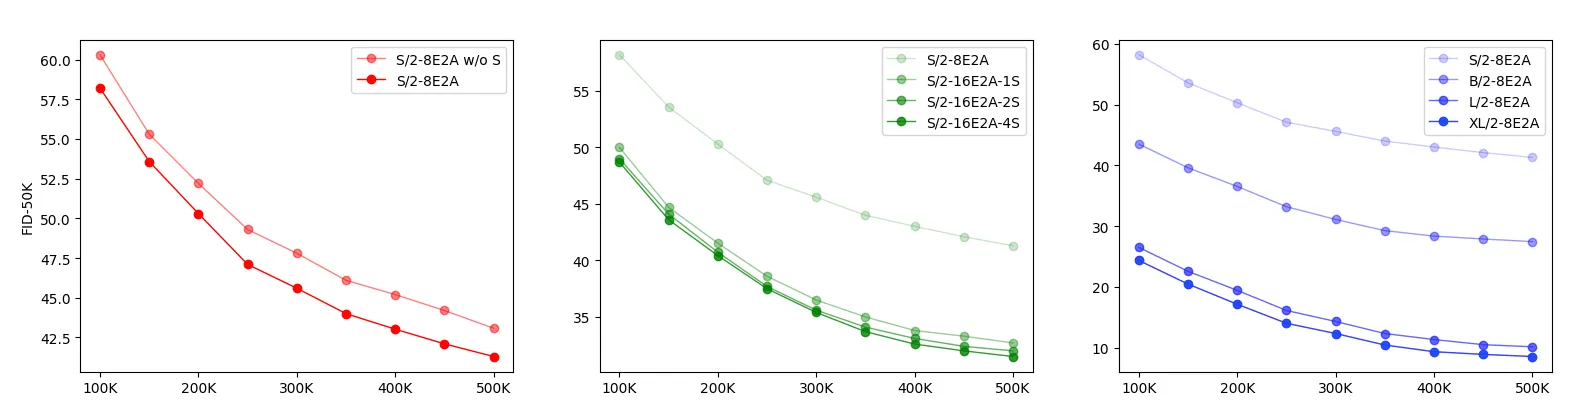
Figure 3: ImageNet 256×256 消融实验,报告 50K 生成样本的 FID(无 CFG)。
关键发现:
- (a) 共享专家路由加速训练并优化生成结果
- (b) 增加专家数量(8→16)一致提升性能
- (c) 增加模型大小一致提升 FID
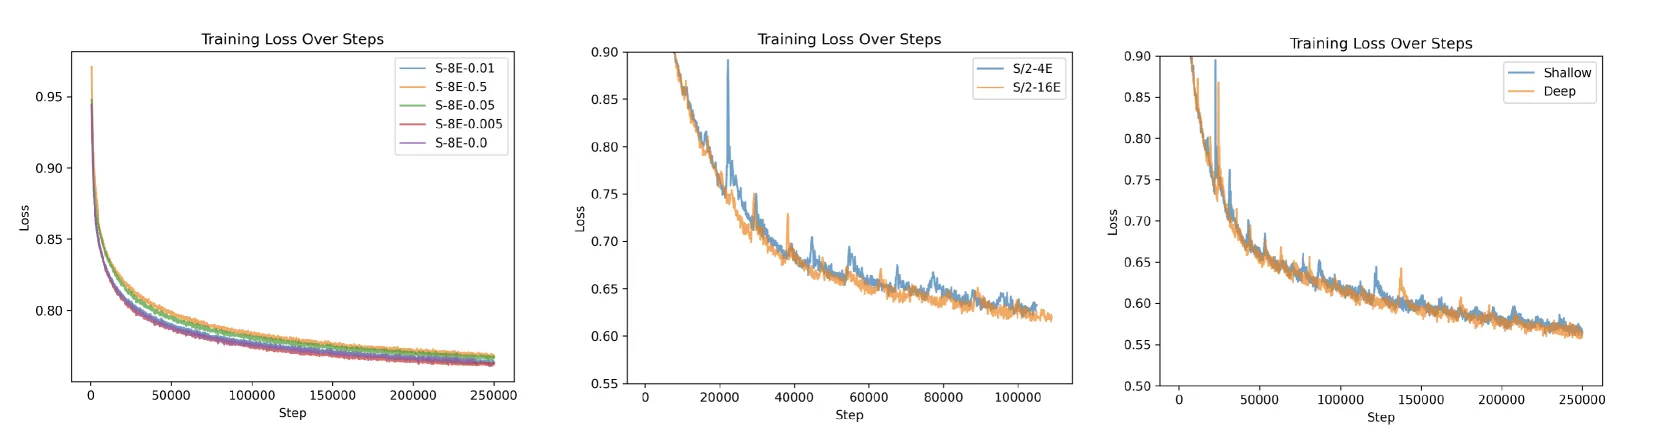
Figure 4: 小版本不同元素的训练损失曲线。
- (a) 专家平衡损失 效果最佳
- (b) 增加专家数量加速收敛
- (c) 深层 MoE 替换优于浅层
专家特化分析
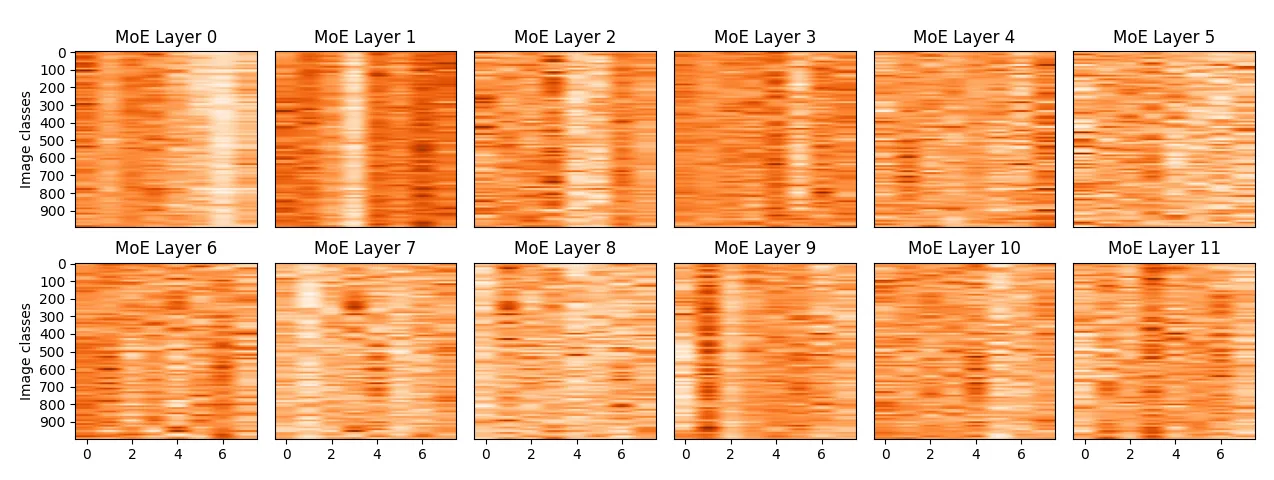
Figure 5: 每个图像类别的专家选择频率。12 个 MoE 层,x 轴对应 8 个专家,y 轴是 1000 个 ImageNet 类别。
关键发现:
- 专家选择对类别条件信息不敏感
- 不同类别间无明显路由模式差异
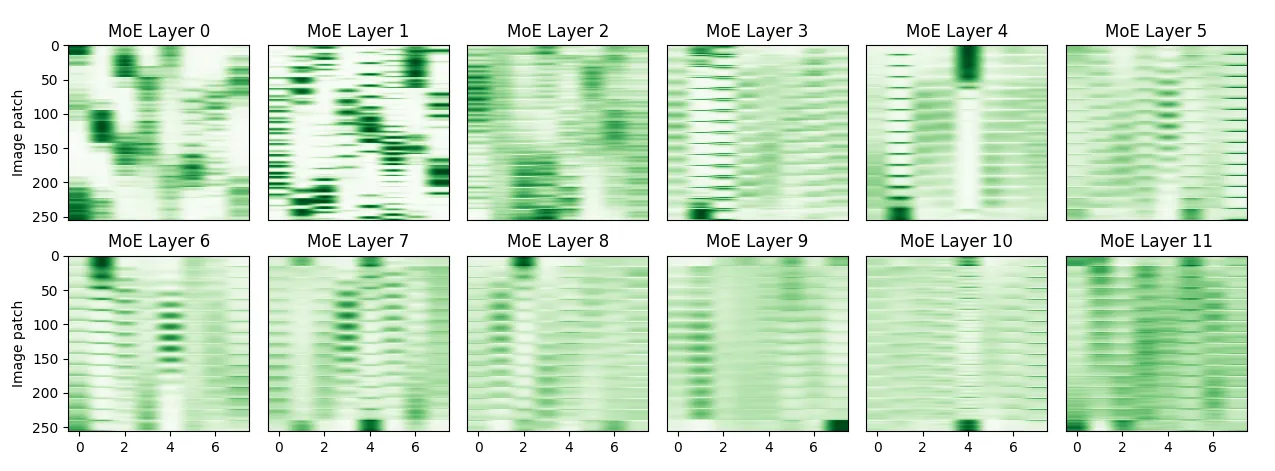
Figure 6: 每个图像 patch 位置的专家选择频率。x 轴对应 8 个专家,y 轴是 256 个 patch。
关键发现:
- 浅层 MoE (层 0): 专家选择与空间聚类强相关
- 深层 MoE (层 9): 专家选择分布更均匀
- 随层数加深,从特定位置偏好转向分散均衡
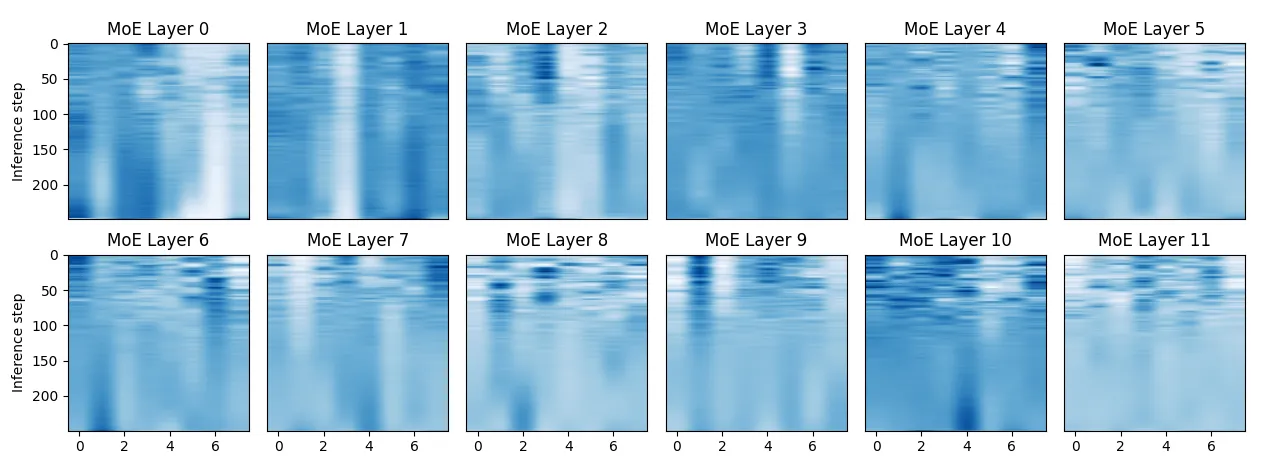
Figure 7: 每个去噪时间步的专家选择频率。x 轴对应 8 个专家,y 轴是 250 个 DDPM 步骤。
关键发现:
- 早期步骤 (<50): 专家选择更集中(低频空间信息)
- 后期步骤 (>100): 分布更均匀(高频复杂信息)
ImageNet 256×256 基准测试
| 模型 | FID↓ | sFID↓ | IS↑ | Precision↑ | Recall↑ |
|---|---|---|---|---|---|
| BigGAN-deep | 6.95 | 7.36 | 171.4 | 0.87 | 0.28 |
| StyleGAN-XL | 2.30 | 4.02 | 265.12 | 0.78 | 0.53 |
| ADM | 10.94 | 6.02 | 100.98 | 0.69 | 0.63 |
| LDM-4-G | 3.60 | - | 247.67 | 0.87 | 0.35 |
| DiT-XL/2 | 2.27 | 4.60 | 278.24 | 0.83 | 0.57 |
| DiT-MoE-XL/2 | 2.28 | 4.51 | 272.30 | 0.84 | 0.56 |
ImageNet 512×512 基准测试
DiT-MoE 在 512×512 分辨率下展示了 promising 的性能,与密集网络相比具有竞争力。
16.5B 参数扩展结果
| 配置 | 总参数 | 激活参数 | FID-50K (512×512) |
|---|---|---|---|
| G/2-16E2A | 16.5B | 3.1B | 1.80 (SOTA) |
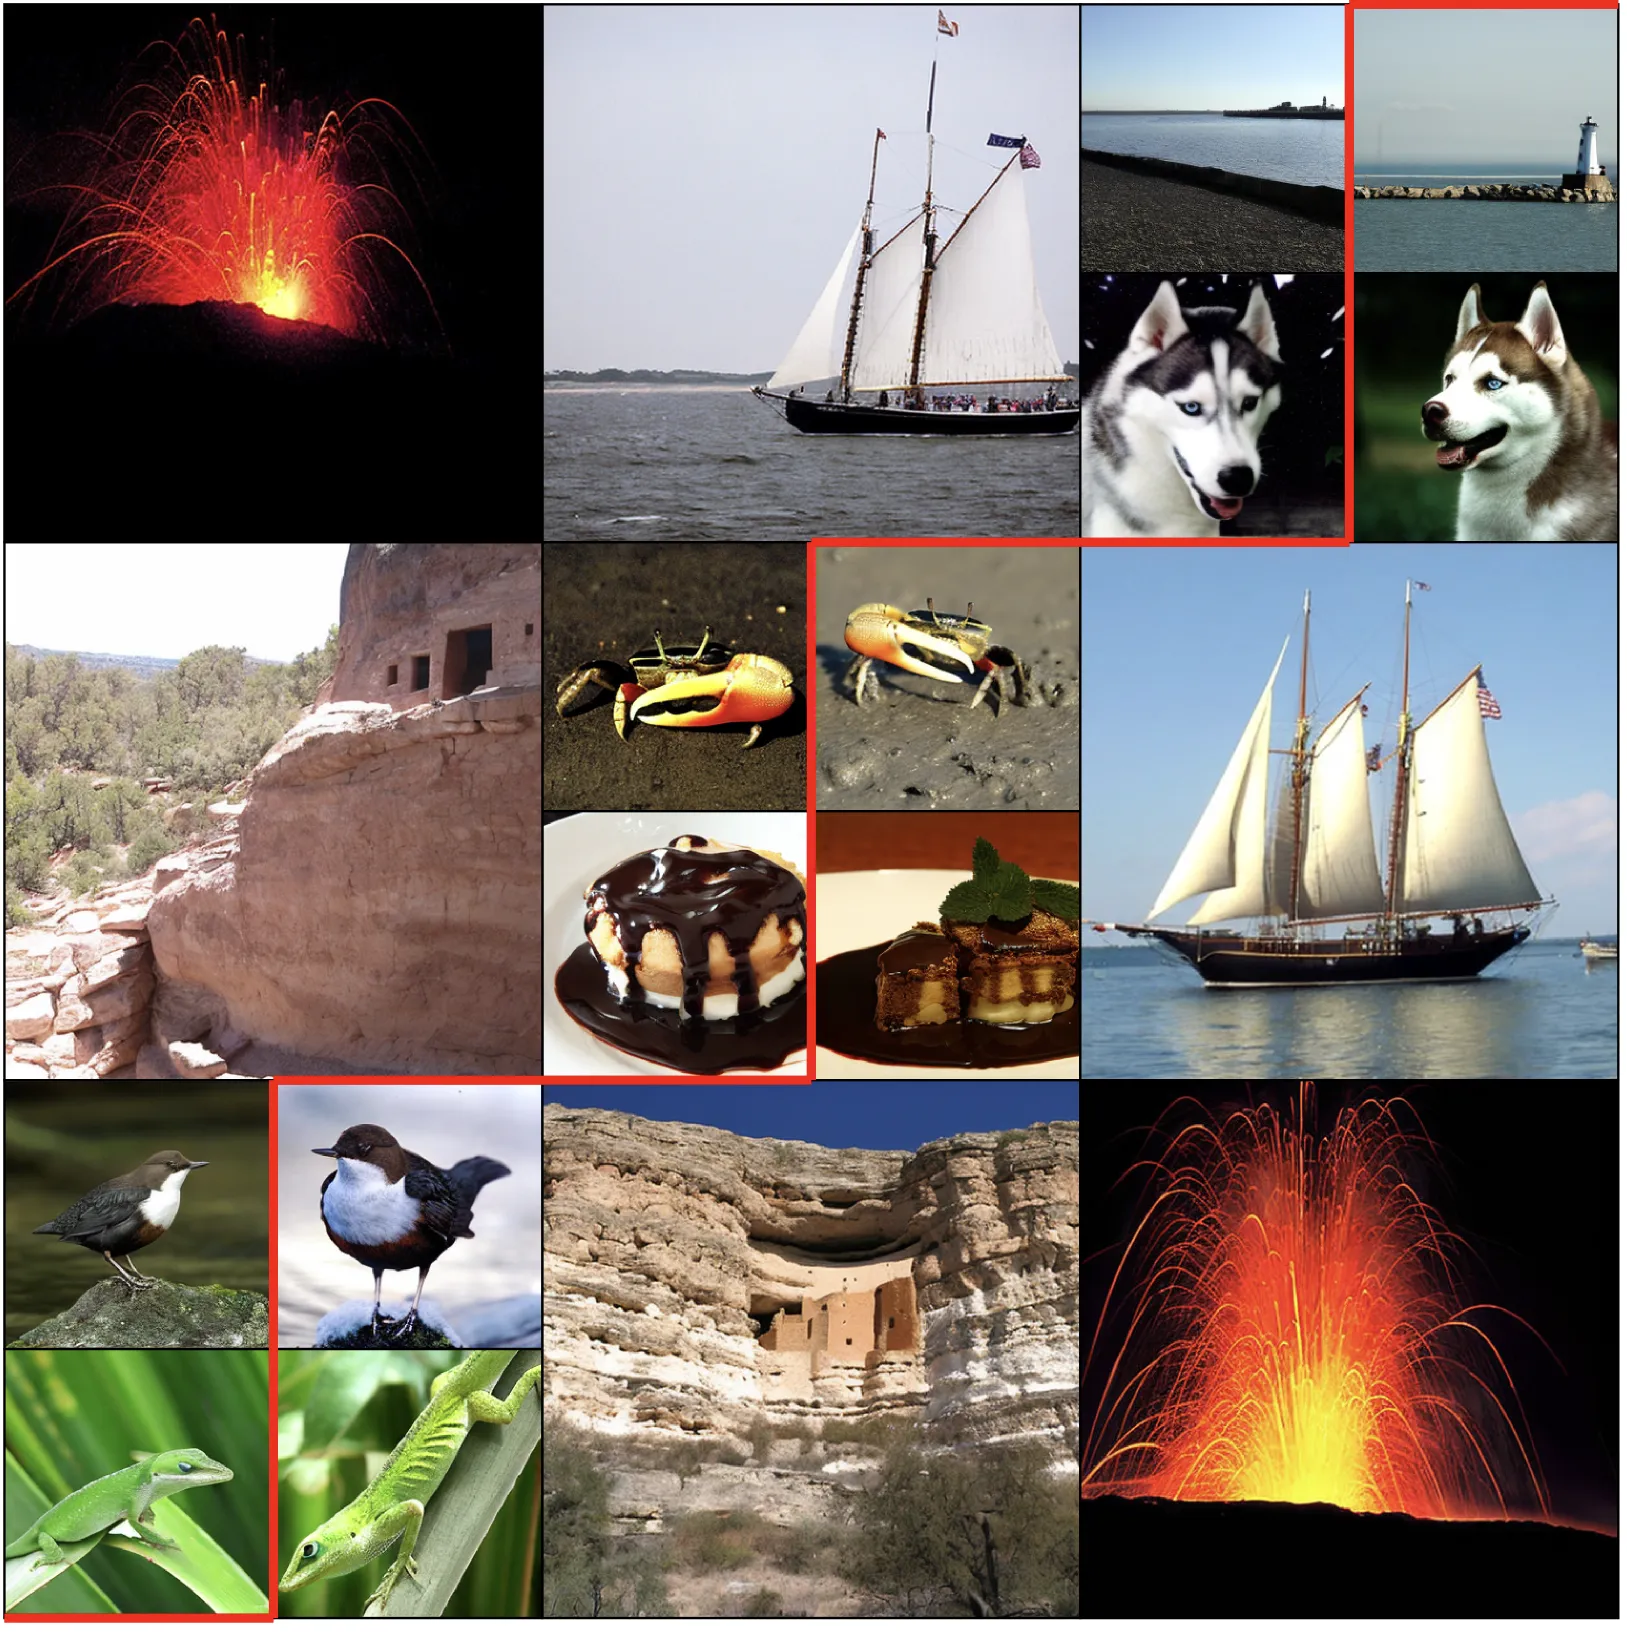
Figure 1: DiT-MoE 生成的样本。左: XL/2-8E2A 在 512×512 分辨率。右: G/2-16E2A 在 256×256 分辨率。
六、与现有方法对比
| 方面 | 密集 DiT | 传统 MoE | DiT-MoE |
|---|---|---|---|
| 参数效率 | 所有参数激活 | 部分激活 | 稀疏激活 (3.1B/16.5B) |
| 负载均衡 | - | 需要辅助损失 | 专家级平衡损失 |
| 知识共享 | 无 | 无 | 共享专家路由 |
| 最大参数 | ~8B | ~8B | 16.5B |
| FID (512×512) | ~2.3 | ~2.5 | 1.80 |
| 推理成本 | 高 | 中等 | 低 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| DiT (Peebles & Xie, 2023) | 基础架构,DiT-MoE 在其上构建 |
| Stable Diffusion 3 | 密集基线,8B 参数 |
| Switch Transformer | MoE 路由启发 |
| DeepSeekMoE | 共享专家策略参考 |
| GShard | 条件计算框架 |
八、总结
核心贡献
- MoE 扩展扩散 Transformer: 首个将 MoE 应用于 DiT 的工作,实现 16.5B 参数扩展
- 共享专家路由: 捕获通用知识,减少专家间冗余
- 专家级平衡损失: 有效解决负载不平衡问题
- 专家特化分析: 揭示专家选择与空间位置、时间步的关系
- SOTA 性能: ImageNet 512×512 FID 1.80,新 SOTA
技术影响
- 扩散模型扩展: 为 DiT 提供高效的扩展方法
- MoE 应用: 证明 MoE 在扩散模型中的有效性
- 推理效率: 16.5B 参数仅激活 3.1B,大幅降低推理成本
- 合成数据: 验证合成数据辅助训练的有效性
局限性
- 仅在 ImageNet 类条件生成上验证
- 未探索文本到图像生成
- 合成数据依赖外部模型 (SDXL, SD3)
- 未与最新模型 (如 FLUX, SD3.5) 比较
九、参考资源
- 论文: arXiv:2407.11633
- 代码: GitHub
- 主题: cs.CV
- 页数: 约 20 页
十、关键公式速查
| 公式 | 说明 |
|---|---|
| 前向扩散过程 | |
| 条件扩散目标 | |
| MoE 层定义 | |
| 专家级平衡损失 |
十一、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | DiT-MoE 生成样本 | x1.png |
| Figure 2 | DiT-MoE 架构概览 | x2.png |
| Figure 3 | 消融实验 | ablation.png |
| Figure 4 | 训练损失曲线 | x3.png |
| Figure 5 | 类别-专家频率热图 | class.png |
| Figure 6 | 空间位置-专家频率热图 | patch.png |
| Figure 7 | 时间步-专家频率热图 | step.png |