FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
利用异步性和低精度实现快速准确的注意力机制
FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision |
| 作者 | Jay Shah, Ganesh Bikshandi, Ying Zhang, Vijay Thakkar, Pradeep Ramani, Tri Dao |
| 机构 | Colfax International, Princeton |
| 论文 | arXiv:2407.08608 |
| 代码 | GitHub |
| 发布 | 2024年7月11日 (v1), 2024年7月12日 (v2) |
| 主题 | cs.LG, cs.AR |
二、核心思想
问题定义
注意力机制作为 Transformer 的核心层,是大语言模型和长上下文应用的瓶颈。FlashAttention 通过最小化内存读写来加速注意力,但尚未充分利用新硬件的特性。FlashAttention-2 在 H100 GPU 上仅达到 35% 的利用率(vs GEMM 的 80-90%)。
核心观察
- 异步性: Hopper GPU 的 Tensor Core 和 TMA 可异步执行,允许重叠计算和数据移动
- 低精度: FP8 提供 2× 吞吐量,但需要小心处理量化误差(特别是异常值特征)
- 非 GEMM 瓶颈: 指数函数吞吐量比 GEMM 低 256×,但 softmax 可占 50% 的周期
解决方案概述
FlashAttention-3 提出三种技术加速 Hopper GPU 上的注意力:
- 生产者-消费者异步: Warp 特化软件流水线,利用 TMA 和 Tensor Core 的异步执行
- GEMM-Softmax 重叠: 将 softmax 操作隐藏在异步 WGMMA 指令下
- FP8 低精度: 块量化 + 不相干处理,利用 FP8 Tensor Core
核心性能
| 指标 | 数值 |
|---|---|
| FP16 前向加速 | 1.5-2.0× vs FlashAttention-2 |
| FP16 后向加速 | 1.5-1.75× vs FlashAttention-2 |
| FP16 峰值性能 | 740 TFLOPs/s (75% 利用率) |
| FP8 峰值性能 | ~1.2 PFLOPs/s |
| FP8 精度 | 2.6× 低于标准 FP8 注意力的数值误差 |
三、技术架构
核心洞察
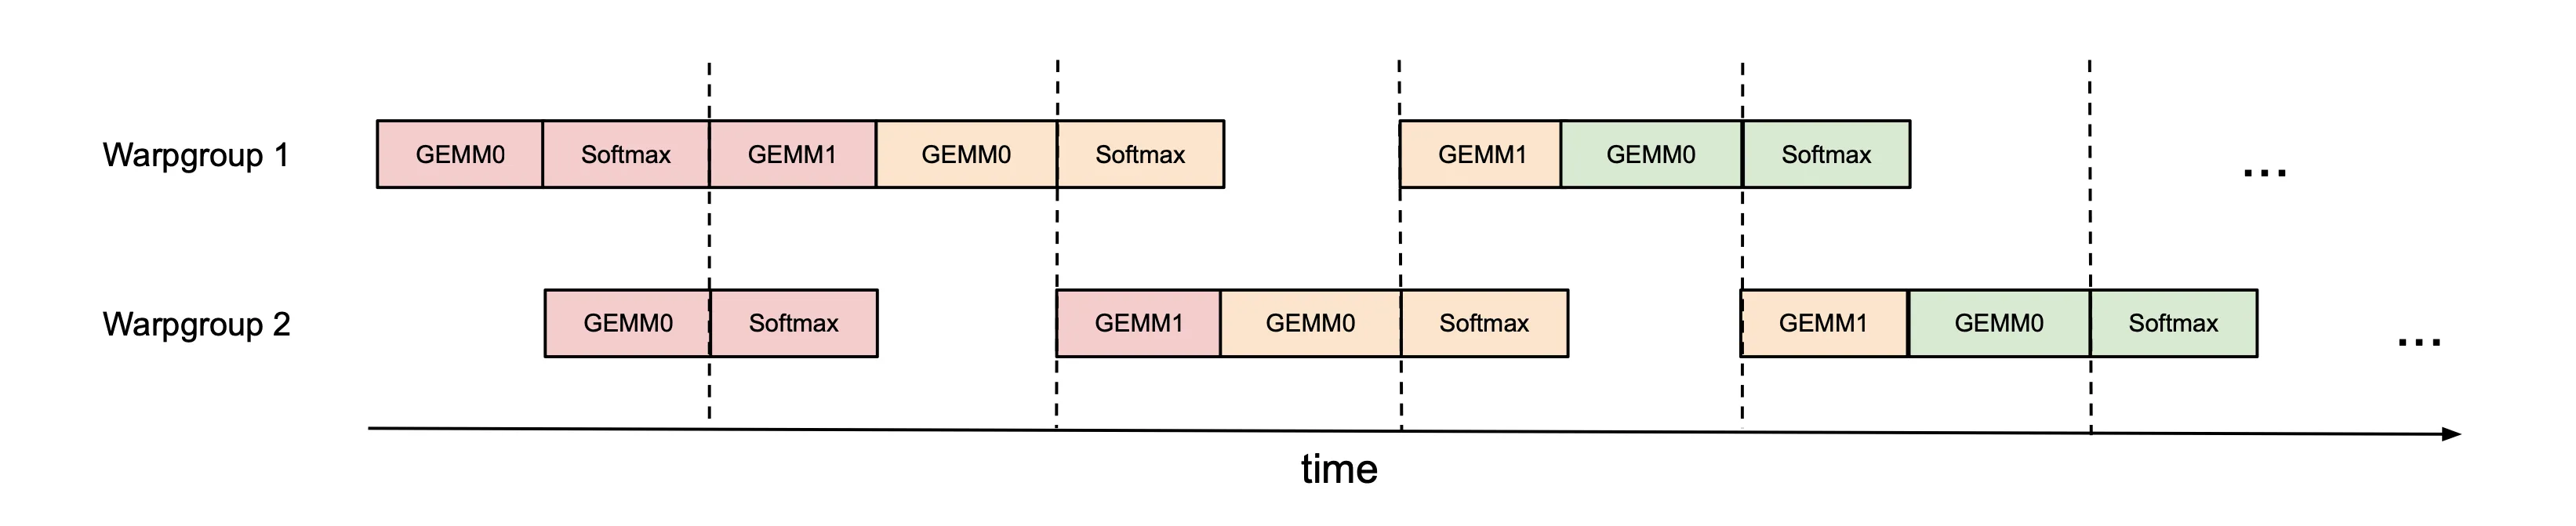
Figure 1: Pingpong 调度:2 个 warpgroup 重叠 softmax 和 GEMM。一个 warpgroup 的 softmax 应在另一个 warpgroup 运行 GEMM 时调度。相同颜色表示相同迭代。
关键问题: H100 有 989 TFLOPS FP16 GEMM 但仅 3.9 TFLOPS 特殊函数(如指数)。对于 head dimension 128 的 FP16 前向:
- GEMM FLOPS 比指数操作多 512×
- 但指数吞吐量低 256×
- 所以指数可占 GEMM 50% 的周期
- FP8 时更糟:GEMM 吞吐翻倍,指数不变
核心公式
多头注意力
给定查询 , 键 , 值 :
其中 ,softmax 逐行应用。
反向传播
三大核心技术
1. 生产者-消费者异步 (Warp 特化)
Warp 特化:
- CTA 中的 warps 分为生产者和消费者角色
- 生产者仅发出数据移动(TMA)
- 消费者仅执行计算(WGMMA)
- 通过
setmaxnreg动态重分配寄存器
Pingpong 调度:
- 使用
bar.sync强制 warpgroup 1 的 GEMMs 在 warpgroup 2 之前调度 - 结果:warpgroup 1 的 softmax 在 warpgroup 2 执行 GEMMs 时调度
- 然后角色互换
- 性能提升:570 TFLOPS → 620-640 TFLOPS
2. GEMM-Softmax 流水线
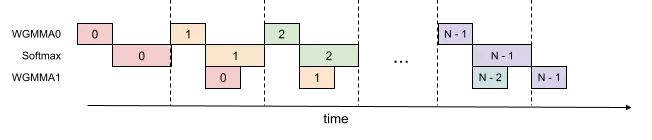
Figure 2: 2 阶段 WGMMA-softmax 流水线。
核心思想: 打破 softmax 和 GEMMs 之间的顺序依赖,通过跨迭代流水线化。
Algorithm 2 (消费者 warpgroup 前向):
- 初始化 ,
- 计算 (WGMMA)
- 主循环 (lines 8-16):
- 计算 (WGMMA, commit 但不 wait)
- 计算 (WGMMA, commit 但不 wait)
- Wait WGMMA, 计算
- Wait WGMMA, rescale
关键: 第二个 WGMMA () 与下一次迭代的 softmax () 重叠。
寄存器压力: 需要额外寄存器存储 ,大小 。
3 阶段流水线: 进一步重叠第二个 WGMMA 与 softmax,但需要更多寄存器。
3. FP8 低精度
布局挑战:
- FP8 WGMMA 仅支持 k-major 格式
- 但 通常在 head dimension 上连续
- 解决方案:内核内转置(使用 LDSM/STSM 指令)
寄存器布局差异:
- FP32 累加器布局(Figure 3)与 FP8 操作数 A 布局(Figure 4)不同
- 使用字节置换指令转换:
精度优化:
- 块量化: 每个块保持一个标量(而非每张量),自然融合到 FlashAttention 的块操作中
- 不相干处理: 将 和 乘以随机正交矩阵 再量化到 FP8
- ,所以
- 每个条目是原始条目的随机和,“分散”异常值
- 选择 为随机 对角矩阵和 Hadamard 矩阵的乘积
- 计算复杂度 ,可融合到 rotary embedding
GPU 硬件特性
内存层次
| 硬件级别 | 并行代理 | 数据位置 | 容量 @ 带宽 |
|---|---|---|---|
| Chip | Grid | GMEM | 80 GiB @ 3.35 TB/s |
| GPC | Threadblock Clusters | L2 | 50 MiB @ 12 TB/s |
| SM | Threadblock (CTA) | SMEM | 228 KiB per SM, 31 TB/s per GPU |
| Thread | Thread | RMEM | 256 KiB per SM |
线程层次
- Threads → Warps (32 threads) → Warpgroups (4 warps) → Threadblocks (CTAs) → Clusters → Grids
Hopper 异步特性
- TMA: 专用硬件单元,GMEM↔SMEM 异步拷贝
- WGMMA: Warpgroup 级异步 GEMM,可直接从 SMEM 源操作数
- setmaxnreg: 动态重分配 warpgroup 间寄存器
算法伪代码
Algorithm 1 (无重叠的前向):
Producer warpgroup:
  Load Q_i from HBM to SMEM
  For j = 0 to T_c - 1:
    Wait buffer stage consumed
    Load K_j, V_j from HBM to SMEM
    Commit notification

Consumer warpgroup:
  Initialize O_i = 0, l_i = 0, m_i = -inf
  Wait Q_i loaded
  For j = 0 to T_c - 1:
    Wait K_j loaded
    S_i(j) = Q_i K_j^T (SS-GEMM)
    m_i = max(m_i, rowmax(S_i(j)))
    P~_i(j) = exp(S_i(j) - m_i)
    l_i = exp(m_i_old - m_i) l_i + rowsum(P~_i(j))
    Wait V_j loaded
    O_i = diag(exp(m_i_old - m_i))^{-1} O_i + P~_i(j) V_j (RS-GEMM)
    Release buffer stage
  O_i = diag(l_i)^{-1} O_i, L_i = m_i + log(l_i)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Warp 特化 | 生产者/消费者分离,利用 TMA/WGMMA 异步性 | 570→620 TFLOPS |
| Pingpong 调度 | 跨 warpgroup 重叠 softmax 与 GEMM | 隐藏指数操作延迟 |
| 2/3 阶段流水线 | 跨迭代重叠 GEMM 与 softmax | 570→661 TFLOPS |
| FP8 块量化 | 每块一个标量,自然融合 | 2.6× 精度提升 |
| 不相干处理 | 随机正交矩阵分散异常值 | 2.6× 精度提升 |
| 内核内转置 | 使用 LDSM/STSM 指令转置 V | 避免额外预处理内核 |
五、实验结果
测试配置
| 配置 | 值 |
|---|---|
| GPU | NVIDIA H100 SXM5 80GB |
| 实现 | CUTLASS 原语 (WGMMA, TMA) |
| 序列长度 | 512, 1k, …, 16k |
| 总 token 数 | 16k |
| Hidden dimension | 2048 |
| Head dimension | 64, 128, 256 |
性能基准
FP16 前向加速
| 配置 | FA-3 vs FA-2 | FA-3 vs 标准注意力 |
|---|---|---|
| Head dim 64 | 1.5-1.8× | 3-10× |
| Head dim 128 | 1.5-2.0× | 3-12× |
| Head dim 256 | 1.5-1.9× | 5-16× |
关键发现:
- 中长序列 (1k+) 时 FA-3 超越 cuDNN 优化实现
- 达到 740 TFLOPS/s (75% 利用率)
- 后向加速 1.5-1.75×
FP8 前向
- 达到接近 1.2 PFLOPS/s
- Head dim 256 时性能对比见 Figure 7
消融实验
| 配置 | 时间 | TFLOPS/s |
|---|---|---|
| FlashAttention-3 | 3.538 ms | 661 |
| 无 GEMM-Softmax 流水线, 有 Warp 特化 | 4.021 ms | 582 |
| 有 GEMM-Softmax 流水线, 无 Warp 特化 | 4.105 ms | 570 |
关键发现: 两种技术都重要,组合效果最佳。
数值精度
| 方法 | RMSE |
|---|---|
| FP16 | |
| Baseline FP16 | 3.2e-4 |
| FlashAttention-2 FP16 | 1.9e-4 |
| FlashAttention-3 FP16 | 1.9e-4 |
| FP8 | |
| Baseline FP8 (per-tensor) | 2.4e-2 |
| FlashAttention-3 FP8 | 9.1e-3 |
| 无块量化 | 9.3e-3 |
| 无不相干处理 | 2.4e-2 |
关键发现:
- FP16: FA-3 与 FA-2 数值误差相同,比标准实现低 1.7×(因 softmax 保持 FP32)
- FP8: FA-3 比基线 FP8 低 2.6× 数值误差
测试数据分布
模拟 LLM 异常值特征:
即每个条目服从零均值、标准差 1 的正态分布,但 0.1% 的条目加上标准差 10 的独立项。
六、关键算法细节
Warp 特化实现
- 使用
setmaxnreg进行寄存器 (de)allocations - TMA 加载 和
- WGMMA 执行消费者主循环中的 GEMMs
- SS 前缀表示第一个操作数来自 SMEM,RS 表示来自 RMEM
FP8 布局转换
问题: FP32 累加器和 FP8 操作数 A 的寄存器布局不同
解决方案: 字节置换指令,将序列改为 ,每 8 字节复制
V 的内核内转置:
- 使用 LDSM/STSM 指令(128 字节粒度)
- 生产者 warpgroup 执行
- 可在前一个 块和当前 块的两个 WGMMA 阴影中执行
不相干处理
选择 为:
其中 为随机 对角矩阵, 为 Hadamard 矩阵。
计算复杂度 ,可融合到 rotary embedding。
七、与 FlashAttention-2 的对比
| 方面 | FlashAttention-2 | FlashAttention-3 |
|---|---|---|
| 目标硬件 | Ampere | Hopper |
| 异步利用 | 有限 | 充分 (TMA, WGMMA) |
| Warp 特化 | 无 | 生产者/消费者分离 |
| GEMM-Softmax 重叠 | 无 | 2/3 阶段流水线 |
| FP8 支持 | 无 | 块量化 + 不相干处理 |
| H100 利用率 | 35% | 75% |
| FP16 前向 | 基准 | 1.5-2.0× |
| FP8 | N/A | ~1.2 PFLOPS |
八、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| FlashAttention | 前身,引入 tiling 策略 |
| FlashAttention-2 | 直接前作,FA-3 的基准 |
| ThunkerKitten | Hopper 特定指令简化实现 |
| cuDNN 9 | 厂商优化实现,FA-3 在长序列上超越 |
| CUTLASS | 提供 WGMMA 和 TMA 抽象 |
| QuIP | 不相干处理的灵感来源 |
九、总结
核心贡献
- 生产者-消费者异步: Warp 特化软件流水线,利用 Hopper 异步执行
- GEMM-Softmax 重叠: 将 softmax 隐藏在异步 WGMMA 下
- FP8 注意力: 块量化 + 不相干处理,1.2 PFLOPS 且精度高
- 75% H100 利用率: 从 35% 提升到 75%
- 开源: 宽松许可证,集成 PyTorch 和 Hugging Face
技术影响
- 异步编程范式: Warp 特化成为 GPU 高性能计算的标准技术
- 低精度注意力: FP8 注意力可行且准确
- 长上下文加速: 1.5-2.0× 加速解锁更长上下文应用
- 硬件-算法协同设计: 充分利用 Hopper 特性
局限性
- 仅针对 Hopper GPU,需适配其他架构
- FP8 内核未集成持久内核设计
- 未研究低精度注意力在大规模训练中的效果
- 3 阶段流水线寄存器压力大,需权衡 tile 大小
十、参考资源
- 论文: arXiv:2407.08608
- 代码: GitHub - flash-attention
- 主题: cs.LG, cs.AR
- 页数: 约 20 页, 9 图