survey mixture-of-experts llm sparse-activation conditional-computation gating-function load-balancing distributed-training
A Survey on Mixture of Experts in Large Language Models
MoE 在大语言模型中的全面综述,涵盖门控函数、专家网络、训练推理方案、系统设计和应用
A Survey on Mixture of Experts in Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | A Survey on Mixture of Experts in Large Language Models |
| 作者 | Weilin Cai*, Juyong Jiang*, Fan Wang*, Jing Tang†, Sunghun Kim†, Jiayi Huang† |
| 机构 | The Hong Kong University of Science and Technology (Guangzhou) |
| 论文 | arXiv:2407.06204 |
| 代码 | GitHub |
| 发布 | 2024-06-26 (v1), 2025-04-09 (v3) |
| 期刊 | IEEE Transactions on Knowledge and Data Engineering (TKDE) 2025 |
二、核心思想
问题定义
大语言模型(LLM)的性能与模型参数量密切相关,但全参数计算带来了巨大的计算开销。混合专家(Mixture of Experts, MoE)通过条件计算(Conditional Computation)实现以最小的计算增量大幅扩展模型容量:
- Dense MoE: 激活所有专家,计算开销与参数量线性增长
- Sparse MoE: 仅激活 top-k 专家,计算开销保持可控
解决方案概述
本文提出三层分类体系(Taxonomy):
- 算法设计: 门控函数、专家网络、超参数、训练推理方案
- 系统设计: 计算优化、通信优化、存储优化
- 应用领域: NLP、CV、推荐系统、多模态
三、技术架构
整体框架图
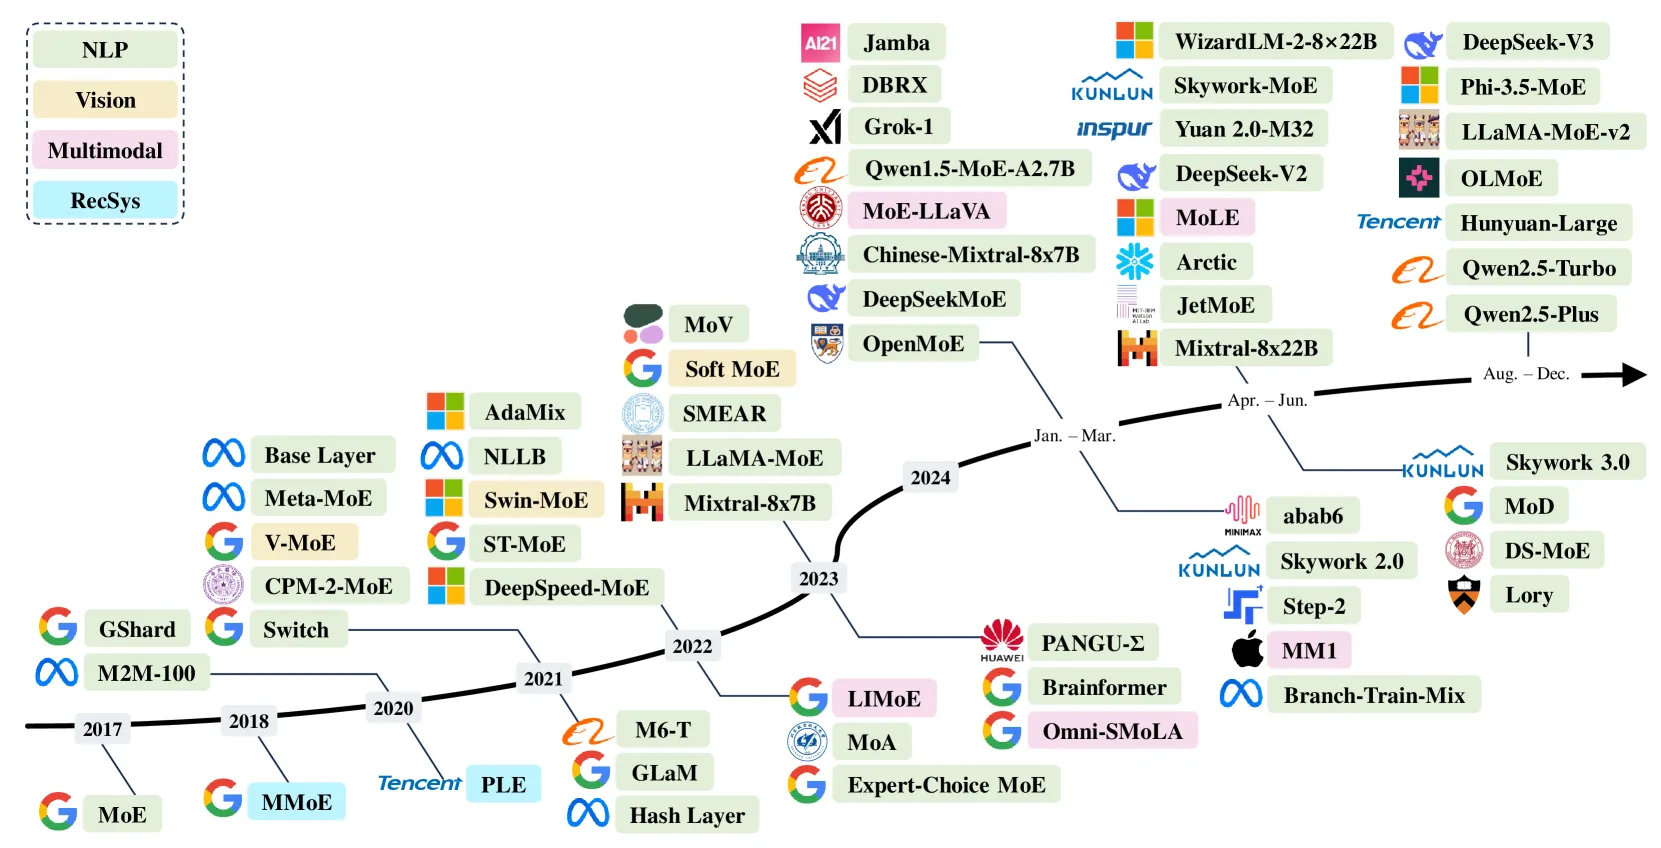
MoE 层基础结构
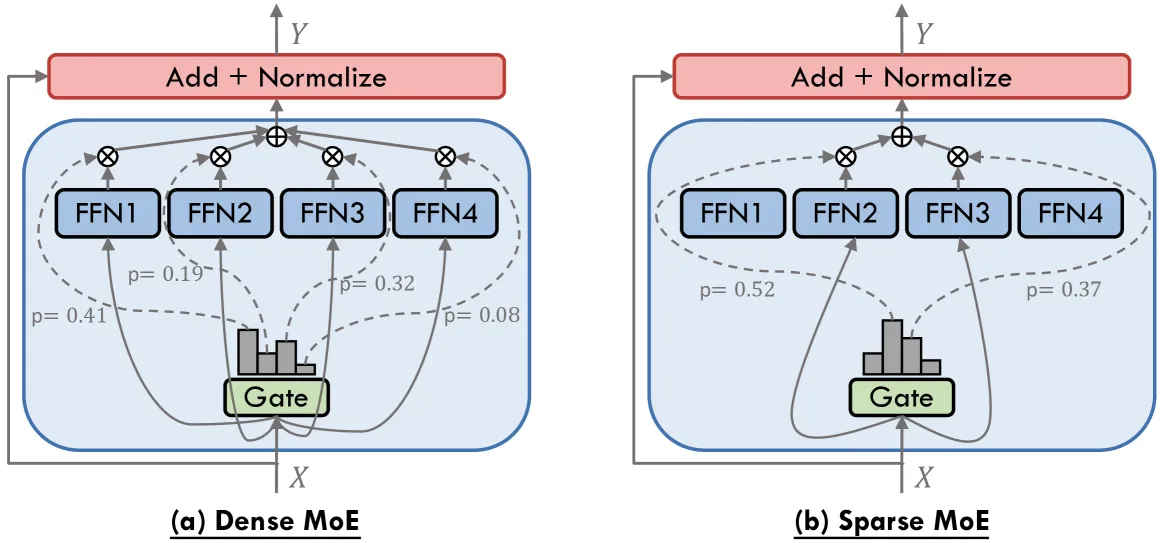
Dense MoE 公式:
Sparse MoE 公式:
负载均衡损失:
其中 是分配给专家 的 token 比例, 是门控概率分配给专家 的比例。
门控函数分类
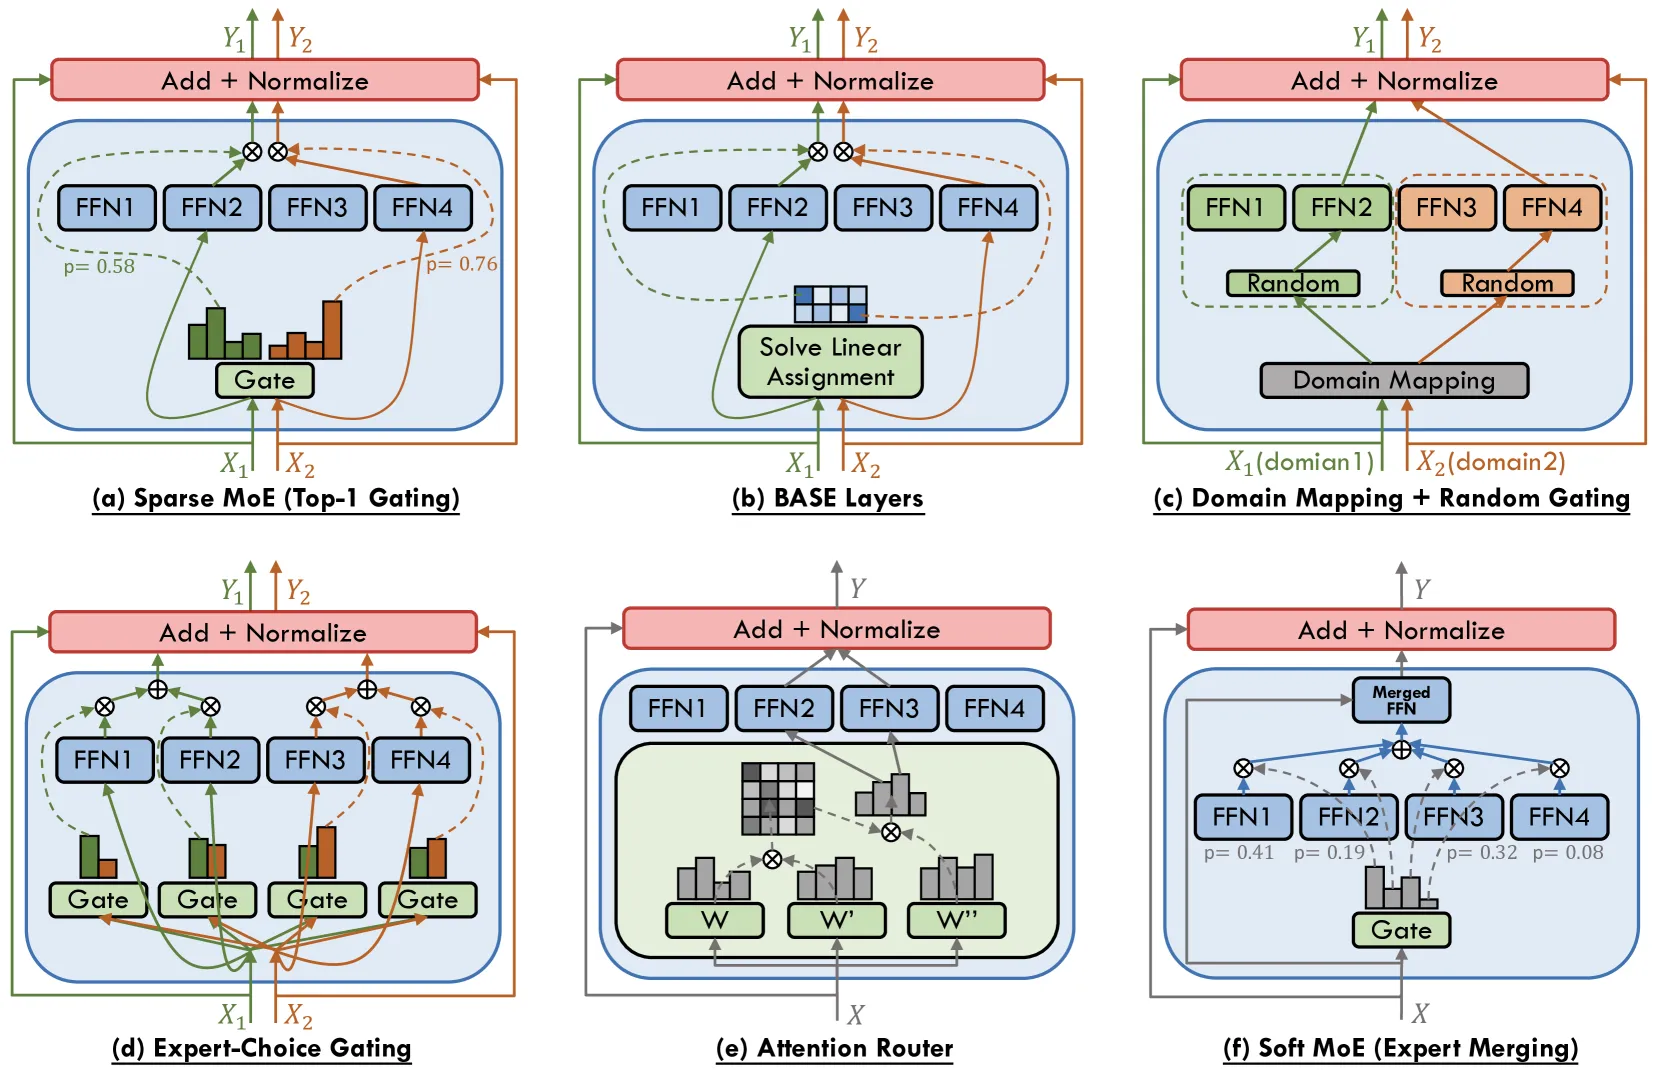
| 类型 | 代表方法 | 特点 |
|---|---|---|
| Token-Choice (Top-1) | Switch Transformer | 每个 token 选择 1 个专家 |
| Token-Choice (Top-k) | GShard, Mixtral | 每个 token 选择 k 个专家 |
| BASE Layer | Lewis et al. | 线性分配问题,保证专家均衡 |
| Expert-Choice | Zhou et al. | 专家选择 token,天然均衡 |
| Attention Router | Yuan 2.0 | 使用注意力机制作为路由器 |
| Soft MoE | Fedus et al. | token/专家合并,完全可微 |
MoPE 在 Transformer 中的位置
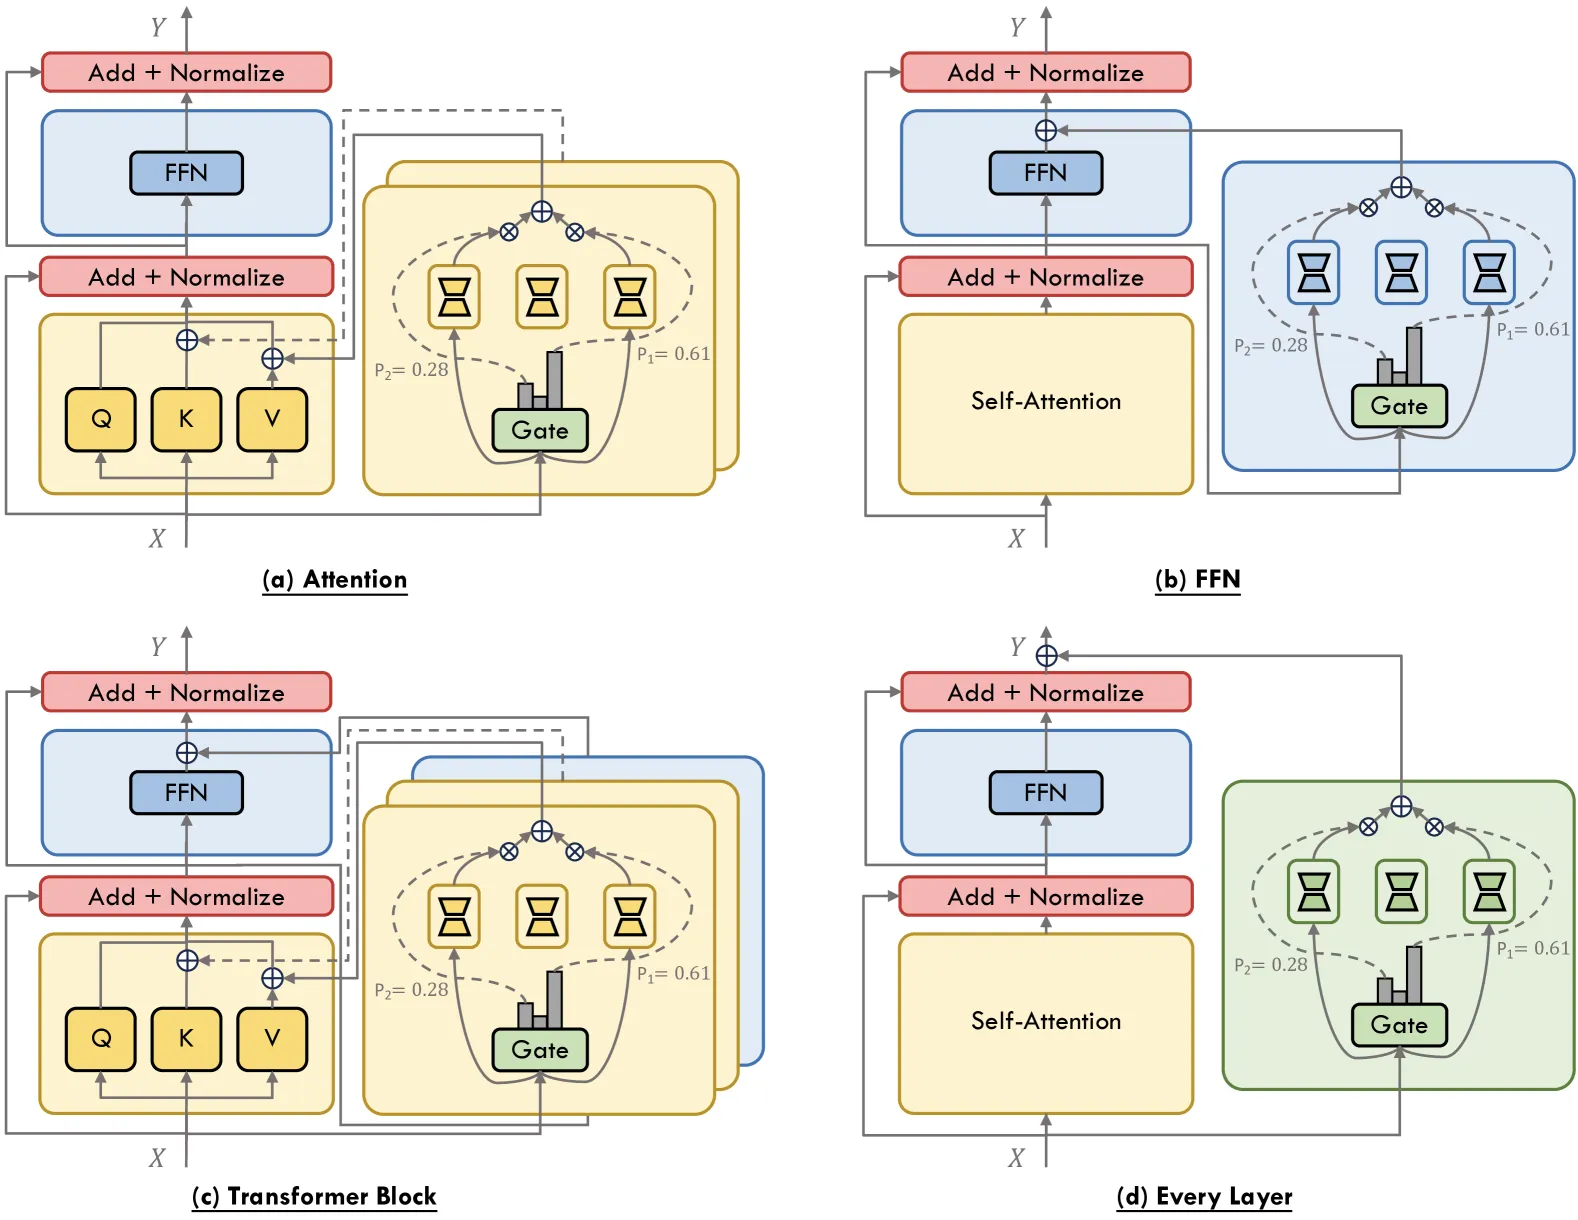
| 位置 | 说明 | 代表工作 |
|---|---|---|
| Attention (K/V) | 替换注意力中的 Key/Value 投影 | MoA, JetMoE |
| FFN | 替换前馈网络层 | GShard, Switch Transformer |
| Transformer Block | 注意力和 FFN 各自使用独立专家组 | DS-MoE |
| Layer-wise | 整个 Transformer 层作为专家 | Lory, MoV |
训练与推理方案
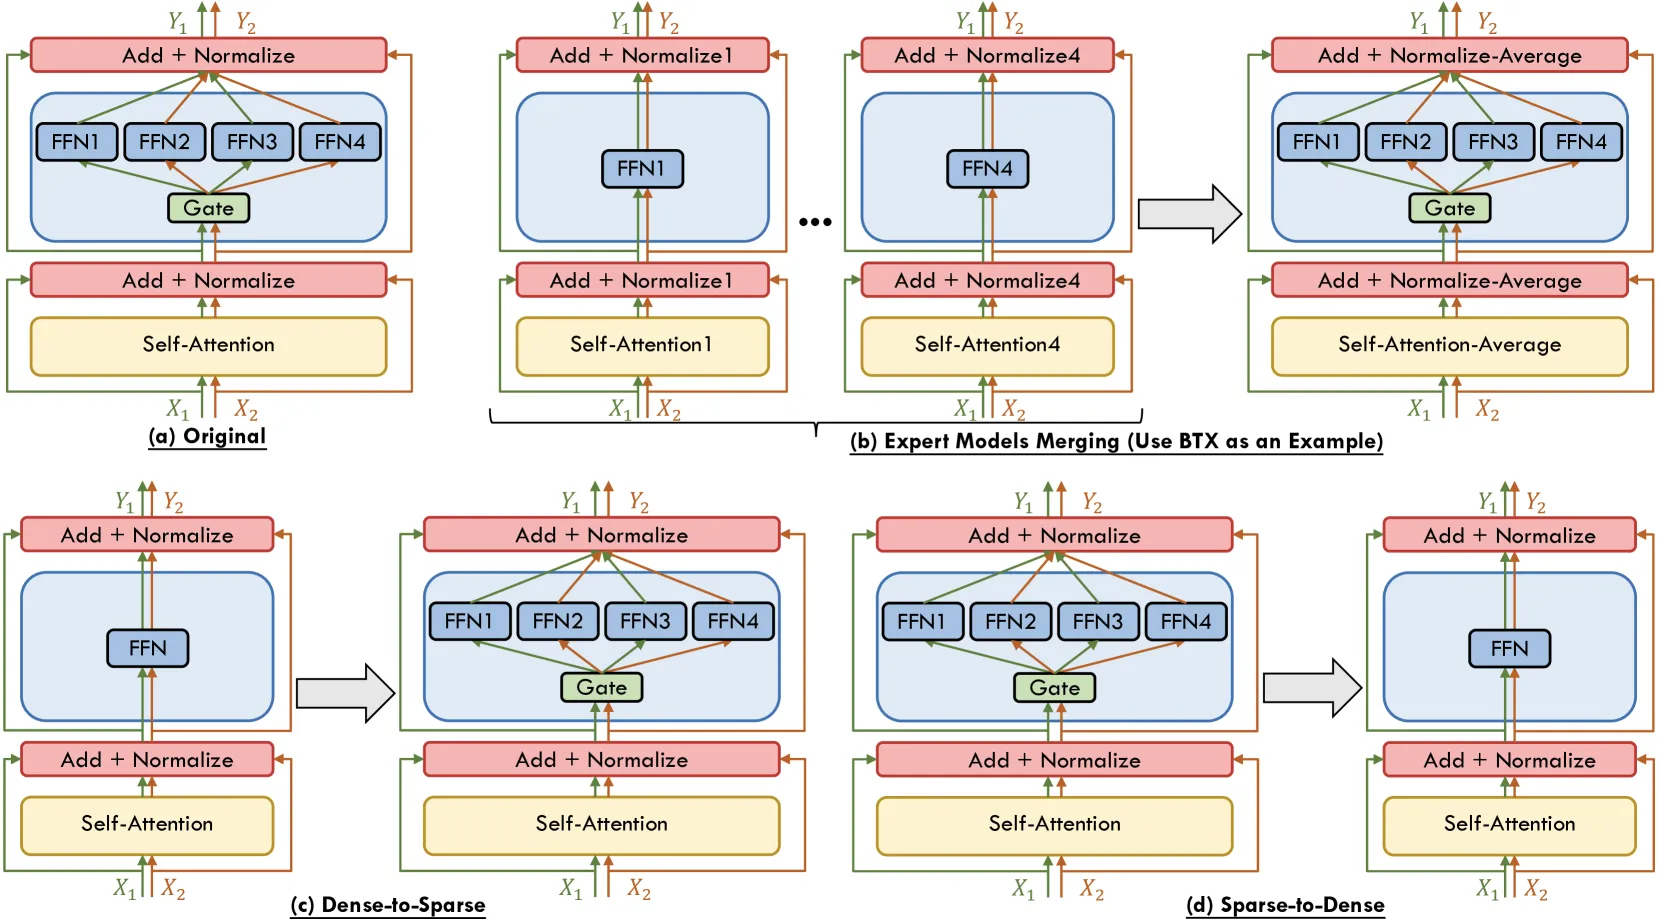
| 方案 | 说明 | 代表工作 |
|---|---|---|
| Dense2Sparse | 从密集模型转换为稀疏模型 | Sparse Upcycling, MoEfication |
| Sparse2Dense | 从稀疏模型转换为密集模型 | OneS, MoE-Pruning |
| Expert Merging | 合并多个专家模型 | Branch-Train-MiX, FoE |
并行策略
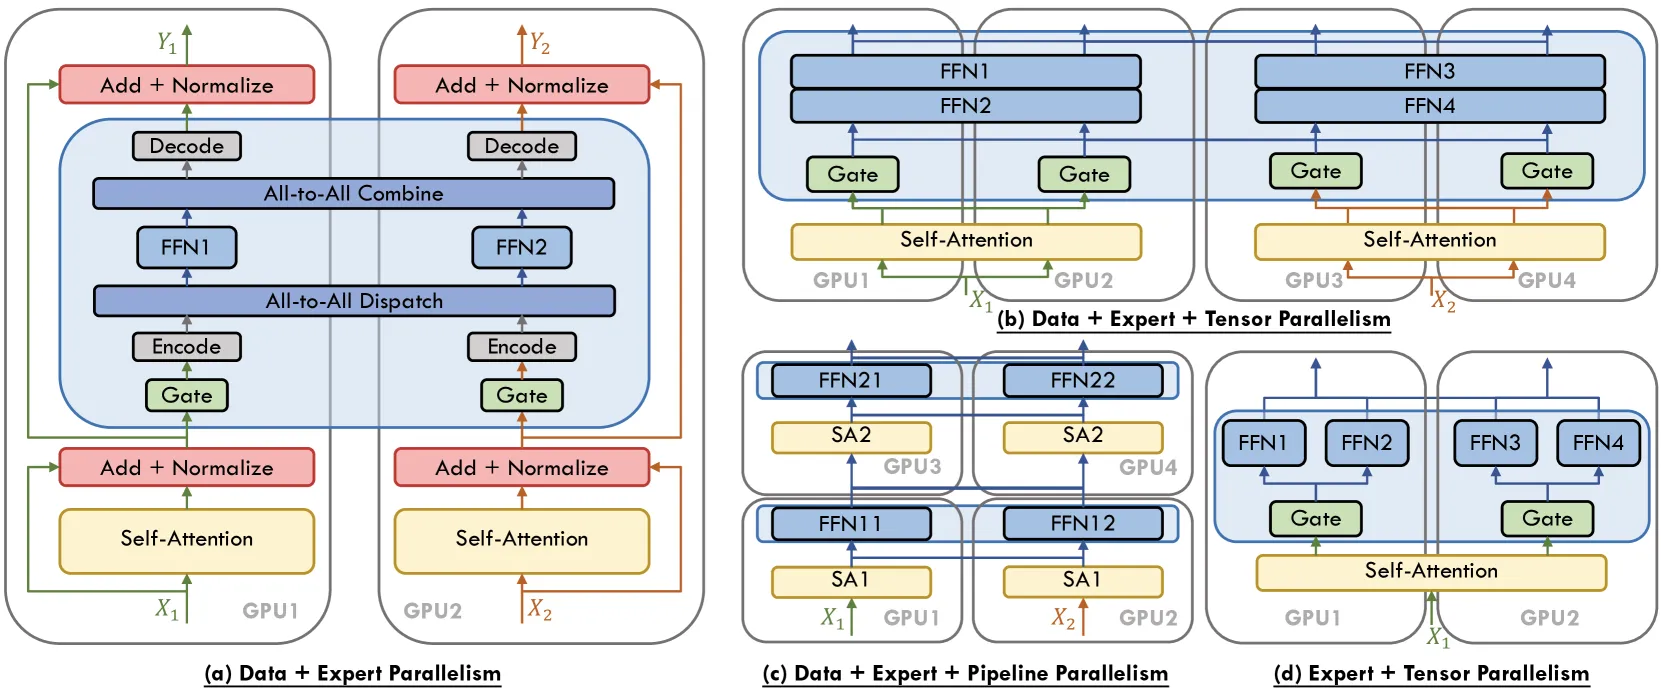
| 策略 | 说明 | 代表系统 |
|---|---|---|
| 数据并行 | 不同 GPU 处理不同数据 | DeepSpeed-MoE |
| 专家并行 | 不同 GPU 存储不同专家 | Tutel, FasterMoE |
| 管道并行 | 不同 GPU 处理不同层 | Megatron-LM |
| 序列并行 | 不同 GPU 处理序列不同部分 | SE-MoE |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 三层分类体系 | 算法-系统-应用三维分类 | 覆盖 100+ 篇文献 |
| 门控函数统一视角 | 将稀疏/稠密/软门控统一分析 | 对比不同门控的优劣 |
| 负载均衡损失对比 | 系统对比 L_aux, L_importance, L_z, L_MI | Table I 汇总 |
| MoPE 位置分类 | 将专家参数高效微调分为 4 个层级 | 图 6 展示 |
| 系统优化全景 | 计算/通信/存储三维度系统优化 | 覆盖 FastMoE 等 20+ 系统 |
五、代码实现分析
本论文为综述性质,不包含具体代码实现。但维护了一个 GitHub 仓库持续更新 MoE 相关资源:
GitHub 仓库结构:
- 按年份组织的论文列表
- 开源模型实现链接
- 超参数配置汇总
- 实验评估结果
六、实验结果
代表性 MoE 模型性能对比
| 模型 | 活跃参数 | 总参数 | 专家数 | 关键性能 |
|---|---|---|---|---|
| Mixtral-8x7B | 13B | 46.7B | 8 | 等效 Llama-2-70B |
| DeepSeekMoE 16B | 16B | 64B | 64 | 等效 Llama-2-7B,计算减少 40% |
| Qwen1.5-MoE | 2.7B | 14.3B | 60 | 等效 Mistral-7B |
| DeepSeek-V2 | 21B | 236B | 160 | MLA + DeepSeekMoE |
门控函数效果对比
| 门控类型 | 均衡性 | 性能 | 训练稳定性 |
|---|---|---|---|
| Top-1 (Switch) | 中 | 高 | 高 |
| Top-k (GShard) | 中 | 高 | 高 |
| BASE Layer | 高 | 中 | 中 |
| Expert-Choice | 高 | 中 | 中 |
| Soft MoE | 高 | 中 | 高 |
辅助损失函数对比
| 损失函数 | 公式 | 系数 | 代表工作 |
|---|---|---|---|
| L_importance + L_load | CV(Importance)^2 + smooth load | 0.1, 0.1 | Shazeer et al., V-MoE |
| L_aux | dot-product approximation | 0.01 | GShard, Switch-T, Mixtral |
| L_aux + L_z | L_aux + log-sum-exp penalty | 0.01, 0.001 | ST-MoE, OpenMoE |
| L_MI | mutual information | 0.001 | Mod-Squad, DS-MoE |
七、相关工作
综述对比
| 综述 | 发布时间 | 覆盖范围 | 局限性 |
|---|---|---|---|
| 本Survey | 2024/2025 | 算法+系统+应用 | - |
| Previous Survey 1 | 2012 | Dense MoE | 未覆盖 Sparse MoE |
| Previous Survey 2 | 2022 | 基础 MoE | 未覆盖 LLM 时代进展 |
关键里程碑模型
| 年份 | 模型 | 关键创新 |
|---|---|---|
| 2017 | GShard | 首个大规模 MoE,提出 L_aux |
| 2021 | Switch Transformer | Top-1 gating,简化 MoE |
| 2023 | Mixtral-8x7B | 开源 MoE,等效 70B 性能 |
| 2024 | DeepSeek-V2 | MLA + DeepSeekMoE,236B 总参数 |
| 2024 | DBRX | 细粒度专家,16 个专家 |
八、总结
核心贡献
- 全面分类体系: 提出算法-系统-应用三层分类,覆盖 MoE 在 LLM 中的全貌
- 门控函数统一分析: 将稀疏/稠密/软门控统一到一个框架下对比
- 系统优化全景: 首次系统性综述 MoE 的计算/通信/存储优化
- 持续更新仓库: 建立 GitHub 仓库跟踪 MoE 最新进展
技术影响
- MoE 已成为 LLM 扩展的主流范式: Mixtral、DeepSeek-V2、DBRX 等模型证明 MoE 可以用更少计算达到更大模型性能
- 门控函数趋于成熟: GShard 的 L_aux 仍是工业界主流选择
- 系统优化是关键瓶颈: 专家并行的通信开销是主要挑战
- MoPE 为参数高效微调提供新范式: 将 MoE 思想应用于 PEFT
局限性
- 时间限制: 综述基于 2024 年中工作,可能不包含最新进展
- 评估不统一: 各 MoE 模型的评估基准和指标不一致
- 系统实验有限: 缺乏统一平台下的系统性能对比
- 应用深度不足: 对 CV、推荐系统等领域的 MoE 应用分析较浅
九、参考资源
- 论文链接: arXiv:2407.06204
- PDF 下载: arXiv PDF
- GitHub 仓库: withinmiaov/A-Survey-on-Mixture-of-Experts-in-LLMs
- DOI: 10.1109/TKDE.2025.3554028
- 期刊: IEEE Transactions on Knowledge and Data Engineering (TKDE) 2025