Lazarus: Resilient and Elastic Training of Mixture-of-Experts Models
Lazarus 是首个面向 MoE 模型的弹性容错训练系统,通过自适应专家副本分配和可证明最优的专家放置算法,在频繁节点故障下实现高达 5.7x 的性能提升
Lazarus: Resilient and Elastic Training of Mixture-of-Experts Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Lazarus: Resilient and Elastic Training of Mixture-of-Experts Models |
| 作者 | Yongji Wu*, Wenjie Qu*, Xueshen Liu*, Tianyang Tao, Yifan Qiao, Zhuang Wang, Wei Bai, Yuan Tian, Jiaheng Zhang, Z. Morley Mao, Matthew Lentz, Danyang Zhuo, Ion Stoica (*共同一作) |
| 机构 | UC Berkeley, NUS, UMich, AWS, NVIDIA, UCLA, Duke |
| 论文 | arXiv:2407.04656 |
| 代码 | 将开源 (论文中提及) |
| 发布 | 2024年7月5日 (v1), 2025年10月24日 (v2) |
| 领域 | cs.DC (分布式、并行与集群计算), cs.LG (机器学习) |
二、核心思想
问题定义
随着大语言模型 (LLM) 训练规模的不断扩大,稀疏激活的混合专家 (Mixture-of-Experts, MoE) 架构因其亚线性的计算成本扩展特性而被广泛采用。然而,频繁的故障在训练规模化过程中构成了重大挑战:
- 故障成本极高:即使单个故障也会导致所有 GPU 空闲等待,直到故障解决,可能丢失大量训练进度
- 故障频率上升:在 128K GPU 集群中,平均故障间隔时间 (MTTF) 仅约 14 分钟
- Spot 实例加剧问题:云提供商的抢占式实例虽然可节省高达 90% 的成本,但抢占频率可达每 5-10 分钟一次
现有的容错训练方案存在两个关键局限:
- 基于检查点的方案缺乏弹性,需要等待替换节点
- 基于流水线并行的弹性方案无法应用于 MoE 模型,因为 MoE 采用专家并行 (Expert Parallelism, EP) 策略
解决方案概述
Lazarus 提出了一种全新的方法来解决 MoE 模型的弹性容错训练问题。其核心洞察是:自适应调整每个专家的副本数量及其放置方式,可以在提高弹性的同时增强容错能力。
Lazarus 的三大关键设计:
- 自适应专家分配与放置:根据专家负载分布动态分配更多副本给热门专家,同时设计可证明最优的放置算法最大化故障恢复概率
- 灵活的 Token 调度器:在非对称专家放置下,高效地将 token 调度到拥有对应专家副本的 GPU,并平衡负载
- 高效重配置:故障后快速重新分配专家副本,最小化状态迁移开销
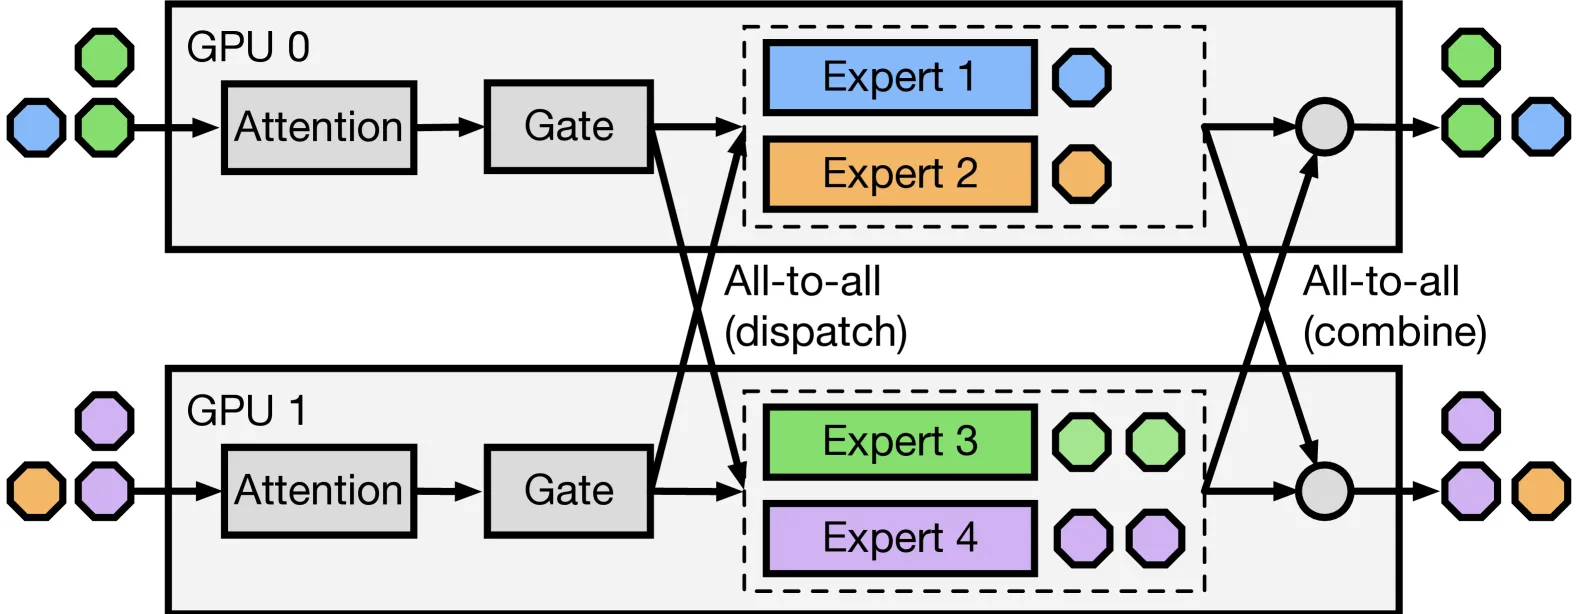 Figure 1: MoE 架构利用专家并行进行分布式训练,但由于门控网络的动态性,也面临负载不均衡问题
三、技术架构
整体框架图
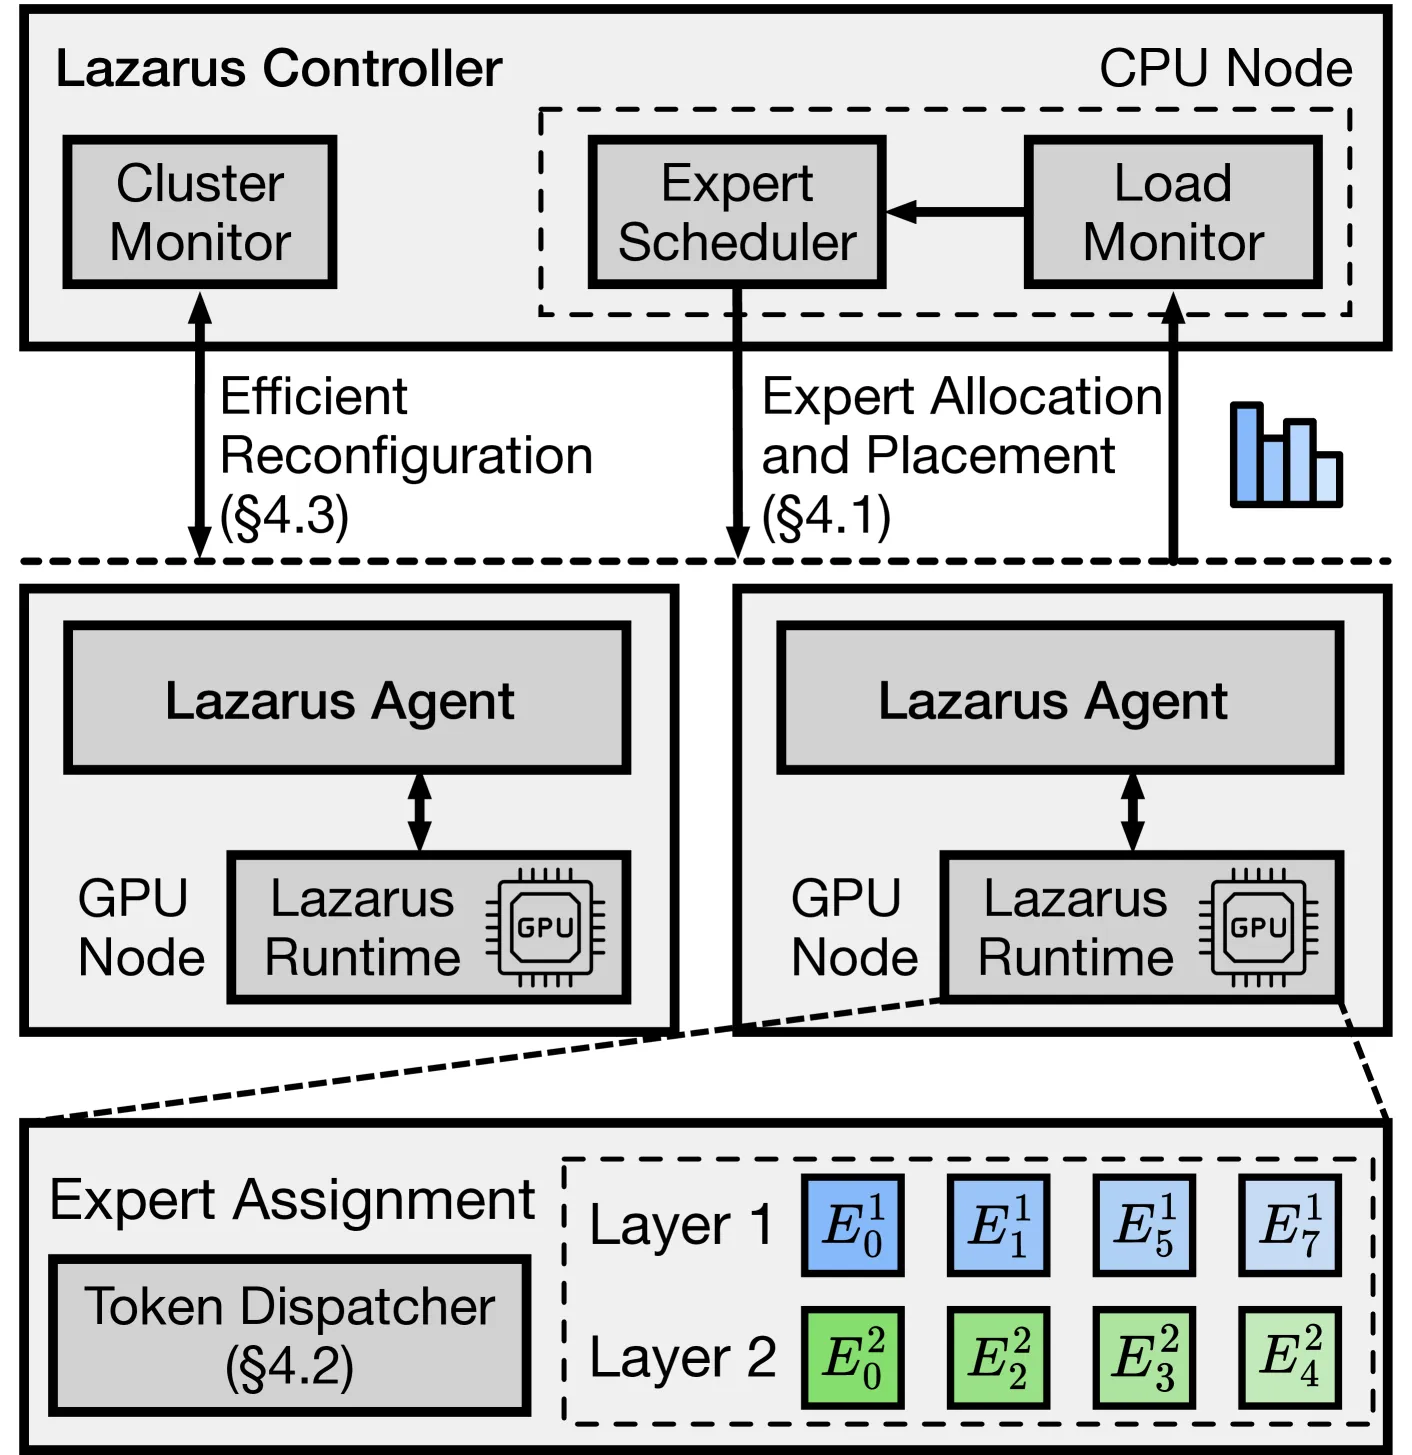 Figure 3: Lazarus 系统架构
Lazarus 由三个主要组件构成:
| 组件 | 说明 | 关键功能 |
|---|---|---|
| 集中式控制器 (Controller) | 运行在 CPU 节点上的持久进程 | 管理 GPU 集群、监控节点状态、计算专家放置计划 |
| Lazarus Agent | 每个 GPU 节点上的代理进程 | 与控制器通信、启动 Worker 进程、收集路由历史 |
| Lazarus Runtime | 运行在每个 GPU 上的运行时 | 执行专家计算、Token 调度、状态迁移 |
工作流程:
- Scheduler 在控制器中分配专家副本并计算容错放置计划
- 放置计划发送给各 Agent 配置 Worker
- Runtime 根据放置计划加载对应专家到各层
- Agent 周期性收集专家负载分布,用于重平衡
- 故障发生时,控制器重新计算放置计划并最小化迁移
核心公式
专家副本分配公式 (Expert Replica Allocation)
给定 N 个节点、E 个专家、每个节点可容纳 c 个副本、路由到专家 e 的总 token 数为 t_e,Lazarus 按以下公式迭代计算每个专家的副本数 r_e:
其中 f 是容错阈值,保证每个专家至少有 f 个副本。
关键性质:
- (所有副本槽位被充分利用)
- (保证 f 个节点以内故障时 100% 恢复)
- (热门专家获得更多副本)
- (副本比例匹配负载比例)
Token 调度算法 (Token Dispatch)
对于专家 e,每个副本应处理的 token 数:
节点 j 对专家 e 的处理容量:
其中 是节点 j 上专家 e 的副本数。
节点 i 将剩余 token 调度到节点 j 的数量:
定理 1 (MRO 放置最优性):对于任何最大秩重叠 (Maximum Rank Overlap, MRO) 放置计划 T,在均匀随机节点故障下,T 最大化恢复概率 。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Gate Network | 可训练的门控网络,决定 token 路由 | top-k 选择 |
| Expert FFN | 并行的前馈网络子模块 | 可变数量 (8-16) |
| Flexible Token Dispatcher | CUDA kernel 实现的 token 调度器 | 并行处理所有专家和目标 rank |
| NCCL Communication | all-to-all 通信原语 | 批量 send/recv |
| Greedy Migration | 贪心算法减少状态迁移 | 最小化新分配专家数 |
专家放置算法
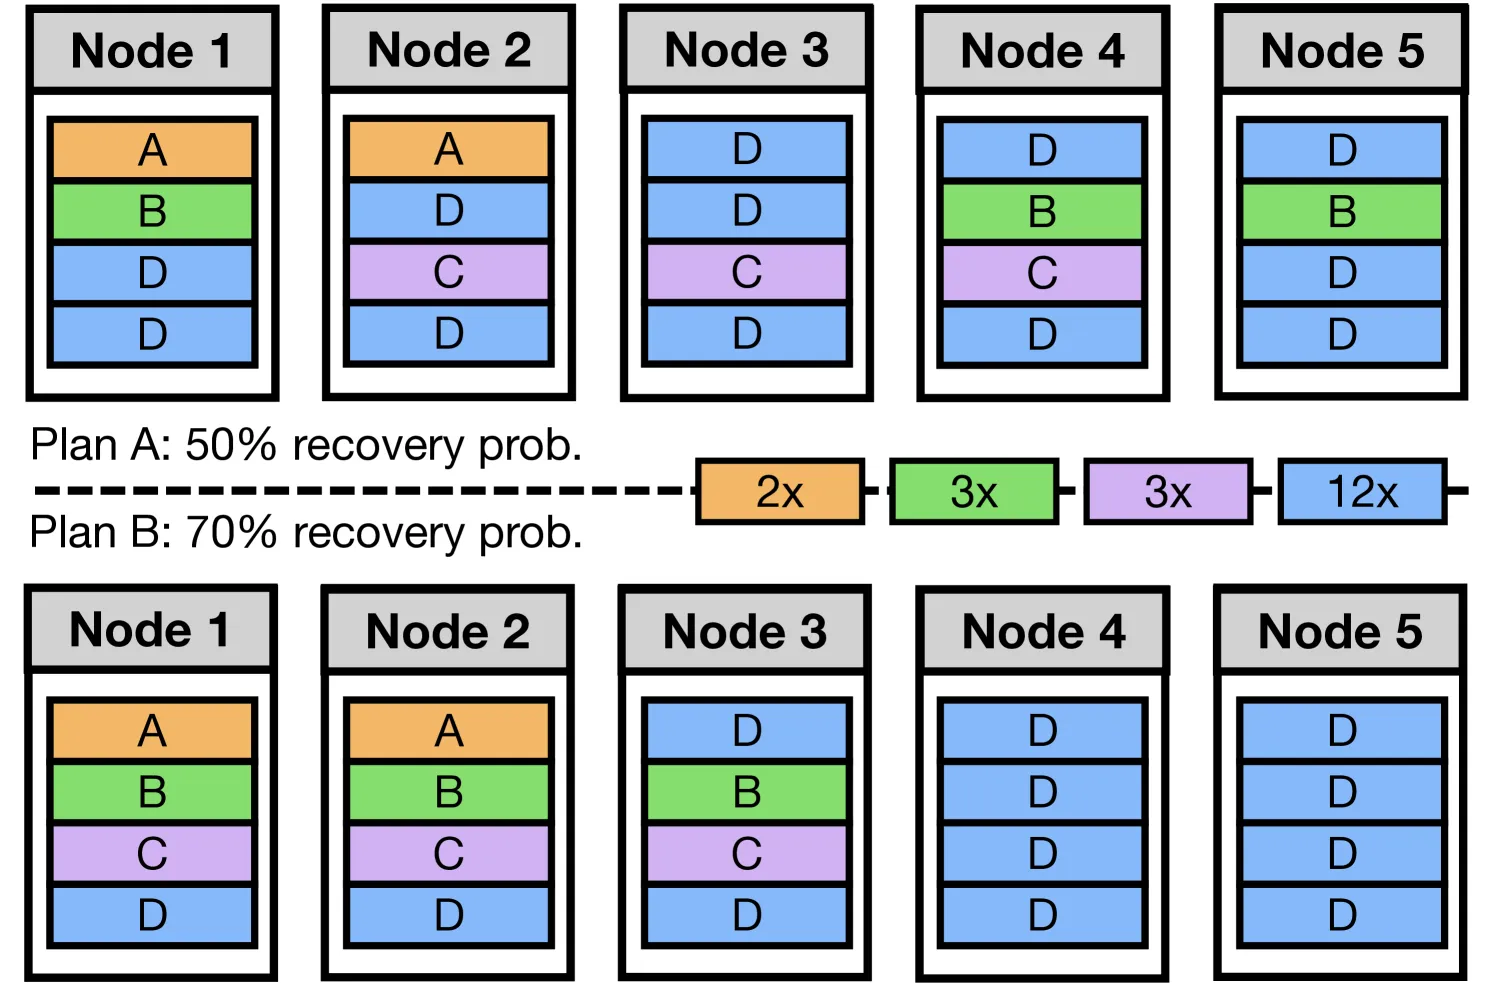 Figure 4: 容错能力取决于专家副本的放置方式
Lazarus 的专家放置算法分为两种情况:
情况 1:E <= c(专家数 <= 每节点槽位数)
策略:将前 min(r_1, N) 个节点放置第一个(最不热门)专家,前 min(r_2, N) 个节点放置第二个专家,以此类推。空位均匀放置剩余专家。
此策略满足 ,即节点集合的嵌套关系,保证最优恢复概率。
情况 2:E > c(专家数 > 每节点槽位数)
将专家和节点分别划分为 个组。每组内应用情况 1 的策略,最大化组内专家的节点重叠。
核心原则:“把所有鸡蛋放在一个篮子里” — 让更多专家在更少的故障模式下同时失效,从而减少导致不可恢复故障的故障组合数。
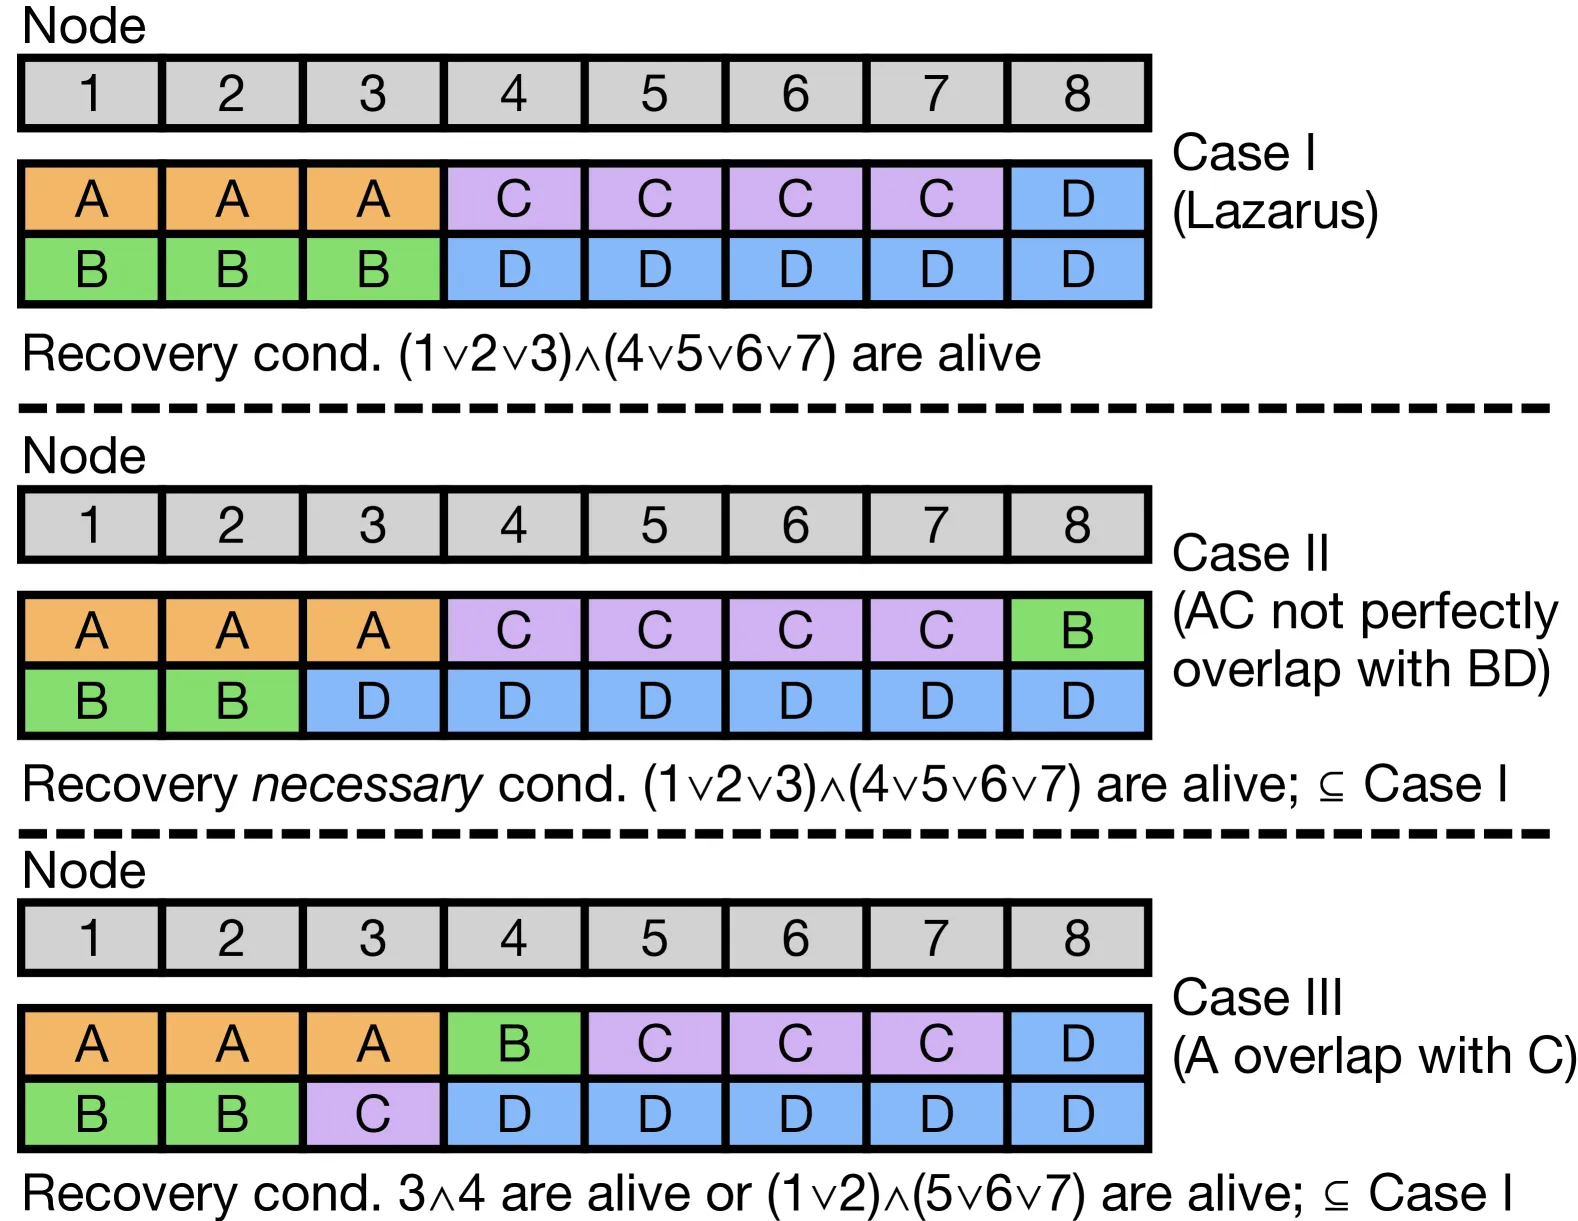 Figure 5: Lazarus 通过最小化有边连接的故障组合顶点数来最小化故障概率
训练流程
- 初始化:控制器计算初始专家分配和放置计划
- 正常训练:Runtime 按放置计划执行 MoE 前向/反向传播
- 负载监控:每 200 步重新平衡专家分配
- 故障处理:
- 检测到故障后,NCCL 操作超时
- 控制器重新计算放置计划(<100ms)
- Agent 配置新 Worker
- 贪心映射减少状态迁移
- 恢复训练
- 扩容处理:新节点加入时,延迟重配置直到当前训练步完成
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个 MoE 弹性容错系统 | Lazarus 是第一个同时支持快速故障恢复和充分利用所有可用 GPU 的 MoE 训练系统 | 在频繁故障下比 DeepSpeed MoE 快 5.7x |
| 可证明最优的专家放置算法 | MRO 算法在均匀随机节点故障下最大化恢复概率 | 定理 1 证明了最优性;GPT-L 在 4 节点故障下恢复概率 41% vs 基线 12% |
| 自适应专家副本分配 | 根据动态负载分布分配更多副本给热门专家 | 负载比 4:1 时吞吐量保持恒定,而 DeepSpeed 吞吐量急剧下降 |
| 灵活的 Token 调度器 | CUDA kernel 实现的非对称 token 调度,无 padding 的 all-to-all | 有效计算时间占比高,重配置开销 <10% |
| 高效重配置机制 | 贪心算法最小化状态迁移,批量 NCCL send/recv | 每次重配置仅需 20-40 秒 |
五、实验结果
实验设置
| 配置项 | 详情 |
|---|---|
| 测试平台 | 5 台服务器,每台 2x NVIDIA RTX 3090 GPU,100Gbps Mellanox NIC |
| 集群规模 | 模拟 10 个 GPU 节点 |
| 基线 | DeepSpeed MoE (DS), DS with Fault Tolerance (DS(FT)) |
| 数据集 | Wikitext-2 |
| 精度 | FP16 |
模型配置:
| 模型 | Layers | Feature Dim | Experts | Parameters |
|---|---|---|---|---|
| GPT-S | 12 | 768 | 8 | 521M |
| GPT-M | 12 | 1024 | 12 | 1.3B |
| GPT-L | 12 | 1024 | 16 | 1.7B |
单节点故障结果
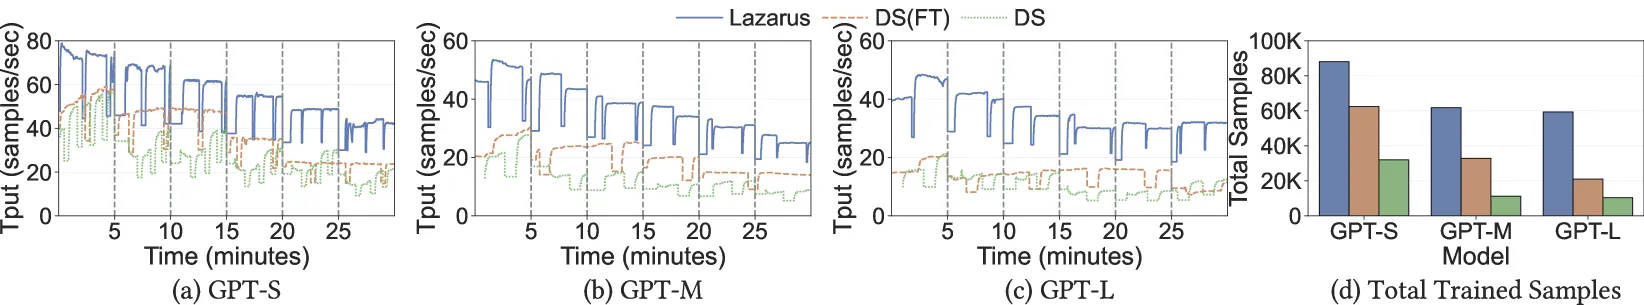 Figure 6: 单节点故障场景(每 5 分钟故障一次)的吞吐量和训练样本数
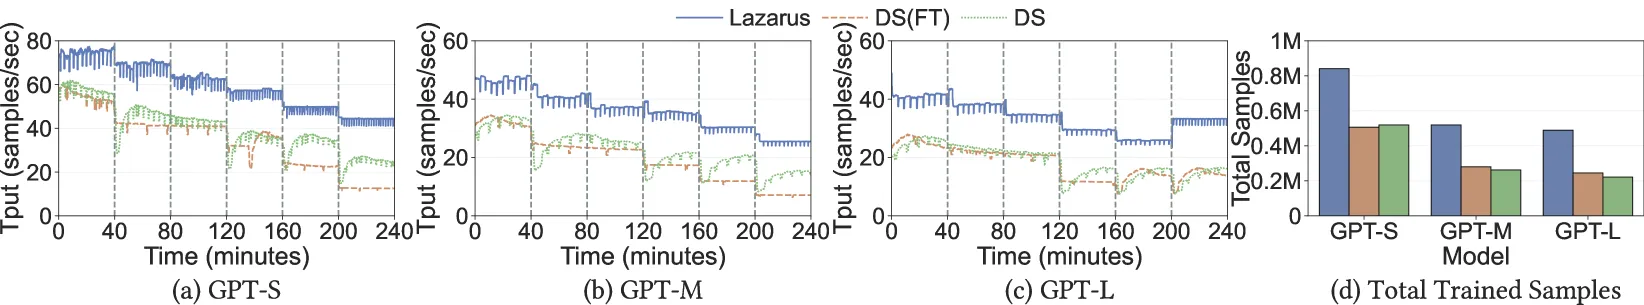 Figure 7: 单节点故障场景(每 40 分钟故障一次)的吞吐量和训练样本数
关键结果:
| 场景 | 模型 | Lazarus vs DS | Lazarus vs DS(FT) |
|---|---|---|---|
| 高频故障 (5min MTBF) | GPT-S | 2.8x | 1.4x |
| 高频故障 (5min MTBF) | GPT-L | 5.7x | 2.8x |
| 低频故障 (40min MTBF) | GPT-S | 1.6x | - |
| 低频故障 (40min MTBF) | GPT-L | 2.3x | - |
多节点故障结果
| 模型 | 步骤 | 丢失节点数 | 重配置时间(s) | 专家迁移数 | 迁移时间(s) |
|---|---|---|---|---|---|
| GPT-S | 200 | 2 | 21.3 | 11 | 2.3 |
| GPT-S | 4000 | 3 | 34.1 | 52 | 3.0 |
| GPT-L | 200 | 4 | 18.2 | 160 | 7.6 |
| GPT-L | 4000 | 5 | 19.7 | 55 | 7.8 |
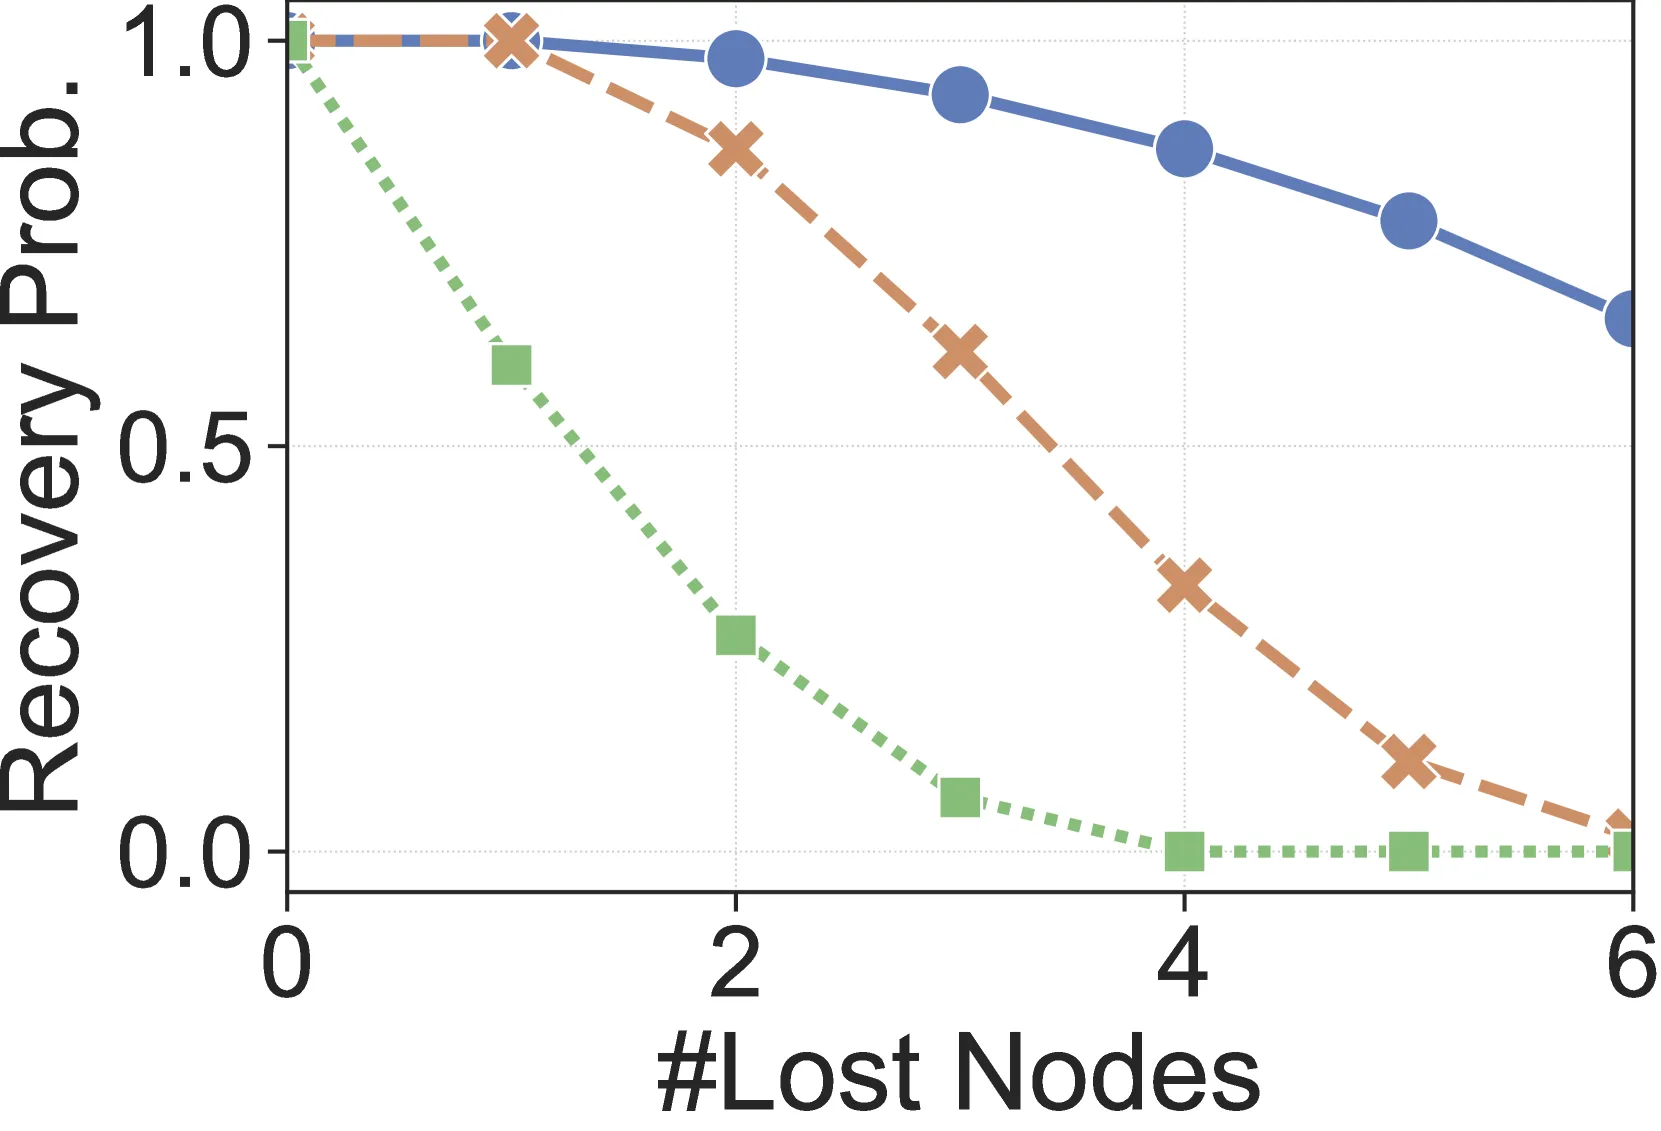 Figure 8: 多节点故障下的恢复概率对比
恢复概率对比 (GPT-L, step 200, 4 节点故障):
- Lazarus (MRO): 41%
- Spread Placement: 12%
- Compact Placement: ~0%
Spot 实例 Trace 结果
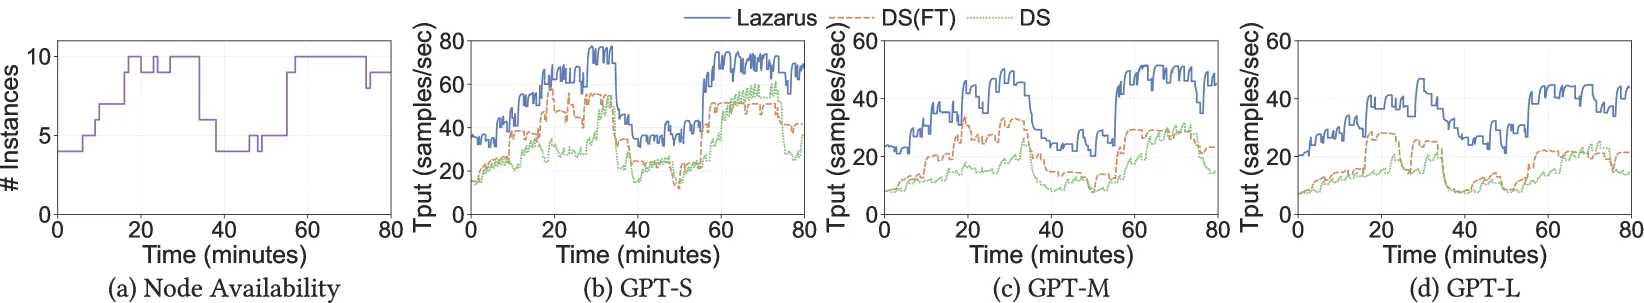 Figure 9: Spot 实例环境下的吞吐量变化
| 模型 | Lazarus vs DS | Lazarus vs DS(FT) |
|---|---|---|
| GPT-S | 2.3x | 1.2x |
| GPT-L | 3.4x | 1.8x |
在 80 分钟的 AWS EC2 P3 实例 trace 回放中,Lazarus 仅在一次 4 节点同时丢失的事件中需要从检查点恢复。
消融实验
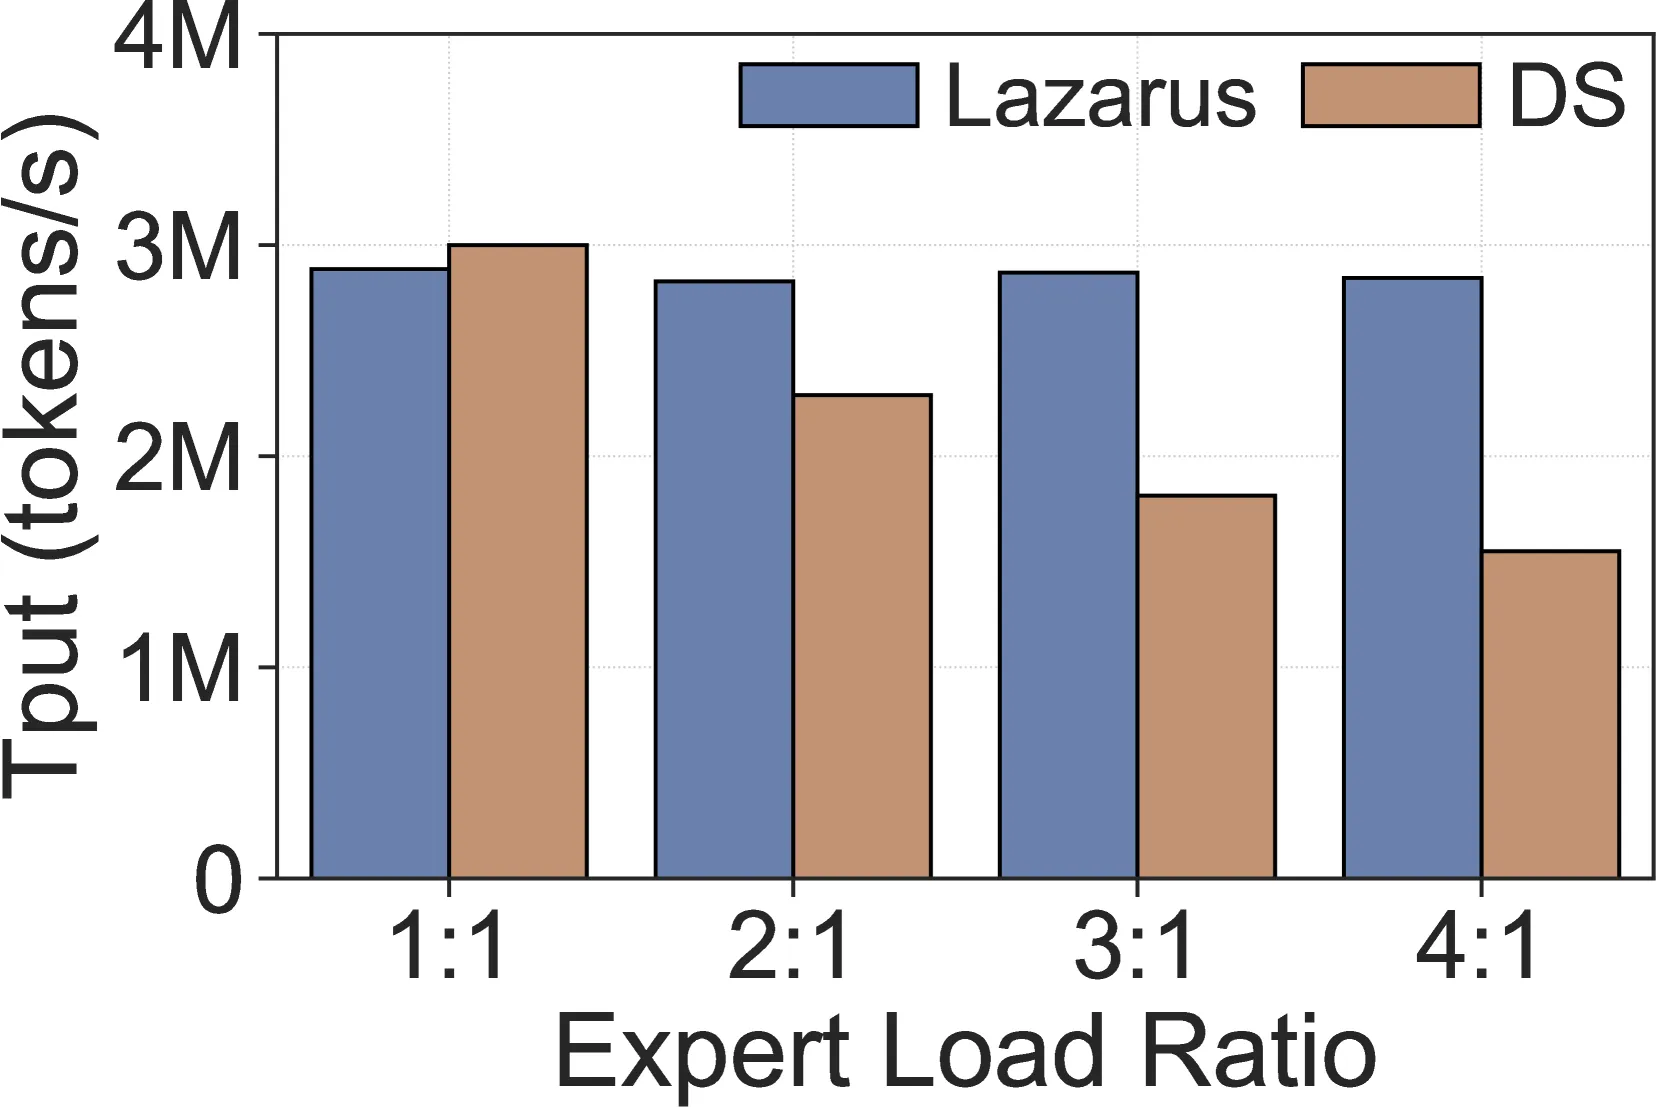 Figure 10a: 不同专家负载比下的吞吐量
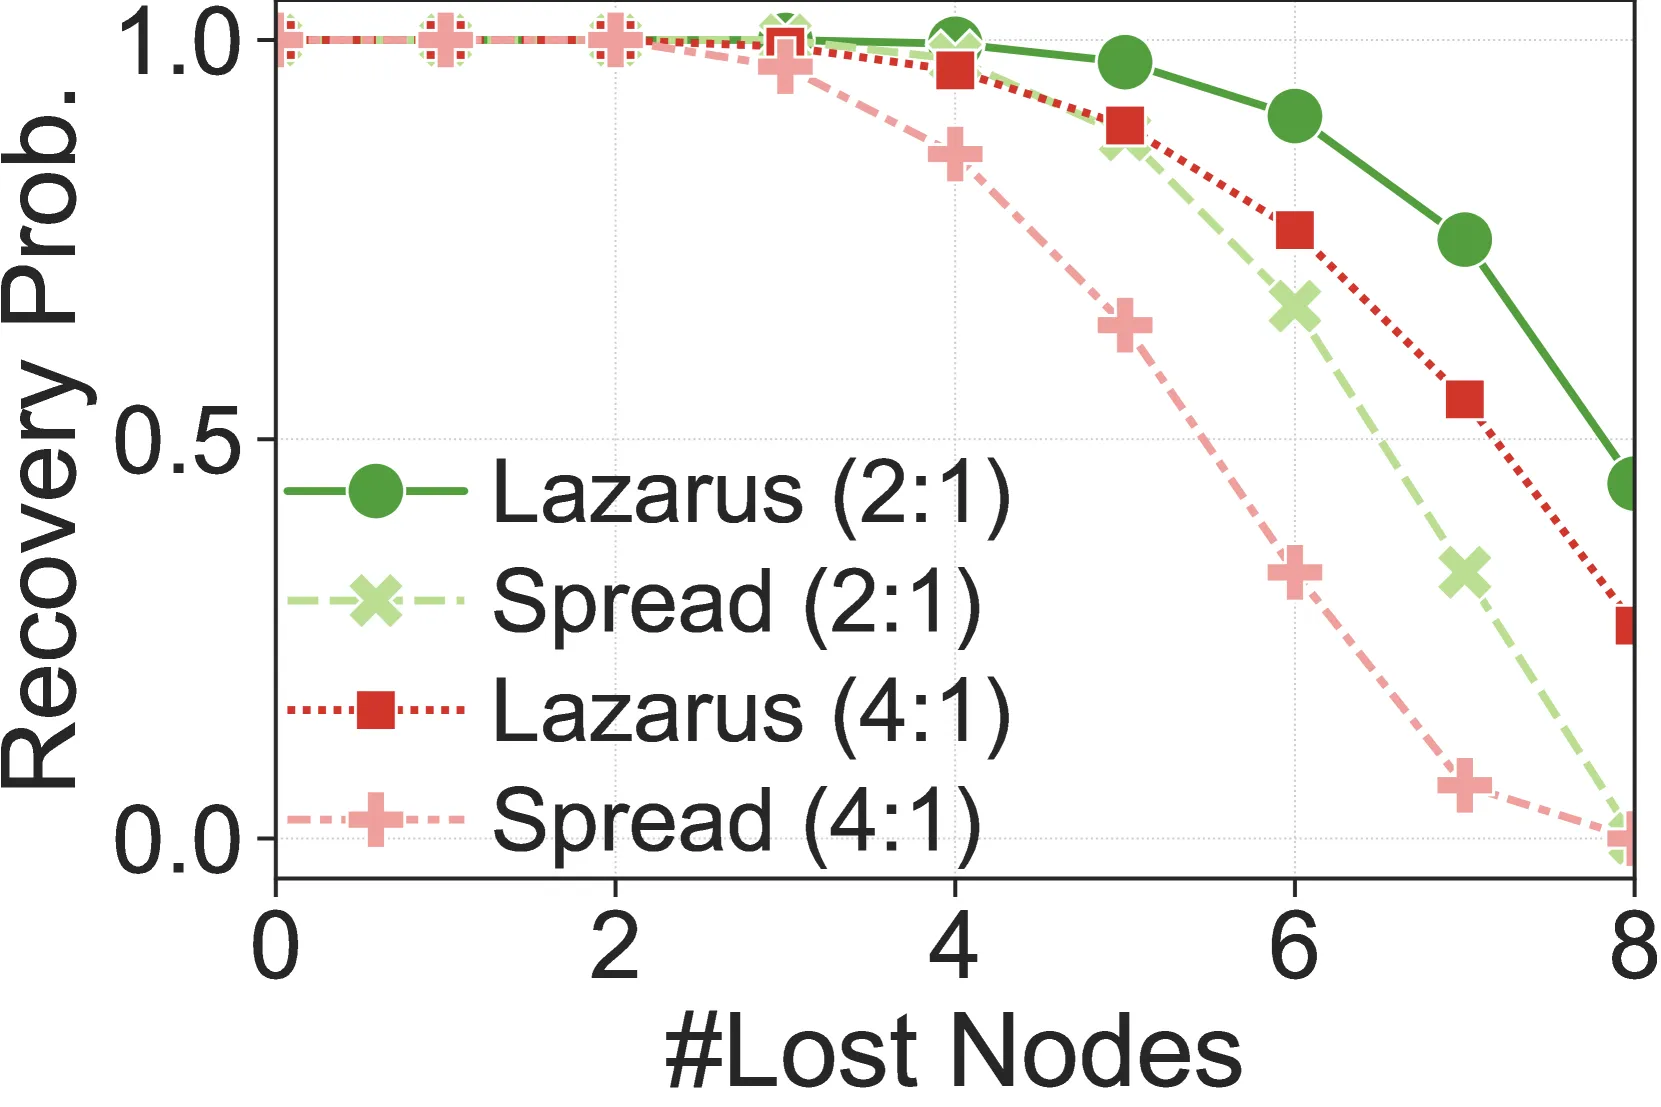 Figure 10b: 不同负载比下的恢复概率
负载不均衡影响:
- Lazarus 的吞吐量在负载比变化时保持恒定
- DeepSpeed 的吞吐量在负载偏斜时急剧下降
- 负载越不均衡,恢复概率越低,但 Lazarus 的 MRO 算法始终优于 spread placement
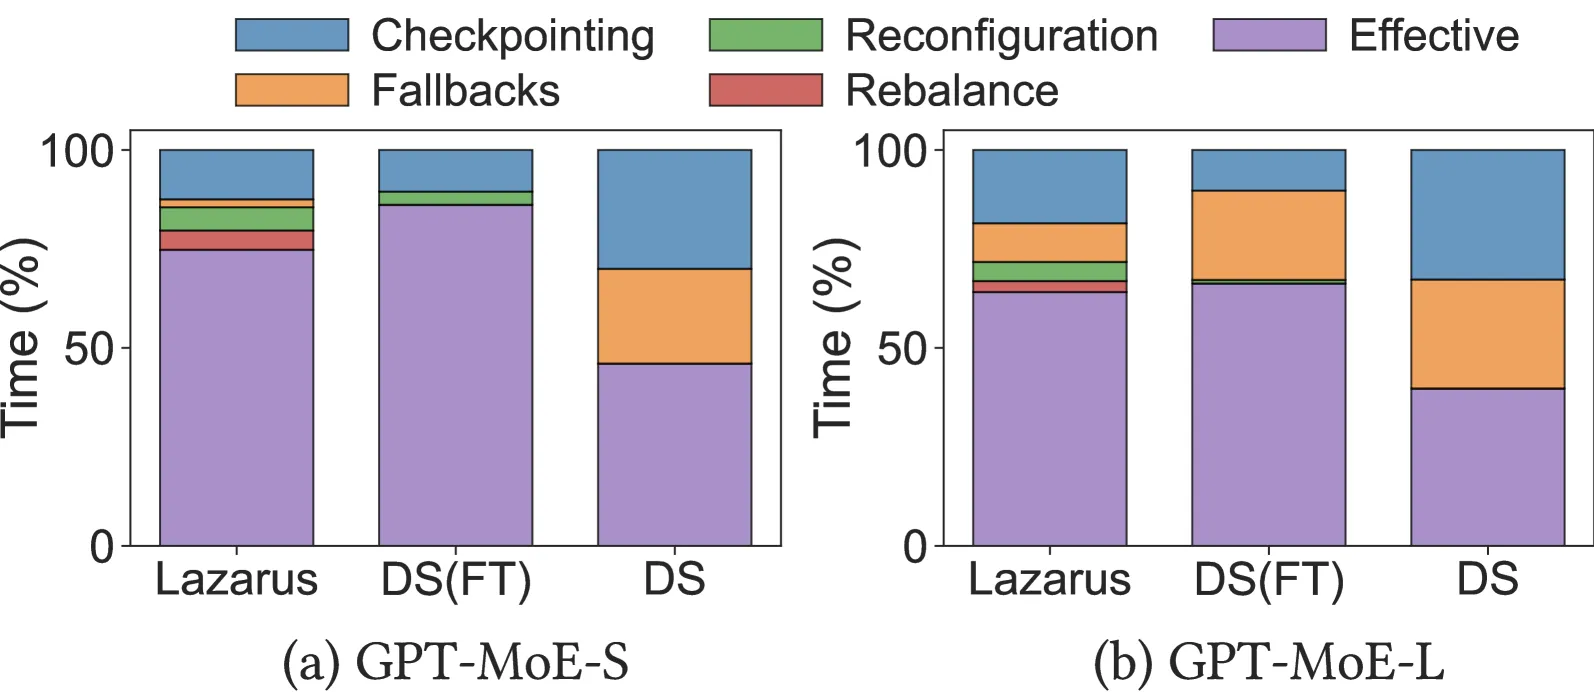 Figure 11: Spot 实例 trace 下的运行时间分解
运行时间分解:
- Lazarus 和 DS(FT) 的有效计算时间占比远高于 DS
- DS 超过一半时间花在检查点和重启上
- Lazarus 的重配置和重平衡开销 <10%
- DS(FT) 在 GPT-L 上仍有 27% 的重启开销
六、相关工作
| 方向 | 代表工作 | 与 Lazarus 的关系 |
|---|---|---|
| MoE 训练优化 | Tutel, SmartMoE, FasterMoE, FlexMoE | 聚焦固定集群规模的训练加速,Lazarus 关注弹性环境 |
| All-to-All 通信优化 | DeepSpeed MoE, MegaScale | 正交,可集成到 Lazarus |
| 内存检查点 | Gemini, Oobleck | Gemini 假设均匀副本数,不适用于 Lazarus 的非均匀专家放置 |
| 流水线并行弹性训练 | Bamboo, Varuna, PACE | 基于流水线并行,无法应用于 MoE 的专家并行 |
| 弹性数据并行 | TorchElastic | 仅适用于小模型,不适用于超出单 GPU 内存的 LLM |
七、总结
核心贡献
- 首个 MoE 弹性容错训练系统:Lazarus 是第一个同时实现快速故障恢复和充分利用所有可用 GPU 的 MoE 训练系统
- 可证明最优的专家放置算法:MRO 算法在均匀随机节点故障下最大化恢复概率,具有严格的理论保证
- 完整的系统实现与评估:基于 PyTorch 实现 (4K LoC Python + 500 LoC CUDA),在多种场景下进行了全面评估
技术影响
- 降低 MoE 训练成本:通过支持 Spot 实例训练,可节省高达 90% 的计算成本
- 提高训练效率:在频繁故障场景下性能提升高达 5.7x
- 推动 MoE 架构普及:解决了 MoE 训练的关键瓶颈,有助于 MoE 架构在更大规模模型中的应用
- 启发后续研究:自适应专家分配和最优放置的思想可扩展到其他分布式训练场景
局限性
- 实验规模有限:测试平台仅使用 RTX 3090 GPU 模拟 10 节点集群,未在大规模生产环境验证
- 未考虑网络拓扑:当前假设所有节点间通信成本相同,未优化跨机架/跨数据中心的通信
- 与流水线并行的集成:虽然提到可扩展到流水线并行,但未实现和评估
- 检查点回退:在极端情况下(如同时丢失过多节点)仍需回退到检查点恢复
八、参考资源
- 论文: arXiv:2407.04656
- PDF: arXiv PDF
- HTML: arXiv HTML v2
- 相关项目: