Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
面向 Kimi 的 KVCache 中心化解耦架构,通过分离 Prefill 和 Decode 集群实现 525% 吞吐量提升
Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
论文信息: arXiv:2407.00079 [cs.DC] 03 Sep 2025
作者: Ruoyu Qin, Zheming Li, Weiran He, Mingxing Zhang, Yongwei Wu, Weimin Zheng, Xinran Xu
机构: Moonshot AI, Tsinghua University
许可: arXiv.org perpetual non-exclusive license
一、论文概述
1.1 研究背景
随着大语言模型(LLM)在各种场景中的快速采用,LLM 服务的工作负载变得显著多样化。这些工作负载在输入/输出长度、到达频率和分布上有所不同,最重要的是,需要不同类型的 SLO(服务级别目标)。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 工作负载多样化 | 不同请求的输入/输出长度、到达模式差异大 |
| SLO 约束 | 需要同时满足 TTFT 和 TBT 延迟要求 |
| 资源利用率 | GPU 集群中 CPU、DRAM、SSD 资源未被充分利用 |
| KVCache 调度 | KVCache 的复用和传输是系统调度的核心 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| KVCache 中心化架构 | 以 KVCache 为核心的解耦设计,分离 Prefill 和 Decode 集群 |
| 解耦缓存池 | 利用 CPU、DRAM、SSD 资源构建解耦的 KVCache 缓存池 |
| 缓存感知调度 | 考虑前缀缓存命中和负载均衡的全局调度算法 |
| 过载场景处理 | 基于预测的早期拒绝策略,应对高负载场景 |
二、核心思想
2.1 问题定义
Mooncake 是 Kimi 的服务平台,需要解决一个具有多个复杂约束的优化问题:
优化目标:最大化整体有效吞吐量(直接影响收入)
约束条件:
- TTFT(Time to First Token)SLO
- TBT(Time Between Tokens)SLO
2.2 解决方案概述
Mooncake 采用 KVCache 中心化的解耦架构:
- 分离 Prefill 和 Decode 集群:利用两者计算特性的差异
- 构建解耦 KVCache 池:利用 CPU、DRAM、SSD 资源提供缓存容量
- KVCache 中心化调度:平衡缓存复用、负载均衡和 SLO 满足
三、技术架构
3.1 整体架构
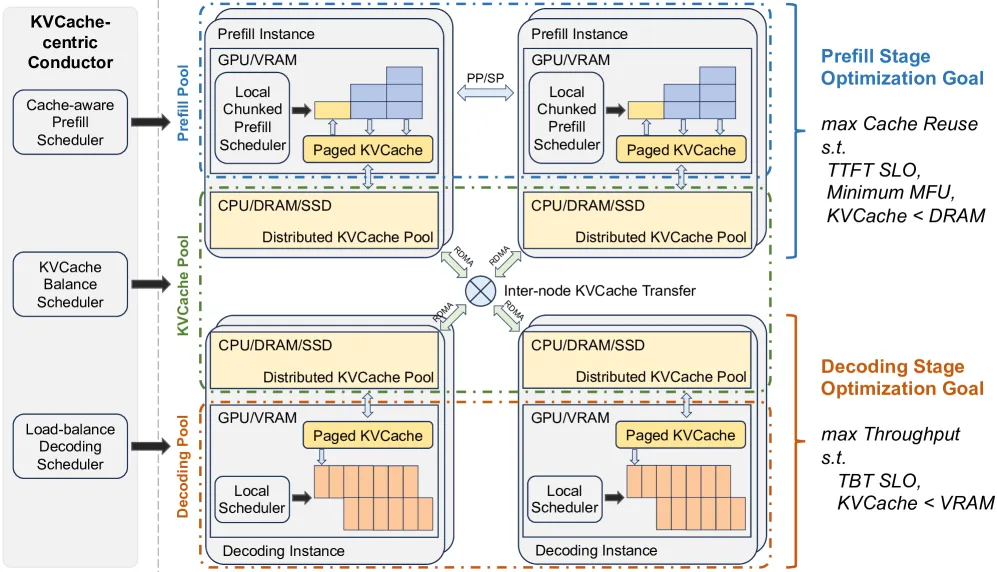 图 1:Mooncake 架构。
核心组件:
| 组件 | 功能 |
|---|---|
| Conductor | 全局调度器,负责请求分发和 KVCache 管理 |
| Prefill Pool | Prefill 实例池,处理请求的预填充阶段 |
| Decode Pool | Decode 实例池,处理请求的解码阶段 |
| KVCache Pool | CPU 内存中的 KVCache 缓存池 |
| Messenger | 基于 RDMA 的跨节点 KVCache 传输组件 |
3.2 KVCache 缓存池
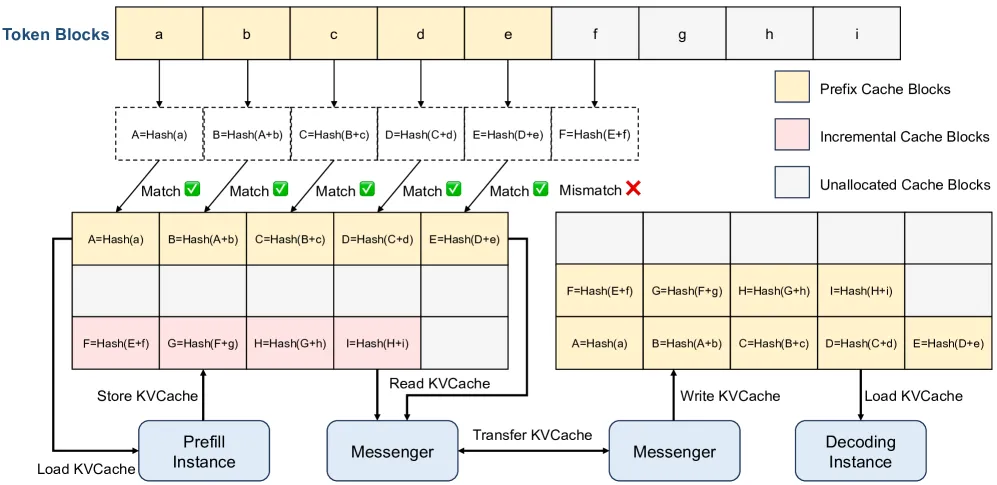 图 3:CPU 内存中的 KVCache 池。每个块附带由自身哈希和前缀确定的哈希值以进行去重。
存储逻辑:
- KVCache 以分页块的形式存储在 CPU 内存中
- 根据请求模式使用缓存淘汰算法(LRU、LFU 等)
- 通过 GPUDirect RDMA 处理 CPU 和 GPU 之间的传输
3.3 请求工作流
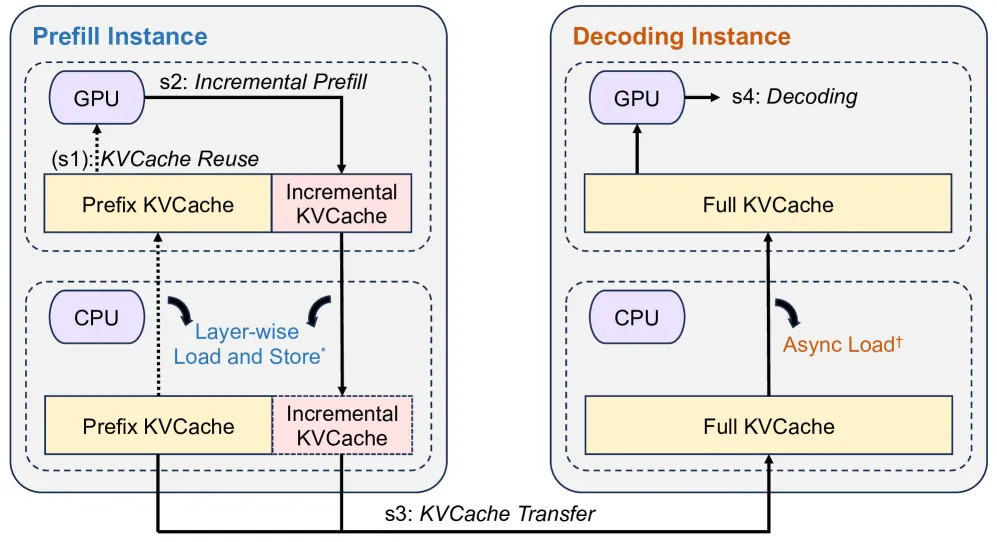 图 4:推理实例的工作流。
四个步骤:
- KVCache 复用:从远程 CPU 内存加载前缀缓存到 GPU 内存
- 增量 Prefill:使用前缀缓存完成预填充,存储新生成的 KVCache
- KVCache 传输:异步流式传输 KVCache 到 Decode 节点
- Decoding:请求加入持续批处理,生成输出
3.4 核心算法
KVCache 中心化调度算法:
Algorithm 1: KVCache-centric Scheduling Algorithm
输入: Prefill 实例池 P, Decode 实例池 D, 请求 R, 缓存块大小 B
输出: 处理 R 的 (prefill, decode) 实例对

1. block_keys ← PrefixHash(R.prompt_tokens, B)
2. TTFT ← inf, p ← ∅
3. best_prefix_len, best_matched_instance ← FindBestPrefixMatch(P, block_keys)
4. for instance ∈ P do
5.   prefix_len ← instance.prefix_len
6.   T_queue ← EstimatePrefillQueueTime(instance)
7.   if best_prefix_len/prefix_len < kvcache_balancing_threshold then
8.     // 缓存感知的 Prefill 调度
9.     T_prefill ← EstimatePrefillExecutionTime(len(R.prompt_tokens), prefix_len)
10.    if TTFT > T_queue + T_prefill then
11.      TTFT ← T_queue + T_prefill
12.      p ← instance
13.    end if
14.  else
15.    // 缓存感知且均衡的 Prefill 调度
16.    transfer_len ← best_prefix_len - prefix_len
17.    T_transfer ← EstimateKVCacheTransferTime(...)
18.    T_prefill ← EstimatePrefillExecutionTime(...)
19.    if TTFT > T_transfer + T_queue + T_prefill then
20.      TTFT ← T_transfer + T_queue + T_prefill
21.      p ← instance
22.    end if
23.  end if
24. end for
25. d, TBT ← SelectDecodingInstance(D)
26. if TTFT > TTFT_SLO or TBT > TBT_SLO then
27.   reject R; return
28. end if
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| KVCache 中心化设计 | 以 KVCache 调度为核心优化目标 | 系统架构设计 |
| 解耦缓存池 | 利用 CPU/DRAM/SSD 资源构建缓存池 | 资源利用率分析 |
| 缓存感知调度 | 考虑前缀缓存命中和负载均衡 | 算法设计和实验验证 |
| 过载场景处理 | 基于预测的早期拒绝策略 | 真实工作负载验证 |
4.2 技术细节
Prefill 和 Decode 的计算特性差异:
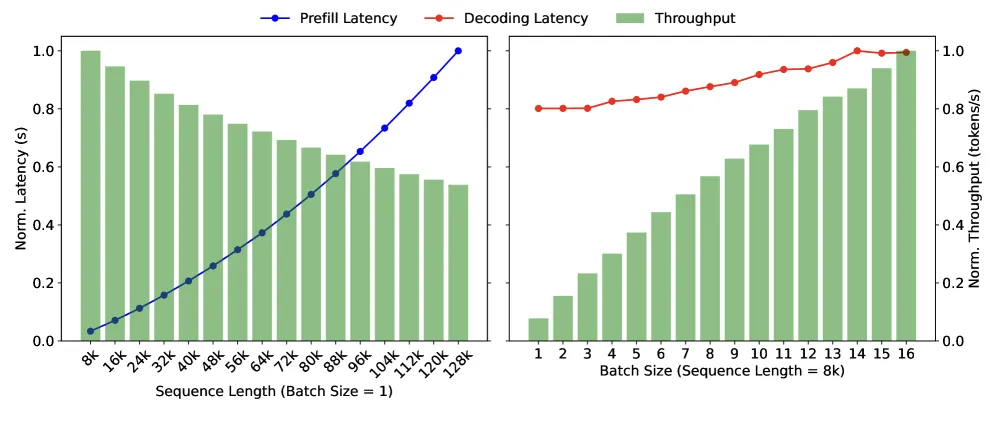 图 2:不同序列长度或批大小下 Prefill 和 Decode 阶段的归一化吞吐量和延迟。
关键发现:
- Prefill 阶段是计算密集型,延迟随序列长度线性增长
- Decode 阶段是内存密集型,延迟随批大小增长
- 分离两者可以独立优化各自特性
Layer-wise Prefill 优化:
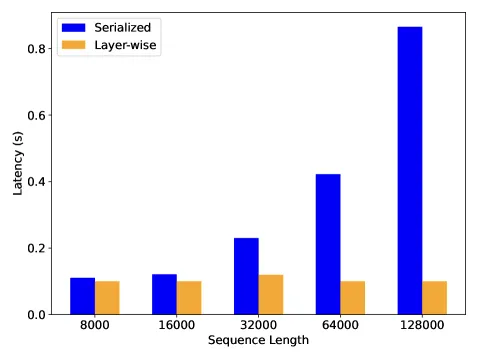 图 7:存储不同请求长度 KVCache 的延迟。
优化策略:
- 逐层执行 Prefill,与 KVCache 存储并行
- 减少传输延迟,提高整体效率
五、代码实现分析
5.1 系统组件
| 组件 | 实现 |
|---|---|
| Conductor | 全局调度器,基于 KVCache 状态和负载进行决策 |
| Prefill 实例 | 处理请求的预填充阶段,支持多节点和 Layer-wise 执行 |
| Decode 实例 | 处理请求的解码阶段,支持持续批处理 |
| KVCache 池 | CPU 内存中的分页缓存,支持 LRU/LFU 淘汰策略 |
| Messenger | 基于 GPUDirect RDMA 的跨节点传输组件 |
5.2 部署架构
- 硬件:每节点 8× NVIDIA A800-SXM4-80GB GPU
- 网络:支持 800 Gbps 互联带宽的 RDMA 网卡
- 模型:基于 LLaMA2-70B 架构的 dummy 模型
六、实验结果
6.1 端到端性能
公共数据集结果:
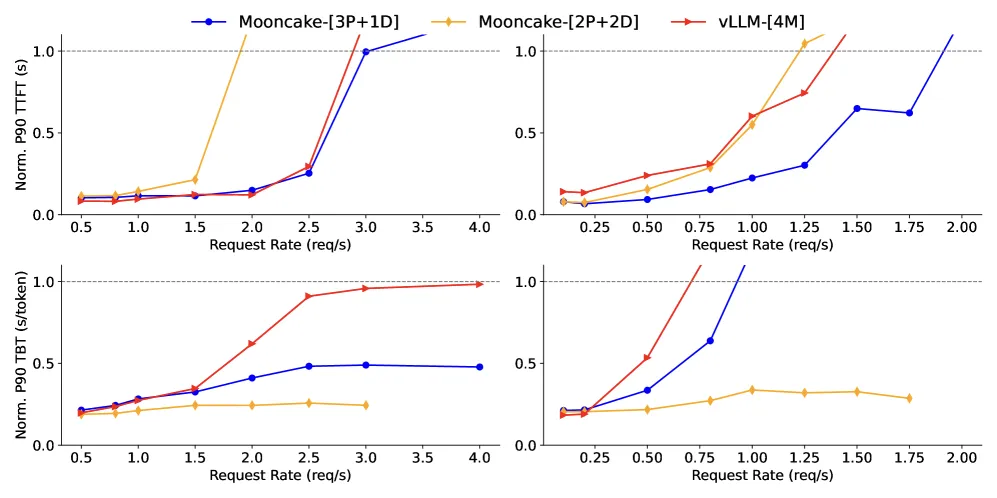 图 11:Mooncake 和 vLLM 在 ArXiv Summarization 和 L-Eval 数据集上的端到端实验。
| 数据集 | vLLM-[4M] | Mooncake-[3P+1D] | Mooncake-[2P+2D] | 提升 |
|---|---|---|---|---|
| ArXiv Summarization | 1× | 1.2× | 1.1× | 20% |
| L-Eval | 1× | 1.4× | 1.2× | 40% |
模拟数据集结果:
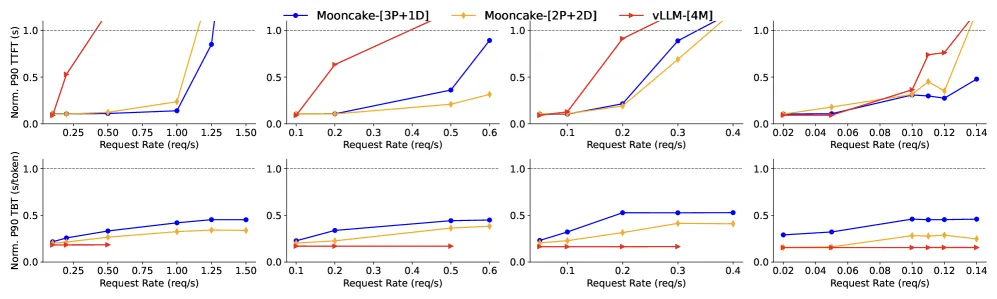 图 12:Mooncake 和 vLLM 在模拟数据上的端到端实验。
关键发现:
- 在长上下文场景中,Mooncake 实现高达 525% 的吞吐量提升
- 前缀缓存显著减少 Prefill 时间,提高整体效率
- 解耦架构在长上下文场景中优势明显
6.2 真实工作负载
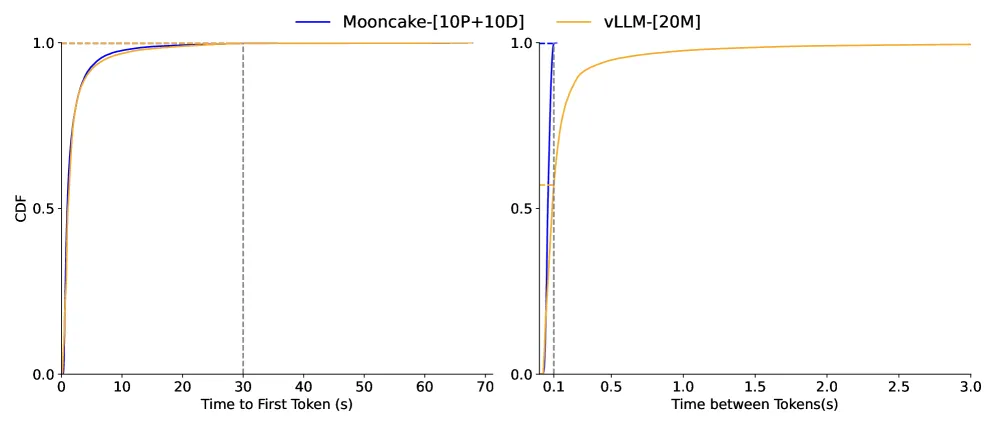 图 13:Mooncake 和 vLLM 在真实工作负载下的请求 TTFT 和 TBT 分布。
结果:
- Mooncake 的创新架构使 Kimi 能够处理 75% 更多请求
- 在真实工作负载下保持 SLO 满足
6.3 过载场景
基于预测的早期拒绝:
图 13:应用早期拒绝和基于预测的早期拒绝时的实例负载。
关键发现:
- 早期拒绝可以防止负载波动
- 基于预测的早期拒绝可以进一步平滑负载
七、相关工作
7.1 LLM 服务系统
| 系统 | 特点 | 关系 |
|---|---|---|
| vLLM | 持续批处理 + PagedAttention | 基线对比 |
| DeepSpeed-FastGen | SplitFuse 技术 | 相关工作 |
| Sarathi | Chunked Prefill | 相关工作 |
| Mooncake | KVCache 中心化解耦架构 | 本文工作 |
7.2 解耦架构
| 方法 | 特点 | 关系 |
|---|---|---|
| Splitwise | Prefill-Decode 分离 | 相关工作 |
| DistServe | 解耦 Prefill 和 Decode | 相关工作 |
| Mooncake | KVCache 中心化 + 解耦缓存池 | 本文工作 |
八、总结
8.1 核心贡献
- KVCache 中心化架构:以 KVCache 调度为核心的解耦设计
- 解耦缓存池:利用 CPU/DRAM/SSD 资源构建 KVCache 缓存池
- 缓存感知调度:考虑前缀缓存命中和负载均衡的全局调度算法
- 过载场景处理:基于预测的早期拒绝策略
- 显著性能提升:高达 525% 吞吐量提升,处理 75% 更多请求
8.2 技术影响
- 生产系统验证:在 Kimi 生产环境中验证了架构的有效性
- 长上下文优化:在长上下文场景中优势明显
- 资源利用率:充分利用 GPU 集群中的 CPU/DRAM/SSD 资源
- SLO 满足:在高负载下仍能满足延迟 SLO
8.3 局限性
- 架构复杂性:解耦架构增加了系统复杂性
- 传输开销:KVCache 传输可能成为瓶颈
- 负载均衡:Prefill 和 Decode 实例比例需要预设
- 预测准确性:早期拒绝依赖于准确的负载预测
九、参考资源
9.1 论文链接
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | Mooncake 架构 | figure-1-architecture.png |
| 图 2 | 吞吐量和延迟 | figure-2-throughput-latency.png |
| 图 3 | KVCache 缓存池 | figure-3-kvcache-pool.png |
| 图 4 | 请求工作流 | figure-4-workflow.png |
| 图 7 | Layer-wise 延迟 | figure-7-layer-wise-latency.png |
| 图 11 | 公共数据集结果 | figure-11-e2e-public.png |
| 图 12 | 模拟数据集结果 | figure-12-e2e-simulated.png |
| 图 13 | 真实工作负载 | figure-13-real-workload.png |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| vLLM | Kwon et al. | 2023 | 基线对比 |
| Splitwise | Patel et al. | 2024 | 解耦架构 |
| DistServe | Zhong et al. | 2024 | 解耦架构 |
| DeepSpeed-FastGen | Microsoft | 2024 | 相关工作 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| KVCache | Key-Value Cache | 注意力机制中缓存的键值对 |
| Prefill | Prefill | LLM 推理的预填充阶段 |
| Decode | Decode | LLM 推理的解码阶段 |
| TTFT | Time to First Token | 首个 token 生成时间 |
| TBT | Time Between Tokens | token 间时间 |
| SLO | Service Level Objective | 服务级别目标 |
| RDMA | Remote Direct Memory Access | 远程直接内存访问 |
分析完成时间:2026年6月24日 分析工具:Claude Code + paper-analyzer skill