SampleAttention: Near-Lossless Acceleration of Long Context LLM Inference with Adaptive Structured Sparse Attention
SampleAttention通过自适应结构化稀疏注意力实现长上下文LLM推理的近无损加速,显著降低首token延迟。
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | SampleAttention: Near-Lossless Acceleration of Long Context LLM Inference with Adaptive Structured Sparse Attention |
| arXiv ID | 2406.15486 |
| 发表日期 | 2024年6月17日 (v1), 2025年9月3日 (v3) |
| 研究领域 | 计算与语言 (cs.CL), 人工智能 (cs.AI), 机器学习 (cs.LG) |
| 核心贡献 | 提出一种自适应结构化稀疏注意力机制,可在不损失精度的情况下加速长上下文LLM推理 |
1.2 摘要
大型语言模型(LLMs)现已支持极长的上下文窗口,但标准注意力机制的二次复杂度导致首令牌生成时间(Time-to-First-Token, TTFT)延迟显著增加。现有方法需要额外的预训练或微调,且常常牺牲模型精度。
本文首先提供了近无损稀疏注意力的理论和实验证明。作者发现在运行时动态捕获特定注意力头(head-specific)的稀疏模式至关重要。基于此,提出了SampleAttention——一种自适应结构化近无损稀疏注意力方法。该方法利用观察到的显著稀疏模式,通过固定比例的相邻令牌捕获局部窗口模式,并采用两阶段查询引导的键值过滤方法,自适应地选择最小键值集合来捕获列条纹模式。
综合评估表明,SampleAttention可以无缝替换现成LLM中的标准注意力,几乎无精度损失,并将TTFT延迟降低最多2.42倍(相比FlashAttention)。
1.3 研究动机
- 长上下文场景下(如100万令牌),标准注意力计算时间占据TTFT的90%以上
- 现有稀疏注意力方法需要预训练/微调,无法直接应用于现成模型
- 需要一种即插即用、近无损的注意力加速方案
二、核心思想
2.1 关键发现
作者通过理论分析和实验观察,发现了长上下文注意力中的三个重要特性:
| 特性 | 描述 | 意义 |
|---|---|---|
| 固有高稀疏度 | 大多数层的稀疏度超过90%(α=0.95阈值) | 说明注意力天然具有稀疏性,可被利用 |
| 头特异性 | 不同注意力头的稀疏度差异巨大(27.4%到99.8%) | 不能对所有头统一压缩,需要自适应 |
| 内容感知性 | 相同头在不同输入下呈现不同稀疏模式 | 需要在运行时动态确定稀疏模式 |
2.2 两种显著稀疏模式
通过观察注意力分数矩阵,作者发现两种关键模式:
2.2.1 局部窗口模式 (Local Window Pattern)
- 捕获最近的上下文信息
- 相邻令牌通常具有较高的注意力分数
2.2.2 列条纹模式 (Column Stripe Pattern)
- 体现关键的全局上下文信息
- 某些键值位置在所有查询中都获得高分(如”注意力汇”attention sinks)
- 少量关键列可以覆盖大部分注意力分数
2.3 核心思路
标准注意力 → 识别稀疏模式 → 构造结构化掩码 → 稀疏计算 → 近无损输出SampleAttention的核心思路是:
- 固定窗口:用序列长度的固定百分比捕获局部模式
- 自适应条纹:通过两阶段过滤动态选择关键键值索引
- 硬件高效:利用结构化稀疏模式优化IO和计算
三、技术架构
3.1 整体架构
SampleAttention的架构如图3所示,包含以下核心组件:
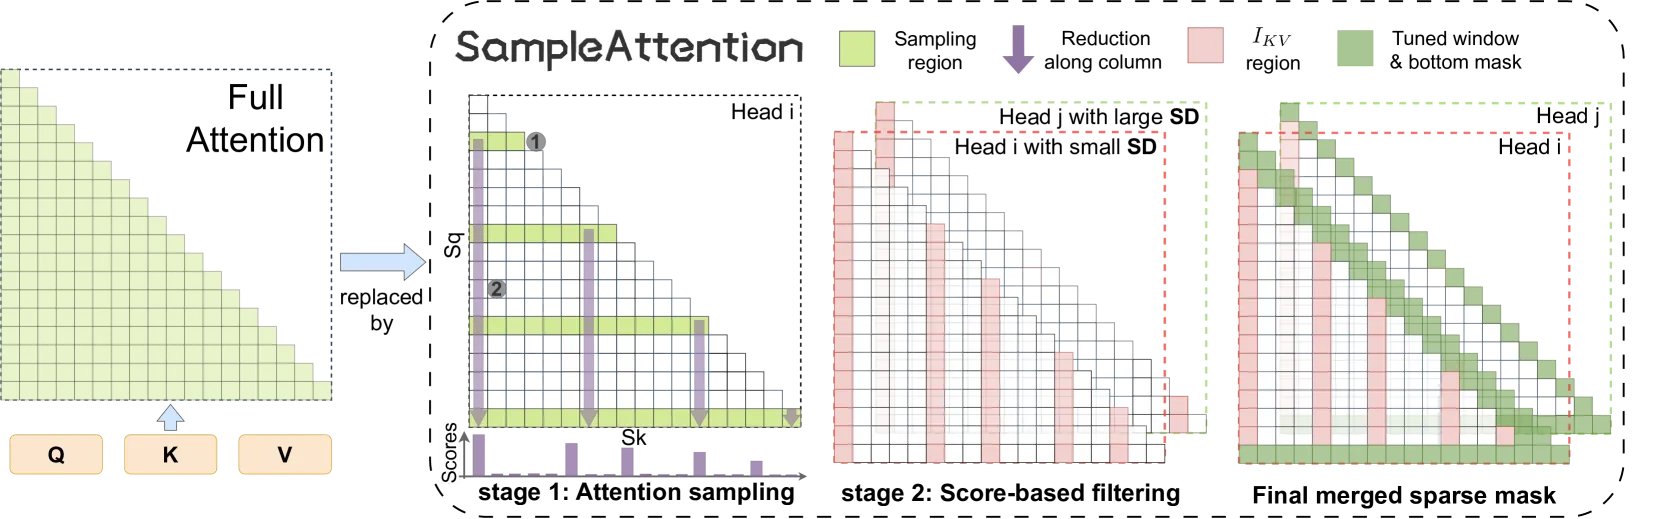
图3:SampleAttention用两阶段实现替代原始全注意力。第一阶段通过跨多行的步幅采样计算注意力分数并沿列累积;第二阶段通过top-k操作为每个头选择满足CRA阈值α的索引。
3.2 问题形式化
3.2.1 稀疏注意力定义
给定查询Q和键值K, V,标准注意力输出为:
稀疏注意力通过掩码M实现:
3.2.2 关键度量指标
| 指标 | 定义 | 意义 |
|---|---|---|
| 累积残余注意力 (CRA) | 衡量稀疏化后每行保留的最小注意力概率和 | |
| 稀疏度 (SD) | 衡量在满足CRA阈值α下可丢弃的最大键值比例 |
3.2.3 理论保证
定理1(近无损稀疏注意力):假设值V的L1范数上界为R > 0,给定ε > 0,存在注意力掩码M使得:
引理1:近无损稀疏注意力的CRA满足下界:
3.3 结构化稀疏掩码
为实现硬件高效性,SampleAttention将掩码分解为两个结构化组件:
其中:
- w:局部窗口大小,设为序列长度的固定百分比
- I_{KV}:列条纹的键值索引集合,自适应选择
定理2:结构化稀疏掩码 保持近无损特性。
四、核心创新
4.1 两阶段查询引导键值过滤
这是SampleAttention最核心的创新点。
4.1.1 第一阶段:查询引导注意力采样
动机:列条纹模式表明,如果某个键对一个查询获得高分,那么它对其他查询很可能也获得高分。
方法:
- 对查询维度进行步幅采样(采样率 )
- 只对采样的查询行计算完整注意力分数
- 大幅减少计算开销
优势:
- 简单有效的行采样可以准确近似真实的CRA
- 采样开销随序列长度增加而比例降低
4.1.2 第二阶段:基于分数的键值过滤
方法:
- 对采样的注意力分数沿列进行累积(列归约)
- 基于累积分数选择top-k键值索引
- 为每个头独立选择以满足CRA阈值α
优势:
- 列累积是注意力分数的统计近似
- 自适应发现”注意力汇”(attention sinks)
- 每个头的稀疏模式独立确定
4.2 自适应窗口大小
| 对比项 | 传统窗口注意力 | SampleAttention |
|---|---|---|
| 窗口大小 | 固定绝对值 | 序列长度的固定百分比 |
| 适应性 | 无法适应不同长度 | 自动适应各种上下文长度 |
| 灵活性 | 所有头相同 | 可与其他模式组合 |
4.3 硬件高效实现
- 算子融合:将bmm、softmax、归约等小算子融合,减少IO开销
- 修改FlashAttention:基于FlashAttention实现高效稀疏注意力kernel
- IO感知:通过减少KV内存传输实现加速
4.4 超参数设计
| 超参数 | 描述 | 调优方式 |
|---|---|---|
| α | CRA阈值 | 离线profiling单独确定 |
| r_{row} | 第一阶段采样率 | 离线profiling确定 |
| r_w% | 局部窗口比例 | 离线profiling确定 |
关键发现:通过轻量级离线profiling确定的固定超参数在不同任务上表现良好。使用包含22个请求(25K-96K上下文长度)的小数据集即可确定这些参数。
五、实验结果
5.1 实验设置
5.1.1 模型
| 模型 | 参数量 | 上下文窗口 | 架构基础 | 特点 |
|---|---|---|---|---|
| ChatGLM2-6B | 6B | 96K | GLM | 通过扩展序列长度继续训练扩展上下文 |
| InternLM2-7B | 7B | 200K | LLaMA2 | 通过rope scaling实现长度外推 |
5.1.2 评估任务
| 任务 | 描述 | 序列长度 | 评估方式 |
|---|---|---|---|
| LongBench | 多任务基准(QA、摘要、少样本学习、合成任务、代码补全) | 4K-35K | 4750+测试用例 |
| BABILong | 长上下文推理能力评估 | 4K-88K | 20种任务,灵活长度 |
| Needle in a Haystack | 从长文档中提取特定信息 | 10K-96K | 32个深度间隔 |
5.1.3 基线方法
| 方法 | 类型 | 设置 |
|---|---|---|
| Full Attention | 标准注意力 | 金标准 |
| BigBird | 窗口+全局+随机 | 窗口比例8%,全局比例8% |
| StreamingLLM | 注意力汇+近期令牌 | 窗口比例8%,初始注意力汇4令牌 |
| HyperAttention | LSH采样 | bucket_size=256, sampled_columns=256 |
| Hash-Sparse | 哈希稀疏 | bucket_number=16 |
SampleAttention设置:r_{row}=5%, α=0.95, r_w%=8%
5.2 精度结果
5.2.1 LongBench和BABILong结果
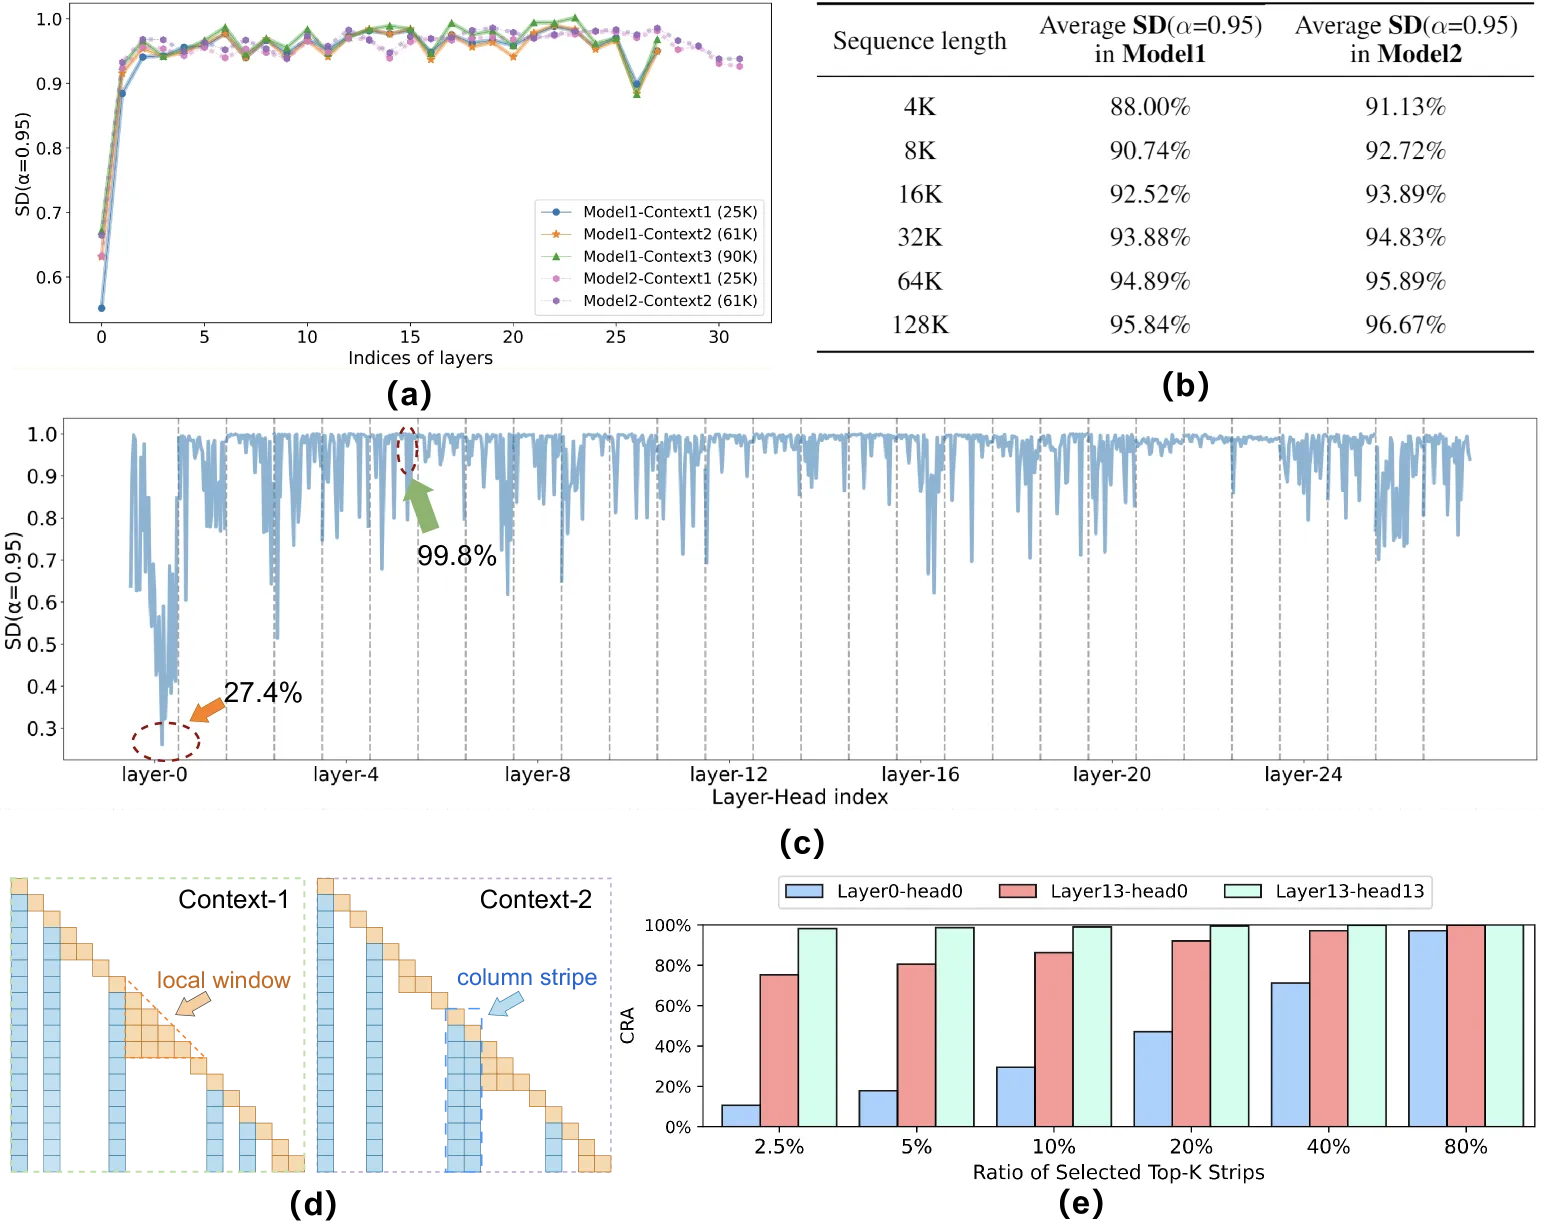
表2:不同稀疏方法在LongBench和BABILong上的精度对比
| 模型 | 方法 | LongBench总分 | BABILong总分 | 相对Full Attention |
|---|---|---|---|---|
| ChatGLM2-6B | Full Attention | 837.40 | 30.20 | 100% |
| SampleAttention (α=0.95) | 833.00 | 31.04 | 99.5% / 102.8% | |
| BigBird | 765.94 | 27.68 | 91.5% / 91.7% | |
| StreamingLLM | 519.27 | 14.60 | 62.0% / 48.3% | |
| HyperAttention | 508.94 | 17.00 | 60.8% / 56.3% | |
| Hash-Sparse | 364.49 | 11.20 | 43.5% / 37.1% | |
| InternLM2-7B | Full Attention | 685.46 | 35.24 | 100% |
| SampleAttention (α=0.95) | 686.86 | 36.88 | 100.2% / 104.7% | |
| BigBird | 637.04 | 34.12 | 92.9% / 96.8% | |
| StreamingLLM | 319.55 | 5.96 | 46.6% / 16.9% | |
| HyperAttention | 336.57 | 16.64 | 49.1% / 47.2% | |
| Hash-Sparse | 156.84 | 2.82 | 22.9% / 8.0% |
关键发现:
- SampleAttention在所有基准上持续保持稳健性能,精度保持在Full Attention的99%以上
- 在某些任务上(如BABILong)甚至超过Full Attention
- 其他方法在不同任务上存在不同程度的性能退化
5.2.2 Needle in a Haystack结果
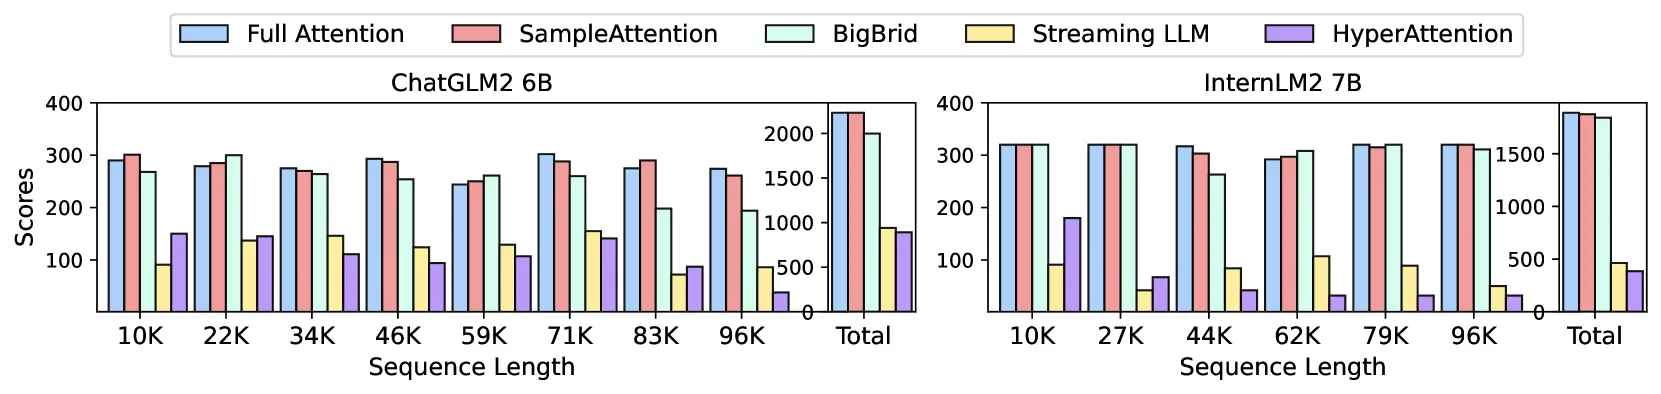
图4:不同方法在各种长度”Needle in a Haystack”任务上的得分
SampleAttention在不同序列长度下均能稳定完成针 haystack测试,而其他基线方法在较长序列上性能显著下降。
5.3 超参数消融研究
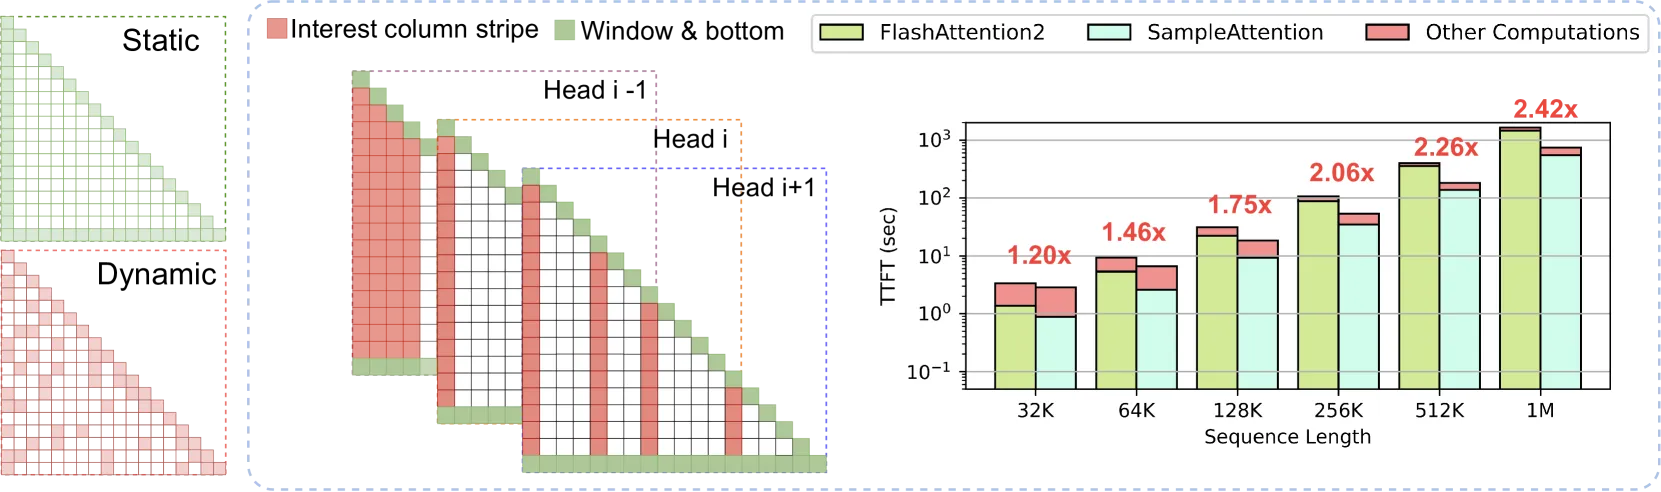
表3:ChatGLM2-6B上三个超参数的变化结果
| 任务 | Full Attention | α=0.80 | α=0.90 | α=0.95 | α=0.98 | r_w=4 | r_w=8 | r_row=2% | r_row=5% | r_row=10% |
|---|---|---|---|---|---|---|---|---|---|---|
| LongBench | 837.40 | 820.30 | 824.98 | 833.00 | 829.80 | 792.87 | 833.00 | 809.34 | 833.00 | 831.14 |
| BABILong | 30.20 | 27.28 | 29.08 | 31.04 | 31.16 | 31.12 | 31.04 | 28.92 | 31.04 | 30.64 |
| Needle | 2235 | 2130 | 2090 | 2239 | 2231 | 2084 | 2239 | 2106 | 2239 | 2231 |
分析:
- CRA阈值α:α过低导致性能下降,α=0.95时性能稳定
- 局部窗口比例r_w:减半(r_w=4)导致LongBench和Needle任务性能下降超过6%
- 采样比例r_row:降至2%导致约4.5%性能损失,但达到一定阈值后性能稳定
5.4 加速性能基准测试
5.4.1 单GPU性能
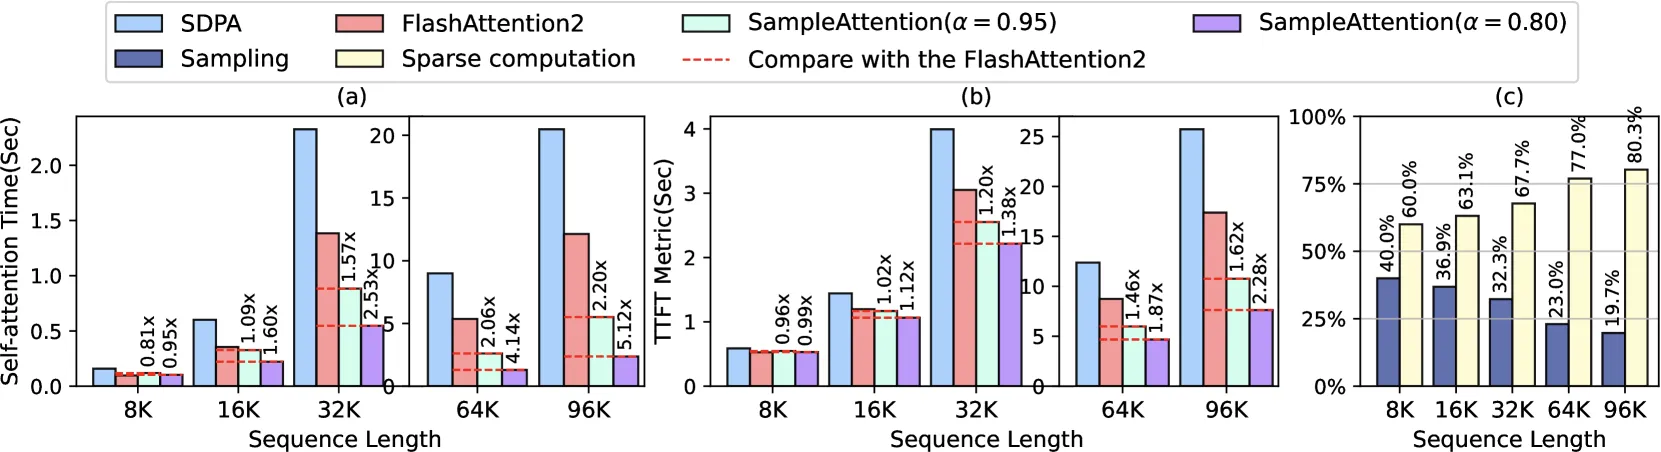
图5:(a)自注意力模块延迟对比;(b)采样和稀疏计算的时间占比;(c)TTFT指标对比
测试环境:单NVIDIA A100 GPU (80GB),ChatGLM2-6B配置(32头,d=128)
| 序列长度 | 方法 | 注意力延迟加速 | TTFT加速 |
|---|---|---|---|
| 96K | SampleAttention (α=0.95) | 2.20× | 1.62× |
| 96K | SampleAttention (α=0.80) | 5.12× | 2.28× |
关键观察:
- 短序列时采样开销导致无加速优势
- 长序列(96K)时显著加速,因为KV内存传输节省明显
- 采样开销占比随序列长度增加而降低
5.4.2 扩展到1M序列长度
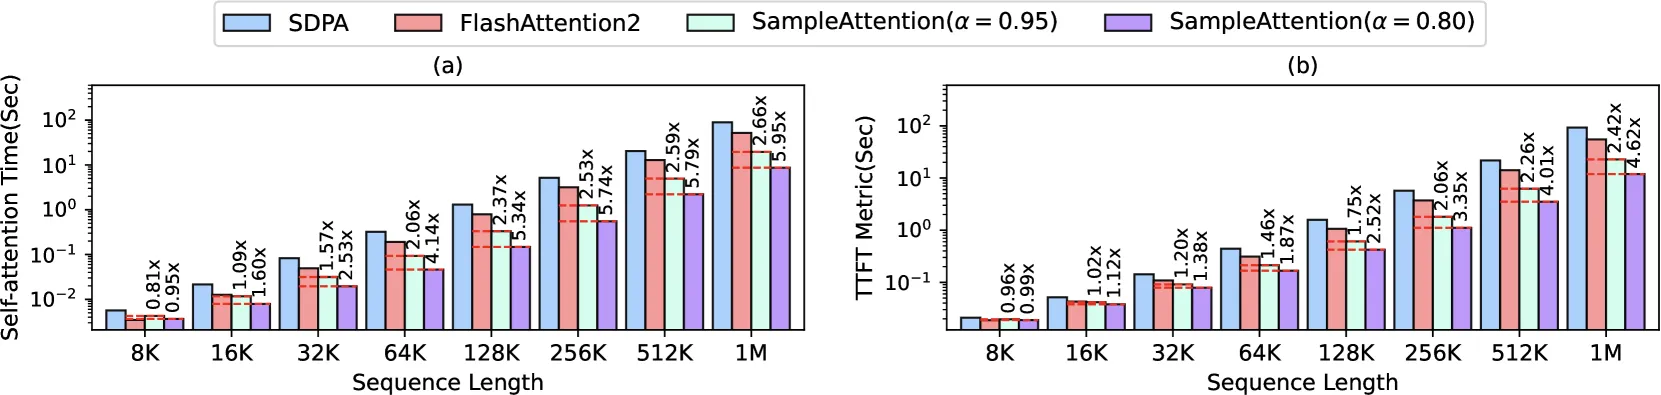
图6:(a)和(b)分别比较序列从8K扩展到1M时的注意力延迟和TTFT指标
| 序列长度 | α=0.95 TTFT加速 | α=0.80 TTFT加速 |
|---|---|---|
| 1M | 2.27× | 4.62× |
关键发现:
- SampleAttention可以扩展到100万令牌的超长序列
- 在1M序列长度下,α=0.95实现2.27倍TTFT加速
- 更激进的稀疏度(α=0.80)可实现4.62倍加速
六、相关工作
6.1 近似注意力方法
| 方法 | 技术路线 | 局限性 |
|---|---|---|
| BigBird | 窗口+全局+随机注意力 | 静态模式,需微调 |
| Reformer | 局部敏感哈希 | 粗粒度稀疏,忽略头特异性 |
| LongNet | 扩张注意力 | 固定模式 |
| Linformer | 低秩矩阵近似 | 需要重新训练 |
| HyperAttention | LSH识别重要条目 | 粗粒度近似 |
| Sparse Transformer | 固定稀疏模式 | 不能适应不同头 |
SampleAttention的差异化:
- 自适应、头特异性、内容感知
- 无需微调或重新训练
- 硬件高效的结构化稀疏
6.2 KV缓存压缩方法
| 方法 | 目标 | 与SampleAttention的关系 |
|---|---|---|
| StreamingLLM | 无限生成场景的内存优化 | 正交,可组合 |
| H2O | 解码阶段动态保留重要令牌 | 正交,可组合 |
| FastGen | 根据头策略自适应构建KV缓存 | 正交,可组合 |
| KV缓存量化 | 降低精度减少内存 | 正交,可组合 |
关键区别:
- 上述方法主要关注减少KV缓存内存消耗(解码阶段)
- SampleAttention关注减少长上下文计算开销(prefill阶段)
- 两者正交,可以组合使用
七、总结
7.1 主要贡献
-
理论基础:
- 提出近无损稀疏注意力的理论框架
- 定义CRA和SD等关键度量指标
- 证明结构化稀疏掩码保持近无损特性
-
实证发现:
- 揭示注意力稀疏性的三个特性:固有高稀疏度、头特异性、内容感知性
- 识别两种显著稀疏模式:局部窗口和列条纹
-
方法创新:
- 提出两阶段查询引导键值过滤
- 设计自适应窗口大小机制
- 实现硬件高效kernel
-
实用价值:
- 即插即用,无需微调
- 在多个基准上验证近无损精度
- 实现最高2.42倍TTFT加速(FlashAttention对比)
7.2 局限性与未来方向
根据论文附录讨论:
- 当前实现主要针对prefill阶段
- 可进一步与KV缓存压缩方法结合
- 探索更高效的采样策略
- 扩展到更多模型架构
7.3 核心洞察
“注意力稀疏性是固有高、头特异性和内容感知的,呈现显著的局部窗口和列条纹模式。这种自适应稀疏性表明,稀疏注意力应在运行时动态捕获自适应稀疏模式才能实现近无损。“
八、参考资源
8.1 论文链接
| 资源 | 链接 |
|---|---|
| arXiv页面 | https://arxiv.org/abs/2406.15486 |
| PDF下载 | https://arxiv.org/pdf/2406.15486 |
| HTML版本 | https://arxiv.org/html/2406.15486v3 |
8.2 关键图表
| 图表 | 文件名 | 描述 |
|---|---|---|
| 图1 | figure1_ttft_comparison.png | 稀疏注意力模式和TTFT延迟加速对比 |
| 图2 | figure2_sparsity_stats.png | ChatGLM-6B和InternLM2-7B的稀疏性统计 |
| 图3 | figure3_sampleattention_method.png | SampleAttention两阶段方法示意图 |
| 图4 | figure4_needle_haystack.png | Needle in a Haystack任务结果 |
| 图5 | figure5_speedup_benchmark.png | 加速性能基准测试 |
| 图6 | figure6_scaling_1m.png | 扩展到1M序列长度的性能 |
8.3 相关代码与实现
论文提到了基于以下技术的实现:
- FlashAttention:作为稀疏注意力kernel的基础
- PyTorch:参考算法实现见附录A.7
- CUDA:硬件高效kernel实现
8.4 引用信息
@article{zhu2024sampleattention,
  title={SampleAttention: Near-Lossless Acceleration of Long Context LLM Inference with Adaptive Structured Sparse Attention},
  author={Zhu, Qianchao and Duan, Jiangfei and Chen, Chang and Liu, Siran and Li, Xiuhong and Feng, Guanyu and Lv, Xin and Cao, Huanqi and Xiao, Chuanfu and Zhang, Xingcheng and Lin, Dahua and Yang, Chao},
  journal={arXiv preprint arXiv:2406.15486},
  year={2024}
}
8.5 关键术语表
| 术语 | 英文 | 定义 |
|---|---|---|
| 首令牌时间 | Time-to-First-Token (TTFT) | 从输入到生成第一个输出令牌的延迟 |
| 累积残余注意力 | Cumulative Residual Attention (CRA) | 稀疏化后每行保留的最小注意力概率和 |
| 稀疏度 | Sparsity Degree (SD) | 满足CRA阈值下可丢弃的最大键值比例 |
| 注意力汇 | Attention Sinks | 在所有查询中都获得高分的键值位置 |
| 列条纹模式 | Column Stripe Pattern | 某些列在所有行中都有高注意力分数的模式 |
| 局部窗口模式 | Local Window Pattern | 相邻令牌具有高注意力分数的模式 |
文档生成日期:2026年5月30日 数据来源:arXiv:2406.15486v3