ReaL: Efficient RLHF Training of Large Language Models with Parameter Reallocation
ReaL提出基于参数重分配的高效RLHF训练框架,通过动态调整GPU间的参数分布优化大语言模型对齐训练。
ReaL: Efficient RLHF Training of Large Language Models with Parameter Reallocation
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | ReaL: Efficient RLHF Training of Large Language Models with Parameter Reallocation |
| 作者 | Zhiyu Mei, Wei Fu, Kaiwei Li, Guangju Wang, Huanchen Zhang, Yi Wu |
| 机构 | - |
| 发表时间 | 2024年6月20日 (arXiv), 2025年 (MLSys) |
| arXiv ID | 2406.14088 |
| 代码 | https://github.com/openpsi-project/ReaLHF |
1.2 摘要
ReaL是一个用于高效RLHF训练的系统,通过**参数重分配(Parameter Reallocation)**技术动态调整训练过程中的并行策略。该系统在LLaMA模型上进行了评估,最高支持700亿参数和128个GPU,相比基线方法实现了最高3.58倍的加速,在长上下文场景下比基于Megatron-LM的启发式方法平均提升81%的性能。
二、核心思想
2.1 问题背景
RLHF训练过程比监督训练复杂得多,涉及四个LLM实例的协同工作:
| 模型 | 功能 | 说明 |
|---|---|---|
| Actor | 生成+训练 | 主要训练目标,生成响应并更新参数 |
| Critic | 推理+训练 | 评估Actor生成的响应质量 |
| Reward | 推理 | 提供奖励信号 |
| Reference | 推理 | 提供参考分布用于KL散度计算 |
2.2 现有方法的局限性
| 问题 | 描述 |
|---|---|
| 对称并行化 | 所有模型使用相同的并行策略,导致过度并行化和大量同步通信开销 |
| 非对称并行化 | 不同模型分配到不同GPU,但固定分配导致GPU利用率低下 |
| 固定设备分配 | 训练过程中模型在GPU上的分配不变,无法适应不同工作负载 |
2.3 核心创新:参数重分配
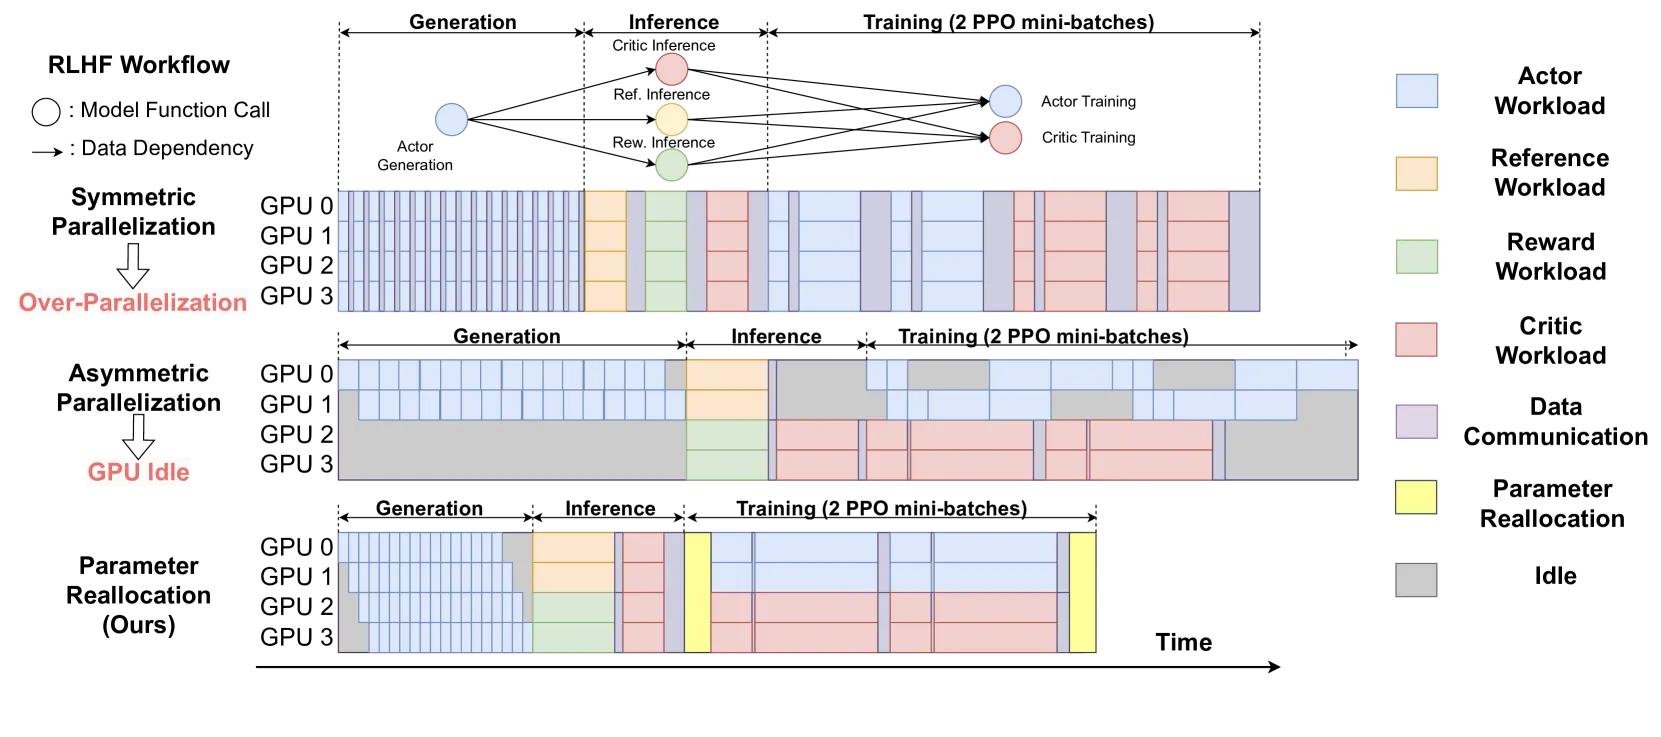 图1:RLHF迭代分解,展示三种不同并行策略的执行时间线
核心思想是动态地在训练过程中重新分配模型参数到不同GPU,为每个模型函数调用选择最优的并行策略:
- 为每个函数调用(生成、推理、训练)选择最适合的并行策略
- 在不重叠的函数调用之间实现并行执行
- 通过参数重分配消除冗余通信
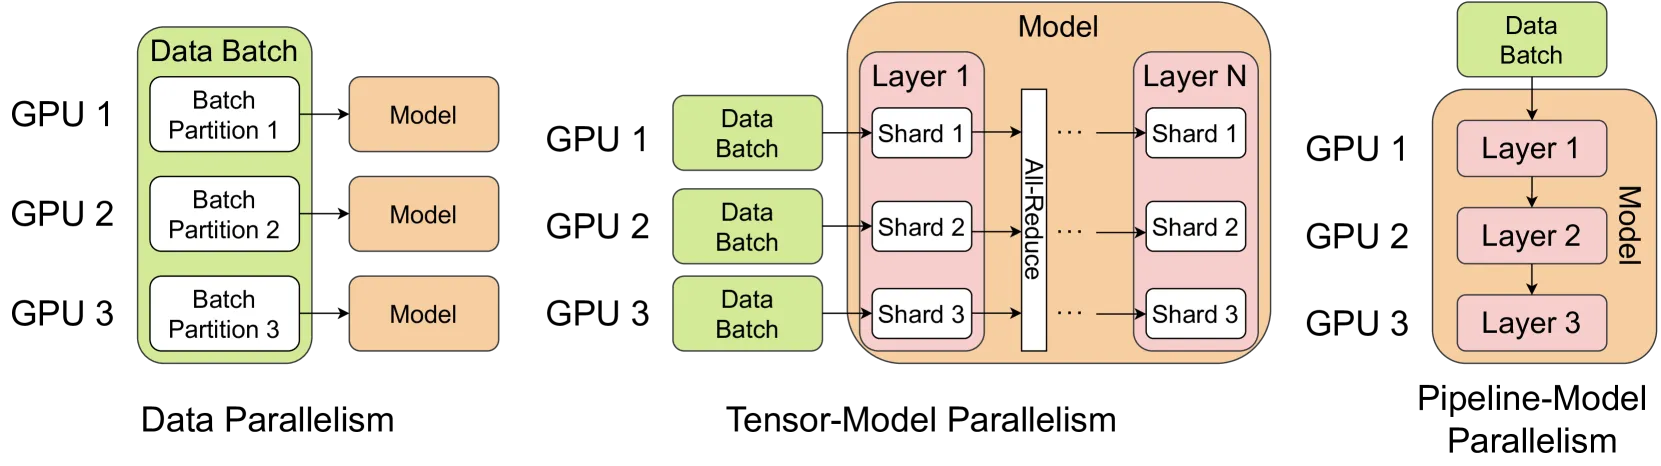 图2:基于3D并行执行计划的优化机会,展示通过优化推理并行策略、重新分配Critic工作负载和Actor工作负载的逐步改进
三、技术架构
3.1 系统架构总览
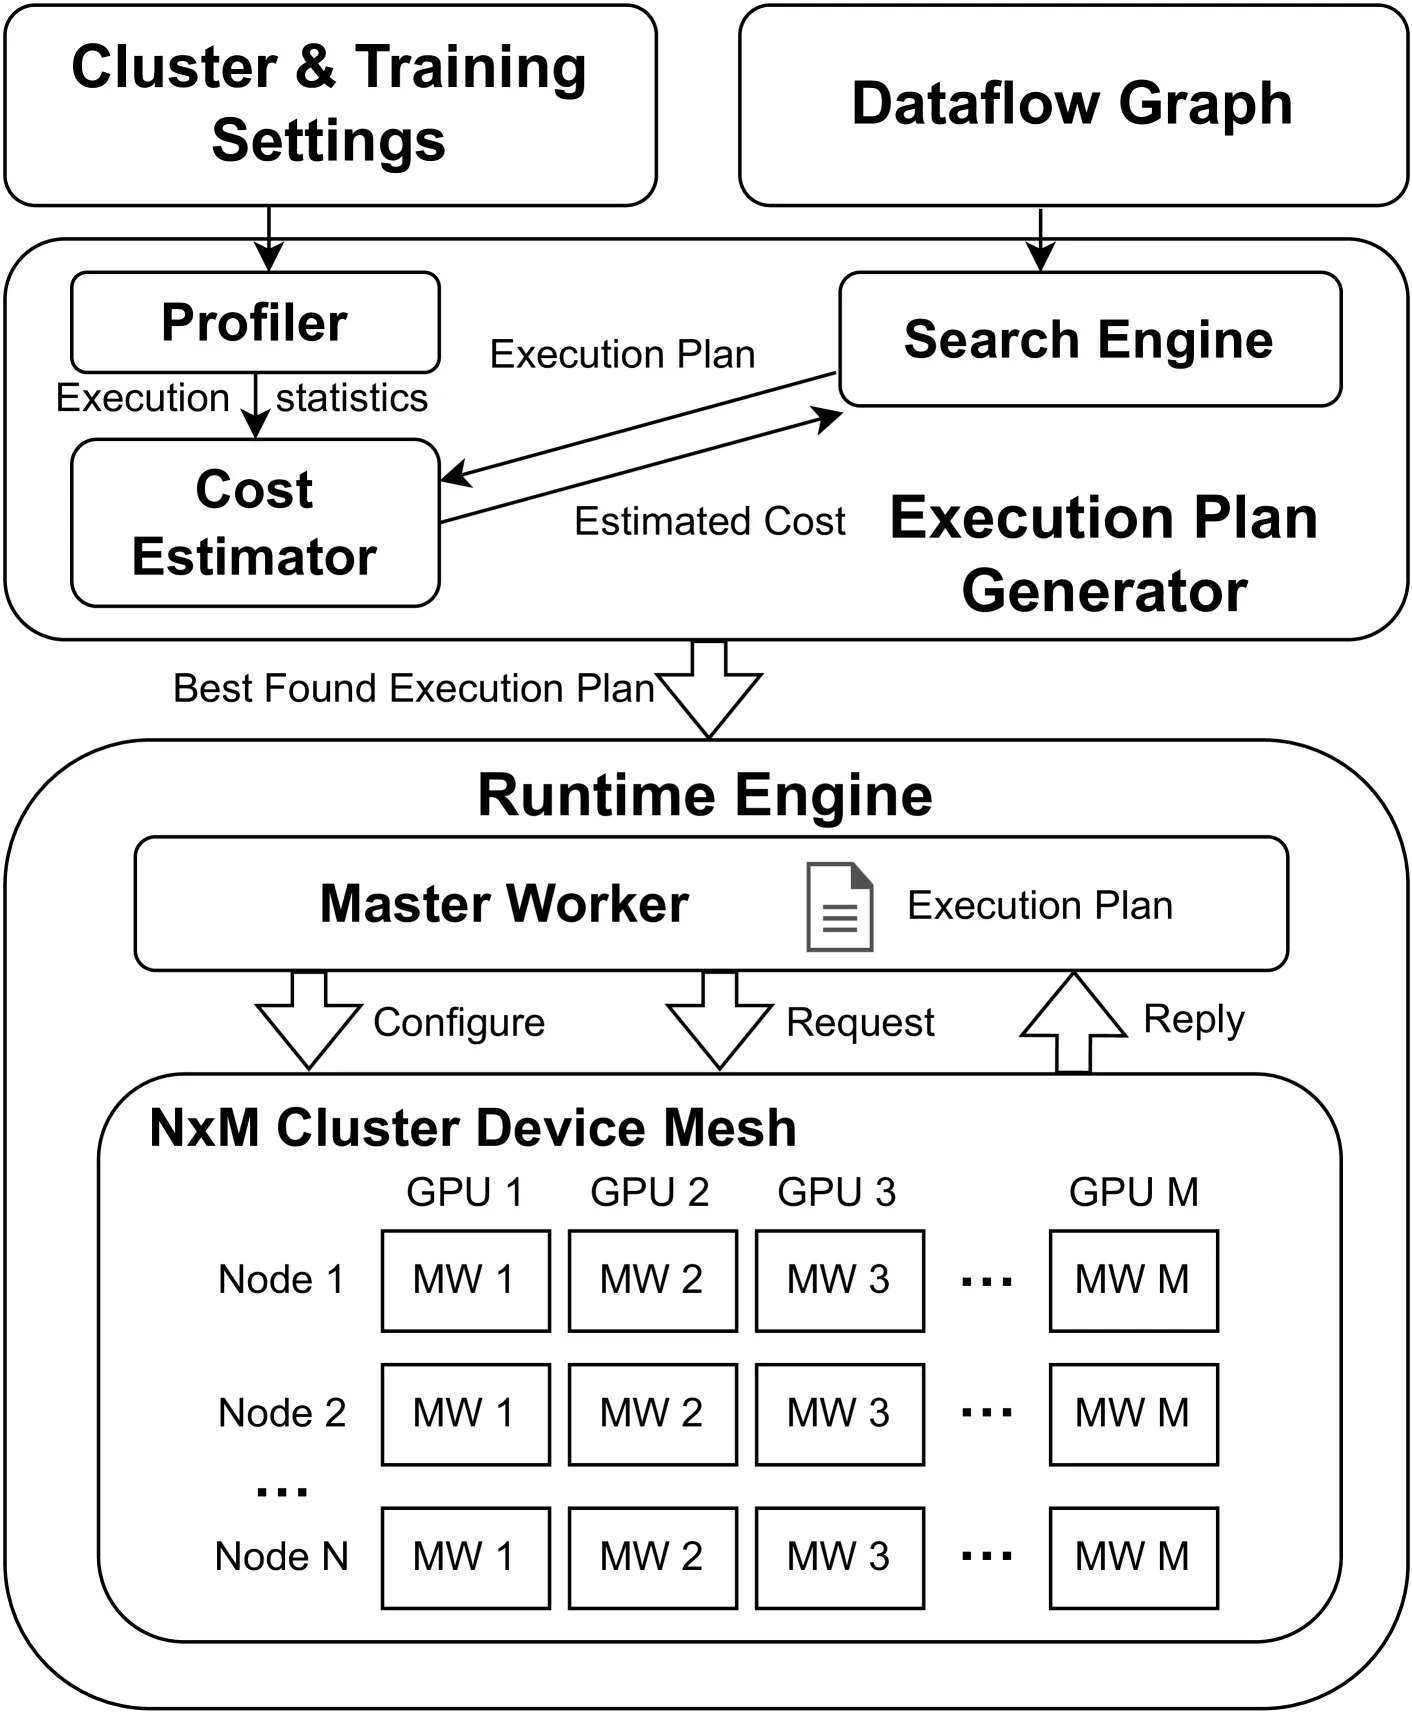 图3:ReaLHF系统架构总览
ReaL由两个核心组件构成:
| 组件 | 功能 |
|---|---|
| 执行计划生成器 | 使用MCMC采样搜索最优执行计划 |
| 运行时引擎 | 部署执行计划,实现并行计算和参数重分配 |
3.2 执行计划(Execution Plan)
执行计划定义为增强数据流图,包含:
- 资源分配:每个函数调用使用的GPU数量和位置
- 并行策略:3D并行参数 (dp, tp, pp)
- 执行顺序:函数调用之间的依赖关系和并发可能性
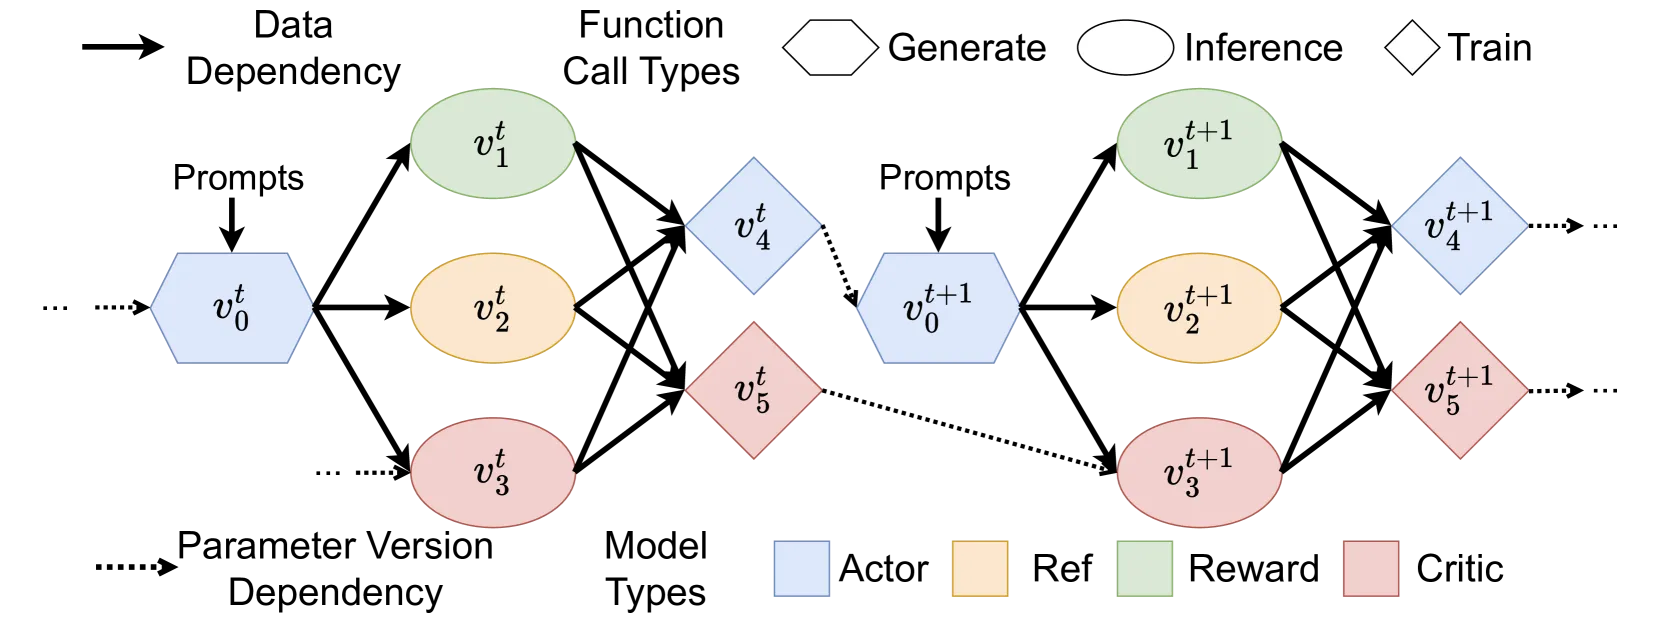 图4:两个连续RLHF迭代的数据流图,每个模型是独立的LLM,每个模型函数调用是模型的计算任务
3.3 并行策略空间
系统支持的3D并行策略:
| 维度 | 全称 | 说明 |
|---|---|---|
| DP | Data Parallelism | 数据并行,不同数据批次 |
| TP | Tensor Parallelism | 张量并行,层内分割 |
| PP | Pipeline Parallelism | 流水线并行,层间分割 |
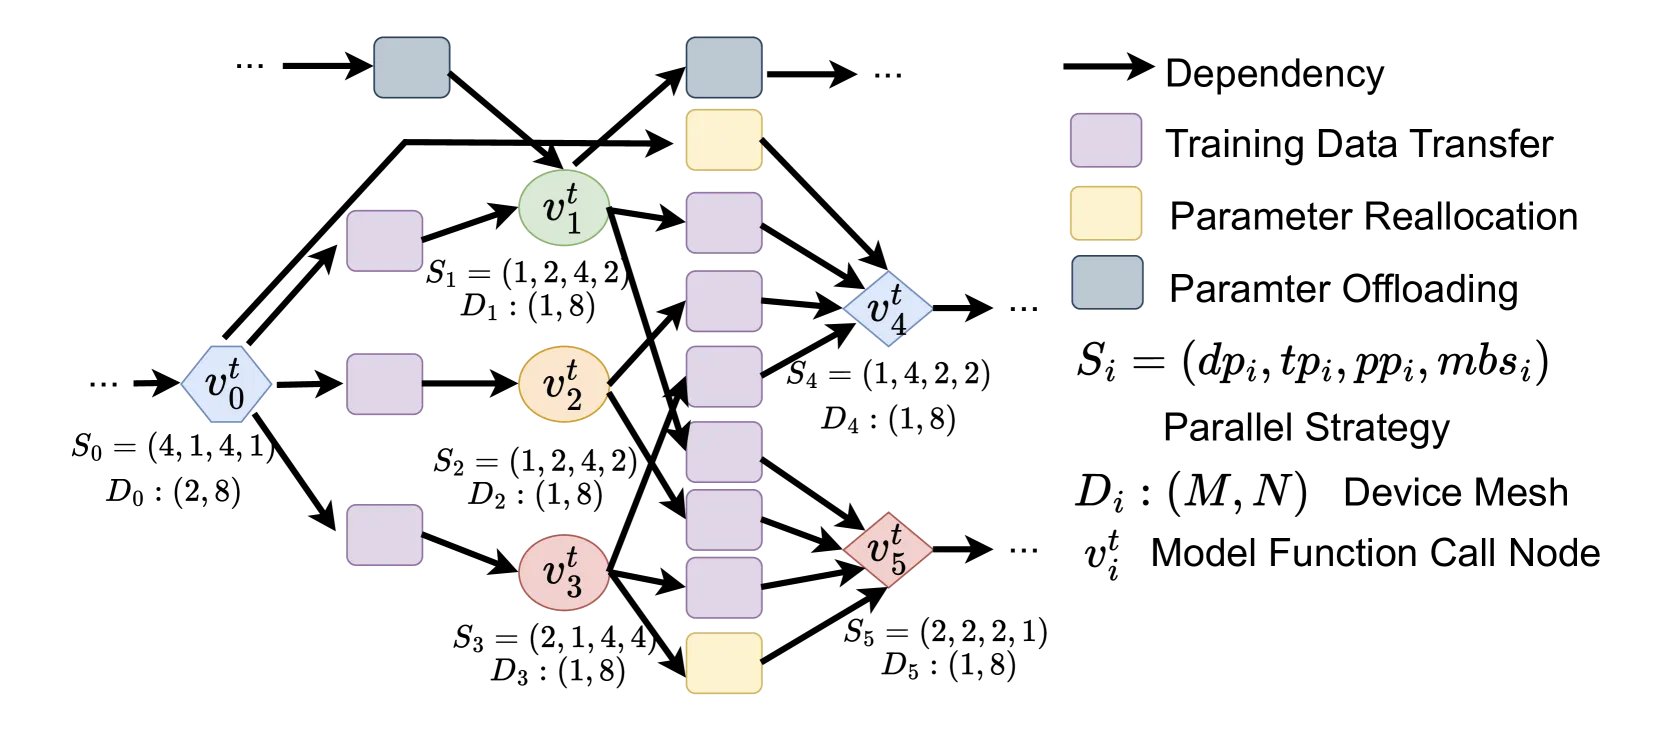 图5:执行计划实例的增强数据流图,展示第t次RLHF迭代中的资源分配和并行策略
3.4 设备网格(Device Mesh)
设备网格定义为GPU的二维网格,形状为(N,M),覆盖N个节点,每个节点配备M个设备。相同形状的设备网格可以有不同的位置。
四、核心创新
4.1 执行计划搜索算法
搜索过程基于MCMC采样:
| 步骤 | 说明 |
|---|---|
| 1. 成本估计 | 使用轻量级profiler估算执行时间 |
| 2. 候选生成 | 随机修改当前计划生成候选 |
| 3. 接受/拒绝 | 基于Metropolis-Hastings准则决定是否接受 |
| 4. 迭代优化 | 重复直到找到满意计划 |
4.2 运行时引擎
运行时引擎的关键技术:
| 技术 | 说明 |
|---|---|
| Worker管理 | 动态创建和管理模型Worker |
| 参数重分布 | 高效地在GPU之间传输模型参数 |
| 数据传输优化 | 减少函数调用之间的数据传输开销 |
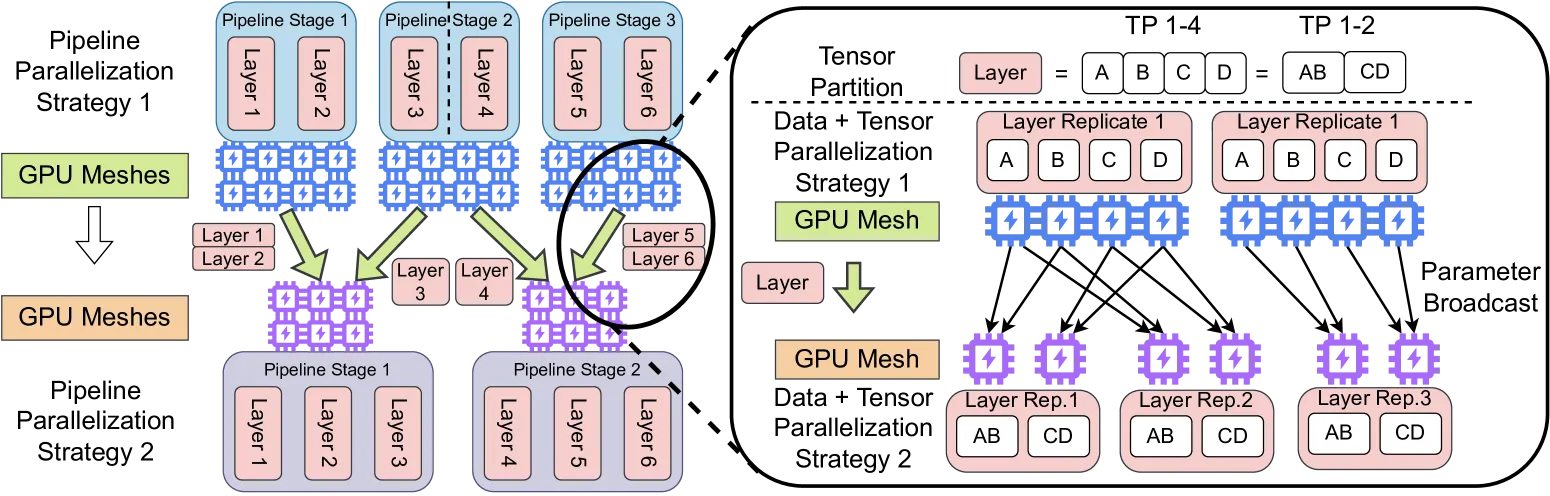 图6:参数重分布的层次化过程。外层循环中,每对流水线阶段通信它们共同层的参数;内层循环中,层从一个DP+TP网格重新映射到另一个
4.3 案例分析
表6展示了ReaL为7B Actor + 34B Critic配置生成的执行计划:
| 函数调用 | 设备分配 | 并行策略 (dp, tp, pp) |
|---|---|---|
| Actor Gen. | Node[1-2] | (8, 1, 2) |
| Actor Train | Node[1-2] | (2, 1, 8) |
| Critic Train | Node[3-4] | (1, 4, 4) |
| Critic Inf. | Node[3-2] | (2, 2, 4) |
| Reward Inf. | Node[1-2] | (1, 2, 8) |
| Reference Inf. | Node[1-2] | (4, 4, 1) |
关键观察:ReaL将Actor和Critic分配到不同的设备子集,使得Actor生成和Critic训练可以跨迭代重叠执行。
五、实验结果
5.1 实验设置
| 参数 | 值 |
|---|---|
| 模型规模 | 7B, 13B, 34B, 70B (LLaMA-3) |
| GPU数量 | 8, 16, 32, 64, 128 |
| 生成长度 | 128, 384, 896 |
| 批次大小 | 512, 256, 128 |
| PPO mini-batches | 4 |
| 基线系统 | DeepSpeed-Chat, OpenRLHF |
5.2 端到端性能
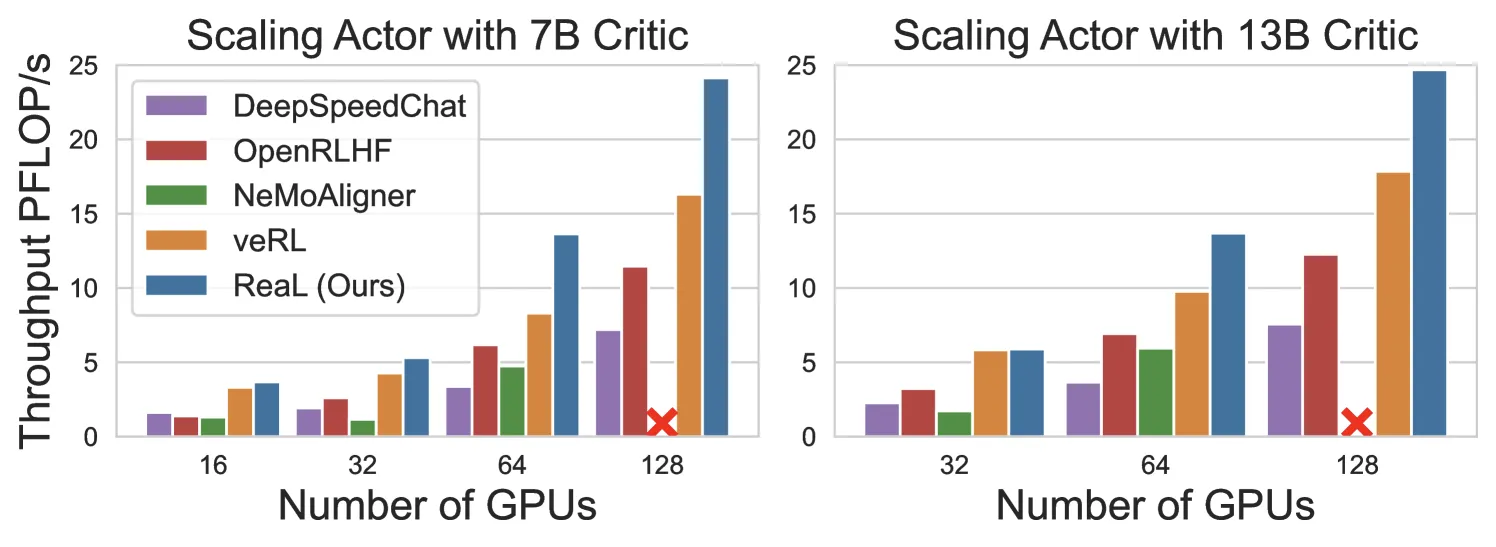 图7:与基线系统的端到端吞吐量对比,红色叉号表示由可扩展性问题导致的不稳定和OOM错误
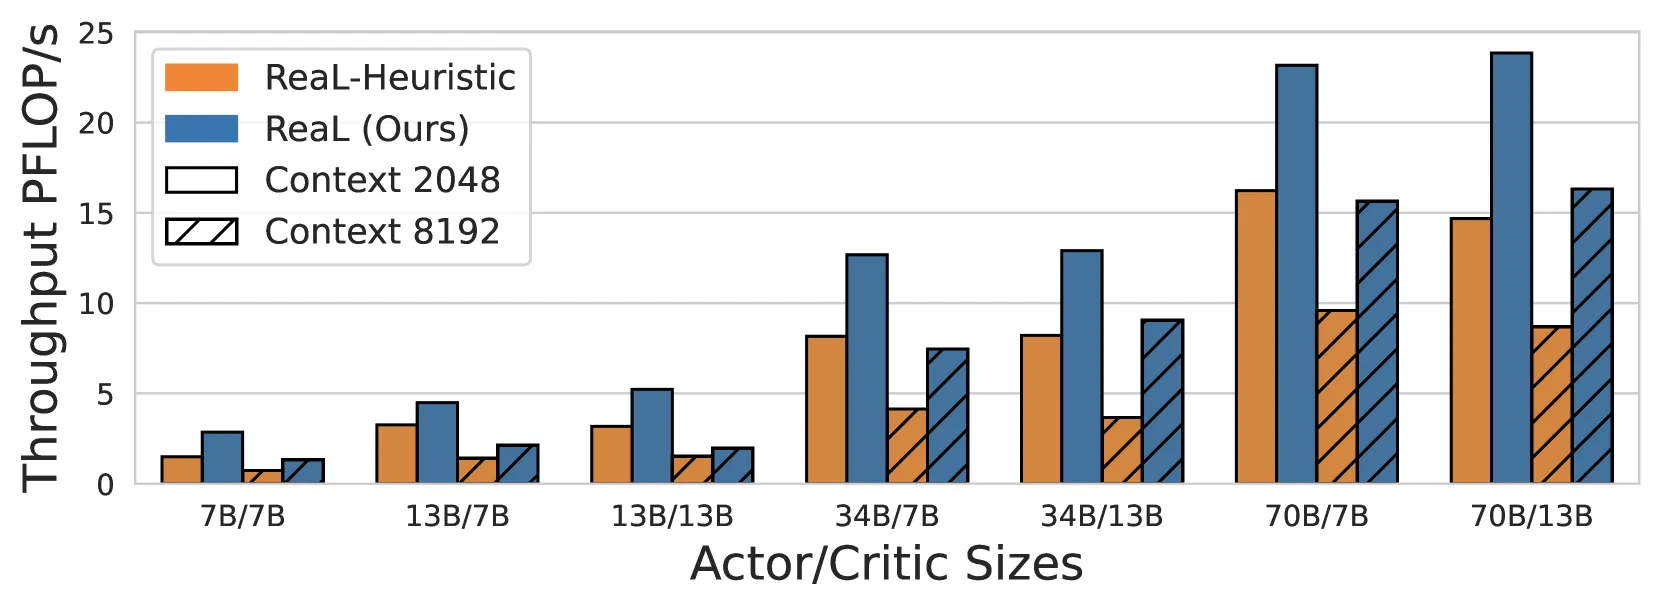 图8:不同上下文长度下与启发式执行计划的吞吐量对比
| 指标 | 结果 |
|---|---|
| 相对基线加速 | 最高3.58x |
| 相对启发式方法提升 | 平均54% |
| 长上下文场景提升(8192 tokens) | 平均81% |
表3:70B模型完整RLHF训练预估时间
| 系统 | 预估时间(小时) |
|---|---|
| DSChat | 141.5 |
| OpenRLHF | 152.8 |
| ReaL-Heuristic | 21.2 |
| ReaL | 17.0 |
5.3 性能分解分析
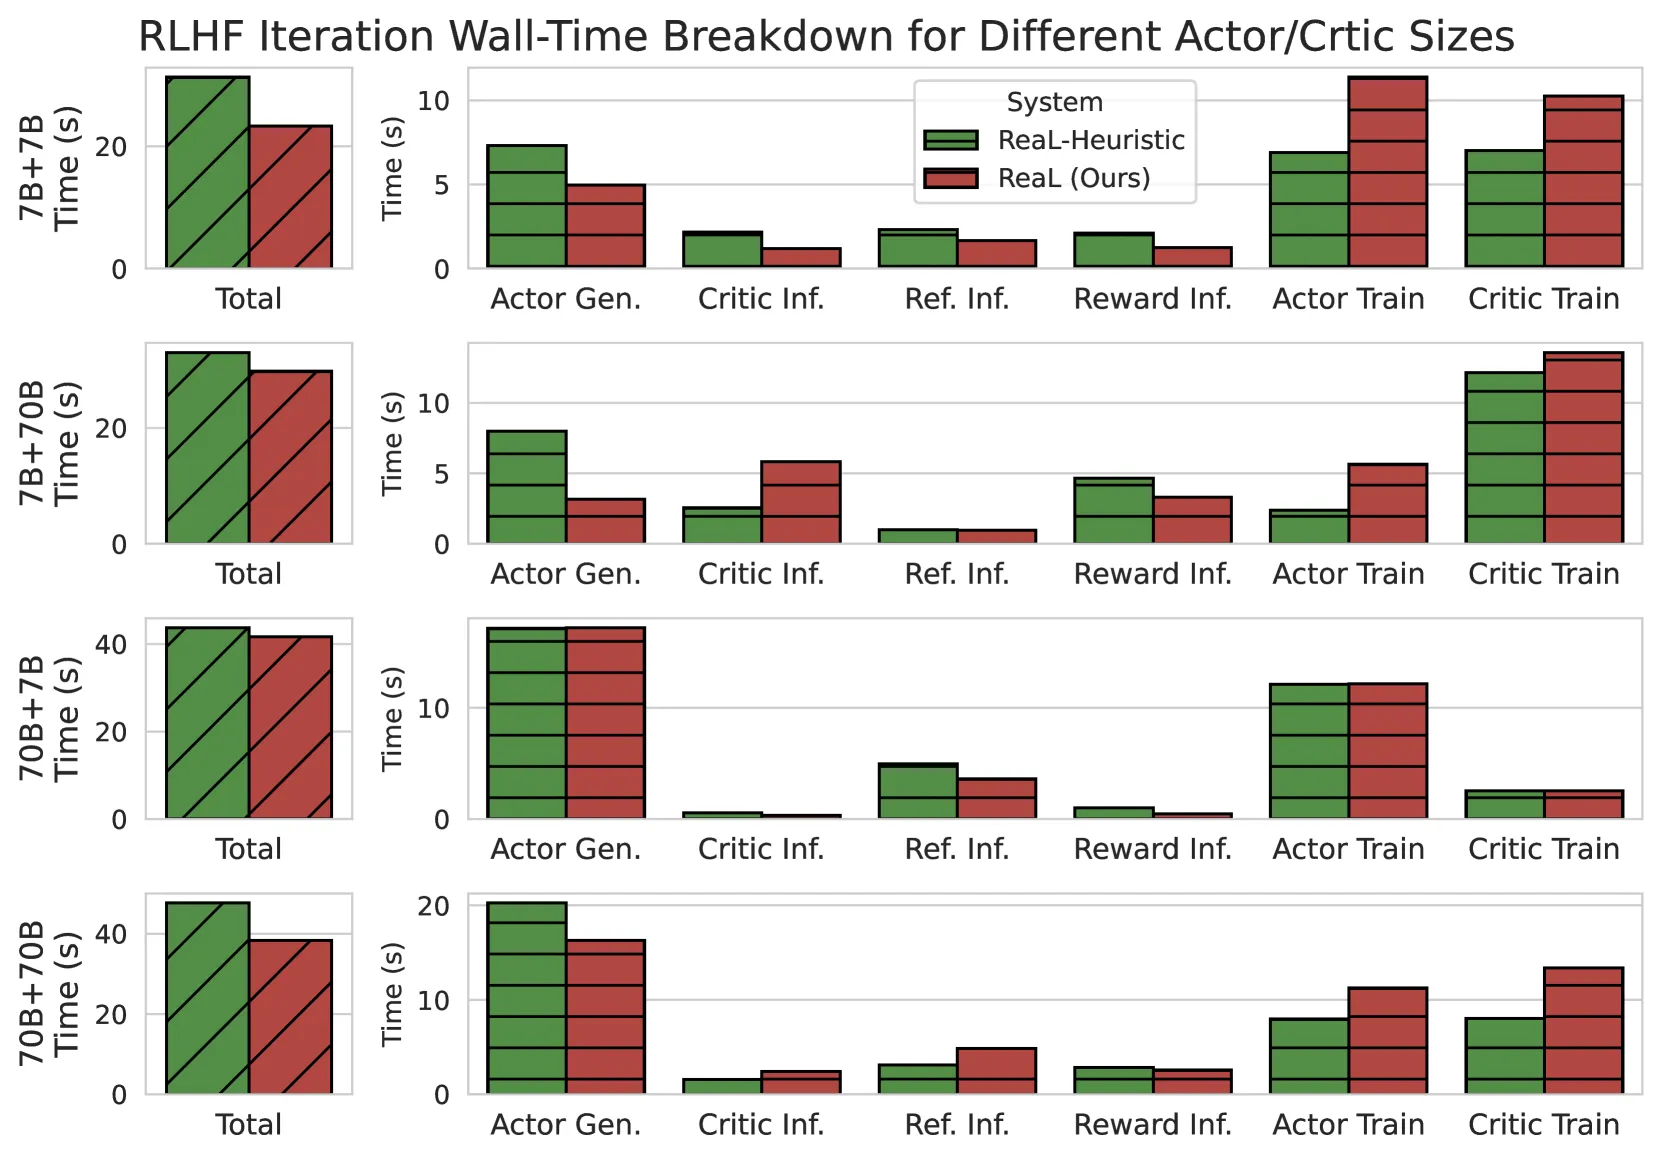 图9:7B+7B和70B+7B配置下一次训练步骤的墙钟时间,展示不同优化级别的效果
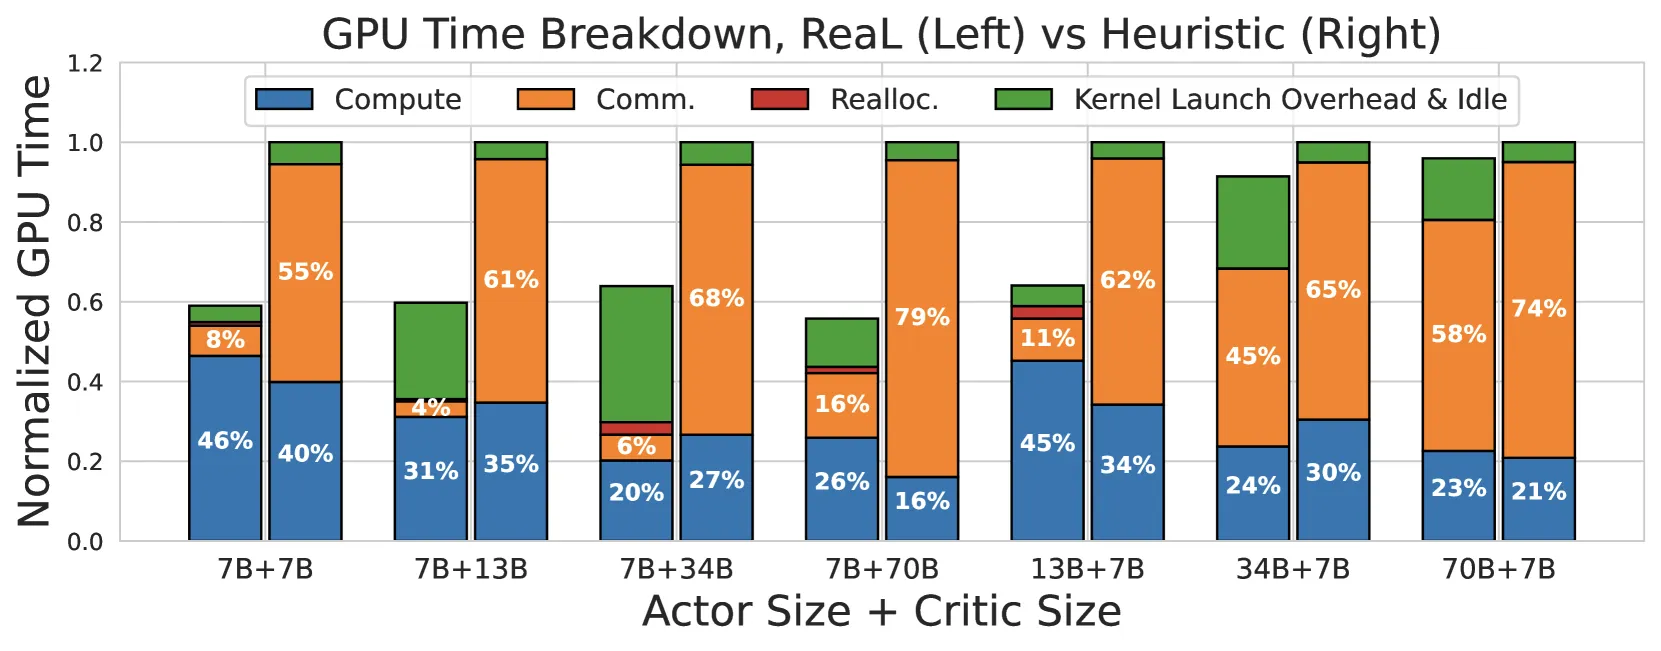 图10:完成相同解码或训练计算量的Transformer层的简化内核追踪。上方追踪为ReaL,下方为ReaL-Heuristic
性能提升来源:
| 来源 | 说明 |
|---|---|
| 通信开销减少 | 通过选择最优并行策略减少TP和PP通信 |
| 内存IO减少 | 减少计算内核的内存IO时间 |
| GPU利用率提升 | 并发执行不重叠的函数调用 |
| 参数传输开销 | 仅占总GPU时间的2.2%,可忽略 |
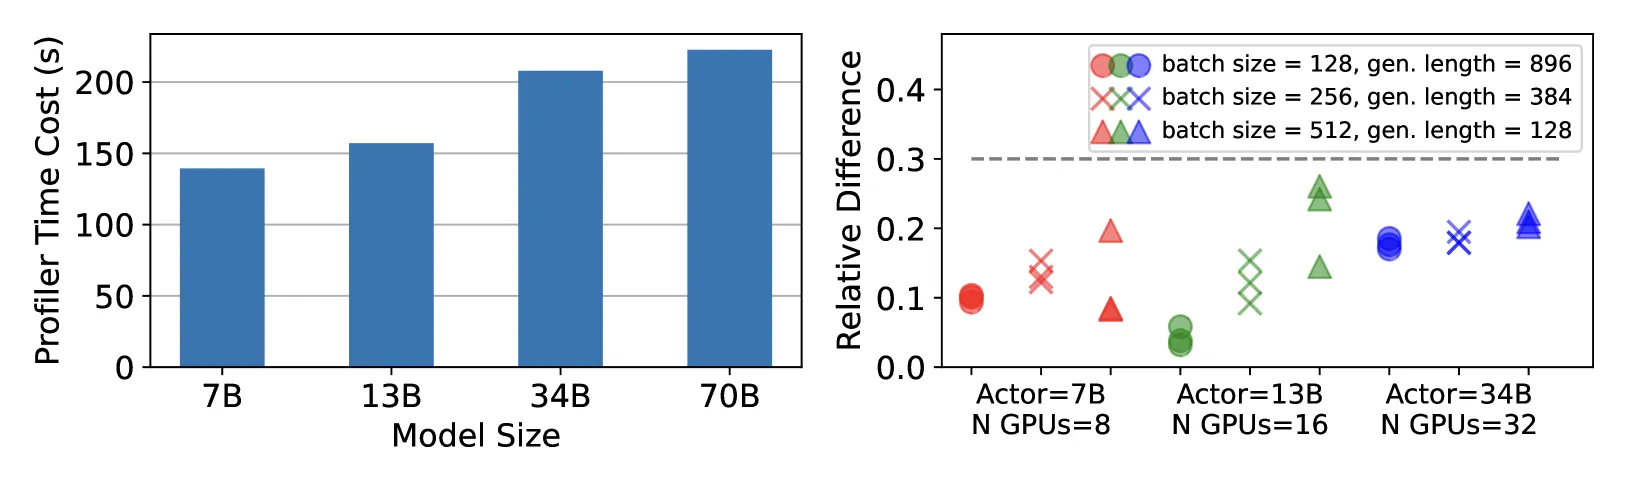 图11:ReaL(左)和ReaL-Heuristic(右)的RLHF迭代CUDA内核时间统计。ReaL有效消除了并行化开销
5.4 搜索算法评估
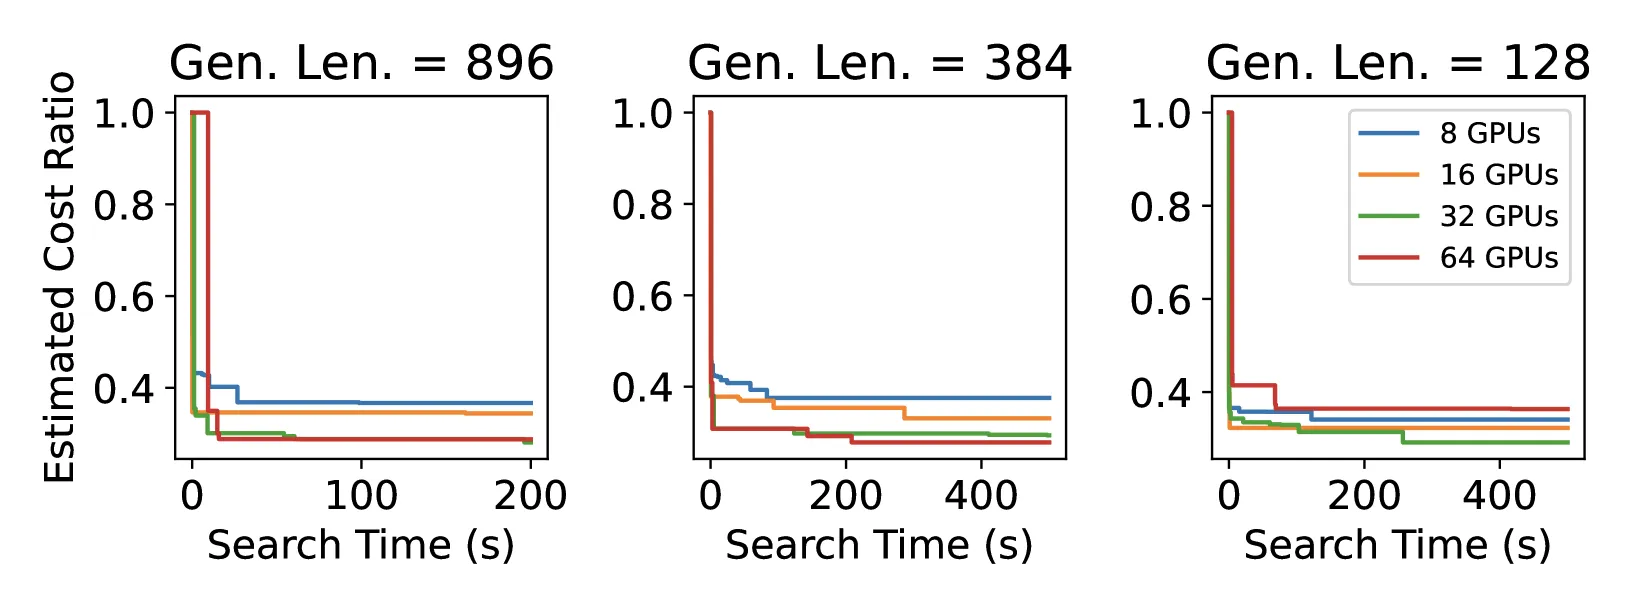 图12:(左)成本估计前的profiling时间;(右)估计器产生的估计时间成本与执行计划的实际时间成本对比
| 评估项 | 结果 |
|---|---|
| Profiling时间 | 每个模型<4分钟 |
| 估计精度 | 相对误差最大28% |
| 搜索时间 | 最优计划在5分钟内找到 |
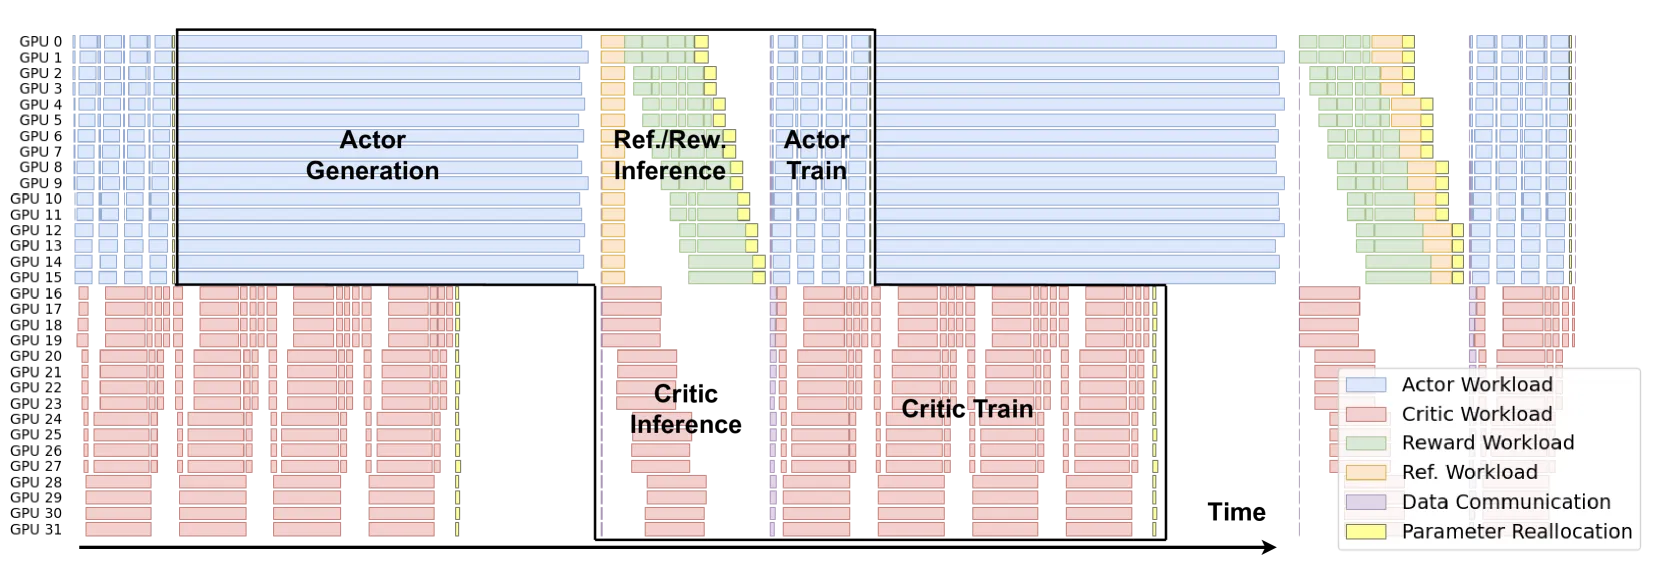 图13:搜索过程中发现的最优执行计划相对于初始计划的时间成本改进比率
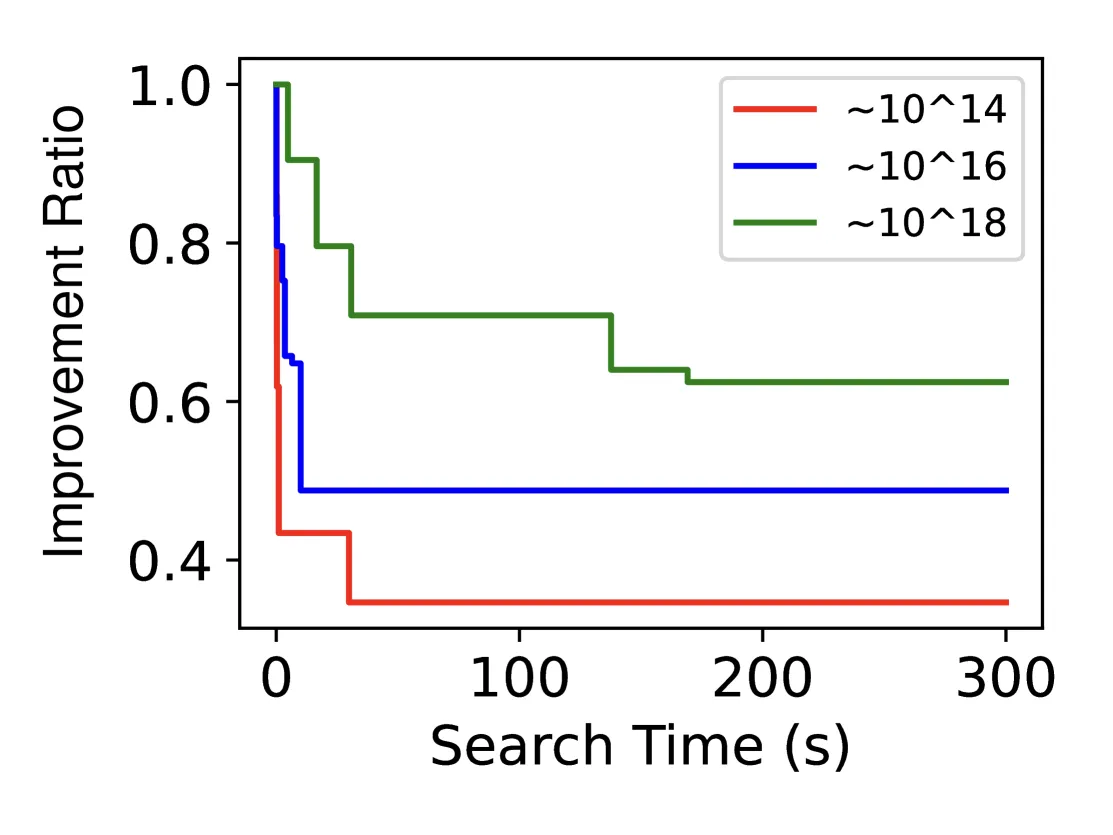 图14:在1024 GPU设置下MCMC搜索算法的性能,展示不同搜索空间大小的收敛情况
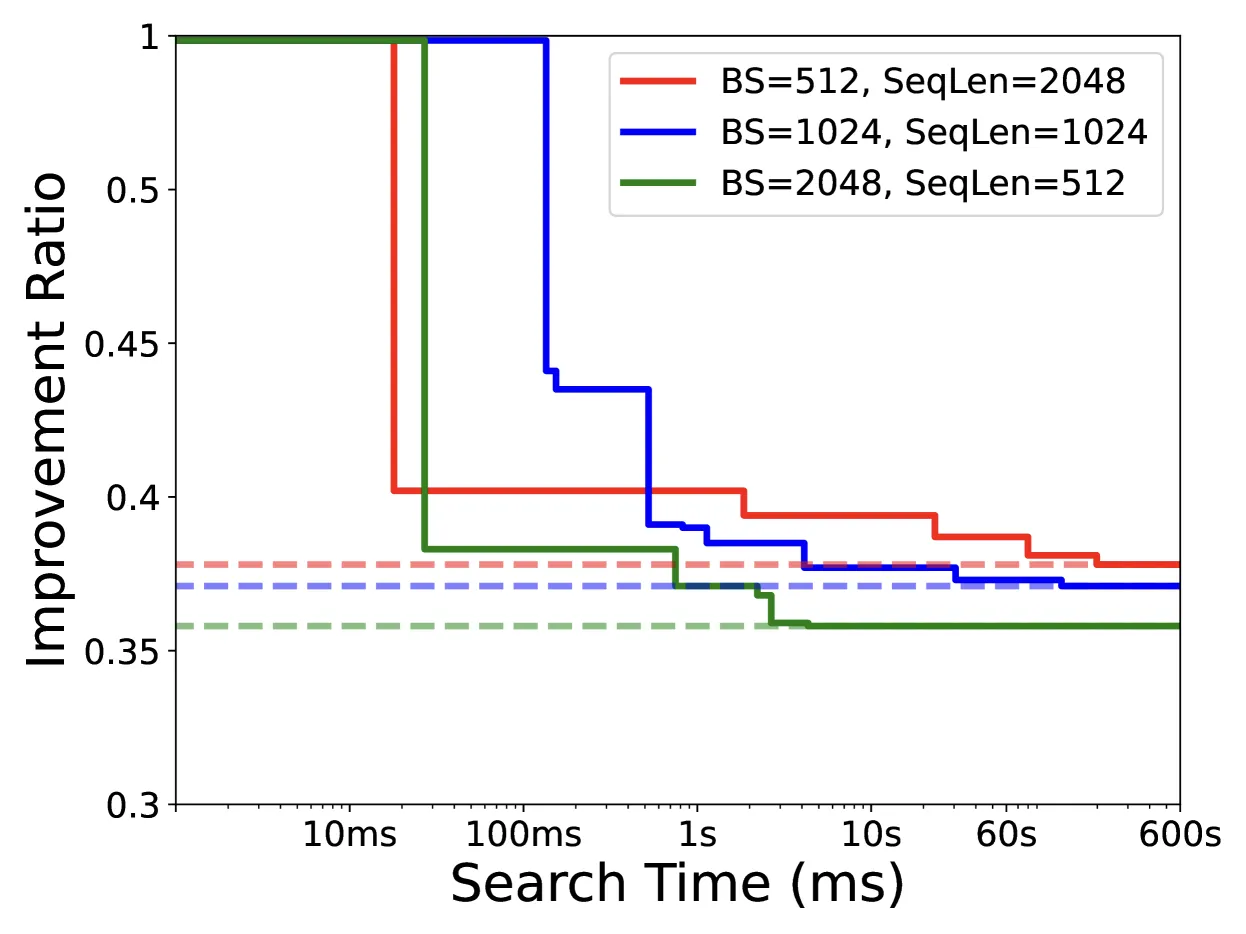 图15:MCMC搜索在10分钟内产生的执行计划性能,虚线标记暴力搜索产生的最优性能
5.5 算法泛化性
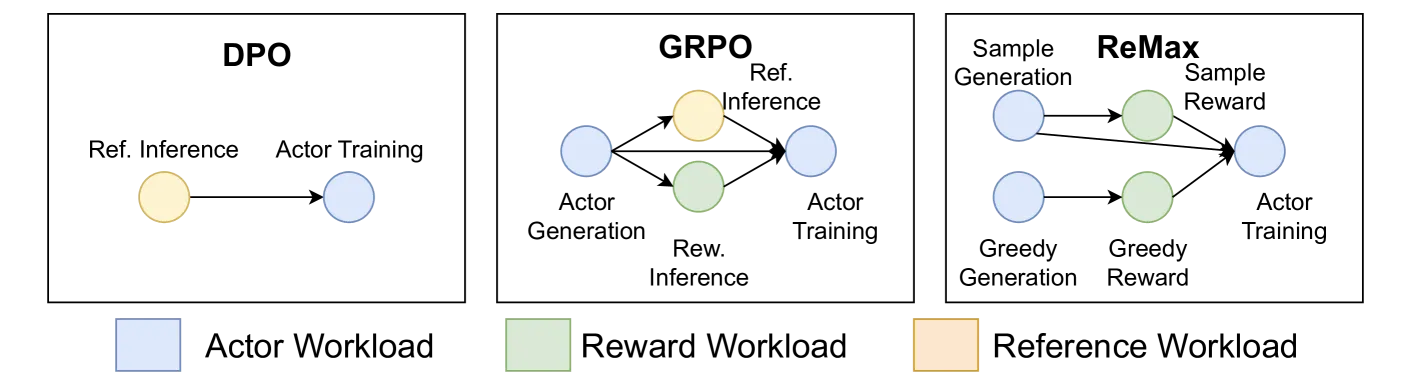 图16:除PPO外三种流行RLHF算法的吞吐量对比
ReaL可以自然地支持任何可表示为有向无环图(DAG)的RLHF算法,包括:
- DPO (Direct Preference Optimization)
- GRPO (Group Relative Policy Optimization)
- ReMax
5.6 强扩展性分析
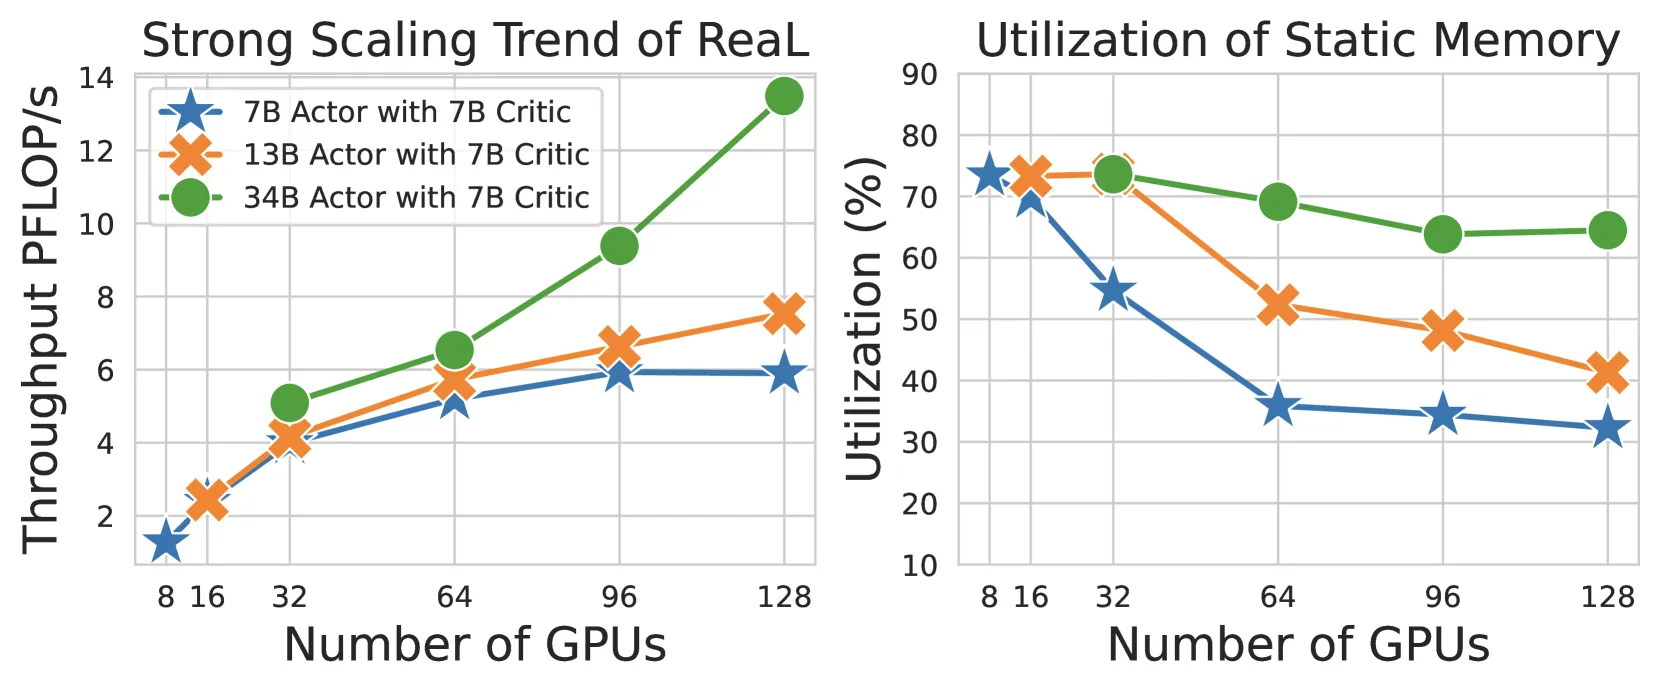 图17:强扩展实验中的吞吐量和内存利用率。ReaL在计算预算紧张时可实现(超)线性扩展
关键观察:
- 7B Actor:子线性扩展,因自回归生成的内存IO开销而达到平台期
- 34B Actor:超线性扩展,通过并行化计算和以内存换通信实现
5.7 GPU执行时间线
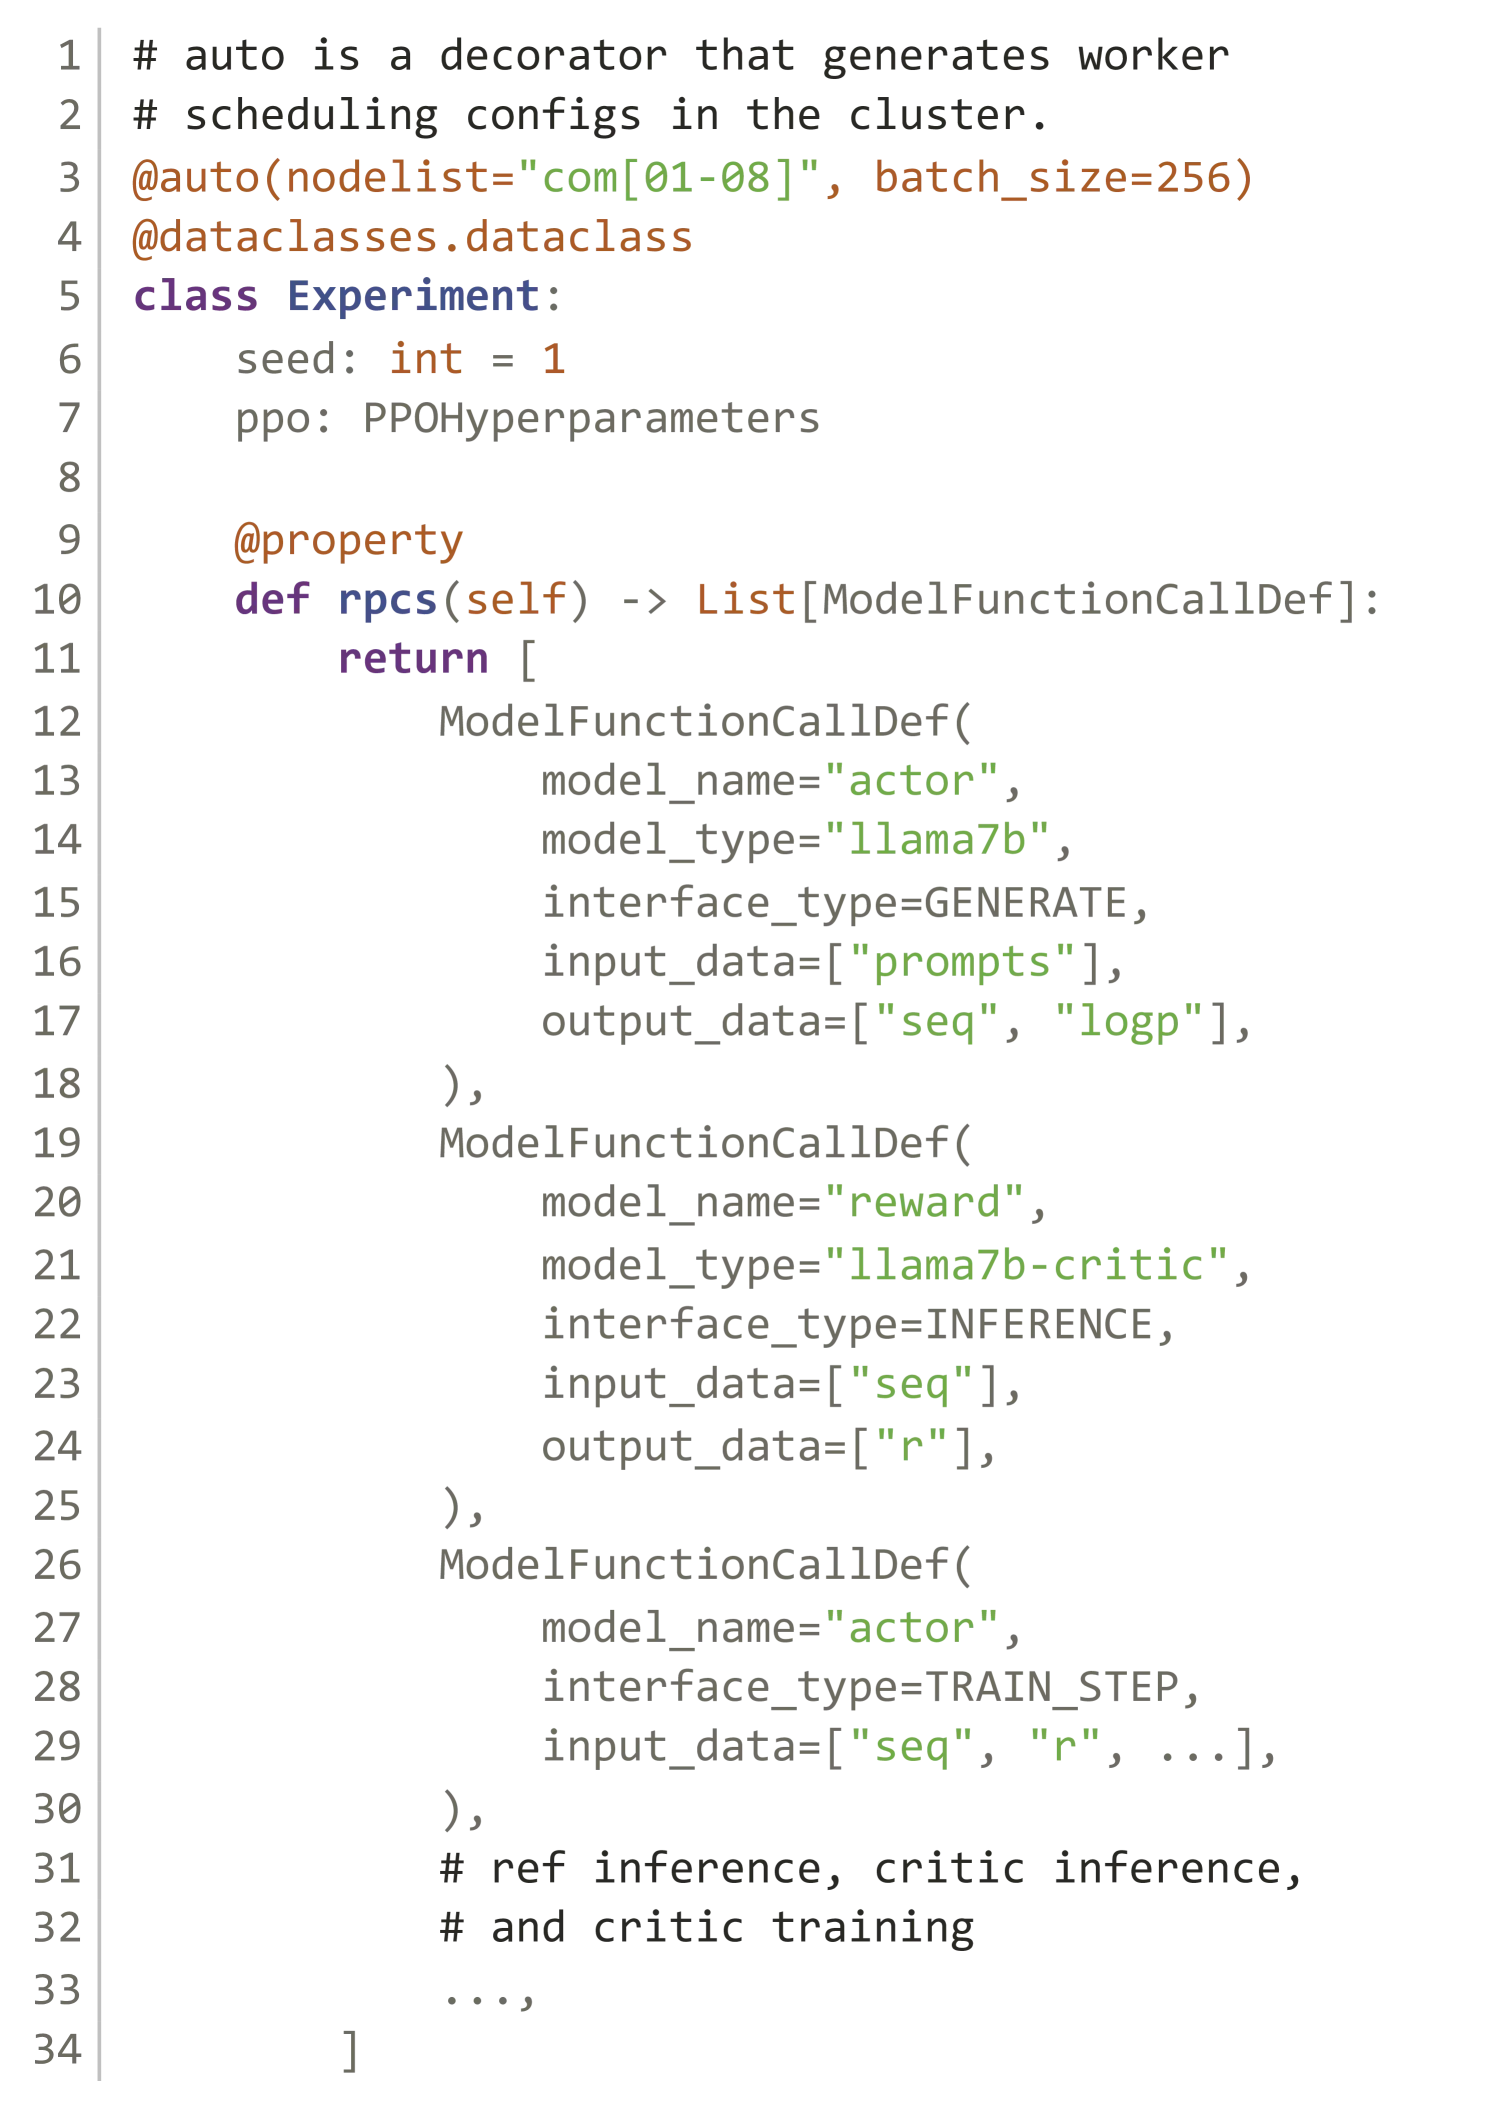 图18:ReaL在7B Actor + 34B Critic配置下的GPU执行时间线
黑线标记RLHF训练迭代边界,展示了跨迭代的计算重叠。
六、相关工作
6.1 LLM训练与服务系统
| 方向 | 代表工作 | 与ReaL的关系 |
|---|---|---|
| 分布式训练 | Megatron-LM, MegaScale | ReaL扩展了并行策略搜索 |
| 模型服务 | vLLM, S-LoRA, Orca | ReaL集成了生成优化 |
| RLHF系统 | DeepSpeed-Chat, OpenRLHF | ReaL的直接对比基线 |
6.2 GPU内存管理
| 方法 | 说明 |
|---|---|
| 梯度检查点 | 时间换空间 |
| ZeRO-3 | 参数分片 |
| 参数卸载 | CPU/NVMe offload |
6.3 自动并行化
| 系统 | 方法 |
|---|---|
| Alpa | 动态规划 |
| FlexFlow | MCMC搜索 |
| ReaL | 针对RLHF的专用搜索 |
ReaL与Alpa/FlexFlow的关键区别:
- ReaL考虑参数重分配,而传统方法不考虑
- ReaL在模型函数调用粒度操作,而非张量算子粒度
- 搜索空间更小,搜索效率更高
七、总结
7.1 主要贡献
- 参数重分配技术:首次提出在训练过程中动态重新分配LLM参数
- 执行计划搜索算法:基于MCMC的高效搜索方法
- ReaL系统:自动发现和执行高效执行计划的完整系统
- 全面评估:在多种配置下验证了系统有效性
7.2 局限性
| 局限 | 说明 |
|---|---|
| 可预测性要求 | 需要稳定的函数调用以保证成本估计有效 |
| 非最优保证 | 搜索不保证找到全局最优解 |
| 单线程搜索 | 搜索引擎可以进一步优化 |
7.3 未来方向
- 支持更多RLHF算法变体
- 多线程搜索加速
- 动态工作负载适应
- 更大规模模型支持
八、参考资源
8.1 论文链接
| 资源 | 链接 |
|---|---|
| arXiv | https://arxiv.org/abs/2406.14088 |
| https://arxiv.org/pdf/2406.14088 | |
| HTML | https://arxiv.org/html/2406.14088v2 |
| 代码 | https://github.com/openpsi-project/ReaLHF |
8.2 关键图表索引
| 图表 | 内容 | 文件 |
|---|---|---|
| Figure 1 | RLHF迭代分解与并行策略对比 | fig1_rlhf_breakdown.png |
| Figure 2 | 基于3D并行执行计划的优化机会 | fig2_parallelization.png |
| Figure 3 | ReaLHF系统架构 | fig3_architecture.png |
| Figure 4 | 两个连续RLHF迭代的数据流图 | fig4.png |
| Figure 5 | 执行计划实例的增强数据流图 | fig5.png |
| Figure 6 | 参数重分布的层次化过程 | fig6.png |
| Figure 7 | 与基线系统的端到端吞吐量对比 | fig7.png |
| Figure 8 | 不同上下文长度下的吞吐量对比 | fig8.png |
| Figure 9 | 墙钟时间分解 | fig9_walltime.png |
| Figure 10 | CUDA内核追踪对比 | fig10_cuda_kernels.png |
| Figure 11 | CUDA内核时间统计 | fig11_profiler.png |
| Figure 12 | Profiler性能与估计精度 | fig12_search.png |
| Figure 13 | 搜索收敛过程 | fig13_timeline.png |
| Figure 14 | MCMC搜索算法性能 | fig14.png |
| Figure 15 | MCMC搜索结果对比 | fig15.png |
| Figure 16 | 多算法泛化性对比 | fig16.png |
| Figure 17 | 强扩展性分析 | fig17.png |
| Figure 18 | GPU执行时间线 | fig18.png |
8.3 关键引用
- Schulman et al. (2017) - PPO算法
- Ouyang et al. (2022) - InstructGPT/RLHF实践
- Touvron et al. (2023) - LLaMA 2
- Yao et al. (2023) - DeepSpeed-Chat
- Hu et al. (2023) - OpenRLHF
- Shoeybi et al. (2019) - Megatron-LM
- Zheng et al. (2022) - Alpa
- Rafailov et al. (2023) - DPO
- Shao et al. (2024) - GRPO
- Li et al. (2024) - ReMax