QQQ: Quality Quattuor-Bit Quantization for Large Language Models
W4A8量化方法,通过自适应平滑和Hessian补偿实现高质量4-bit权重量化,同时加速预填充和解码
QQQ: Quality Quattuor-Bit Quantization for Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | QQQ: Quality Quattuor-Bit Quantization for Large Language Models |
| 作者 | Ying Zhang, Peng Zhang, Mincong Huang, Jingyang Xiang, Yujie Wang, Chao Wang, Yineng Zhang, Lei Yu, Chuan Liu, Wei Lin |
| 机构 | Meituan, Zhejiang University |
| 论文 | arXiv:2406.09904 |
| 发布 | 2024年6月14日 |
二、核心思想
QQQ是一种高质量W4A8量化方法(4-bit权重,8-bit激活),通过自适应平滑和Hessian补偿解决W4A8量化的精度退化问题,同时开发高效的W4A8 GEMM内核实现推理加速。
问题定义
现有量化方法的局限:
| 方法类型 | 代表 | 问题 |
|---|---|---|
| W8A8 | SmoothQuant | 仅加速预填充(计算密集),解码阶段收益有限 |
| W4A16 | GPTQ, AWQ | 仅加速解码(内存密集),预填充阶段计算量未减少 |
| W4A4 | Atom | 精度损失严重 |
| W4A8 | QoQ | 精度仍有提升空间 |
W4A8的优势:同时减少权重内存(解码加速)和激活计算量(预填充加速),但面临两大挑战:
- 激活中的离群值导致量化误差大
- 缺乏高效的W4A8 GEMM内核
解决方案
QQQ通过以下技术解决上述挑战:
- 自适应平滑(Adaptive Smoothing):仅对含显著离群值的激活通道进行平滑,保留其他通道
- Hessian补偿(Hessian-based Compensation):基于二阶信息补偿权重量化损失
- 高效GEMM内核:针对per-channel和per-group量化分别设计W4A8 GEMM
三、技术架构
整体框架
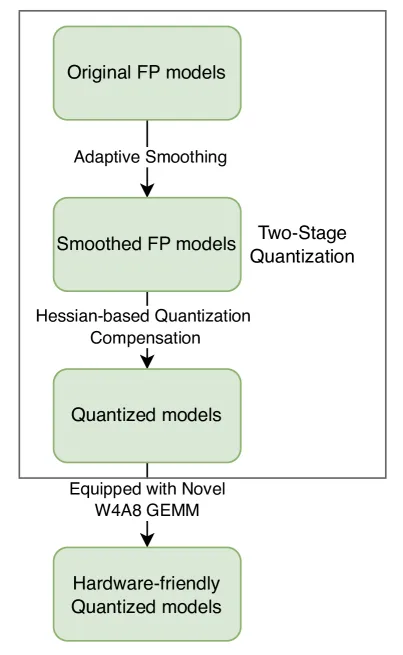
QQQ是一个两阶段量化方法:
- 阶段1:自适应平滑激活通道,将量化难度从激活转移到权重
- 阶段2:Hessian补偿权重量化,最小化量化误差
自适应平滑
核心思想:仅对含显著离群值的激活通道进行平滑,其他通道保持不变。
离群通道选择:
其中 是通过网格搜索确定的阈值,范围为 。
平滑参数优化:
目标是最小化量化前后激活-权重乘积的平方误差。
Hessian补偿
在平滑激活后,使用GPTQ框架进行权重量化补偿:
权重更新:
误差补偿:
其中 是Hessian矩阵。
W4A8 GEMM内核
Per-Channel量化GEMM
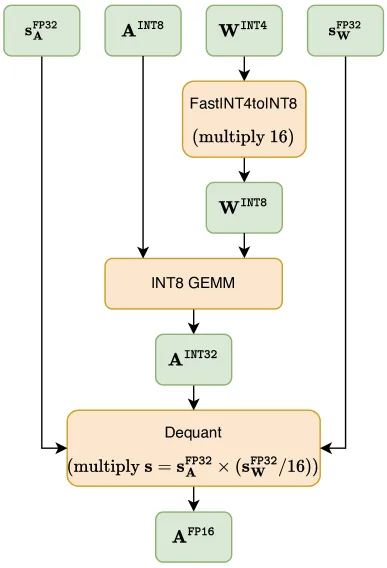
流程:
- INT4权重 → INT8(FastINT4toINT8:左移4位)
- INT8 GEMM计算
- INT32结果 → FP16(反量化)
关键优化:
- FastINT4toINT8:利用位移操作高效转换
- 融合反量化:在GEMM内完成INT32到FP16的转换
Per-Group量化GEMM
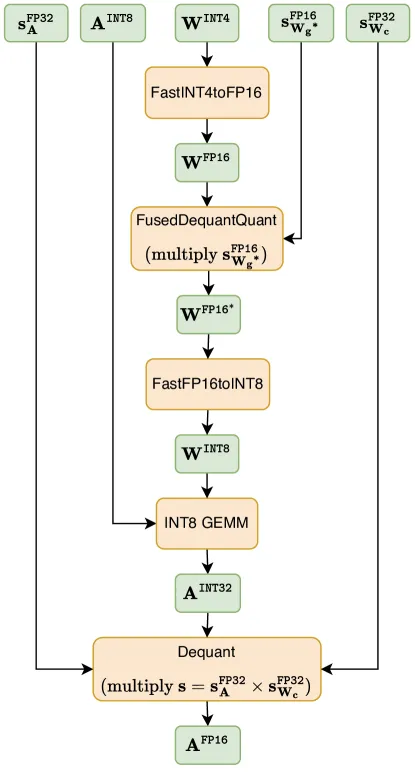
流程:
- INT4权重 → FP16(FastINT4toFP16)
- FusedDequantQuant:组缩放反量化 + 通道缩放重量化
- FP16 → INT8(FastFP16toINT8)
- INT8 GEMM计算
- INT32结果 → FP16(反量化)
FusedDequantQuant优化:
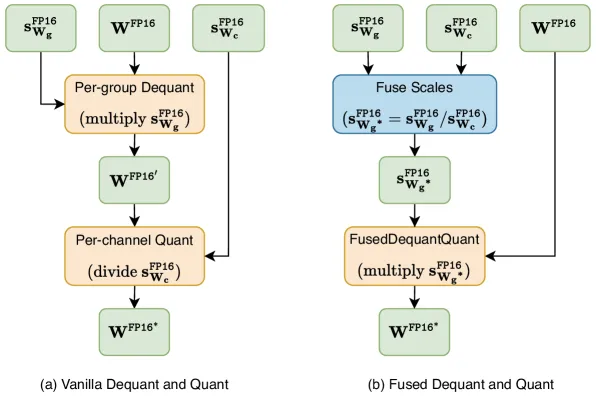
将组缩放除以通道缩放,合并为单一操作,减少内存访问。
FastFP16toINT8优化:
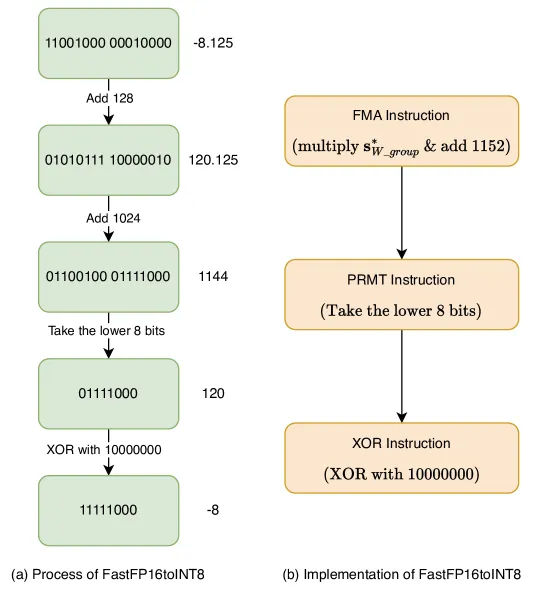
传统方法:使用标准FP16→INT8指令,速度慢。
QQQ方法:
- 加128:将FP16值移到[0.0, 255.0]范围(对应UINT8)
- 加1024:将UINT8的8位对齐到FP16尾数的低位
- 位提取:直接从FP16位模式中提取INT8值
加速效果:FastFP16toINT8可加速per-group W4A8 GEMM最高2.02×。
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 自适应平滑 | 仅平滑含离群值的激活通道 | 比全通道平滑更有效 |
| Hessian补偿 | 基于二阶信息补偿权重量化损失 | 显著降低精度退化 |
| FastINT4toINT8 | 位移操作实现高效类型转换 | per-channel GEMM 3.67×加速 |
| FusedDequantQuant | 融合组缩放反量化和通道缩放量化 | 减少内存访问 |
| FastFP16toINT8 | 位操作替代标准转换指令 | per-group GEMM 2.02×加速 |
与现有方法对比
| 方法 | 位宽 | 对称量化 | 预填充加速 | 解码加速 | 精度 |
|---|---|---|---|---|---|
| SmoothQuant | W8A8 | ✓ | ✓ | ✗ | 高 |
| GPTQ | W4A16 | ✗ | ✗ | ✓ | 高 |
| AWQ | W4A16 | ✗ | ✗ | ✓ | 高 |
| Atom | W4A4 | ✓ | ✓ | ✓ | 中 |
| QoQ | W4A8 | ✗ | ✓ | ✓ | 高 |
| QQQ | W4A8 | ✓ | ✓ | ✓ | 高 |
五、实验结果
评估设置
| 项目 | 配置 |
|---|---|
| 模型 | LLaMA-1 (7B/13B/30B), LLaMA-2 (7B/13B/70B), LLaMA-3 (8B) |
| 基准 | WikiText2 (困惑度), PIQA/ARC/HellaSwag/WinoGrande (零样本) |
| 硬件 | NVIDIA A100 80G GPU |
| 框架 | vLLM v0.4.1 + Marlin内核 |
WikiText2困惑度
Table 1: WikiText2困惑度(序列长度2048)
| 位宽 | 方法 | LLaMA-1 7B | 13B | 30B | LLaMA-2 7B | 13B | 70B | LLaMA-3 8B |
|---|---|---|---|---|---|---|---|---|
| FP16 | - | 5.68 | 5.09 | 4.10 | 5.47 | 4.88 | 3.32 | 6.27 |
| W8A8 | SmoothQuant | 5.78 | 5.17 | 4.28 | 5.58 | 4.93 | 3.39 | 6.39 |
| W4A16 | GPTQ-g128 | 5.83 | 5.20 | 4.22 | 5.63 | 4.99 | 3.43 | 6.44 |
| AWQ-g128 | 5.78 | 5.19 | 4.21 | 5.60 | 4.97 | 3.41 | 6.38 | |
| W4A4 | Atom-g128 | 6.25 | 5.52 | 4.61 | 6.12 | 5.31 | 3.73 | 7.16 |
| W4A8 | QoQ | 5.93 | 5.28 | 4.34 | 5.75 | 5.12 | 3.52 | 6.61 |
| QQQ | 5.84 | 5.20 | 4.28 | 5.65 | 5.01 | 3.43 | 6.49 | |
| QQQ-g128 | 5.76 | 5.15 | 4.19 | 5.57 | 4.95 | 3.38 | 6.36 |
关键发现:
- Per-group QQQ与W8A8 SmoothQuant、W4A16 GPTQ、W4A16 AWQ性能相当
- 相比W4A4 Atom,per-group QQQ在LLaMA-2-13B上困惑度降低0.41
- 相比W4A8 QoQ,per-group QQQ在大多数模型上更优
零样本准确率
Table 2: LLaMA-2零样本准确率
| 模型 | 方法 | PIQA | ARC-e | ARC-c | HellaSwag | WinoGrande |
|---|---|---|---|---|---|---|
| 7B | FP16 | 79.05 | 74.58 | 46.25 | 76.05 | 68.98 |
| Atom-g128 | 75.14 | 52.99 | 38.40 | 69.37 | 62.75 | |
| QoQ | 77.64 | 72.81 | 43.60 | 74.00 | 68.03 | |
| QQQ-g128 | 78.51 | 72.94 | 44.37 | 74.53 | 67.01 | |
| 13B | FP16 | 80.52 | 77.44 | 49.06 | 79.38 | 72.22 |
| Atom-g128 | 76.07 | 55.64 | 39.42 | 71.86 | 64.72 | |
| QoQ | 78.72 | 75.24 | 46.33 | 77.14 | 70.17 | |
| QQQ-g128 | 79.41 | 76.28 | 47.15 | 77.44 | 70.48 |
关键发现:
- QQQ显著优于W4A4 Atom(LLaMA-2-13B HellaSwag上+4.79%)
- Per-group QQQ与QoQ相当,平均提升0.3%
推理吞吐量
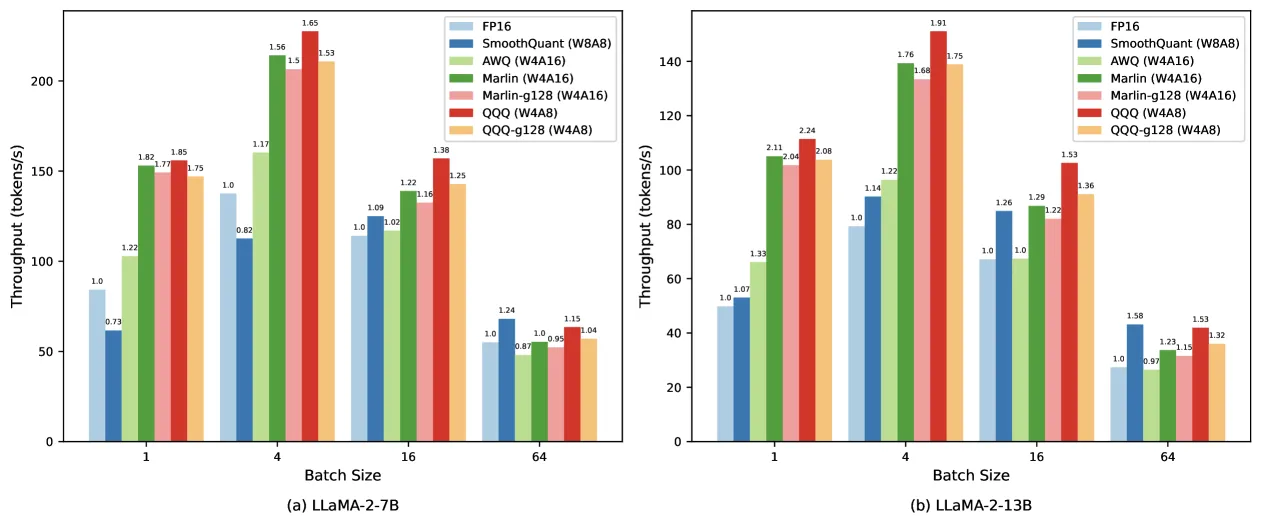
在LLaMA-2-13B上的加速比:
| 对比方法 | 加速比 |
|---|---|
| vs FP16 | 2.24× |
| vs W8A8 SmoothQuant | 2.10× |
| vs W4A16 AWQ | 1.59× |
| vs W4A16 Marlin | 1.25× |
关键发现:
- QQQ在大多数batch size下优于所有对比方法
- 相比W4A16 AWQ和Marlin,小batch size时速度相当,大batch size时优势明显
- 相比W8A8 SmoothQuant,平均约2×加速
GEMM内核性能
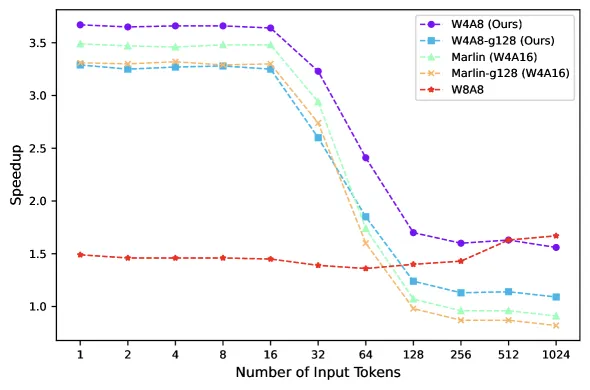
Per-channel W4A8 GEMM加速比:
| 对比方法 | 加速比 |
|---|---|
| vs PyTorch FP16 GEMM | 3.67× |
| vs W8A8 GEMM | 2.51× |
| vs W4A16 Marlin GEMM | 1.71× |
Per-group W4A8 GEMM加速比:
| 对比方法 | 加速比 |
|---|---|
| vs PyTorch FP16 GEMM | 3.29× |
| vs W8A8 GEMM | 2.26× |
关键发现:
- 小token数(<64)时W4A8 GEMM相比W8A8有显著优势
- 随token数增加,per-channel GEMM变慢(类型转换开销),per-group保持高效
FastFP16toINT8效果
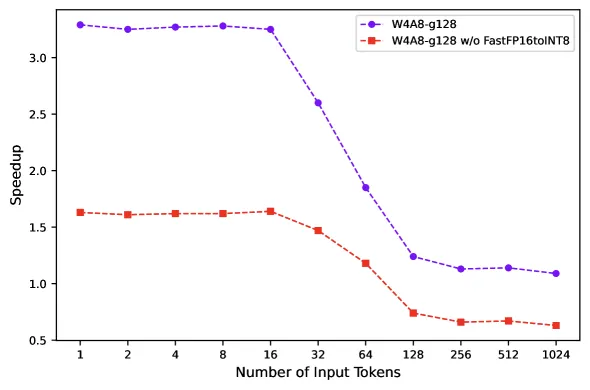
- FastFP16toINT8可加速per-group W4A8 GEMM最高2.02×
- 证明了高效类型转换对GEMM性能的关键影响
消融实验
Table 3: 量化技术组合效果(LLaMA系列困惑度)
| 粒度 | 模型 | 基线 | +自适应平滑 | +GPTQ补偿 |
|---|---|---|---|---|
| Per-channel | LLaMA-1-7B | 6.93 | 6.77 | 6.19 |
| LLaMA-1-13B | 5.84 | 5.84 | 5.43 | |
| LLaMA-1-30B | 5.04 | 4.89 | 4.61 | |
| LLaMA-2-7B | 7.36 | 7.29 | 5.95 | |
| LLaMA-2-13B | 5.47 | 5.43 | 5.21 | |
| LLaMA-2-70B | 4.07 | 3.88 | 3.68 | |
| LLaMA-3-8B | 10.88 | 9.46 | 7.41 |
关键发现:
- 自适应平滑 + GPTQ补偿组合效果最佳
- 在LLaMA-3-8B上,困惑度从10.88降至7.41(降低3.47)
六、相关工作
| 方向 | 代表工作 | QQQ优势 |
|---|---|---|
| W8A8量化 | SmoothQuant, LLM.int8() | 同时加速预填充和解码 |
| W4A16量化 | GPTQ, AWQ | 预填充阶段也获得加速 |
| W4A4量化 | Atom | 精度显著更高 |
| W4A8量化 | QoQ | 对称量化更高效,精度相当 |
| GEMM优化 | Marlin | 专为W4A8设计,速度更快 |
七、总结
核心贡献
- 提出QQQ,一种高质量W4A8量化方法,通过自适应平滑和Hessian补偿实现接近FP16的精度
- 开发高效的W4A8 GEMM内核,包括FastINT4toINT8、FusedDequantQuant和FastFP16toINT8优化
- 集成到vLLM框架,实现端到端推理加速
- 在LLaMA系列模型上验证有效性和通用性
性能总结
| 指标 | 结果 |
|---|---|
| 精度 | 接近FP16,显著优于W4A4 Atom |
| GEMM加速 | per-channel 3.67×,per-group 3.29× vs FP16 |
| 端到端加速 | 2.24× vs FP16,2.10× vs W8A8,1.25× vs W4A16 Marlin |
| 兼容性 | 支持per-channel和per-group量化,集成vLLM |
局限性
- 两阶段量化方法需要更多量化时间
- 混合精度GEMM目前仅支持4-bit权重
- 对称量化限制了某些场景的灵活性