AsyncDiff: Parallelizing Diffusion Models by Asynchronous Denoising
通用分布式加速框架,通过异步去噪实现扩散模型的多设备并行推理
AsyncDiff: Parallelizing Diffusion Models by Asynchronous Denoising
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | AsyncDiff: Parallelizing Diffusion Models by Asynchronous Denoising |
| 作者 | Zigeng Chen, Xinyin Ma, Gongfan Fang, Zhenxiong Tan, Xinchao Wang |
| 论文 | arXiv:2406.06911 |
| 发布 | 2024-06-11 |
| 主题 | cs.CV (Computer Vision and Pattern Recognition) |
| 关联 | DeepCache/Learning-to-Cache同一作者组的工作 |
二、核心思想
问题定义
扩散模型因其多步顺序去噪特性而面临高累积延迟问题,无法进行并行计算。现有的加速方法主要关注减少采样步数或单步优化,但无法充分利用多设备的计算资源。
核心问题:如何通过模型并行化,在多设备上实现扩散推理的真正并行?
核心观察
相邻时间步的隐藏状态高度相似:
与DeepCache的观察类似,扩散模型相邻步骤之间的隐藏特征具有显著的时间一致性。这为打破顺序依赖链提供了可能。
解决方案概述
AsyncDiff:通用的、即插即用的分布式加速框架。
核心思想:
- 将去噪模型分割为多个组件,分配到不同设备
- 利用异步去噪打破组件间的依赖链
- 通过步进去噪(Stride Denoising)进一步提升效率
三、技术架构
整体框架
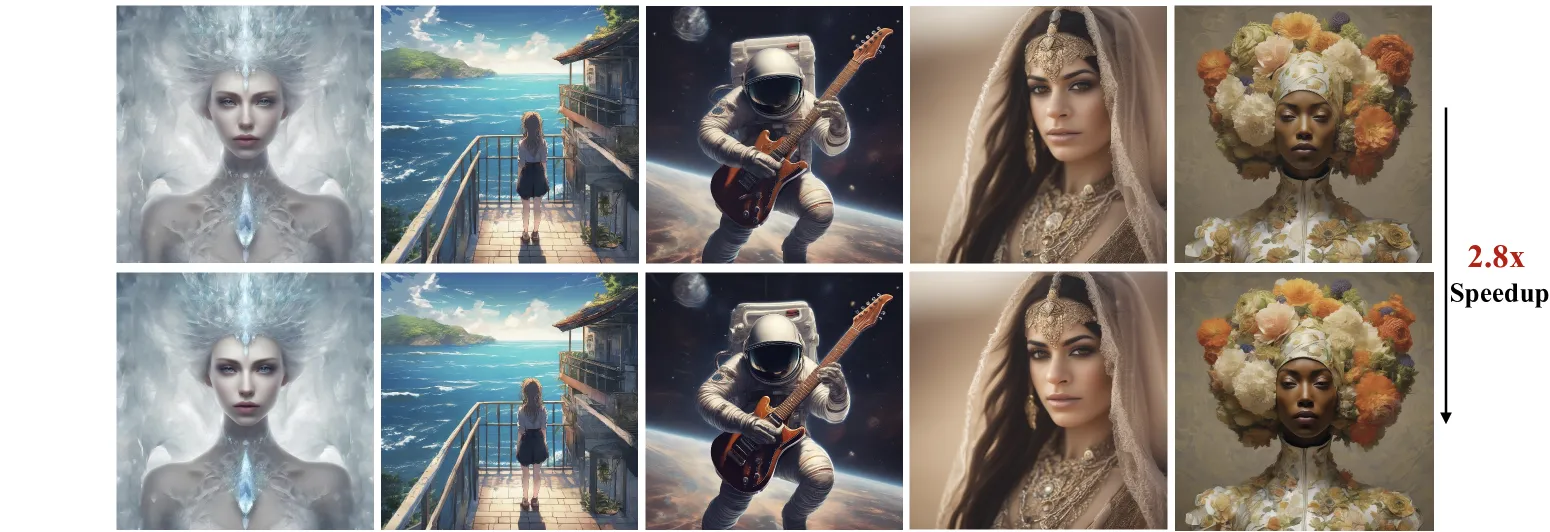
Figure 1: AsyncDiff在Stable Diffusion XL上实现2.8倍加速。
并行计算概念
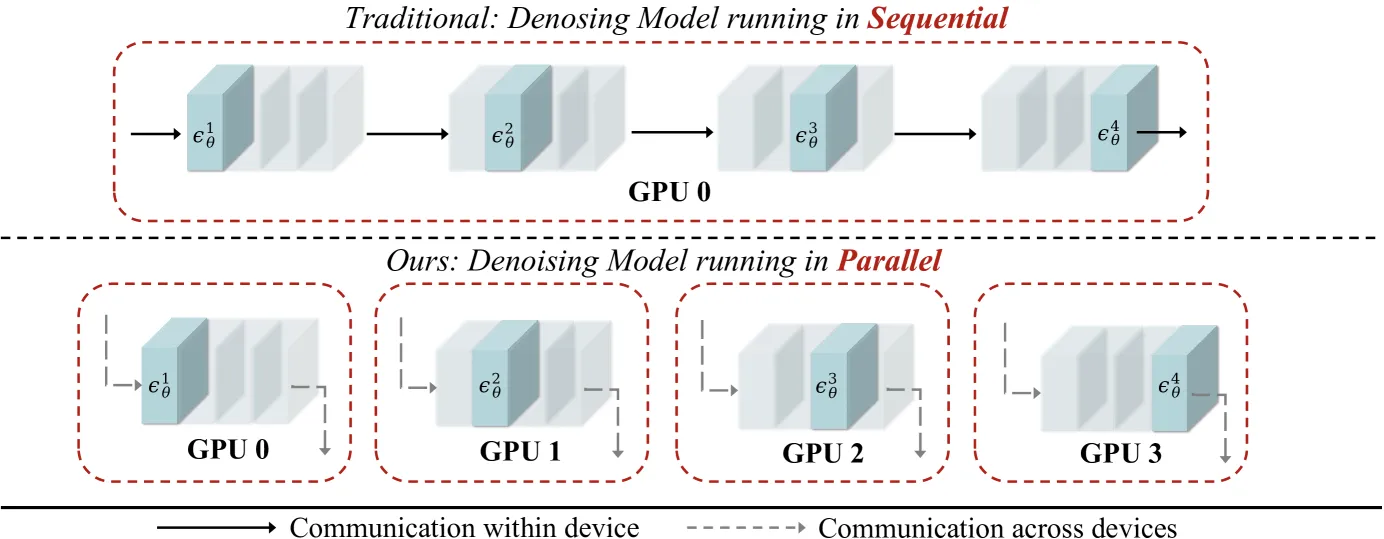
Figure 2: 通过预先准备每个组件的输入,实现去噪模型的并行计算。
异步去噪过程
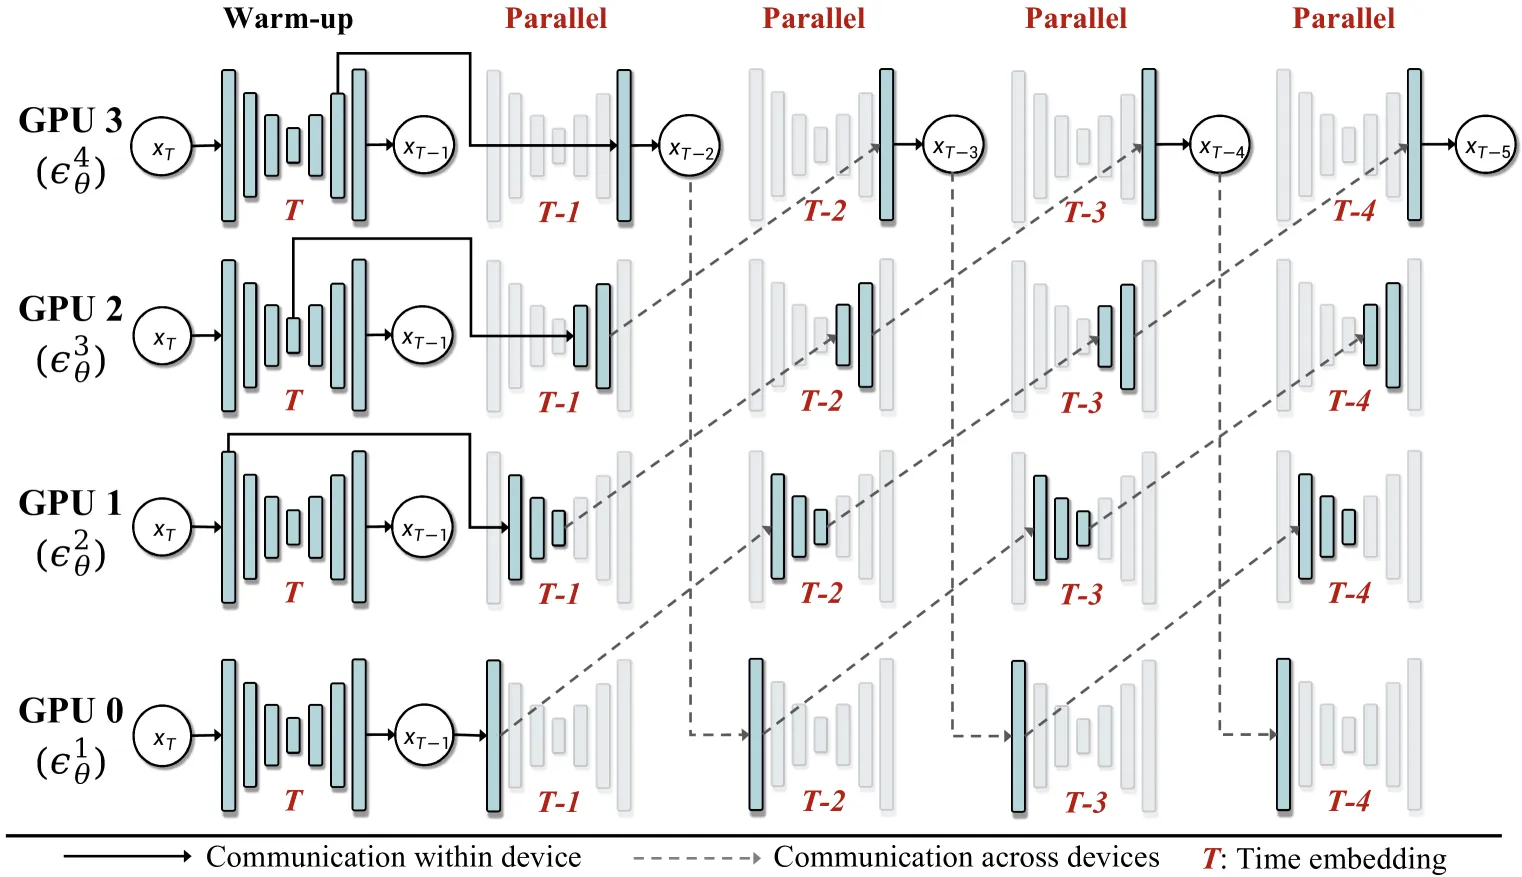
Figure 3: 异步去噪过程概述。
关键机制:
- 热身阶段(Warm-up):前 步执行完整顺序推理
- 异步阶段:后续步骤利用前一步的缓存特征打破依赖链
- 组件并行: 个分割的组件在多设备上同时处理
步进去噪
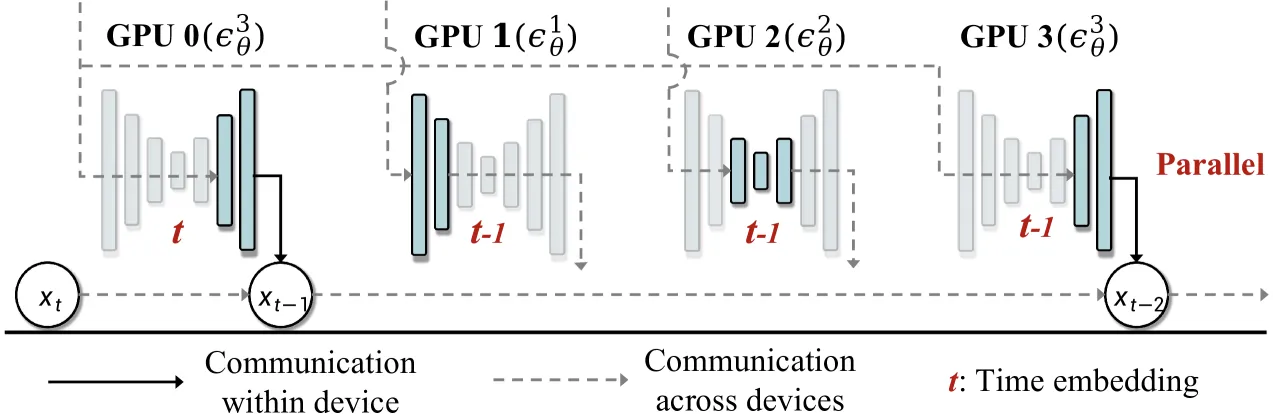
Figure 4: 步进去噪示意图(步幅=2)。
步进去噪:通过单次并行计算完成多个去噪步骤。
- 常规异步去噪:每轮并行完成1步
- 步进去噪:每轮并行完成 步
- 通信次数从 降至
核心公式
标准顺序去噪:
异步去噪:打破依赖链,每个组件使用前一步的缓存输出
模型并行复杂度:
多设备通信
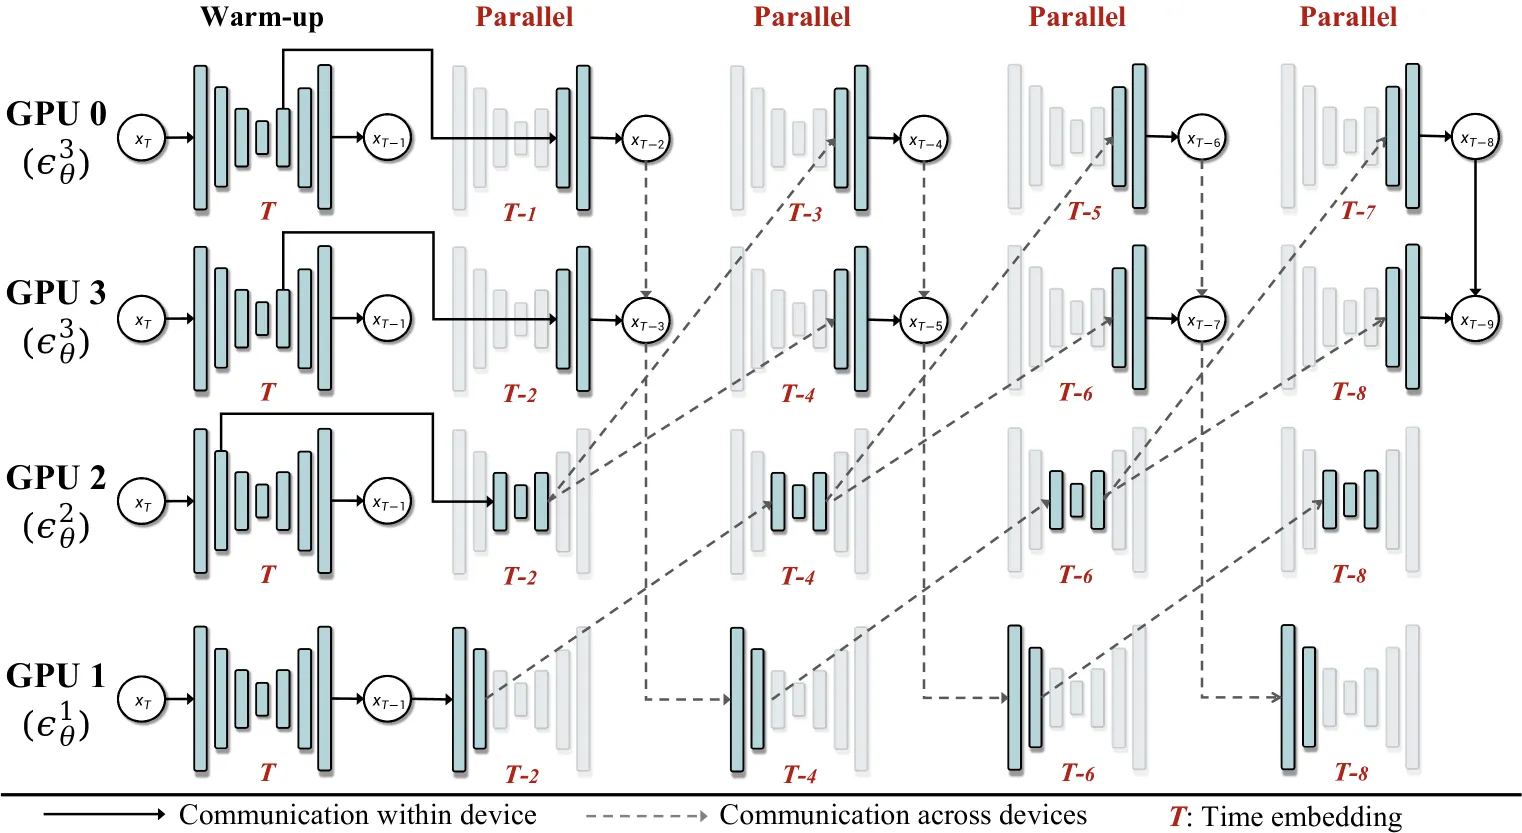
Figure 7: 结合步进去噪的异步扩散模型完整示意图。
通信优化:
- 使用广播(broadcast)机制传递缓存特征
- 步进去噪减少通信次数
- 通信开销通常仅占总时间的4-14%
四、实验结果
文本到图像生成
Table 1: 三个文本到图像扩散模型的定量评估
| 基础模型 | 配置 | 设备数 | MACs↓ | 延迟↓ | 加速比↑ | CLIP↑ | FID↓ | LPIPS↓ |
|---|---|---|---|---|---|---|---|---|
| SD 2.1 | 原始 | 1 | 76T | 5.51s | 1.0× | 31.60 | 27.89 | – |
| N=2 S=1 | 2 | 38T | 3.03s | 1.8× | 31.59 | 27.79 | 0.212 | |
| N=3 S=1 | 3 | 25T | 2.41s | 2.3× | 31.56 | 28.00 | 0.276 | |
| N=4 S=1 | 4 | 19T | 2.10s | 2.6× | 31.40 | 28.28 | 0.313 | |
| N=2 S=2 | 3 | 19T | 1.82s | 3.0× | 31.43 | 28.55 | 0.346 | |
| N=3 S=2 | 4 | 13T | 1.35s | 4.0× | 31.22 | 29.41 | 0.378 | |
| SD 1.5 | 原始 | 1 | 34T | 2.70s | 1.0× | 30.63 | 29.96 | – |
| N=2 S=1 | 2 | 17T | 1.52s | 1.8× | 30.62 | 29.94 | 0.199 | |
| N=3 S=2 | 4 | 6T | 0.72s | 3.7× | 30.17 | 30.89 | 0.381 | |
| SDXL | 原始 | 1 | 299T | 13.81s | 1.0× | 32.33 | 27.43 | – |
| N=2 S=1 | 2 | 150T | 7.43s | 1.9× | 32.31 | 27.53 | 0.225 | |
| N=4 S=1 | 4 | 75T | 4.94s | 2.8× | 32.24 | 27.75 | 0.355 |
关键结果:
- SD 2.1: 4.0倍加速,CLIP仅下降0.38
- SD 1.5: 3.7倍加速,CLIP仅下降0.46
- SDXL: 2.8倍加速,CLIP仅下降0.09
Warm-up步数影响
Table 2: Warm-up步数对像素级一致性的影响
| 配置 | SD 2.1 | SD 1.5 | SDXL |
|---|---|---|---|
| 加速比↑ | CLIP↑ | LPIPS↓ | |
| 原始 | 1.0× | 31.60 | – |
| Warm-up=3 | 3.5× | 31.26 | 0.329 |
| Warm-up=5 | 3.1× | 31.27 | 0.277 |
| Warm-up=9 | 2.7× | 31.40 | 0.194 |
| Warm-up=11 | 2.4× | 31.45 | 0.163 |
关键发现:
- 更多Warm-up步数 → 更好的像素级一致性(更低LPIPS)
- 但会降低加速比
- 存在速度-一致性权衡
与其他并行方法对比
Table 3: 与其他并行加速方法的对比
| 方法 | 加速比↑ | 设备数 | MACs↓ | 内存↓ | CLIP↑ | FID↓ | LPIPS↓ |
|---|---|---|---|---|---|---|---|
| 原始 | 1.0× | 1 | 76T | 5240MB | 31.60 | 27.87 | – |
| Faster Diffusion | 1.6× | 1 | 57T | 9692MB | 30.84 | 29.95 | 0.348 |
| Distrifusion | 1.6× | 2 | 38T | 6538MB | 31.59 | 27.89 | 0.018 |
| AsyncDiff | 1.6× | 2 | 44T | 5450MB | 31.59 | 27.79 | 0.094 |
| Distrifusion | 2.3× | 4 | 19T | 7086MB | 31.43 | 27.97 | 0.271 |
| AsyncDiff | 2.3× | 3 | 20T | 5516MB | 31.49 | 27.71 | 0.212 |
| Distrifusion | 2.7× | 8 | 10T | 7280MB | 31.31 | 28.12 | 0.293 |
| AsyncDiff | 2.7× | 4 | 14T | 5580MB | 31.40 | 28.03 | 0.194 |
关键优势:
- 更少设备:AsyncDiff用4 GPU达到Distrifusion 8 GPU的效果
- 更少内存:内存需求接近原始模型,Distrifusion显著增加
- 更好质量:CLIP Score和FID均优于Distrifusion
与Distrifusion质量对比
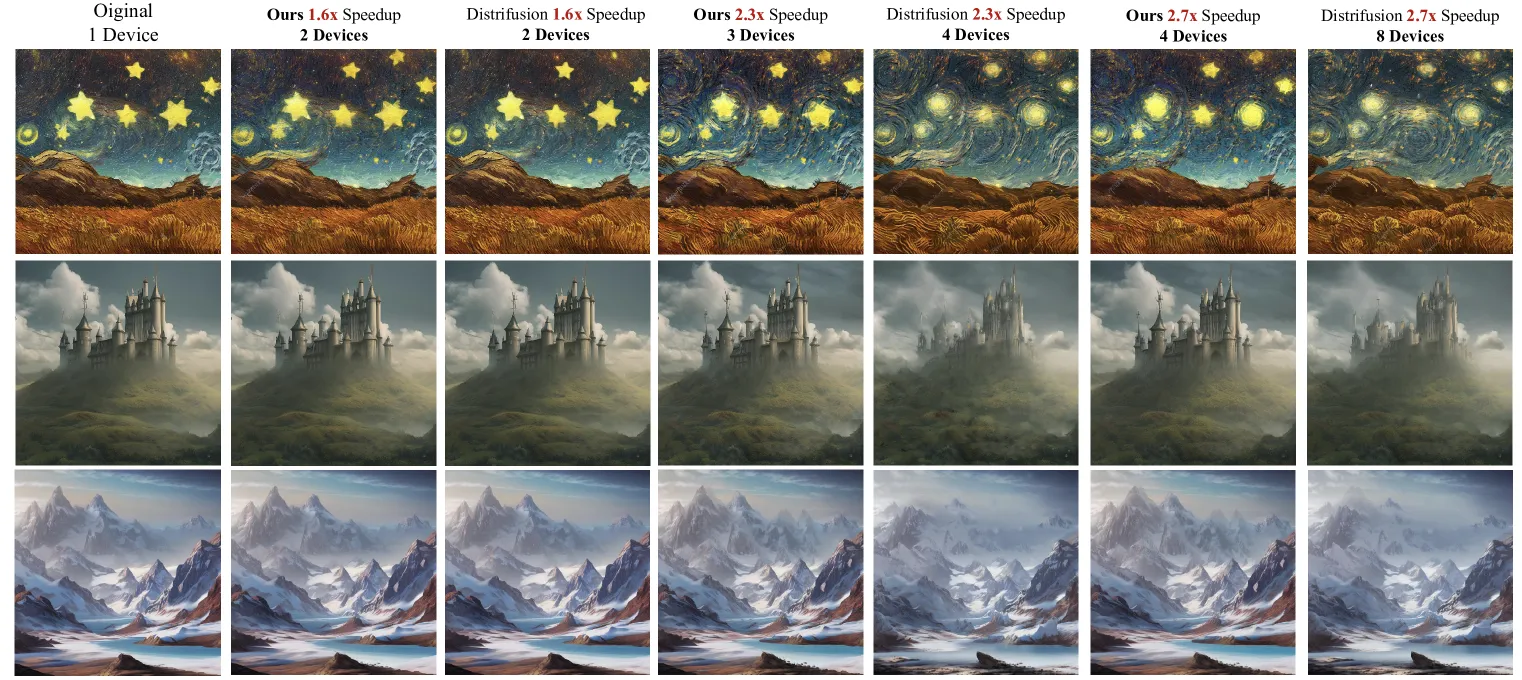
Figure 6: 与Distrifusion在SD 2.1上的质量对比。相同加速比下,AsyncDiff生成质量更好。
视频生成结果
Table 4: 文本到视频和图像到视频扩散模型的评估
| 基础模型 | 配置 | 设备数 | MACs↓ | 延迟↓ | 加速比↑ | CLIP↑ |
|---|---|---|---|---|---|---|
| AnimateDiff | 原始 | 1 | 786T | 43.5s | 1.0× | 30.65 |
| (文本到视频) | N=2 S=1 | 2 | 393T | 24.5s | 1.8× | 30.65 |
| N=3 S=1 | 3 | 262T | 19.1s | 2.3× | 30.54 | |
| N=2 S=2 | 3 | 197T | 14.2s | 3.0× | 30.32 | |
| N=3 S=2 | 4 | 131T | 11.5s | 3.8× | 30.20 | |
| SVD | 原始 | 1 | 3221T | 184s | 1.0× | 26.88 |
| (图像到视频) | N=2 S=1 | 2 | 1611T | 101s | 1.8× | 26.66 |
| N=3 S=1 | 3 | 1074T | 80s | 2.3× | 26.56 | |
| N=4 S=1 | 4 | 805T | 68s | 2.7× | 26.19 |
关键结果:
- AnimateDiff: 3.8倍加速,CLIP仅下降0.45
- SVD: 2.7倍加速,CLIP仅下降0.69
- 视频生成受益更大(原始延迟184s→68s)
步进去噪效果
Table 5: 步进去噪在SD 2.1上的效果
| 配置 | MACs↓ | 延迟↓ | 加速比↑ | 通信次数↓ | 通信延迟↓ | CLIP↑ |
|---|---|---|---|---|---|---|
| 3设备 w/o stride | 25T | 2.41s | 2.3× | 49次 | 0.23s(9.5%) | 31.56 |
| 3设备 w/ stride | 19T | 1.82s | 3.0× | 25次 | 0.12s(6.6%) | 31.43 |
| 4设备 w/o stride | 19T | 2.10s | 2.6× | 49次 | 0.40s(19.0%) | 31.40 |
| 4设备 w/ stride | 13T | 1.35s | 4.0× | 25次 | 0.10s(7.4%) | 31.22 |
关键发现:
- 步进去噪将通信次数从49降至25
- 4设备场景下:2.6× → 4.0×加速
通信开销分析
Table 6: SD 2.1上的时间成本对比
| 配置 | 总时间 | 运行时间 | 通信时间 | 比例 |
|---|---|---|---|---|
| N=2 S=1 | 3.03s | 2.90s | 0.13s | 4.30% |
| N=3 S=1 | 2.41s | 2.18s | 0.23s | 9.54% |
| N=4 S=1 | 2.10s | 1.80s | 0.30s | 14.29% |
| N=2 S=2 | 1.82s | 1.70s | 0.12s | 6.59% |
| N=3 S=2 | 1.35s | 1.25s | 0.10s | 7.40% |
关键发现:
- 通信开销通常仅占4-14%
- 步进去噪有效降低通信比例
不同步数下的加速比
Table 7: SD 2.1在不同去噪步数下的加速比
| 配置 | 25步 | 50步 | 100步 |
|---|---|---|---|
| 原始 | 1.0× (2.89s) | 1.0× (5.51s) | 1.0× (10.96s) |
| N=2 S=1 | 1.7× | 1.8× | 1.8× |
| N=3 S=1 | 2.1× | 2.3× | 2.3× |
| N=4 S=1 | 2.4× | 2.6× | 2.7× |
| N=2 S=2 | 2.7× | 3.0× | 3.2× |
| N=3 S=2 | 3.4× | 4.0× | 4.3× |
关键发现:
- 步数越多,加速比越高
- 100步时最高可达4.3倍加速
定性结果
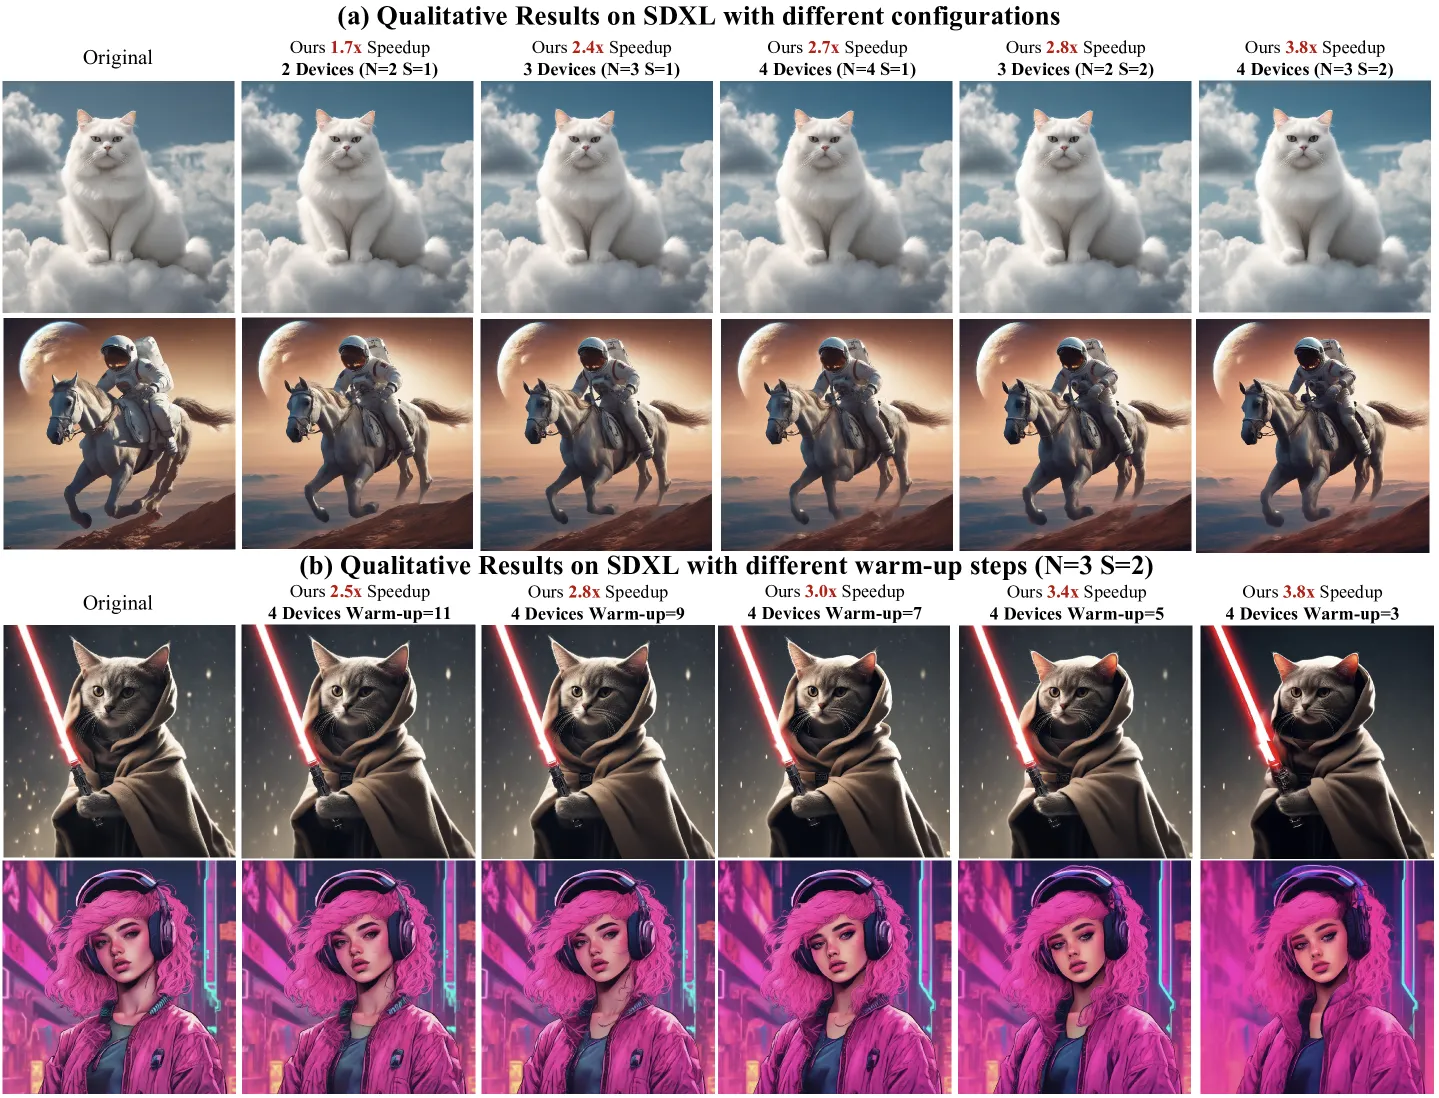
Figure 5: (a) AsyncDiff显著加速去噪过程,对生成质量影响最小。(b) 视频生成结果。
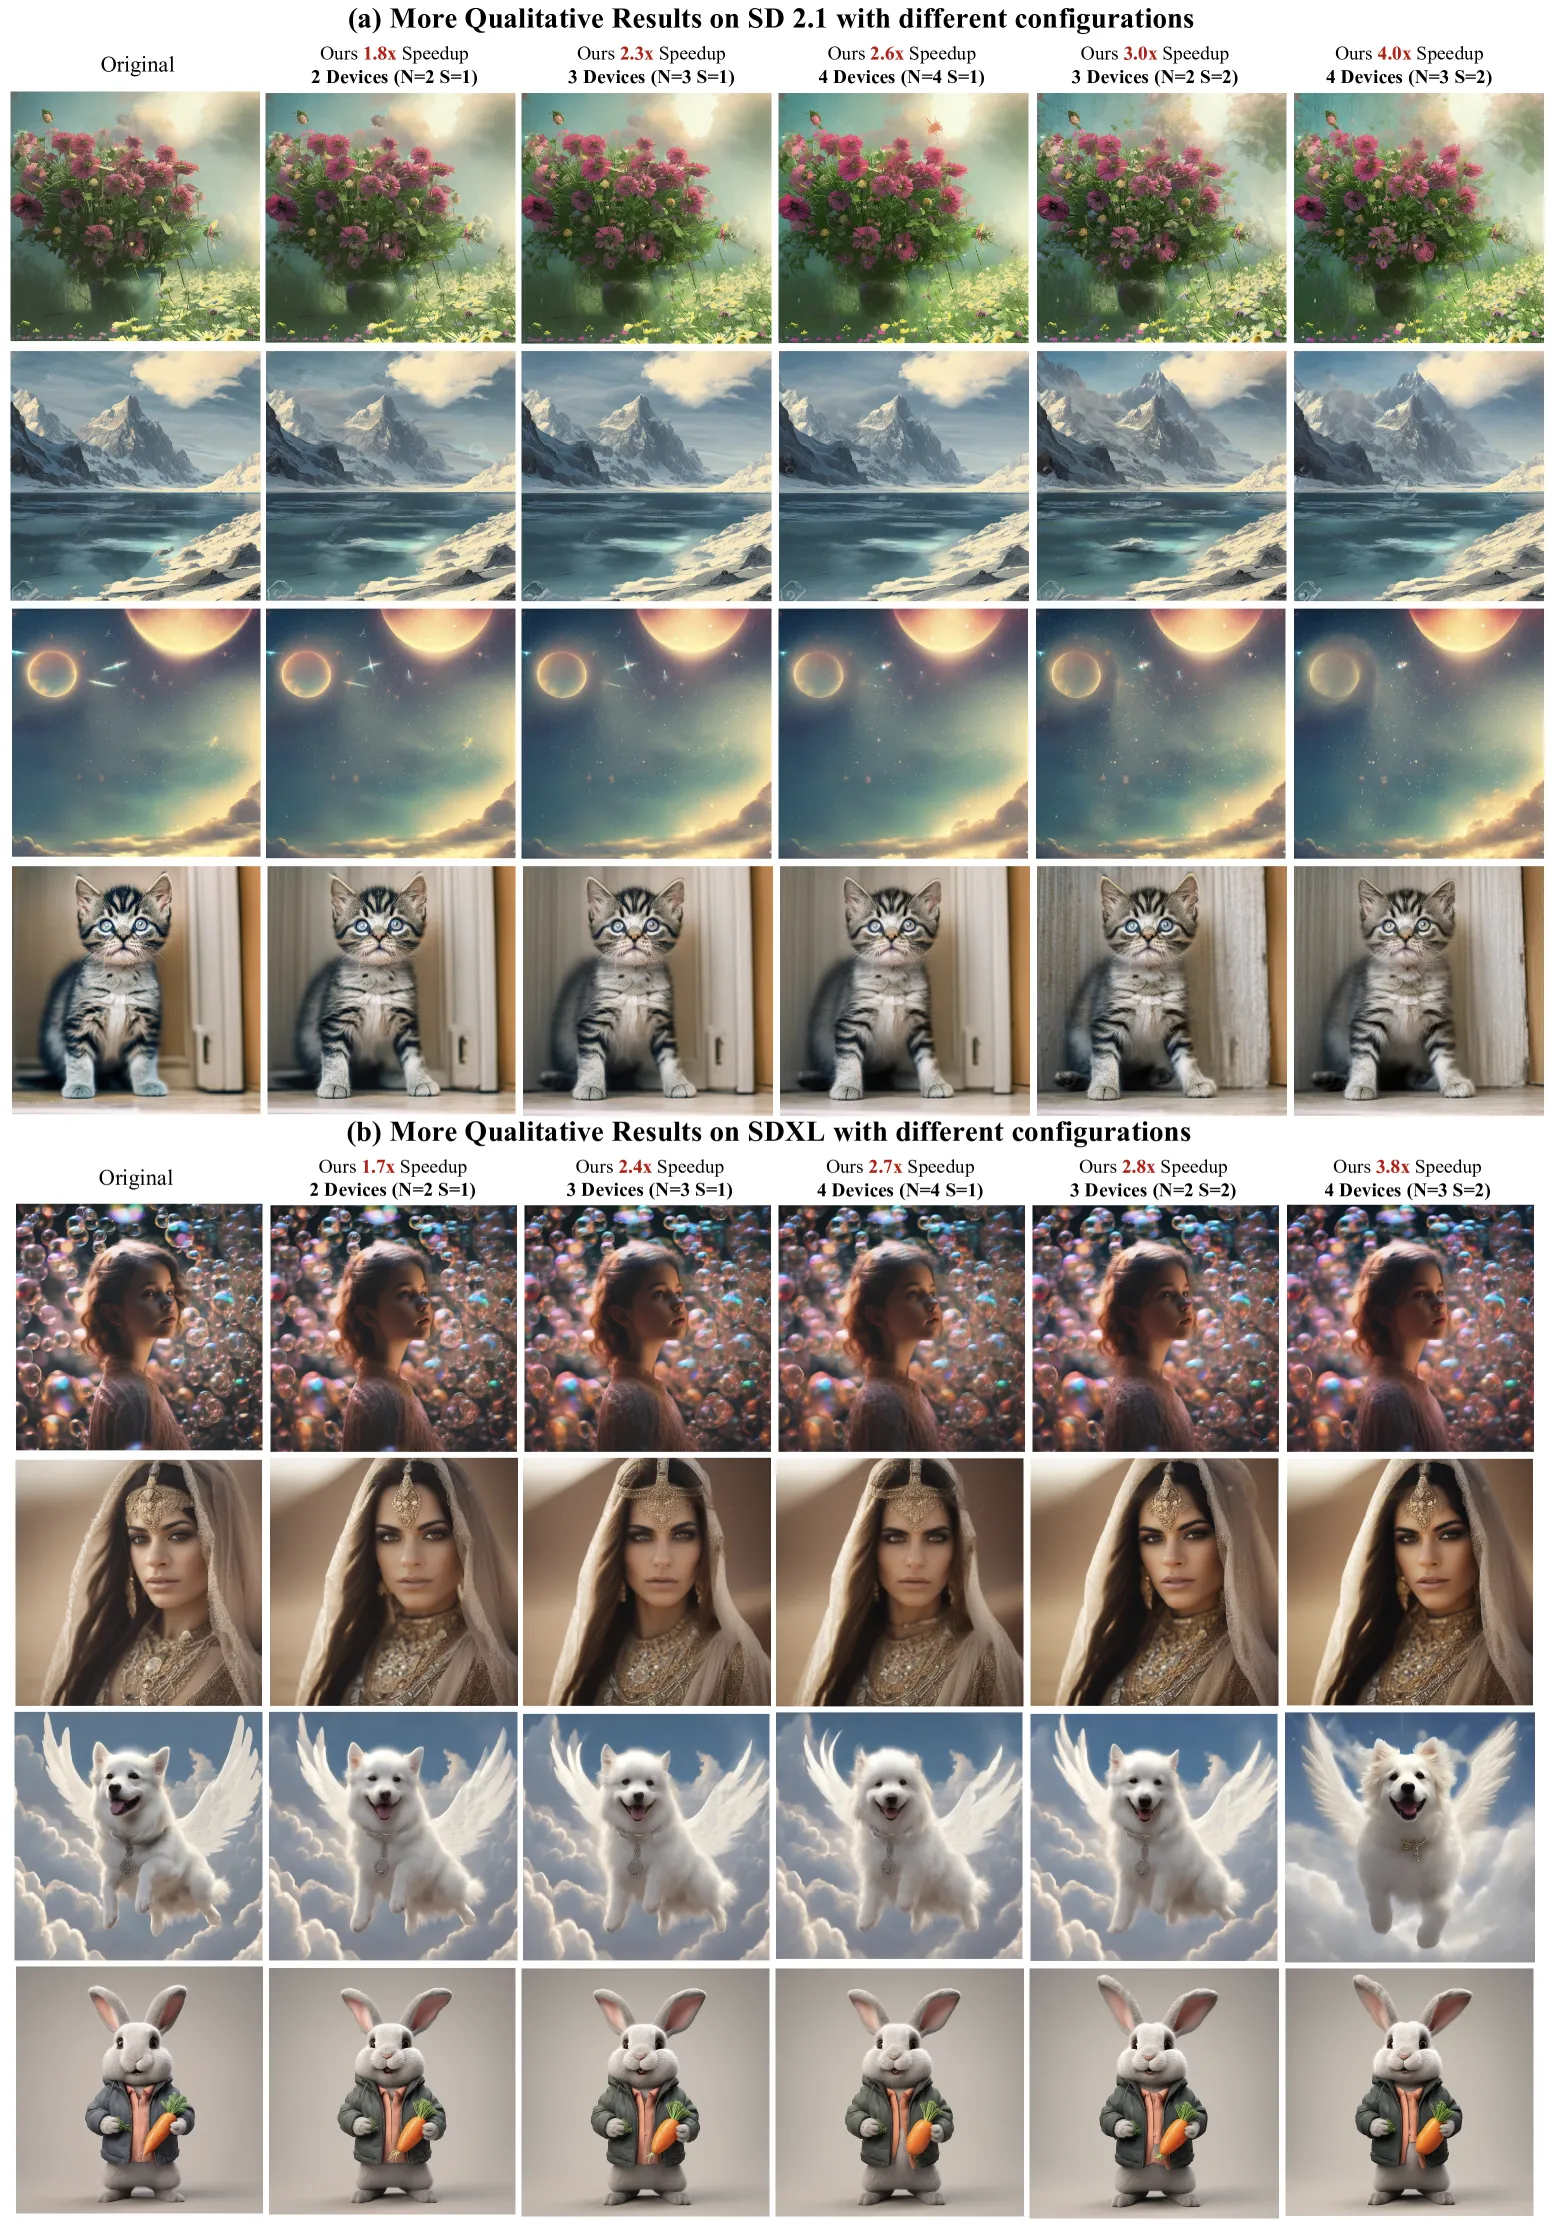
Figure 8: SD 2.1和SDXL在不同配置下的定性结果。
视频生成定性结果
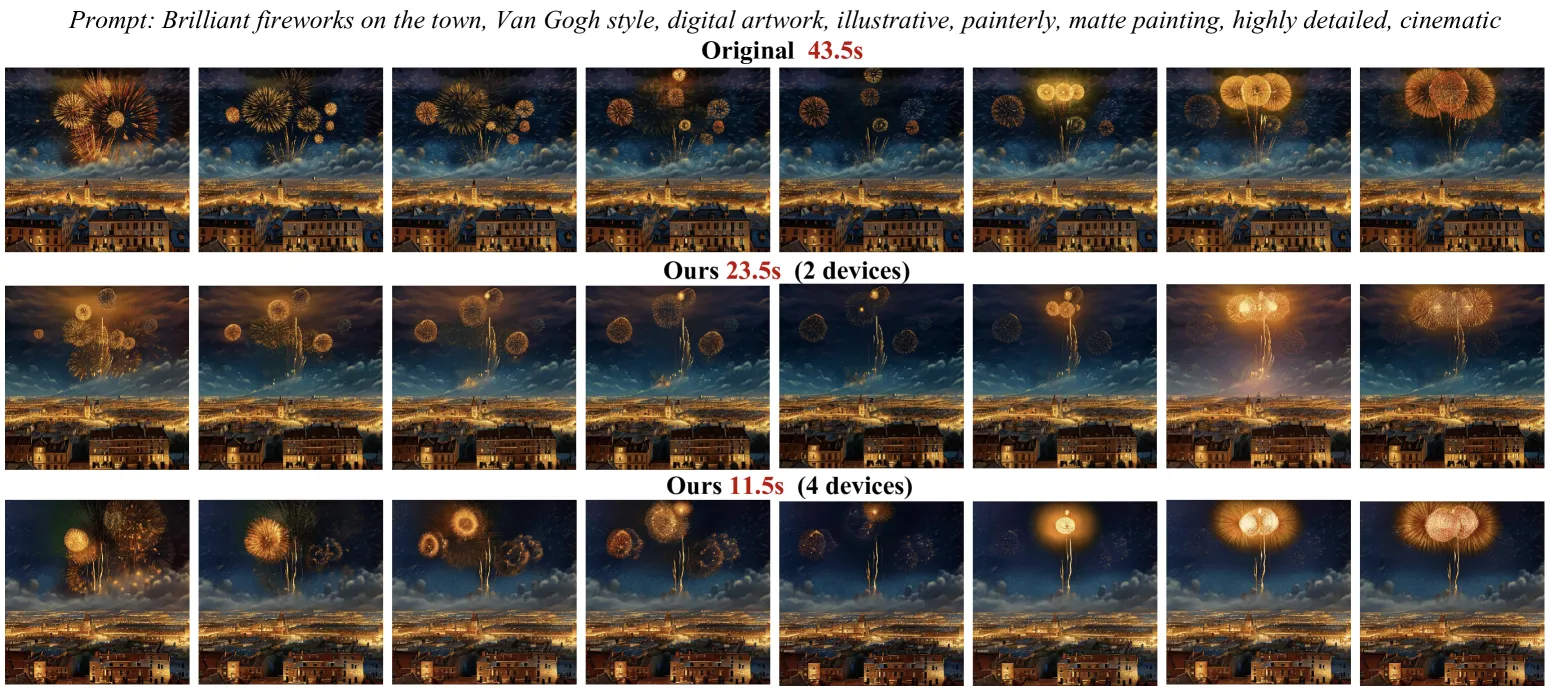
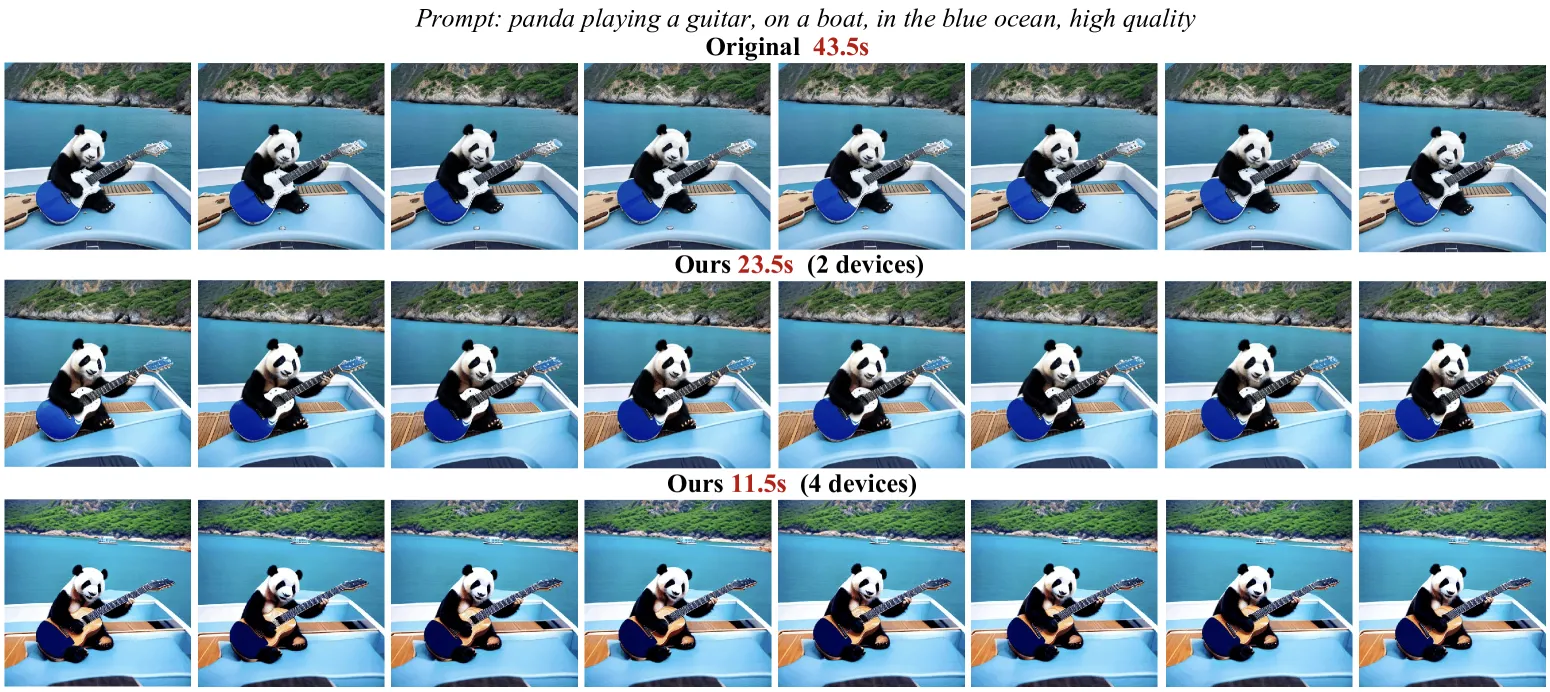
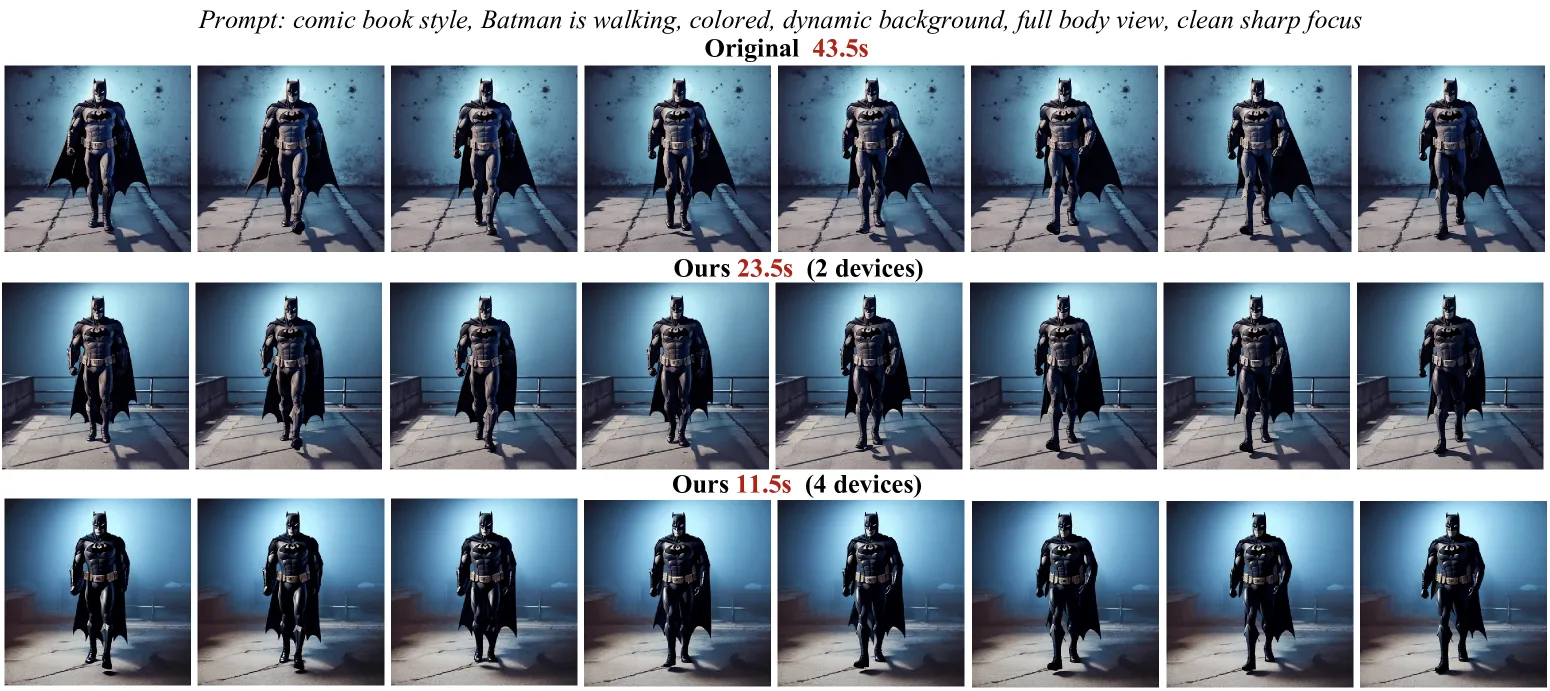
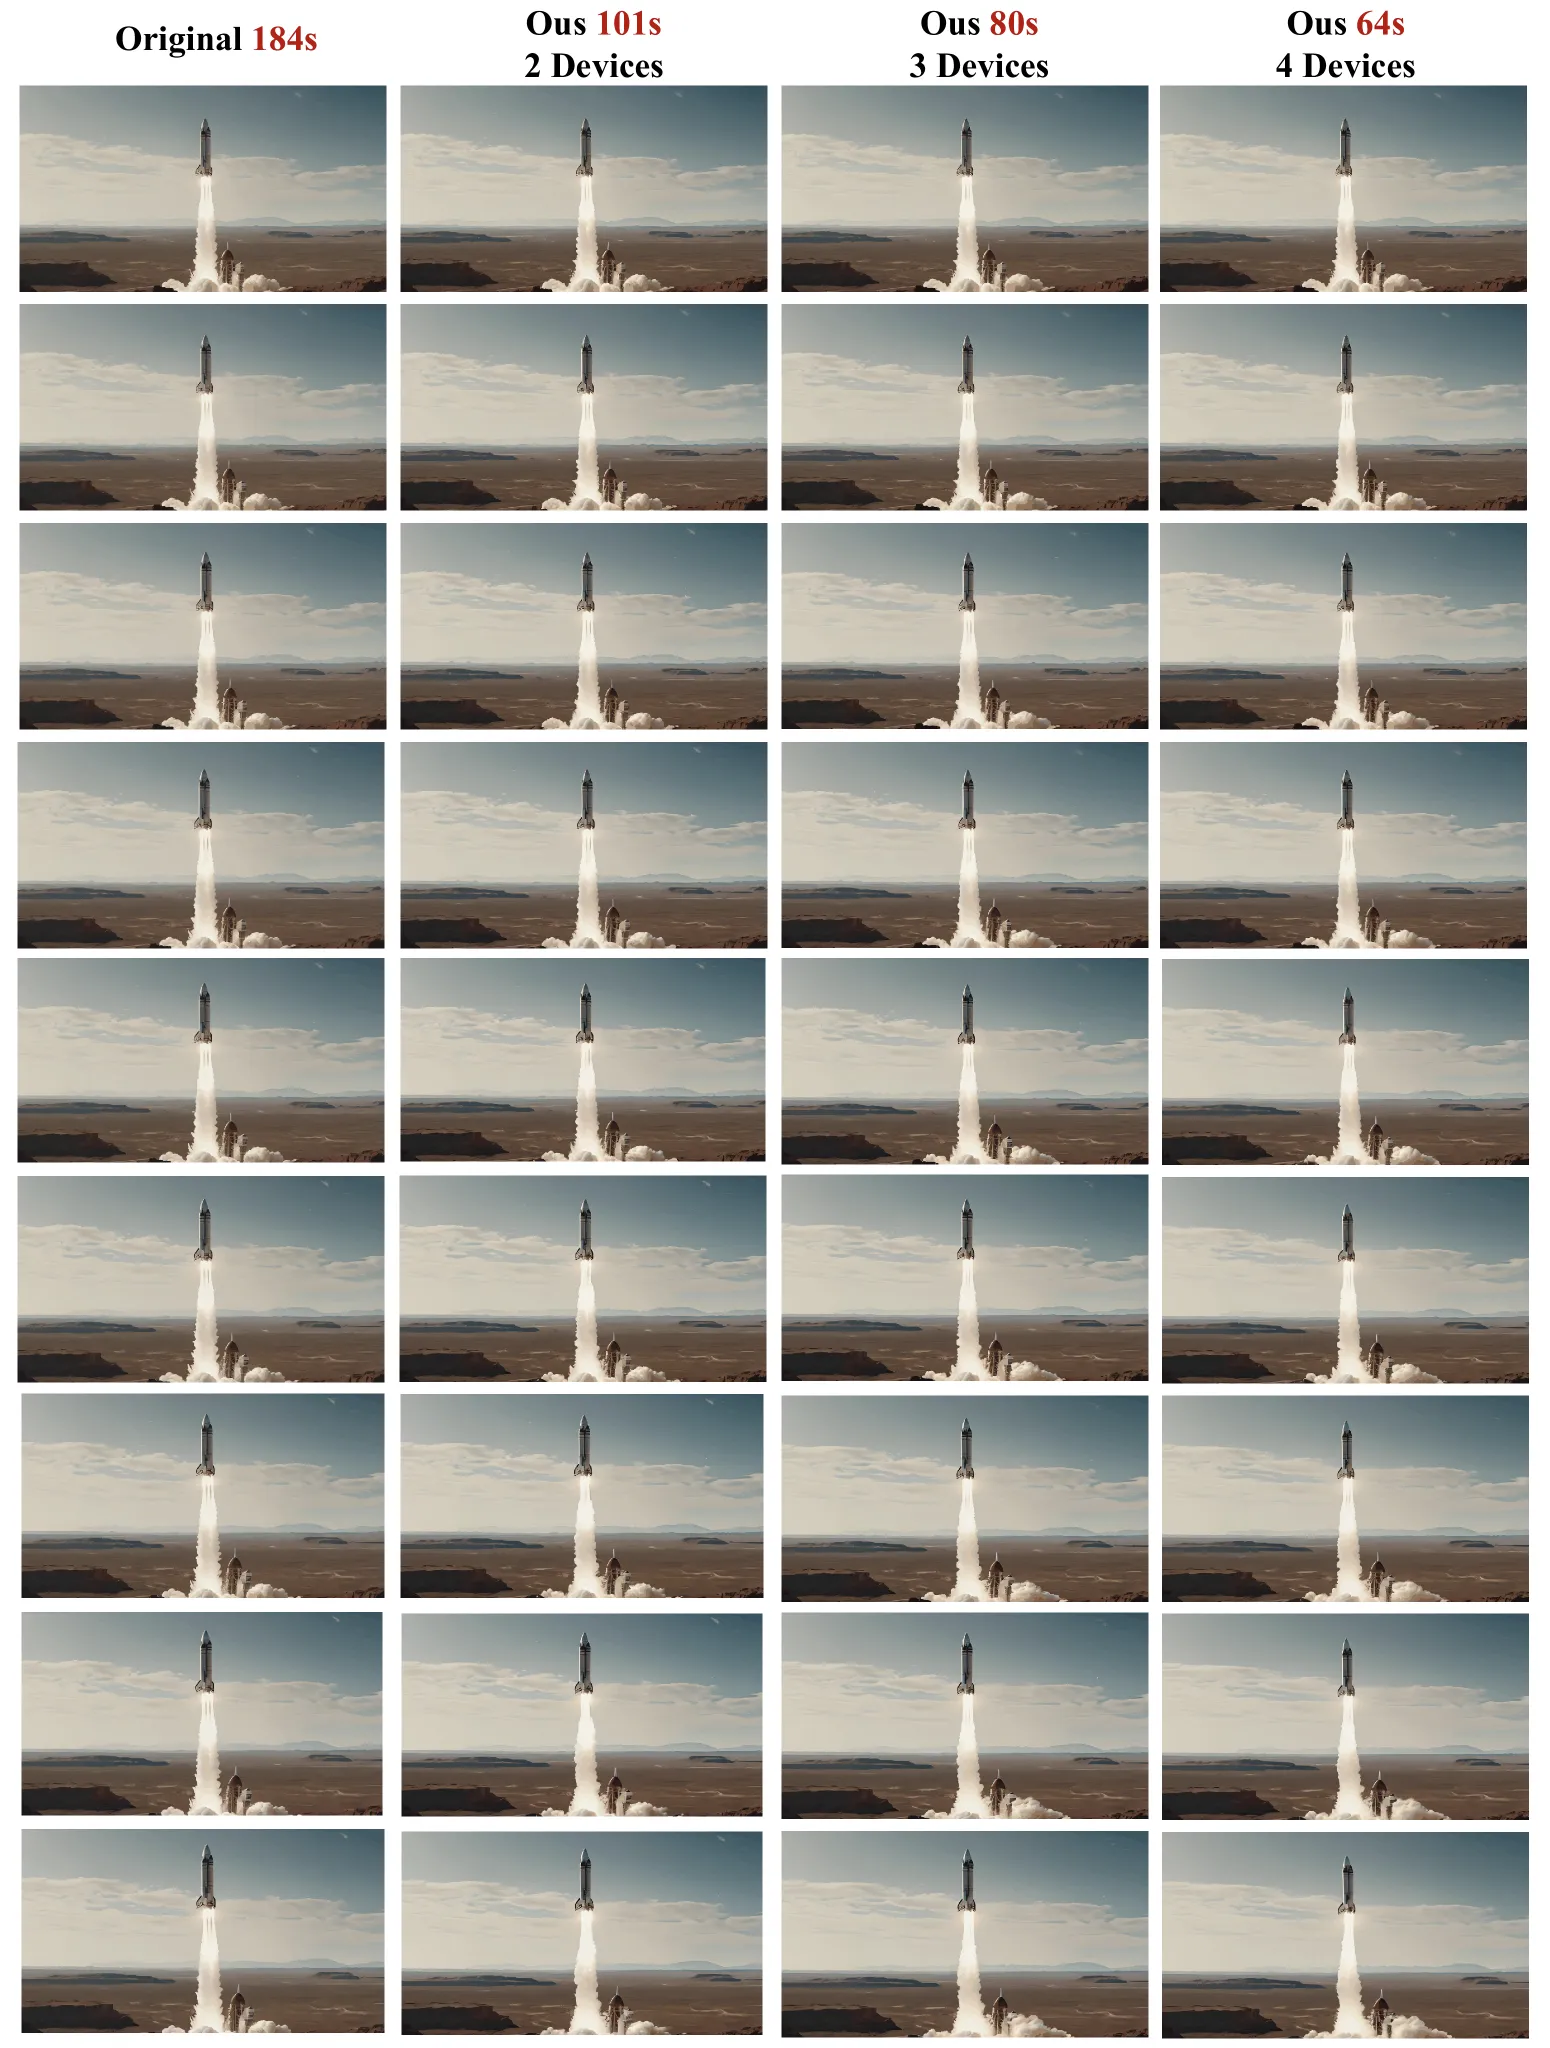
五、核心创新
| 创新点 | 说明 | 实验验证 |
|---|---|---|
| 异步去噪 | 打破顺序依赖链,实现组件并行 | 所有实验验证 |
| 步进去噪 | 单次并行完成多步去噪 | Table 5: 通信次数减半 |
| 通用框架 | 即插即用,适用于多种模型 | SD/SDXL/AnimateDiff/SVD |
| 模型并行 | 真正的分布式推理,非数据并行 | 与Distrifusion对比 |
| 低通信开销 | 通信仅占4-14% | Table 6验证 |
六、与相关方法对比
| 方法 | 并行方式 | 设备需求 | 内存开销 | AsyncDiff优势 |
|---|---|---|---|---|
| Distrifusion | Patch并行 | 8 GPU | 显著增加 | 更少设备,更少内存 |
| Faster Diffusion | 编码器传播 | 1 GPU | 翻倍 | 质量更好 |
| ParaDiGMS | Picard迭代 | - | - | 实际加速比更高 |
| DeepCache | 时间冗余 | 1 GPU | 不变 | 可叠加使用 |
| DDIM/DPM-Solver | 减少步数 | 1 GPU | 不变 | 可叠加使用 |
七、局限性
- 通信依赖:设备间通信能力影响性能
- 模型依赖:依赖预训练扩散模型
- Warm-up开销:需要少量顺序步骤初始化
- 内存占用:每设备需存储完整组件
八、总结
核心贡献
- 新范式:首次实现扩散模型的真正模型并行化
- 异步去噪:利用时间冗余打破顺序依赖链
- 步进去噪:进一步减少通信次数,提升效率
- 广泛验证:在图像和视频生成模型上验证有效性
性能总结
| 模型 | 最大加速比 | CLIP变化 | 设备数 |
|---|---|---|---|
| SD 2.1 | 4.0× | 31.60→31.22 (-0.38) | 4 GPU |
| SD 1.5 | 3.7× | 30.63→30.17 (-0.46) | 4 GPU |
| SDXL | 2.8× | 32.33→32.24 (-0.09) | 4 GPU |
| AnimateDiff | 3.8× | 30.65→30.20 (-0.45) | 4 GPU |
| SVD | 2.7× | 26.88→26.19 (-0.69) | 4 GPU |
技术影响
AsyncDiff开创了扩散模型分布式推理的新方向:
- 多GPU利用:真正实现模型并行,而非数据并行
- 可扩展性:加速比接近设备数线性增长
- 通用性:适用于图像和视频生成
- 可叠加性:可与DeepCache、DDIM等方法组合使用
九、参考资源
- 论文: arXiv:2406.06911
- 相关工作:
- DeepCache (2312.00858) - 时间冗余缓存
- Learning-to-Cache (2406.01733) - 层缓存
- PostDiff (2508.06160) - 混合分辨率去噪
- Distrifusion - Patch并行
- Stable Diffusion
- AnimateDiff