Learning-to-Cache: Accelerating Diffusion Transformer via Layer Caching
面向扩散Transformer的层缓存加速方法,通过可微分路由器学习最优缓存策略
Learning-to-Cache: Accelerating Diffusion Transformer via Layer Caching
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Learning-to-Cache: Accelerating Diffusion Transformer via Layer Caching |
| 作者 | Xinyin Ma, Gongfan Fang, Michael Bi Mi, Xinchao Wang |
| 论文 | arXiv:2406.01733 |
| 发布 | 2024-06-03 |
| 主题 | cs.CV (Computer Vision and Pattern Recognition) |
| 关联 | DeepCache作者的后续工作,将缓存概念扩展到Transformer架构 |
二、核心思想
问题定义
扩散Transformer(Diffusion Transformers)在各种任务中展现出前所未有的生成能力,但其推理速度慢是一个主要障碍——每个去噪步骤都需要对大规模Transformer模型进行推理。
核心问题:如何在不更新模型参数的情况下,通过缓存机制加速扩散Transformer的推理?
核心观察
层冗余的普遍存在:
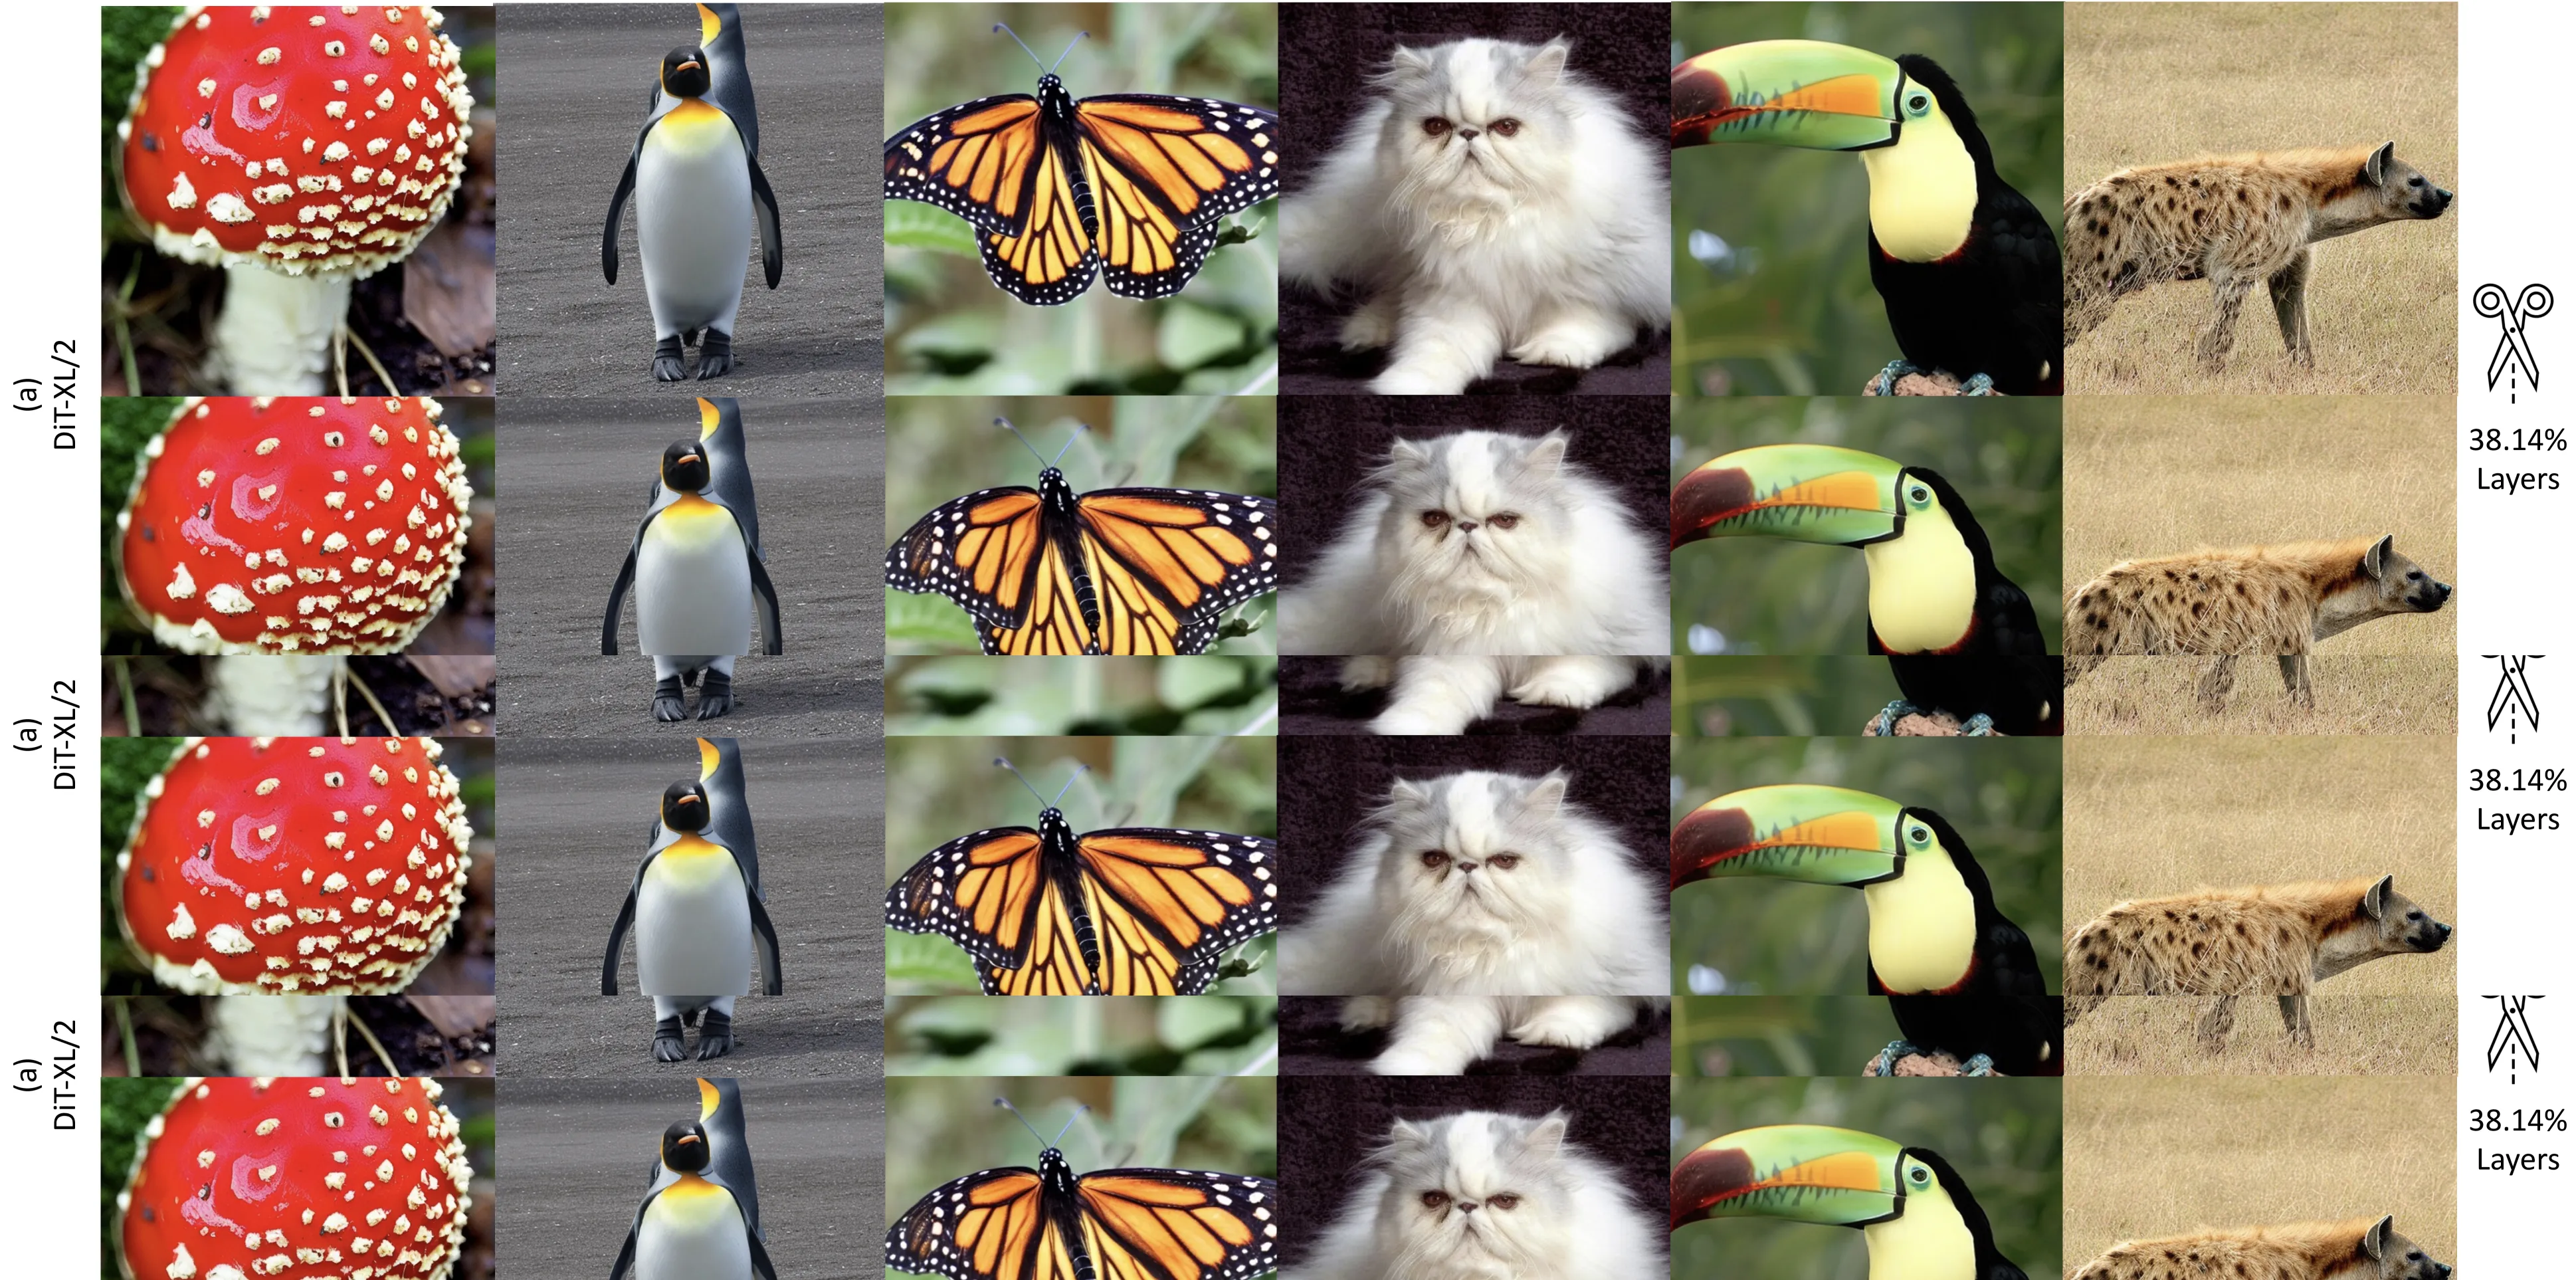
Figure 1: (a) 使用DiT-XL/2生成512×512图像。(b) 使用U-ViT-H/2生成256×256图像。
关键发现:
- U-ViT-H/2:约**93.68%**的层在缓存步骤中可缓存
- DiT-XL/2:约**47.43%**的层可缓存
- 两者均在几乎无性能损失的情况下实现(ΔFID < 0.01)
解决方案概述
Learning-to-Cache (L2C):一种专为扩散Transformer设计的加速方法。
核心思想:
- 将非可微分的层选择问题转化为可微分的优化问题
- 通过插值机制学习最优的层缓存策略
- 训练一个连续路由器,推理时离散化
三、技术架构
方法概述
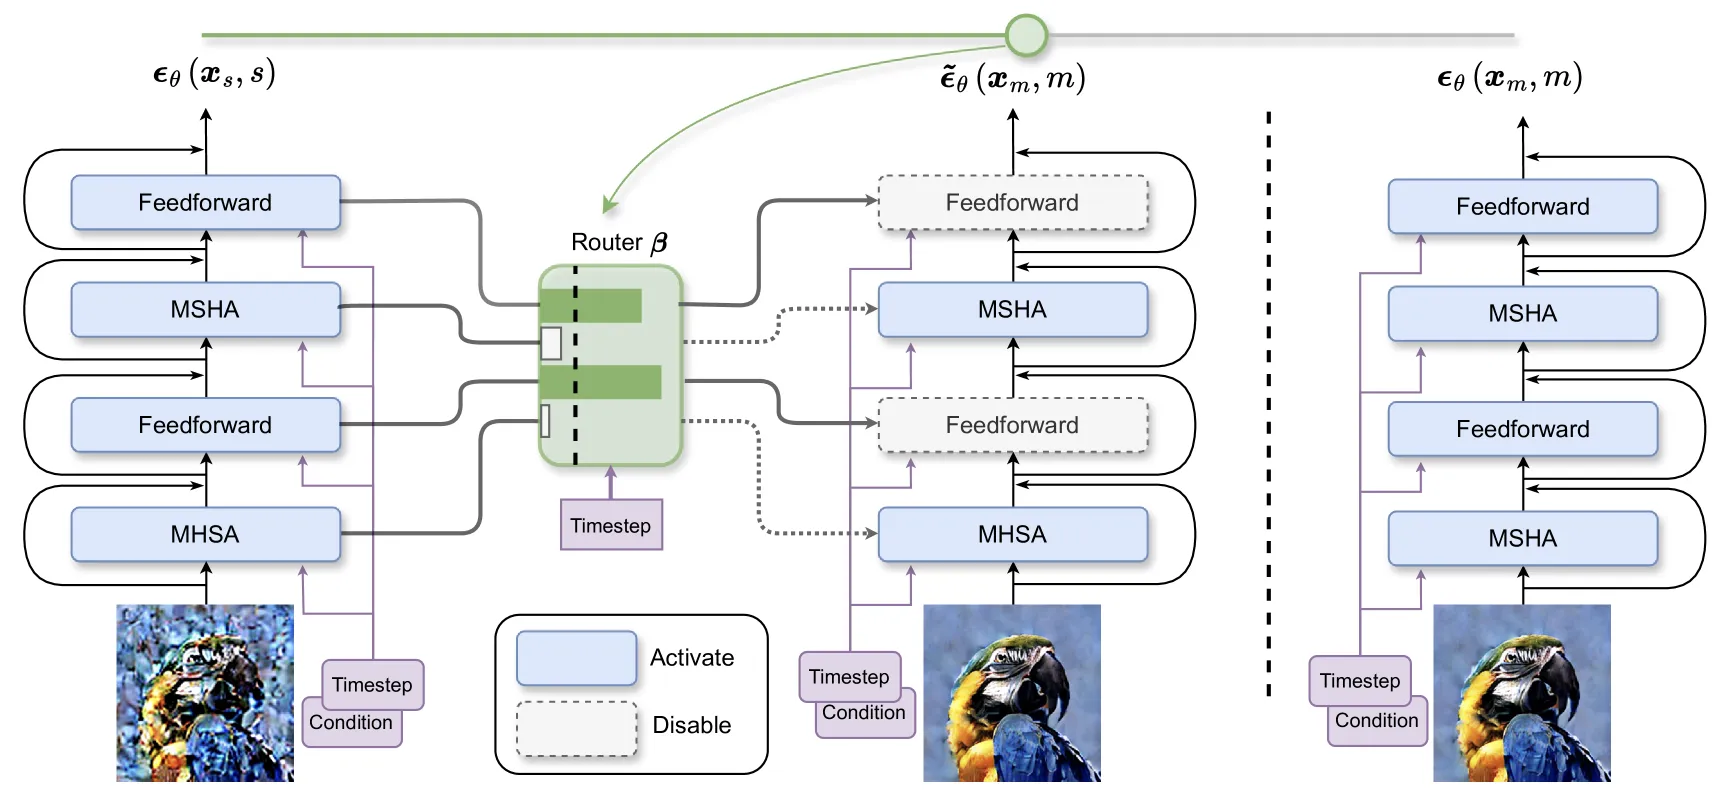
Figure 2: Learning-to-Cache示意图。当层被激活时,计算正常进行;否则复用前一步的缓存结果。
问题形式化
标准去噪过程:
给定两个时间步 和 ,反向扩散过程:
两种解决方案:
- 快速但次优:直接复用
- 最优但昂贵:计算
插值机制
关键创新:在两种方案之间进行插值,寻找既快速又高质量的中间解。
对于第 层,定义插值:
其中:
- :跳过该层计算,复用前一步结果
- :执行计算
- :时间步相关的缩放函数
可微分路由器
优化目标:
训练过程:
- 仅优化路由器参数 (如DiT-XL-2有560个可训练变量)
- 在ImageNet训练集上训练1个epoch
- 学习率0.01
近似误差分析
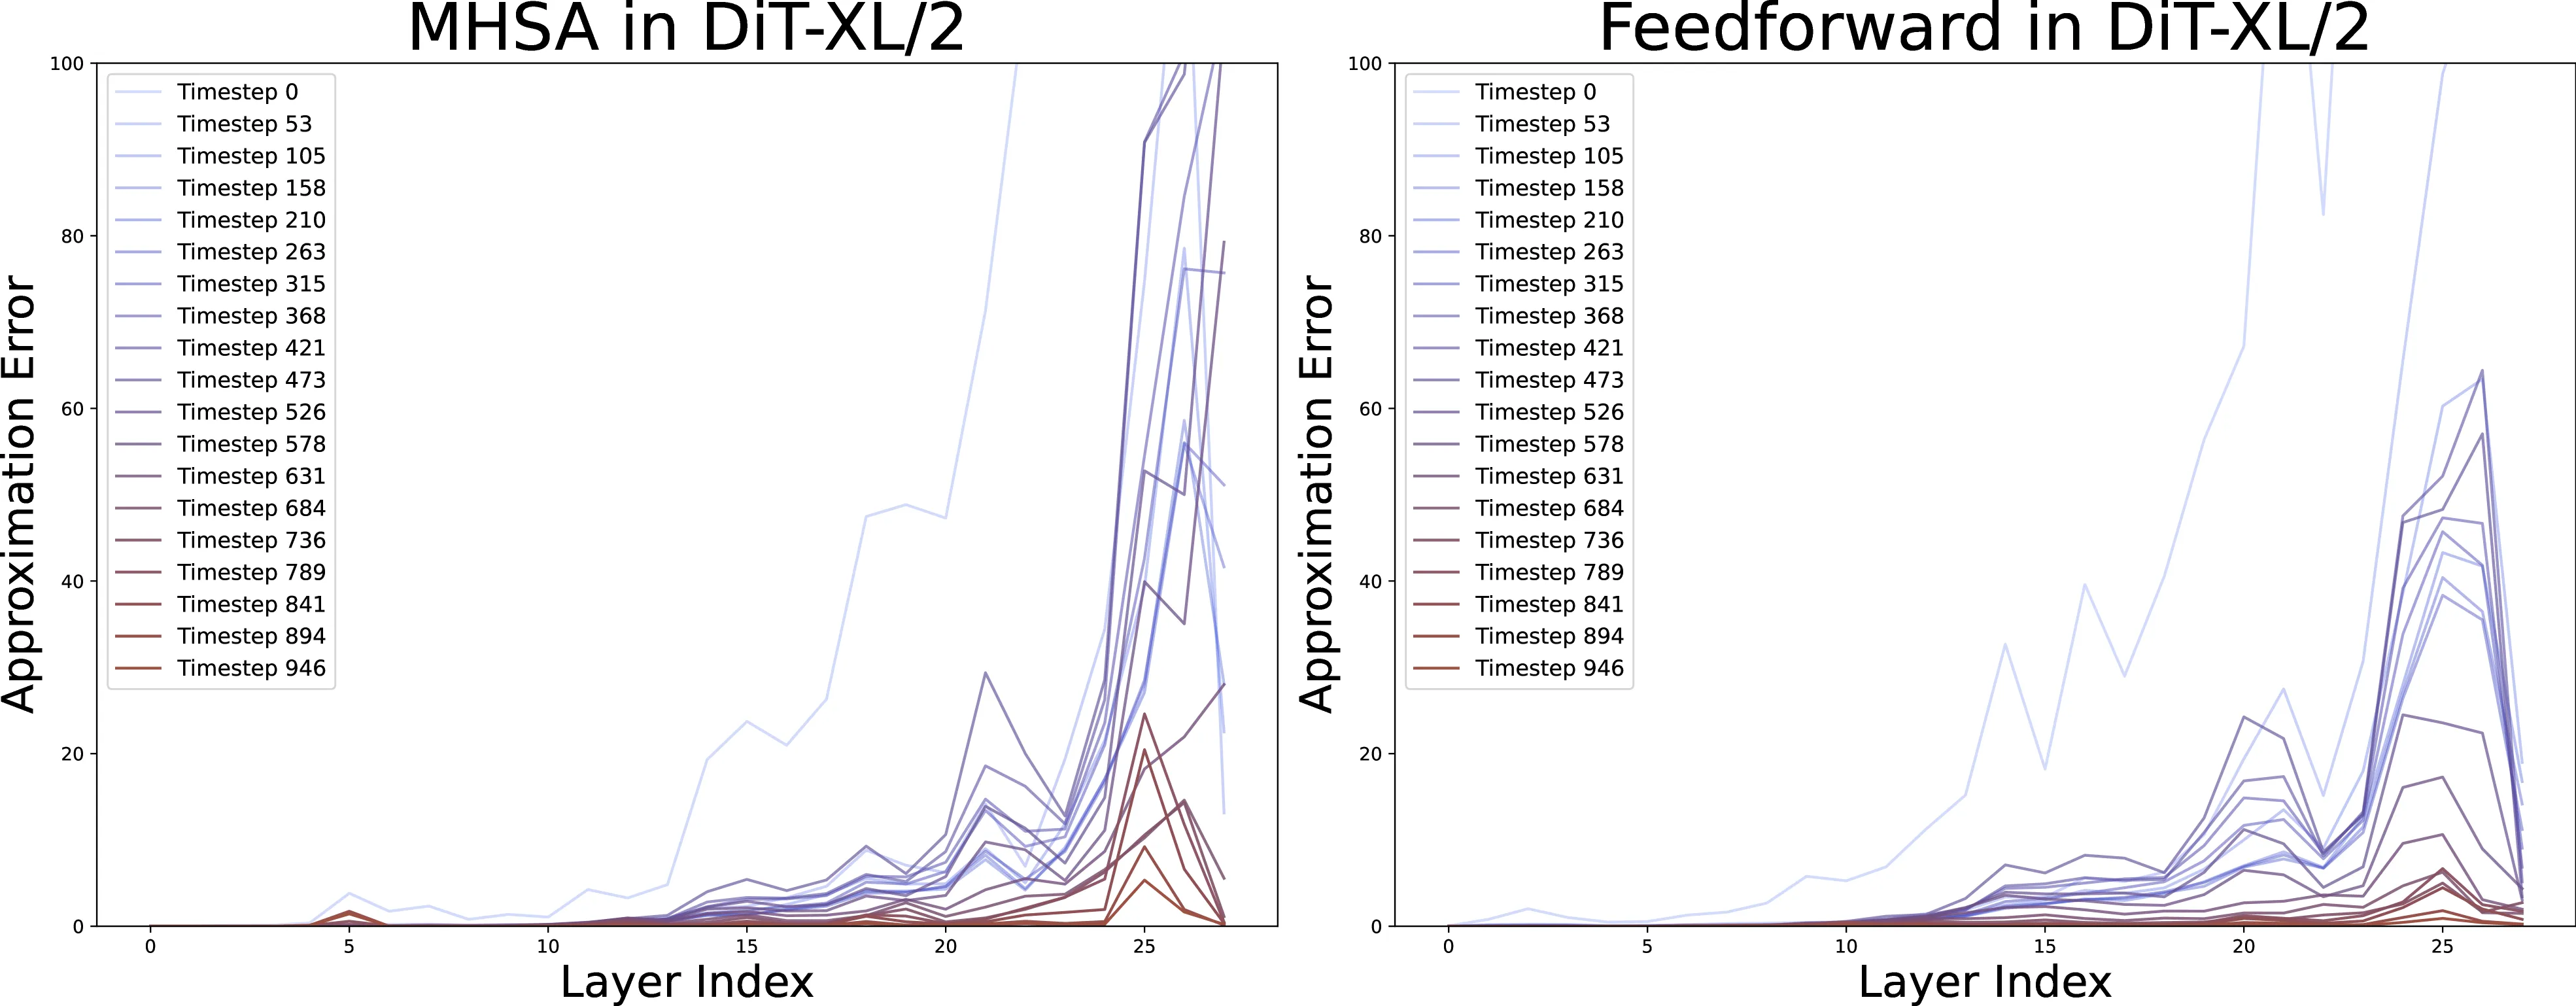
Figure 3: DiT和U-ViT在不同时间步和不同层的近似误差。
关键观察:
- 不同模型的可缓存层比例差异显著
- U-ViT中间部分几乎完全可缓存
- DiT的缓存模式更分散
四、实验结果
DiT模型结果
Table 1: DiT模型在ImageNet上的加速结果
| 模型 | 方法 | NFE | MACs(T) | 延迟(s) | 加速比 | FID ↓ |
|---|---|---|---|---|---|---|
| DiT-XL/2 (256²) | DDIM | 50 | 5.72 | 7.25 | 1.00× | 2.26 |
| DDIM | 20 | 2.29 | 2.87 | 1.00× | 3.48 | |
| L2C | 50 | 4.36 | 5.57 | 1.30× | 2.27 | |
| L2C | 20 | 1.78 | 2.26 | 1.27× | 3.46 | |
| DiT-XL/2 (512²) | DDIM | 50 | 22.90 | 30.41 | 1.00× | 2.84 |
| L2C | 50 | 17.46 | 23.41 | 1.30× | 2.85 |
关键结果:
- DiT-XL/2 (256²): 1.30倍加速,FID几乎不变(2.26→2.27)
- DiT-XL/2 (512²): 1.30倍加速,FID仅增加0.01
U-ViT模型结果
Table 2: U-ViT-H/2在ImageNet上的结果
| 方法 | NFE | MACs | 延迟 | 加速比 | FID ↓ |
|---|---|---|---|---|---|
| DPM-Solver | 50 | 6.44 | 19.37 | 1.00× | 2.37 |
| DPM-Solver | 30 | 3.86 | 11.55 | 1.68× | 2.46 |
| L2C | 50 | 3.79 | 11.16 | 1.74× | 2.36 |
| DPM-Solver | 20 | 2.58 | 7.69 | 1.00× | 2.57 |
| L2C | 20 | 1.92 | 5.64 | 1.35× | 2.58 |
关键结果:
- U-ViT-H/2: 1.74倍加速,FID甚至略有改善(2.37→2.36)
速度-质量权衡
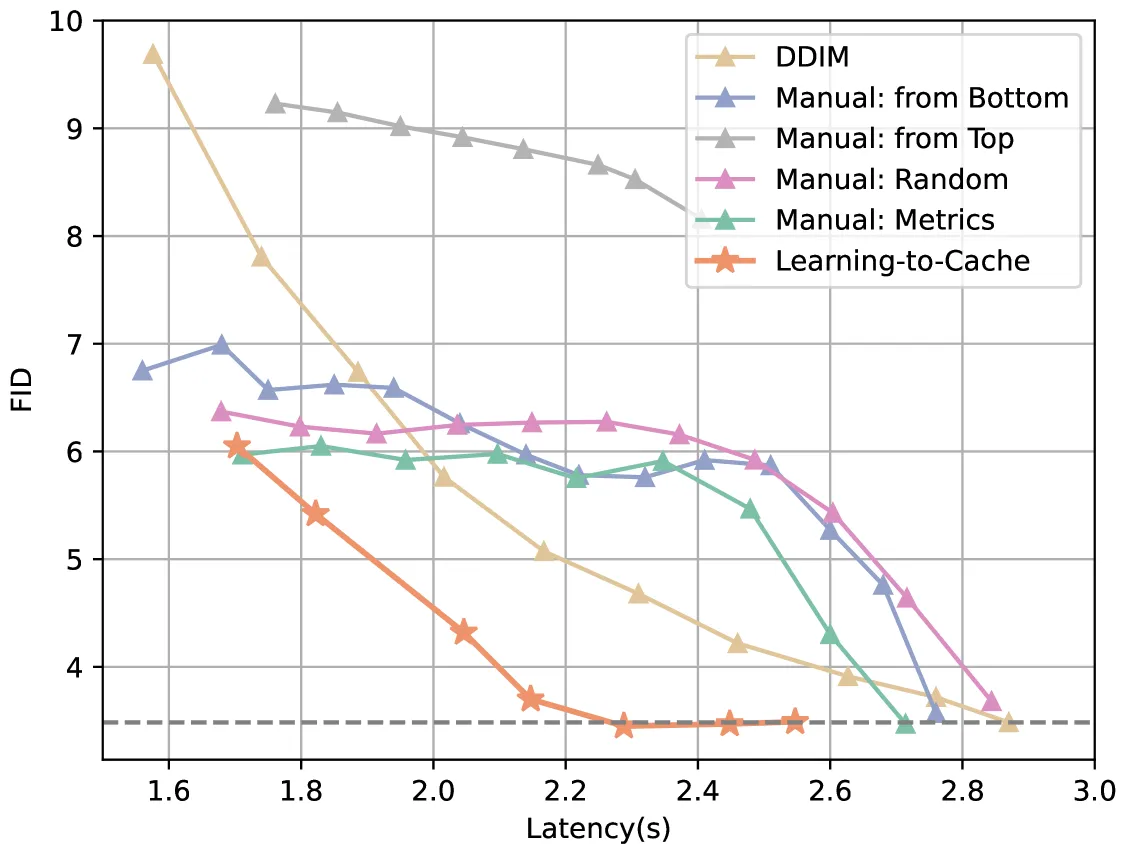
Figure 4: DiT-XL/2和U-ViT-H/2的速度-质量权衡曲线。
关键发现:
- L2C在所有加速比下均优于启发式方法
- 存在可缓存层的上限,低于此上限时图像质量几乎不受影响
与其他缓存方法对比
Table 3: 与其他缓存方法在U-ViT上的对比
| 方法 | NFE | 延迟 | 加速比 | FID ↓ |
|---|---|---|---|---|
| DPM-Solver | 20 | 7.69 | 1.00× | 2.57 |
| DeepCache | 20 | 4.68 | 1.64× | 2.70 |
| L2C | 20 | 4.62 | 1.67× | 2.64 |
| Faster Diffusion | 20 | 5.95 | 1.29× | 2.82 |
| L2C | 20 | 5.93 | 1.30× | 2.57 |
关键发现:
- L2C在U-ViT上优于DeepCache和Faster Diffusion
- FID保持更好(2.64 vs 2.70)
学习到的路由器模式
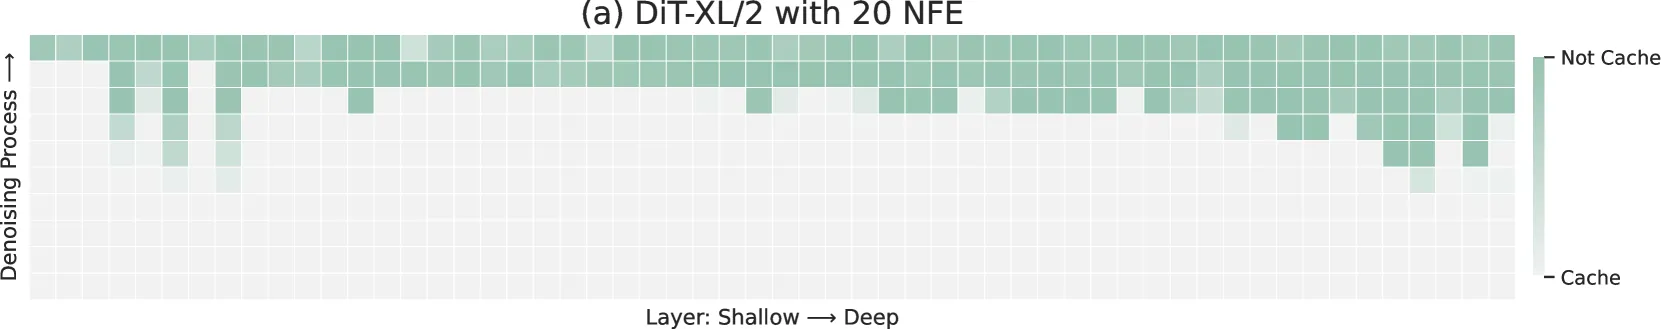
Figure 5: DiT-XL/2(上)和U-ViT-H/2(下)学习到的路由器β。
关键观察:
- U-ViT:中间部分几乎完全可缓存,两端不可丢弃
- DiT:缓存模式更分散,不同层有不同策略
- 这解释了为什么DeepCache在U-Net上效果更好
与层丢弃对比
Table 5: 与层丢弃方法的对比
| 方法 | 移除比例 | 延迟(s) | 加速比 | FID ↓ | sFID ↓ |
|---|---|---|---|---|---|
| Random Drop | 170/560 | 2.439 | 1.18× | 277.42 | 171.83 |
| Learn-to-Drop | 179/560 | 2.421 | 1.19× | 17.35 | 28.46 |
| Learn-to-Cache | 176/560 | 2.438 | 1.18× | 3.47 | 4.58 |
关键发现:
- 层缓存显著优于层丢弃
- 缓存保持像素级一致性,丢弃会破坏生成质量
阈值效应
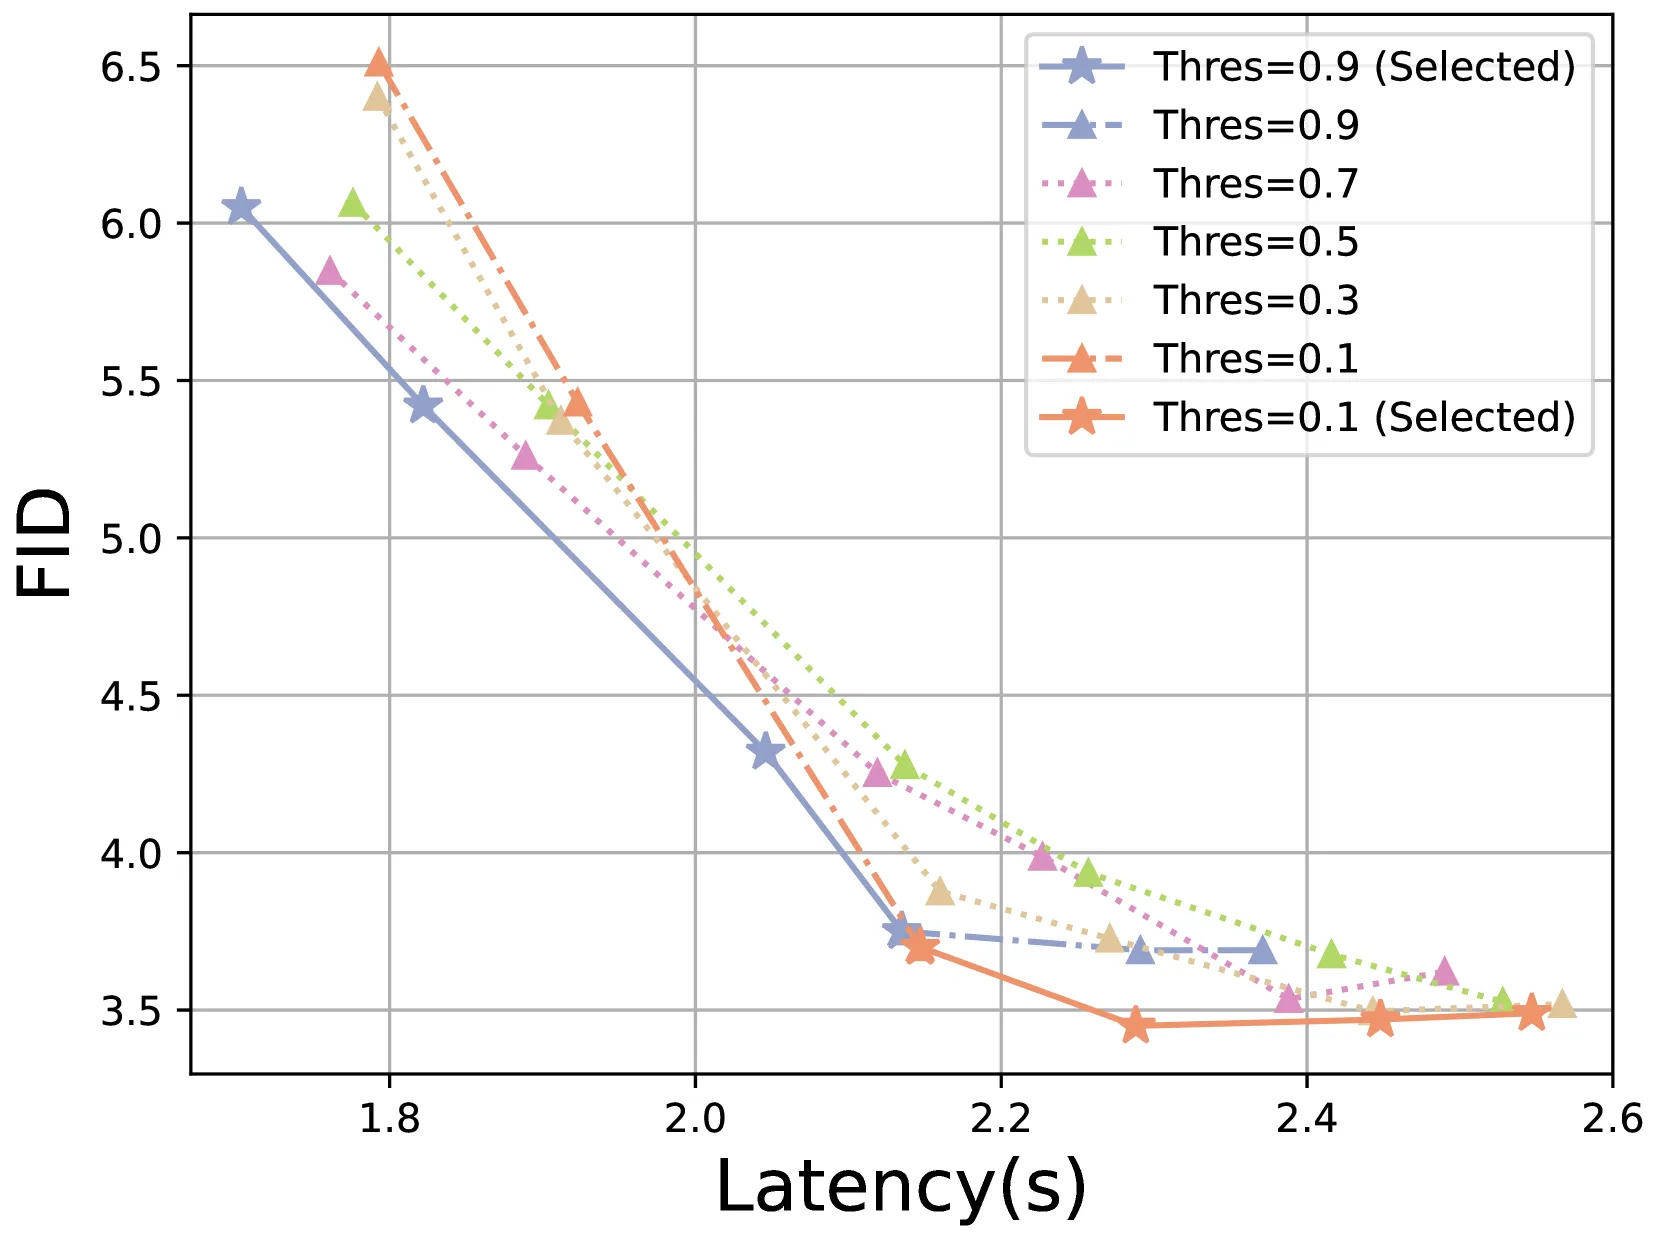
Figure 6: 阈值θ对图像质量的影响。
关键发现:
- 高加速比需要较大阈值
- 低加速比需要较小阈值以保持质量
缓存步移位技巧
Table 6: DPM-Solver的缓存步移位
| 方法 | NFE | 延迟 | 加速比 | FID ↓ |
|---|---|---|---|---|
| DPM-Solver-2 | 20 | 7.69 | 1.00× | 2.57 |
| Cache | 20 | 4.25 | 1.81× | 5.30 |
| Cache-shifted | 20 | 4.54 | 1.70× | 2.80 |
关键发现:
- 移位缓存步可显著改善质量(5.30→2.80)
- 因为DPM-Solver-2需要一阶导数
超参数分析
Table 9: 不同λ值的性能
| λ | 移除比例 | 延迟(s) | 加速比 | FID ↓ |
|---|---|---|---|---|
| 0 | 0/560 | 2.87 | 1.00× | 3.48 |
| 5e-7 | 129/560 | 2.55 | 1.13× | 3.49 |
| 1e-6 | 176/560 | 2.45 | 1.17× | 3.47 |
| 5e-6 | 248/560 | 2.28 | 1.26× | 3.45 |
| 1e-5 | 300/560 | 2.15 | 1.33× | 3.70 |
| 5e-5 | 404/560 | 1.92 | 1.49× | 5.43 |
| 1e-4 | 460/560 | 1.79 | 1.60× | 6.51 |
关键发现:
- λ控制路由器稀疏度
- λ越大,可缓存层越多,但质量下降
- 最佳λ取决于目标加速比
五、核心创新
| 创新点 | 说明 | 实验验证 |
|---|---|---|
| 可微分层选择 | 将离散选择转化为连续优化 | 所有实验验证 |
| 插值机制 | 在快速次优和最优昂贵之间插值 | 理论证明+实验验证 |
| 连续路由器 | 训练连续,推理离散 | 560个参数即可优化 |
| 通用性 | 适用于DiT和U-ViT架构 | 两种架构验证 |
| 缓存步移位 | 针对DPM-Solver的优化 | Table 6验证 |
六、与相关方法对比
| 方法 | 适用架构 | 特点 | L2C优势 |
|---|---|---|---|
| DeepCache | U-Net | 基于skip connection | 可用于Transformer |
| Faster Diffusion | U-Net | 层丢弃 | 更好的质量保持 |
| Diff-Pruning | U-Net | 结构剪枝 | 免训练,更通用 |
| DDIM/DPM-Solver | 通用 | 减少采样步数 | 可叠加使用 |
| 层丢弃 | 通用 | 直接移除层 | 缓存优于丢弃 |
七、局限性
- 模型依赖性:不同模型的可缓存层比例差异显著
- 分辨率影响:DiT-XL/2在512分辨率下FID略有下降
- 需要训练路由器:虽然只需1个epoch,但仍需训练
- 超参数敏感:λ和θ需要针对不同模型调整
八、总结
核心贡献
- 新范式:首次将层缓存概念系统化应用于扩散Transformer
- 可微分优化:将离散层选择问题转化为可微分问题
- 显著加速:U-ViT 1.74倍,DiT 1.30倍,几乎无质量损失
- 理论分析:证明了插值机制的有效性
性能总结
| 模型 | 加速比 | FID变化 | 训练成本 |
|---|---|---|---|
| DiT-XL/2 (256²) | 1.30× | 2.26→2.27 (+0.01) | 1 epoch |
| DiT-XL/2 (512²) | 1.30× | 2.84→2.85 (+0.01) | 1 epoch |
| U-ViT-H/2 | 1.74× | 2.37→2.36 (-0.01) | 1 epoch |
技术影响
L2C展示了Transformer架构特有的加速潜力:
- 层一致性:Transformer层结构一致,更适合缓存
- 可学习性:路由器可学习最优缓存策略
- 通用性:可扩展到视频生成、3D生成等任务
九、参考资源
- 论文: arXiv:2406.01733
- 相关工作:
- DeepCache (2312.00858) - U-Net缓存加速
- PostDiff (2508.06160) - 混合分辨率去噪
- DiT - Diffusion Transformer
- U-ViT - U-shaped Vision Transformer