Helix: Serving Large Language Models over Heterogeneous GPUs and Network via Max-Flow
基于最大流的异构GPU集群LLM推理服务系统
Helix: Serving Large Language Models over Heterogeneous GPUs and Network via Max-Flow
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Helix: Serving Large Language Models over Heterogeneous GPUs and Network via Max-Flow |
| 作者 | Yixuan Mei, Yonghao Zhuang, Xupeng Miao, Juncheng Yang, Zhihao Jia, Rashmi Vinayak |
| 机构 | Carnegie Mellon University |
| 论文 | https://arxiv.org/abs/2406.01566 |
| 代码 | https://github.com/Thesys-lab/Helix-ASPLOS25 |
| 发布 | 2024-06-03 (v1), 2025-03-05 (v2) |
| 会议 | ASPLOS 2025 |
| 类别 | cs.DC, cs.CL, cs.LG |
核心亮点
- 首次将异构GPU集群LLM服务建模为最大流问题
- MILP最优模型放置:混合整数线性规划求解最优模型分区和放置
- Per-Request Pipeline:每个请求独立分配流水线,最大化资源利用
- 3.3x吞吐量提升:相比现有方案,吞吐量提升最高3.3倍
- 66% Prompt延迟降低:24% Decode延迟降低
- ASPLOS 2025:顶级系统会议
二、核心思想
问题定义
现代LLM规模越来越大,需要大量GPU来服务。然而:
- GPU异构性:云平台包含多种GPU类型(H100、A100、V100、L4、T4),性能和内存差异巨大
- 地理分布:GPU实例分布在不同区域,跨区域网络带宽有限(60-200 Mbps)
- 资源稀缺:单一区域内难以分配到足够的同构GPU
Table 1: 服务LLM所需的最少GPU数量
| LLM | 参数量 | L4 | A100 | H100 |
|---|---|---|---|---|
| LLaMA-2 | 70B | 12 | 7 | 4 |
| GPT-3 | 175B | 30 | 18 | 9 |
| Grok-1 | 314B | 53 | 32 | 16 |
| LLaMA-3 | 405B | 68 | 41 | 21 |
Table 3: GPU规格对比
| GPU | FP16 (TFLOPs) | 内存 (GB) | 带宽 (GB/s) | 功耗 (W) | 价格 (USD) |
|---|---|---|---|---|---|
| H100 | 1979 | 80 | 3350 | 700 | 25k-40k |
| A100 | 312 | 40 | 1555 | 400 | 10k-15k |
| L4 | 242 | 24 | 300 | 72 | ~3k |
| T4 | 65 | 16 | 300 | 70 | ~1k |
解决方案概述
Helix将异构GPU集群上的LLM推理建模为最大流(Max-Flow)问题:
- 图抽象:将GPU节点抽象为图的节点,网络连接抽象为边,边容量由GPU计算能力和网络带宽决定
- MILP优化:使用混合整数线性编程求解最优模型放置策略
- Per-Request Pipeline:每个请求独立分配流水线,而非使用固定流水线
- IWRR调度:交错加权轮询调度器,按最大流分配请求
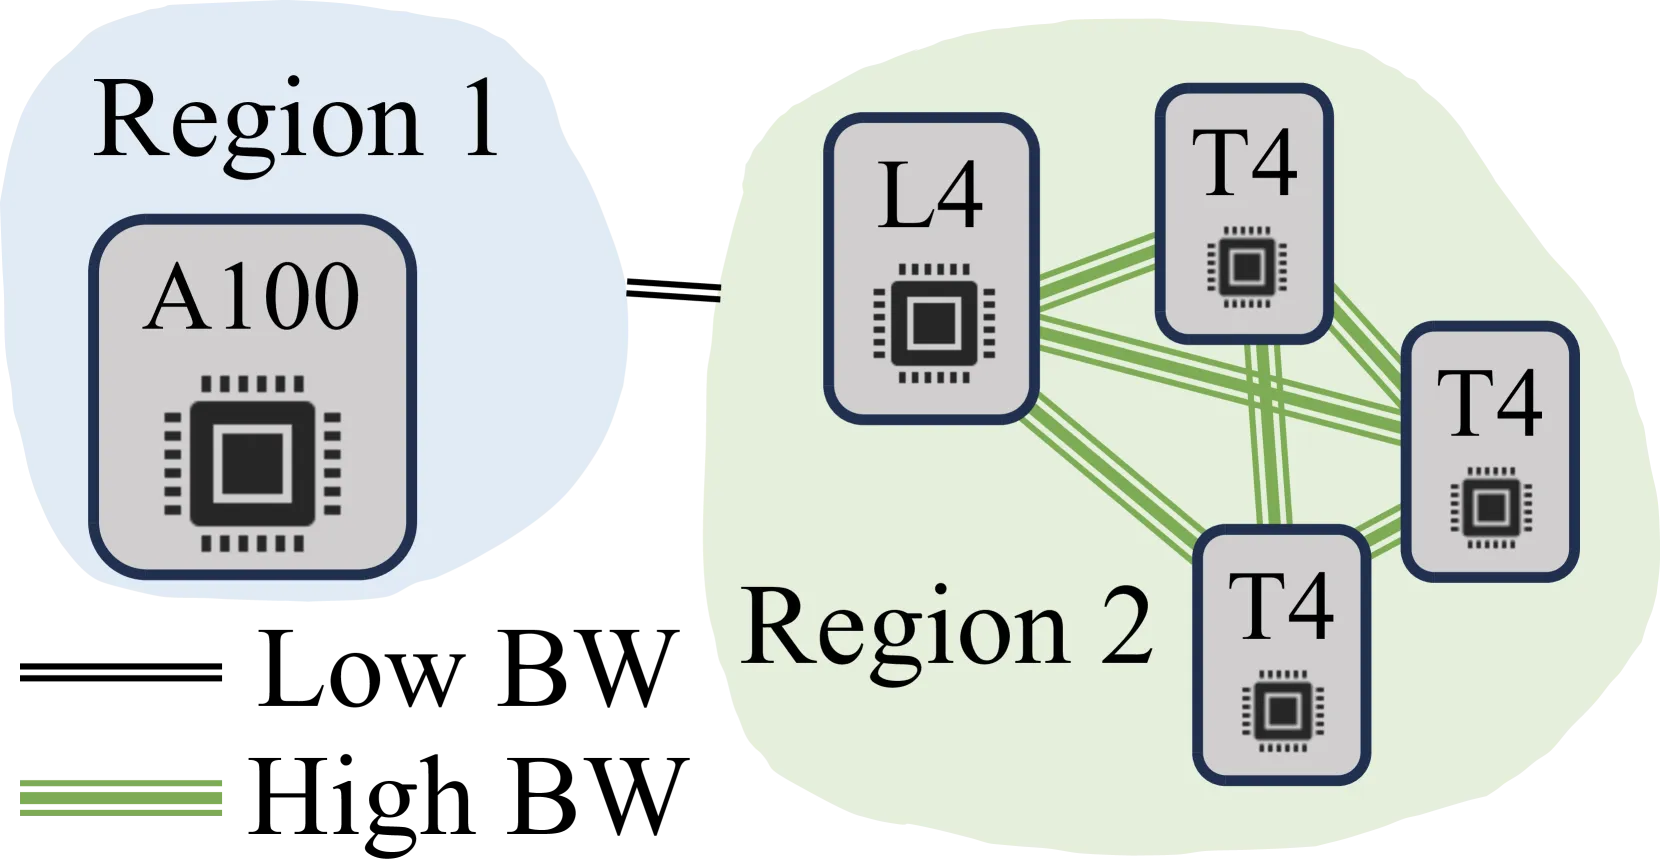
Figure 1: 异构集群中的模型放置示例。(a) 两个区域的5节点集群;(b) 均匀分区的次优方案;(c) 平衡FLOPs但仍次优;(d) Helix的网络感知最优放置。
三、技术架构
3.1 整体框架
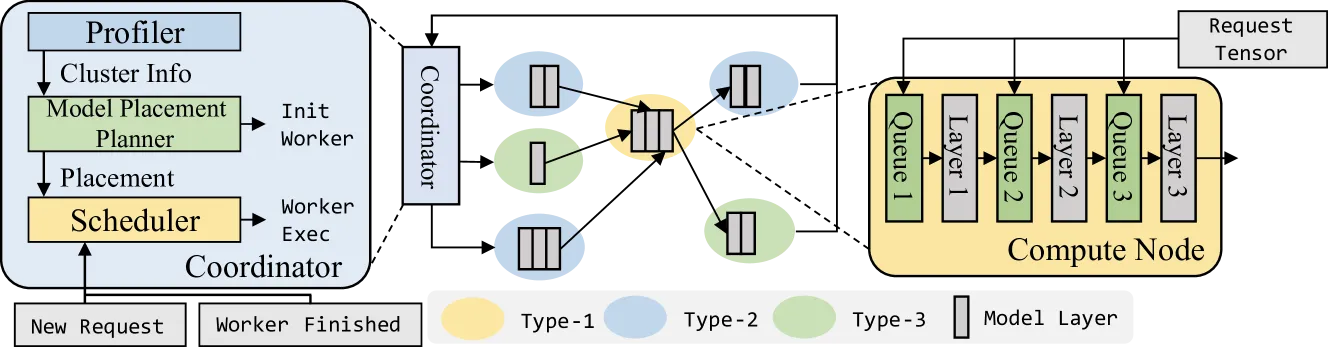
Figure 3: Helix概览。协调器规划模型放置(一次性),新请求到达时调度器分配per-request流水线,计算节点执行推理并转发到下一节点。
系统组件:
| 组件 | 功能 |
|---|---|
| Coordinator | 接收请求,运行调度器,管理KV-cache估计 |
| MILP Solver | 一次性求解最优模型放置策略 |
| IWRR Scheduler | 按最大流分配per-request流水线 |
| Compute Nodes | 执行分配的模型层,转发到下一节点 |
3.2 最大流建模
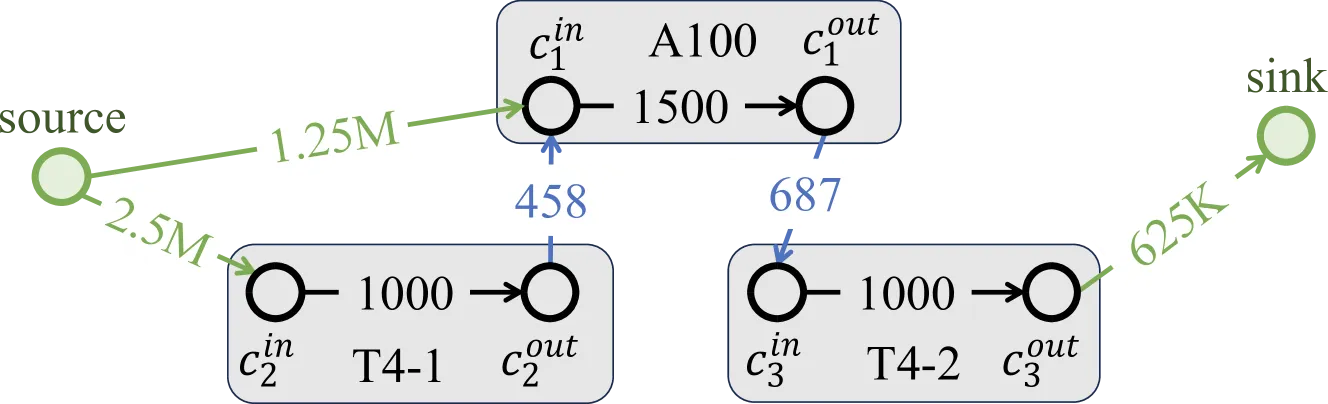
Figure 2: (a) 3节点集群的模型放置;(b) 集群的图抽象。协调器和计算节点之间的连接传输token(4 Byte),其他连接传输中间激活(16 KB)。
图构建:
对于每个计算节点 :
- 表示为两个顶点 和
- 边 的容量 = min(计算吞吐量, 网络吞吐量)
- 容量单位:每秒可处理的token数
对于每对节点 :
- 边 的容量 = 网络连接的传输吞吐量
- 仅当 的第一层紧接 的最后一层时才存在边
最大流 = 集群的最大服务吞吐量
3.3 MILP优化公式
Table 5: MILP变量
| 符号 | 类型 | 数量 | 说明 |
|---|---|---|---|
| int | O( | C | |
| binary | O( | C | |
| real | O( | E | |
| binary | O( | E |
Table 6: MILP约束
| 约束组 | 数量 | 约束 |
|---|---|---|
| 模型放置 | O( | C |
| 流守恒 | O( | C |
| 推理吞吐量 | O( | C |
| 连接有效性 | O( | E |
| 传输吞吐量 | O( | E |
目标函数:最大化从源节点到汇节点的最大流
问题规模:
| 集群 | 剪枝后 | 剪枝前 |
|---|---|---|
| 24节点 | 876变量, 1122约束 | 1376变量, 1848约束 |
| 42节点 | 2144变量, 2772约束 | 4004变量, 5502约束 |
3.4 Per-Request Pipeline
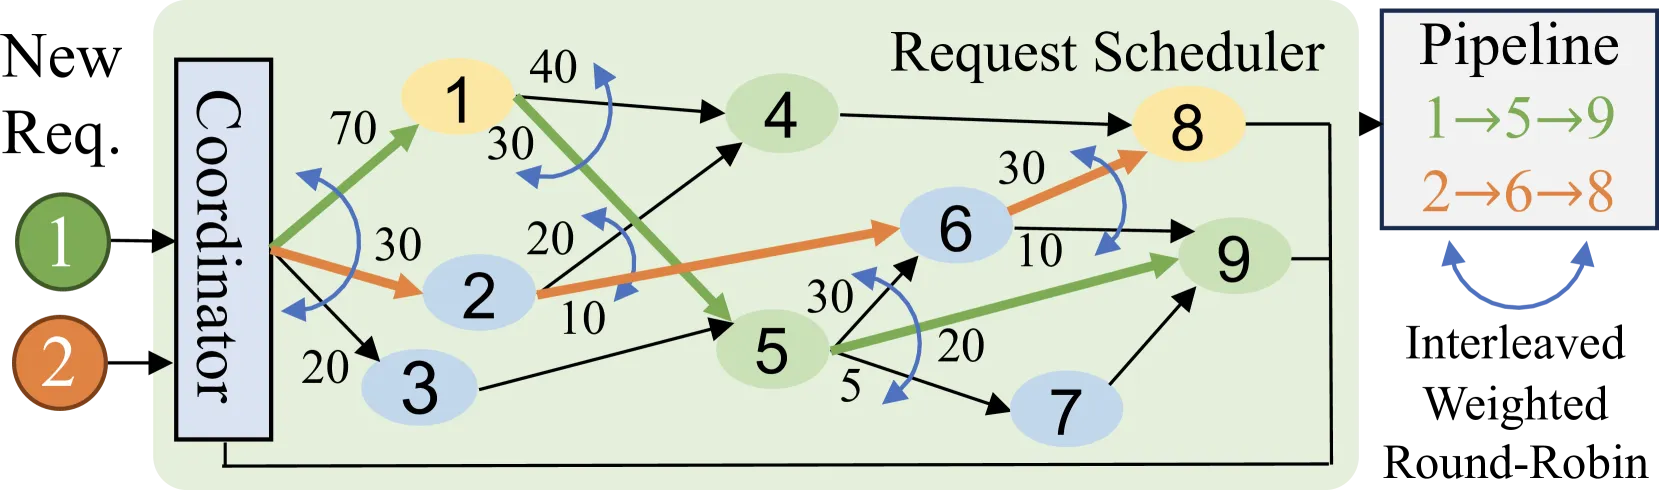
Figure 4: 集群拓扑图。边上的数字表示最大流解中网络连接的流量。右侧展示请求1和2的调度流水线。
关键创新:每个请求独立分配流水线
- 传统方法:使用固定流水线,请求轮询分配到固定流水线
- Helix方法:每个请求有独立流水线,流水线可以交叉重叠
- 流水线数量 = 源到汇的路径数量,提供极大灵活性
IWRR调度器:
- 每个顶点绑定一个交错加权轮询调度器
- 候选集 = 所有相邻顶点
- 权重 = 最大流解中对应边的流量
- 按权重比例选择下一个节点,避免突发
3.5 Helix Runtime
请求处理流程:
- 协调器接收新请求
- IWRR调度器从协调器节点开始,逐跳选择下一个节点
- 建立完整流水线(从源到汇)
- 协调器将请求发送到流水线第一个节点
- 每个节点执行分配的模型层,转发到下一节点
- 最后一个节点将输出token发送回协调器
- 协调器为下一个token调度相同的流水线
KV-Cache管理:
- 维护所有计算节点的KV-cache使用估计
- 使用平均输出长度估计
- 超过高水位线的节点在IWRR中被屏蔽
- 防止GPU内存溢出
3.6 加速MILP求解
集群剪枝:
- 识别不可能出现在最优解中的节点和连接
- 移除这些变量和约束,减小问题规模
- 24节点集群:1376→876变量(36%减少)
初始值启发式:
- 使用启发式方法(如Petals的贪心分配)生成初始解
- 将初始解作为MILP的warm start
- 显著加速求解器收敛
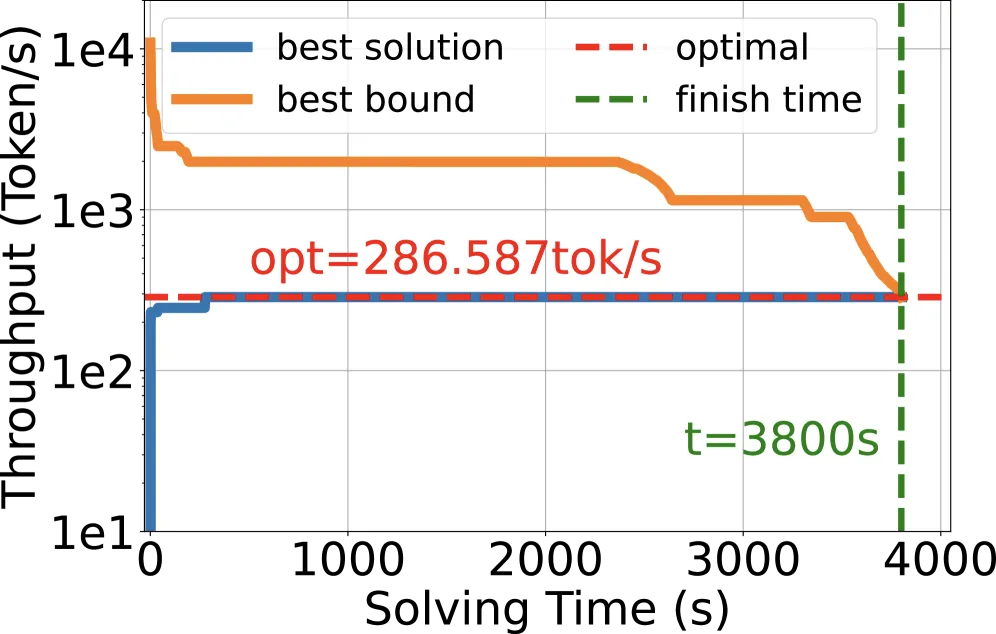
Figure 12: MILP求解器找到的最佳解和最佳上界随求解时间的变化。红线标记该集群的最优吞吐量。
四、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| 最大流建模 | 将异构LLM服务建模为有向加权图的最大流问题 | 联合优化模型放置和请求调度 |
| MILP优化 | 混合整数线性编程求解最优模型放置 | 保证最优解,超越启发式方法 |
| Per-Request Pipeline | 每个请求独立分配流水线 | 最大化资源利用,避免固定流水线的低效 |
| IWRR调度 | 交错加权轮询,按最大流分配 | 平滑调度,避免突发 |
| 集群剪枝 | 移除不可能最优的节点和连接 | 问题规模减少36% |
| 网络感知放置 | 同时考虑GPU异构性和网络异构性 | 避免通信瓶颈 |
五、实验结果
5.1 实验设置
集群配置:
| 集群 | 节点数 | GPU类型 | 场景 |
|---|---|---|---|
| 单集群 | 24节点 | 7种节点类型 | 同区域异构 |
| 地理分布 | 42节点 | A100, L4, T4 | 4个区域(亚洲、美国、欧洲、澳洲) |
| 高异构 | 24节点 | 7种不同GPU组合 | GPU异构性递增 |
Table 7: 跨区域网络带宽(Google Compute Engine)
| asia-east | us-central | eu-west | au-se | |
|---|---|---|---|---|
| asia-east | / | 123 Mbps | 67 Mbps | 175 Mbps |
| us-central | 122 Mbps | / | 204 Mbps | 123 Mbps |
| eu-west | 61 Mbps | 196 Mbps | / | 54 Mbps |
| au-se | 159 Mbps | 118 Mbps | 63 Mbps | / |
5.2 单集群性能
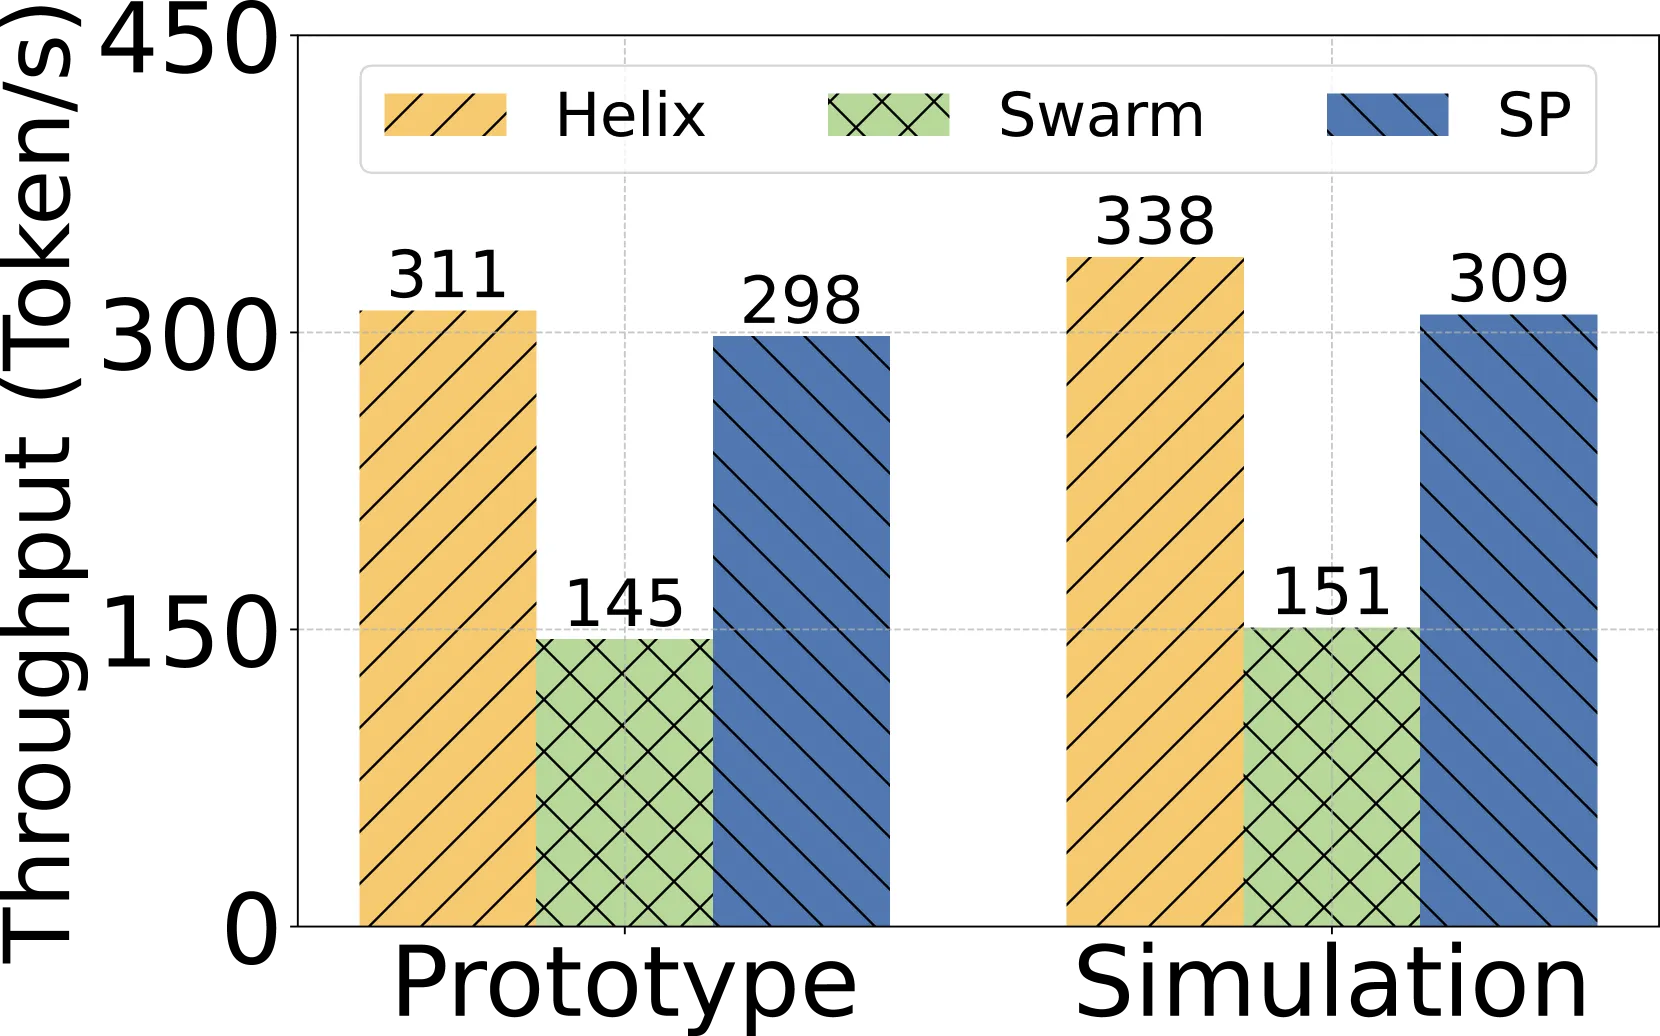
Figure 6: LLaMA-30B和LLaMA-70B在不同集群配置下的吞吐量和延迟对比。
关键结果:
- 吞吐量提升:最高3.3倍(vs HexGen、Petals等基线)
- Prompt延迟降低:最高66%
- Decode延迟降低:最高24%
- 离线和在线场景均显著优于基线
5.3 地理分布集群
在4区域42节点集群上:
- Helix充分利用地理分布的异构GPU资源
- 跨区域网络感知的模型放置避免了通信瓶颈
- 相比无地理感知的方案,吞吐量显著提升
5.4 模型放置深度分析
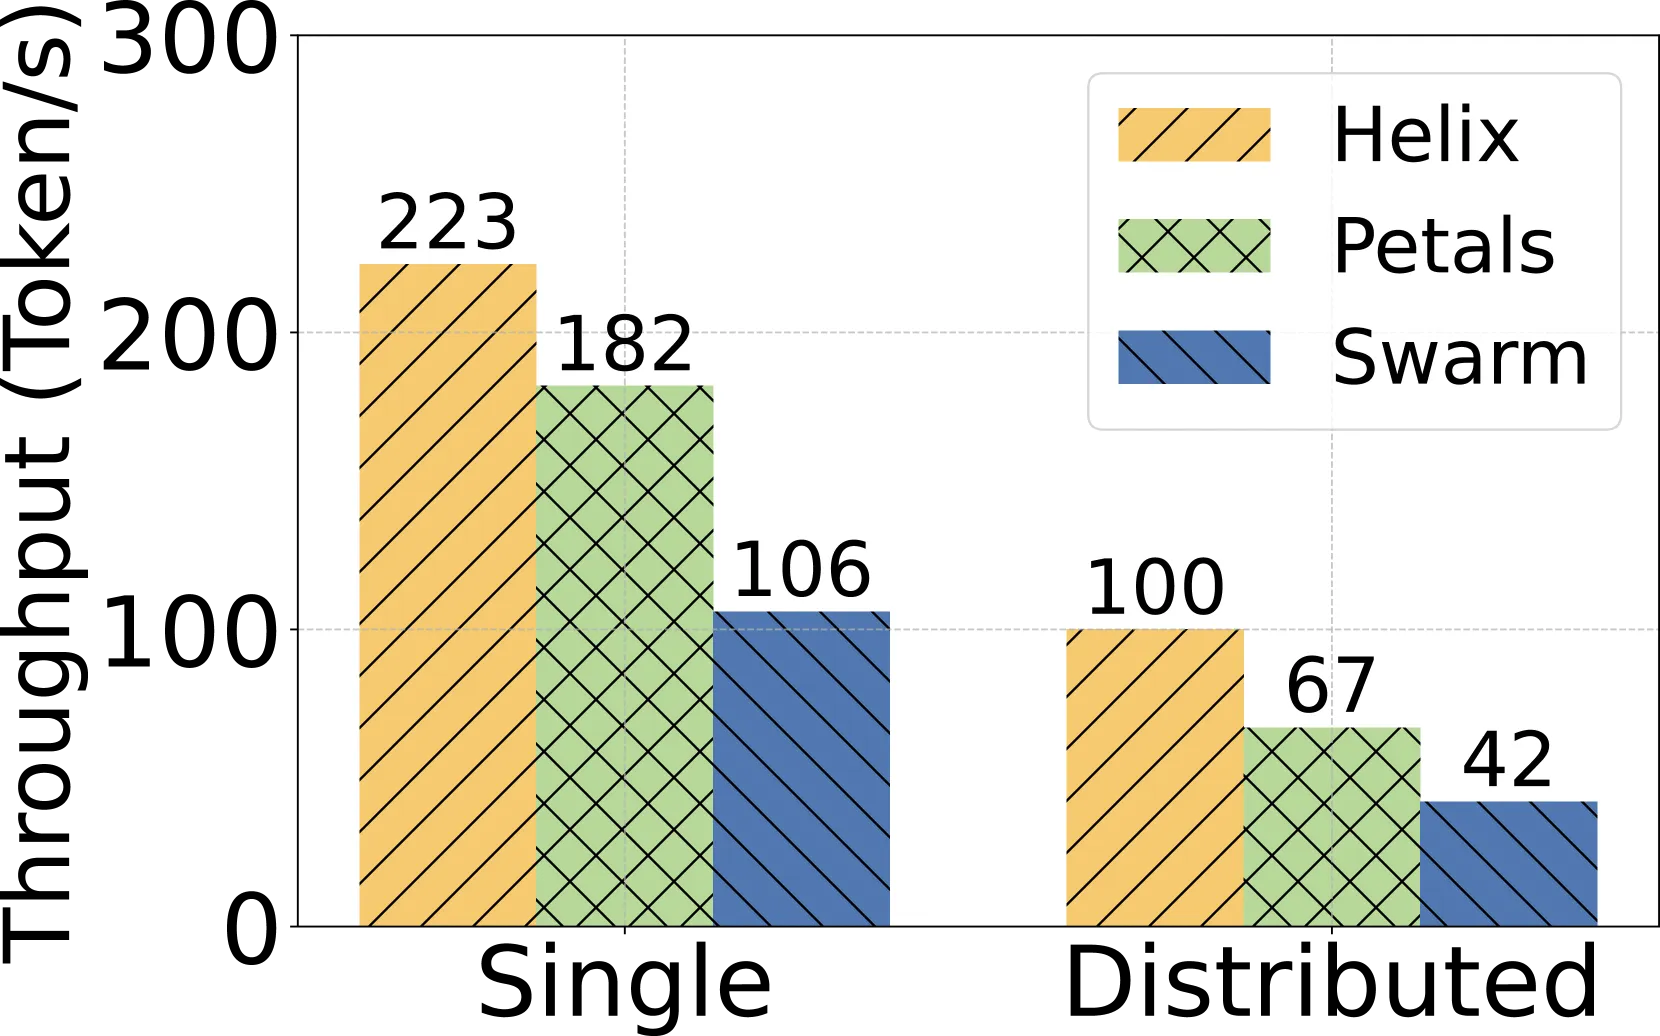
Figure 9: (a) Decode吞吐量;(b) 模型放置案例研究。数字表示每个节点持有的层数。
关键发现:
- Helix的模型放置不是简单的均匀分配
- 高性能GPU(如A100)通常分配更多层
- 网络连接质量也影响放置决策
- 数据并行和流水线并行的灵活组合
5.5 请求调度深度分析
Per-Request Pipeline的优势:
- 固定流水线导致资源利用不均
- Per-Request Pipeline允许请求动态分配到不同路径
- 总流水线数量 = 源到汇的路径数量
- IWRR按最大流比例分配,避免热点
5.6 消融实验
优化组件消融:
| 配置 | 吞吐量变化 |
|---|---|
| Helix (完整) | 基准 |
| 去除网络感知 | -30% |
| 去除Per-Request Pipeline | -20% |
| 使用均匀分区 | -50% |
5.7 MILP vs 启发式 vs LP
Table 8: 问题规模对比
| 方法 | 24节点 | 42节点 |
|---|---|---|
| MILP (剪枝后) | 876 var, 1122 cstr | 2144 var, 2772 cstr |
| MILP (剪枝前) | 1376 var, 1848 cstr | 4004 var, 5502 cstr |
关键发现:
- MILP在合理时间内求解(秒级到分钟级)
- LP松弛会产生次优解
- 启发式方法无法保证最优性
- 集群剪枝和初始值显著加速求解
六、与现有方法对比
| 方法 | GPU异构 | 网络异构 | 流水线 | 优化方法 | 最优性 |
|---|---|---|---|---|---|
| Orca | × | × | 固定 | 均匀分配 | × |
| vLLM | × | × | 固定 | 均匀分配 | × |
| Petals | ✓ | 部分 | 固定 | 贪心 | × |
| HexGen | ✓ | × | 固定 | 启发式 | × |
| SWARM | ✓ | ✓ | 固定 | 局部贪心 | × |
| Helix | ✓ | ✓ | Per-Request | MILP | ✓ |
七、总结
核心贡献
- 最大流建模:首次将异构GPU集群LLM服务建模为最大流问题
- MILP优化:混合整数线性编程求解最优模型放置,保证最优性
- Per-Request Pipeline:每个请求独立分配流水线,最大化灵活性
- IWRR调度:按最大流比例的交错加权轮询调度
- 系统实现:基于vLLM实现,1.5k LoC Python + 1.7k LoC C++
- 全面评估:3个集群(24-42节点),最高3.3x吞吐量提升
技术影响
- 异构资源利用:充分利用云平台中不同类型的GPU
- 地理分布服务:支持跨区域的LLM推理服务
- 成本优化:使用低成本GPU(L4、T4)补充高端GPU
- 理论保证:MILP提供最优性保证,超越启发式方法
局限性
- MILP求解时间:大规模集群的求解时间可能较长(但只需一次)
- 静态放置:模型放置是一次性的,不适应动态负载变化
- KV-Cache估计:使用平均输出长度估计,可能不够精确
- 单模型服务:当前仅支持单模型,多模型服务待扩展
- 故障恢复:未详细讨论节点故障的处理机制
八、参考资源
- 论文: https://arxiv.org/abs/2406.01566
- 代码: https://github.com/Thesys-lab/Helix-ASPLOS25
- vLLM: https://github.com/vllm-project/vllm
- Gurobi: MILP求解器
- ZeroMQ: 节点间通信