CXL Shared Memory Programming: Barely Distributed and Almost Persistent
首个CXL共享内存故障模型,分类处理数据故障与进程故障,并提出适配CXL特性的冗余与一致性机制
CXL Shared Memory Programming: Barely Distributed and Almost Persistent
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | CXL Shared Memory Programming: Barely Distributed and Almost Persistent |
| 作者 | Yi Xu, Suyash Mahar, Ziheng Liu, Mingyao Shen, Steven Swanson |
| 机构 | UC Berkeley, UC San Diego |
| 论文 | arXiv:2405.19626 |
| 发布 | 2024-05-30 (v1), 2024-07-17 (v2, 最终版) |
| 许可 | CC BY 4.0 |
| 领域 | Distributed, Parallel, and Cluster Computing (cs.DC) |
二、核心思想
问题定义
CXL(Compute Express Link)支持多节点间缓存一致性的共享内存,使得内存可以与计算资源物理分离(memory disaggregation)。这种架构带来了全新的故障模式:
- 数据故障:存储数据的节点失效,导致数据对其他计算节点不可访问或不一致
- 进程故障:执行计算的节点失效,但数据仍然可用
传统系统中,数据和进程通常共存于同一节点,故障是”全有或全无”的。而CXL将二者解耦,使它们可以独立故障。
核心观察
- CXL的数据故障不同于分布式存储:CXL使用load/store指令而非网络DMA,复制操作需要CPU参与而非NIC卸载,带来额外CPU开销
- CXL的进程故障不同于持久内存(PMEM):CXL是易失性的,且访问延迟远低于PMEM,PMEM的日志/检查点方案在CXL中可能引入不可接受的开销
- CXL的低延迟和高带宽为快速恢复提供了新机会
解决方案概述
本文是首个定义CXL共享内存故障模型并提出针对性解决方案的工作,核心贡献包括:
- 定义了三种故障场景(数据故障、进程故障、联合故障)
- 针对数据故障:提出CXL交换机级复制、擦除编码适配
- 针对进程故障:提出应用相关(日志)和应用无关(检查点、全系统持久化)的方法
- 针对联合故障:提出分层和协同设计的多种组合方案
三、技术架构
CXL故障模型
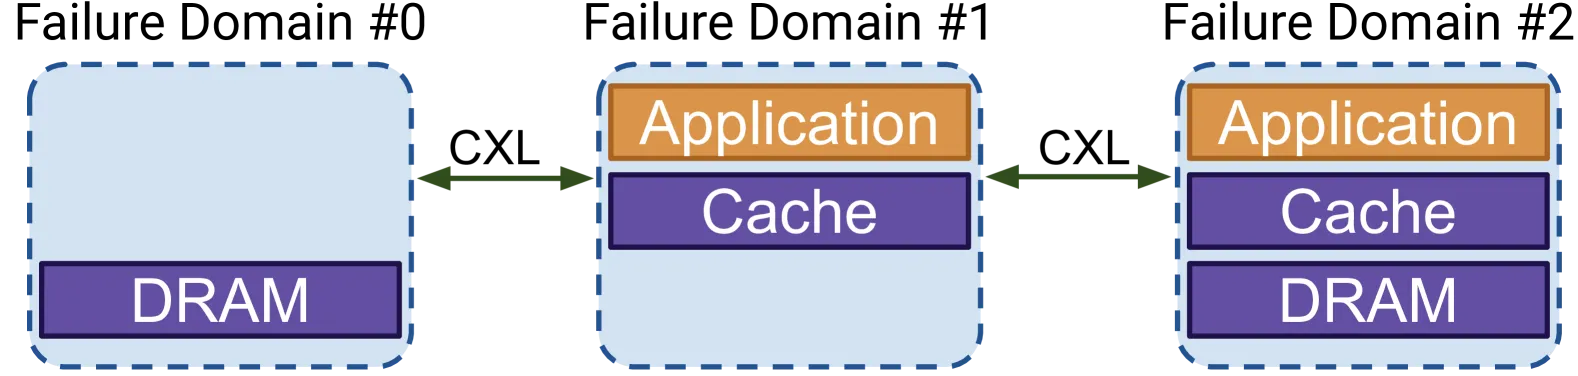
CXL系统将系统划分为多个故障域(Failure Domain),每个域包含可能同时故障的设备。根据应用和数据的相对位置,产生三种故障场景:
| 故障域 | 场景 | 描述 |
|---|---|---|
| #0(仅数据) | 数据故障 | 存储数据的节点失效,数据对所有CXL连接的计算设备不可访问或不一致 |
| #1(仅进程) | 进程故障 | 执行计算的节点失效,但数据仍可通过CXL访问;进程可能在更新中途崩溃,导致数据不一致 |
| #2(数据+进程) | 联合故障 | 数据和进程所在节点同时失效 |
与传统系统对比:
- 单机系统:只有一个故障域,数据和进程同时失效
- 分布式系统:数据和处理逻辑通常共存于同一节点,故障时两者同时崩溃
3.1 数据故障处理
传统方案及其CXL适配挑战
复制(Replication):
- 问题:CXL中使用load/store指令访问远程内存,复制需要活跃CPU参与,无法像分布式系统那样卸载到NIC的DMA引擎
- CXL方案:在CXL交换机中嵌入复制功能,交换机自动将store复制到多个故障域,compute node只需向交换机发出一条store
Compute Node → CXL Switch → Replica 1 (FD #0)
                         → Replica 2 (FD #1)
                         → Replica 3 (FD #2)
擦除编码(Erasure Coding):
- 问题:CXL数据传输粒度为256B FLIT,但应用分配的对象大小各异;写入时需要先读取整个block计算新校验块,放大传输量
- 挑战:CXL的低延迟意味着计算开销占总开销的比例显著增大
- 潜在方案:将多个对象组织成固定大小的组,为每组生成校验数据(借鉴far-memory系统经验)
关键洞察
| 方案 | 存储开销 | CPU开销 | CXL适配建议 |
|---|---|---|---|
| 复制 | R×(R为副本数) | 高(需CPU参与load/store) | 使用CXL交换机卸载复制 |
| 擦除编码 | (1+1/k)× | 中(需计算校验) | 对象分组策略,但计算开销需评估 |
3.2 进程故障处理
进程故障的核心挑战是:进程在更新CXL共享内存中途崩溃,可能导致数据不一致。CXL硬件保证缓存行级别的原子性,但应用定义原子性的粒度可能更大。
3.2.1 数据一致性背景
与PMEM类似,CXL中保证故障原子性(failure atomicity)——单个操作或事务要么全部应用,要么完全不应用。但PMEM的关键约束是写有序性(write ordering),而CXL是易失性的,无需持久化保证,这改变了trade-off。
3.2.2 应用相关方法(日志)
CXL中日志的位置选择与PMEM不同,因为CXL的低延迟使性能权衡发生变化:
| 日志类型 | 适用场景 | CXL中的位置要求 | 性能特点 |
|---|---|---|---|
| Undo Log | 读密集型 | 必须在进程节点之外的故障域 | 每次原地更新前需记录旧值并确保到达目标故障域;写密集型负载下性能差 |
| Redo Log | 写密集型 | 直到事务结束前可在同域 | 直接更新日志条目,事务结束时确保到达不同故障域;后续访问重定向到日志 |
关键洞察:CXL中日志的元数据传输位置应根据设计目标选择:
- 高可用性目标:元数据必须跨故障域存储
- 快速恢复目标:元数据可放在数据节点,恢复更快且内存消耗更少
3.2.3 应用无关方法
检查点(Checkpoint):
- 在数据一致的执行点复制数据到不同故障域
- 可优化:增量检查点、部分检查点
- 缺点:可能双倍内存使用,线程同步和高数据量增加尾延迟
全系统持久化(Whole System Persistence) ⭐推荐:
- 仅持久化缓存和寄存器(数据量小)
- 硬件实现:小型备用电源,进程故障时将缓存/寄存器迁移到另一故障域,故障前零性能开销
- 软件实现:在另一故障域维护缓存/寄存器的较新版本,开销取决于拷贝间隔
- 优势:比检查点内存消耗小得多;无序持久化比有序驱逐更简单更快;确保IO一致性
3.2.4 关键设计洞察
| 设计目标 | 元数据位置 | 优点 | 缺点 |
|---|---|---|---|
| 高可用性 | 跨故障域 | 数据故障时仍可恢复 | 元数据传输成本高 |
| 快速恢复 | 数据节点 | 恢复更快,内存消耗少 | 数据故障时元数据也丢失 |
元传输成本与带宽/延迟/费用相关:
- 高传输成本 → 优先选择日志(减少元数据量)
- 低传输成本 → 日志吸引力下降,写放大和编程复杂度更重要
3.3 联合处理进程和数据故障
3.3.1 分层方法(Layered)
将数据故障处理和进程故障处理独立叠加:
| 组合方案 | 延迟 | 吞吐 | 说明 |
|---|---|---|---|
| 复制/EC + Undo Log | 2× | 1/(2R)× | 日志翻倍每次写入,加上内存排序 |
| 复制/EC + 原子指针更新 | 1~n× | n/R~1/R× | 更新副本后原子更新指针;频繁更新小字段时效率低 |
| 复制/EC + 全系统持久化 | 1× | 1/R× | ⭐最优:仅故障时转移少量缓存/寄存器,无运行时开销 |
| 阶段式复制 | ≤2× | 1/R× | 强制副本按顺序应用更新;多数副本不在更新中即可容错 |
3.3.2 协同设计方法(Co-designed)
Redo压缩复制(Redo-compacted Replication):
- 所有后续访问重定向到redo日志,减少副本更新量
- 后台压缩处理redo日志到副本,防止无限增长
- 写延迟1×,读延迟>1×;吞吐在1/(2R)×~1/R×之间
检查点上的日志结构化内存(Log-structured Memory on Checkpoints):
- 复制最近检查点到各故障域
- 记录自上次检查点以来的更新到复制的语义日志结构内存
- 写延迟1×;若高效实现可达1/R×吞吐
3.4 故障处理的附加收益
进程迁移
CXL复制内存系统可大幅简化数据中心内的进程迁移:
- 编排器终止进程
- 使用检查点或全系统持久化状态在另一机器恢复
- 对外部而言应用”迁移”了,对应用而言只是”故障”
数据访问带宽提升
- 复制:读取可从任一副本服务,提升读带宽
- 擦除编码:大写入可条带化为多个小写入分布在多个CXL内存系统,提升写吞吐
四、核心创新
| 创新点 | 说明 | 价值 |
|---|---|---|
| 首个CXL共享内存故障模型 | 定义数据故障、进程故障、联合故障三类场景 | 为CXL系统设计提供理论基础 |
| CXL交换机级复制 | 在CXL交换机中嵌入复制功能,卸载CPU负担 | 解决load/store复制的CPU开销问题 |
| 全系统持久化适配CXL | 仅持久化缓存和寄存器,利用CXL低延迟特性 | 比检查点更高效,比日志更简单 |
| 元数据位置设计洞察 | 根据高可用vs快速恢复目标选择元数据位置 | 提供明确的设计指导原则 |
| 分层vs协同设计对比 | 系统分析多种故障处理组合的性能特征 | 帮助开发者选择最优组合 |
| 故障处理的附加价值 | 利用冗余机制实现进程迁移和带宽提升 | 一石二鸟,故障容忍与性能优化兼得 |
五、与PMEM的关键区别
| 维度 | PMEM | CXL | 对方案的影响 |
|---|---|---|---|
| 持久性 | 非易失,断电数据不丢失 | 易失,断电数据丢失 | CXL无需持久化有序性保证,可简化恢复 |
| 访问延迟 | 较高(~μs级) | 低(~2-4×本地内存) | CXL中计算开销占比更高,需尽量卸载 |
| 故障模型 | 进程和数据同域 | 进程和数据可分域 | CXL需要独立处理数据故障和进程故障 |
| 日志位置约束 | 日志可在本地 | Undo日志必须跨故障域 | CXL中Undo日志性能代价更高 |
六、总结
核心贡献
- 定义了CXL共享内存的故障模型,区分数据故障、进程故障和联合故障三种场景
- 提出针对CXL特性的数据故障处理方案:CXL交换机级复制、擦除编码适配
- 提出适配CXL的进程故障处理方法:基于应用特性的日志选择和全系统持久化
- 分析分层与协同设计的联合故障处理:给出多种组合方案的性能对比
- 揭示故障处理的附加收益:进程迁移和数据访问带宽提升
技术影响
- 为CXL内存解耦架构的容错设计提供了系统性框架
- 证明了CXL的低延迟特性既带来挑战(计算开销敏感),也提供机遇(快速恢复)
- 全系统持久化思路可推广到其他易失性共享内存场景
局限性
- 本文为概念性框架,未提供具体原型实现和基准测试
- 交换机级复制依赖支持复制功能的CXL交换机,实际部署受限
- 擦除编码的计算开销在CXL低延迟背景下可能需要硬件卸载
- 全系统持久化的硬件方案需要备用电源,增加成本和复杂性
七、参考资源
- 论文:https://arxiv.org/abs/2405.19626
- DOI:https://doi.org/10.48550/arXiv.2405.19626
- 许可证:CC BY 4.0
- CXL规范:https://cxlcompute.org/
- 相关系统:
- DirectCXL — 高性能内存解耦
- Telepathic Datacenters — CXL共享内存RPC
- Carbink — 容错far memory
- Zhuque — 全系统故障恢复
- Puddles — PMEM应用无关恢复