PipeFusion: Displaced Patch Pipeline Parallelism for Inference of Diffusion Transformer Models
Patch-level pipeline parallelism for DiT inference that eliminates pipeline bubbles and enables PCIe-scale multi-GPU inference at 8K resolution
PipeFusion: Displaced Patch Pipeline Parallelism for Inference of Diffusion Transformer Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PipeFusion: Displaced Patch Pipeline Parallelism for Inference of Diffusion Transformer Models |
| 作者 | Jiarui Fang, Jinzhe Pan, Aoyu Li, Xibo Sun, Jiannan Wang |
| 机构 | (xDiT 项目团队成员) |
| 论文 | https://arxiv.org/abs/2405.14430 |
| 代码 | https://github.com/xdit-project/xDiT / https://github.com/PipeFusion/PipeFusion |
| 发布 | 2024-05-23 (v1), 2025-12-03 (v4) |
| 发表 | NeurIPS 2025 |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
Diffusion Transformer (DiT) 模型的推理延迟极高,尤其是高分辨率图像(高达 8192px)和长视频序列。现有 DiT 并行方法面临两大限制:
- 依赖昂贵的 NVLink 互联:张量并行、序列并行等方法需要 NVLink 连接的高带宽 GPU 集群,无法在廉价的 PCIe 连接 GPU 上高效运行
- 内存开销无界:DistriFusion 虽然将注意力 K/V 复制 across 设备,但其内存开销随层数线性增长
解决方案概述
本文提出 PipeFusion——一种基于**位移块流水线并行(Displaced Patch Pipeline Parallelism)**的多 GPU 并行方法,专为 DiT 推理设计:
- 将图像分割为 M 个不重叠的 patch,将 DiT 网络的 L 层划分为 N 个阶段分配到不同设备
- 利用输入时间冗余性(相邻扩散步之间的高度相似性),复用上一扩散步的 stale feature maps 消除流水线气泡
- 仅需相邻设备间的点对点(P2P)通信传输首层输入和末层输出激活,大幅降低通信带宽需求
- 支持在PCIe 连接的 GPU 集群上运行,无需昂贵的 NVLink 基础设施
三、技术架构
整体框架图
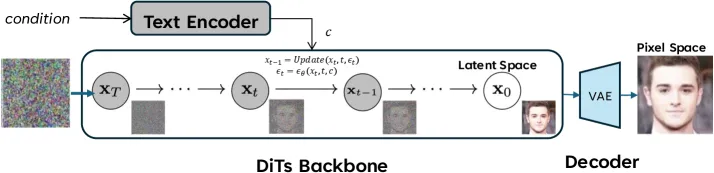
核心思想对比:
┌────────────────────────────────────────────────────────────────┐
│  DistriFusion (Prior Work)              │  PipeFusion (Ours)    │
│                                         │                        │
│  Replicate DiT parameters across all    │  Shard DiT parameters  │
│  devices, partition patches              │  across stages         │
│                                         │                        │
│  Device 0: [Layer 1-M] patch 0          │  Device 0: [Layer 1-N/4] patch 0  │
│  Device 1: [Layer 1-M] patch 1          │  Device 1: [Layer 1-N/4] patch 1  │
│  ...           AllGather K/V each layer │  ...  P2P between stages  │
│                                         │                        │
│  Comm: O(phs·L) — allgather per layer   │  Comm: O(phs) — P2P only  │
│  Mem: AL extra buffer per device        │  Mem: AL/M extra buffer   │
└────────────────────────────────────────────────────────────────┘
流水线工作流程
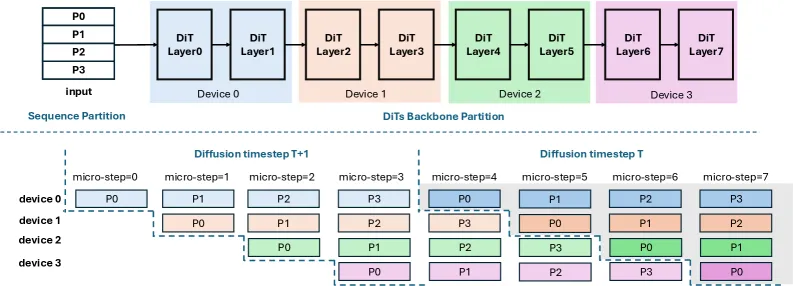
PipeFusion 的流水线编排:
时间 →
┌─────────────────────────────────────────────────────────────┐
│ Device 0 (Stage 1):                                       │
│  Patch 0: ██░░░░░░  →  fresh + stale features              │
│  Patch 1:   ░░████░░  →  pipelined                         │
│  Patch 2:     ░░████░░                                   │
│  Patch 3:       ░░████░░                                 │
│                                                         │
│ Device 1 (Stage 2):                                       │
│  Patch 0:   ██░░░░░░  →  receives from Device 0           │
│  Patch 1:     ░░████░░  →  pipelined                      │
│  ...                                                        │
│                                                         │
│ Device N-1 (Stage N):                                     │
│  Patch 0:         ░░████                                  │
│  ...                                                        │
└─────────────────────────────────────────────────────────────┘

关键:每个设备处理自己的 patch 在其分配的阶段上,通过 P2P 通信
在设备间传递激活值,形成流水线。
新鲜 vs 陈旧激活
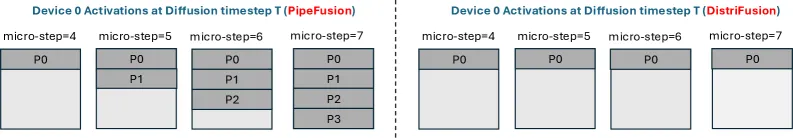
输入时间冗余性(Input Temporal Redundancy):
扩散过程中,相邻时间步的输入高度相似。PipeFusion 利用这一特性:
- 每个设备使用上一步的 stale 激活提供上下文,消除流水线等待
- 初始扩散步使用同步通信建立可靠上下文(warmup steps,通常 1-4 步)
Fresh Activation 优势:
- PipeFusion 在每个扩散步中** progressively 增加 fresh activation 区域**(从首层到末层)
- DistriFusion 的 fresh 区域恒定为 1/N,而 PipeFusion 的 fresh 区域随层数递增,理论上提供更准确的梯度
通信/内存对比
表 I: 通信与内存开销对比
| 方法 | attn-KV | 通信成本 | 参数内存 | 激活内存 | 额外缓冲 |
|---|---|---|---|---|---|
| Tensor Parallel | fresh | 4O(phs)L | P/N | A/N | 0 |
| DistriFusion* | stale | 2O(phs)L | P | A | AL |
| Ring Seq Parallel* | fresh | NA | P/N | A/N | 0 |
| Ulysses Seq Parallel | fresh | 4O(phs)L | P | A/N | 0 |
| PipeFusion* | stale- | O(phs) | P/N | A/M | AL/M |
(* = 异步, stale- = 比 stale 更稳定)
PipeFusion 实现了最佳平衡:最低通信成本 O(phs),参数内存 P/N,额外缓冲 AL/M。
模型架构
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 基座模型 | Pixart-alpha (0.6B), SD3, Flux.1 | Diffusion Transformer |
| 图像分块 | M 个不重叠 patch | M = N 或 M ≠ N |
| 阶段划分 | L 层划分为 N 个阶段 | N < L |
| Warmup | 初始扩散步同步通信 | 1-4 步(共 20 步) |
| 通信方式 | 相邻设备 P2P | 仅首层输入 + 末层输出 |
Warmup 策略
初始扩散步使用同步通信建立可靠上下文:
- 通常 1-4 个 warmup 步(总共 20 步)
- 4 个 warmup 步生成的图像与原始方法几乎无法区分
- 无 warmup 时质量显著下降(LPIPS 0.322 vs 0.220)
- Warmup 可解耦并在专用设备上运行以避免流水线气泡
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 位移块流水线并行 | 将图像分块与网络层分阶段结合,M 和 N 可不同 | 计算比率 M·S/(M·S+N-1),M=N=4, S=50 时达 98.5% |
| 输入时间冗余利用 | 复用上一扩散步的 stale 特征图消除气泡 | 相邻扩散步输入差异极小(Figure 11 验证) |
| 渐进式 fresh 激活 | 每个扩散步中 fresh 区域从首层到末层递增 | 理论上比 DistriFusion 恒定 1/N 更准确 |
| O(phs) 通信 | 仅需相邻设备 P2P,无需 allgather | 比 DistriFusion 的 O(phs·L) 降低 L 倍 |
| PCIe 可行 | 在廉价 PCIe GPU 集群上实现高效推理 | 4× A100 PCIe 性能媲美 8× A100 NVLink |
五、代码实现分析
GitHub: https://github.com/xdit-project/xDiT
PipeFusion 的关键实现:
- 基于 xDiT 项目,支持 Pixart-alpha、Stable Diffusion 3、Flux.1 等模型
- 图像分割为 M 个 patch,网络层划分为 N 个 stage
- P2P 通信仅传递首层输入和末层输出激活
- VAE 内存尖峰 workaround:chunking convolution inputs
- Warmup 策略可解耦运行
六、实验结果
基准测试
硬件配置:
| 配置 | GPU | 互联 | P2P 带宽 |
|---|---|---|---|
| PCIe 4-GPU | 4× A100 80GB | PCIe | ~23 GB/s |
| NVLink 8-GPU | 8× A100 80GB | NVLink | ~268 GB/s |
| PCIe L20 | 8× L20 40GB | PCIe | ~26 GB/s |
PCIe 4× A100 延迟对比(Pixart-alpha, 不同分辨率):
| 分辨率 | PipeFusion 加速比 | 对比基线 |
|---|---|---|
| 1024px | 2.01× | 最佳替代方法 |
| 2048px | 1.48× | 最佳替代方法 |
| 4096px | 显著改善 | DistriFusion/Seq Parallel OOM |
| 8192px | 1.10× | 单 GPU 的 3.1-4.3× 加速 |
8× L20 PCIe 结果:
| 分辨率 | PipeFusion 加速比 |
|---|---|
| 1024px | 1.47× |
| 4096px | 1.31× |
| 8192px | DistriFusion/Seq Parallel OOM |
关键发现
- PCIe ≈ NVLink:PipeFusion 在 PCIe 上的性能与 NVLink 相当,证明通信开销基本消除
- 8K 分辨率可行:在 8192px 分辨率下 PipeFusion 仍能生成图像,而 DistriFusion 和序列并行在 4096px 就 OOM
- 视觉质量不可区分:定性结果显示生成的图像与原始方法视觉上一致
消融实验
Warmup 步数影响:
| Warmup 步数 | LPIPS (vs original) | 质量评价 |
|---|---|---|
| 0 | 0.322 | 明显退化 |
| 1 | 0.258 | 轻微退化 |
| 2 | 0.235 | 接近 |
| 4 | 0.220 | 几乎不可区分 |
| 原生 | 0.000 | 基准 |
Patch 数量 M 的影响:
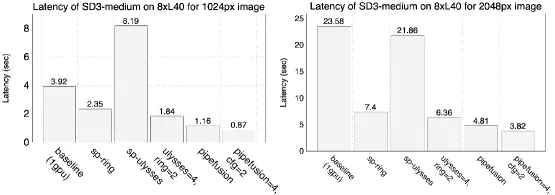
- 增加 patch 数量 M 可降低延迟,但收益递减
- PipeFusion 在 M=N 时达到最佳平衡
质量评估
FID 分数(L20 PCIe, 8 设备):
| 方法 | FID |
|---|---|
| PipeFusion (8 devices) | 31.30 |
| DistriFusion (8 devices) | 33.76 |
| 原始 | — |
PipeFusion 的 FID 略优于 DistriFusion。
七、相关工作
- DistriFusion:将 DiT 参数复制到所有设备,对每个 patch 并行处理,但需每层 allgather attention K/V
- 张量并行:将矩阵切分到多设备,需要高带宽互联
- 序列并行(Ring/Ulysses):沿序列维度切分,适合 LLM 但不直接适用于 DiT
- xDiT 项目:分布式 DiT 推理的更广泛生态系统
八、总结
核心贡献
- PipeFusion 框架:首个位移块流水线并行方法,专为 DiT 推理设计
- 输入时间冗余利用:利用扩散步间的相似性消除流水线气泡
- O(phs) 通信:相比 DistriFusion 降低 L 倍通信开销
- PCIe 友好:在廉价 PCIe GPU 集群上实现高效推理
- 8K 分辨率生成:在 8192px 分辨率下成功生成图像
- NeurIPS 2025 发表:顶级会议认可
技术影响
- ** democratizes DiT inference**:通过消除 NVLink 依赖,大幅降低多 GPU 推理成本
- 高扩展性:计算比率 M·S/(M·S+N-1) 在典型扩散步数下接近完美流水线利用率
- 可扩展到其他 DiT 模型:已在 Pixart-alpha、SD3、Flux.1 上验证
局限性
- 目前主要针对 DiT 架构,对其他扩散模型架构的适用性未验证
- Warmup 步数需要调优,过多会增加延迟
- 在极低带宽互联(如跨节点)上的性能未充分评估
九、参考资源
- arXiv: https://arxiv.org/abs/2405.14430
- GitHub: https://github.com/xdit-project/xDiT
- License: CC BY 4.0
- 评估硬件: 4× A100 PCIe, 8× A100 NVLink, 8× L20 PCIe
- 评估模型: Pixart-alpha (0.6B), SD3, Flux.1
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | DistriFusion vs PipeFusion 对比 | comparison-diagram.png |
| Figure 3 | 流水线工作流程 | pipeline-workflow.png |
| Figure 4 | Fresh vs Stale 激活区域 | fresh-stale.png |
| Figure 5 | 定性结果对比 | qualitative-results.png |
| Figure 6 | 延迟扩展(不同分辨率) | latency-scaling.png |