LeanAttention: Hardware-Aware Scalable Attention Mechanism for the Decode-Phase of Transformers
LeanAttention提出硬件感知的可扩展注意力机制,优化Transformer解码阶段的注意力计算效率。
LeanAttention: Hardware-Aware Scalable Attention Mechanism for the Decode-Phase of Transformers
一、论文概述 (Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | LeanAttention: Hardware-Aware Scalable Attention Mechanism for the Decode-Phase of Transformers |
| arXiv ID | 2405.10480 |
| 作者 | Rya Sanovar, Srikant Bharadwaj, Renee St. Amant, Victor Rühle, Saravan Rajmohan |
| 机构 | Microsoft |
| 发表日期 | 2024-05-17 (v1), 2025-01-14 (v2) |
| 领域 | cs.AR (Hardware Architecture), cs.LG (Machine Learning) |
| 论文长度 | 13页, 10张图 |
1.2 摘要
Transformer模型已成为NLP、NLG和图像生成中最广泛使用的架构。随着模型规模达到数十亿参数,这些大型模型即使在GPU等尖端AI加速器上也存在显著的推理延迟问题。注意力操作的时间和内存复杂度相对于总上下文长度呈二次方增长。
本文提出LeanAttention,一种针对解码器-only Transformer模型解码阶段(token-generation phase)的可扩展自注意力计算技术。核心创新是利用在线softmax的结合律性质,将其视为规约操作,从而实现对大上下文长度的并行计算。通过扩展”stream-K”风格的分块计算到自注意力,实现了平均2.6倍的注意力执行加速,在512k上下文长度下最高可达8.33倍加速。
1.3 核心贡献
- 识别解码阶段的限制: 揭示了FlashAttention-2在解码阶段的GPU占用率极低问题
- Softmax重缩放作为规约: 将softmax操作从注意力算法的内循环中提取出来,作为结合律规约操作
- Stream-K风格分解: 利用stream-K风格的注意力分解,实现均衡的计算负载分配
- 通用注意力机制: 定义了一种与硬件资源紧密对齐的通用注意力分区机制
二、核心思想 (Core Ideas)
2.1 问题背景
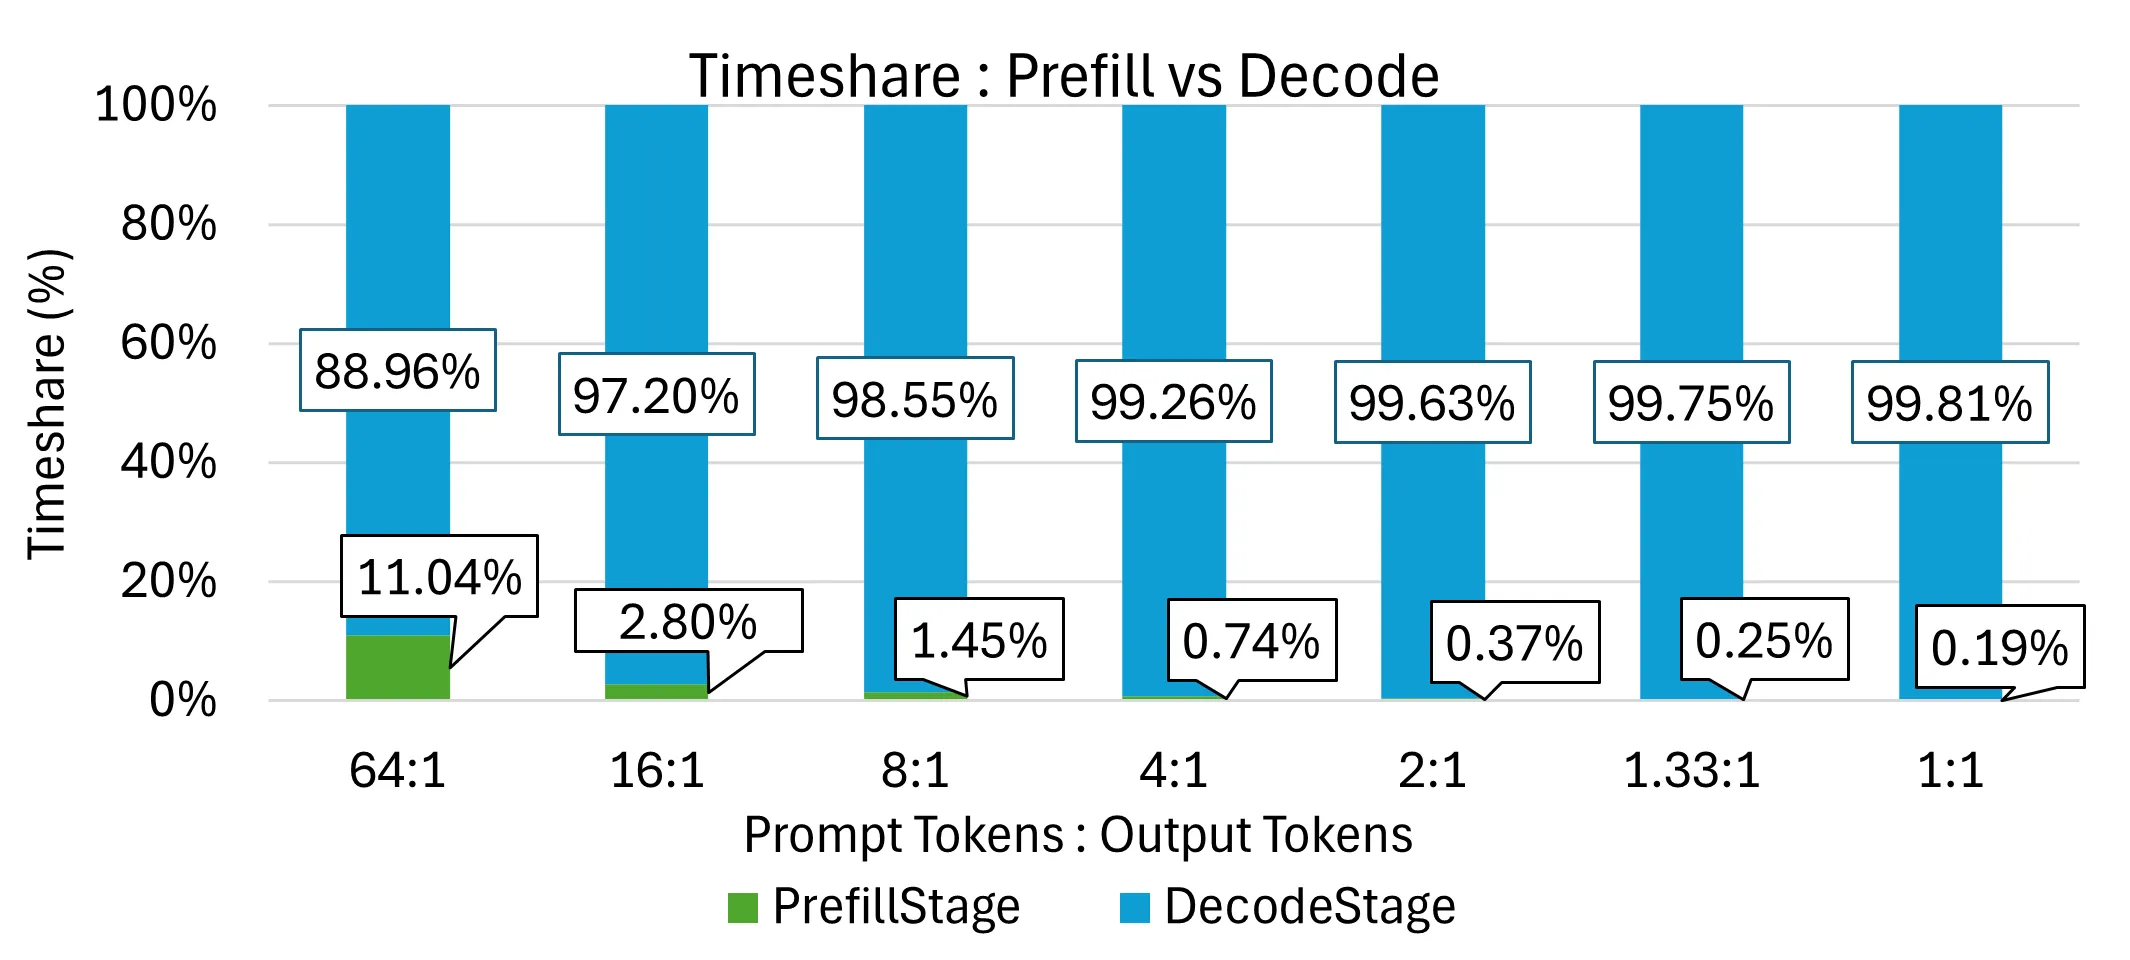
LLM推理包含两个截然不同的计算阶段:
| 阶段 | 特征 | 计算需求 |
|---|---|---|
| Prefill阶段 | 处理所有输入token, Nq=Nk=N | 计算密集, 需要高FLOPS/s |
| Decode阶段 | 自回归生成, Nq=1, Nk递增 | 内存带宽受限, GPU利用率低 |
关键发现: 即使prompt与输出token比例为64:1,超过80%的处理时间被decode阶段消耗,对于更长的输出长度可达近100%。
2.2 FlashAttention-2的局限性
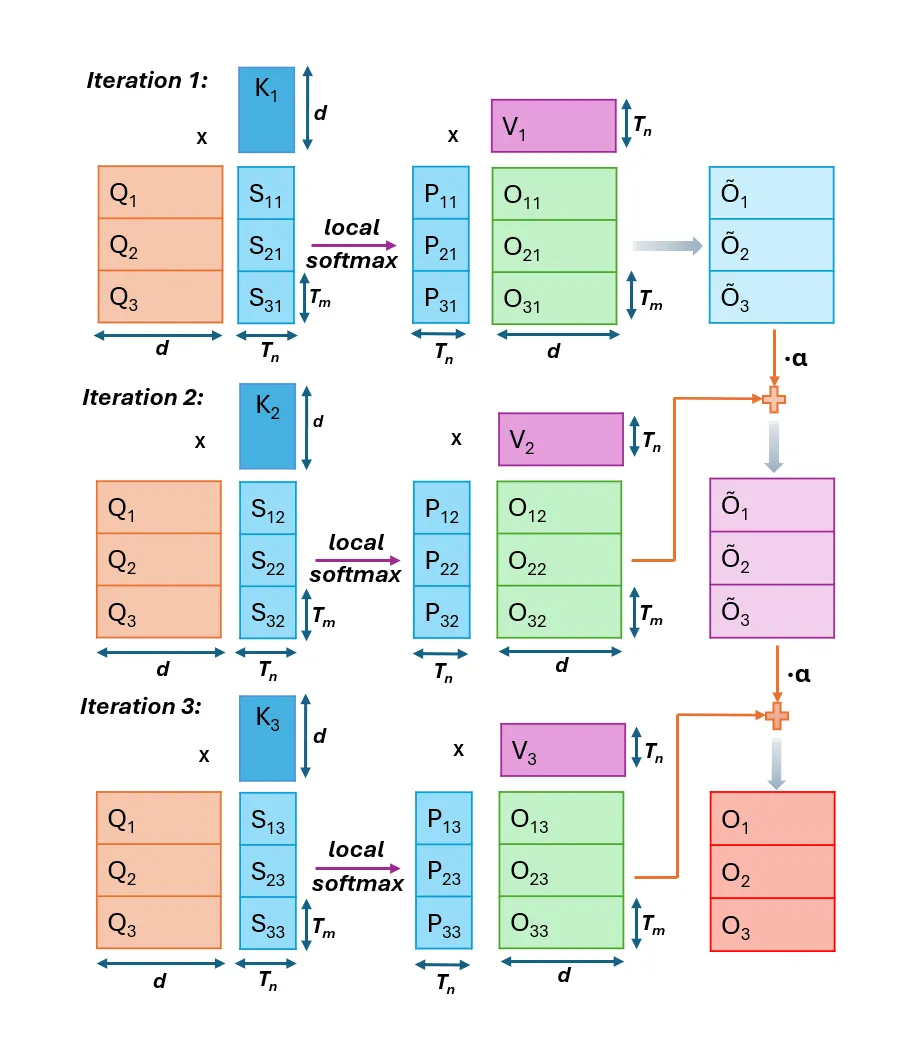
| 局限性 | 描述 |
|---|---|
| 低SM占用率 | Decode阶段query长度为1,无法有效并行化 |
| 顺序softmax约束 | 沿上下文长度维度顺序计算,无法利用并行性 |
| 不支持张量并行 | 无法适应多GPU场景 |
| 有限的并行模式 | 仅支持batch size和head数量的并行 |
2.3 FlashDecoding的不足
FlashDecoding使用固定分割(fixed-split)策略:
- 需要额外的规约kernel启动
- 规约开销随问题规模缩放
- 分割效率(quantization efficiency)依赖于问题规模
- 无法在所有硬件配置下实现最优GPU利用率
2.4 LeanAttention的核心理念
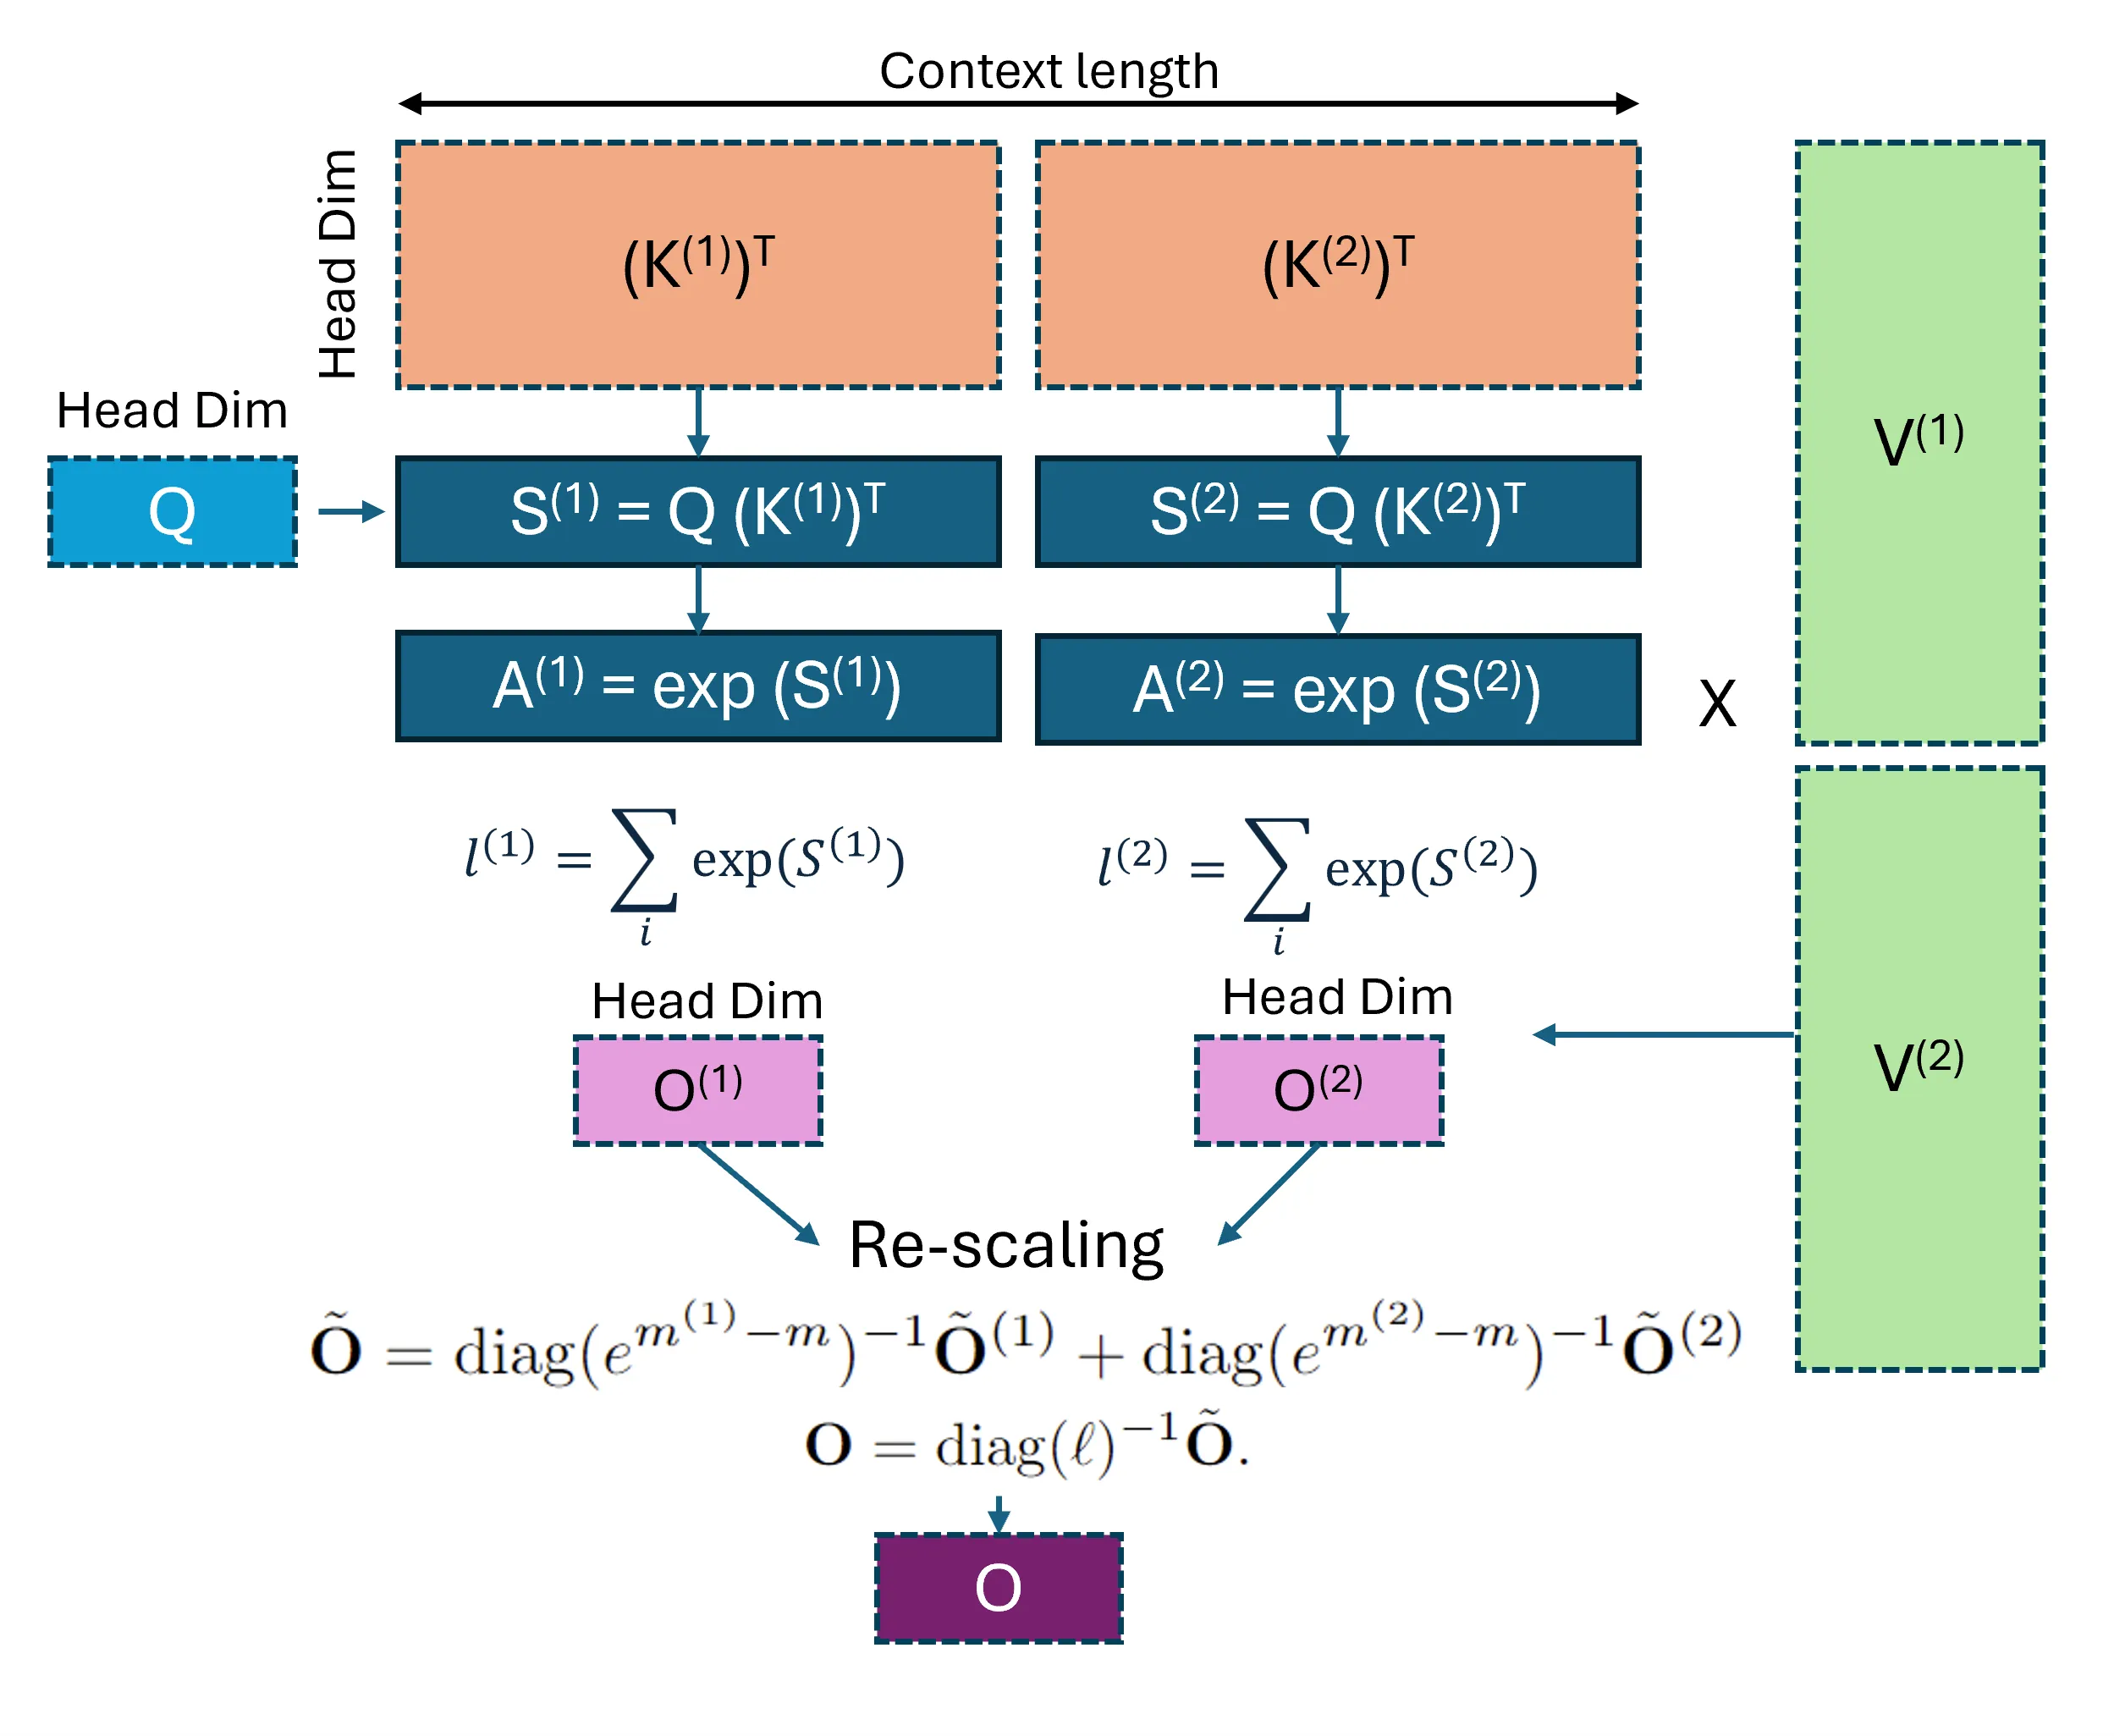
传统方式: Q x K^T → softmax → P x V (顺序执行)
LeanAttention: 将softmax重缩放提取为规约操作 → 并行计算部分输出 → 规约合并关键洞察: 在线softmax的结合律性质允许我们将不同大小的块的注意力输出进行规约合并。
三、技术架构 (Technical Architecture)
3.1 标准注意力计算
标准自注意力公式:
S = Q * K^T
P = softmax(S / sqrt(d))
O = P * V
其中:
- Q ∈ R^(Nq × d): 查询矩阵
- K, V ∈ R^(Nk × d): 键值矩阵
- S ∈ R^(Nq × Nk): 注意力分数矩阵
- O ∈ R^(Nq × d): 输出矩阵
3.2 Softmax重缩放作为规约操作
LeanAttention将注意力计算分为两部分:
第一部分: 计算未缩放的输出
对于两个不同大小的块x和y:
S^(i) = Q * (K^(i))^T
m^(i) = rowmax(S^(i))
ℓ^(i) = rowsum(exp(S^(i) - m^(i)))
O̅^(i) = exp(S^(i) - m^(i)) * V^(i)
第二部分: Softmax重缩放规约
定义规约操作 f(x,y):
m^(x,y) = max(m^(x), m^(y))
ℓ^(x,y) = exp(m^(x) - m^(x,y)) * ℓ^(x) + exp(m^(y) - m^(x,y)) * ℓ^(y)
f(x,y) = diag(exp(m^(x) - m^(x,y))) * O̅^(x) + diag(exp(m^(y) - m^(x,y))) * O̅^(y)
O^(x,y) = diag(ℓ^(x,y))^(-1) * f(x,y)结合律证明: f(f(x,y),z) = f(x,f(y,z)) = f(x,y,z)
这一性质使得可以并行计算不同大小的块,然后规约合并得到精确注意力输出。
3.3 LeanTile: 最小计算单元
LeanTile定义了注意力计算的最小分块粒度:
| 参数 | Head Dim 64 | Head Dim 128 |
|---|---|---|
| LeanTile大小 | 256 tokens | 128 tokens |
LeanTile计算流程:
- 加载Q, K, V片段到共享内存
- 计算局部注意力分数 S_f = Q_f * K_f^T
- 应用在线softmax更新统计量(m, l)
- 计算部分输出 O_acc = P_f * V_f + diag(rescaling) * O_acc
- 返回部分输出O_acc, 统计量l和m
3.4 Stream-K风格分解
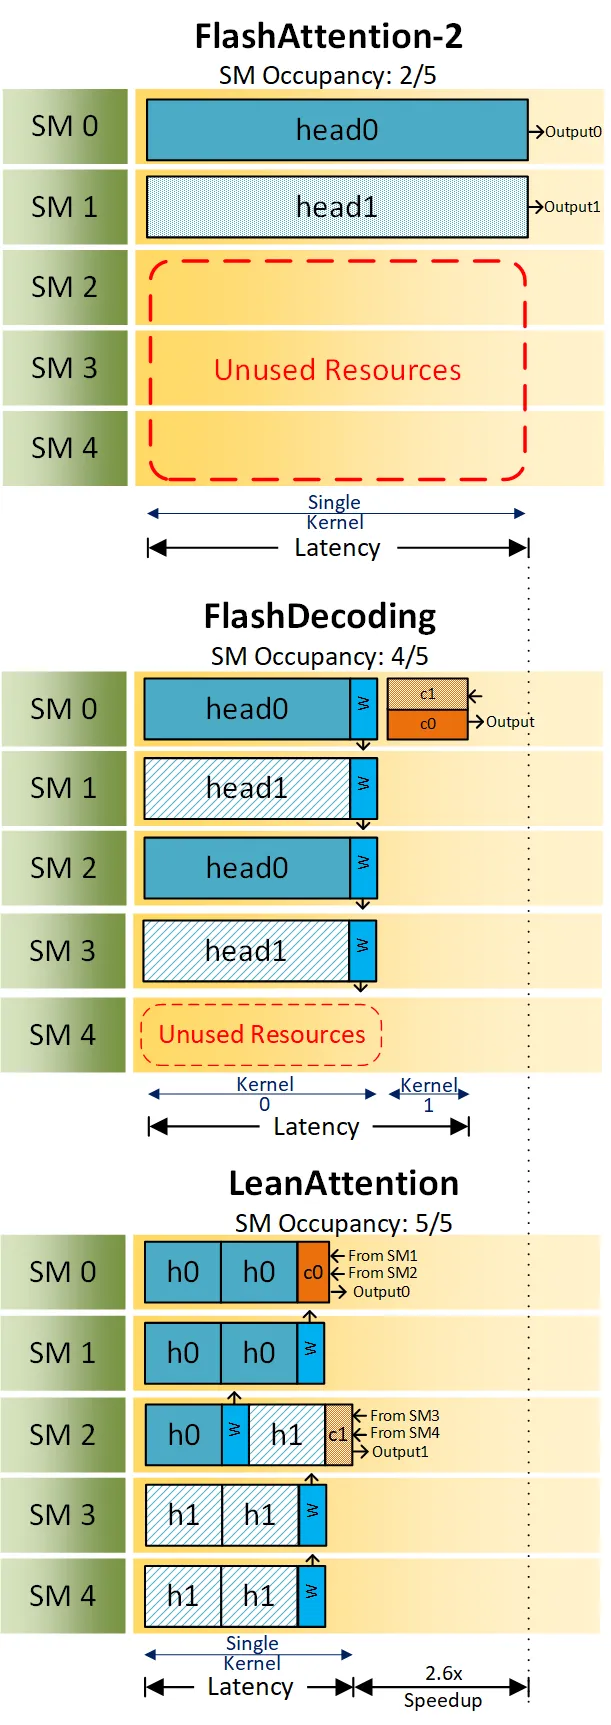
Stream-K分解策略的核心特点:
- 线性映射: 将LeanTile迭代沿上下文维度线性展平
- 均衡分配: 将总工作量均分给所有CTA
- 跨边界处理: 允许CTA跨越head和query边界
- 单kernel启动: 并行计算和规约在单个kernel中完成
传统FlashAttention-2: 每个SM处理一个query tile的完整上下文
FlashDecoding: 固定分割,可能有空闲SM
LeanAttention: 所有SM均分总工作量,接近100%占用率
3.5 执行流程
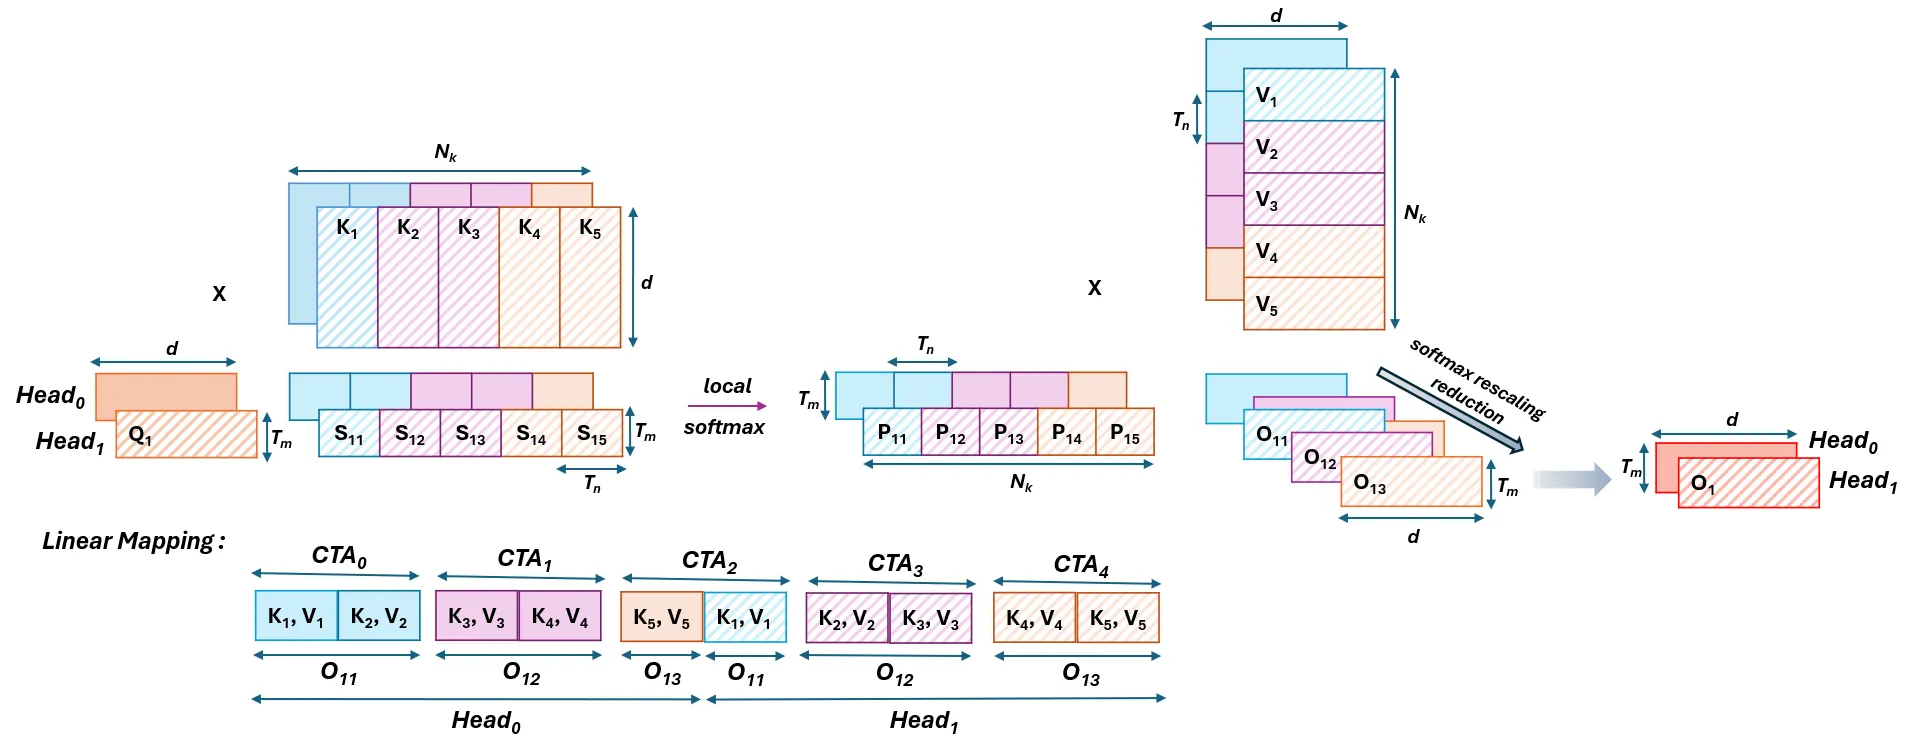
LeanAttention的Stream-K执行流程:
- 初始化: 确定grid size G,计算每CTA的迭代数 I_G = I/G
- 并行执行: 每个CTA执行I_G次LeanTile迭代
- Host/Finishing检测: 确定每个输出tile的host CTA和finishing CTA
- 部分结果共享: 非host CTA通过全局内存共享部分结果
- 规约合并: Host CTA等待并规约所有部分结果
- 最终输出: 应用最终缩放因子,写回全局内存
四、核心创新 (Key Innovations)
4.1 Softmax结合律的发现与证明
创新点: 首次将softmax重缩放操作形式化为满足结合律的规约操作。
传统观点认为softmax需要顺序计算所有元素,LeanAttention证明了:
- 不同大小的块的softmax输出可以通过重缩放操作进行规约
- 规约结果与顺序计算的结果完全相同(精确注意力)
- 这一性质适用于任意大小的块划分
4.2 Stream-K到注意力的扩展
创新点: 将矩阵乘法的stream-K分解技术扩展到注意力机制。
| 方面 | Stream-K (MatMul) | LeanAttention |
|---|---|---|
| 规约操作 | 加法 | Softmax重缩放 |
| 部分结果 | 标量 | 向量(输出tile) |
| 合并方式 | 累加 | 带统计量的重缩放 |
| 精度保证 | 精确 | 精确注意力 |
4.3 硬件感知的工作分配
创新点: 根据硬件资源动态确定最优工作分配策略。
LeanAttention自动泛化:
- 当输出tile数 = grid size → 行为类似FlashAttention-2
- 当grid size是输出tile数的整数倍 → 行为类似FlashDecoding
- 其他情况 → LeanAttention独特的均衡分配
4.4 单Kernel融合执行
创新点: 将并行计算和规约合并到单个kernel中执行。
优势:
- 避免FlashDecoding的额外kernel启动开销
- 减少全局内存读写
- 降低同步开销
五、实验结果 (Experimental Results)
5.1 实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | Nvidia A100-80GB GPU (单GPU和8xGPU) |
| SM数量 | 单GPU: 108 SMs, 8GPU: 864 SMs |
| 实现 | 使用NVIDIA CUTLASS库的CUTE抽象 |
| 对比基线 | FlashAttention-2 (FA2), FlashDecoding (FD) |
| 测试规模 | 500+样本, 不同batch size/context length/head数量 |
| 模型 | OPT 1.3B, OPT 6.7B |
5.2 单GPU注意力性能
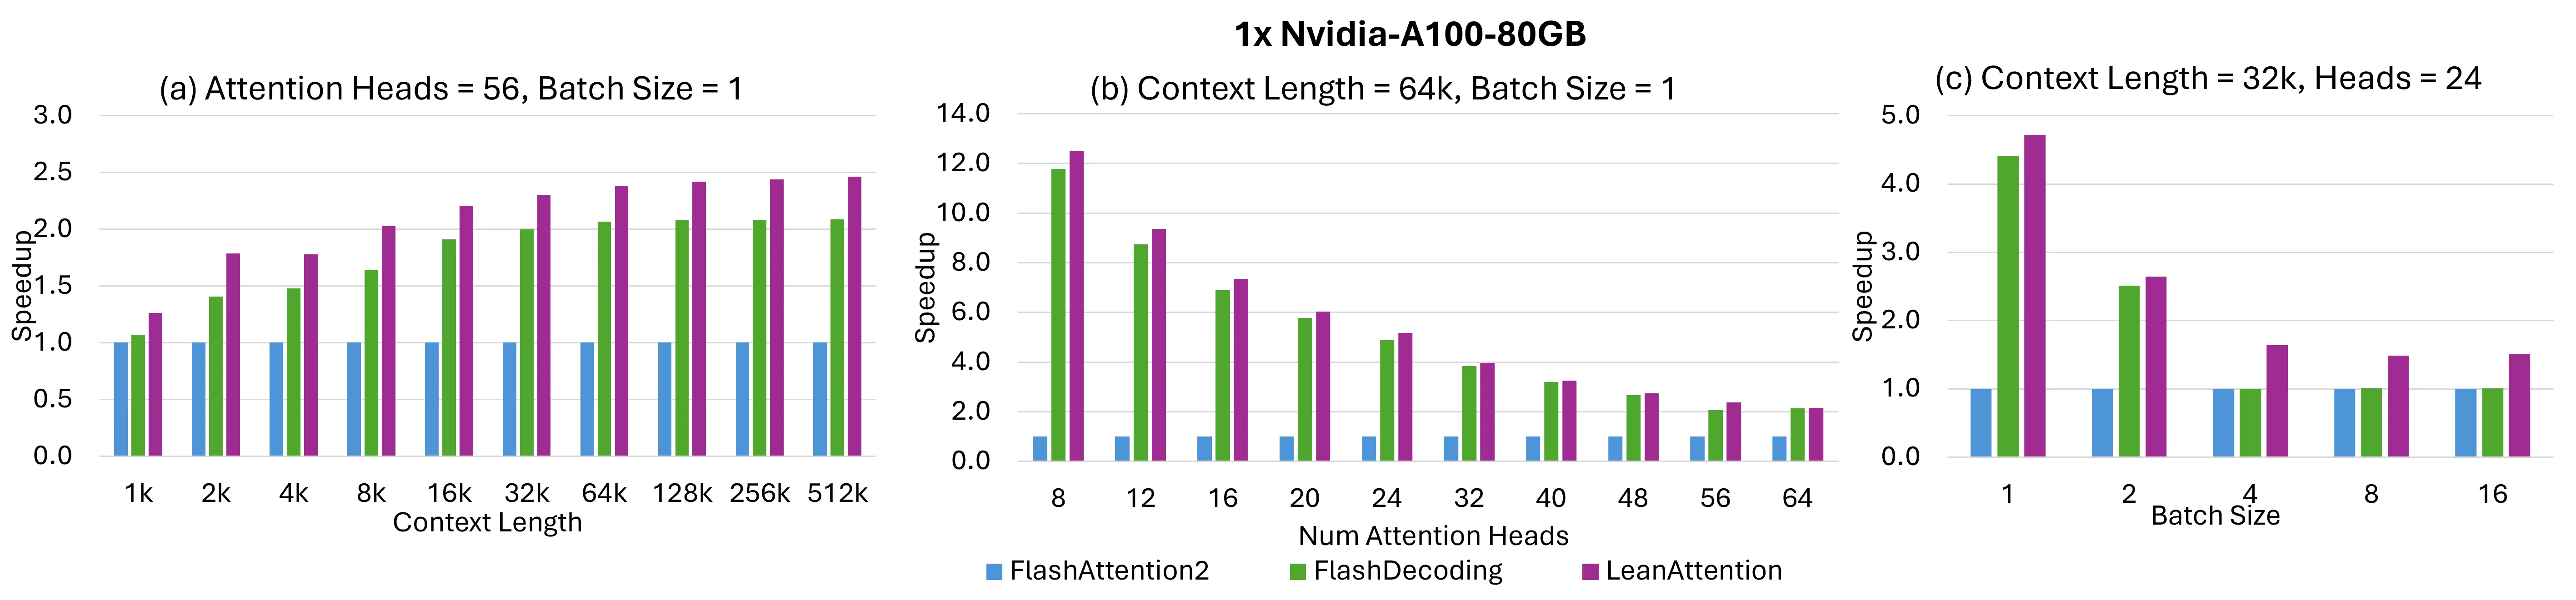
上下文长度影响 (56 heads, batch=1)
| 上下文长度 | vs FA2加速比 | vs FD加速比 |
|---|---|---|
| 8k | >2x | - |
| 32k | ~2.2x | ~1.2x |
| 64k | ~2.4x | ~1.3x |
| 512k | 2.46x | ~1.3x |
注意力头数量影响 (64k context, batch=1)
| Head数量 | vs FA2加速比 |
|---|---|
| 16 | 12.5x |
| 64 | 2.15x |
| 更多 | 渐进降低但仍显著 |
Batch Size影响
| Batch Size | vs FA2 | vs FD |
|---|---|---|
| 1 | 4.71x | 1.06x |
| 较大batch | 1.5x | 1.0x+ |
总体统计
| 指标 | vs FA2 | vs FD |
|---|---|---|
| 平均加速 | 2.6x | 1.27x |
| 最大加速 | 8.33x (16 heads, 512k) | 1.71x (24 heads, 512k) |
| 最小加速 | 1.1x (24 heads, 1k) | 0.99x (24 heads, 1k) |
5.3 多GPU性能 (8xA100)
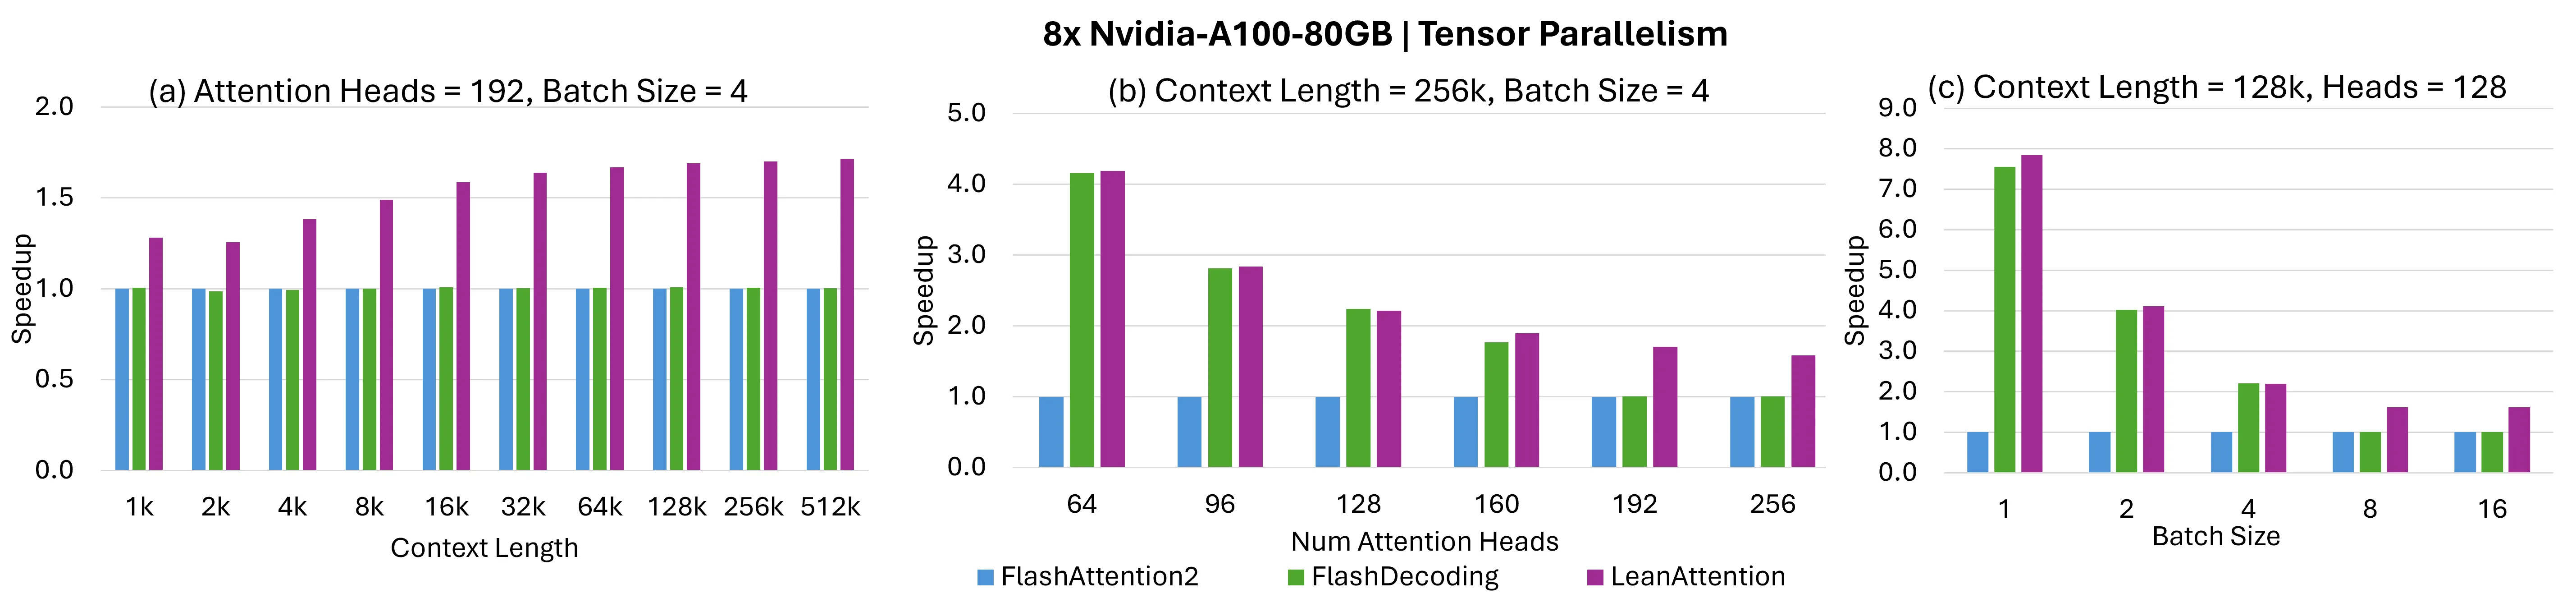
上下文长度影响 (192 heads, batch=4)
| 上下文长度 | vs FA2加速比 | 备注 |
|---|---|---|
| 1k | 1.28x | FD = FA2 (head数量多) |
| 64k | >1.70x | - |
| 512k | ~1.70x | - |
Head数量影响 (256k context, batch=4)
| Head数量 | vs FA2加速比 | 备注 |
|---|---|---|
| 64 | 4.18x | FA2严重低利用 |
| 128 | 显著加速 | - |
| 192 | 仍优于FA2 | FD退化为FA2 |
Batch Size影响 (128 heads, 256k context)
| Batch Size | vs FA2加速比 |
|---|---|
| 1 | 7.8x |
| 16 | 显著但较低 |
5.4 Head Dimension 128
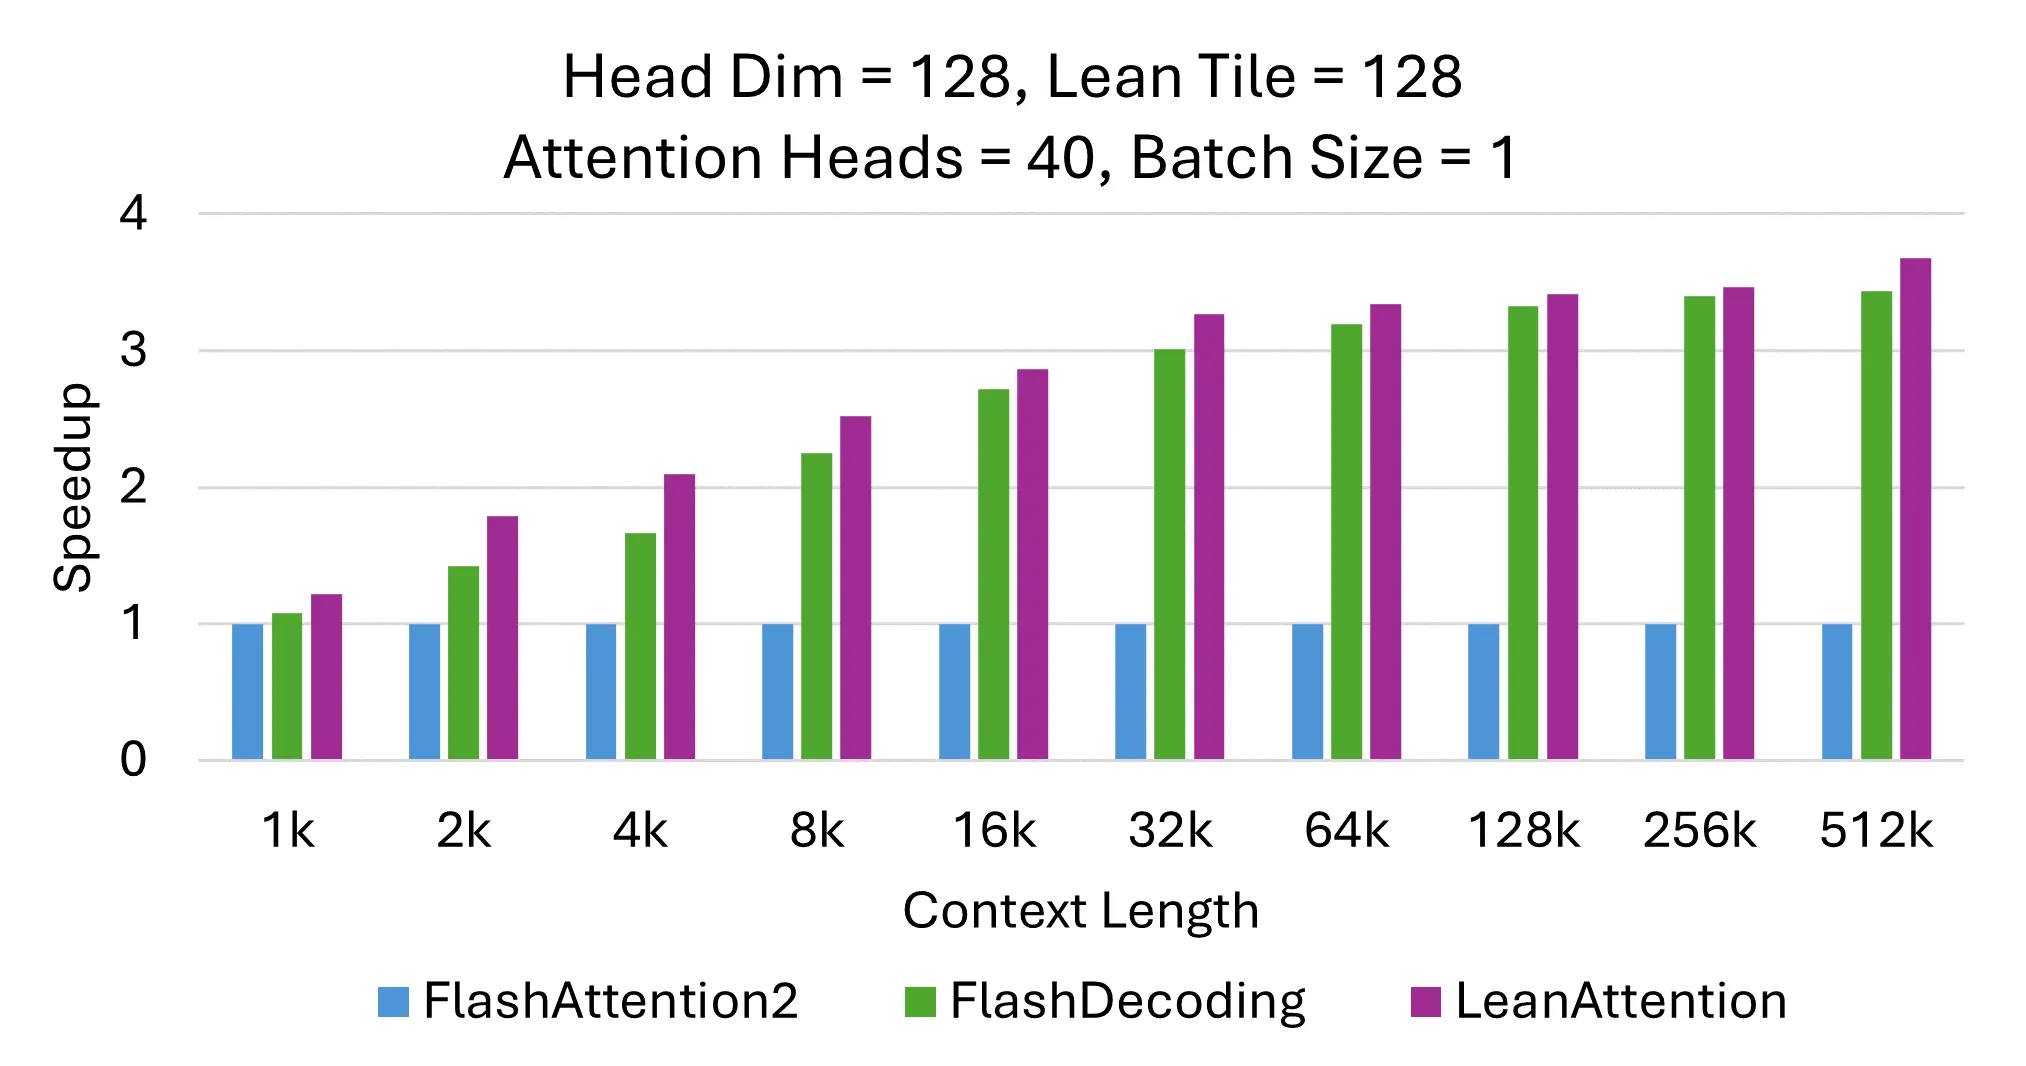
使用128 token宽的LeanTile:
| 上下文长度 | vs FA2加速比 |
|---|---|
| 1k | 1.2x |
| 512k | 3.67x |
5.5 端到端推理性能
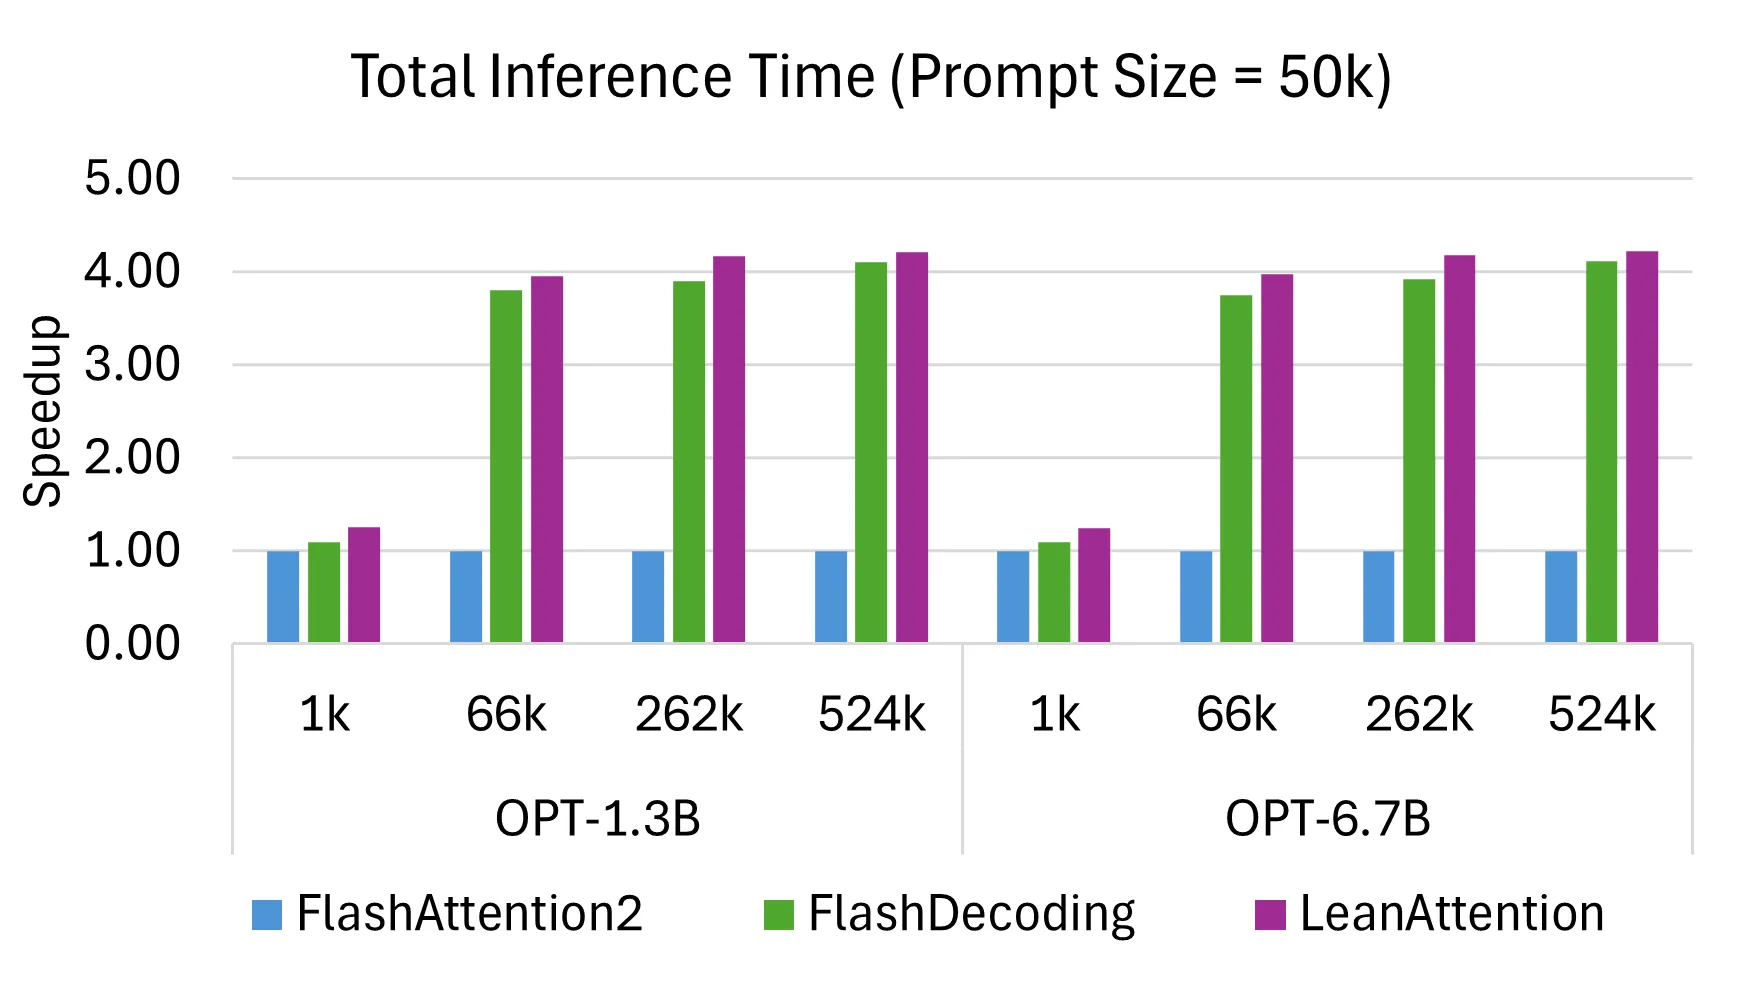
使用OPT模型 (50k prompt tokens):
| 模型 | 输出长度 | vs FA2 | vs FD |
|---|---|---|---|
| OPT 1.3B | 1k tokens | 1.26x | - |
| OPT 1.3B/6.7B | >64k tokens | 4.0x | 1.06x |
5.6 GPU占用率
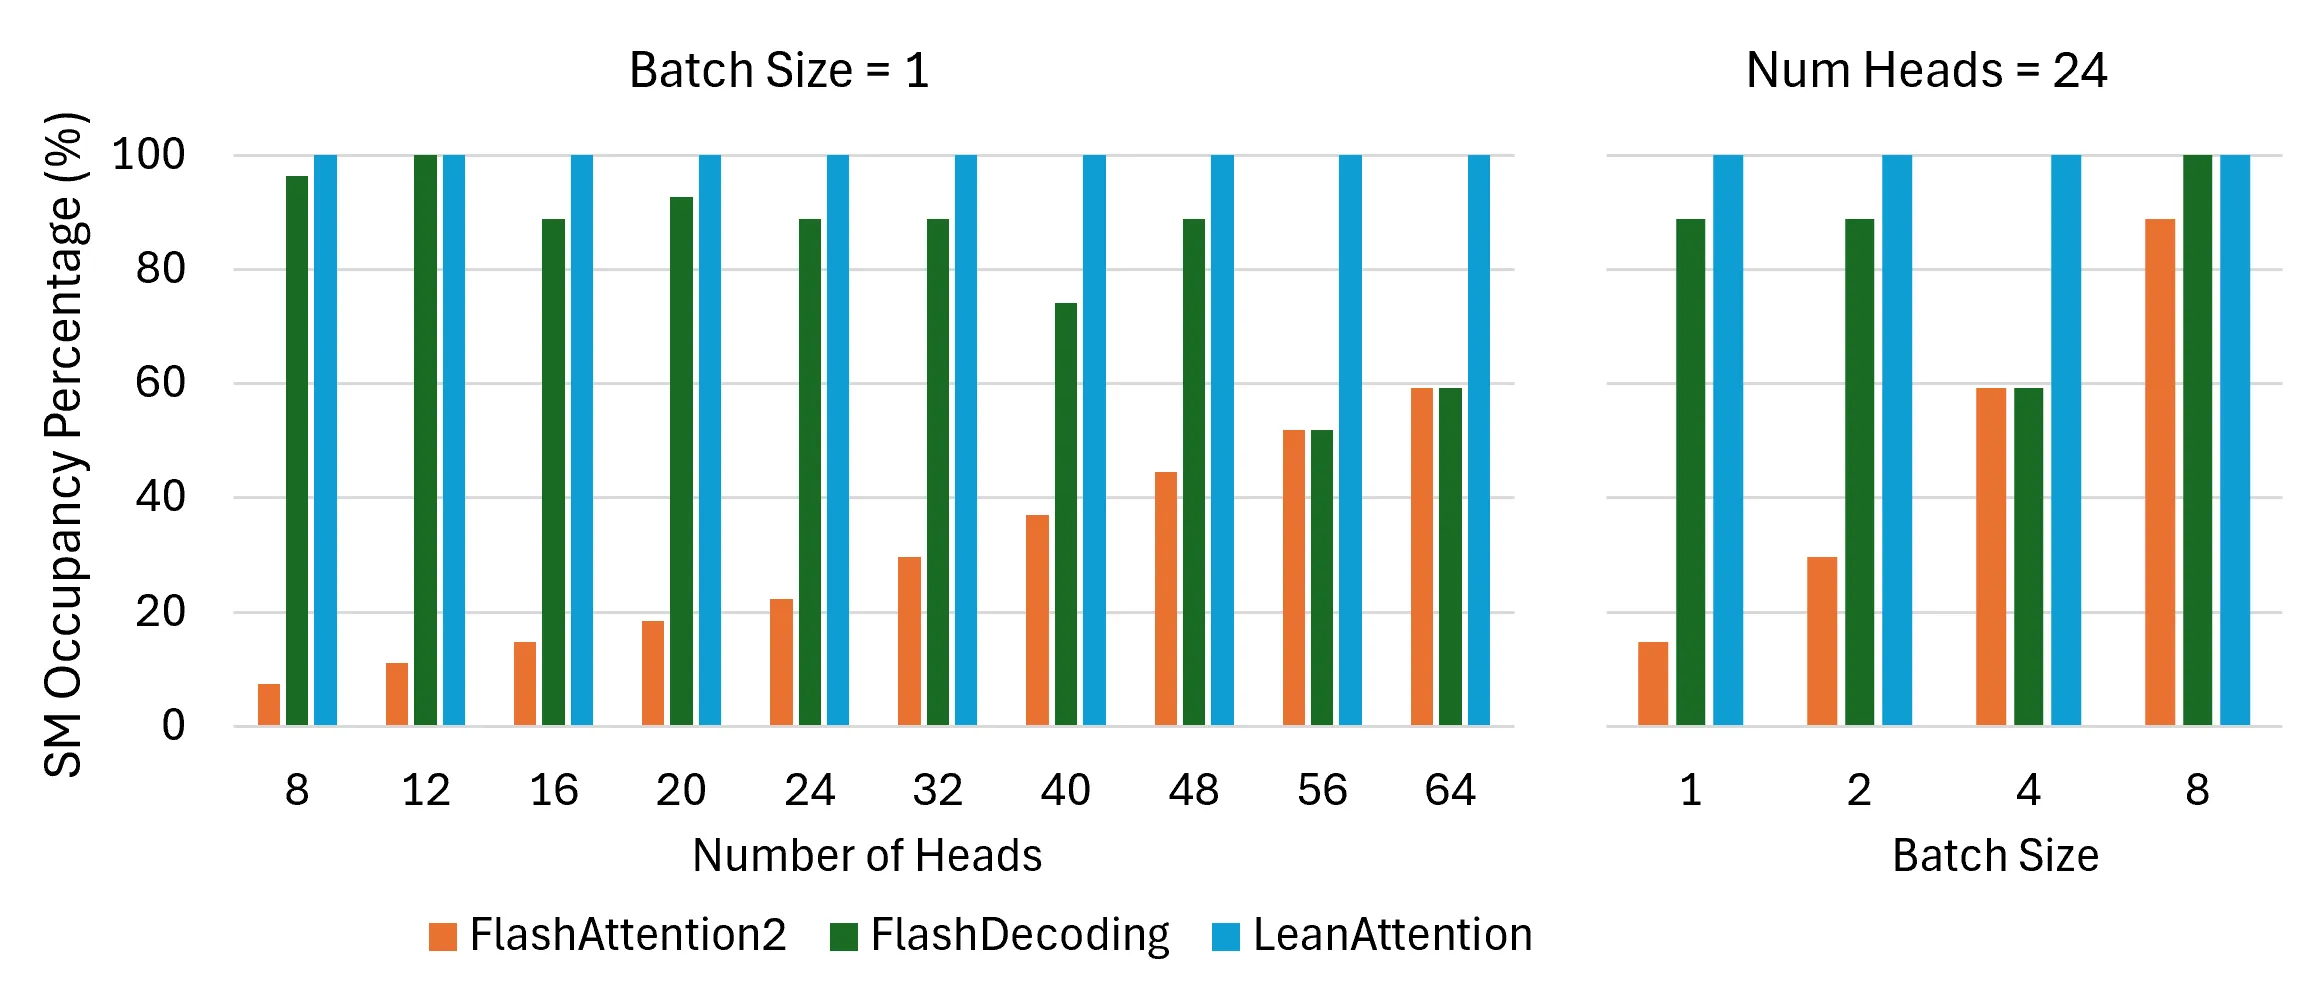
| 方法 | SM占用率 |
|---|---|
| FlashAttention-2 | 低 (decode阶段) |
| FlashDecoding | 中等 (取决于分割因子) |
| LeanAttention | 接近100% |
六、相关工作 (Related Work)
6.1 注意力优化方法
| 方法 | 关键思想 | 局限性 |
|---|---|---|
| FlashAttention | IO感知的分块计算, 在线softmax | 不支持decode阶段优化 |
| FlashAttention-2 | 减少非matmul操作, query维度并行 | Decode阶段SM占用率低 |
| FlashDecoding | 固定分割上下文长度 | 量化效率低, 规约开销大 |
| FlashDecoding++ | 近似全局max, 双缓冲 | 仍受限于固定分割 |
| Ring Attention | 环形通信的分布式注意力 | 优化prefill阶段 |
| Striped Attention | 条纹式分区的因果注意力 | 优化prefill阶段 |
6.2 相关技术背景
| 技术 | 与LeanAttention的关系 |
|---|---|
| 在线Softmax | LeanAttention的基础,用于分块计算 |
| Stream-K分解 | 直接扩展到注意力机制 |
| 张量并行 | LeanAttention原生支持 |
| KV Cache | Decode阶段的核心优化 |
6.3 与现有方法的对比
| 特性 | FA2 | FD | FD++ | LeanAttention |
|---|---|---|---|---|
| Prefill优化 | ✓ | ✓ | ✓ | ✓ |
| Decode优化 | ✗ | ✓ | ✓ | ✓✓ |
| 上下文并行 | ✗ | ✓ | ✓ | ✓✓ |
| 负载均衡 | - | ✗ | ✗ | ✓✓ |
| 量化效率 | - | 低 | 中 | ~100% |
| 单Kernel | ✓ | ✗ | ✗ | ✓ |
| 多GPU支持 | ✗ | 有限 | 有限 | ✓ |
| 精确注意力 | ✓ | ✓ | 近似 | ✓ |
七、总结 (Conclusion)
7.1 核心成就
LeanAttention针对Transformer解码阶段的注意力计算瓶颈,提出了创新的解决方案:
- 理论突破: 发现并证明了softmax重缩放的结合律性质
- 工程创新: 将stream-K分解成功扩展到注意力机制
- 性能提升: 平均2.6x加速,最高8.33x加速
- 硬件对齐: 实现接近100%的GPU占用率
- 通用性: 自动适应不同问题规模和硬件配置
7.2 技术贡献总结
| 贡献 | 描述 | 影响 |
|---|---|---|
| Softmax规约化 | 结合律证明与规约操作定义 | 理论基础 |
| LeanTile设计 | 最优分块粒度(64→256, 128→128) | 实现细节 |
| Stream-K扩展 | 从MatMul到Attention | 方法论创新 |
| 单Kernel融合 | 并行计算+规约合并 | 工程优化 |
7.3 适用场景
LeanAttention特别适用于:
- 长上下文推理 (>8k tokens)
- 小batch size场景
- 模型head数量有限的情况
- 多GPU张量并行部署
- Decode阶段密集的自回归生成
7.4 局限性与未来方向
当前局限:
- 需要修改输入tensor的内存布局 (batch, heads, seq_len, head_dim)
- 规约阶段需要少量全局内存用于部分结果共享
- 最优LeanTile大小需要针对不同硬件和配置进行调优
未来方向:
- 扩展到更多硬件平台 (AMD, Intel GPU)
- 与推测性解码(Speculative Decoding)结合
- 支持更多注意力变体 (GQA, MQA, MLA)
- 与量化技术结合进一步优化
八、参考资源 (References)
8.1 论文链接
- arXiv: https://arxiv.org/abs/2405.10480
- PDF: https://arxiv.org/pdf/2405.10480
- HTML: https://arxiv.org/html/2405.10480v1
8.2 相关代码与工具
| 资源 | 链接 | 说明 |
|---|---|---|
| FlashAttention-2 | https://github.com/Dao-AILab/flash-attention | 对比基线实现 |
| NVIDIA CUTLASS | https://github.com/NVIDIA/cutlass | LeanAttention实现基础 |
| CUTE文档 | https://github.com/NVIDIA/cutlass/blob/main/media/docs/cute/ | Tensor抽象库 |
| HuggingFace Transformers | https://github.com/huggingface/transformers | 端到端测试使用的OPT模型 |
8.3 关键参考文献
| 编号 | 论文 | 关键贡献 |
|---|---|---|
| [13] | FlashAttention-2 (Dao, 2023) | 基线对比,IO感知注意力 |
| [14] | FlashAttention (Dao et al., 2022) | 原始FlashAttention |
| [27] | Stream-K (Osama et al., 2023) | MatMul的stream-K分解 |
| [4] | FlashDecoding | Decode阶段的固定分割策略 |
| [17] | FlashDecoding++ | FlashDecoding的改进版本 |
| [25] | Online Softmax (Milakov & Gimelshein, 2018) | 在线softmax算法 |
| [31] | Attention is All You Need (Vaswani et al., 2017) | 原始Transformer架构 |
8.4 关键公式速查
标准注意力: S = QK^T, P = softmax(S/√d), O = PV

Softmax重缩放规约:
  m^(x,y) = max(m^(x), m^(y))
  ℓ^(x,y) = exp(m^(x)-m^(x,y))ℓ^(x) + exp(m^(y)-m^(x,y))ℓ^(y)
  f(x,y) = diag(exp(m^(x)-m^(x,y)))O̅^(x) + diag(exp(m^(y)-m^(x,y)))O̅^(y)
  O^(x,y) = diag(ℓ^(x,y))^(-1) f(x,y)

结合律: f(f(x,y),z) = f(x,f(y,z)) = f(x,y,z)
8.5 图表索引
| 图号 | 描述 | 文件路径 |
|---|---|---|
| Figure 1 | FlashAttention-2, FlashDecoding, LeanAttention执行调度对比 | figures/leanattention/high_level_figure.png |
| Figure 2 | FlashAttention-2迭代更新输出过程 | figures/leanattention/flashattn_parta.png |
| Figure 3 | Prefill与Decode阶段时间占比 | figures/leanattention/token_phase_timeshare.png |
| Figure 4 | 不同注意力模式的SM占用率 | figures/leanattention/sm_occupancy.png |
| Figure 5 | LeanAttention分解策略示意图 | figures/leanattention/lean_math.png |
| Figure 6 | Decode阶段LeanAttention执行流程 | figures/leanattention/lean_attn_fig.png |
| Figure 7 | 单GPU不同配置下的加速比 | figures/leanattention/unit_results.png |
| Figure 8 | 8xGPU不同配置下的加速比 | figures/leanattention/unit_results_8xgpu.png |
| Figure 9 | Head Dimension 128的加速比 | figures/leanattention/head_dim_128.png |
| Figure 10 | 端到端推理加速比 | figures/leanattention/end_to_end_speedup.png |
分析日期: 2026-05-30 分析师: AI Paper Analyzer