Mirage: A Multi-Level Superoptimizer for Tensor Programs
多层级张量程序超级优化器,通过统一搜索空间生成高效注意力内核
Mirage: A Multi-Level Superoptimizer for Tensor Programs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Mirage: A Multi-Level Superoptimizer for Tensor Programs |
| 作者 | Mengdi Wu, Xinhao Cheng, Shengyu Liu, Chunan Shi, Jianan Ji, Man Kit Ao, Praveen Velliengiri, Xupeng Miao, Oded Padon, Zhihao Jia |
| 机构 | Carnegie Mellon University, Peking University, Pennsylvania State University, Purdue University, Weizmann Institute of Science |
| 论文 | arXiv:2405.05751 |
| 代码 | GitHub: mirage-project/mirage |
| 发布 | 2024-05-09 (v1), 2025-06-06 (v3) |
| 领域 | Machine Learning (cs.LG), Programming Languages (cs.PL) |
二、核心思想
问题定义
在GPU上实现DNN的高性能执行对现代ML应用至关重要。当前的DNN框架使用张量程序(有向无环图)来指定计算,但现有优化方法存在局限:
- 单层级优化:现有编译器(如TVM、Triton)主要在单一抽象层级优化,无法发现跨层级的优化机会
- 搜索空间巨大:张量程序的优化空间呈指数级增长
- 正确性保证:优化后的程序必须与原始程序等价
解决方案概述
Mirage是首个多层级超级优化器,核心创新包括:
- μGraphs(μ图):统一表示张量程序在kernel、thread block、thread三个层级的计算
- 抽象剪枝:基于抽象表达式的搜索空间剪枝技术,提供最优性保证
- 概率等价验证:具有强理论保证的随机等价性检查
三、技术架构
整体框架图
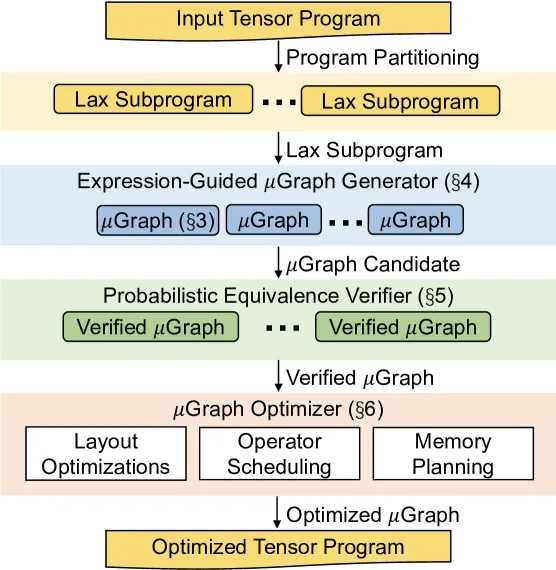
Mirage的工作流程:
| 阶段 | 名称 | 说明 |
|---|---|---|
| 输入 | 计算图 | 用户提供的DNN计算图 |
| 生成 | μGraph Generator | 生成候选μGraph |
| 剪枝 | Abstract Pruning | 基于抽象表达式剪枝 |
| 验证 | Equivalence Checking | 概率等价性验证 |
| 输出 | 最优μGraph | 高性能CUDA代码 |
核心概念:μGraphs
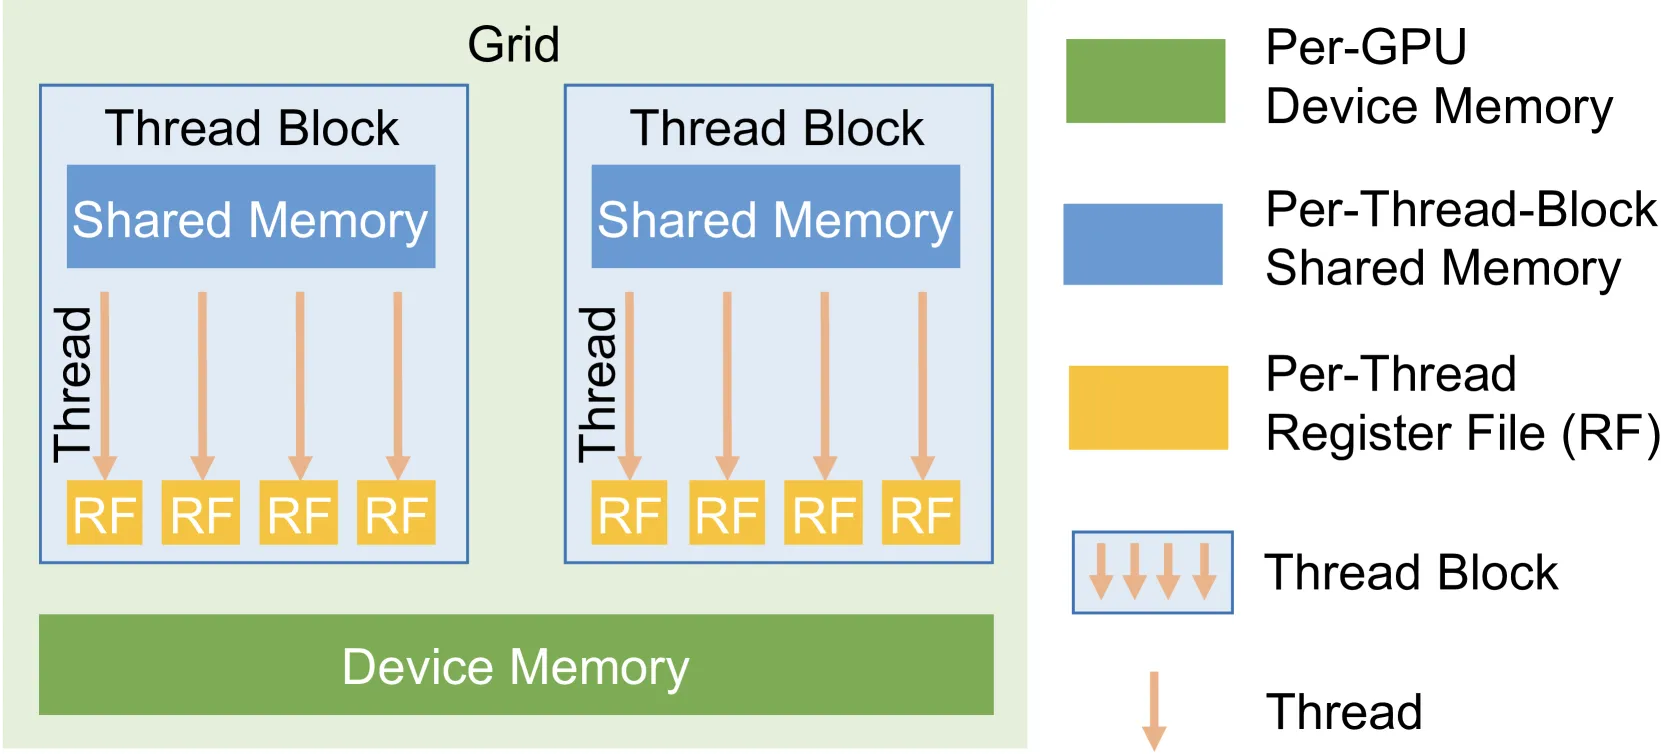
μGraphs统一表示GPU计算层级:
| 层级 | 说明 | 对应GPU层级 |
|---|---|---|
| Kernel Graph | 内核级计算图 | GPU Kernel |
| Block Graph | 线程块级计算图 | Thread Block |
| Thread Graph | 线程级计算图 | Thread |
关键洞察: 通过在三个层级统一表示,Mirage可以发现组合代数变换、调度变换和新内核生成的优化。
μGraph示例
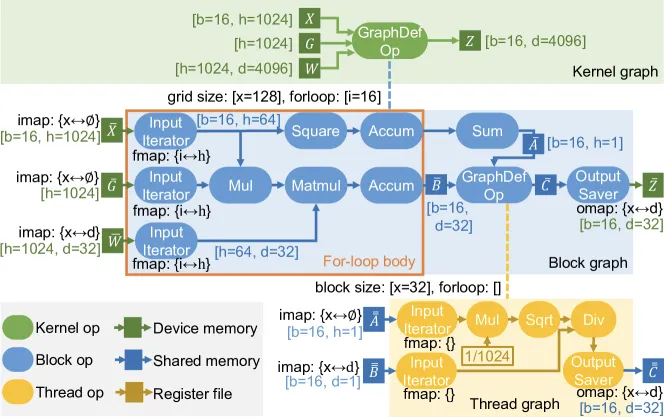
以RMSNorm和MatMul为例:
- 现有系统:分离的两个kernel
- Mirage发现:融合的μGraph,消除中间tensor物化
核心公式
抽象表达式 (Abstract Expressions):
每个tensor的抽象表达式描述其计算语义:
抽象剪枝 (Abstract Pruning):
给定两个抽象表达式 和 ,检查 是否是 的子表达式:
通过SMT求解器验证,如果 为假,则剪枝该搜索分支。
等价性验证 (Equivalence Verification):
使用随机测试在有限域上验证等价性:
选择素数 和 (),在有限域 和 上进行测试。
μGraph生成算法
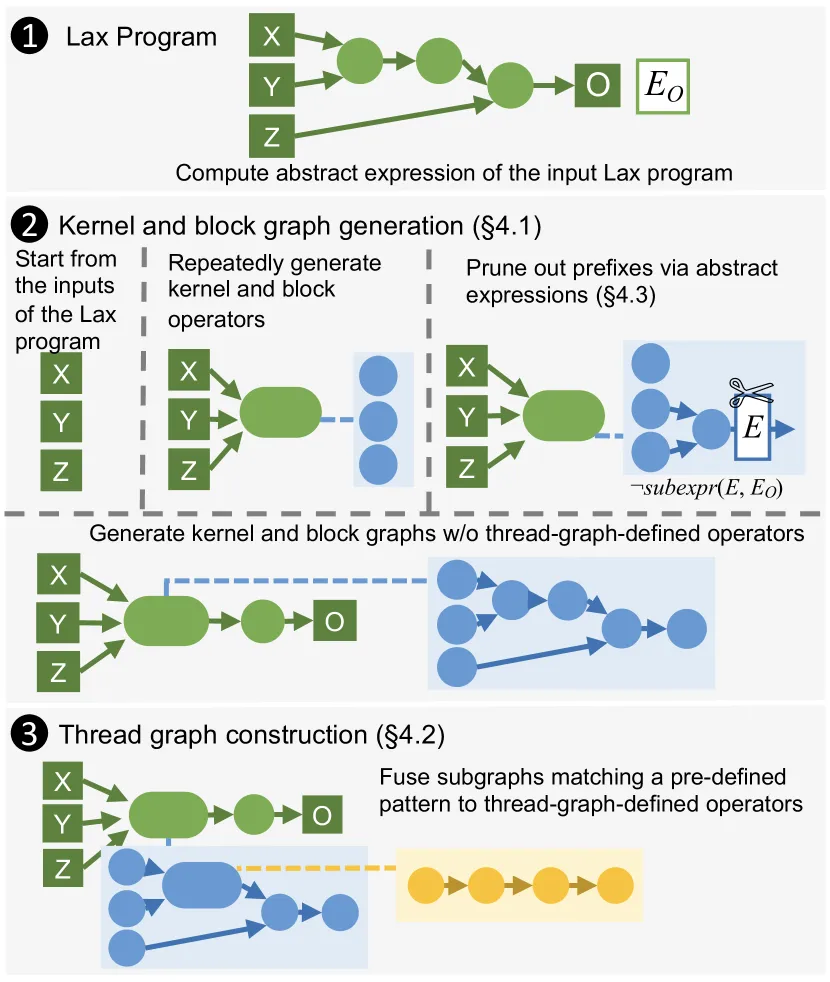
Algorithm 1: Mirage’s hybrid μGraph generation algorithm
输入: 计算图 G
输出: 最优 μGraph

1. 将 G 转换为 kernel graph
2. 对每个 kernel graph:
   a. 生成 thread block graph 候选
   b. 对每个 thread block graph:
      i. 生成 thread graph 候选
      ii. 使用抽象表达式剪枝
      iii. 验证等价性
3. 返回最优 μGraph
关键优化:
- 多线程并行搜索:并行探索搜索空间
- 抽象表达式剪枝:显著减少搜索空间
- 增量式生成:逐步细化μGraph
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| μGraphs统一表示 | 在kernel、block、thread三层统一表示 | 发现跨层级优化机会 |
| 抽象表达式剪枝 | 基于SMT的搜索空间剪枝 | 提供最优性保证 |
| 概率等价验证 | 有限域随机测试 | 强理论保证(错误概率可调) |
| 混合生成算法 | 自顶向下生成 + 自底向上细化 | 高效探索搜索空间 |
五、实验结果
性能比较
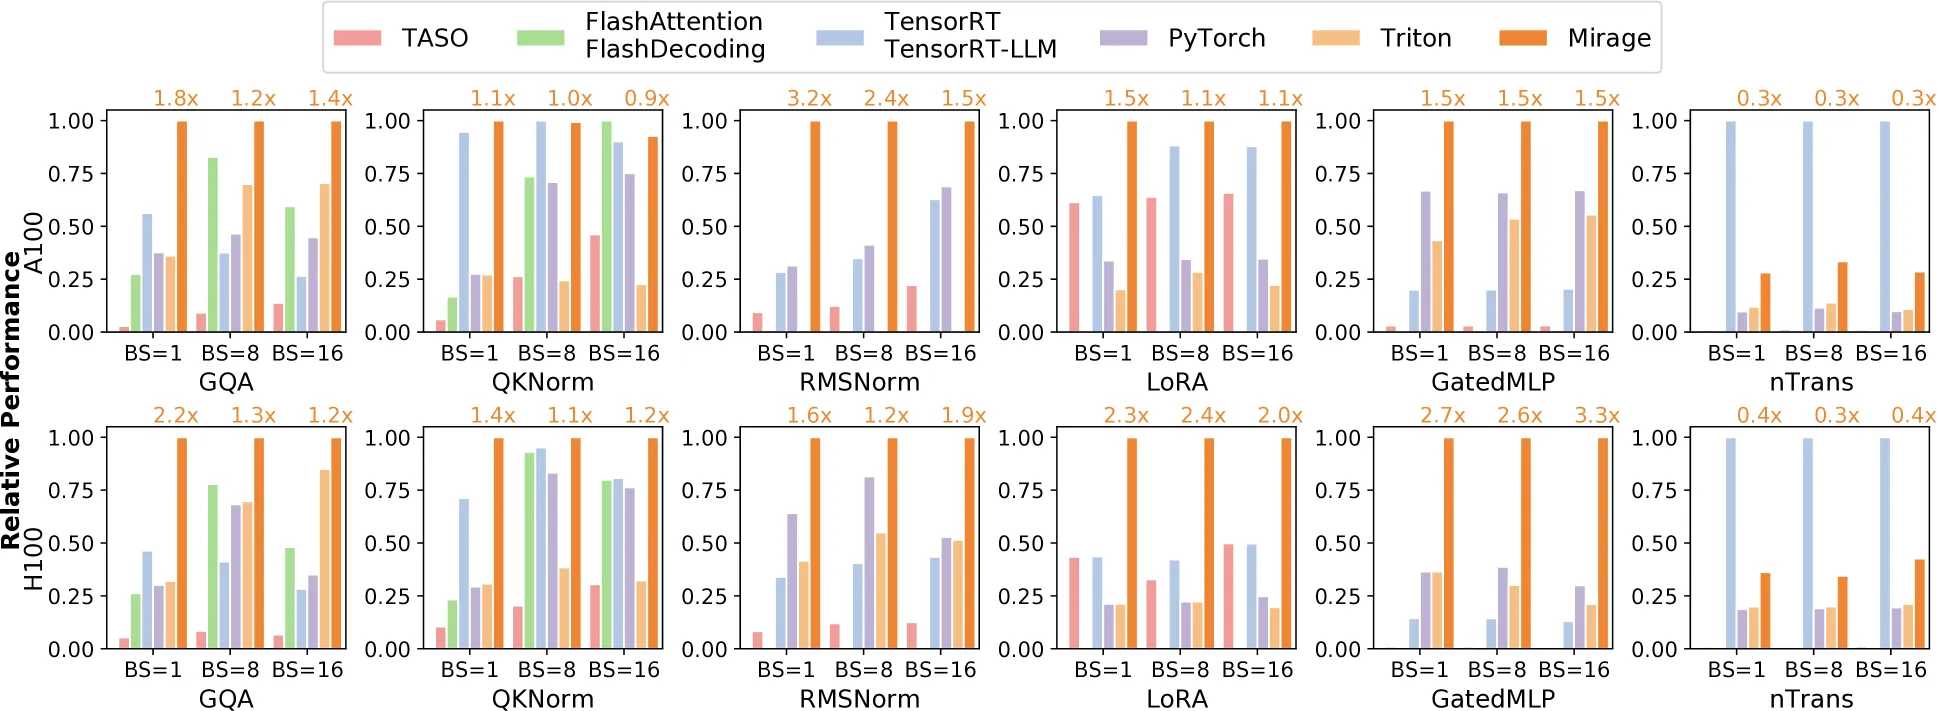
6个基准测试在A100和H100上的结果:
| 基准测试 | Mirage vs 最佳基线 | 说明 |
|---|---|---|
| RMSNorm + MatMul | 3.3× | 跨层级融合 |
| QKNorm + Attention | 2.4× | 注意力优化 |
| LoRA | 2.1× | 低秩适配优化 |
| GatedMLP | 1.8× | 门控MLP优化 |
| 其他DNN | 1.2-2.0× | 广泛适用 |
端到端推理性能
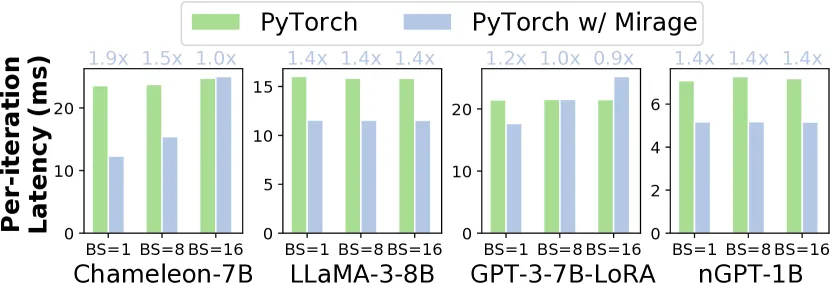
PyTorch vs PyTorch + Mirage生成的kernel:
- 在广泛使用和高度优化的DNN上仍能显著提升性能
- 即使是成熟的模型(如Transformer)也能获得改进
消融实验
| 技术 | 搜索时间影响 |
|---|---|
| 多线程并行 | 减少3-5× |
| 抽象表达式剪枝 | 减少10-100× |
| 增量式生成 | 减少2-3× |
六、相关工作
| 方向 | 代表工作 | Mirage的优势 |
|---|---|---|
| DNN编译器 | TVM, Triton | 跨层级优化,发现新kernel |
| 超级优化 | Souper, STOKE | 专门针对张量程序 |
| 调度搜索 | AutoTVM, Ansor | 搜索空间更高效 |
| 手写kernel | cuBLAS, cuDNN | 自动发现,无需人工设计 |
七、总结
核心贡献
- 首个多层级张量超级优化器:通过μGraphs统一表示kernel、block、thread三层
- 抽象剪枝技术:基于抽象表达式减少搜索空间,提供最优性保证
- 概率等价验证:具有强理论保证的随机等价性检查
- 显著性能提升:在广泛使用的DNN上比现有系统快1.2-3.3×
技术影响
- 自动化优化:无需人工设计kernel,自动发现跨层级优化
- 理论贡献:抽象剪枝和概率验证的理论框架
- 开源实现:公开可用,可集成到现有DNN框架
局限性
- 搜索时间可能较长(对于复杂程序)
- 当前主要支持前馈网络,循环网络支持有限
- 需要GPU硬件特定的优化
八、参考资源
- 论文: arXiv:2405.05751
- 代码: GitHub: mirage-project/mirage
- 应用场景: DNN推理优化、张量程序编译