QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving
QServe提出W4A8KV4量化与系统协同设计,通过QoQ算法和QServe推理库实现LLM服务吞吐量提升2.36倍,成本降低3倍。
QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving
一、论文概述
1.1 论文基本信息
| 项目 | 内容 |
|---|---|
| 标题 | QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving |
| 作者 | Yujun Lin*, Haotian Tang*, Shang Yang*, Zhekai Zhang, Guangxuan Xiao, Chuang Gan, Song Han |
| 机构 | MIT, NVIDIA, UMass Amherst, MIT-IBM Watson AI Lab |
| 发表时间 | 2024年5月7日 (v1), 2025年5月1日 (v3) |
| arXiv ID | 2405.04532 |
| 代码 | https://github.com/mit-han-lab/qserve |
1.2 摘要翻译
量化可以加速大语言模型(LLM)推理。超越INT8量化,研究社区正在积极探索更低精度的量化,如INT4。然而,最先进的INT4量化技术只能加速低批次、边缘LLM推理,无法在大批次、云基LLM服务中带来性能提升。
本文揭示了一个关键问题:现有的INT4量化方法在GPU上反量化权重或部分和时存在显著的运行时开销(20-90%)。为解决这一挑战,作者引入了QoQ——一种W4A8KV4量化算法,采用4-bit权重、8-bit激活和4-bit KV缓存。QoQ代表”quattuor-octo-quattuor”,即拉丁语中的4-8-4。
QoQ通过QServe推理库实现,可获得实测加速。QServe的关键洞察是:GPU上LLM服务的效率受到低吞吐量CUDA核心上操作的关键影响。基于此洞察:
- 在QoQ算法中,引入渐进式量化以降低W4A8 GEMM中的反量化开销
- 开发SmoothAttention以有效缓解4-bit KV量化带来的精度下降
- 在QServe系统中,执行计算感知权重重排并利用寄存器级并行性减少反量化延迟
- 使融合注意力成为内存受限,利用KV4量化带来的性能增益
最终结果:
- Llama-3-8B: A100上1.2x加速,L40S上1.4x加速
- Qwen1.5-72B: A100上2.4x加速,L40S上3.5x加速
- 相比TensorRT-LLM,LLM服务的美元成本降低3倍
1.3 核心贡献
- W4A8KV4精度组合的提出: 首次系统性论证了W4A8KV4相比W8A8、W4A16、W4A4的优越性
- QoQ量化算法: 包括渐进式分组量化、SmoothAttention等创新技术
- QServe系统设计: 计算感知权重重排、寄存器级并行、KV4注意力优化
- 算法-系统协同设计: 在A100和L40S GPU上实现显著吞吐量提升
二、核心思想
2.1 问题背景
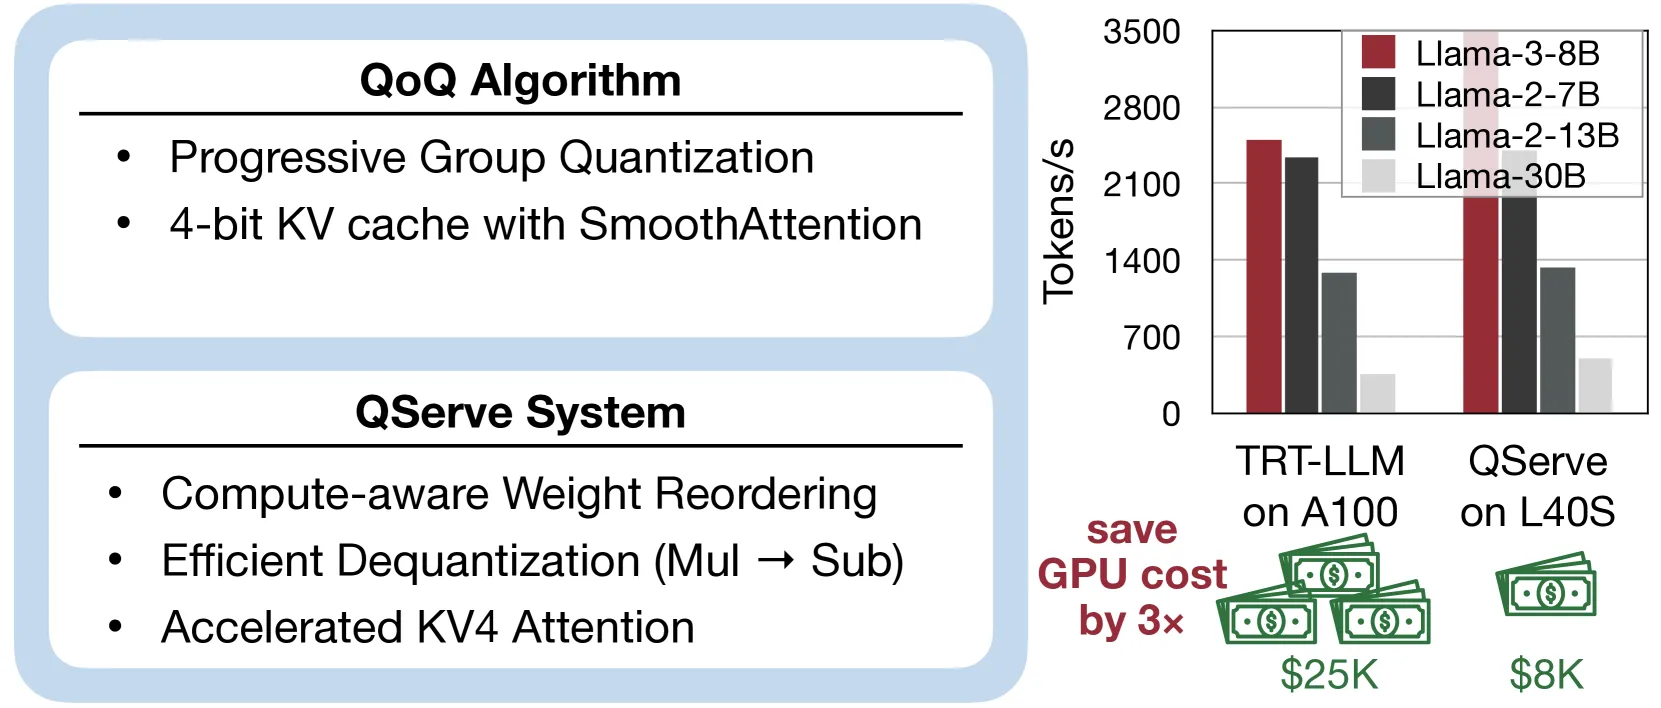
Figure 1: QServe在L40S上运行Llama模型时比TensorRT-LLM在A100上实现更高吞吐量,通过系统-算法协同设计将LLM服务的美元成本降低3倍。
当前LLM量化面临的核心矛盾:
| 量化方案 | 优势 | 劣势 |
|---|---|---|
| W8A8 | 精度损失小,INT8张量核心高效 | 内存占用较大 |
| W4A16 | 内存占用小,边缘设备友好 | 大批次时计算受限 |
| W4A4 | 理论吞吐量最高 | 精度损失大,反量化开销严重 |
2.2 关键发现
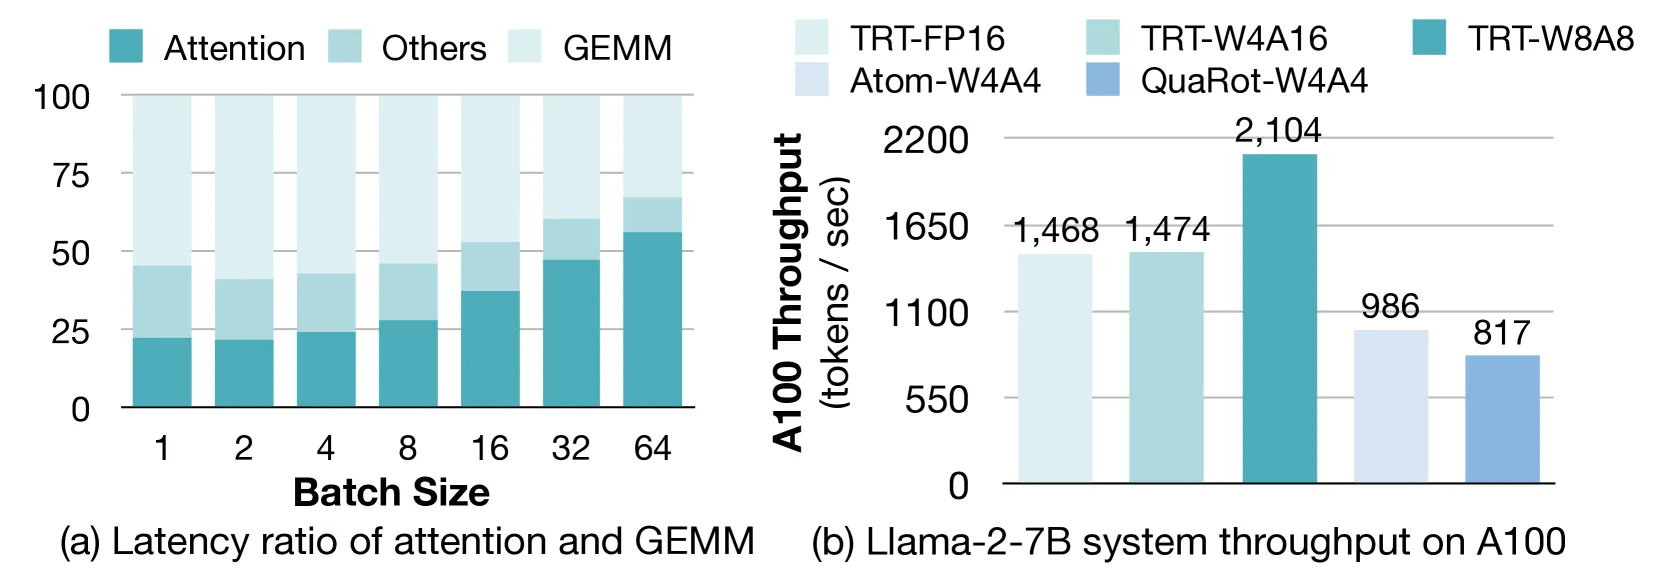
Figure 2: 左图:注意力和GEMM对端到端LLM延迟都至关重要。右图:尽管理论峰值性能高出2倍,W4A4系统在效率上仍显著落后于TRT-LLM-W8A8。
论文发现现有INT4量化方法存在20-90%的反量化开销,主要原因:
- CUDA核心瓶颈: 在A100上,一个CUDA核心操作等价于50个INT4张量核心操作
- 主循环开销: W4A4 GEMM的主循环中需要FP32 CUDA核心进行部分和反量化
- 寄存器压力: W4A4需要同时维护INT32和FP32两套寄存器
2.3 W4A8KV4的优越性
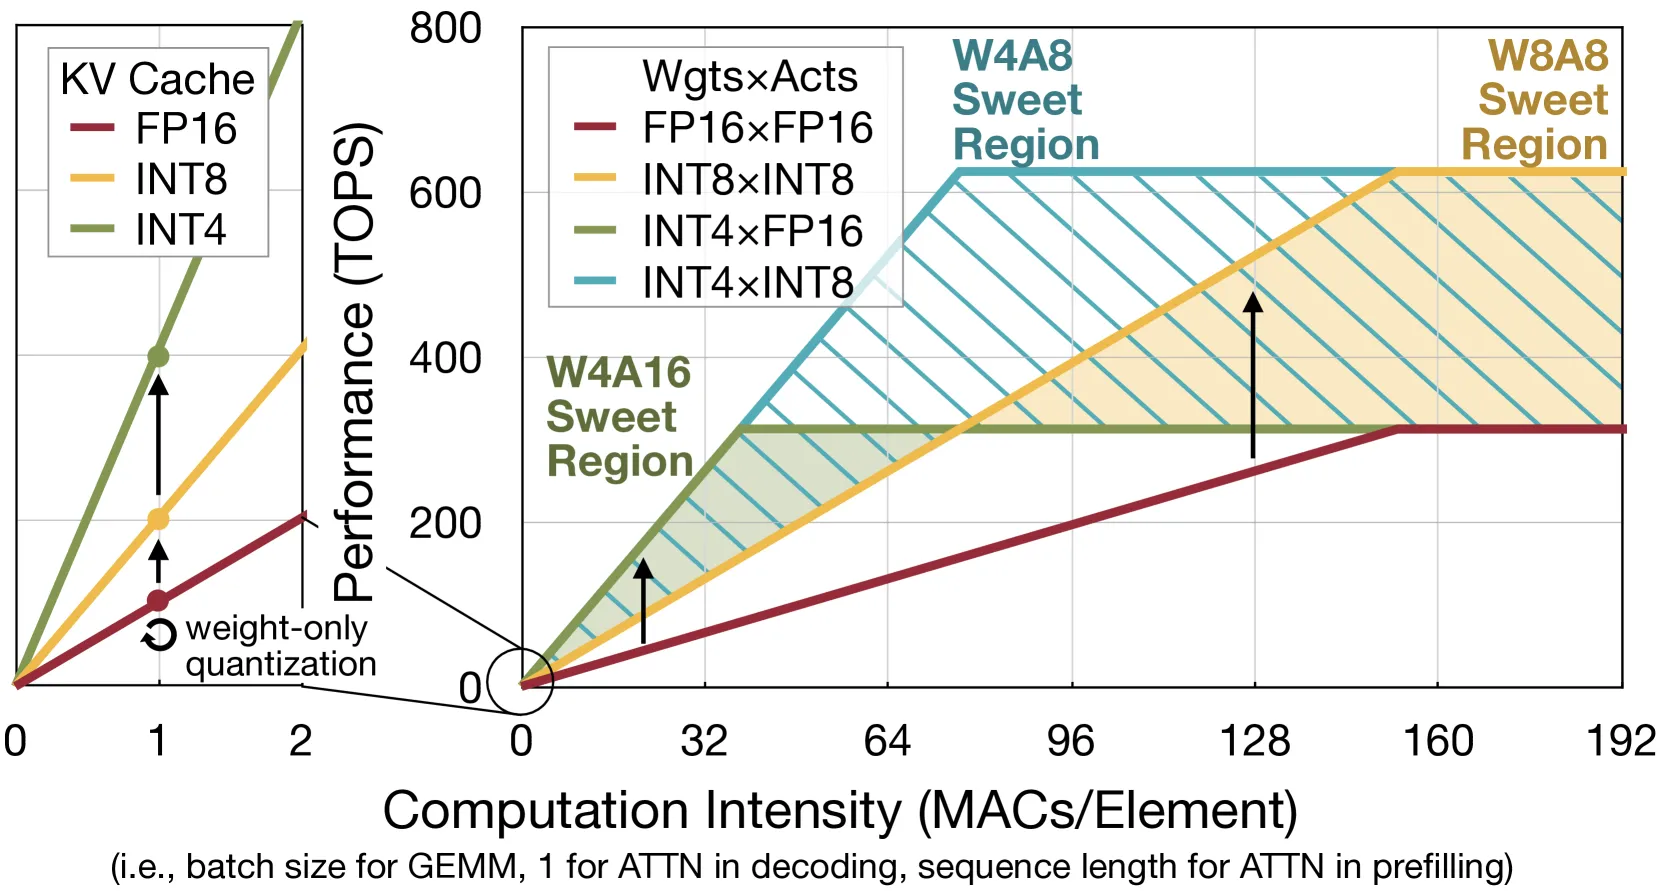
Figure 3: A100 Roofline分析:对于GEMM层,W4A8 roofline在不同批次大小下均优于W4A16和W8A8;对于注意力层,4-bit量化提升理论峰值性能。
通过Roofline分析,W4A8KV4在不同批次大小下均表现优异:
                    GEMM层                    注意力层
小批次(m<78):  W4A8 > W4A16 > W8A8        KV4 > KV8 (2x带宽优势)
大批次(m>78): W8A8 > W4A8 > W4A16 KV4 > KV8 (2x带宽优势)关键洞察: W4A8结合了W4A16的内存优势和W8A8的计算优势,同时KV4为注意力层提供2倍带宽增益。
三、技术架构
3.1 系统整体架构
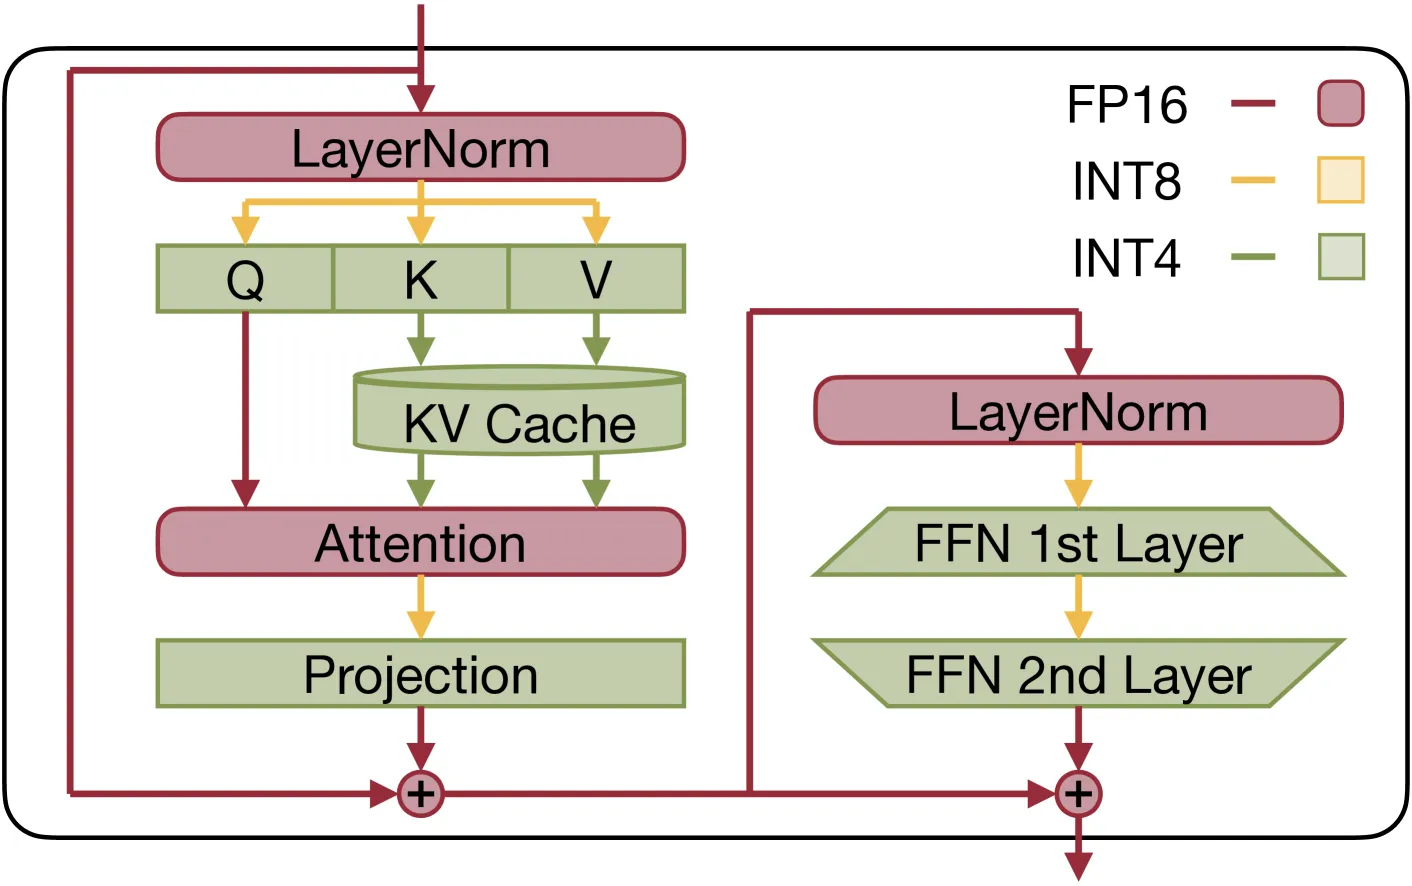
Figure 11: QServe的FP16输入、FP16输出LLM块的精度映射。所有GEMM算子接受W4A8输入并产生FP16输出。激活量化在归一化和激活层中发生。
┌─────────────────────────────────────────────────────────────┐
│                    QServe 系统架构                            │
├─────────────────────────────────────────────────────────────┤
│  输入: FP16激活                                              │
│       ↓                                                      │
│  ┌─────────────────────────────────────────────────────┐    │
│  │  QoQ 量化层                                          │    │
│  │  ├── 渐进式分组量化 (权重)                             │    │
│  │  ├── SmoothAttention (KV缓存)                        │    │
│  │  └── 激活量化 (融合到LayerNorm)                       │    │
│  └─────────────────────────────────────────────────────┘    │
│       ↓                                                      │
│  ┌─────────────────────────────────────────────────────┐    │
│  │  W4A8 GEMM (INT8张量核心)                            │    │
│  │  ├── 计算感知权重重排                                  │    │
│  │  ├── 寄存器级并行反量化                                │    │
│  │  └── 减法后乘法计算顺序                                │    │
│  └─────────────────────────────────────────────────────┘    │
│       ↓                                                      │
│  ┌─────────────────────────────────────────────────────┐    │
│  │  KV4 注意力 (FP16 CUDA核心)                          │    │
│  │  ├── FP16计算替代FP32                                 │    │
│  │  ├── 位操作优化                                       │    │
│  │  └── 异步预取                                         │    │
│  └─────────────────────────────────────────────────────┘    │
│       ↓                                                      │
│  输出: FP16激活                                              │
└─────────────────────────────────────────────────────────────┘
3.2 运行时精度映射
| 组件 | 输入精度 | 计算精度 | 输出精度 |
|---|---|---|---|
| GEMM层 | W4A8 | INT8张量核心 | FP16 |
| 注意力层 | FP16 + KV4 | FP16 CUDA核心 | FP16 |
| 激活量化 | FP16 | - | INT8 |
| KV缓存 | FP16 | - | INT4 |
3.3 Roofline分析
基于A100 GPU的Roofline分析:
| 配置 | 峰值性能 | 内存带宽 | 临界批次大小 |
|---|---|---|---|
| FP16张量核心 | 312 TFLOPS | 2 TB/s | - |
| INT8张量核心 | 624 TOPS | 2 TB/s | 78 |
| INT4张量核心 | 1248 TOPS | 2 TB/s | 39 |
结论: W4A8在所有批次大小下都具有最优的计算强度,因为它可以在INT8张量核心上执行,同时保持4-bit权重的内存优势。
四、核心创新
4.1 QoQ量化算法
4.1.1 渐进式分组量化 (Progressive Group Quantization)
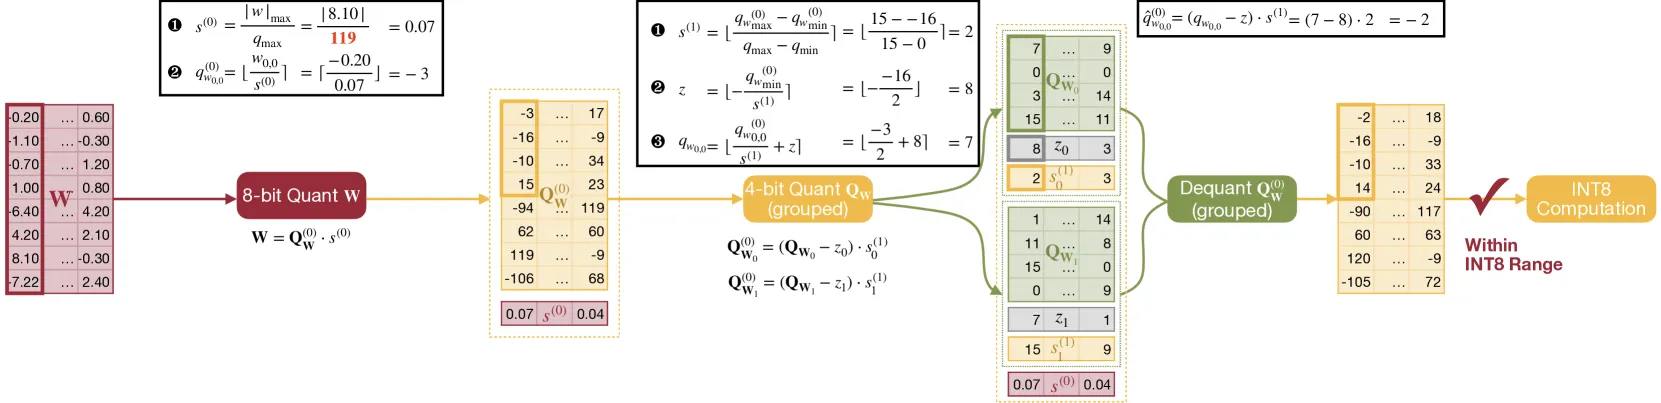
Figure 6: 渐进式分组量化首先采用每通道INT8量化(保护范围[-119, 119]),然后进行每组INT4量化,使反量化的中间值保持在INT8范围内用于计算。
核心思想: 两级量化,确保中间结果保持在INT8范围内
第一级: 通道级INT8量化
Ŵ = Q_W^(0)_s8 · s^(0)_fp16- 对称INT8量化,保护范围[-119, 119]
- 通道级FP16缩放因子
第二级: 分组级INT4量化
Q_W^(0)_s8 = (Q_W_u4 - z_u4) · s^(1)_u8- 非对称INT4量化
- 分组级UINT8缩放因子和零点
保护范围机制:
- 问题: 直接两级量化可能导致反量化溢出
- 解决: 将INT8量化范围从[-127, 127]收缩到[-119, 119]
- 数学保证: su8 ≤ 17,因此 q̂_s8 ≤ q_s8 + 8.5 ≤ 127
与现有方法的对比:
| 方法 | 量化流程 | 计算精度 | 问题 |
|---|---|---|---|
| VSQuant/DoubleQuant | 先INT4分组量化,再INT8通道量化 | FP16 | 中间值超出INT8范围 |
| DGQ | 类似VSQuant,但限制缩放因子 | INT8 | 分离式反量化,速度慢 |
| QoQ (本文) | 先INT8通道量化,再INT4分组量化 | INT8 | 保护范围确保无溢出 |
4.1.2 SmoothAttention
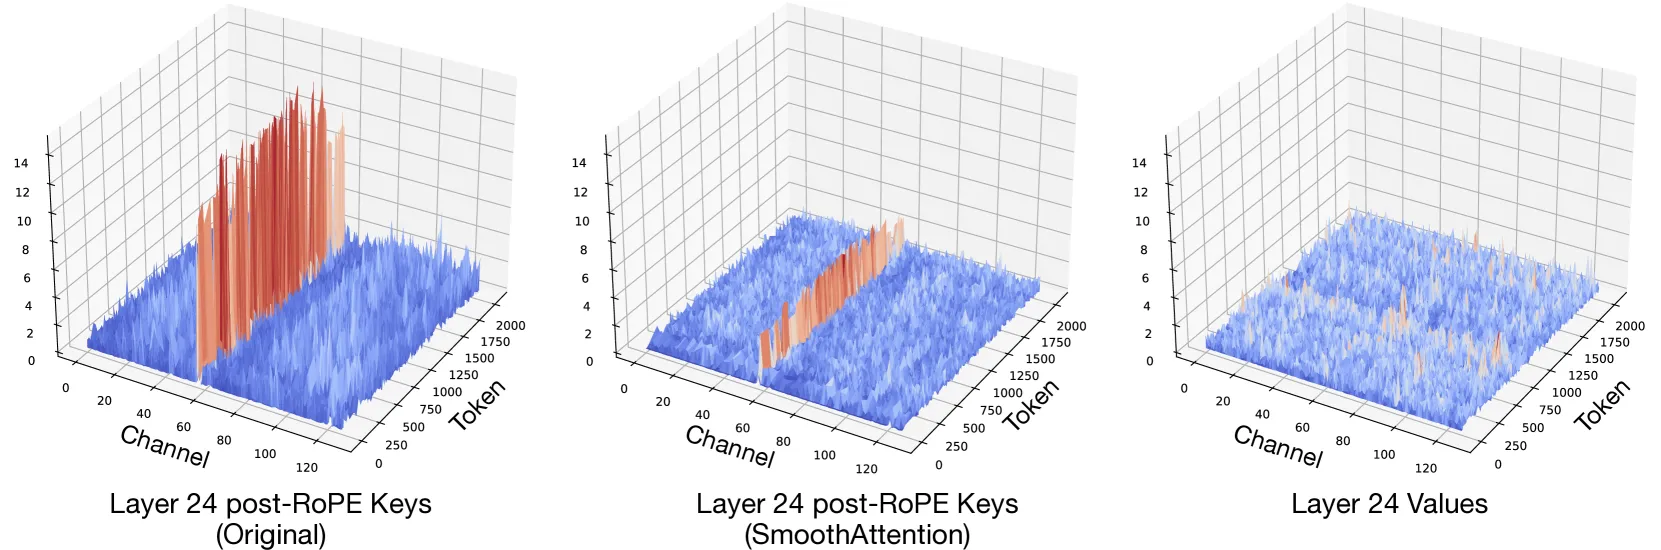
Figure 7: SmoothAttention有效平滑了Key中的异常值。Value不受异常值影响。
问题: Key缓存存在固定通道的异常值(约10x大于正常值),对KV4量化造成严重精度损失
解决方案: 通过缩放因子λ平滑Key缓存
Z = (QΛ) · (KΛ^{-1})^T
λ_i = max(|K_i|)^α, α = 0.5与RoPE的兼容性:
- RoPE将通道i与通道i+D/2配对
- 约束: λ_i = λ_{i+D/2}
- 实现: λ_i = max(max(|K_i|), max(|K_{i+D/2}|))^α
融合优化: 将Λ融合到前一层权重中
- W_Q = ΛW_Q
- W_K = Λ^{-1}W_K
4.1.3 通用量化优化
| 技术 | 描述 | 效果 |
|---|---|---|
| 块输入模块旋转 | 使用Hadamard矩阵旋转激活,抑制异常值 | 0.18困惑度改善 |
| 块输出模块平滑 | 平滑中间激活,迁移量化难度到权重 | 0.05困惑度改善 |
| 激活感知通道重排 | 按激活幅度重排权重通道,相似幅度在同一量化组 | 0.03困惑度改善 |
| 权重裁剪 | 最小化块输出MSE优化裁剪比例 | 0.16困惑度改善 |
4.2 QServe系统优化
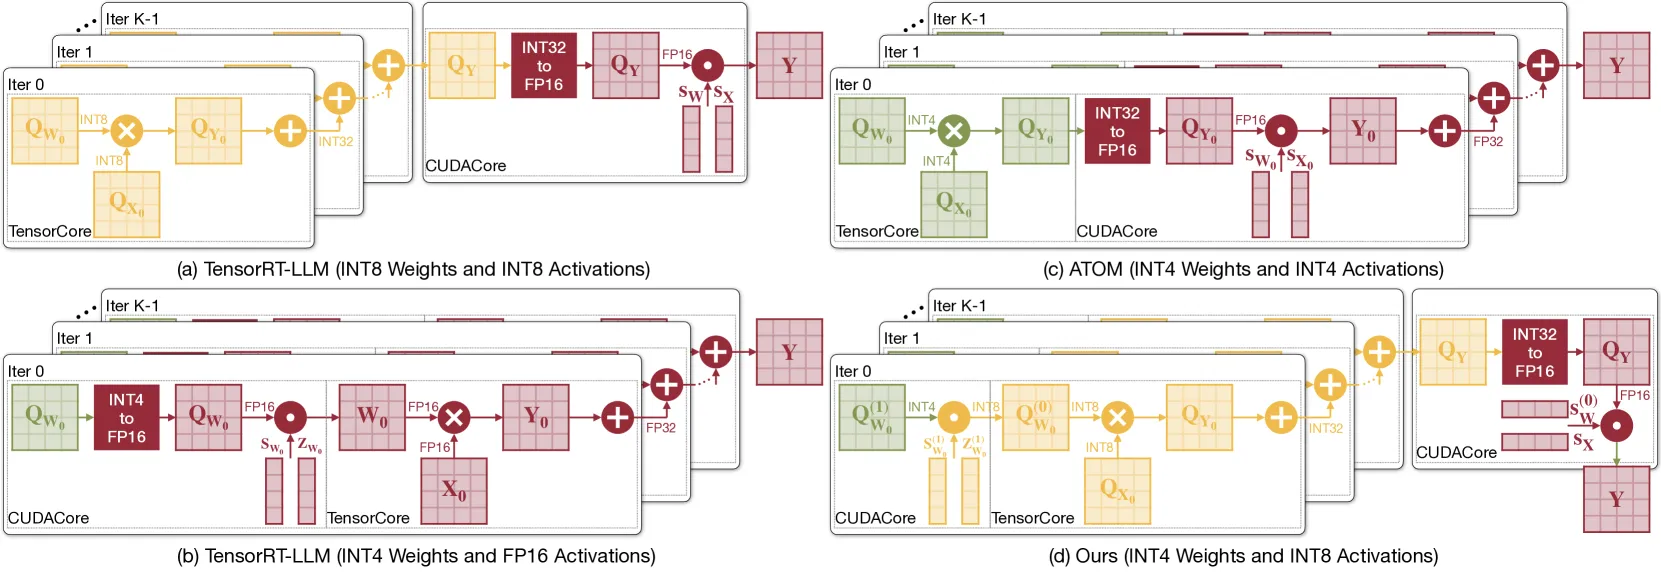
Figure 5: GPU上的量化GEMM:W8A8很快,因为其主循环仅包含张量核心操作,所有反量化操作都在epilogue中。Atom-W4A4和TensorRT-LLM-W4A16在主循环中存在显著的部分和或权重反量化开销。得益于两级渐进式量化算法,QServe-W4A8通过引入寄存器级并行性减少主循环反量化开销。
4.2.1 计算感知权重重排
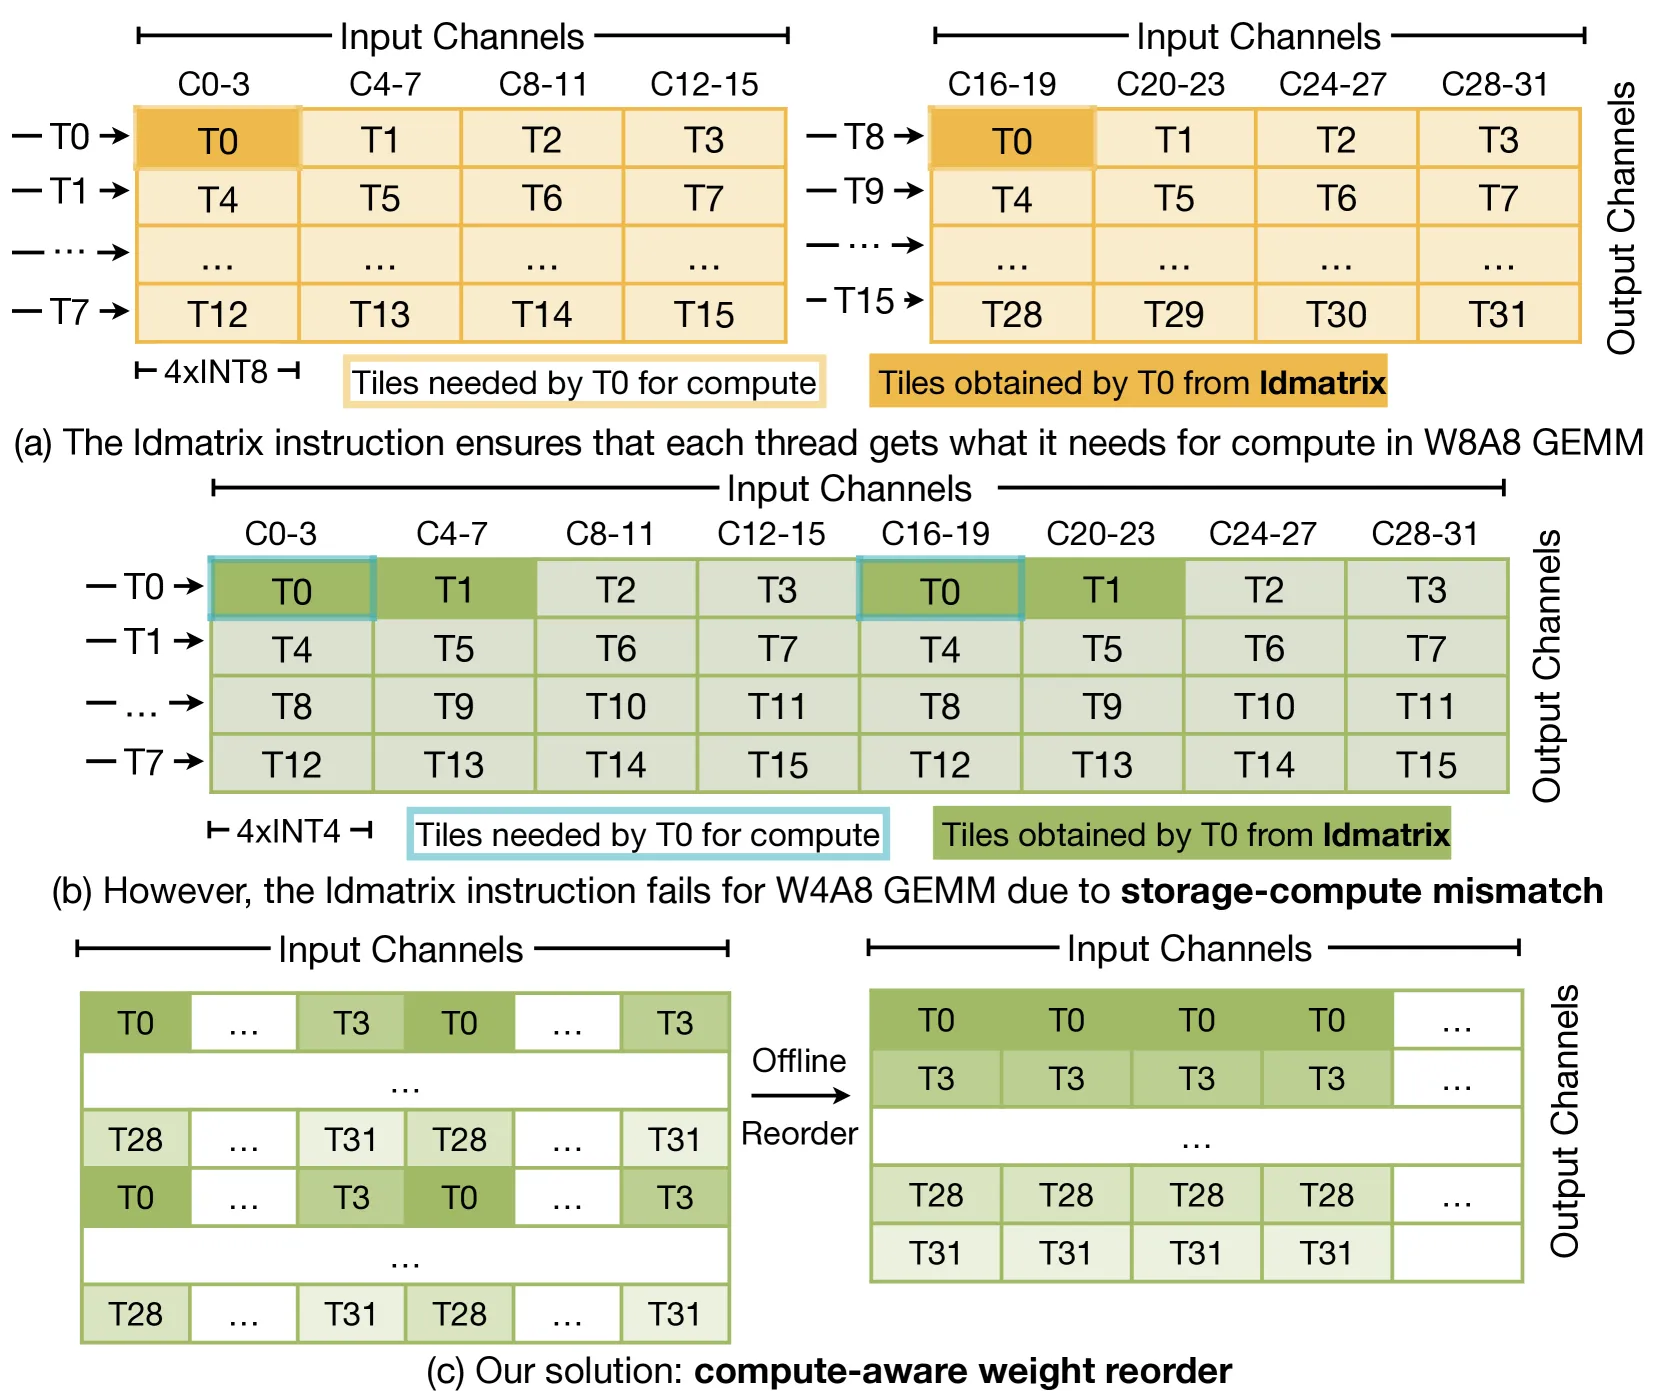
Figure 12: QServe应用计算感知权重重排以最小化W4A8 GEMM主循环中的指针算术。
问题: W4A8 GEMM中,权重加载需要复杂的地址计算
解决方案: 按计算顺序重排权重存储
原始顺序: w0, w1, w2, ..., w31
重排后: w0, w16, w1, w17, w2, w18, ...优势:
- 减少指针算术开销到ldmatrix指令同等水平
- 保证128位/线程高带宽内存事务
- 对零点和缩放因子同样适用
4.2.2 快速反量化: 减法后乘法
传统方法 (减法前乘法):
O = (Q_X · S_X) · ((Q_W - Z_W) · S_W)- 需要在主循环中执行整数减法
- 额外开销不可忽略
本文方法 (减法后乘法):
O = (Q_X · Q_W) ⊙ (s_W × s_X) - X · (z_W ⊙ s_W)- 零点减法移到epilogue
- 第一项类似W8A8 GEMM
- 第二项可融合到epilogue
预计算: t_X = X·1_k (每个token的输入通道求和)可融合到前一个内存受限kernel
4.2.3 寄存器级并行性
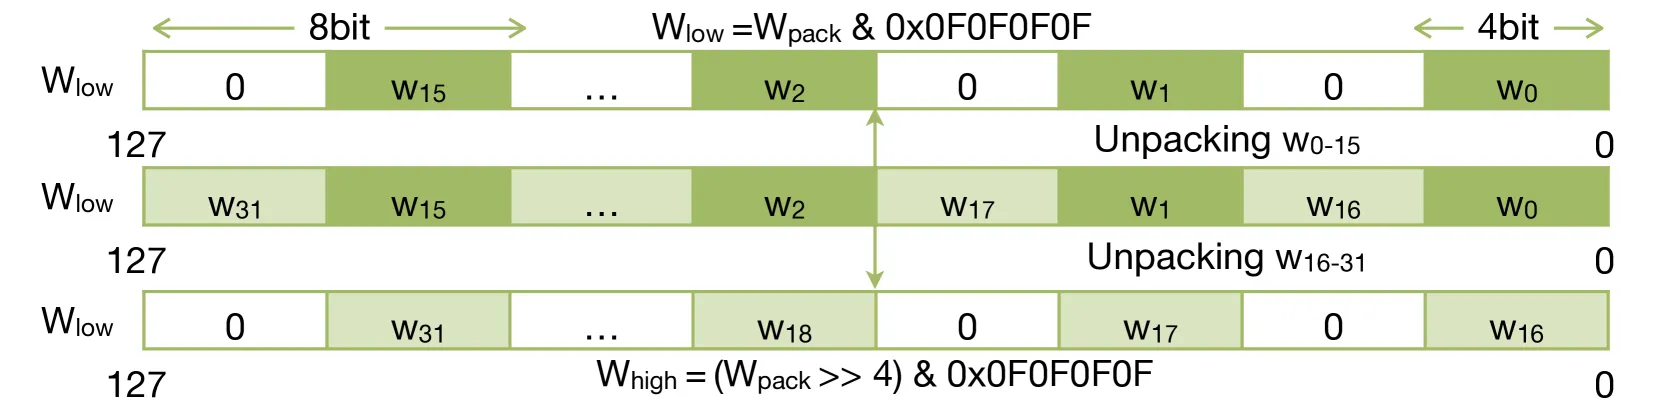
Figure 13: QServe利用寄存器级并行性显著减少UINT4到UINT8权重解包所需的逻辑操作数量。
INT4到INT8解包优化:
- 重排32个UINT4权重: w0, w16, w1, w17, …
- 使用3个逻辑操作完成解包 (vs 传统方法的多次操作)
分组量化中的并行性:
- 使用vadd4指令: 一条INT32 ALU操作执行4个INT8加法
- 通过填充24个零到MSB模拟4路INT8乘法
- 渐进式量化确保乘法结果不溢出INT8范围
4.2.4 KV4注意力优化
问题: 直接KV4实现
- L40S: 1.7x加速 (vs KV8)
- A100: 1.2x减速 (CUDA核心成为瓶颈)
优化措施:
| 优化 | 效果 |
|---|---|
| FP32→FP16计算 | 计算天花板翻倍 |
| 位操作技巧 | 反量化操作从5 ops/element降到2 ops/element |
| 控制流简化 | 减少0.05ms延迟 |
| 异步预取 | 减少0.03ms延迟 |
最终结果: A100上KV4注意力比KV8快1.5x
五、实验结果
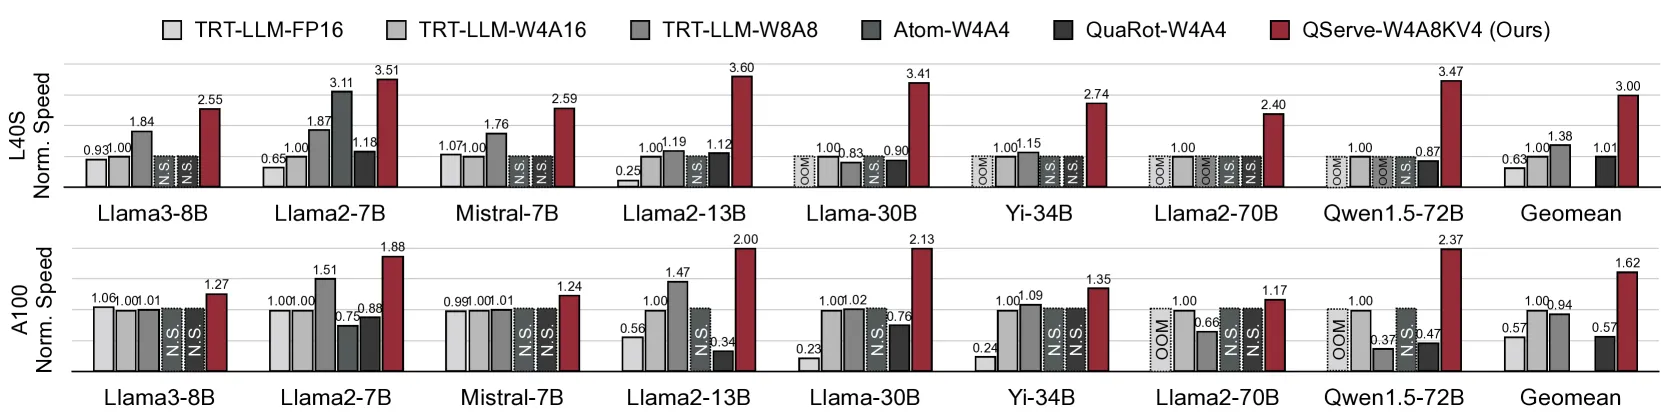
Figure 15: QServe在批量生成任务中显著优于现有LLM服务框架,覆盖7B到72B模型。在L40S GPU上平均加速2.36倍(vs TensorRT-LLM v0.9.0),在A100 GPU上加速1.68倍。
5.1 精度评估
WikiText2困惑度 (序列长度2048)
| 精度 | 方法 | Llama-3 8B | Llama-2 7B | Llama-2 13B | Llama-2 70B | Mistral 7B |
|---|---|---|---|---|---|---|
| FP16 | - | 6.14 | 5.47 | 4.88 | 3.32 | 5.68 |
| W8A8 | SmoothQuant | 6.28 | 5.54 | 4.95 | 3.36 | 5.73 |
| W4A16 g128 | AWQ | 6.54 | 5.60 | 4.97 | 3.41 | 5.78 |
| W4A4 | QuaRot | 8.20 | 6.10 | 5.40 | 3.79 | 6.26 |
| W4A4 g128 | Atom† | 7.57 | 6.03 | 5.27 | 3.69 | 6.16 |
| W4A8KV4 | QoQ | 6.89 | 5.75 | 5.12 | 3.52 | 5.93 |
| W4A8KV4 g128 | QoQ | 6.76 | 5.70 | 5.08 | 3.47 | 5.89 |
关键发现:
- QoQ W4A8KV4相比W4A4方法有显著优势(最多0.49困惑度改善)
- QoQ W4A8KV4 g128接近W4A16 AWQ的精度水平
- 相比FP16,QoQ仅增加0.16-0.23困惑度
零样本准确率 (Llama-2)
| 方法 | PIQA | ARC-e | ARC-c | HellaSwag | WinoGrande | 平均 |
|---|---|---|---|---|---|---|
| FP16 | 79.05 | 74.58 | 46.25 | 76.05 | 68.98 | 68.98 |
| W4A4 QuaRot | 76.77 | 69.87 | 40.87 | 72.16 | 63.77 | 64.69 |
| W4A4 g128 Atom | 75.14 | 52.99 | 38.40 | 69.37 | 62.75 | 59.73 |
| W4A8KV4 QoQ | 77.64 | 72.81 | 43.60 | 74.00 | 68.03 | 67.22 |
| W4A8KV4 g128 QoQ | 78.07 | 73.32 | 44.80 | 74.98 | 68.59 | 67.95 |
关键发现:
- QoQ相比QuaRot在WinoGrande上准确率高4.82%
- QoQ相比FP16仅损失1.03%准确率(7B模型)
5.2 吞吐量评估
L40S GPU吞吐量 (tokens/second)
| 系统 | Llama-3 8B | Llama-2 7B | Mistral 7B | Llama-2 13B | Llama-30B | Yi-34B | Llama-2 70B | Qwen1.5 72B |
|---|---|---|---|---|---|---|---|---|
| TRT-LLM-FP16 | 1326 | 444 | 1566 | 92 | OOM | OOM | OOM | OOM |
| TRT-LLM-W4A16 | 1431 | 681 | 1457 | 368 | 148 | 313 | 119 | 17 |
| TRT-LLM-W8A8 | 2634 | 1271 | 2569 | 440 | 123 | 364 | OOM | OOM |
| QServe | 3656 | 2394 | 3774 | 1327 | 504 | 869 | 286 | 59 |
| 加速比 | 1.39x | 1.88x | 1.47x | 3.02x | 3.41x | 2.39x | 2.40x | 3.47x |
A100 GPU吞吐量 (tokens/second)
| 系统 | Llama-3 8B | Llama-2 7B | Mistral 7B | Llama-2 13B | Llama-30B | Yi-34B | Llama-2 70B | Qwen1.5 72B |
|---|---|---|---|---|---|---|---|---|
| TRT-LLM-FP16 | 2503 | 1549 | 2371 | 488 | 80 | 145 | OOM | OOM |
| TRT-LLM-W4A16 | 2370 | 1549 | 2403 | 871 | 352 | 569 | 358 | 143 |
| TRT-LLM-W8A8 | 2396 | 2334 | 2427 | 1277 | 361 | 649 | 234 | 53 |
| QServe | 3005 | 2908 | 2970 | 1741 | 749 | 797 | 419 | 340 |
| 加速比 | 1.20x | 1.25x | 1.22x | 1.36x | 2.07x | 1.23x | 1.17x | 2.38x |
关键发现:
- L40S上QServe平均加速2.36x (vs TRT-LLM最佳配置)
- A100上QServe平均加速1.68x
- QServe在L40S上可达到比TRT-LLM在A100上更高的吞吐量 (5/7个模型)
- 实现LLM服务成本降低3倍
5.3 消融实验
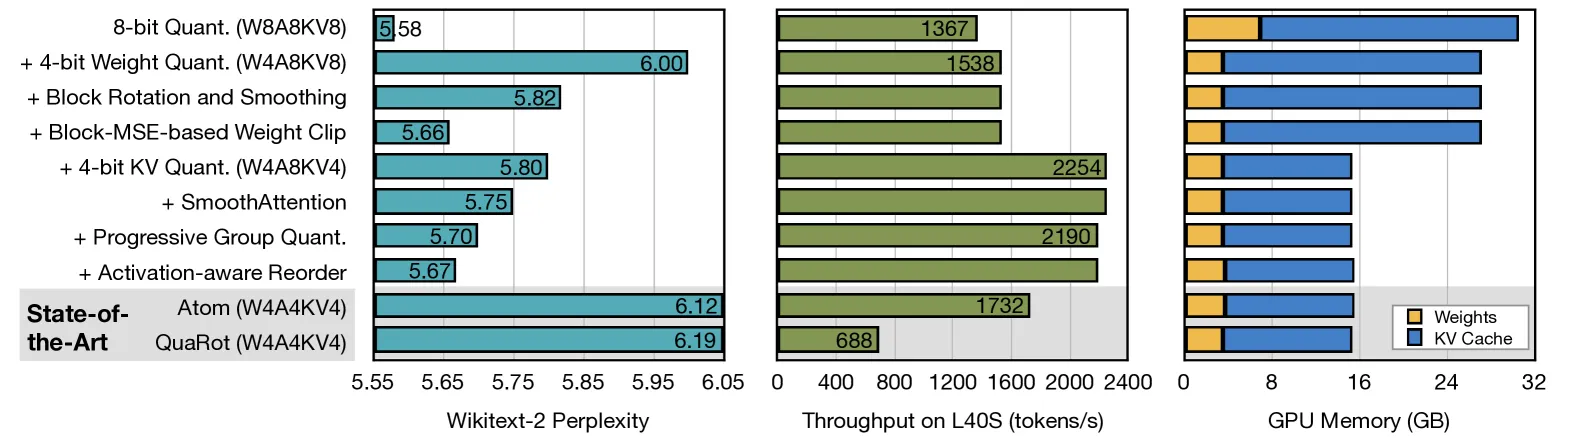
Figure 16: QoQ量化技术的消融研究及其对QServe服务吞吐量和GPU内存消耗的影响。模型为Llama-2-7B。
量化技术消融 (Llama-2-7B)
| 配置 | 困惑度 | 吞吐量提升 | 内存节省 |
|---|---|---|---|
| W8A8 (基线) | 5.54 | 1.00x | 0 GB |
| + 权重4-bit | 6.51 | 1.12x | 3.5 GB |
| + 旋转 | 6.33 | 1.12x | 3.5 GB |
| + 权重裁剪 | 6.17 | 1.12x | 3.5 GB |
| + KV4 | 6.31 | 1.47x | 7.0 GB |
| + SmoothAttention | 6.26 | 1.47x | 7.0 GB |
| + 渐进式分组量化 | 6.24 | 1.47x | 7.0 GB |
| + 通道重排 | 6.21 | 1.47x | 7.0 GB |
反量化开销对比
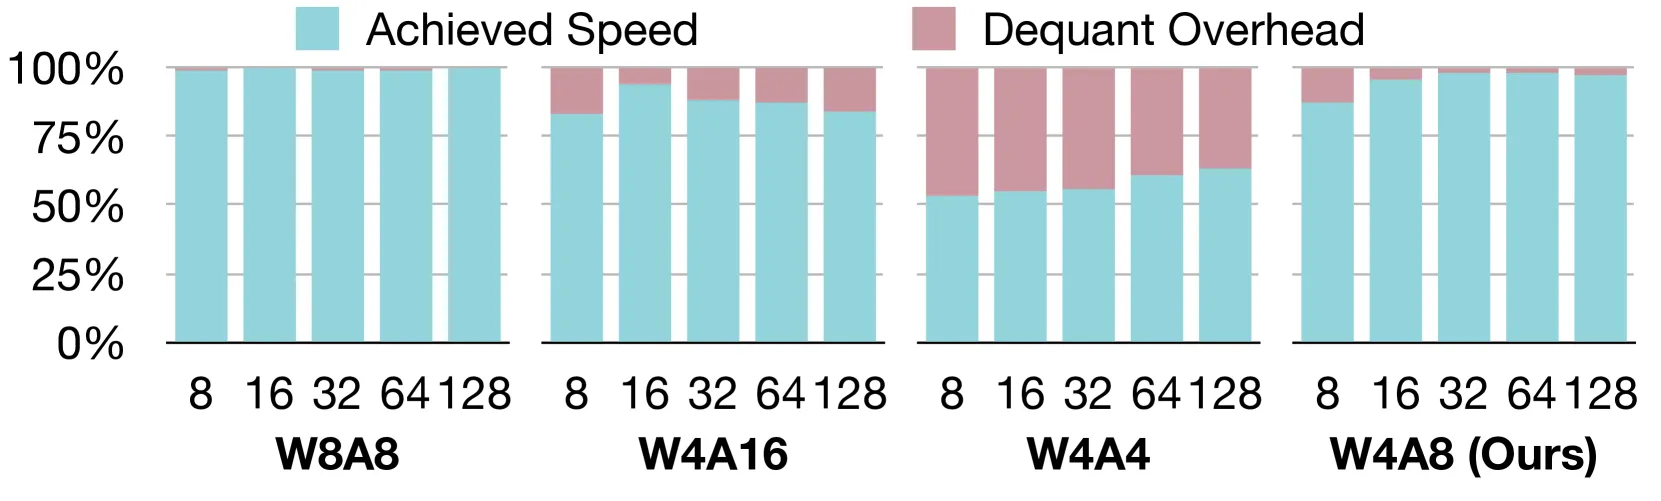
Figure 18: QServe中的反量化开销远小于Atom-W4A4(高达90%)。
| 方法 | 反量化开销 |
|---|---|
| TRT-LLM-W8A8 | ~0% |
| TRT-LLM-W4A16 | 15-20% |
| Atom-W4A4 | 20-90% |
| QServe-W4A8 | 10-15% |
六、相关工作
6.1 LLM量化方法
| 类别 | 代表方法 | 特点 |
|---|---|---|
| 权重量化 | GPTQ, AWQ, SqueezeLLM | 仅量化权重,适用于边缘设备 |
| 权重-激活量化 | SmoothQuant, OmniQuant | 同时量化权重和激活,加速计算 |
| 混合精度 | Atom | 重要权重保持FP16 |
| 旋转量化 | QuaRot | 使用旋转矩阵抑制异常值 |
6.2 LLM服务系统
| 系统 | 特点 |
|---|---|
| TensorRT-LLM | NVIDIA工业标准,支持FP16/W8A8/W4A16 |
| vLLM | PagedAttention,高效KV缓存管理 |
| SGLang | RadixAttention,高级编程原语 |
| LMDeploy | 持久批处理,块状KV缓存 |
| LightLLM | Token级KV缓存控制 |
| MLC-LLM | 编译器加速,跨设备部署 |
6.3 LLM加速器
| 加速器 | 方法 |
|---|---|
| A3, ELSA | 注意力剪枝 |
| SpAtten | 注意力稀疏化 |
| GOBO, EdgeBERT | 量化加速 |
| DOTA | 弱注意力检测与省略 |
| STA | N:M稀疏性 |
| DFX | 模型并行优化 |
七、总结
7.1 核心贡献总结
- W4A8KV4精度组合: 首次系统论证其在roofline分析下的优越性
- QoQ算法创新:
- 渐进式分组量化: 两级量化确保INT8计算
- SmoothAttention: 解决KV4的精度问题
- 保护范围机制: 数学保证无溢出
- QServe系统优化:
- 计算感知权重重排: 减少地址计算开销
- 减法后乘法: 将零点减法移到epilogue
- 寄存器级并行: 4路INT4解包优化
- KV4注意力优化: FP16计算+位操作技巧
7.2 性能提升总结
| 指标 | L40S | A100 |
|---|---|---|
| 平均吞吐量提升 | 2.36x | 1.68x |
| 最大吞吐量提升 | 3.47x | 2.38x |
| 成本降低 | 3x | 2x |
7.3 局限性与未来方向
局限性:
- 仅支持NVIDIA GPU (Ampere/Hopper架构)
- 需要CUDA和PTX汇编优化
- 对GQA模型支持有限 (QuaRot不支持)
未来方向:
- 扩展到更先进GPU架构 (Hopper, Blackwell)
- 支持更多模型架构 (MoE, 长上下文)
- 探索更低位宽 (W4A4, W2A8)
- 与分布式推理系统集成
7.4 关键启示
- 算法-系统协同设计的重要性: 仅优化算法或系统都不够,需要协同设计
- CUDA核心是瓶颈: 在现代GPU上,CUDA核心操作比张量核心操作昂贵50倍
- 精度选择需要roofline指导: 不同批次大小下最优精度不同
- KV缓存量化潜力巨大: 注意力占30-50%运行时,KV4可提供2x加速
八、参考资源
8.1 论文链接
- arXiv: https://arxiv.org/abs/2405.04532
- PDF: https://arxiv.org/pdf/2405.04532
- HTML: https://arxiv.org/html/2405.04532v3
8.2 代码仓库
- GitHub: https://github.com/mit-han-lab/qserve
- HuggingFace: https://huggingface.co/mit-han-lab
8.3 关键图表
| 图表 | 描述 | 文件 |
|---|---|---|
| Figure 1 | QServe性能对比 (L40S vs A100) | |
| Figure 2 | 注意力与GEMM运行时分析 | |
| Figure 3 | A100 Roofline分析 | |
| Figure 4 | GPU GEMM示意 | 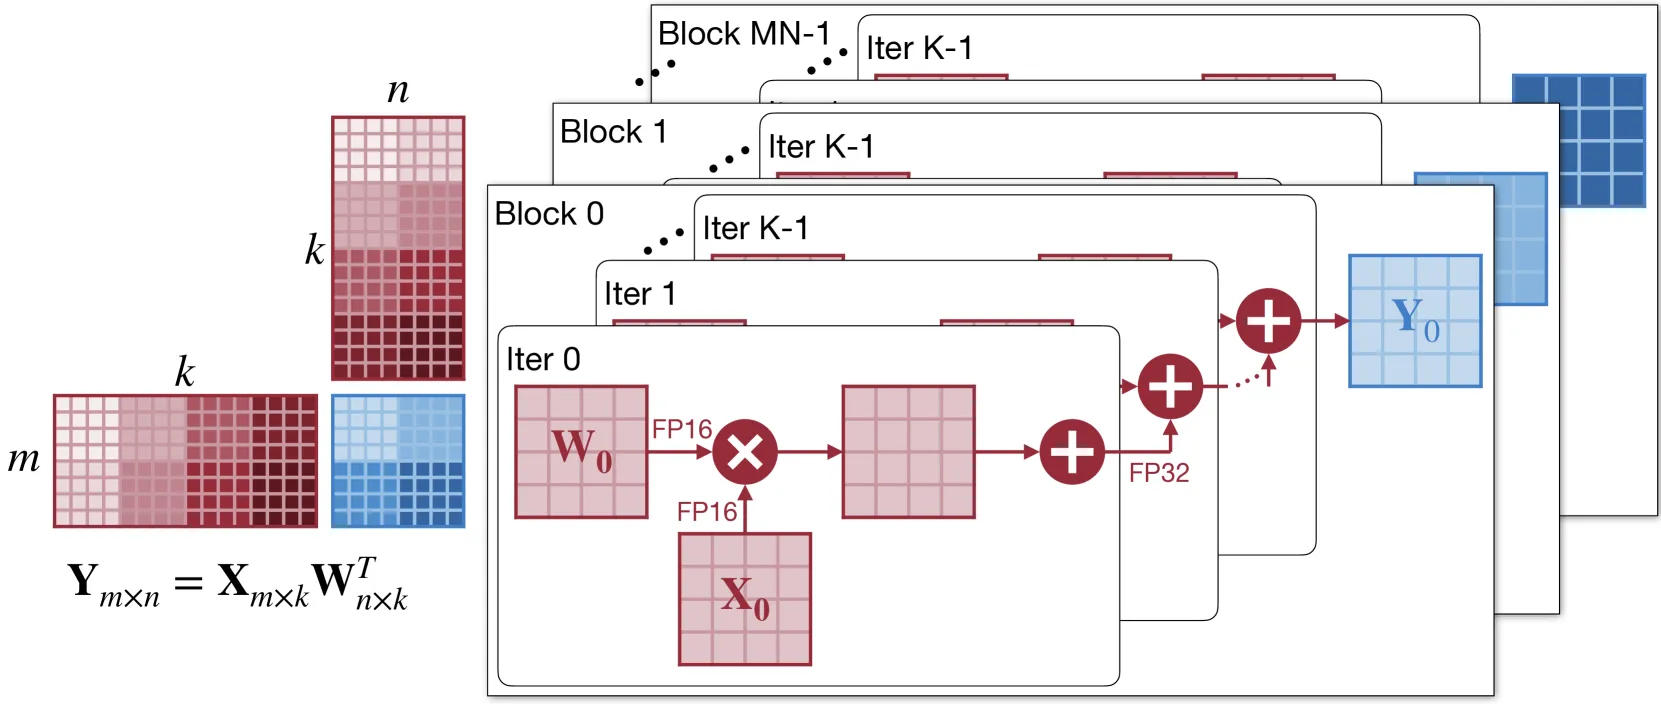 |
| Figure 5 | 量化GEMM对比 | |
| Figure 6 | 渐进式分组量化 | |
| Figure 7 | SmoothAttention效果 | |
| Figure 8 | 块输入旋转 | 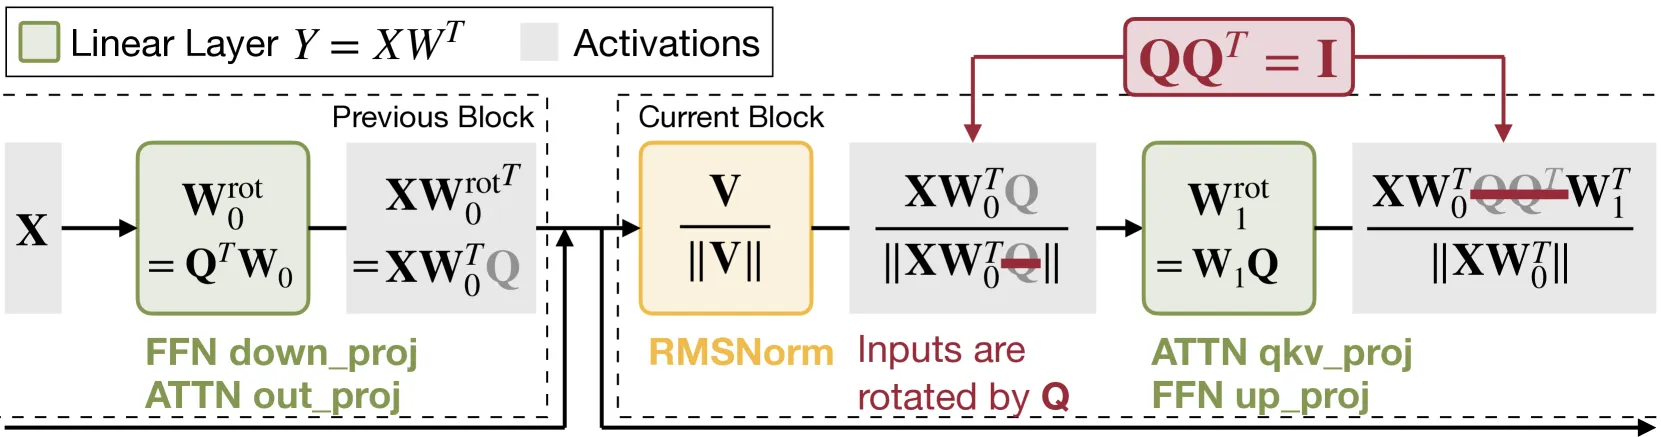 |
| Figure 9 | 块中间激活平滑 | 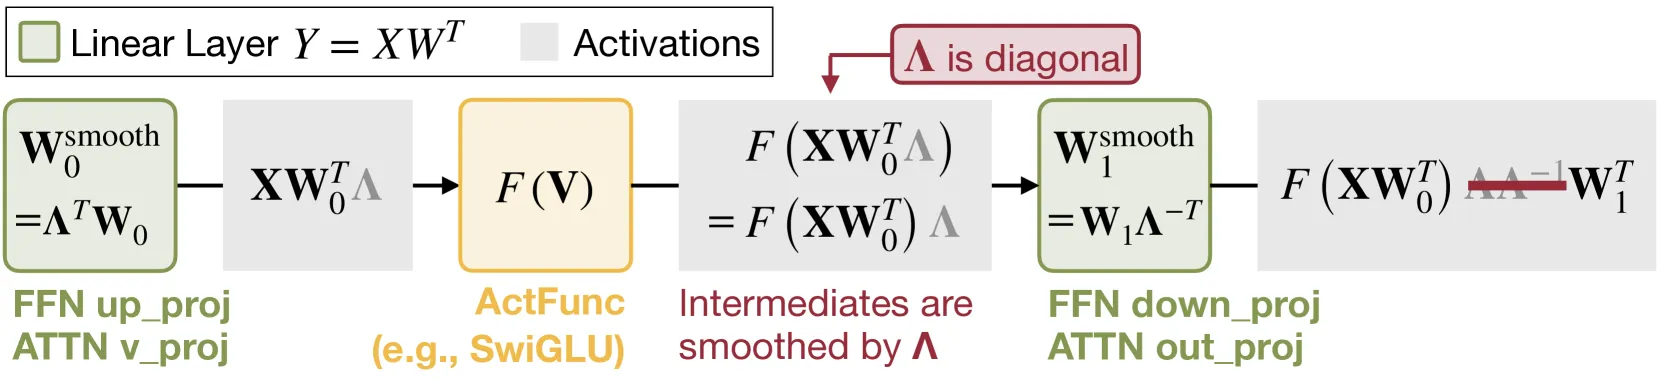 |
| Figure 10 | 通道重排 | 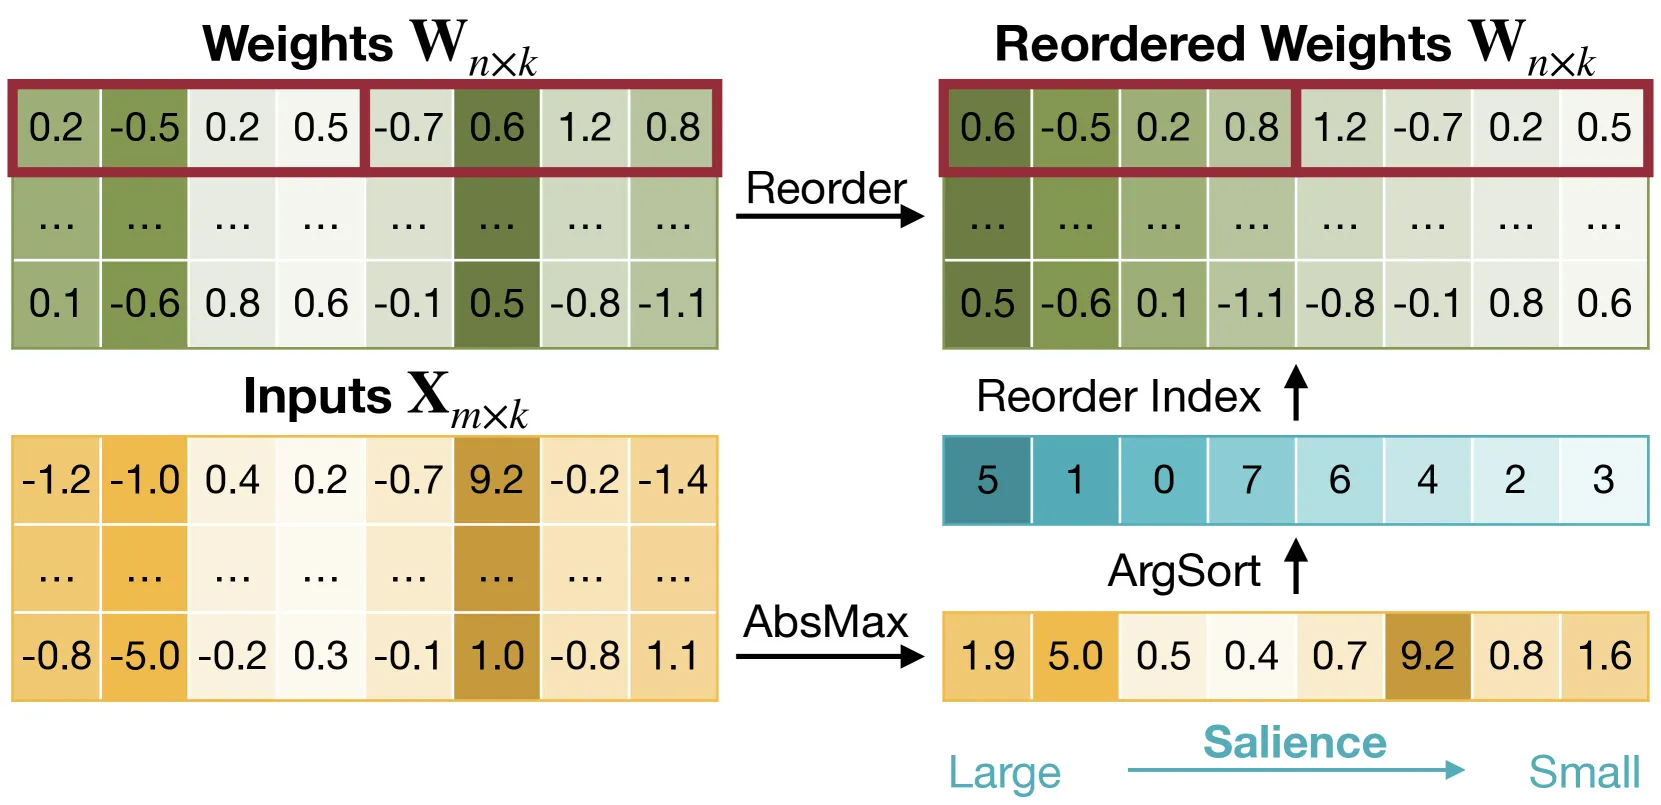 |
| Figure 11 | 精度映射架构 | |
| Figure 12 | 计算感知权重重排 | |
| Figure 13 | 寄存器级并行性 | |
| Figure 14 | 减法后乘法计算顺序 | 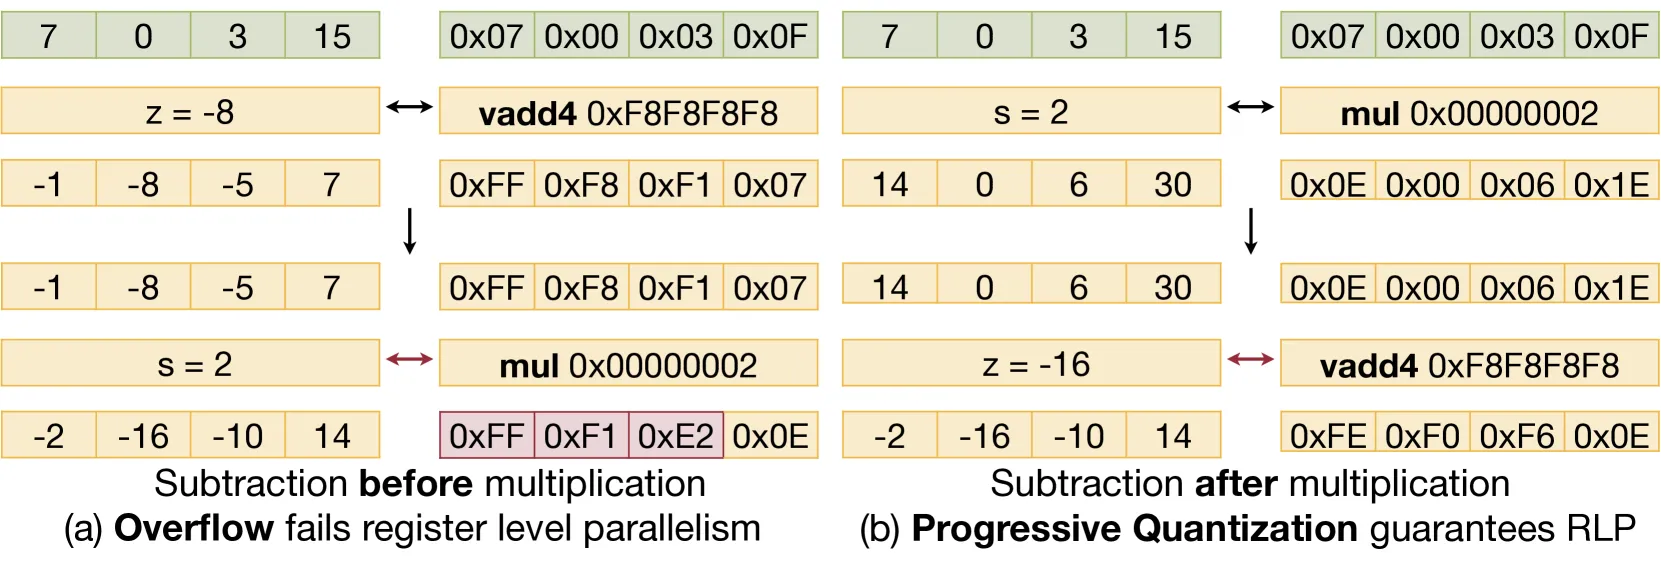 |
| Figure 15 | 主要吞吐量对比 | |
| Figure 16 | 量化技术消融 | |
| Figure 17 | 同批次吞吐量对比 | 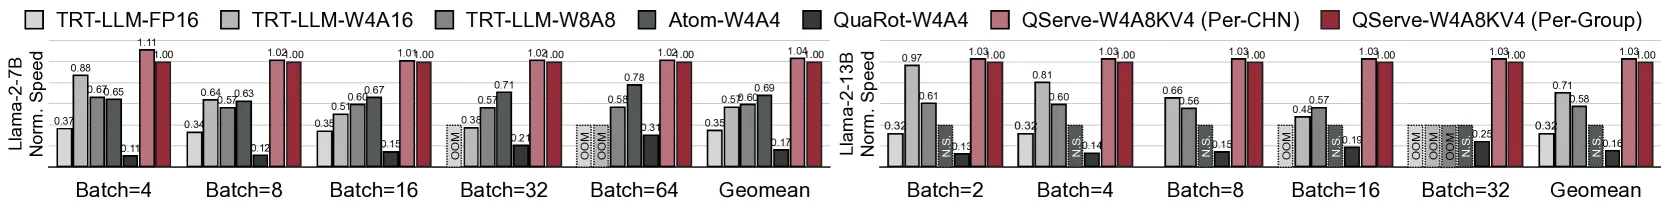 |
| Figure 18 | 反量化开销对比 | |
8.4 相关论文
| 论文 | 关系 |
|---|---|
| SmoothQuant [38] | 激活量化基础 |
| AWQ [23] | 权重量化参考 |
| GPTQ [12] | 后训练量化 |
| QuaRot [2] | W4A4基线 |
| Atom [44] | W4A4基线 |
| TensorRT-LLM [25] | 主要对比系统 |
| vLLM [22] | PagedAttention参考 |
8.5 引用格式
@article{lin2024qserve,
  title={QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving},
  author={Lin, Yujun and Tang, Haotian and Yang, Shang and Zhang, Zhekai and Xiao, Guangxuan and Gan, Chuang and Han, Song},
  journal={arXiv preprint arXiv:2405.04532},
  year={2024}
}
附录: 关键公式
A.1 量化公式
非对称量化:
Q_X = ⌈(X + z) / s⌋
s = (X_max - X_min) / (q_max - q_min)
z = ⌈q_min - X_min / s⌋对称量化:
Q_X = ⌈X / s⌋
s = max(|X|) / (2^{n-1} - 1)
A.2 渐进式量化
第一级 (通道级INT8):
Ŵ = Q_W^(0)_s8 · s^(0)_fp16第二级 (分组级INT4):
Q_W^(0)_s8 = (Q_W_u4 - z_u4) · s^(1)_u8A.3 SmoothAttention
缩放因子:
λ_i = λ_{i+D/2} = max(max(|K_i|), max(|K_{i+D/2}|))^α融合到权重:
W_Q = ΛW_Q
W_K = Λ^{-1}W_K
A.4 减法后乘法
GEMM分解:
O = (Q_X · Q_W) ⊙ (s_W × s_X) - X · (z_W ⊙ s_W)预计算:
t_X = X · 1_k (每个token的输入通道求和)文档生成时间: 2026-05-30 分析工具: Claude Code