Better & Faster Large Language Models via Multi-token Prediction
通过多 token 预测训练提升 LLM 性能和推理速度
Better & Faster Large Language Models via Multi-token Prediction
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Better & Faster Large Language Models via Multi-token Prediction |
| 作者 | Fabian Gloeckle, Badr Youbi Idrissi, Baptiste Rozière, David Lopez-Paz, Gabriel Synnaeve |
| 机构 | Meta AI (FAIR) |
| 论文 | arXiv:2404.19737 |
| 发布 | 2024年4月30日 |
| 主题 | cs.CL (计算与语言) |
二、核心思想
问题定义
当前大语言模型(如 GPT、Llama)使用 next-token prediction 损失进行训练。然而,next-token prediction 是一种低效的语言、世界知识和推理能力获取方式。Teacher forcing 依赖局部模式,忽略了”困难”决策点,导致 SOTA 模型需要比人类儿童多数个数量级的数据才能达到相同的流利程度。
解决方案概述
本文提出 multi-token prediction:在训练语料的每个位置,让模型同时预测接下来的 个 token,使用 个独立的输出头(output heads)在共享的模型主干(shared trunk)上并行操作。
关键发现:
- 作为辅助训练任务,multi-token prediction 在代码和自然语言模型上均提升了下游能力,且无训练时间开销
- 方法在更大模型规模上效果更显著
- 13B 参数模型在 HumanEval 上多解决 12% 的问题,在 MBPP 上多解决 17%
- 4-token prediction 模型推理速度提升 3 倍
核心性能
| 指标 | 数值 |
|---|---|
| MBPP Pass@1 提升 | +3.8% (7B 模型, n=4) |
| HumanEval Pass@1 提升 | +1.2% (7B 模型, n=4) |
| 13B 模型 MBPP 增益 | +17% |
| 13B 模型 HumanEval 增益 | +12% |
| 推理加速 | 最高 3× (token 模型), 6.4× (byte 模型) |
| 训练开销 | 无额外开销 |
三、技术架构
方法概览
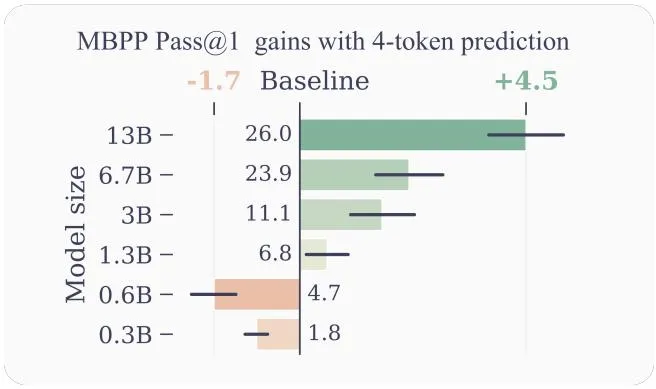
Figure 1: Multi-token prediction 概览。(Top) 训练时,模型通过共享主干和 4 个专用输出头同时预测 4 个未来 token。推理时仅使用 next-token 输出头,其他三个头可用于加速推理(最高 3 倍)。(Bottom) Multi-token prediction 在 MBPP 代码任务上显著提升 pass@1,且随模型规模增大效果更显著。
核心公式
标准 Next-token Prediction 损失: L_1 = -\sum_t \log P_\theta(x_{t+1} \mid x_{t:1}) \tag{1}
Multi-token Prediction 损失: L_n = -\sum_t \log P_\theta(x_{t+n:t+1} \mid x_{t:1}) \tag{2}
分解形式(假设共享主干 + 独立头):
实际架构:
其中:
- = 共享 transformer 主干(shared trunk)
- = 第 个独立输出头(transformer 层)
- = 共享 unembedding 矩阵
- = 主干产生的隐藏表示
内存高效实现
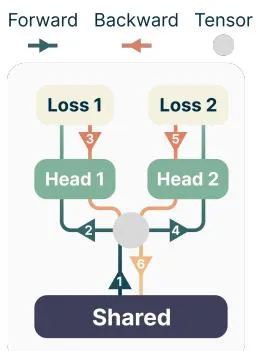
Figure 2: n-token prediction 模型 (n=2) 的前向/反向传播顺序。通过按顺序对各头执行前向/反向传播,避免同时物化所有 unembedding 层梯度,降低峰值 GPU 内存使用。
关键设计: 在共享主干前向传播后,顺序计算每个独立输出头的前向和反向传播,在主干处累积梯度。
- 朴素实现: 峰值 GPU 内存
- 优化实现: 峰值 GPU 内存
- 其中 = 词汇表大小, = 隐藏维度
伪代码:
z = model.shared(x)
d = z.detach()
d.requires_grad = True
for i in range(n):
    p = model.heads[i](d)
    loss(p, y[i]).backward()
z.backward(gradient=d.grad)
推理加速
Multi-token prediction 训练的额外输出头可用于自推测解码(self-speculative decoding),无需额外的 draft 模型:
- Blockwise parallel decoding (Stern et al., 2018)
- Medusa-like tree attention (Cai et al., 2024)
| 解码方式 | 代码加速 | 文本加速 | 接受 token 数 |
|---|---|---|---|
| 4-head 推测解码 | 3.0× | 2.7× | 2.5/3 (代码) |
| 8-byte 推测解码 | 6.4× | - | - |
训练细节
| 配置 | 说明 |
|---|---|
| 模型规模 | 300M - 13B 参数 |
| 训练数据 | 91B - 1T tokens (代码/自然语言) |
| 公平比较 | 相同参数量:添加 n-1 层输出头时,从主干移除 n-1 层 |
| 优化器 | Adam |
| 硬件 | A100-80GB, H100 |
| 总训练 | ~500K GPU 小时, ~50 tCO2eq |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 无开销辅助损失 | Multi-token prediction 作为辅助训练任务,无训练时间或内存开销 | 内存高效实现:顺序前向/反向传播 |
| 规模效应 | 方法在更大模型上效果更显著 | 13B 模型增益远大于 300M 模型 |
| 自推测解码 | 训练的额外头直接用于推理加速 | 4-token 模型推理加速 3× |
| Byte-level 训练 | 多字节预测解锁高效 byte-level 模型训练 | 8-byte prediction MBPP +67% |
| 选择点加权 | 隐式为重要 token 分配更高权重 | 信息论分析: 权重翻倍 |
| 归纳能力 | 促进小模型的归纳头形成 | 30M 以下模型归纳能力大幅提升 |
五、实验结果
5.1 规模效应
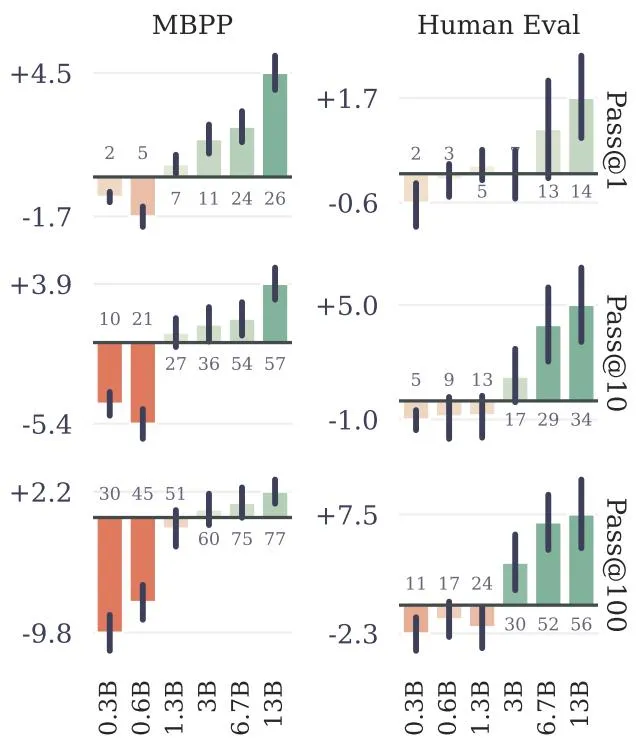
Figure 3: 不同模型规模下 n-token prediction 在 MBPP 上的结果。300M-13B 参数模型在代码上训练。小模型上 multi-token prediction 弱于基线,但在大规模上显著超越。
| 模型规模 | MBPP Pass@1 增益 | HumanEval Pass@1 增益 |
|---|---|---|
| 0.3B | - | - |
| 0.6B | +1.8% | - |
| 1.3B | +4.7% | +6.8% |
| 3B | +11.1% | - |
| 6.7B | +23.9% | - |
| 13B | +26.0% | +12% |
5.2 最优 n 值搜索
7B 模型, 200B tokens 代码训练:
| n | MBPP @1 | MBPP @10 | MBPP @100 | HumanEval @1 | HumanEval @10 | HumanEval @100 |
|---|---|---|---|---|---|---|
| 1 (baseline) | 30.0 | 53.8 | 73.7 | 22.8 | 36.4 | 62.0 |
| 2 | 30.3 | 55.1 | 76.2 | 22.2 | 38.5 | 62.6 |
| 4 | 33.8 | 55.9 | 76.9 | 24.0 | 40.1 | 66.1 |
| 6 | 31.9 | 53.9 | 73.1 | 20.6 | 38.4 | 63.9 |
| 8 | 30.7 | 52.2 | 73.4 | 20.0 | 36.6 | 59.6 |
关键发现: n=4 在 HumanEval 和 MBPP 上一致性最优。最优窗口大小可能依赖于数据分布。
5.3 Byte-level 训练
7B 模型, 314B bytes (≈116B tokens):
| n | MBPP @1 | HumanEval @1 | APPS/Intro @1 |
|---|---|---|---|
| 1 (baseline) | 19.3 | 18.1 | 0.1 |
| 8 | 32.3 (+67%) | 21.8 (+20%) | 1.2 |
| 16 | 28.6 | 20.4 | 1.0 |
| 32 | 23.0 | 17.2 | 0.6 |
关键发现: Multi-byte prediction 是解锁高效 byte-level 模型训练的有前途途径。8-byte prediction 模型接近 token-based 模型性能,且训练数据少 1.7×。
5.4 多 epoch 训练
1T tokens (4 epochs):
| n | MBPP @1 | HumanEval @1 | HumanEval @100 |
|---|---|---|---|
| 1 | 40.7 | 31.7 | 83.0 |
| 4 | 43.1 (+2.4%) | 31.6 | 86.2 (+3.2%) |
Multi-token prediction 在多 epoch 训练中仍保持优势,但增益有所减小。
5.5 Finetuning 效果
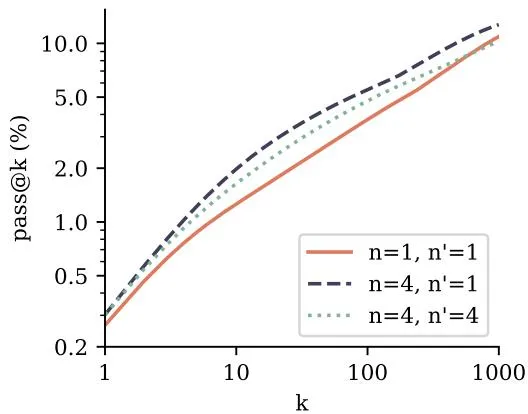
Figure 4: CodeContests 上的 finetuning 性能比较。4-token prediction 预训练模型的两种 finetuning 方式均超越 next-token 基线。
关键发现:
- 4-token prediction 预训练 + next-token prediction finetuning 效果最佳
- 符合”辅助任务预训练 + 任务特定 finetuning”的经典范式
- CodeContests 是最具挑战性的编码基准
5.6 自然语言评估
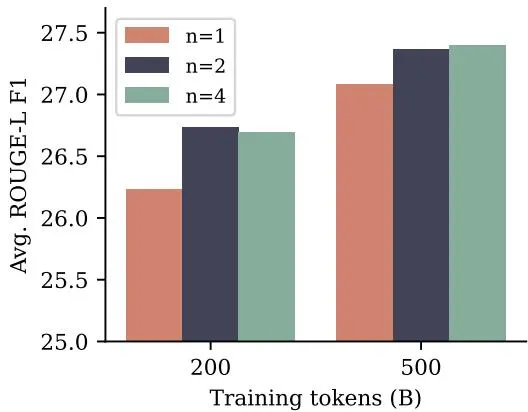
Figure 6: 摘要任务性能。7B 模型在 200B 和 500B tokens 自然语言上训练,finetuning 后在 8 个摘要基准上评估 ROUGE-L F1。
| 训练 tokens | n=1 | n=2 | n=4 |
|---|---|---|---|
| 200B | 26.2 | 26.7 | 26.7 |
| 500B | 27.1 | 27.4 | 27.4 |
关键发现:
- 标准 NLP 基准(选择题、负对数似然)上,n=4 有轻微退化
- 生成式评估(摘要)上,n=2 和 n=4 均有提升
- 选择题基准不适合有效区分生成能力
六、消融实验(合成数据)
6.1 归纳能力
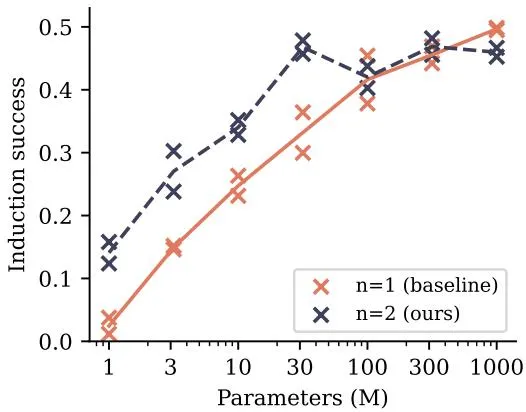
Figure 7: n-token prediction 模型的归纳能力。显示已提及的两 token 名字的第二个 token 的准确率。
实验设置: 在儿童故事数据集上训练 1M-1B 参数模型,通过替换角色名为随机生成的两 token 名字测量归纳能力。
关键发现:
- 30M 参数以下: 2-token prediction 模型的归纳能力远超 next-token 模型
- 100M 参数以上: 优势消失
- 解释: Multi-token prediction 促进跨序列位置的信息传递,有利于归纳头的形成。一旦归纳能力形成,next-token prediction 即可学习该任务。
6.2 算法推理
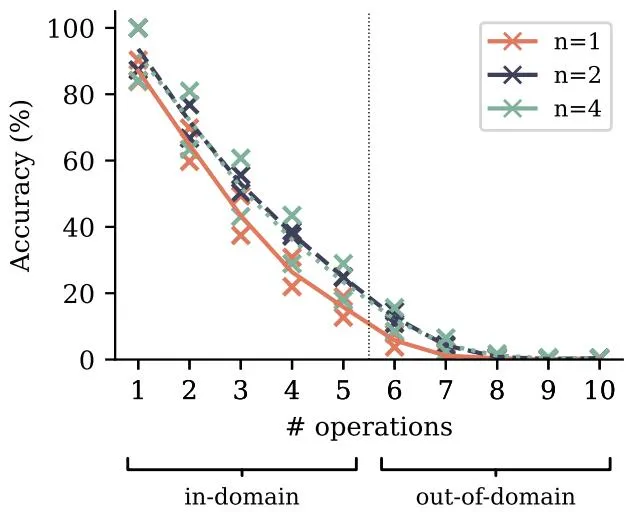
Figure 8: 多项式算术任务准确率。Multi-token prediction 提升了所有难度级别的准确率,尤其在分布外泛化上效果显著。
实验设置: 上的多项式算术(取反、加法、乘法、组合),训练时操作数 1-5,测试时扩展到 1-10。
关键发现:
- Multi-token prediction 在分布外泛化上带来显著提升
- 将模型从 30M 增大到 100M 的效果不如将 next-token 替换为 multi-token prediction
七、为什么有效?理论分析
7.1 Lookahead 强化选择点
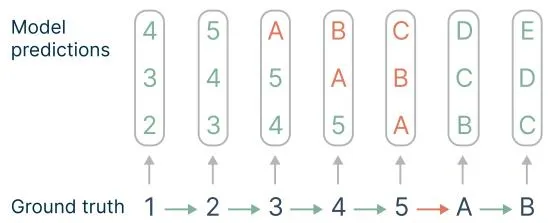
Figure 9: Multi-token prediction 损失为重要 token 分配更高隐式权重。困难转换 “5→A” 的后果同样难以预测,因此通过其关联获得更高权重。
核心洞察: 并非所有 token 决策都同等重要。选择点(choice points)与高层语义属性相关,决定文本是否有用。
隐式权重分配:
- 选择点: 权重
- 非关键点: 权重
7.2 信息论分析
设 = 下一个 token, = 下下个 token, = 上下文。
Next-token prediction:
2-token prediction:
关键发现: 2-token prediction 将 (互信息)的权重提高了 2 倍。Multi-token predictor 在预测与后续文本相关的 token 时更准确。
八、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| ProphetNet (Qi et al., 2020) | 最早研究 multi-token prediction,但复制残差流 n 倍 |
| Blockwise parallel decoding (Stern et al., 2018) | 首次提出推测解码方案,本文用 transformer 层替换线性头 |
| Medusa (Cai et al., 2024) | 使用 top-k 预测的自推测解码,可与本文模型结合 |
| XLNet (Yang et al., 2019) | 排列语言建模,但仅预测 15% token |
| UL2 (Tay et al., 2022) | 去噪任务混合,但仅 15-25% 掩码 |
| Rho-1 (Lin et al., 2024) | 选择性 token 训练,与选择点加权相关 |
九、总结
核心贡献
- 简单有效的训练改进: Multi-token prediction 作为辅助损失,无训练开销
- 规模效应: 在更大模型上效果更显著,13B 模型代码任务提升 12-17%
- 推理加速: 自推测解码实现 3× 加速(token)或 6.4× 加速(byte)
- Byte-level 训练: 解锁高效 byte-level 模型训练
- 理论分析: 信息论解释为什么 multi-token prediction 有效
技术影响
- 训练范式: 为 next-token prediction 之外的辅助损失开辟了新方向
- 推理效率: 自推测解码无需额外 draft 模型,降低部署成本
- Byte-level 模型: 使 byte-level LLM 训练变得可行
- 归纳能力: 促进小模型的 in-context learning 能力
局限性
- 自然语言标准基准(选择题)上 n=4 有轻微退化
- 最优 n 值依赖于数据分布,尚无自动选择方法
- Byte-level 模型仍需更多数据才能完全匹配 token-based 模型
十、参考资源
- 论文: arXiv:2404.19737
- 引用: arXiv:2404.19737 [cs.CL]
- 环境影响: ~500K GPU 小时 (A100/H100), ~50 tCO2eq (100% 碳抵消)