Toward Inference-optimal Mixture-of-Expert Large Language Models
面向推理最优的MoE大语言模型扩展律研究
Toward Inference-optimal Mixture-of-Expert Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Toward Inference-optimal Mixture-of-Expert Large Language Models |
| 作者 | Longfei Yun, Yonghao Zhuang, Yao Fu, Eric P. Xing, Hao Zhang |
| 机构 | - |
| 论文 | arXiv:2404.02852 |
| 代码 | - |
| 发布 | 2024-04-03 |
| 领域 | 机器学习 (cs.LG) |
二、核心思想
问题定义
MoE 模型(如 Mixtral、DeepSeek-MoE)通过稀疏激活专家来扩展模型规模,避免了密集 Transformer 的二次训练成本增长。然而,一个关键问题尚未解决:
给定训练预算,模型规模和专家数量的最优分配是什么?
现有研究的局限:
- 仅关注训练损失最优(loss-optimal),忽略推理效率
- 增加专家数量存在收益递减效应
- 推理成本与专家数量成正比增长
解决方案概述
本文提出将推理效率作为扩展律的另一个优化维度,建立 MoE 模型的完整扩展律。
核心发现:
- 4/8 专家的 MoE 是同等性能下最高效的推理方案,但训练成本高 2.5-3.5×
- 16/32 专家的 MoE 比损失最优方案小 70-85%,但使用更大数据集训练,是训练预算下的有前途方案
三、技术架构
MoE 架构
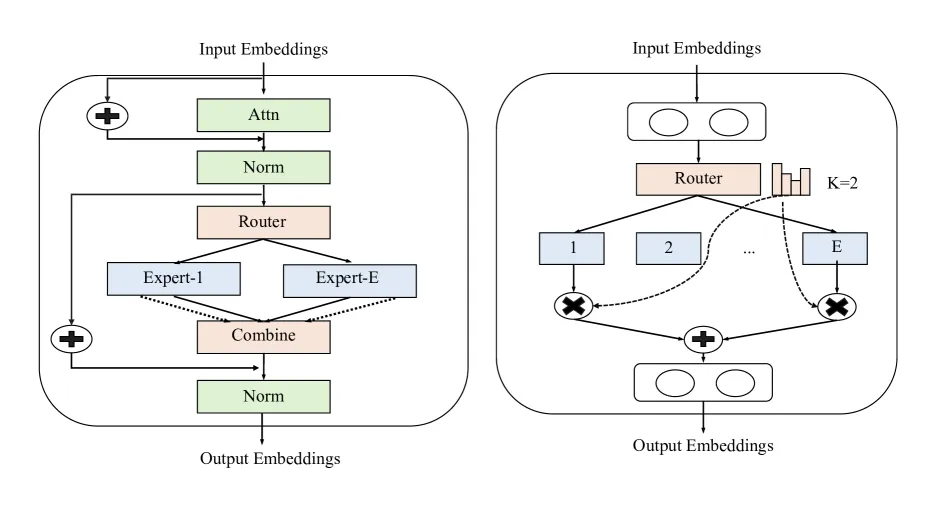
MoE 层由 E 个前馈网络(FFN)组成,每个输入 token 被路由到 K 个专家处理:
其中 是门控机制产生的路由概率。
核心公式:MoE 扩展律
密集模型扩展律 (Eq. 1):
MoE 扩展律 (Eq. 2):
其中:
- :对应密集模型的参数数量
- :训练 token 数量
- :专家数量
- :幂律指数
- :拟合常数
扩展律拟合
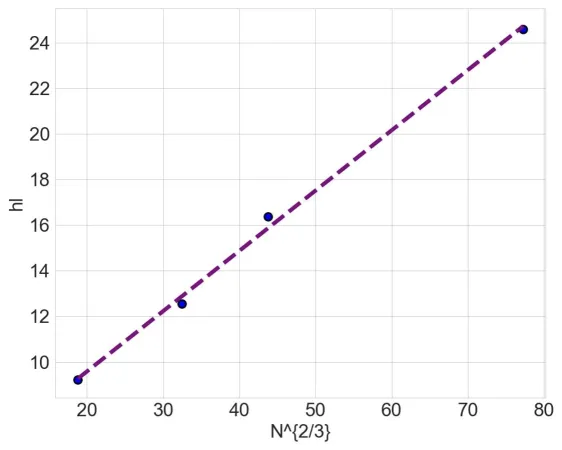
专家数量扩展
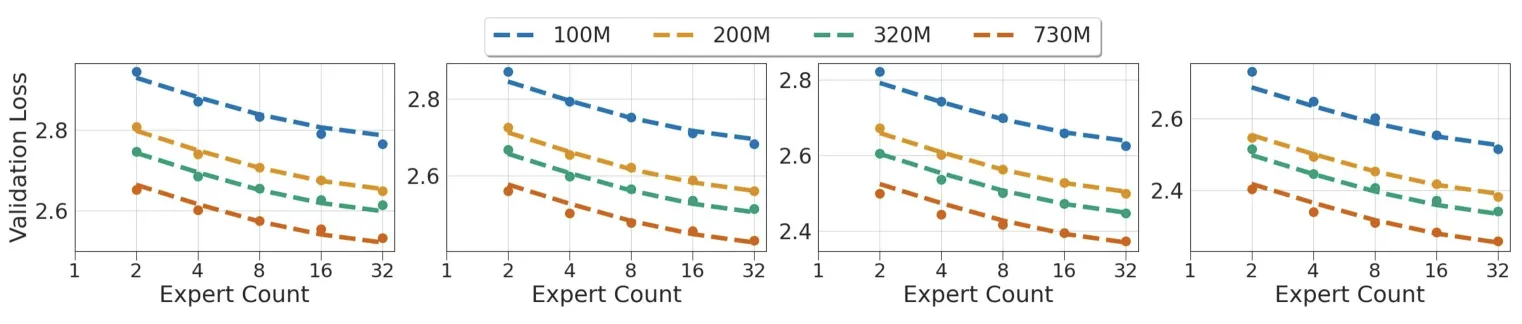
关键观察:
- 增加专家数量存在收益递减
- 不同密集模型规模从专家扩展中获益不均
- D 和 E 之间存在交互效应
推理成本建模
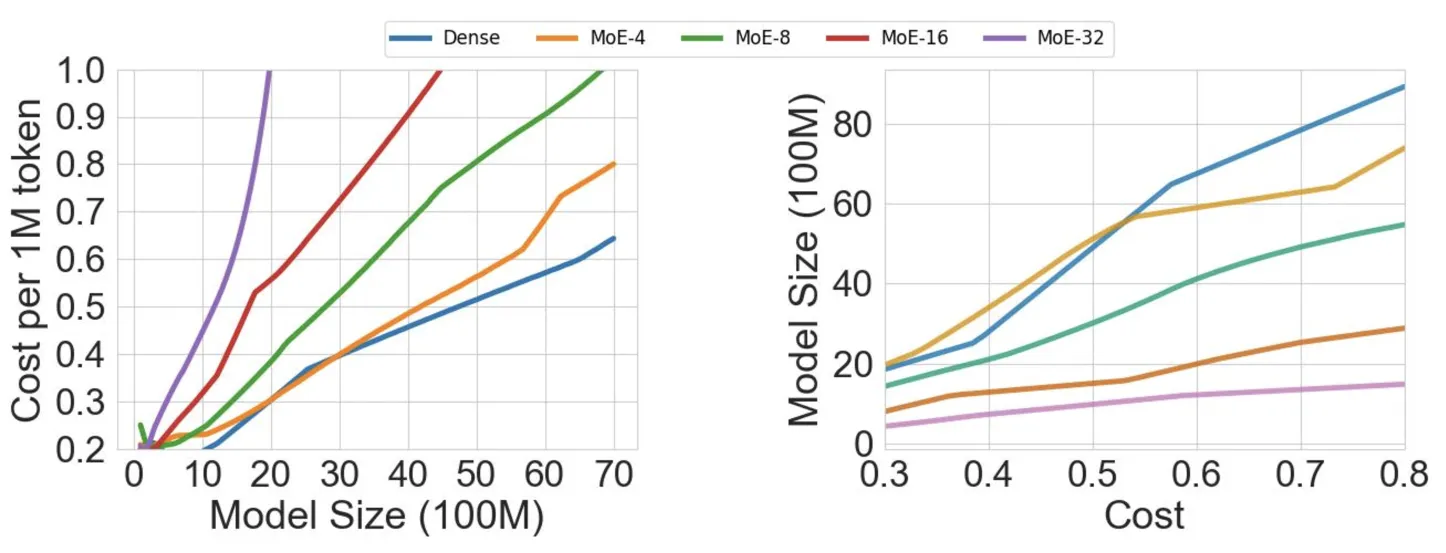
推理成本 (Eq. 5):
其中:
- :GPU 数量
- :单 GPU 每秒成本
- :吞吐量
吞吐量 (Eq. 4):
推理成本近似:推理成本与总参数数量近似线性关系。
三维权衡
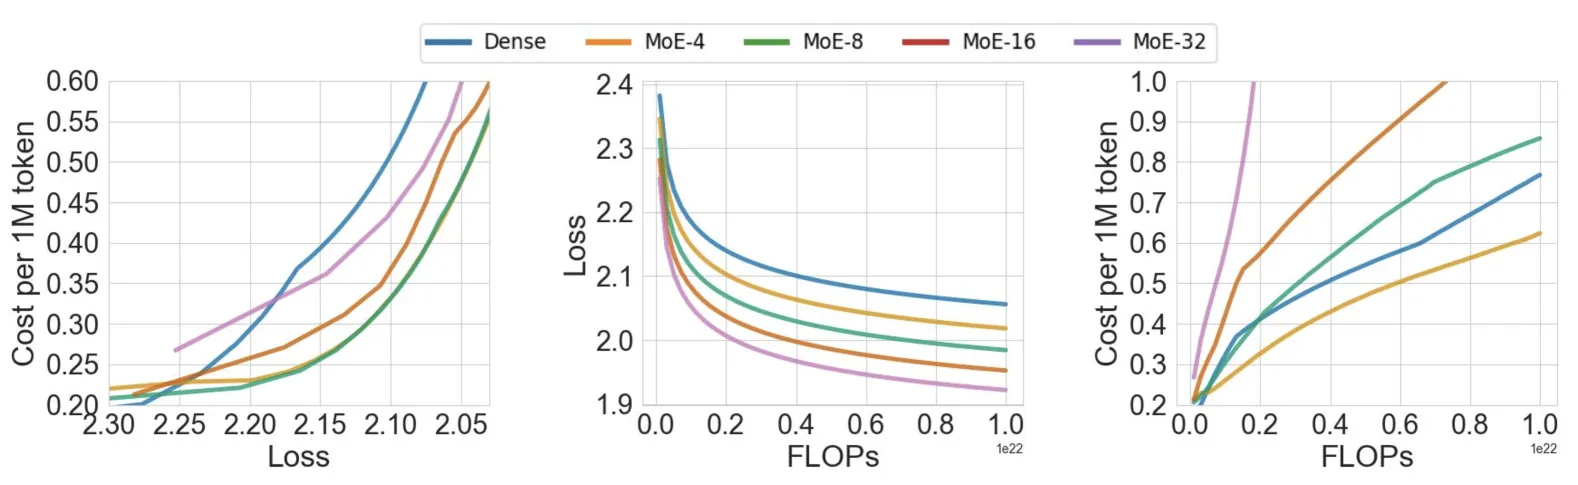
存在三维权衡:
- 训练预算 vs 模型质量:更多专家 → 更高性能
- 训练预算 vs 推理成本:更多专家 → 更高推理成本
- 模型质量 vs 推理成本:同等质量下,4/8 专家最优
损失-成本曲线
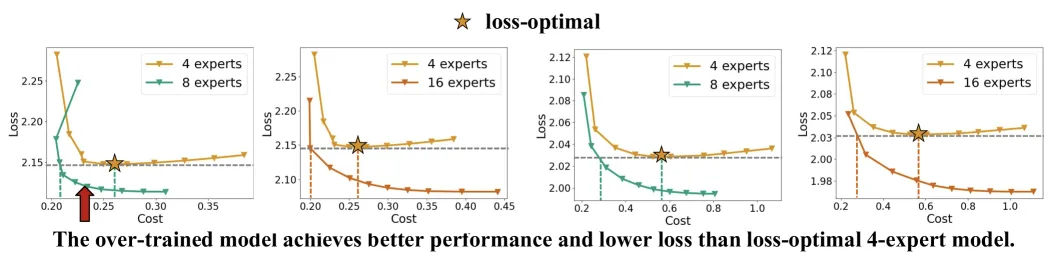
关键发现:过训练的 16 专家模型在损失和成本上都达到最优。
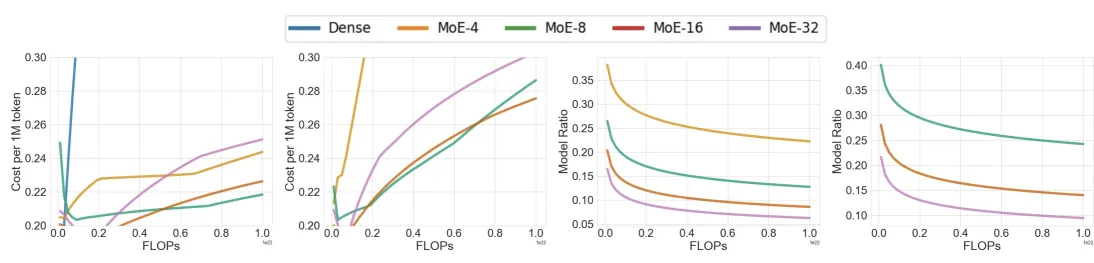
约束优化
有界损失下的最优推理成本:
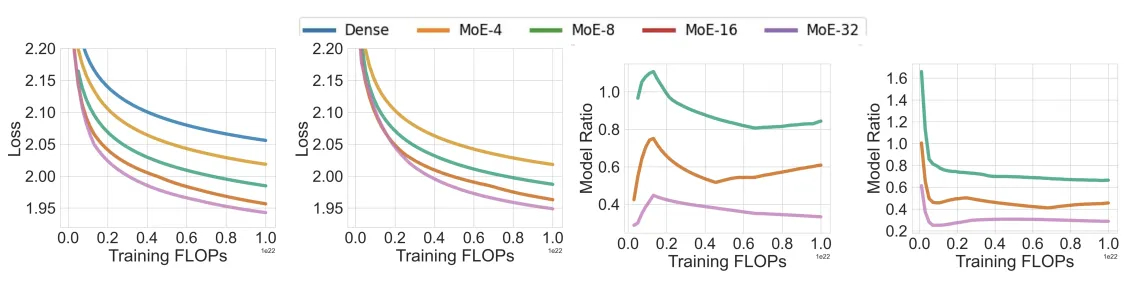
有界推理成本下的最优损失:
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| MoE 扩展律 | 将专家数量 E 纳入扩展律 | 幂律关系 R² > 0.99 |
| 推理效率指标 | 将推理成本作为优化维度 | 发现 4/8 专家最优 |
| 三维权衡分析 | 训练预算-质量-推理成本 | 实验验证 |
| 过训练策略 | 小模型 + 大数据 | 16 专家过训练方案最优 |
五、实验结果
实验设置
模型规模:100M - 730M 参数(密集模型)
| 模型 | d_model | n_layers | n_heads | 参数量 |
|---|---|---|---|---|
| 100M | 768 | 12 | 8 | 81M |
| 200M | 896 | 14 | 8 | 185M |
| 320M | 1024 | 16 | 12 | 289M |
| 730M | 1536 | 16 | 16 | 679M |
专家数量:4, 8, 16, 32(及密集基线)
训练数据:SlimPajama,2.5B - 20B tokens
扩展律拟合结果
拟合参数:
- RMSLE = 3.908e-3
- Huber Loss = 1.033e-3
核心发现
1. 专家数量的收益递减
- 从 0→4 专家:显著性能提升
- 从 4→8→16→32:提升幅度递减
2. 推理最优配置
- 同等性能下:4/8 专家 MoE 推理成本最低
- 原因:推理成本 ∝ 总参数量,4/8 专家可使用更大密集模型
3. 训练预算下的最优策略
- 训练 16/32 专家 MoE,但比损失最优方案小 70-85%
- 使用更多训练数据补偿模型规模
- 推理成本显著降低,性能损失可控
4. 过训练的有效性
- 16 专家 MoE 过训练(小模型 + 大数据)达到最优损失-成本平衡
六、相关工作
| 方法 | 特点 | 本文贡献 |
|---|---|---|
| Kaplan et al. | 密集模型扩展律 | 扩展到 MoE |
| Chinchilla | 训练最优分配 | 引入推理维度 |
| Clark et al. | MoE 扩展律(无 D) | 完整的 (N, D, E) 关系 |
| Sardana & Frankle | 推理成本考虑 | 更精确的推理成本建模 |
| Mixtral/DeepSeek-MoE | 实践中的 MoE | 提供理论指导 |
七、总结
核心贡献
- MoE 完整扩展律:建立 的幂律关系
- 推理效率分析:首次将推理成本纳入 MoE 扩展律优化
- 三维权衡发现:训练预算-模型质量-推理成本的权衡关系
- 实践指导:
- 追求推理效率:选择 4/8 专家
- 给定训练预算:训练更小但更多专家的模型,使用更多数据
技术影响
- 为 MoE 模型的设计提供理论指导
- 挑战了”越多专家越好”的直觉
- 为训练预算分配提供新的优化视角
局限性
- 实验规模较小(最大 730M 密集参数)
- 未验证到更大规模(7B+)的泛化性
- 推理成本建模假设特定硬件配置
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 专家数量扩展律 | scaling-law-experts.png |
| Figure 2 | 推理成本 | inference-cost.png |
| Figure 3 | 三维权衡 | tradeoff-inference-training.png |
| Figure 4 | 损失-成本曲线 | loss-cost-curve.png |
| Figure 5 | 有界损失下的最优推理成本 | optimal-inference-cost.png |
| Figure 6 | 有界推理成本下的最优损失 | optimal-loss.png |
| Figure 7 | MoE 架构 | moe-architecture.png |
| Figure 8 | 扩展律拟合 | scaling-law-fit.png |