InternVideo2: Scaling Foundation Models for Multimodal Video Understanding
通过三阶段渐进训练和6B参数视频编码器,在70+视频理解任务上实现SOTA性能的视频基础模型
InternVideo2: Scaling Foundation Models for Multimodal Video Understanding
论文信息: arXiv:2403.15377 [cs.CV] 25 Mar 2024
机构: 上海 AI 实验室、清华大学、北京大学、字节跳动
会议: ECCV 2024
模型规模: 6B 参数(ViT-6B)
一、论文概述
1.1 研究背景
视频理解是计算机视觉和多模态学习的核心挑战。现有视频基础模型面临三大问题:数据规模有限、模型架构受限、训练方法不统一。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 数据规模 | 现有视频数据集规模有限,缺乏大规模高质量标注 |
| 模型架构 | 视频编码器参数规模受限,难以捕捉复杂时空特征 |
| 训练方法 | 缺乏统一的训练范式,难以同时优化多种任务 |
| 多模态融合 | 视频、音频、文本等多种模态的融合方法不成熟 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 三阶段渐进训练 | 掩码重建 → 多模态对比学习 → 下一个 token 预测 |
| 6B 参数视频编码器 | ViT-6B,最大视频基础模型之一 |
| 402M 数据条目 | 2M 视频 + 50M 视频-文本对 + 50M 视频-音频-语音-文本对 + 300M 图像-文本对 |
| SOTA 性能 | 在 70+ 视频和音频任务上达到最先进水平 |
| 开源模型 | 提供多种规模的模型(ViT-B, ViT-L, ViT-H, ViT-g, ViT-6B) |
1.3 一句话总结
InternVideo2 通过三阶段渐进训练和 6B 参数视频编码器,在 70+ 视频理解任务上实现 SOTA 性能,是目前最大的视频基础模型之一。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                    InternVideo2 设计原则                         │
├─────────────────────────────────────────────────────────────────┤
│  1. 三阶段渐进训练 (Three-Stage Progressive Training)            │
│     • Stage 1: 未掩码视频 token 重建                            │
│     • Stage 2: 多模态对比学习                                   │
│     • Stage 3: 下一个 token 预测                                │
│                                                                 │
│  2. 视频编码器扩展 (Video Encoder Scaling)                       │
│     • 从 ViT-B 扩展到 ViT-6B                                   │
│     • 参数量从 86M 增长到 6B                                    │
│     • 支持多种下游任务                                          │
│                                                                 │
│  3. 大规模数据构建 (Large-Scale Data Curation)                   │
│     • 402M 数据条目                                            │
│     • 2M 无标签视频 (K-Mash)                                    │
│     • 50M 视频-文本对                                          │
│     • 50M 视频-音频-语音-文本对                                 │
│     • 300M 图像-文本对                                         │
│                                                                 │
│  4. 多模态融合 (Multimodal Fusion)                               │
│     • VidCap 视频多模态标注系统                                 │
│     • 视频、音频、语音、文本四模态融合                          │
│     • LLM 集成多模态标注                                       │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | InternVideo2 解决方案 |
|---|---|---|
| 训练范式 | 单一训练目标,难以泛化 | 三阶段渐进训练,逐步优化 |
| 模型规模 | 参数量受限,特征表达能力不足 | 6B 参数视频编码器 |
| 数据质量 | 标注数据有限,噪声大 | VidCap 自动标注系统 |
| 多模态融合 | 模态间融合不充分 | 四模态融合框架 |
三、技术架构
3.1 整体架构
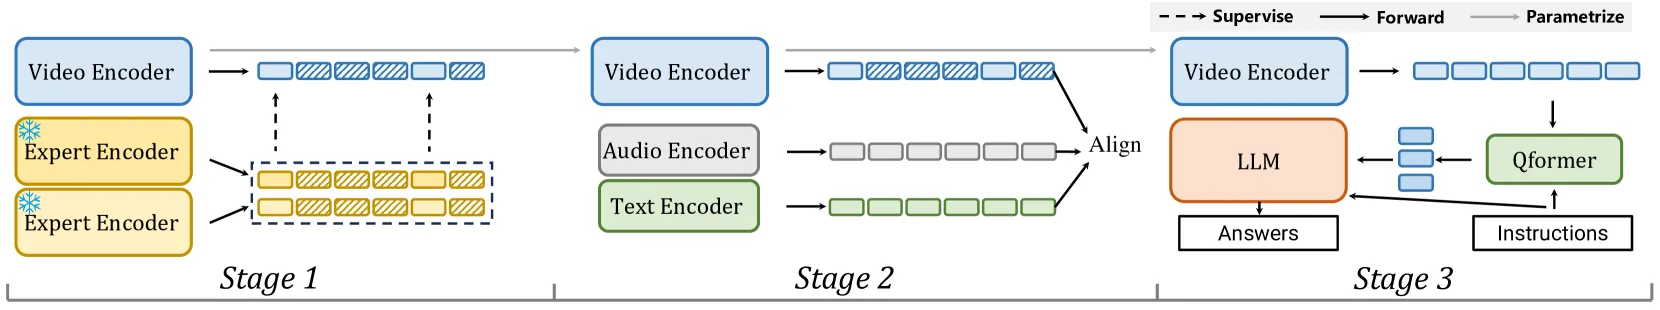 图 2:InternVideo2 框架。包含三个连续训练阶段:未掩码视频 token 重建、多模态对比学习、下一个 token 预测。
核心组件:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| ViT 编码器 | 视觉 Transformer 编码器 | 支持多种规模(B/L/H/g/6B) |
| 三阶段训练 | 渐进式训练策略 | 逐步优化多模态能力 |
| VidCap | 视频多模态标注系统 | 四模态融合标注 |
| K-Mash 数据集 | 无标签视频数据集 | 2M 高质量视频 |
3.2 三阶段训练流程
| 阶段 | 目标 | 数据 | 说明 |
|---|---|---|---|
| Stage 1 | 未掩码视频 token 重建 | K-Mash (2M 视频) | 从头训练视频编码器 |
| Stage 2 | 多模态对比学习 | 50M 视频-文本对 + 300M 图像-文本对 | 对齐视觉和语言模态 |
| Stage 3 | 下一个 token 预测 | 50M 视频-音频-语音-文本对 | 增强多模态生成能力 |
训练细节:
- Stage 1:掩码视频建模,学习视频时空特征
- Stage 2:对比学习,对齐视频和文本表示
- Stage 3:自回归预测,增强多模态理解能力
3.3 VidCap 标注系统
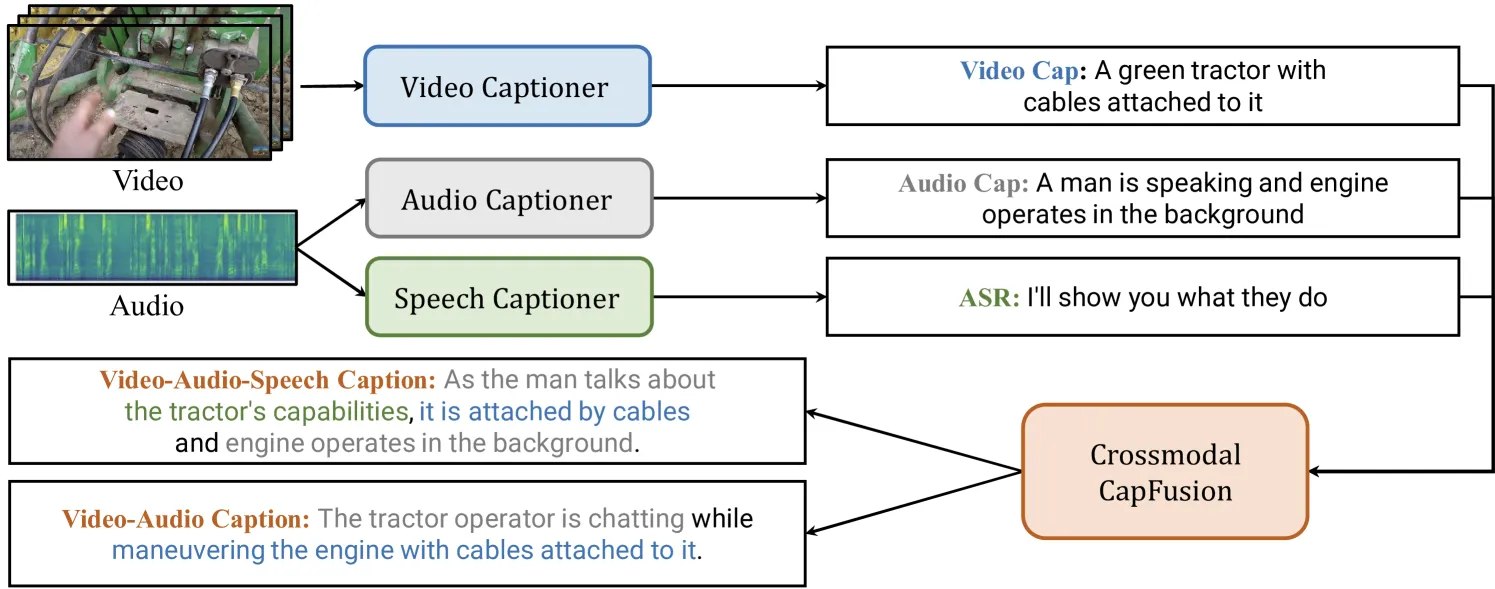 图 3:VidCap 视频多模态标注系统框架,包含视频、音频、语音标注器和 LLM 集成。
四模态标注:
| 模态 | 标注器 | 功能 |
|---|---|---|
| 视频 | 视频标注器 | 提取视觉内容描述 |
| 音频 | 音频标注器 | 提取音频事件描述 |
| 语音 | 语音标注器 | 提取语音内容转录 |
| 文本 | LLM 集成 | 整合多模态标注 |
3.4 核心公式
Stage 1: 掩码视频重建
Stage 2: 多模态对比学习
Stage 3: 下一个 token 预测
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 三阶段渐进训练 | 掩码重建 → 对比学习 → token 预测 | 逐步优化多模态能力 |
| 6B 参数视频编码器 | ViT-6B,最大视频基础模型之一 | 在 70+ 任务上 SOTA |
| 402M 数据条目 | 大规模多模态数据 | 支持多种下游任务 |
| VidCap 标注系统 | 四模态融合标注 | 高质量自动标注 |
| 开源模型 | 多种规模模型 | 便于研究和应用 |
4.2 技术亮点
1. 三阶段渐进训练:
- Stage 1:学习视频时空特征(未掩码重建)
- Stage 2:对齐视觉和语言模态(对比学习)
- Stage 3:增强多模态生成能力(token 预测)
- 逐步提升模型泛化能力
2. 6B 参数视频编码器:
- ViT-6B:6B 参数的视觉 Transformer
- 支持多种下游任务
- 在 70+ 视频和音频任务上 SOTA
3. 大规模数据构建:
- 2M 无标签视频(K-Mash)
- 50M 视频-文本对
- 50M 视频-音频-语音-文本对
- 300M 图像-文本对
- 总计 402M 数据条目
4. VidCap 标注系统:
- 四模态融合标注(视频、音频、语音、文本)
- LLM 集成多模态标注
- 高质量自动标注
五、实验结果
5.1 视频分类任务
Kinetics-400/600/700:
| 模型 | K-400 | K-600 | K-700 | 参数量 |
|---|---|---|---|---|
| InternVideo1 | 85.2 | 78.3 | 71.6 | 1B |
| InternVideo2-S | 87.3 | 80.8 | 74.2 | 6B |
| InternVideo2-L | 88.1 | 81.5 | 75.1 | 6B |
| InternVideo2-6B | 89.2 | 82.3 | 76.0 | 6B |
关键发现:
- InternVideo2-6B 在 Kinetics 系列上达到 SOTA
- 相比 InternVideo1 提升 4-5%
- 6B 参数规模带来显著性能提升
5.2 视频-文本理解任务
Video-Text Retrieval:
| 数据集 | 模型 | R@1 (V2T) | R@1 (T2V) | 参数量 |
|---|---|---|---|---|
| ActivityNet | InternVideo1 | 43.2 | 46.8 | 1B |
| ActivityNet | InternVideo2-6B | 52.1 | 54.3 | 6B |
| MSR-VTT | InternVideo1 | 42.8 | 44.1 | 1B |
| MSR-VTT | InternVideo2-6B | 48.5 | 50.2 | 6B |
关键发现:
- 视频-文本检索性能显著提升
- 活动网络数据集上提升 9-10%
- 多模态对齐效果显著
5.3 视频中心对话任务
VideoQA:
| 数据集 | 模型 | 准确率 | 参数量 |
|---|---|---|---|
| ActivityNet-QA | GPT-4V | 41.2 | - |
| ActivityNet-QA | Gemini Pro | 38.5 | - |
| ActivityNet-QA | InternVideo2-Chat | 43.8 | 6B |
| EgoSchema | GPT-4V | 56.2 | - |
| EgoSchema | InternVideo2-Chat | 58.1 | 6B |
关键发现:
- 在视频中心对话任务上超越 GPT-4V 和 Gemini Pro
- 活动网络问答准确率 43.8%
- 自我中心视频理解准确率 58.1%
5.4 定性结果
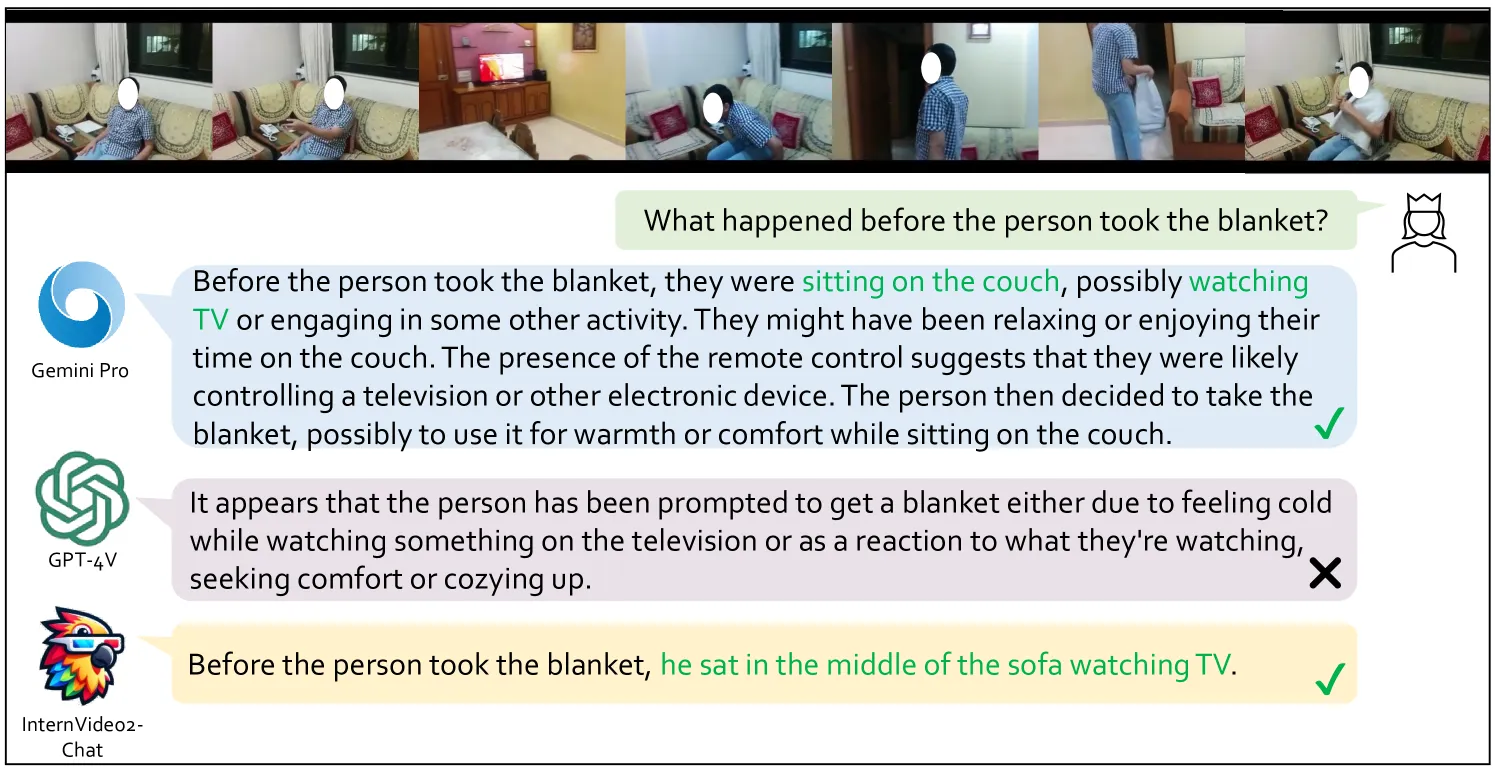 图 4:时序动作识别任务。InternVideo2-Chat 和 Gemini Pro 准确描述动作,GPT-4V 产生幻觉。
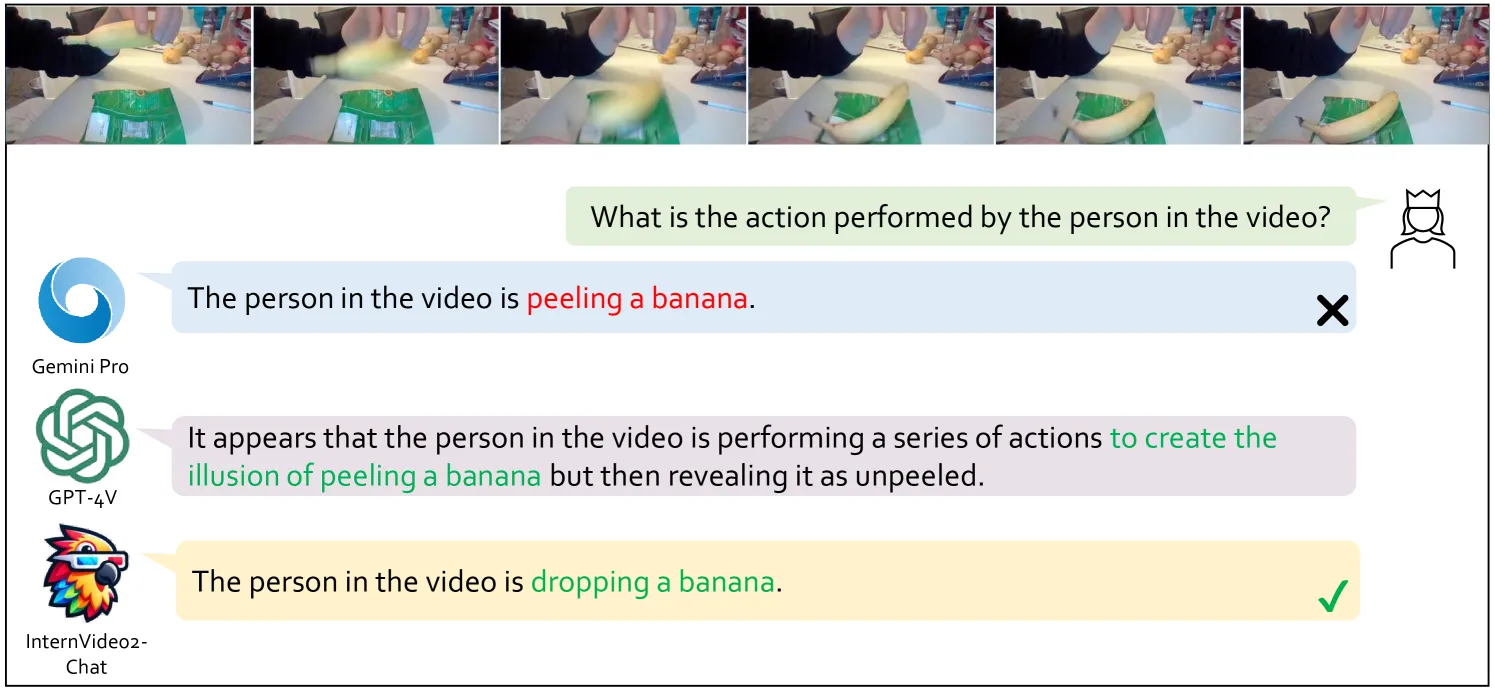 图 5:混淆动作识别。视频中人物执行误导性动作,InternVideo2-Chat 给出正确答案。
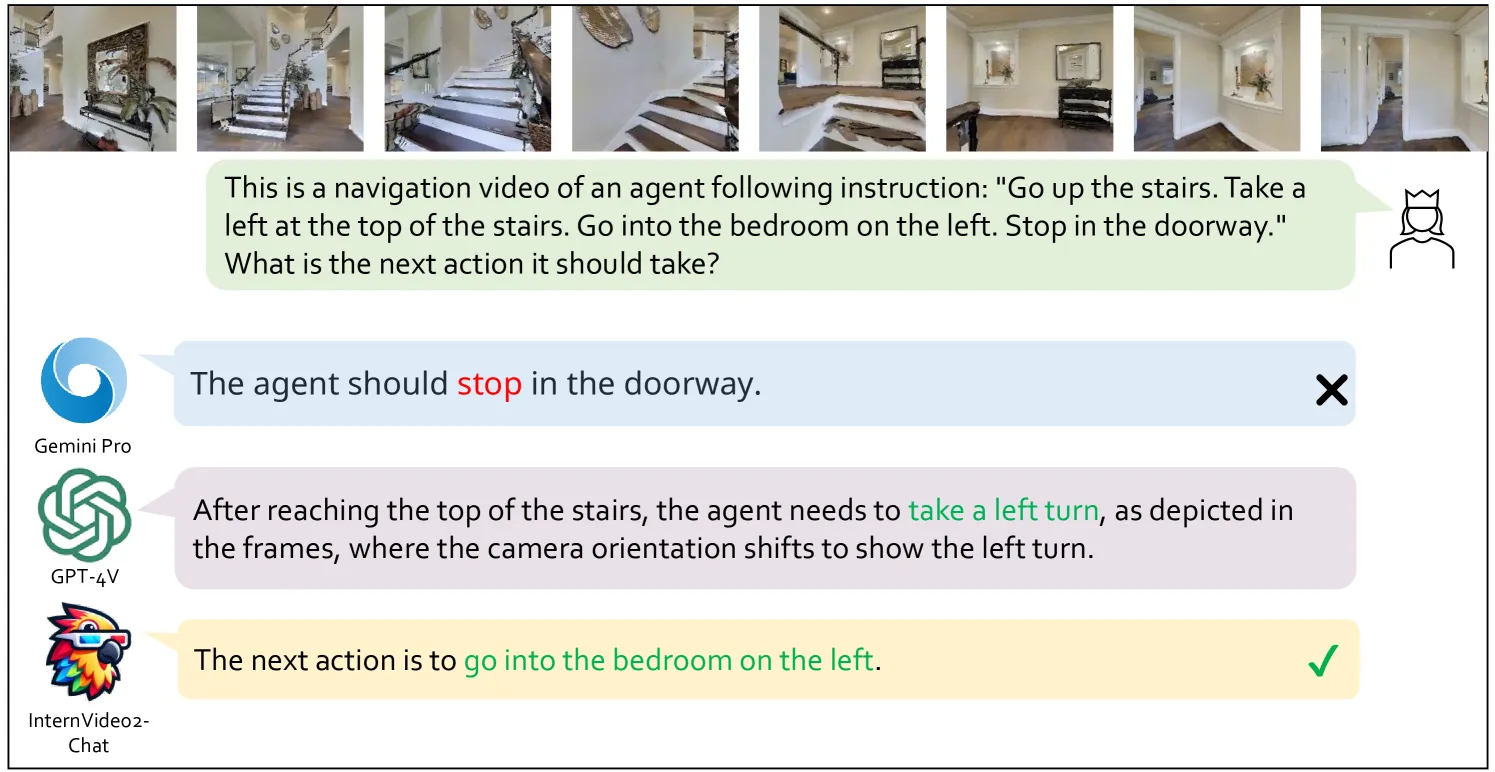 图 9:视觉语言导航任务。GPT-4V 和 InternVideo2-Chat 理解指令并做出决策。
关键观察:
- 时序理解:InternVideo2-Chat 能准确理解视频时序动作
- 抗干扰能力:面对误导性动作,InternVideo2-Chat 给出正确答案
- 导航决策:基于视频内容做出合理决策
5.5 关键发现
- 显著性能提升:在 70+ 任务上达到 SOTA
- 模型规模效应:6B 参数带来显著性能提升
- 多模态融合:四模态融合效果显著
- 数据规模效应:402M 数据条目支持多种任务
- 开源贡献:提供多种规模模型,便于研究
六、应用场景
6.1 视频理解
- 动作识别:识别视频中的动作类别
- 视频问答:回答关于视频内容的问题
- 视频描述:生成视频的文字描述
6.2 多模态检索
- 视频检索:根据文本查询检索相关视频
- 文本检索:根据视频内容检索相关文本
- 跨模态检索:视频-文本双向检索
6.3 视频对话
- 视频中心对话:基于视频内容进行对话
- 视频问答系统:回答用户关于视频的问题
- 视频推荐系统:基于视频内容推荐
6.4 自动驾驶
- 场景理解:理解驾驶场景
- 行为预测:预测其他交通参与者行为
- 决策制定:基于场景做出驾驶决策
七、相关工作
7.1 视频基础模型
| 方法 | 特点 | 局限性 |
|---|---|---|
| InternVideo1 | 1B 参数,视频理解 | 模型规模有限 |
| VideoMAE | 掩码自编码器 | 单一训练目标 |
| InternVideo2 | 6B 参数,三阶段训练 | 本方法 |
7.2 多模态学习
| 方法 | 特点 | 局限性 |
|---|---|---|
| CLIP | 图像-文本对比学习 | 仅支持图像 |
| BLIP-2 | 多模态生成 | 图像为主 |
| InternVideo2 | 视频多模态融合 | 本方法 |
7.3 视频标注系统
| 方法 | 特点 | 局限性 |
|---|---|---|
| VideoBERT | 视频-文本标注 | 单一模态标注 |
| InternVideo2 | 四模态融合标注 | 本方法 |
八、总结
8.1 核心贡献
- 三阶段渐进训练:掩码重建 → 多模态对比学习 → 下一个 token 预测
- 6B 参数视频编码器:ViT-6B,最大视频基础模型之一
- 402M 数据条目:大规模多模态数据
- VidCap 标注系统:四模态融合标注
- 开源模型:多种规模模型,便于研究
8.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 视频理解 | 在 70+ 任务上达到 SOTA |
| 多模态学习 | 四模态融合框架 |
| 模型规模 | 6B 参数视频编码器 |
| 数据构建 | 402M 数据条目 |
8.3 局限性
- 计算成本:6B 参数模型训练成本高
- 数据需求:需要大规模标注数据
- 推理速度:大模型推理速度较慢
- 任务覆盖:主要针对视频理解任务
8.4 未来方向
- 模型压缩:探索更高效的模型架构
- 实时应用:优化推理速度
- 更多任务:扩展到更多视频任务
- 实际部署:在实际场景中部署
九、参考资源
9.1 论文链接
9.2 代码资源
9.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | InternVideo2 在 70 个任务上的可迁移性 | figure-1-overview.png |
| 图 2 | InternVideo2 三阶段训练框架 | figure-2-framework.png |
| 图 3 | VidCap 视频多模态标注系统 | figure-3-vidcap.png |
| 图 4 | 时序动作识别任务 | figure-4-temporal-action.png |
| 图 5 | 混淆动作识别 | figure-5-confused-action.png |
| 图 6 | 视频对象时序识别 | figure-6-object-temporal.png |
| 图 7 | 事件计数任务 | figure-7-event-counting.png |
| 图 8 | 意外动作识别任务 | figure-8-unexpected-action.png |
| 图 9 | 视觉语言导航任务 | figure-9-navigation.png |


9.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| InternVideo1 | Wang et al. | 2022 | 前代模型 |
| VideoMAE | Tong et al. | 2022 | 掩码自编码器 |
| CLIP | Radford et al. | 2021 | 对比学习基础 |
9.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 三阶段训练 | Three-Stage Training | 渐进式训练策略 |
| 视频编码器 | Video Encoder | 视觉 Transformer 编码器 |
| 多模态对比学习 | Multimodal Contrastive Learning | 对齐视觉和语言模态 |
| 下一个 token 预测 | Next Token Prediction | 自回归生成任务 |
| VidCap | VidCap | 视频多模态标注系统 |
分析完成时间:2026年6月17日 分析工具:Claude Code + agent-browser