Enabling Unstructured Sparse Acceleration on Structured Sparse Accelerators
在结构化稀疏加速器上实现非结构化稀疏加速,通过TASD方法弥合软硬件稀疏模式不匹配的鸿沟。
Enabling Unstructured Sparse Acceleration on Structured Sparse Accelerators
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | Enabling Unstructured Sparse Acceleration on Structured Sparse Accelerators |
| 作者 | Geonhwa Jeong, Po-An Tsai, Abhimanyu R. Bambhaniya, Stephen W. Keckler, Tushar Krishna |
| 机构 | Georgia Institute of Technology, NVIDIA |
| 发表 | MLSys 2025 (arXiv:2403.07953) |
| 提交日期 | 2024年3月12日 |
1.2 研究背景
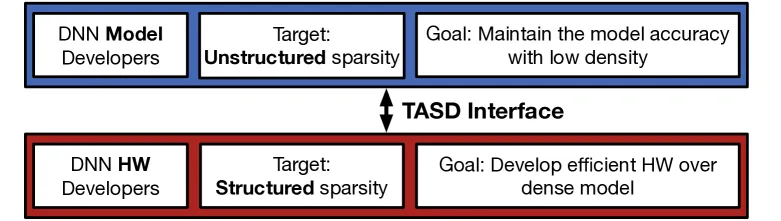
深度神经网络(DNN)的计算需求持续增长,利用模型中的稀疏性成为提升计算效率的重要方向。然而,当前稀疏加速面临一个核心矛盾:
- 软件层面:模型开发者偏好非结构化稀疏(unstructured sparsity),因为它提供更高的灵活性,能获得更好的模型精度和更高的稀疏度
- 硬件层面:硬件设计师偏好结构化稀疏(structured sparsity),因为它实现简单、面积开销低、性能可预测
这种模式不匹配严重阻碍了稀疏DNN加速的广泛应用。
1.3 核心问题
“Can we design a system to expose the flexible unstructured sparse interface to the DNN developers, but only with the efficient, less flexible structured sparse HW support?”
即:能否在高效但不灵活的结构化稀疏硬件上,实现对非结构化稀疏的支持?
二、核心思想
2.1 TASD 方法
论文提出 TASD (Tensor Approximation via Structured Decomposition),核心思想是利用线性代数中的分配律(distributive property),将任意稀疏张量分解为一系列结构化稀疏张量的和。
数学表达:
其中 表示不同的结构化稀疏模式(如 2:4, 2:8 等)。
2.2 直观示例
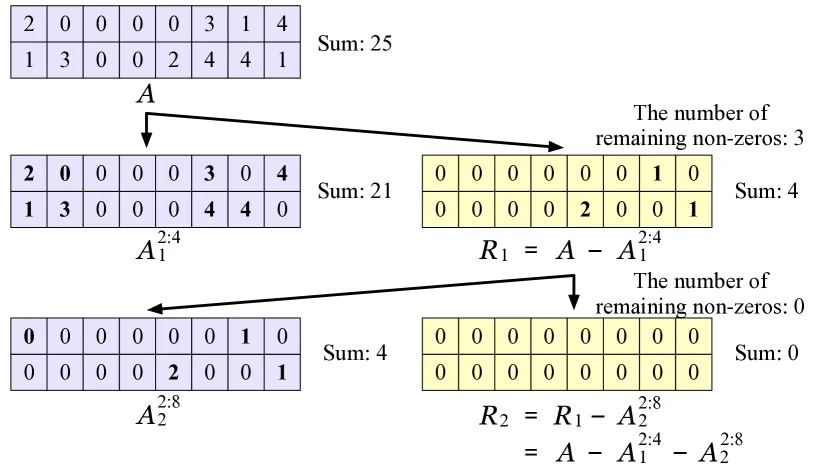
以一个 2×8 的矩阵 A 为例(37.5%稀疏度):
- 第一项:提取 2:4 结构化稀疏视图,覆盖 70% 非零值和 84% 幅度
- 第二项:对残差矩阵继续提取 2:8 结构化稀疏视图
- 最终:两项之和完全覆盖原矩阵(无损近似)
2.3 与 Taylor 级数的类比
TASD 类似于 Taylor 级数:Taylor 级数用多项式近似任意函数,而 TASD 用结构化稀疏张量近似任意张量。每一项(残差结构化稀疏张量)都能提高近似的精度。
2.4 应用于矩阵乘法
利用分配律,矩阵乘法可分解为:
每个子项都是结构化稀疏矩阵乘法,可在现有结构化稀疏硬件上高效执行。
三、技术架构
3.1 系统架构概览
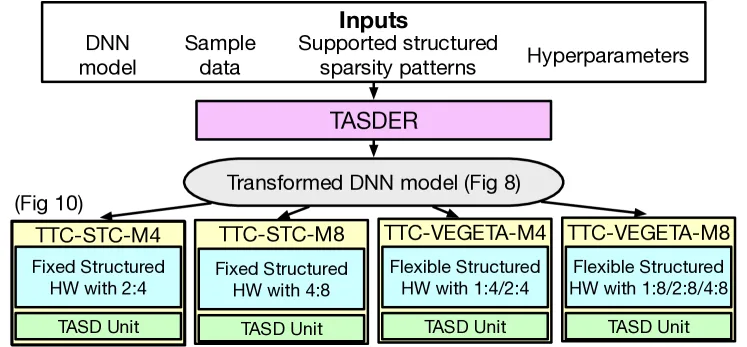
论文提出完整的软硬件协同设计:
| 组件 | 功能 |
|---|---|
| TASDER | 软件框架,搜索每层的最优TASD配置 |
| TASD-W | 对权重应用TASD(离线预处理) |
| TASD-A | 对激活值应用TASD(运行时动态分解) |
| TTC (TASD Tensor Core) | 在现有结构化稀疏加速器上的硬件扩展 |
3.2 TASDER 优化器
TASDER 接收以下输入:
- DNN 模型
- 样本数据(用于校准)
- 目标硬件信息(支持的结构化稀疏模式)
- 超参数
输出每层的 TASD 配置,满足约束:
3.3 权重稀疏加速 (TASD-W)
- 权重是静态的,TASD 可离线预处理
- 采用贪心算法搜索最优配置
- 优先选择丢弃非零元素最少的配置
- 支持逐层自适应配置
3.4 激活值稀疏加速 (TASD-A)
- 激活值是动态生成的,需要运行时分解
- 在 ReLU 层后插入 TASD 层
- 使用校准数据集收集每层稀疏度统计
- 支持非 ReLU 激活函数(如 GeLU, Swish)的”伪密度”方法
3.5 硬件设计
论文基于 VEGETA 架构提出 TTC-VEGETA:
- 支持 1:8, 2:8, 4:8 三种基础结构化稀疏模式
- 通过 TASD 可支持 7 种 N:8 模式(见下表)
- 仅需增加 2% 的芯片面积(TASD单元)
| 稀疏模式 | TASD 级数 |
|---|---|
| 1:8 | 1:8 (1项) |
| 2:8 | 2:8 (1项) |
| 3:8 | 2:8 + 1:8 (2项) |
| 4:8 | 4:8 (1项) |
| 5:8 | 4:8 + 1:8 (2项) |
| 6:8 | 4:8 + 2:8 (2项) |
| 7:8 | - (需3项,实践中少用) |
四、核心创新
4.1 创新点总结
| 创新点 | 描述 |
|---|---|
| TASD 方法 | 首次提出用结构化稀疏张量级数近似非结构化稀疏张量 |
| TASDER 框架 | 自动搜索逐层最优 TASD 配置的软件框架 |
| 硬件扩展 | 在现有结构化稀疏加速器上的低开销架构扩展 |
| 分解感知数据流 | 优化的数据复用策略,最小化分解开销 |
4.2 与现有方案对比
| 硬件类型 | 密集权重 | 非结构化稀疏权重 | 结构化稀疏权重 | 密集激活 | 非结构化稀疏激活 | 面积开销 |
|---|---|---|---|---|---|---|
| 密集加速器 | ✓ | ✗ | ✗ | ✓ | ✗ | 低 |
| 非结构化稀疏加速器 | ✗ | ✓ | ✓ | ✗ | ✓ | 高(32-38%) |
| 结构化稀疏加速器 | ✓ | ✗ | ✓ | ✓ | ✗ | 低 |
| TASD (本文) | ✓ | ✓ | ✓ | ✓ | ✓ | 低(~2%) |
4.3 关键优势
- 无需微调:直接加速现成的密集和稀疏 DNN 模型
- 硬件无关:TASDER 可适配不同结构化稀疏硬件
- 低面积开销:仅需 ~2% 额外芯片面积
- 双向支持:同时支持权重和激活值稀疏加速
五、实验结果
5.1 实验设置
| 硬件设计 | 稀疏支持 |
|---|---|
| TC (密集基线) | 无 |
| DSTC (非结构化稀疏) | 非结构化 |
| TTC-STC-M4 | 2:4 (TASD 1项) |
| TTC-STC-M8 | 4:8 (TASD 1项) |
| TTC-VEGETA-M4 | 1:4, 2:4 (1项) + 3:4 (2项) |
| TTC-VEGETA-M8 | 1:8, 2:8, 4:8 (1项) + 3:8, 5:8, 6:8 (2项) |
5.2 EDP 性能对比
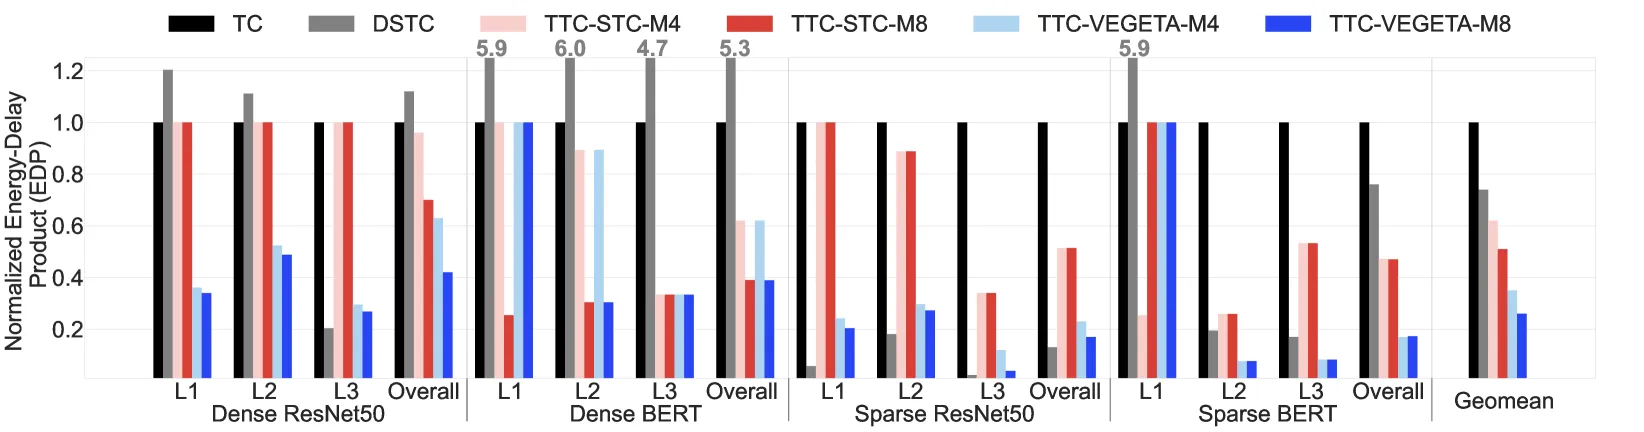
| 工作负载 | TTC-VEGETA-M8 EDP改善 | TTC-STC-M4 EDP改善 |
|---|---|---|
| Dense ResNet50 | 58% | 4% |
| Dense BERT | 61% | 32% |
| Sparse ResNet50 | 83% | 49% |
| Sparse BERT | 82% | 53% |
关键发现:
- TTC-VEGETA-M8 在所有工作负载上均显著改善 EDP
- 即使只支持单一 2:4 模式,TTC-STC-M4 也能获得显著收益
- DSTC 在密集模型上甚至会降低性能(+12% 和 +167% EDP)
5.3 延迟和能耗分析
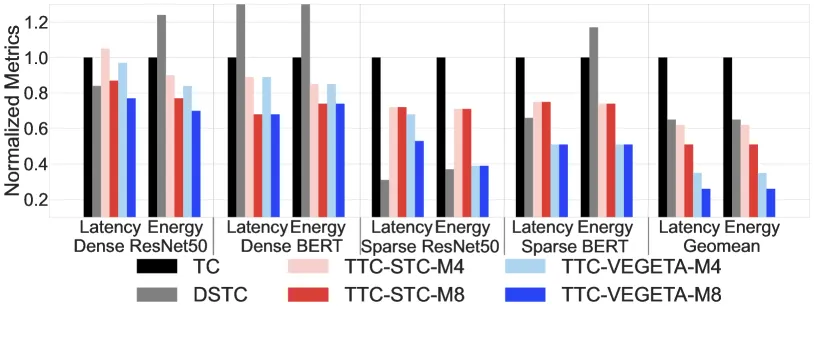
- TTC-VEGETA-M8 在所有工作负载上能效最高
- 仅在 Sparse ResNet50 上比 DSTC 慢 22%(但能效更优)
- 考虑面积开销,TASD 提供了更好的整体权衡
5.4 计算量减少
| 模型类型 | MAC 减少比例 |
|---|---|
| 稀疏 ResNet/VGG 系列 (TASD-W) | ~49% |
| 密集 CNN/Transformer (TASD-A) | ~32% |
5.5 面积和能耗开销
| 指标 | 数值 |
|---|---|
| TASD 单元面积开销 | ≤2% (相比所有PE) |
| 分解感知数据流能耗节省 | 55% (相比密集TC) |
5.6 逐层 vs 全网络 TASD
逐层自适应 TASD 显著优于全网络统一配置:
- Sparse ResNet50: EDP 改善从 75% 提升到 83%
- 通过调整超参数 α 控制近似的激进程度
六、相关工作
6.1 需要微调的方案
| 方法 | 特点 | 与TASD的关系 |
|---|---|---|
| DominoSearch | 搜索逐层 N:M 稀疏模式 | 正交,可结合 |
| Optimal N:M | 训练时强制结构化模式 | 正交,可结合 |
| Doping | Kronecker 乘积改善模型质量 | 不同目标 |
6.2 无需微调的方案
| 方法 | 特点 | 局限性 |
|---|---|---|
| SparseTIR | 可组合的稀疏编译格式 | 未考虑结构化稀疏硬件加速 |
| Channel Permutation | 通道置换恢复精度 | 需要额外处理 |
6.3 硬件加速方案
| 类别 | 代表工作 | 面积开销 | 灵活性 |
|---|---|---|---|
| 非结构化稀疏 | SCNN, SIGMA, DSTC | 32-38% | 高 |
| 结构化稀疏 | STA, NV-STC, VEGETA | 低 | 低 |
| TASD (本文) | TTC-VEGETA | ~2% | 高 |
七、总结
7.1 主要贡献
- 首次提出 TASD 方法:桥接非结构化稀疏 DNN 和结构化稀疏硬件的鸿沟
- TASDER 软件框架:自动搜索逐层最优分解配置
- 低开销硬件扩展:在现有结构化稀疏加速器上仅需 ~2% 面积开销
- 显著性能提升:EDP 改善最高 83%,平均 74%,实际系统加速最高 39%
7.2 核心价值
- 对模型开发者:保持非结构化稀疏的灵活性,无需关心硬件约束
- 对硬件设计师:维持结构化稀疏的高效性,无需支持复杂的非结构化模式
- 对系统整体:在不微调的情况下加速现成的密集和稀疏模型
7.3 局限性与未来方向
- 当前仅针对推理,训练阶段的 TASD 应用有待探索
- 非 ReLU 激活函数(GeLU, Swish)的”伪密度”方法精度有限
- 7:8 等高密度模式需要 3 项 TASD,实际应用受限
- 与通道置换等正交技术的结合有望进一步提升精度
八、参考资源
8.1 论文链接
- arXiv: https://arxiv.org/abs/2403.07953
- PDF: https://arxiv.org/pdf/2403.07953
- HTML: https://arxiv.org/html/2403.07953v1
8.2 关键图表
| 图表 | 说明 | 文件 |
|---|---|---|
| Figure 1 | 不同稀疏利用流程对比 | fig1-sparse-flows.png |
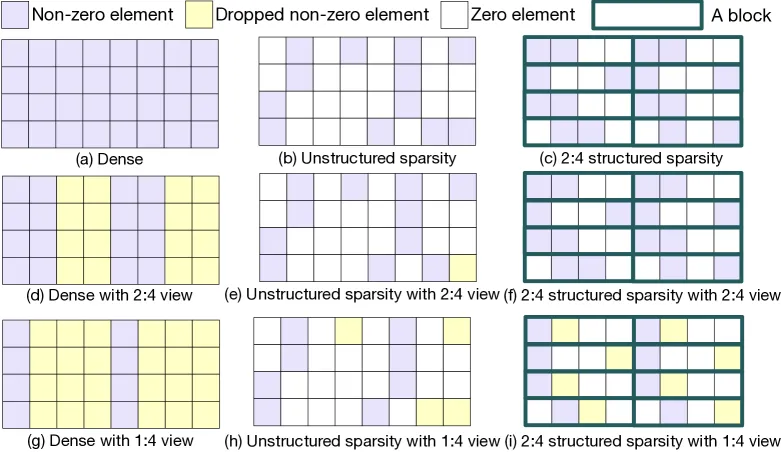
| Figure 2 | 不同稀疏模式和视图 | fig2-sparsity-patterns.png |
| Figure 3 | TASD 接口示意 | fig3-tasd-interface.png |
| Figure 4 | TASD 分解示例 | fig4-tasd-example.png |
| Figure 5 | 丢弃非零元素分析 | fig5-dropped-nonzeros.png |
| Figure 6 | 矩阵乘法误差分析 | fig6-matmul-error.png |
| Figure 7 | 系统架构概览 | fig7-system-overview.png |
| Figure 14 | EDP 性能对比 | fig14-edp-results.png |
| Figure 15 | 延迟和能耗分析 | fig15-latency-energy.png |


8.3 相关项目
- Sparseloop: 稀疏张量加速器建模框架
- SparseZoo: 预训练稀疏模型库
- VEGETA: 结构化稀疏张量加速器架构
8.4 引用格式
@article{jeong2024enabling,
  title={Enabling Unstructured Sparse Acceleration on Structured Sparse Accelerators},
  author={Jeong, Geonhwa and Tsai, Po-An and Bambhaniya, Abhimanyu R. and Keckler, Stephen W. and Krishna, Tushar},
  journal={arXiv preprint arXiv:2403.07953},
  year={2024}
}