Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (Stable Diffusion 3)
Stability AI 的 SD3 论文:改进的 Rectified Flow 时间步采样 + 多模态 MM-DiT 架构,在高分辨率文生图上超越 DALL·E 3 等 SOTA
Scaling Rectified Flow Transformers for High-Resolution Image Synthesis:Stable Diffusion 3 技术解析
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scaling Rectified Flow Transformers for High-Resolution Image Synthesis |
| 作者 | Patrick Esser, Sumith Kulal, Andreas Blattmann, Rahim Entezari, Jonas Müller, …, Robin Rombach(共 17 人) |
| 机构 | Stability AI |
| 论文 | https://arxiv.org/abs/2403.03206 |
| 发布 | 2024-03-05(ICML 2024,SD3 技术报告) |
| 模型 | Stable Diffusion 3(最大 8B 参数,depth=38) |
SD3 是 Rectified Flow(RF)+ Transformer 路线的集大成者。它一方面用改进的时间步采样让 RF 首次在大规模高分辨率文生图上决定性地超越传统扩散公式;另一方面提出多模态 MM-DiT 架构(图文双流独立权重 + 联合注意力),显著提升文本理解、排版(typography)与人类偏好评分。8B 模型在 Parti-prompts 上超越 DALL·E 3、Midjourney、Ideogram 等 SOTA。
二、核心思想
问题定义
Rectified Flow(RF) 用直线连接数据与噪声,理论性质优良、概念简洁,但此前尚未在实践中被确立为标准——已有优势多限于小/中规模的类别条件模型。SD3 要回答两个问题:
- 在大规模高分辨率文生图上,RF 是否真能超越成熟的扩散公式(LDM-Linear、EDM 等)?如何改进 RF 训练?
- 如何设计能同时处理文本 + 图像两种模态、且可预测扩展(scaling)的 Transformer 骨干?
解决方案概述
- 改进 RF 时间步采样:RF 损失对所有时间步均匀训练,但中间时间步的速度预测目标 最难。SD3 用 logit-normal 分布对中间步加权,显著提升性能;
- MM-DiT 架构:图文两模态使用独立的权重集(相当于两个 Transformer),但在注意力时拼接序列联合计算,实现双向信息流;
- 一系列工程改进:QK-RMSNorm 稳定高分辨率混合精度训练、分辨率相关的时间步偏移、16 通道 VAE、三文本编码器、合成 caption、DPO 对齐;
- 可预测扩展:验证损失随模型规模与训练步数平滑下降,且与 GenEval / 人类偏好强相关,无饱和迹象。
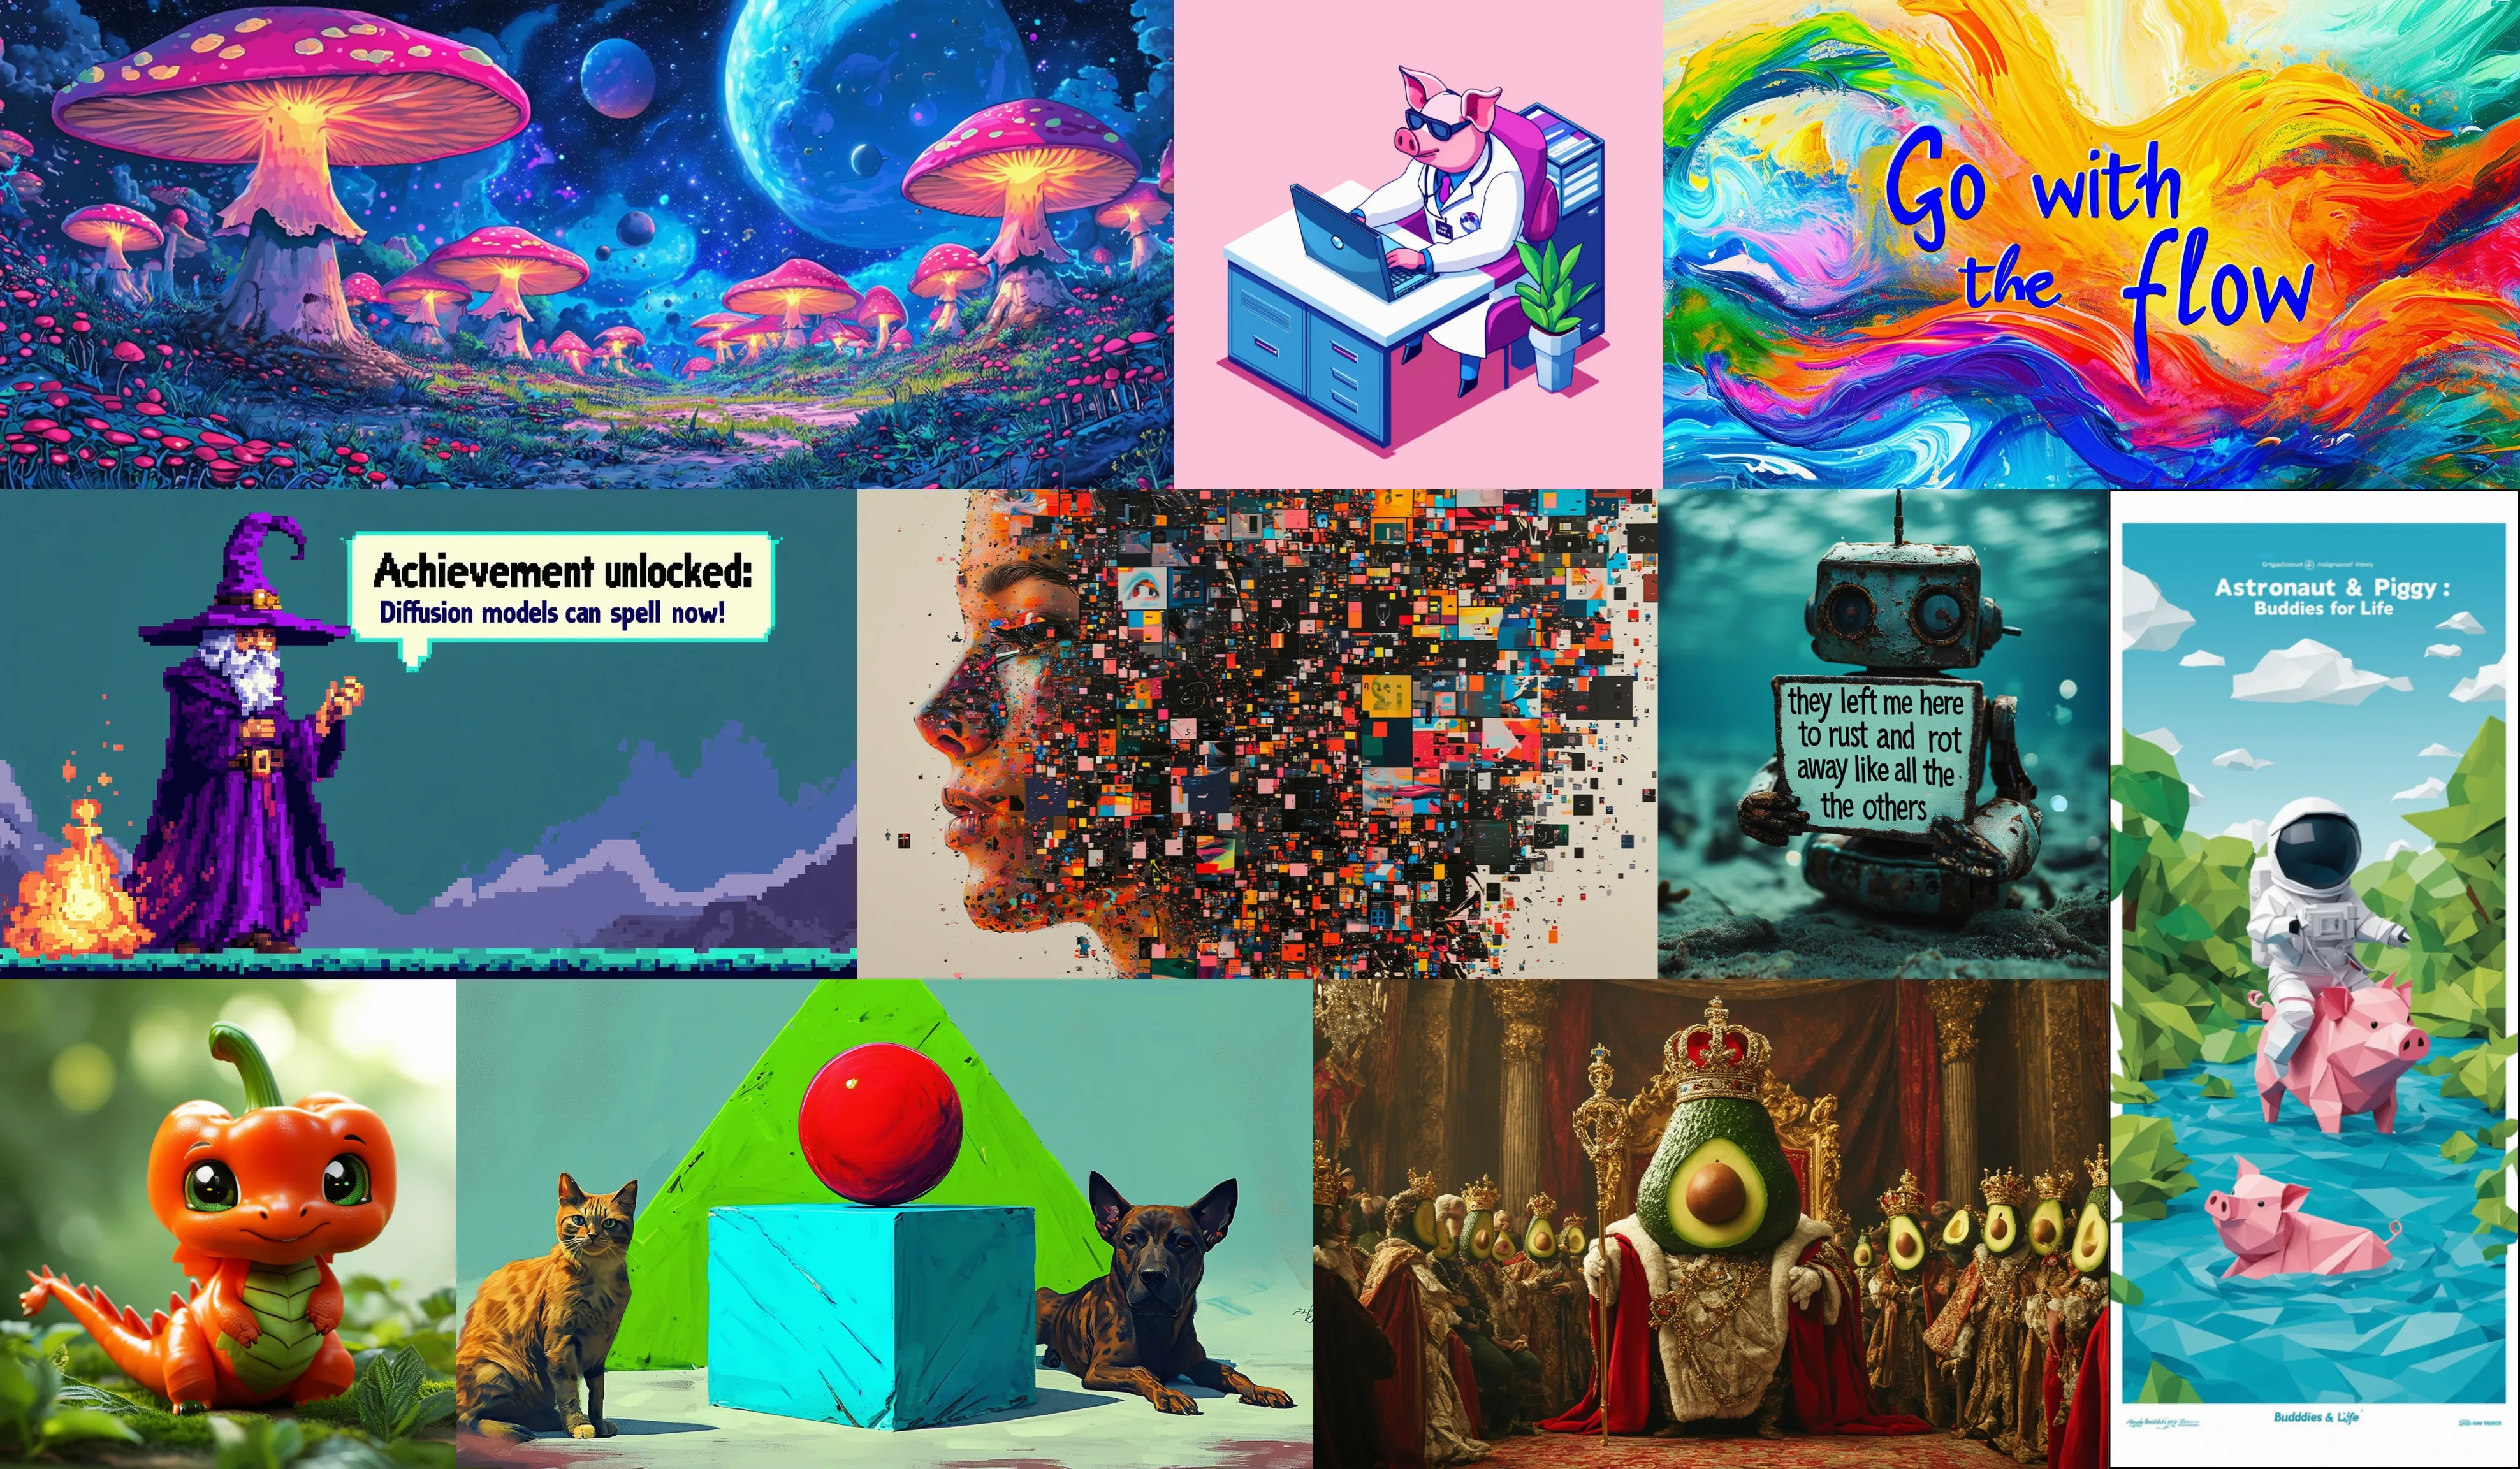
Figure 1:8B rectified flow 模型的高分辨率样本,展示排版、精确 prompt 遵循、空间推理、细节与多样风格。
三、技术架构
3.1 流轨迹公式与统一视角
生成模型将噪声 通过前向路径 连接数据 。不同公式对应不同 :
Rectified Flow(本文主力)——直线路径:
z_t=(1-t)x_0+t\epsilon \tag{13}
网络直接参数化速度 ,对应 CFM 损失权重 。
其它对比公式:
- EDM:,,F-预测;
- Cosine:;
- (LDM-)Linear:方差保持调度 (DDPM/LDM 的 调度)。
3.2 定制 SNR 采样器(核心创新之一)
RF 损失对 均匀训练,但中间时间步预测最难( 时最优预测是 均值, 时是 均值)。将 的分布从均匀 改为密度 等价于加权损失:
w_t^\pi=\frac{t}{1-t}\pi(t) \tag{18}
Logit-Normal 采样(最优选择)——对中间步加权:
\pi_{\mathrm{ln}}(t;m,s)=\frac{1}{s\sqrt{2\pi}}\frac{1}{t(1-t)}\exp\!\Big(-\frac{(\mathrm{logit}(t)-m)^2}{2s^2}\Big) \tag{19}
其中 ,位置参数 可将训练偏向数据()或噪声(),尺度参数 控制宽度。实践中采样 再经 logistic 函数映射。
Mode Sampling with Heavy Tails:logit-normal 在端点 0/1 处密度为零,作者另设计在 上严格正密度的分布作对照。
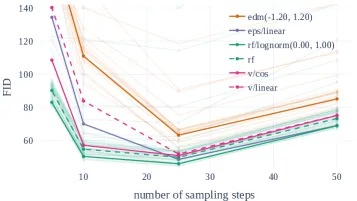
Figure 3:Rectified Flow 采样高效——步数减少时性能下降幅度小于其它公式。25 步以上仅 rf/lognorm(0.00,1.00) 与 eps/linear 竞争。
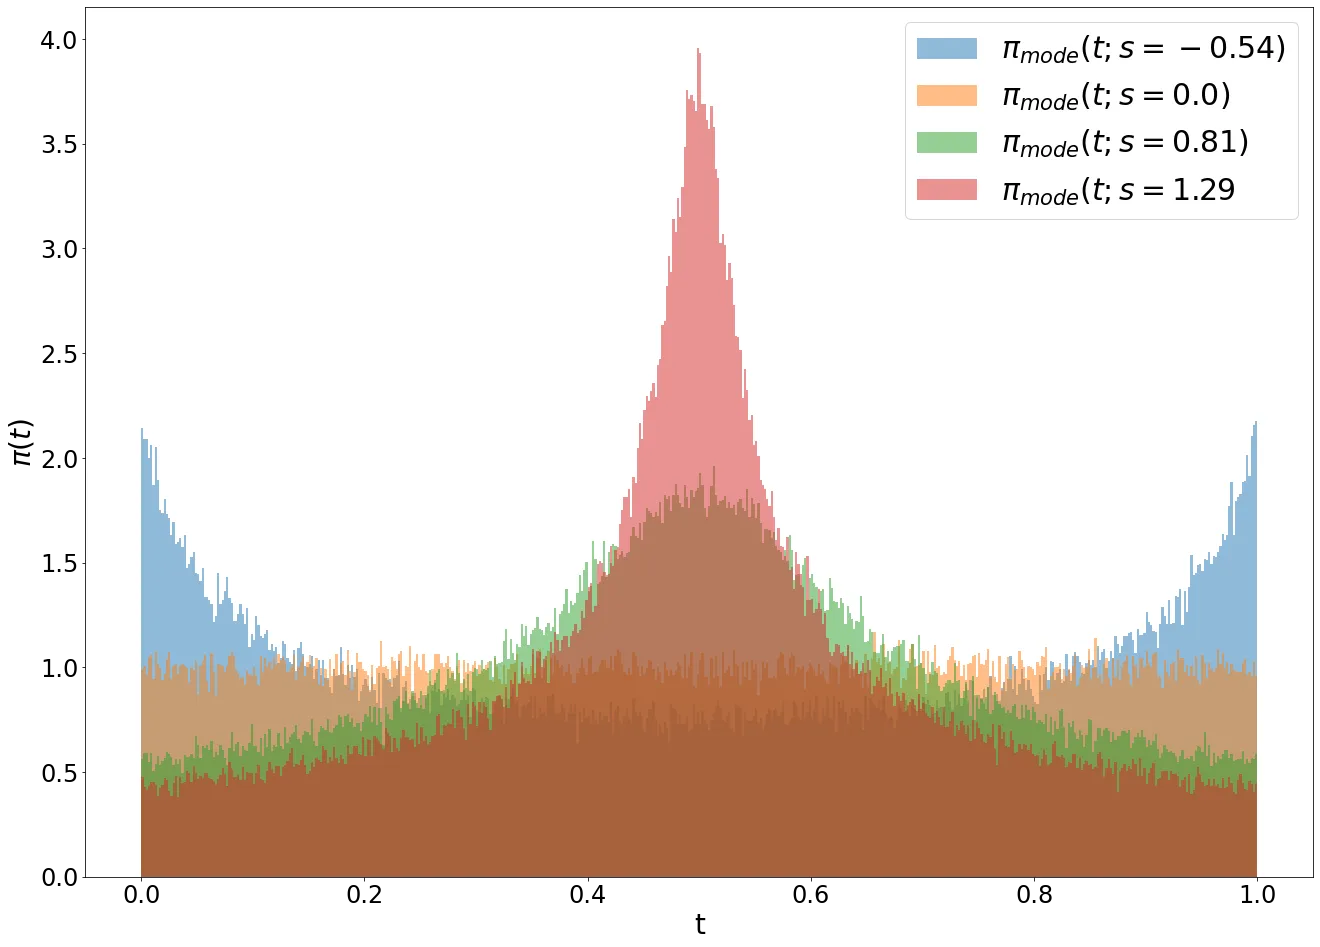
Figure 11:mode(左)与 logit-normal(右)分布,用于对采样偏置。
3.3 多模态扩散骨干 MM-DiT(核心创新之二)
基于 DiT,但 DiT 仅处理类别条件。SD3 的 MM-DiT:
条件来源:
- timestep 与 pooled 文本表示 (CLIP-L + CLIP-G 池化)→ 送入 modulation 机制(类 adaLN);
- 序列文本表示 (因池化只保留粗粒度信息,需序列级信息)→ 拼入 token 序列。
序列构造:
- 图像潜表示 做 patch + 位置编码,得长度 的序列;
- 文本编码 嵌入到相同维度;
- 两序列拼接后经调制注意力 + MLP。
双流独立权重:文本与图像使用两套独立权重(等价于两个独立 Transformer),但在注意力操作时联合序列——各自在自己空间工作,同时考虑对方。
文本流(c)                             图像流(x)
  │ LayerNorm + Mod(α_c,β_c)            │ LayerNorm + Mod(α_x,β_x)
  │ Linear→Q,K,V (可选 RMSNorm Q/K)     │ Linear→Q,K,V (可选 RMSNorm Q/K)
  └──────────┐              ┌───────────┘
             ▼              ▼
        [拼接 Q,K,V 联合注意力 Attention]
             │              │
  ┌──────────┘              └───────────┐
  │ Linear + gate γ_c  残差             │ Linear + gate γ_x  残差
  │ LayerNorm + Mod(δ_c,ε_c) + MLP      │ LayerNorm + Mod(δ_x,ε_x) + MLP
  │ + gate ζ_c 残差                     │ + gate ζ_x 残差
(y = timestep + pooled text 经 SiLU→Linear 产生各调制参数)规模参数化:以深度 (注意力块数)参数化,隐藏维 (MLP 扩展至 ),注意力头数 。8B 模型 。
3.4 关键工程改进
QK-Normalization(稳定高分辨率训练):高分辨率微调时混合精度训练会发散(注意力 logit 无界增长导致熵坍塌,且出现在网络最后几个 block)。SD3 在 MM-DiT 两条流的 Q、K 上加 可学习尺度的 RMSNorm,配合 AdamW ,实现 bf16-mixed 稳定训练。
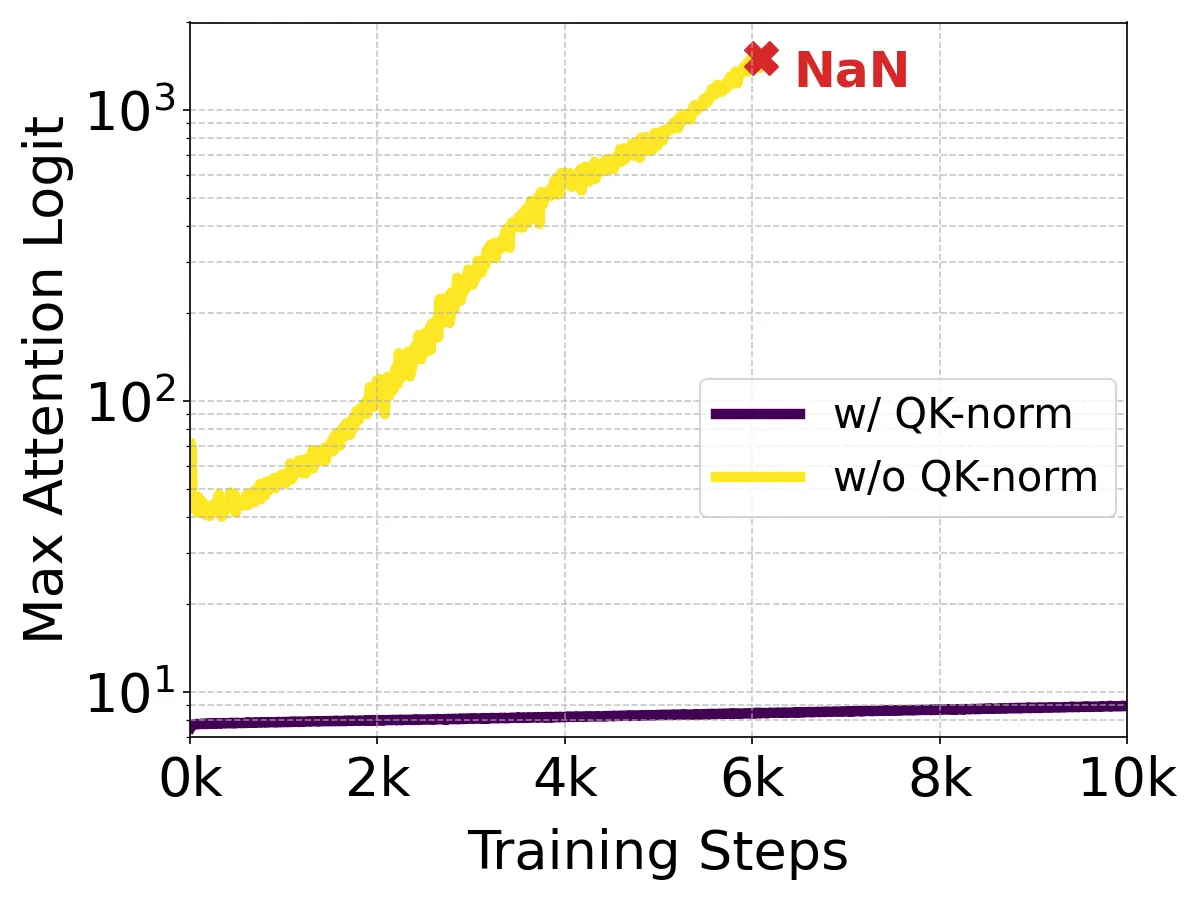
Figure 5:QK-normalization 防止注意力 logit 增长不稳定(左)及熵坍塌(右)。
分辨率相关的时间步偏移:高分辨率像素多,需更多噪声才能破坏信号。对 像素的常数图像,恢复不确定性 ——分辨率翻倍不确定性减半。因此从分辨率 迁移到 时按下式偏移时间步:
t_m=\frac{\sqrt{m/n}\,t_n}{1+(\sqrt{m/n}-1)t_n} \tag{23}
等价于 log-SNR 偏移 :,其中 。人类偏好研究显示 明显更优,1024×1024 训练/采样均用 。
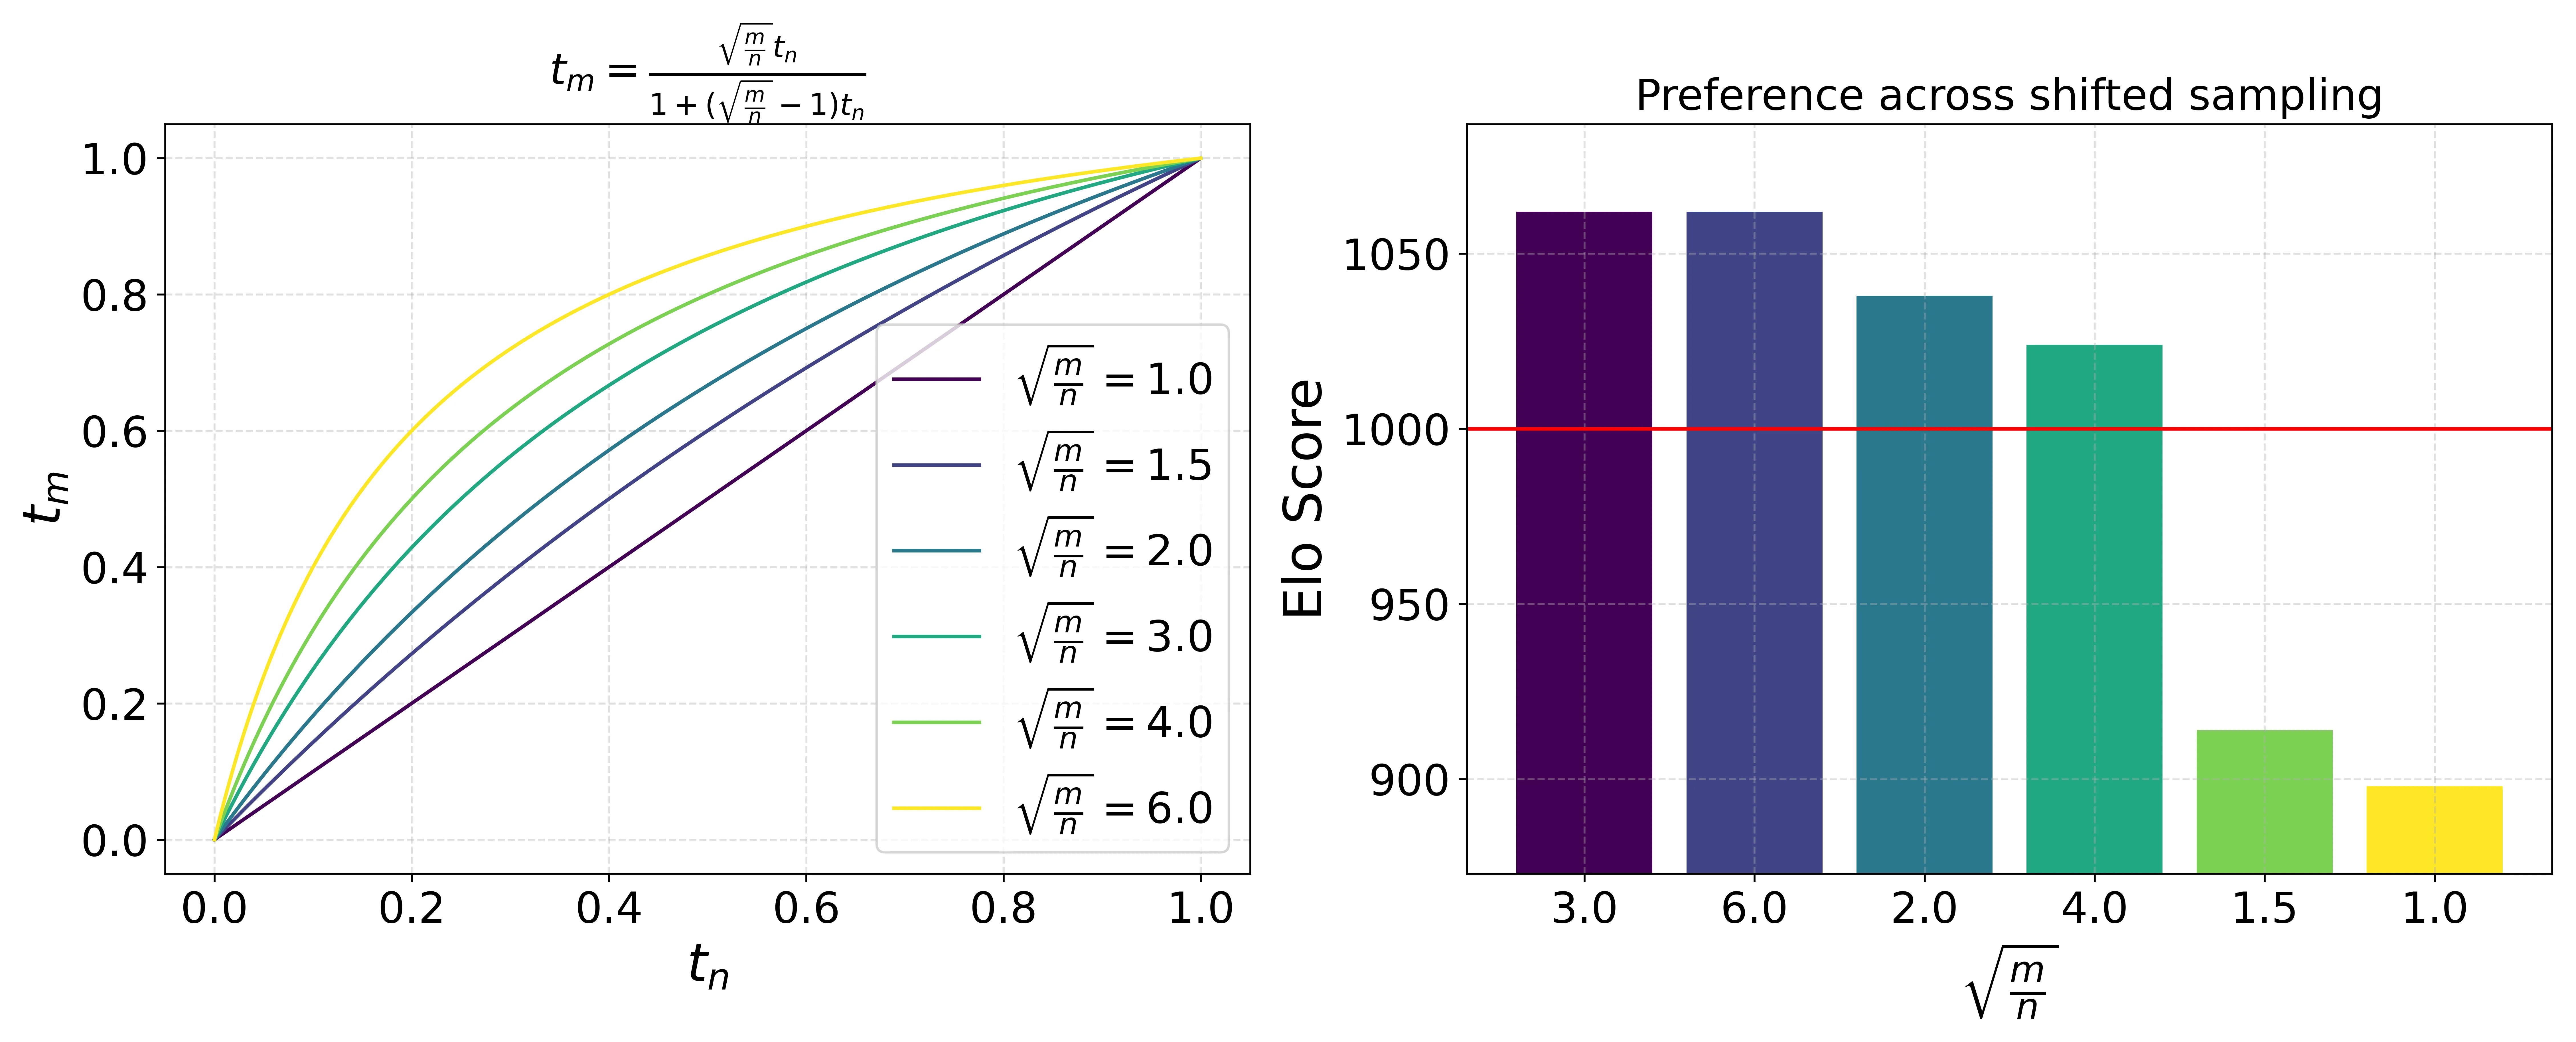
Figure 6:高分辨率下的时间步偏移。(下)比 1.0(上)质量显著更好。
16 通道 VAE:VAE 重建质量是图像质量上界。增加潜通道数 显著提升重建,但需更大模型容量匹配。 在 时相比 8 通道差距可忽略,故最终选 16 通道(下采样因子 8)。
三文本编码器:CLIP-L/14 + CLIP-G/14 + T5-XXL。训练时各自独立 dropout(46.3%),推理可用任意子集。移除 T5 对多数 prompt 影响小,但复杂/长文本、精确排版时 T5 重要。
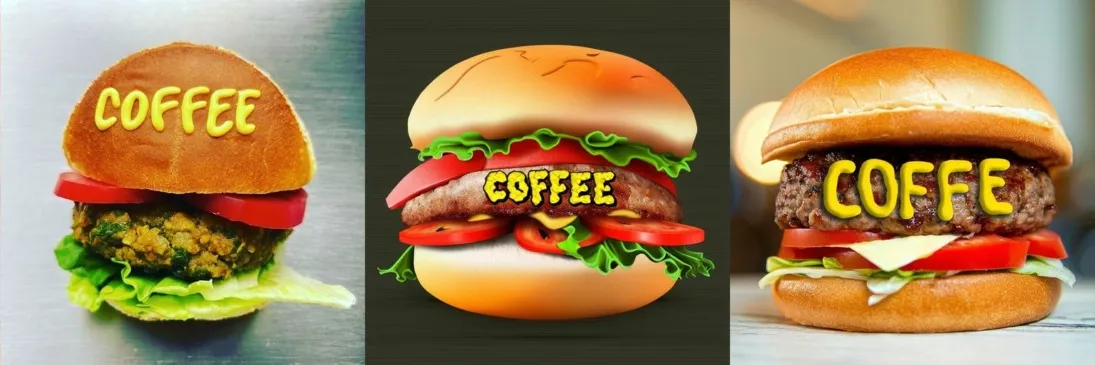
Figure 9:T5 对涉及大量细节或长文本的复杂 prompt(第 2、3 行)很重要。
DPO 对齐:1024 训练后用 Direct Preference Optimization 微调——不改整模型,而是为所有线性层加 rank-128 LoRA,2B/8B 分别微调 4k/2k 步。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| Logit-Normal 时间步采样 | 对中间时间步加权,让 RF 首次全面超越扩散公式 | 式(18)(19),61 种公式大规模对比 |
| MM-DiT 双流架构 | 图文独立权重 + 联合注意力,双向信息流 | 图 2;提升文本理解/排版/偏好 |
| QK-RMSNorm | 稳定高分辨率 bf16-mixed 训练,避免熵坍塌 | 图 5 |
| 分辨率相关时间步偏移 | 高分辨率需更多噪声,log-SNR 偏移 | 式(23), |
| 16 通道 VAE | 提升重建上界,配合大模型容量 | 图 10,Table 3 |
| 可预测 scaling | 验证损失平滑下降且与评测强相关,无饱和 | 图 8 |
五、实验结果
5.1 RF 公式对比(61 种)
在 ImageNet 和 CC12M 上训练 61 种公式,用非支配排序按 CLIP + FID 在 24 种设置下排名求平均:
- rf/lognorm(0.00, 1.00) 一致取得优良排名,超越均匀采样的 RF 及此前的 LDM-Linear(eps/linear);
- 仅改进时间步采样的 RF 变体优于 LDM-Linear;
- rf/lognorm 在多指标多数据集上稳健(少步/多步均衡)。
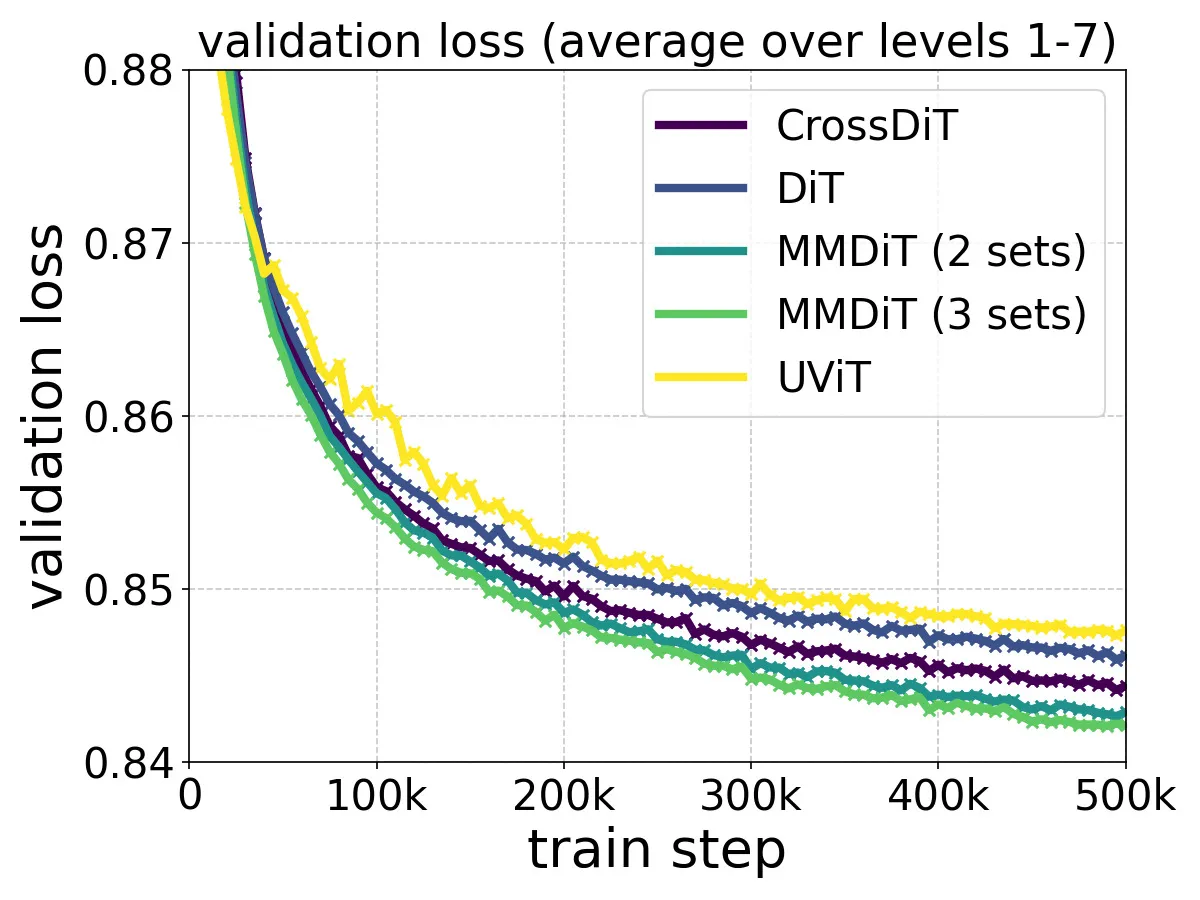
Figure 4:DiT、CrossDiT、UViT、MM-DiT 训练动态对比——MM-DiT 收敛最优。
5.2 Scaling 研究
图像:batch 4096,256² 训 500k 步, patch,CoCo 验证损失。视频:从图像权重出发 + 2× 时序 patch + 时空全注意力,Kinetics 验证。
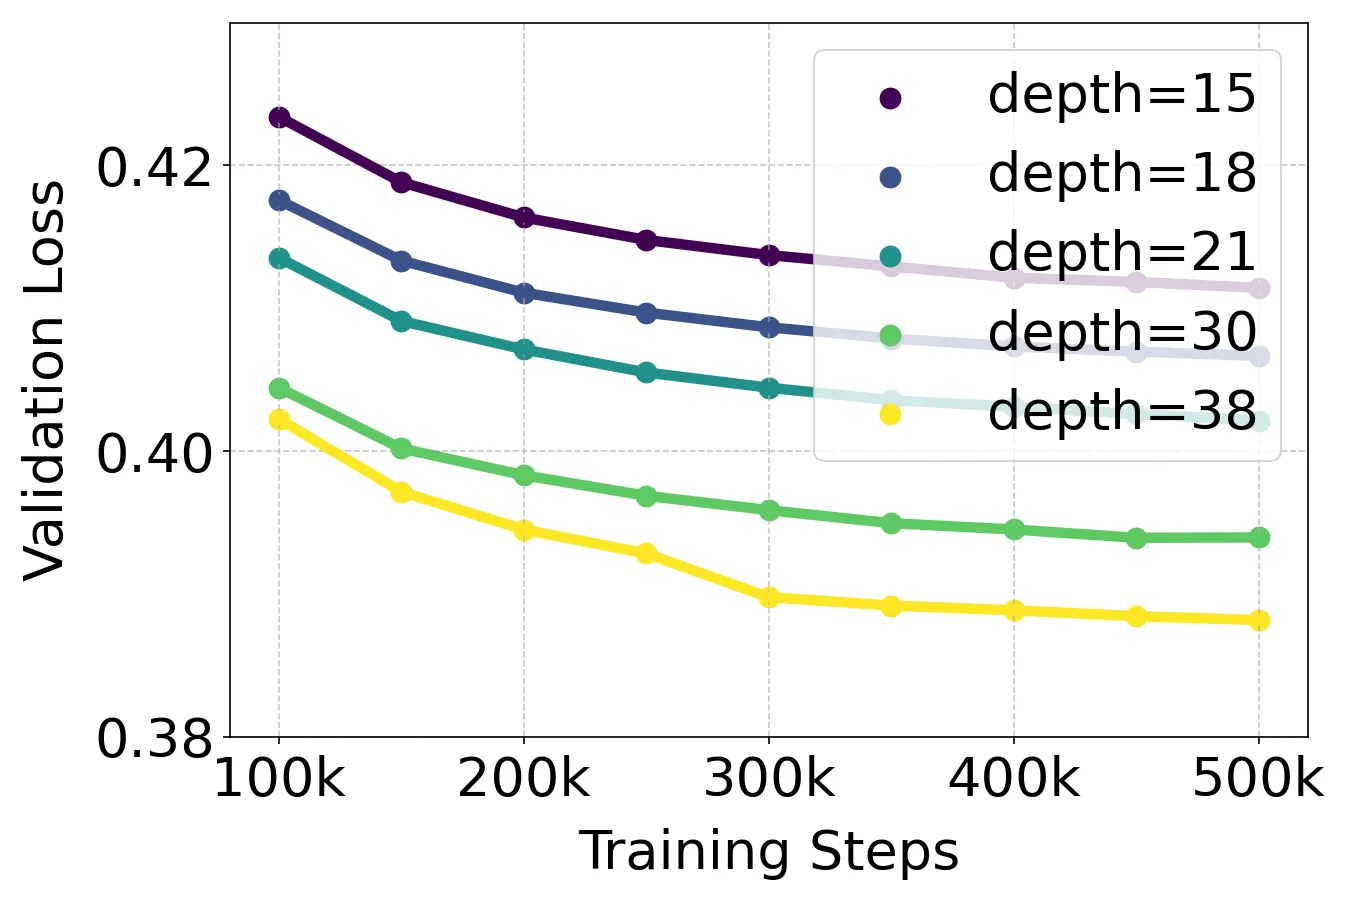
Figure 8:验证损失随模型规模与训练步数平滑下降(上),且与 GenEval、人类偏好、T2I-CompBench 强相关(下),图像与视频皆然,无饱和。
结论:验证损失是模型性能的简单通用度量;扩展到 8B 参数、 训练 FLOPs 仍无饱和。
5.3 与 SOTA 对比
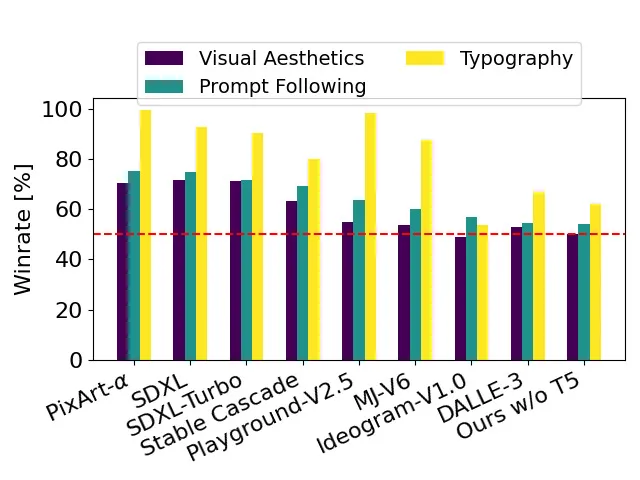
Figure 7:8B 模型在 Parti-prompts 上于视觉质量、prompt 遵循、排版生成三方面对比闭源与开源 SOTA 均占优。
- (8B)模型在 Parti-prompts 人类偏好评测(视觉美学 / prompt 遵循 / 排版生成)超越 DALL·E 3、Ideogram、SDXL、PixArt-α、Würstchen 等;
- GenEval(Table 5):最大模型在多数类别领先,总分超越 DALL·E 3(当前 prompt 理解 SOTA);
- 合成 caption(50/50 CogVLM 合成 + 原始)比纯原始 caption 明显提升 GenEval(Table 4)。
六、总结
核心贡献
- 改进 RF 训练:提出 logit-normal 等定制 SNR 采样器,通过 61 种公式的大规模研究证明改进后的 RF 在高分辨率文生图上决定性超越成熟扩散公式;
- MM-DiT 架构:图文双流独立权重 + 联合注意力,显著提升文本理解、排版与人类偏好;
- 系统工程:QK-RMSNorm、分辨率相关时间步偏移、16 通道 VAE、三文本编码器、合成 caption、DPO 对齐;
- 可预测 scaling:验证损失平滑下降且强相关于综合评测,8B 模型达 SOTA,并承诺开源数据、代码与权重。
技术影响
SD3 确立了 Rectified Flow + MM-DiT 为现代文生图/文生视频的主流范式,其 MM-DiT 双流设计与 logit-normal 采样被 Flux、SD3.5、以及众多视频生成模型继承。它把 Flow Matching / Rectified Flow 的理论优势真正兑现为大规模生产级模型。
局限性
- QK-Norm 并非通用配方,需按训练设置调整;
- T5-XXL 显存开销大(推理可裁剪但复杂 prompt 会掉点);
- CFG 仍需双次前向,采样成本翻倍。
七、参考资源
- 论文:https://arxiv.org/abs/2403.03206
- 相关:Rectified Flow (Liu et al. 2022)、Flow Matching (Lipman et al. 2023,
docs/2210.02747-flow-matching.md)、DiT (Peebles & Xie,docs/2212.09748-dit.md)、LDM (Rombach et al. 2022)、EDM (Karras et al. 2022)