Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations
Generative Recommenders (GR) 将推荐重新定义为序列转导任务,HSTU 编码器比 FlashAttention2 Transformer 快 5.3x-15.2x,1.5 万亿参数模型在线 A/B 测试提升 12.4%
Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations |
| 作者 | Jiaqi Zhai, Lucy Liao, Xing Liu, Yueming Wang, Rui Li, Xuan Cao, Leon Gao, Zhaojie Gong, Fangda Gu, Michael He, Yinghai Lu, Yu Shi |
| 机构 | Meta (Facebook AI Research) |
| 论文 | arXiv:2402.17152 |
| 代码 | github.com/facebookresearch/generative-recommenders |
| 会议 | ICML 2024 |
| 发布 | 2024-02-27 (v1), 2024-05-06 (v3) |
| 许可 | 未明确 |
二、核心思想
问题定义
传统深度学习推荐模型(DLRMs)面临两大核心瓶颈:
| 瓶颈 | 说明 | 现有方法的局限 |
|---|---|---|
| 特征异构性 | 数值特征、嵌入、分类特征混合使用 | 需要手工设计特征交互模块 |
| 计算不可扩展 | 模型质量随计算量增加趋于饱和 | 无法像 LLM/Vision 那样通过 scaling 提升 |
核心矛盾:DLRMs 依赖大量手工工程特征和复杂神经网络组合,但模型质量无法随计算量有效扩展。
解决方案概述
Generative Recommenders (GR) 受 Transformer 在语言和视觉领域成功的启发,提出全新范式:
- 统一特征空间:将所有异构特征(分类、数值)统一编码为单一时间序列
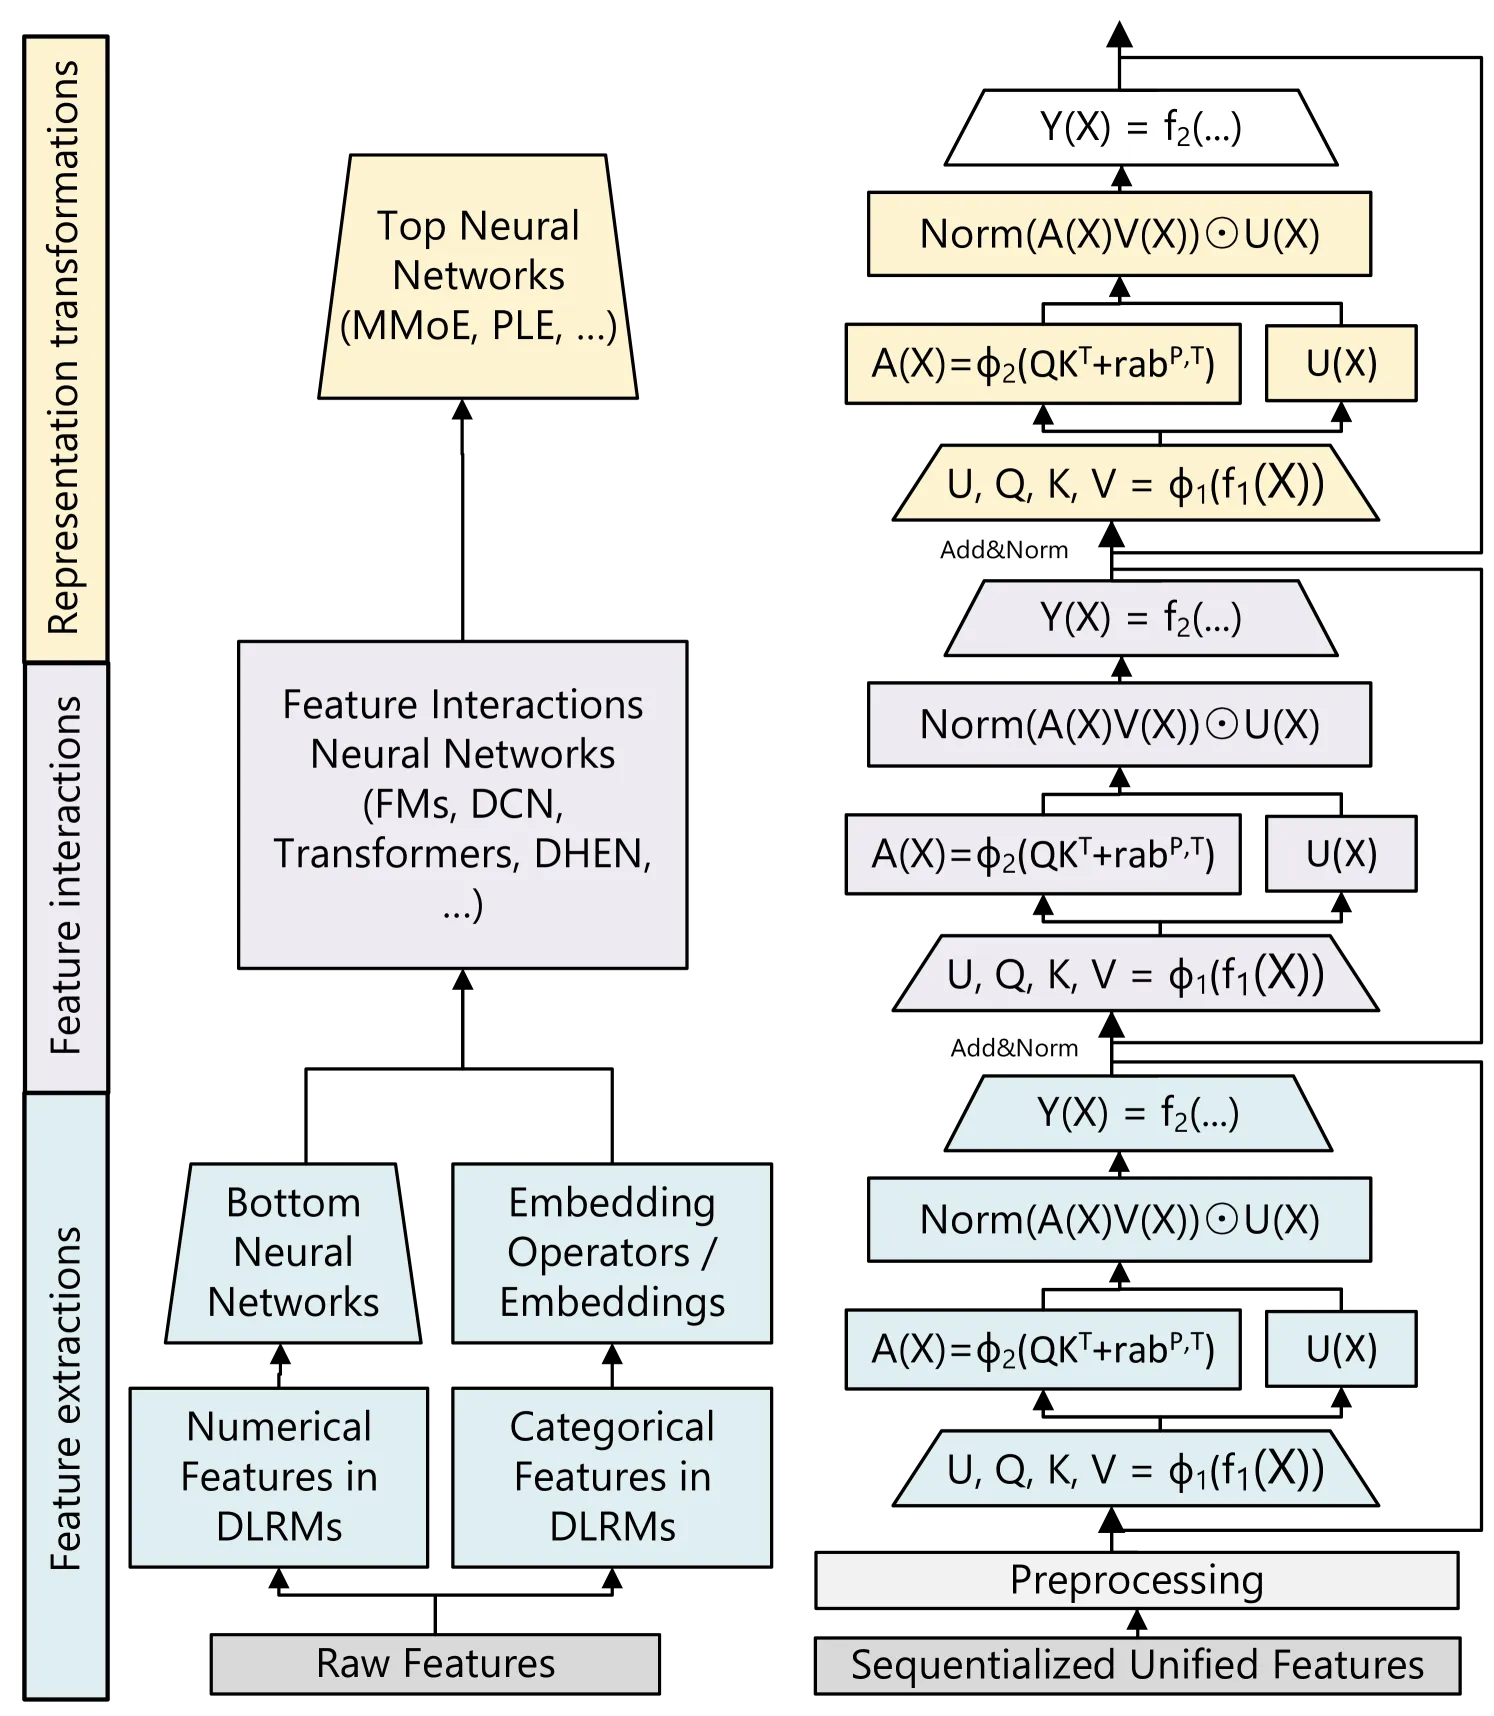
- HSTU 编码器:Hierarchical Sequential Transduction Unit,专为高基数、非平稳流式推荐数据设计
- 生成式训练:将推荐重新定义为序列转导任务,支持流式训练
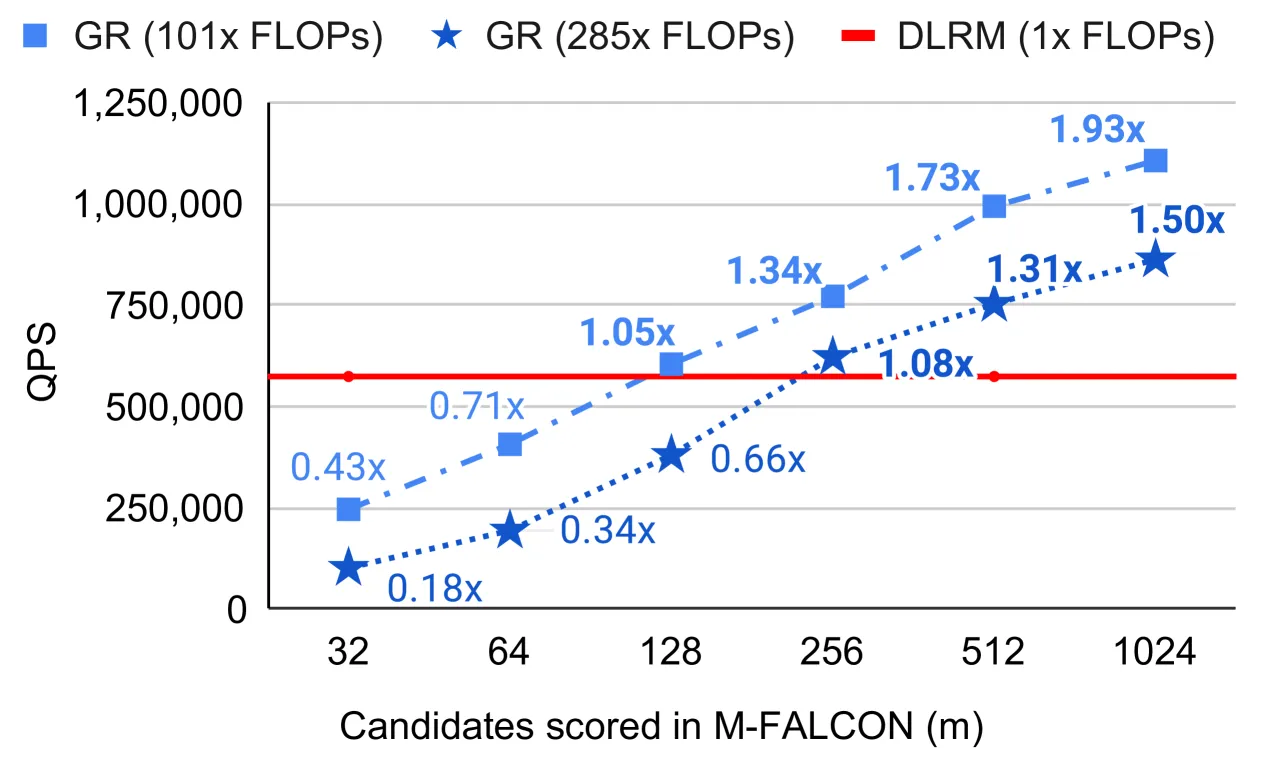
- M-FALCON 推理:Microbatched-Fast Attention Leveraging Cacheable OperatioNs,大规模候选推理加速
三、技术架构
整体框架图
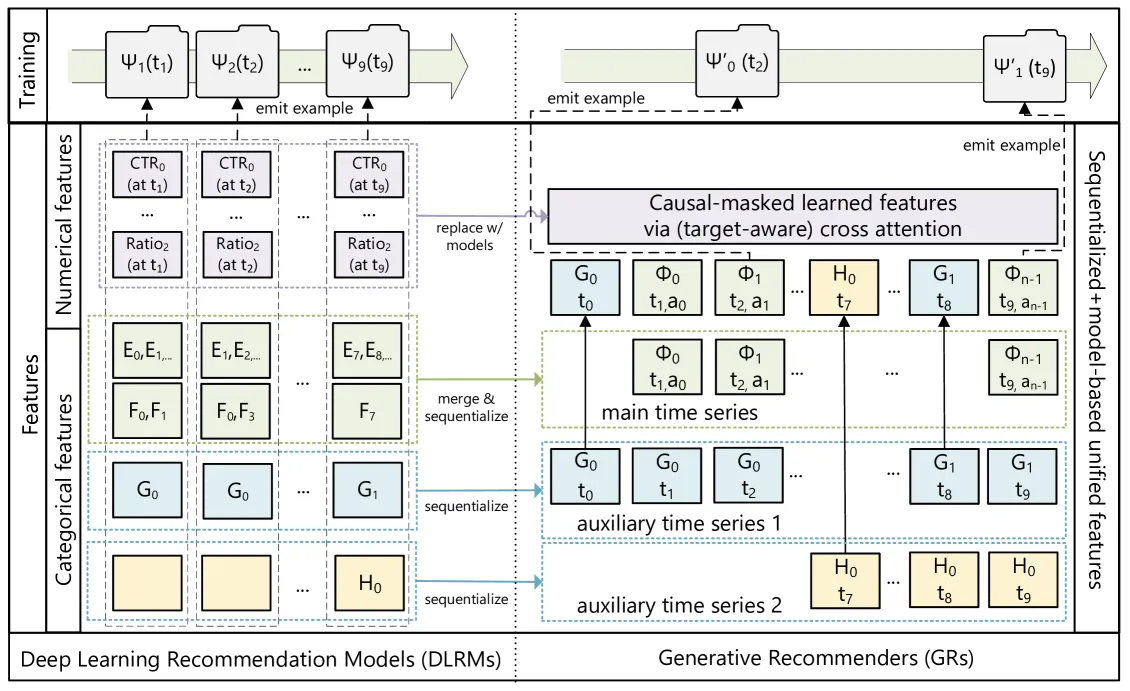
Generative Recommenders Architecture
├── Feature Unification (Section 2.1)
│   ├── Categorical Features → Sequentialize & Merge
│   ├── Numerical Features → Aggregate & Encode
│   └── Unified Time Series x₀, x₁, ..., xₙ₋₁
├── HSTU Encoder (Section 3)
│   ├── Pointwise Projection: U,V,Q,K = Split(ϕ₁(f₁(X)))
│   ├── Spatial Aggregation: A(X)V(X) = ϕ₂(QKᵀ + rab^{p,t})V(X)
│   ├── Pointwise Transformation: Y(X) = f₂(Norm(AV) ⊙ U)
│   └── Residual Connections between layers
├── Training (Section 2.3)
│   ├── Generative Objective (Next-Item Prediction)
│   ├── Stochastic Length (SL) for Efficiency
│   └── Streaming One-Pass Training
└── Inference (Section 3.4)
    └── M-FALCON Algorithm
        ├── Microbatched Parallel Candidates
        ├── Cacheable Attention Operations
        └── Sublinear Cost Scaling
核心公式
HSTU 编码器三层设计:
Pointwise Projection:
Spatial Aggregation (Pointwise Aggregated Attention):
Pointwise Transformation:
其中:
- (线性层)
- :ReLU 激活
- :点式聚合归一化(替代 softmax)
- :相对注意力偏置
Stochastic Length (SL): 其中 , 控制稀疏度。
核心创新:Pointwise Aggregated Attention
关键差异:
| 特性 | Softmax Attention | Pointwise Attention |
|---|---|---|
| 归一化 | 全序列归一化 | 点式归一化 |
| 强度捕获 | 难以捕获用户偏好强度 | 直接反映交互次数 |
| 非平稳性 | 对新词表不鲁棒 | 适应流式新内容 |
| 合成数据差距 | 基线 | +44.7% HR@10 |
设计动机:
- 用户历史中与目标相关的数据点数量是用户偏好强度的强特征
- Softmax 归一化后难以捕获这种强度信息
- Softmax 对非平稳词表不够鲁棒
Stochastic Length (SL)
核心思想:利用推荐系统中用户行为的时间重复性,随机采样子序列
效果:
- :4096 长度序列平均压缩到 776(81% 稀疏度)
- NE 退化不超过 0.002(0.2%)
- 优于现有长度外推技术(RoPE 等)
M-FALCON 推理算法
核心思想:通过微批次并行和缓存操作,将多候选排序的计算成本分摊
关键优化:
- 将 个候选分成 个微批次
- 每个微批次的注意力操作完全相同
- 交叉注意力成本从 降低到
- 缓存机制消除冗余线性和注意力计算
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 统一特征空间 | 将异构特征统一编码为时间序列 | 图 2,表 6-7 |
| HSTU 编码器 | 点式聚合注意力 + 稀疏高效内核 | 公式 1-3,图 3 |
| Pointwise Attention | 替代 softmax,捕获偏好强度 | 表 2,44.7% 差距 |
| Stochastic Length | 随机子序列采样,80%+ 稀疏度 | 图 4-5,表 3 |
| M-FALCON 推理 | 微批次并行 + 缓存,亚线性扩展 | 图 6, 12-13 |
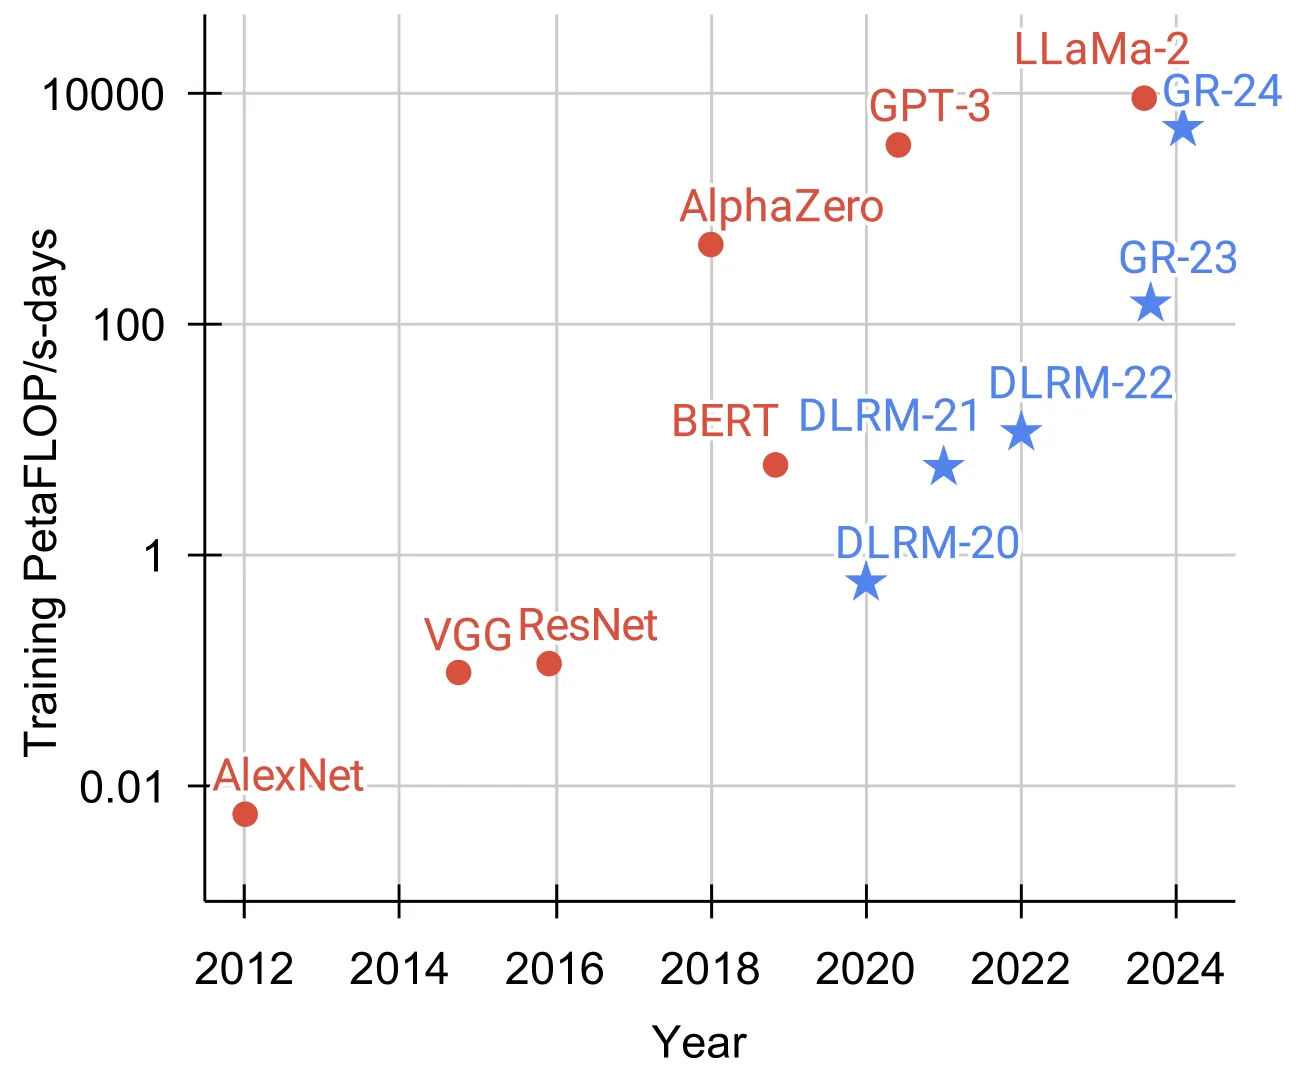
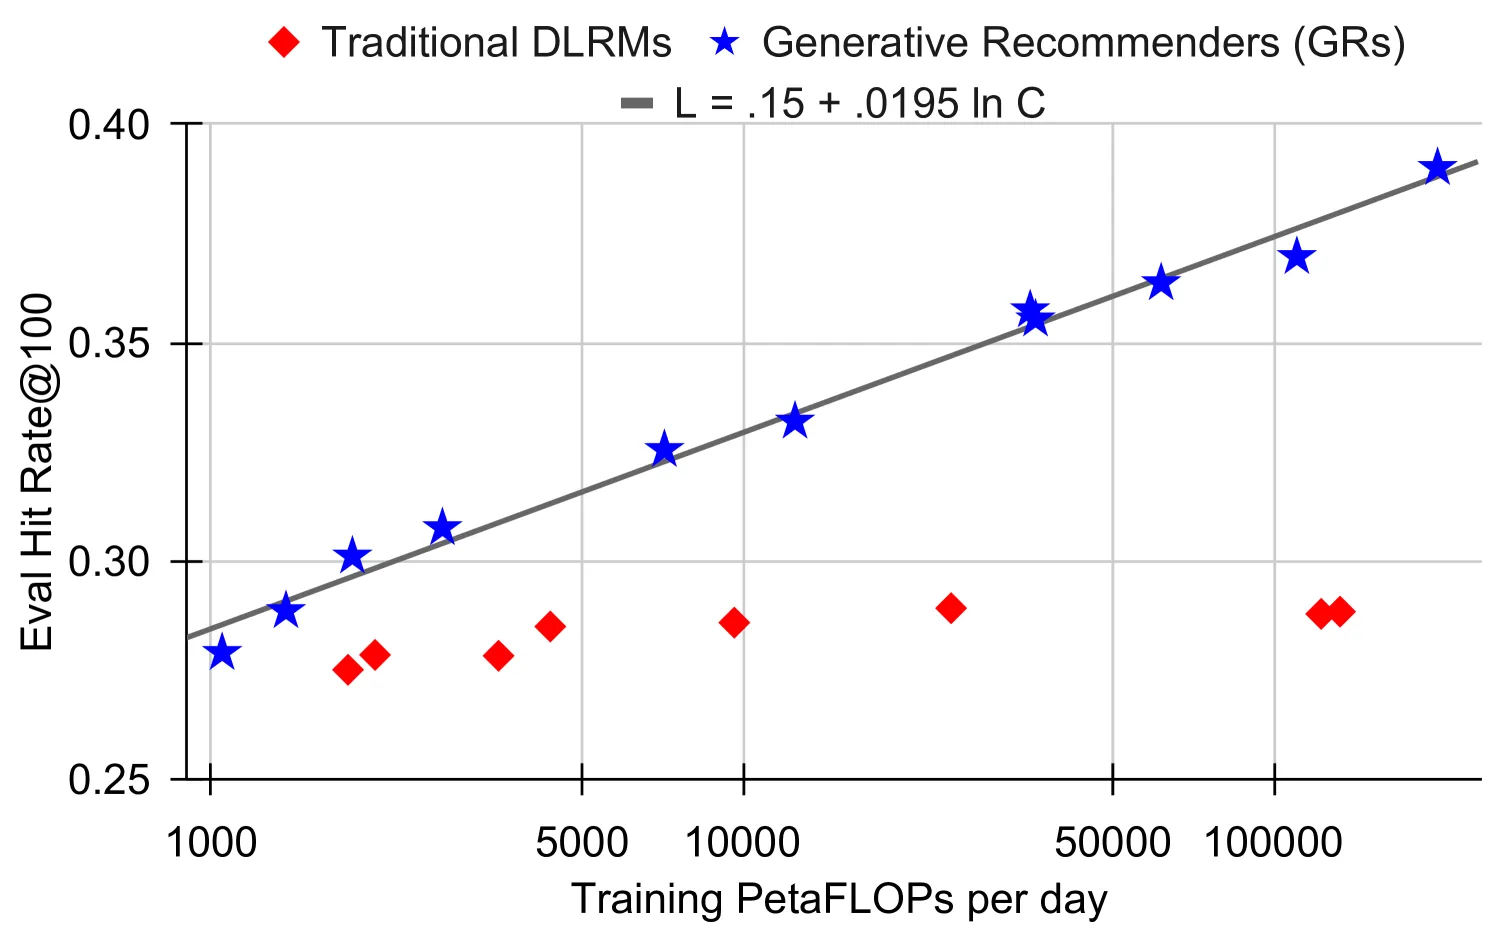
| Scaling Law | 推荐系统遵循幂律缩放 | 图 7 |
五、实验结果
公开数据集(传统顺序设置)
| 方法 | ML-1M HR@10 | ML-1M NDCG@10 | ML-20M HR@10 | ML-20M NDCG@10 | Books HR@10 | Books NDCG@10 |
|---|---|---|---|---|---|---|
| SASRec (2023) | .2853 | .1603 | .2906 | .1621 | .0292 | .0156 |
| HSTU | .3097 (+8.6%) | .1720 (+7.3%) | .3252 (+11.9%) | .1878 (+15.9%) | .0404 (+38.4%) | .0219 (+40.6%) |
| HSTU-large | .3294 (+15.5%) | .1893 (+18.1%) | .3567 (+22.8%) | .2106 (+30.0%) | .0469 (+60.6%) | .0257 (+65.8%) |
关键发现:
- HSTU 在所有数据集上显著超越 SASRec
- HSTU-large(4x 层数,2x 头数)进一步提升性能
- Books 数据集提升最大(+65.8% NDCG@10)
工业级流式设置
| 架构 | Retrieval log pplx. | Ranking NE (E-Task) | Ranking NE (C-Task) |
|---|---|---|---|
| Transformers | 4.069 | NaN | NaN |
| HSTU (-rab, Softmax) | 4.024 | .5067 | .7931 |
| HSTU (-rab) | 4.021 | .4980 | .7860 |
| Transformer++ | 4.015 | .4945 | .7822 |
| HSTU | 3.978 | .4937 | .7805 |
关键发现:
- HSTU 在排序任务上显著优于 Transformer
- Pointwise attention 和相对注意力偏置共同贡献性能提升
- 0.001 NE 降低对应 0.5% 在线指标提升
编码器效率
| 指标 | HSTU vs FlashAttention2 Transformer |
|---|---|
| 训练吞吐量提升 | 最高 15.2x |
| 推理吞吐量提升 | 最高 5.6x |
| 激活内存使用 | 14d(vs Transformer 28d) |
| 线性层数量 | 2(vs Transformer 6) |
GR vs DLRM 工业级对比
检索模型:
| 方法 | HR@100 | HR@500 | Online E-Task | Online C-Task |
|---|---|---|---|---|
| DLRM | 29.0% | 55.5% | +0% | +0% |
| GR (new source) | 36.9% | 62.4% | +6.2% | +5.0% |
| GR (replace source) | - | - | +5.1% | +1.9% |
排序模型:
| 方法 | NE (E-Task) | NE (C-Task) | Online E-Task | Online C-Task |
|---|---|---|---|---|
| DLRM | .4982 | .7842 | +0% | +0% |
| GR | .4845 | .7645 | +12.4% | +4.4% |
关键发现:
- GR 在离线和在线指标上均显著超越 DLRM
- 在线 A/B 测试:12.4% 指标提升
- GR 使用 285x 更复杂的模型,但推理计算量更少
- 模型质量遵循幂律缩放(3 个数量级)
Scaling Law
- GR 模型质量随训练计算量呈幂律缩放
- 跨越 3 个数量级,达到 GPT-3/LLaMa-2 规模
- DLRM 在特定计算/参数区间后趋于饱和
- 这是推荐系统领域首个实证 scaling law
六、消融实验
HSTU 组件消融
| 配置 | Retrieval log pplx. | Ranking NE (E-Task) |
|---|---|---|
| HSTU (-rab, Softmax) | 4.024 | .5067 |
| HSTU (-rab) | 4.021 | .4980 |
| HSTU (original rab) | 4.029 | .4941 |
| HSTU (full) | 3.978 | .4937 |
发现:
- Pointwise attention(vs Softmax)贡献最大
- 相对注意力偏置进一步提升性能
- 两者结合效果最佳
Stochastic Length 消融
| Alpha | 稀疏度 (n=4096) | NE 退化 |
|---|---|---|
| 1.6 | 79.4% | <0.002 |
| 1.7 | 67.3% | <0.001 |
| 1.8 | 51.9% | ~0 |
| 1.9 | 29.6% | ~0 |
发现:
- 可实现 80%+ 稀疏度,NE 退化极小
- SL 显著优于 RoPE 等长度外推技术
特征消融
| 配置 | Retrieval HR@100 | Ranking NE |
|---|---|---|
| GR (interactions only) | 35.6% | .4851 |
| GR (full features) | 36.9% | .4845 |
| DLRM (abl. features) | 28.3% | .5053 |
发现:
- GR 仅用交互历史即可达到较强性能
- DLRM 去除手工特征后性能显著下降
- GR 的架构能有效捕获特征交互
七、相关工作
| 工作 | 方法 | 与 GR 的差异 |
|---|---|---|
| SASRec | 自回归 Transformer | 仅用交互历史,无法扩展 |
| BERT4Rec | 双向自监督 | 非因果设置,不适合流式 |
| DIN | 目标感知注意力 | DLRM 组件,非端到端 |
| DCN | 特征交叉网络 | DLRM 组件,手工特征 |
| GRU4Rec | RNN 序列建模 | 早期工作,性能有限 |
| FlashAttention | 高效注意力内核 | HSTU 的技术基础 |
八、总结
核心贡献
- 新范式:将推荐重新定义为序列转导任务(Generative Recommenders),统一异构特征空间
- HSTU 编码器:专为推荐设计的高效编码器,比 FlashAttention2 Transformer 快 5.3x-15.2x
- Pointwise Aggregated Attention:替代 softmax,更好捕获用户偏好强度
- Stochastic Length:随机子序列采样,实现 80%+ 稀疏度而不损失质量
- M-FALCON 推理:微批次并行算法,实现亚线性推理成本扩展
- Scaling Law:推荐系统首次实证幂律缩放,达到 GPT-3/LLaMa-2 规模
- 工业部署:1.5 万亿参数模型在线 A/B 测试提升 12.4%
技术影响
- 推荐基础模型:为推荐系统领域的基础模型铺平道路
- 特征统一:减少对大量异构特征的依赖,更隐私友好
- Scaling Law:降低模型研发的碳足迹
- 端到端生成:推荐可端到端、生成式地解决
- 长期优化:完全序列化设置有助于捕获用户长期目标
局限性
- 计算成本:1.5 万亿参数模型需要大量计算资源
- 评估局限:主要在 Meta 内部数据集评估,公开复现有限
- 特征简化:GR 的特征简化可能不适用于所有推荐场景
- 训练复杂度:流式训练需要持续更新,运维成本高
- 可解释性:大规模黑盒模型的可解释性仍是挑战
九、参考资源
- 论文: arXiv:2402.17152
- 代码: github.com/facebookresearch/generative-recommenders
- 相关工作:
- SASRec - 自回归序列推荐
- BERT4Rec - 双向自监督推荐
- DIN - 目标感知注意力
- DCN V2 - 特征交叉网络
- FlashAttention - 高效注意力内核
- 基础模型: