Benchmarking and Dissecting the Nvidia Hopper GPU Architecture
对 Nvidia Hopper GPU 架构进行全面基准测试,揭示 Tensor Core、DPX、分布式共享内存等新特性的性能特征
Benchmarking and Dissecting the Nvidia Hopper GPU Architecture
论文信息: arXiv:2402.13499 [cs.AR] 21 Feb 2024
作者: Weile Luo, Ruibo Fan, Zeyu Li, Dayou Du, Qiang Wang, Xiaowen Chu
机构: HKUST(GZ), HIT(Shenzhen), HKUST
代码: https://github.com/hkust-nlp/hopper-benchmark
许可: arXiv nonexclusive-distrib/1.0
一、论文概述
1.1 研究背景
GPU 架构持续演进以满足 AI 和深度学习的计算需求。Hopper 架构引入了多项新特性:
| 新特性 | 说明 |
|---|---|
| FP8 Tensor Core | 支持 FP8 精度,加速 LLM 训练和推理 |
| DPX 指令 | 动态编程硬件加速 |
| 分布式共享内存 | SM 到 SM 直接通信 |
| Tensor Memory Accelerator | 增强异步执行机制 |
现有研究的不足:
- 缺乏对 Hopper 架构新特性的深入分析
- Tensor Core 性能和编程指令集仍不明确
- 需要跨架构(Ampere、Ada、Hopper)的横向性能对比
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 指令级测试 | 对内存架构和 Tensor Core 进行详细指令级测试和分析 |
| 跨架构对比 | 比较 Ampere、Ada、Hopper 三代 GPU 的 AI 性能 |
| 新特性探索 | 首次探索 Hopper 的 DPX、异步内存操作、分布式共享内存 |
二、核心思想
2.1 问题定义
如何全面理解和量化 Hopper GPU 架构的新特性,为软件优化和建模提供指导?
2.2 解决方案概述
两阶段方法:
- 常规基准测试:在 Hopper、Ada、Ampere 三代 GPU 上进行延迟和吞吐量对比
- 新特性基准测试:深入分析 Hopper 特有的 DPX、分布式共享内存、FP8 Tensor Core
三、技术架构
3.1 Hopper 架构概览
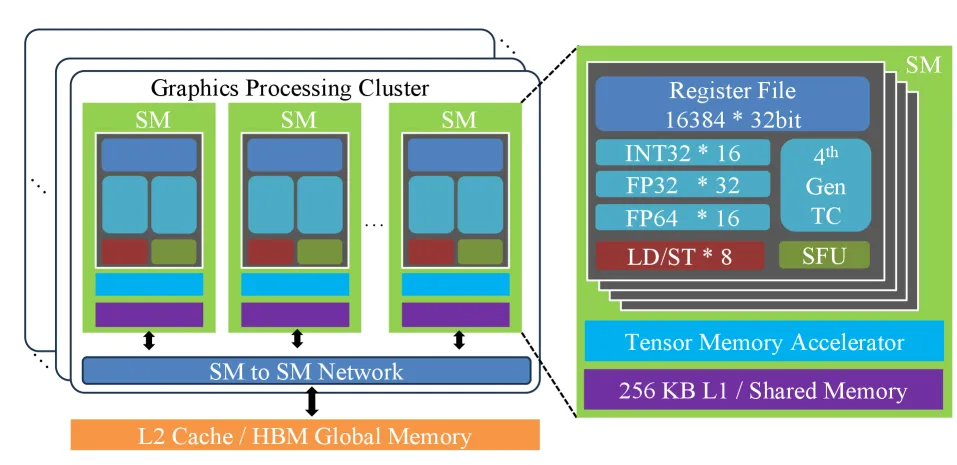 图 1:Hopper 架构概览,展示新特性:DPX、分布式共享内存、Tensor Memory Accelerator。
3.2 Tensor Core 演进
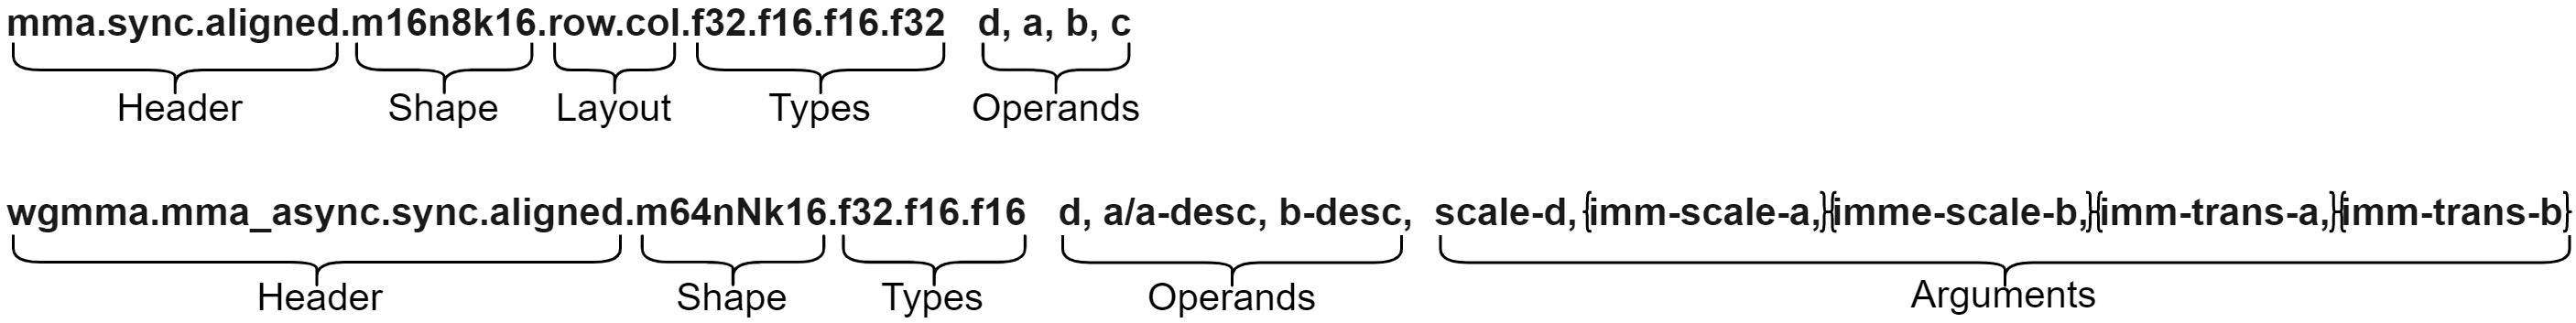 图 2:mma 和 wgmma 指令对比,wgmma 支持异步执行和更大的矩阵尺寸。
Tensor Core 属性对比:
| 架构 | 精度支持 | 编程模式 | 执行模式 |
|---|---|---|---|
| Ampere | FP16,BF16,TF32,FP64,INT8,INT4,Binary | C: wmma, PTX: mma, mma.sp | 同步 |
| Ada | FP16,BF16,FP8,TF32,FP64,INT8,INT4,Binary | C: wmma, PTX: mma, mma.sp | 同步 |
| Hopper | FP16,BF16,FP8,TF32,FP64,INT8,Binary | C: wmma, PTX: mma, mma.sp, wgmma | 同步/异步 |
关键差异:
- Hopper 引入 wgmma 指令,支持异步执行
- wgmma 由 4 个 CUDA warp(warp group)执行,而 mma 由 1 个 warp 执行
- wgmma 可直接从共享内存加载矩阵,而 mma 需要先存储到寄存器
3.3 Transformer Engine
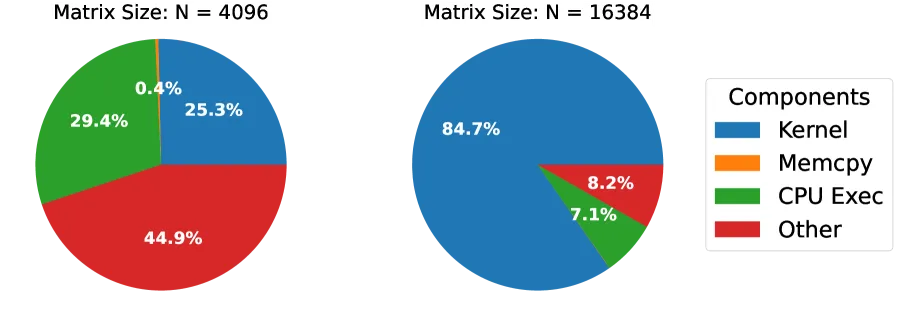 图 3:FP8 矩阵乘法中不同操作的执行时间比例。小矩阵时转换开销占比大。
Transformer Engine 工作流程:
- 输入转换:
inp_fp8 = inp_fp16 / scale - FP8 矩阵乘法:
out_fp8 = inp_fp8 × w_fp8 - 输出缩放:
out_fp16 = out_fp8 × scale
关键发现:
- 小矩阵时,数据转换开销显著大于 GEMM 计算开销
- 大矩阵时,FP8 吞吐量显著提升
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| wgmma 指令分析 | 首次深入分析 Hopper 的 wgmma 指令 | SASS 反汇编和性能测试 |
| FP8 性能评估 | 评估 Transformer Engine 的 FP8 性能 | 矩阵乘法和 LLM 推理测试 |
| DPX 硬件加速 | 首次评估 Hopper 的 DPX 硬件加速 | 延迟和吞吐量测试 |
| 分布式共享内存 | 评估 SM 到 SM 通信性能 | 直方图应用重新设计 |
4.2 实验设备
| 属性 | A100 PCIe | RTX4090 | H800 PCIe |
|---|---|---|---|
| 计算能力 | 8.0 (Ampere) | 8.9 (Ada) | 9.0 (Hopper) |
| SMs × 核心/SM | 108 × 64 | 128 × 128 | 114 × 128 |
| 最大时钟频率 | 1410 MHz | 2520 MHz | 1755 MHz |
| 显存大小 | 40GB | 24GB | 80GB |
| 显存类型 | HBM2e | GDDR6X | HBM2e |
| 显存带宽 | 1555 GB/s | 1008 GB/s | 2039 GB/s |
| Tensor Core | 432 (3rd Gen.) | 512 (4th Gen.) | 456 (4th Gen.) |
| DPX 硬件 | 无 | 无 | 有 |
| 分布式共享内存 | 无 | 无 | 有 |
五、实验结果
5.1 内存延迟和吞吐量
内存访问延迟(时钟周期):
| 类型 | RTX4090 | A100 | H800 |
|---|---|---|---|
| L1 缓存 | 43.4 | 37.9 | 40.7 |
| 共享内存 | 30.1 | 29.0 | 29.0 |
| L2 缓存 | 273.0 | 261.5 | 263.0 |
| 全局内存 | 541.5 | 466.3 | 478.8 |
关键发现:
- 三代 GPU 的内存访问延迟相近
- L2 缓存平均延迟是 L1 的 6.5 倍
- 全局内存平均延迟是 L2 的 1.9 倍
内存访问吞吐量:
| 类型 | RTX4090 | A100 | H800 |
|---|---|---|---|
| L1 缓存 (byte/clk/SM) | 121.2 | 106.8 | 124.1 |
| L2 缓存 (byte/clk) | 1708.0 | 2007.9 | 3942.4 |
| 共享内存 (byte/clk/SM) | 127.9 | 128.0 | 127.9 |
| 全局内存 (GB/s) | 929.8 | 1407.2 | 1861.5 |
| L2 vs. 全局 | 4.67× | 2.01× | 4.23× |
关键发现:
- H800 的 L2 缓存吞吐量是 A100 的 2.2 倍
- 全局内存带宽:H800 (1861.5 GB/s) > A100 (1407.2 GB/s) > RTX4090 (929.8 GB/s)
- 向量化内存访问(FP32.v4)始终性能最佳
5.2 Tensor Core 性能
SASS 指令分析:
| A/B | C/D | mma | wgmma |
|---|---|---|---|
| FP16 | FP16 | HMMA.16816.F16 | HGMMA.64x256x16.F16 |
| FP16 | FP32 | HMMA.16816.F32 | HGMMA.64x256x16.F32 |
| TF32 | FP32 | HMMA.1688.F32.TF32 | HGMMA.64x256x8.F32.TF32 |
| FP8 | FP16 | 无 | QGMMA.64x256x32.F16.E5M2/E4M3 |
关键发现:
- FP8 只能通过 wgmma 指令使用,mma 不支持 FP8
- INT4 在 Hopper 上编译为 IMAD 指令(CUDA 核心),而非 Tensor Core
- wgmma 编译为新的 GMMA SASS 指令
5.3 Transformer Engine 性能
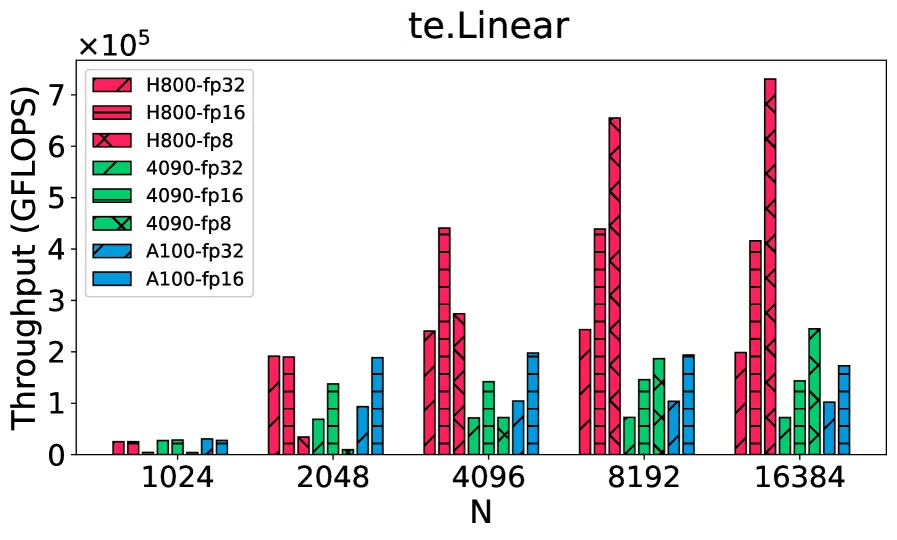 图 4:不同硬件配置和数据类型的矩阵乘法吞吐量对比。
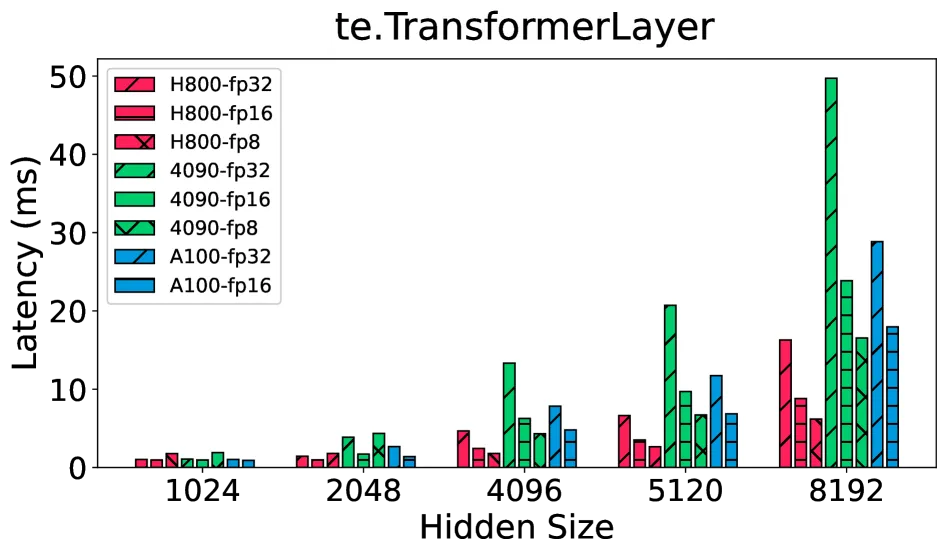 图 5:不同硬件配置和数据类型的 Transformer 层延迟对比。
关键发现:
- FP8 在大矩阵时吞吐量显著高于 FP16
- 隐藏状态大小为 4096(Llama 7b)时,FP8 性能最优
- Softmax 和 GeLU 未量化到 FP8,导致数据格式转换开销
5.4 DPX 动态编程加速
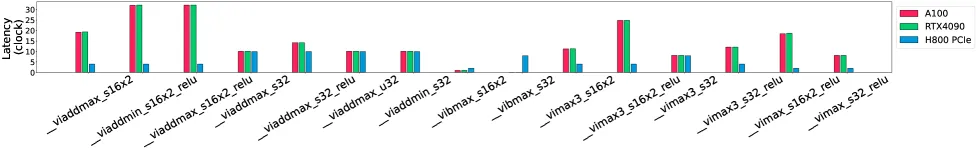 图 6:DPX 函数在不同设备上的延迟。
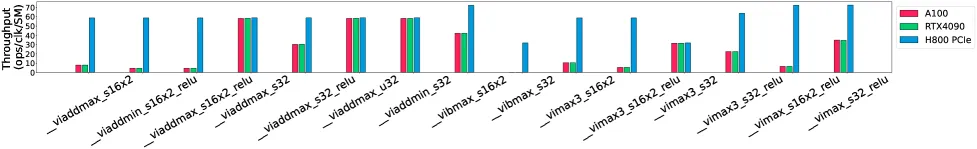 图 7:DPX 函数在不同设备上的吞吐量。
关键发现:
- Hopper 是唯一支持 DPX 硬件加速的架构
- DPX 加速比 Ampere/Ada 快 2-4 倍
- DPX 硬件位于 SM 内部
5.5 分布式共享内存
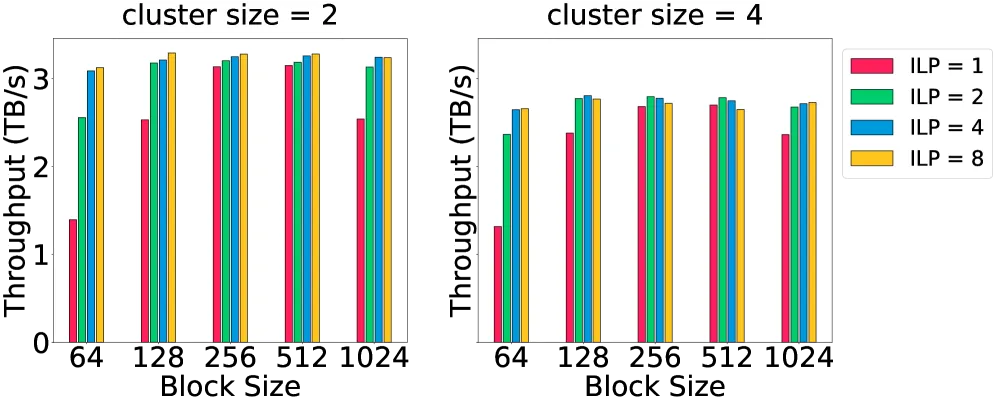 图 8:SM 到 SM 网络的数据通信吞吐量。
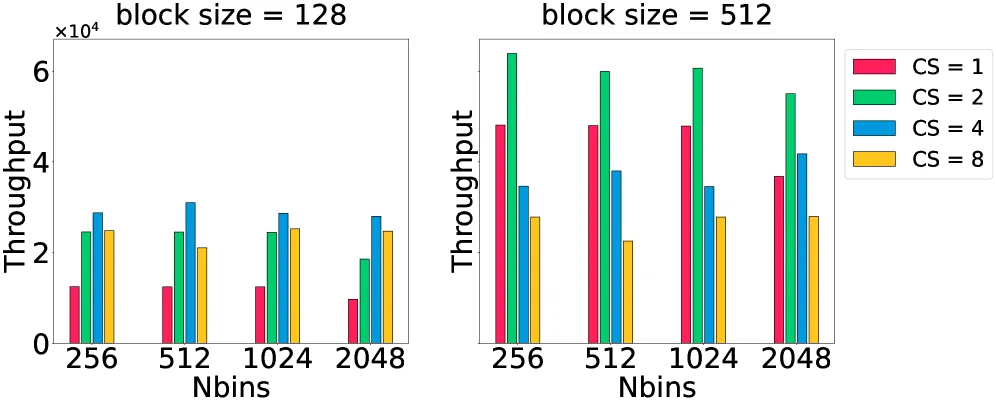 图 9:使用分布式共享内存的直方图应用性能。
关键发现:
- 分布式共享内存支持 SM 到 SM 直接通信
- 可减少块间数据传输开销高达 7 倍
- 集群大小和 ILP 影响通信吞吐量
六、代码实现分析
6.1 项目结构
- 基准测试代码: 包含内存、Tensor Core、DPX、分布式共享内存的测试
- SASS 分析工具: 用于反汇编 PTX 指令
- Transformer Engine 测试: 评估 FP8 性能
6.2 关键组件
- 内存基准测试: L1/L2 缓存、共享内存、全局内存的延迟和吞吐量
- Tensor Core 测试: mma 和 wgmma 指令的性能
- Transformer Engine 测试: te.Linear 和 te.TransformerLayer 的性能
- DPX 测试: 动态编程指令的延迟和吞吐量
- 分布式共享内存测试: SM 间通信的延迟和吞吐量
七、相关工作
7.1 GPU 微架构分析
| 工作 | 架构 | 贡献 |
|---|---|---|
| Jia et al. | Volta, Turing | Tensor Core 初步分析 |
| Sun et al. | Turing, Ampere | mma 指令级基准测试 |
| Fasi et al. | Volta, Turing, Ampere | Tensor Core 数值行为 |
| 本文工作 | Ampere, Ada, Hopper | 首次全面分析 Hopper |
7.2 Tensor Core 编程
| API | 架构 | 特点 |
|---|---|---|
| wmma | Volta+ | C 级 API,灵活性有限 |
| mma | Turing+ | PTX 级指令,支持稀疏 |
| wgmma | Hopper | 异步执行,支持 FP8 |
八、总结
8.1 核心贡献
- 指令级分析:对三代 GPU 的内存架构和 Tensor Core 进行详细测试
- 跨架构对比:首次在 Ampere、Ada、Hopper 间进行横向性能对比
- 新特性探索:首次分析 Hopper 的 DPX、异步内存操作、分布式共享内存
- SASS 反汇编:深入分析 mma 和 wgmma 指令的编译行为
8.2 技术影响
- 软件优化:为 GPU 程序优化提供详细指导
- 性能建模:为 GPU 架构建模提供准确的微架构参数
- 算法设计:帮助设计利用 Hopper 新特性的算法
- 硬件选型:为不同应用选择合适的 GPU 架构提供参考
8.3 关键发现总结
- Tensor Core: Hopper 的 wgmma 指令是唯一支持 FP8 的方式
- FP8 性能: 大矩阵时 FP8 吞吐量显著高于 FP16,但小矩阵时转换开销大
- DPX 加速: Hopper 硬件加速动态编程算法,比前代快 2-4 倍
- 分布式共享内存: 支持 SM 到 SM 直接通信,可减少 7 倍数据传输开销
- L2 缓存: H800 的 L2 缓存吞吐量是 A100 的 2.2 倍
8.4 局限性
- 硬件限制:仅测试了 A100、RTX4090、H800 三款 GPU
- 软件版本:CUDA 版本和驱动版本可能影响结果
- 应用场景:未覆盖所有可能的 GPU 应用场景
- 功耗分析:未包含详细的功耗和能效分析
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2402.13499
- PDF: https://arxiv.org/pdf/2402.13499
- HTML: https://arxiv.org/html/2402.13499v1
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | Hopper 架构概览 | figure-1-hopper-architecture.png |
| 图 2 | mma 和 wgmma 指令 | figure-2-mma-wgmma-instructions.png |
| 图 3 | FP8 执行时间比例 | figure-3-fp8-execution-time.png |
| 图 4 | 吞吐量对比 | figure-4-throughput-comparison.png |
| 图 5 | 延迟对比 | figure-5-latency-comparison.png |
| 图 6 | DPX 延迟 | figure-6-dpx-latency.png |
| 图 7 | DPX 吞吐量 | figure-7-dpx-throughput.png |
| 图 8 | SM 间通信 | figure-8-sm-communication.png |
| 图 9 | 直方图应用 | figure-9-histogram-dsm.png |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Demystifying GPU Microarchitecture | Jia et al. | 2019 | 前驱工作 |
| Instruction-Level Benchmarking | Sun et al. | 2023 | 对比方法 |
| Numeric Behaviors of Tensor Cores | Fasi et al. | 2023 | 相关工作 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| Tensor Core | Tensor Core | GPU 上加速矩阵乘法的专用硬件单元 |
| wgmma | Warp Group MMA | Hopper 引入的异步矩阵乘法指令 |
| DPX | Dynamic Programming X | 动态编程硬件加速指令 |
| 分布式共享内存 | Distributed Shared Memory | SM 到 SM 直接通信机制 |
| Transformer Engine | Transformer Engine | 加速 Transformer 模型的库 |
| FP8 | 8-bit Floating Point | 8 位浮点数格式 |
分析完成时间:2026年6月24日 分析工具:Claude Code + paper-analyzer skill