ES-MoE: Scaling Beyond the GPU Memory Limit for Large Mixture-of-Experts Model
通过专家卸载和动态放置实现MoE模型训练的高效扩展,支持67倍专家扩展和17.5倍吞吐量提升
ES-MoE: Scaling Beyond the GPU Memory Limit for Large Mixture-of-Experts Model Training
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scaling Beyond the GPU Memory Limit for Large Mixture-of-Experts Model Training |
| 作者 | Yechan Kim*, Hwijoon Lim*, Dongsu Han |
| 机构 | KAIST (Kim Jaechul Graduate School of AI & School of Electrical Engineering) |
| 论文 | https://arxiv.org/abs/2402.09624 |
| 代码 | https://github.com/kaist-ina/es-moe |
| 会议 | ICML 2024 |
| 许可 | PMLR 235 |
二、核心思想
问题定义
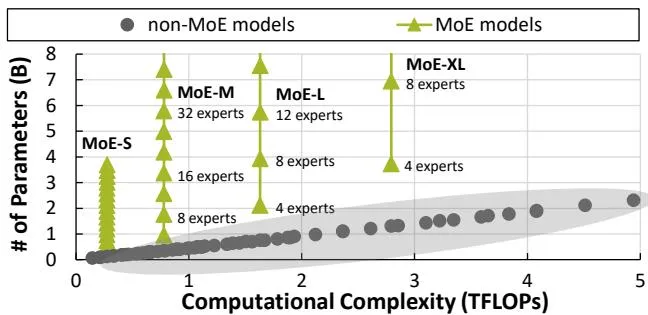
Mixture-of-Experts (MoE) 模型通过增加专家数量来提升模型性能,但不增加计算复杂度。然而,扩展专家数量面临三个关键挑战:
- GPU内存限制:现有框架(FairSeq、Tutel、DeepSpeed-MoE)要求所有专家同时加载到GPU内存,增加专家需要更多GPU
- 负载不均衡:专家数量增加导致token分布更不均匀,造成straggler问题和零填充浪费
- 计算效率低下:batched matrix multiplication需要大型dispatch mask,限制batch size
例如,训练MoE-L(8专家)只需4个A100 GPU,但扩展到128专家需要52个GPU。
解决方案概述
本文提出ES-MoE,一种高效扩展MoE训练的方法:
- 专家卸载:将专家参数和优化器状态卸载到主机内存/SSD
- 流水线专家处理:重叠GPU-CPU通信与GPU计算
- 动态专家放置:基于token负载动态平衡GPU间的专家分配
三、技术架构
整体框架图
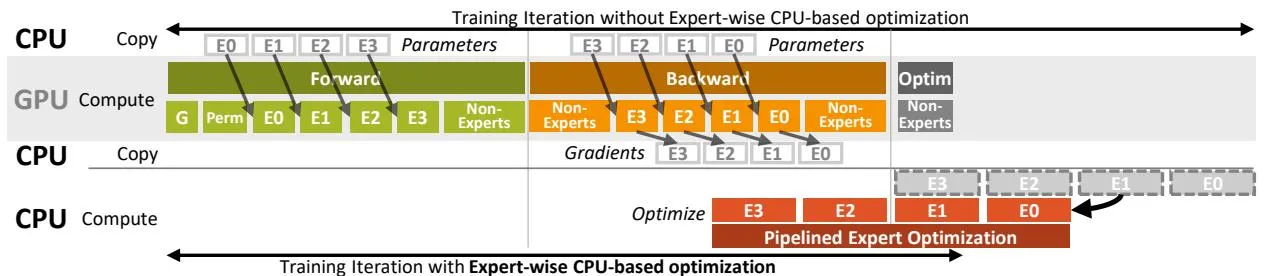
ES-MoE的核心设计包括三个组件:
专家级卸载与处理
关键挑战:专家放置只能在gating network执行后确定,导致上传延迟可能导致GPU停顿。
解决方案:
- 将token permutation阶段与第一个专家的上传重叠
- 后续专家顺序处理,确保专家计算和上传并发进行
- 专家级CPU优化:每个专家完成backward pass后立即启动优化器
内存节省:
- 不使用batched matrix multiplication,避免创建大型dispatch mask
- 顺序分配token到目标专家,节省大量内存
- 例如:训练MoE-L时支持8倍更大的microbatch,吞吐量提升3.1倍
动态专家放置
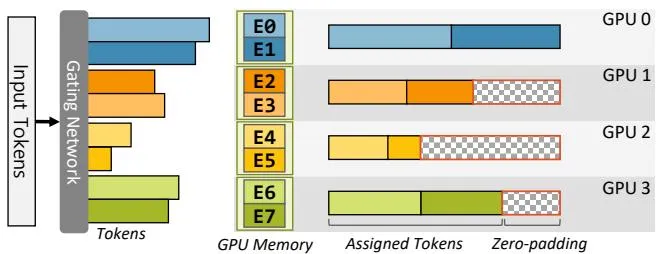
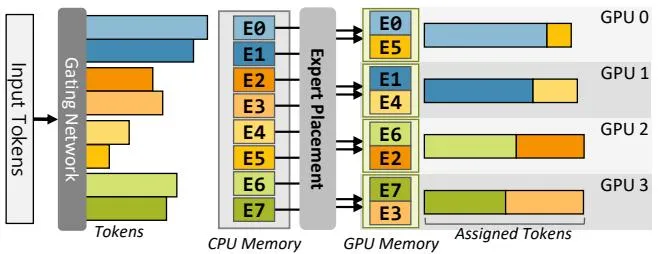
问题:传统方法中专家静态固定在GPU上,token分布随时间变化导致负载不均衡。
解决方案:
- 基于gating network输出,动态决定专家在GPU上的放置
- 使用贪心调度算法(4近似)平衡GPU间的token负载
- 算法复杂度:O(mlog n + mlog m),运行时间 < 2.69 μs
核心公式:
最小化makespan调度问题:
其中 是分配给GPU 的专家集合, 是专家 的处理时间。
贪心算法近似比为 。
自适应卸载
根据专家数量和GPU内存容量自动选择最优策略:
- GPU only:所有专家适合GPU内存时,仅消除零填充
- Expert pinning:将25%高频专家固定在GPU上,减少I/O
- SSD offloading:使用LRU缓存策略和预取,扩展到SSD存储
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 专家级卸载 | 以单个专家为粒度进行卸载和优化 | 避免layer-wise卸载的OOM问题 |
| 流水线处理 | 重叠permutation、专家上传、计算 | GPU利用率提升61.1% |
| 动态专家放置 | 基于token负载动态分配专家 | 负载差距从102%降至15% |
| 顺序处理 | 不使用batched matmul,消除dispatch mask | 支持8倍更大microbatch |
| SSD扩展 | LRU缓存+预取,支持SSD存储 | 扩展67倍专家数量 |
五、实验结果
可扩展性评估
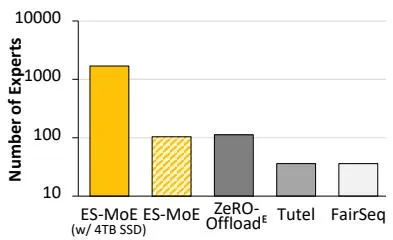
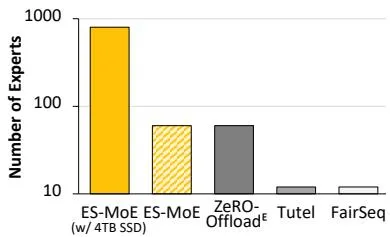
ES-MoE在可扩展性方面显著优于基线:
- 5倍更多专家(仅主机内存)
- 67倍更多专家(使用4TB SSD)
- 成功训练29B参数MoE-L模型,仅需4个GPU
训练吞吐量
| 专家数 | 模型 | 参数量 | Zero-OffloadE | FairSeq | Tutel | ES-MoE | 加速比 |
|---|---|---|---|---|---|---|---|
| 8 | MoE-S | 521M | 46321 | 82631 | 123152 | 163217 | 3.52x |
| 8 | MoE-M | 1.76B | 18784 | 27772 | 57605 | 65352 | 3.48x |
| 8 | MoE-L | 3.93B | 8677 | 21542 | 25526 | 38173 | 4.40x |
| 16 | MoE-S | 974M | 24469 | 60142 | 96314 | 158904 | 6.49x |
| 32 | MoE-S | 1.88B | 12847 | 47088 | 76776 | 148673 | 11.6x |
| 64 | MoE-S | 3.70B | 6702 | 31644 | 55124 | 117150 | 17.5x |
- 相比Zero-OffloadE提升最多11.6倍
- 相比MoE专用框架提升最多3.16倍
Microbatch大小影响
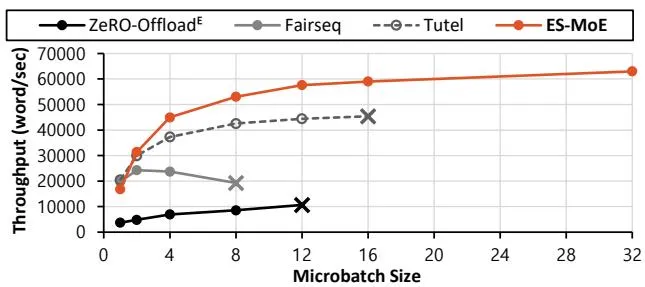
ES-MoE支持更大microbatch(32 vs 其他框架的2-12),带来显著吞吐量提升。
负载均衡效果
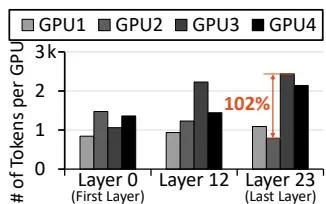
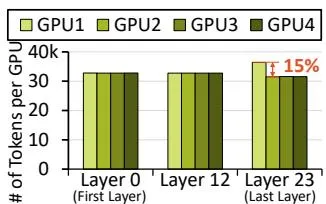
动态专家放置显著改善负载均衡:
- FairSeq:最重和最轻GPU之间差距102%
- ES-MoE:差距降至15%
LLM微调
| 数据集 | 零样本准确率 | 微调后准确率 |
|---|---|---|
| SST-2 | 51.6% | 88.0% |
| MNLI | 49.3% | 78.2% |
| BoolQ | 60.9% | 68.5% |
使用4个GPU在6.5小时内完成15B参数模型微调,无需牺牲精度。
六、相关工作
| 方向 | 代表工作 | 与ES-MoE的关系 |
|---|---|---|
| 专家并行 | GShard, Switch Transformer | ES-MoE扩展专家并行到内存受限场景 |
| 卸载 | ZeRO-Offload, L2L | ES-MoE实现专家级卸载而非层级卸载 |
| 负载均衡 | Auxiliary loss, Token dropping | ES-MoE通过动态放置消除零填充 |
| 稀疏计算 | MegaBlocks | ES-MoE不需要所有专家在GPU内存中 |
七、总结
核心贡献
- 专家级卸载与流水线:实现专家粒度的卸载和优化,重叠通信与计算
- 动态专家放置:基于token负载动态平衡GPU间的专家分配
- 自适应卸载策略:根据模型大小自动选择GPU/主机/SSD卸载
- 开源实现:3.3k行Python + 3.0k行C++代码
技术影响
- 可访问性:使学术研究者能在有限GPU上训练大型MoE模型
- 效率:消除零填充浪费,支持更大batch size
- 扩展性:通过SSD扩展实现近乎无限的专家数量扩展
局限性
- 专家上传延迟在某些场景下仍可能成为瓶颈
- SSD访问延迟高于主机内存,需要有效的预取策略
- 当前实现基于FairSeq框架,移植到其他框架需要额外工作
八、参考资源
- 论文:https://arxiv.org/abs/2402.09624
- 代码:https://github.com/kaist-ina/es-moe
- 会议:ICML 2024 (PMLR 235)