Fiddler: CPU-GPU Orchestration for Fast Inference of Mixture-of-Experts Models
面向资源受限环境的MoE模型高效推理系统,通过智能CPU-GPU协作实现最优执行策略
Fiddler: CPU-GPU Orchestration for Fast Inference of Mixture-of-Experts Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Fiddler: CPU-GPU Orchestration for Fast Inference of Mixture-of-Experts Models |
| 作者 | Keisuke Kamahori, Tian Tang, Yile Gu, Kan Zhu, Baris Kasikci |
| 机构 | 未明确标注 |
| 论文 | arXiv:2402.07033 |
| 代码 | GitHub |
| 发布 | 2024年2月10日(v1),2025年5月1日(v3) |
| 许可 | 未明确 |
二、核心思想
Fiddler是一个面向资源受限环境的MoE模型高效推理系统,通过智能CPU-GPU协作实现最优执行策略。核心创新在于:
- 动态执行策略:根据CPU和GPU的不同批处理效应,为每个专家层选择最优执行设备
- 流行度感知放置:基于离线分析将高频专家放置在GPU上,最大化命中率
- 专用CPU内核:使用AVX512_BF16指令集优化CPU专家处理
问题定义
MoE模型在资源受限环境下的挑战:
- 模型尺寸大:Mixtral-8x7B(47B参数)、Mixtral-8x22B(141B参数)等,需要大量GPU
- GPU内存不足:无法存储所有模型参数,但仅部分参数被激活
- 现有方法局限:
- 卸载方法:频繁CPU-GPU数据传输,延迟高
- CPU推理框架:未考虑MoE特性和设备差异
解决方案概述
Fiddler通过以下方式解决上述挑战:
- 初始化阶段:将非专家层和高频专家放置在GPU上
- 执行阶段:根据输入大小和设备特性动态选择执行策略
- 三种执行场景:GPU直接执行、权重传输后GPU执行、激活传输后CPU执行
三、技术架构
整体框架图
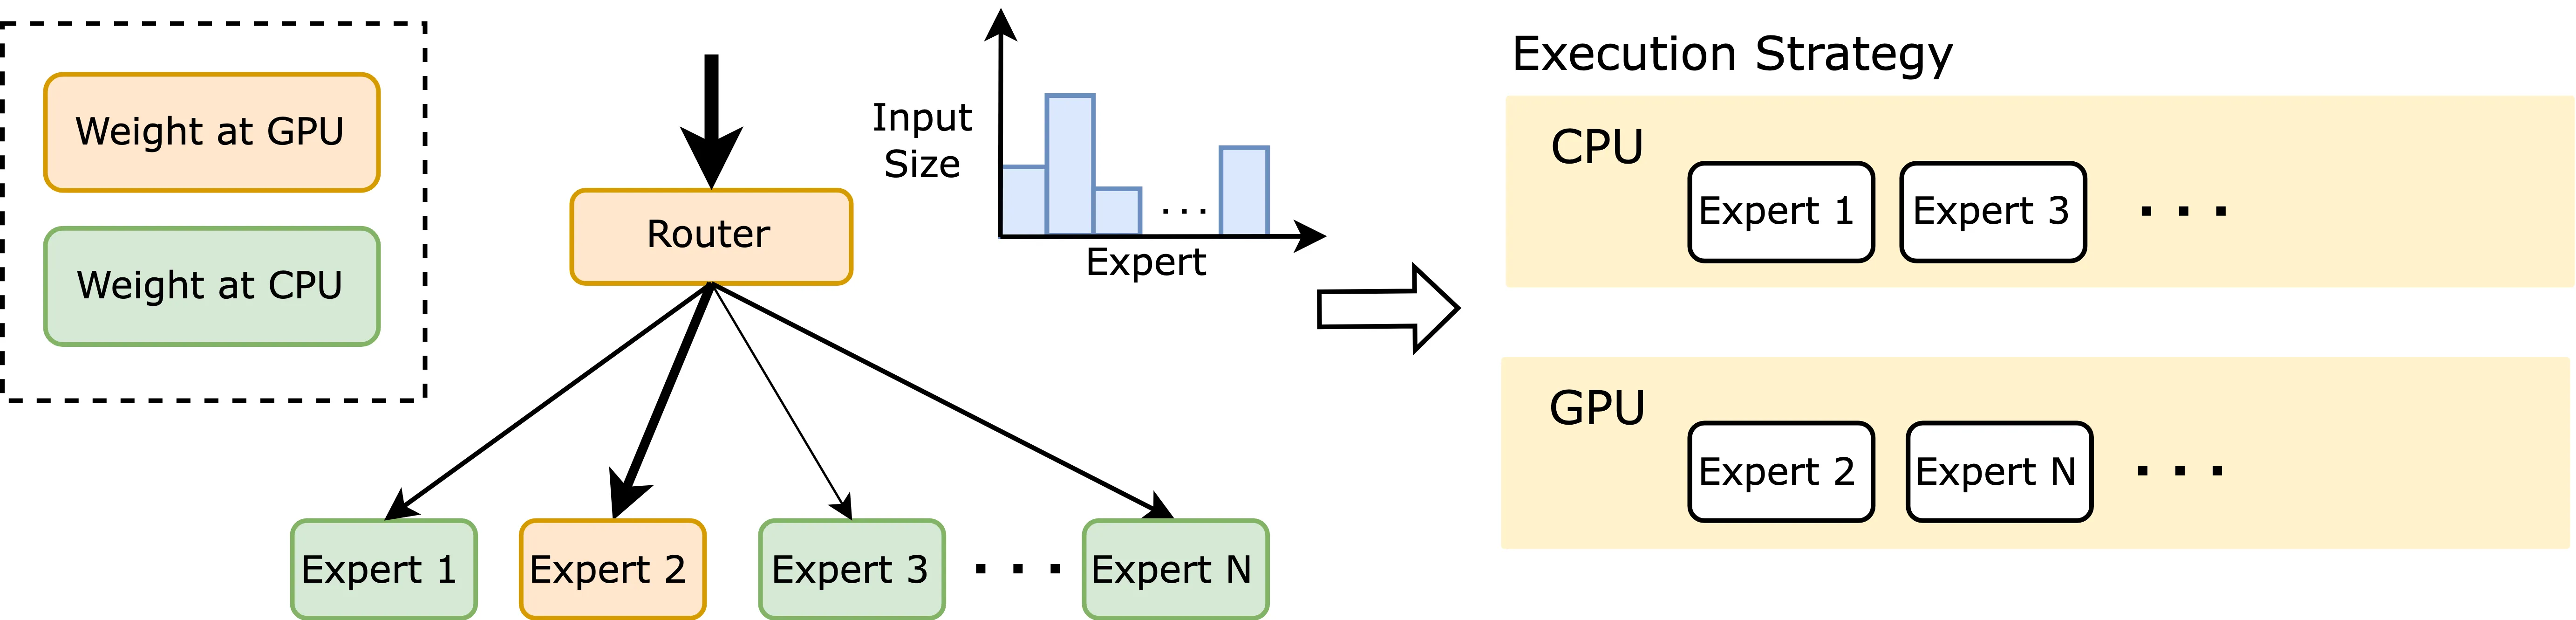
Fiddler的核心设计基于CPU和GPU的不同批处理效应:
- GPU:延迟几乎恒定,受内存带宽限制,适合大批次
- CPU:延迟随输入大小线性增长,受计算能力限制,适合小批次
核心公式
GPU延迟模型:
其中 是常数,与输入大小 无关。
CPU延迟模型:
其中 是常数,延迟与输入大小 线性相关。
传输延迟:
- 权重传输(CPU→GPU):约300MB/专家(16位精度),2-5倍于GPU计算时间
- 激活传输(GPU→CPU):input_size × 4096字节,可忽略(<1%总延迟)
执行策略决策:
如果专家权重在GPU上:
    GPU直接执行(场景a)
否则:
    如果 input_size < 阈值:
        激活传输 + CPU执行(场景c)
    否则:
        权重传输 + GPU执行(场景b)
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 非专家层 | 注意力层等,每个token都使用 | 固定在GPU上 |
| 专家层 | MoE层,仅部分激活 | 按流行度分配CPU/GPU |
| 门控层 | 确定每个token使用哪些专家 | 运行时动态选择 |
| 延迟模型 | 预测CPU/GPU执行延迟 | 初始化阶段校准 |
训练流程
Fiddler是推理时方法,无需训练:
初始化阶段:
- 将非专家层权重放置在GPU上(<2B参数)
- 基于离线分析选择高频专家,按GPU内存容量放置
- 校准CPU/GPU延迟模型参数
执行阶段:
- 执行门控函数确定每个token的专家选择
- 计算每个专家的输入大小
- 使用Algorithm 1确定最优执行策略
- 执行专家层,处理数据传输
专家选择策略
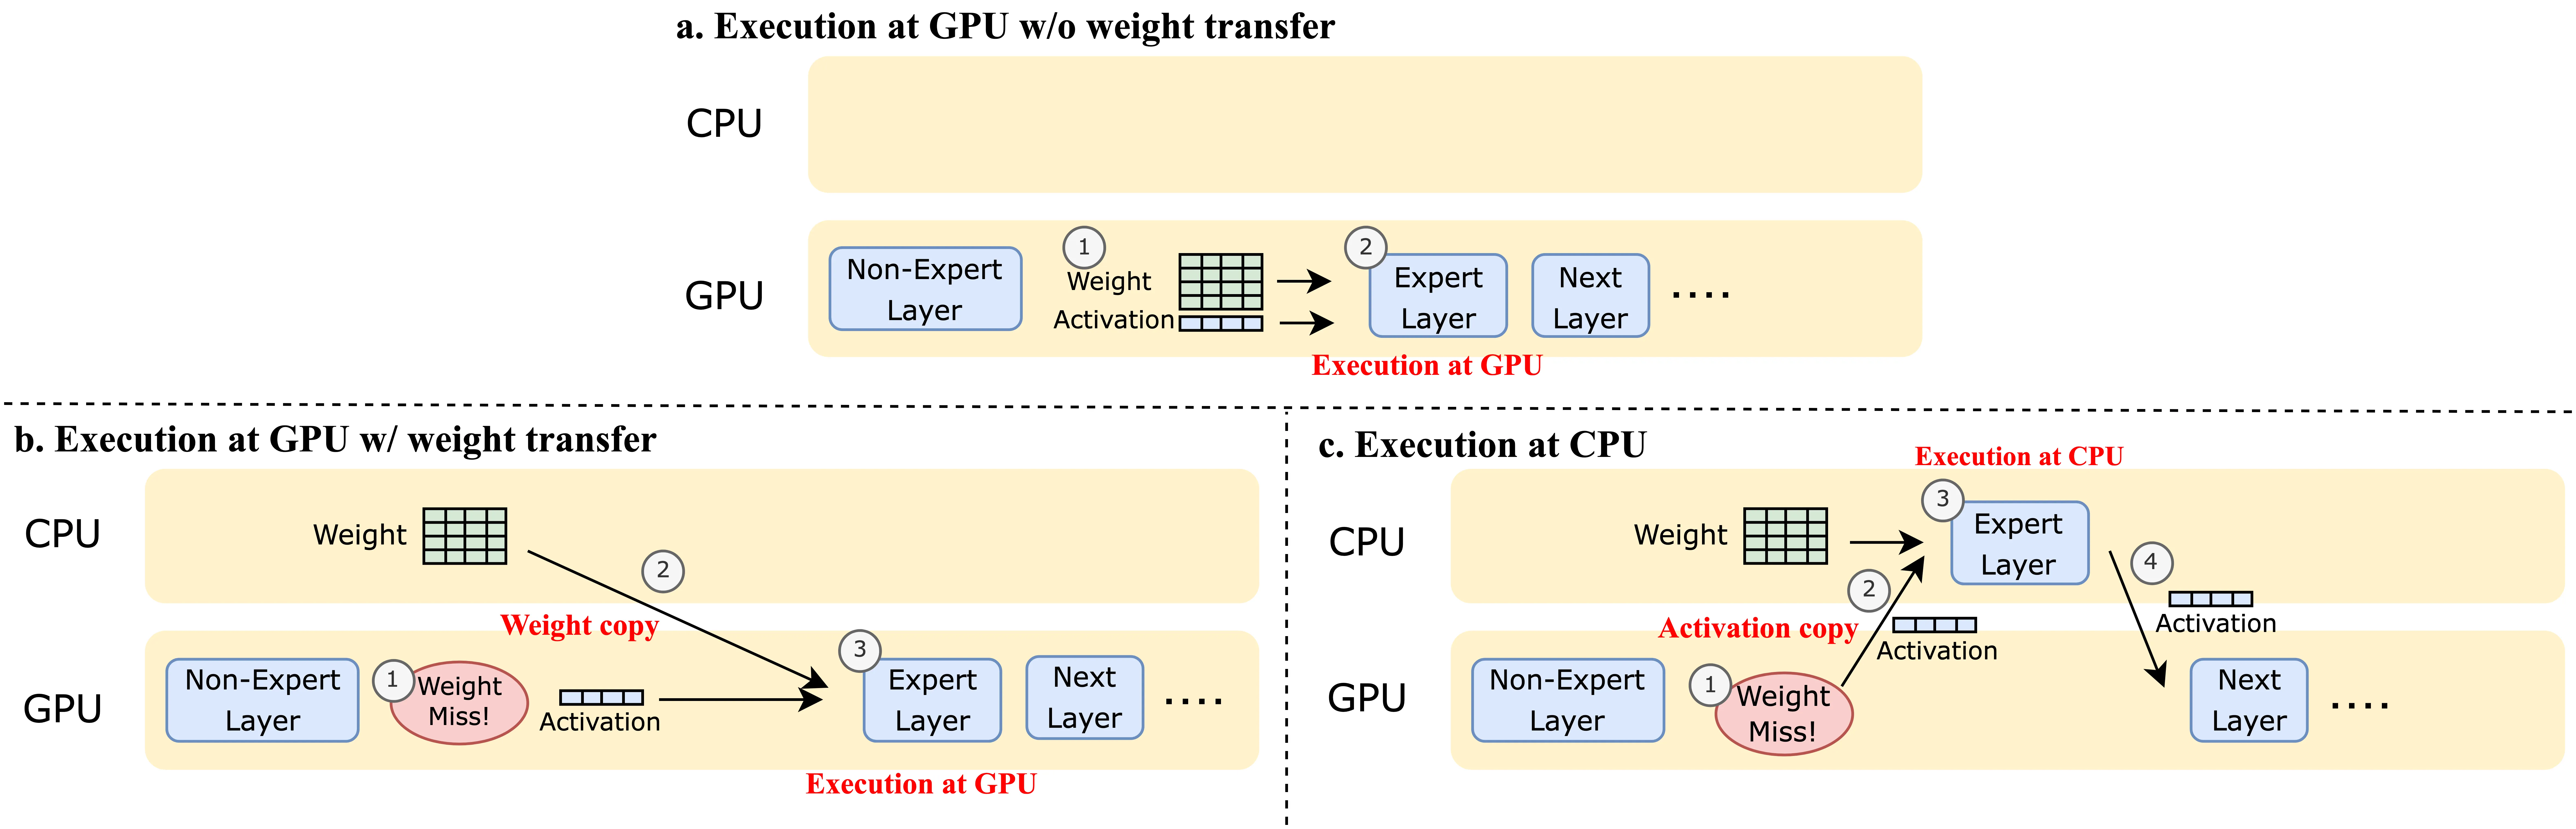
三种执行场景:
场景a:GPU直接执行
- 专家权重已在GPU上
- 无需数据传输
- 最优情况
场景b:权重传输 + GPU执行
- 专家权重在CPU上
- 传输权重到GPU(~300MB/专家)
- GPU计算延迟恒定
- 适合大输入批次
场景c:激活传输 + CPU执行
- 专家权重在CPU上
- 传输激活到CPU(input_size × 4096字节)
- CPU计算延迟线性增长
- 适合小输入批次
决策阈值: 当 时选择场景b,否则选择场景c。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 动态执行策略 | 根据输入大小选择CPU或GPU | CPU延迟线性,GPU延迟恒定 |
| 流行度感知放置 | 高频专家优先放GPU | 最大化GPU命中率 |
| AVX512_BF16内核 | 专用CPU计算内核 | 比PyTorch原生实现更快 |
| 三种场景优化 | 整合卸载和CPU推理优势 | 在所有场景下优于专用系统 |
CPU/GPU批处理效应差异
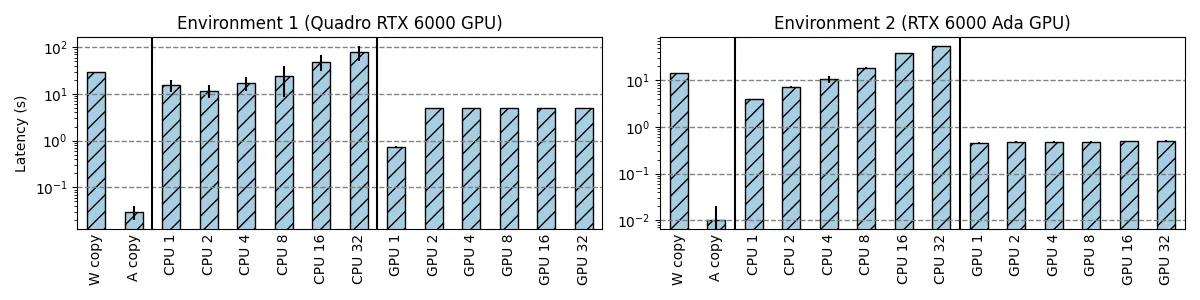
关键发现:
- GPU执行延迟几乎恒定,受内存带宽限制
- CPU执行延迟随输入大小线性增长,受计算能力限制
- 权重传输延迟是GPU计算的2-5倍
- 激活传输延迟可忽略(<1%)
稀疏性分析
Mixtral-8x7B的SiLU激活稀疏性:
- 所有层中,绝对值<0.001的通道<2%
- 30/32层中,绝对值<0.01的通道<5%
- 28/32层中,绝对值<0.1的通道<30%
- SiLU不像ReLU那样有明确的零阈值,限制了稀疏性优化
五、实验结果
基准测试
评估设置:
| 环境 | CPU | GPU | GPU内存 | 可放专家数 |
|---|---|---|---|---|
| 环境1 | 较弱CPU | RTX 3060 | 12GB | 约30/256 |
| 环境2 | 较强CPU | RTX 4090 | 24GB | 约70/256 |
评估场景:
- 单批次推理:输入长度[32,64,128,256],输出长度[64,128,256,512]
- 长上下文预填充:输入长度[512,1024,2048,4096]
- 束搜索推理:束宽度[4,8,12,16],输入32,输出64
基线系统:
- DeepSpeed-MII(ZeRO-Infinity卸载)
- Mixtral-Offloading(专家卸载)
- llama.cpp(CPU推理框架)
端到端性能
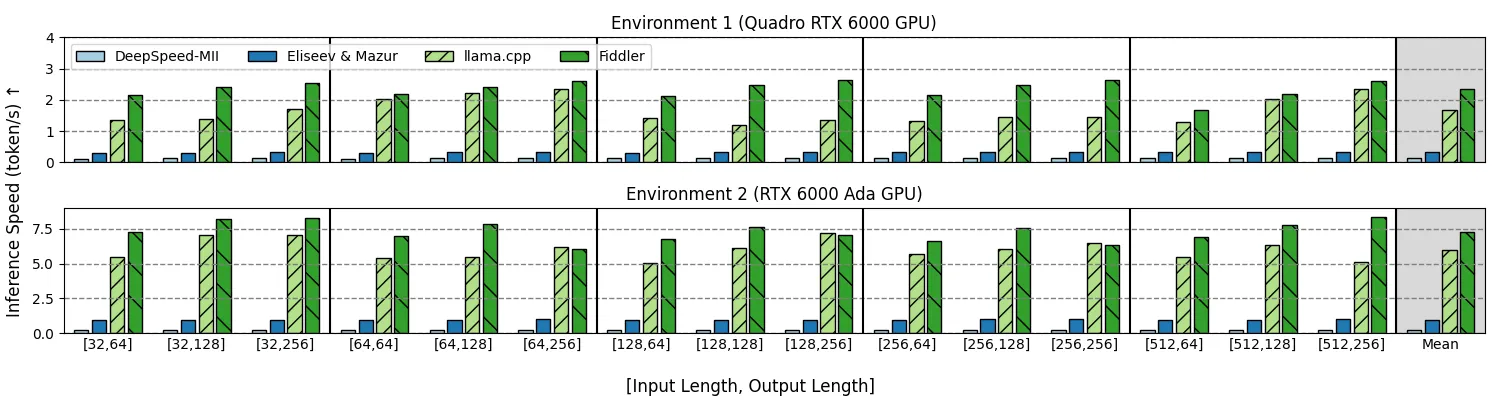
Table 2: 端到端性能对比(tok/s)
| 方法 | 环境1平均 | 环境2平均 |
|---|---|---|
| DeepSpeed-MII | 较低 | 较低 |
| Mixtral-Offloading | 中等 | 中等 |
| llama.cpp | 较高 | 较高 |
| Fiddler | 最高 | 最高 |
关键发现:
- Fiddler比最佳基线llama.cpp平均快1.26倍
- 在所有15种输入/输出长度配置下均表现最佳
- 整合了卸载方法和CPU推理框架的优势
长上下文预填充
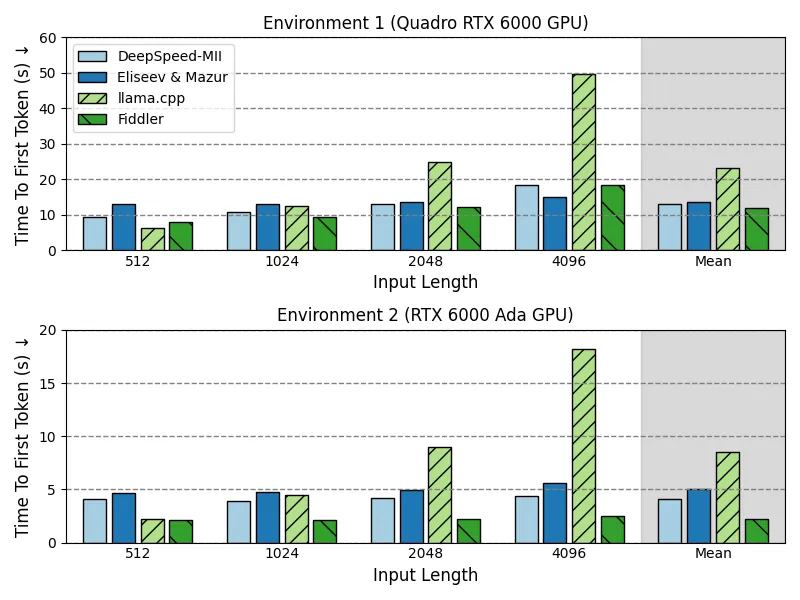
TTFT对比(秒):
| 输入长度 | DeepSpeed-MII | Mixtral-Offloading | llama.cpp | Fiddler |
|---|---|---|---|---|
| 512 | 中等 | 较慢 | 较慢 | 最快 |
| 1024 | 中等 | 较慢 | 较慢 | 最快 |
| 2048 | 中等 | 较慢 | 较慢 | 最快 |
| 4096 | 中等 | 较慢 | 较慢 | 最快 |
关键发现:
- 卸载方法(DeepSpeed-MII, Mixtral-Offloading)优于llama.cpp
- Fiddler比DeepSpeed-MII快1.07倍,比Mixtral-Offloading快1.65倍
- 在长上下文场景下优势明显
束搜索推理
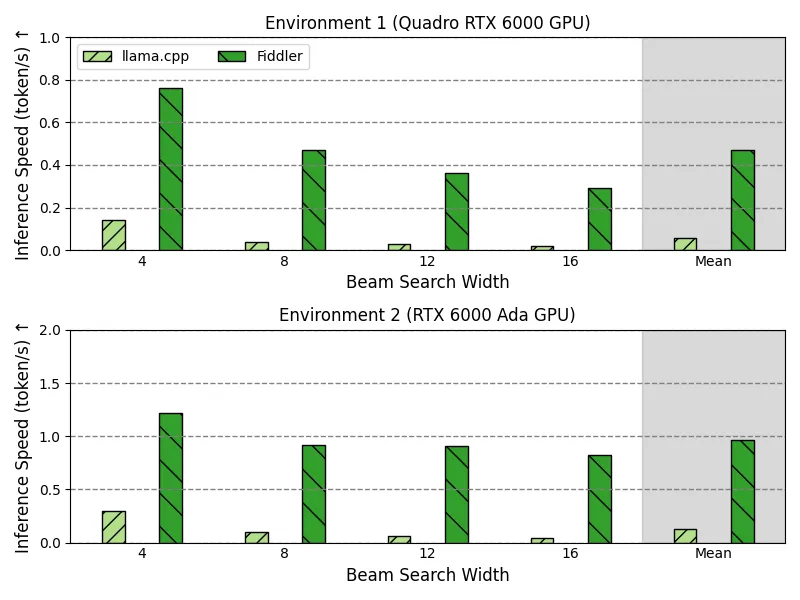
束搜索性能对比(tok/s):
| 束宽度 | llama.cpp | Fiddler | 加速比 |
|---|---|---|---|
| 4 | 较低 | 较高 | ~10x |
| 8 | 较低 | 较高 | ~11x |
| 12 | 较低 | 较高 | ~12x |
| 16 | 较低 | 较高 | ~13x |
关键发现:
- Fiddler比llama.cpp平均快11.57倍
- 束搜索产生大批次输入,GPU执行更高效
- Fiddler的动态策略在束搜索场景下优势巨大
消融实验
专家放置策略:
- 流行度感知放置比随机放置提升显著
- GPU命中率直接影响性能
延迟模型准确性:
- 初始化阶段校准的延迟模型准确预测执行时间
- 决策阈值选择最优执行策略
六、相关工作
| 方向 | 代表工作 | Fiddler优势 |
|---|---|---|
| 卸载系统 | DeepSpeed-MII, Mixtral-Offloading | 动态策略,避免频繁权重传输 |
| CPU推理框架 | llama.cpp | 考虑MoE特性和批处理效应差异 |
| 模型压缩 | 量化、稀疏化 | 无质量损失,利用MoE稀疏性 |
| 激活稀疏 | PowerInfer | 适用于非ReLU激活函数 |
七、总结
核心贡献
- 提出Fiddler,一个面向资源受限环境的MoE模型高效推理系统
- 基于CPU/GPU批处理效应差异设计动态执行策略
- 流行度感知专家放置最大化GPU命中率
- 专用AVX512_BF16内核优化CPU专家处理
- 在所有场景下优于专用系统:单批次1.26x,长预填充1.30x,束搜索11.57x
技术影响
- 整合卸载方法和CPU推理框架的优势
- 为资源受限环境下的MoE推理提供实用解决方案
- 推动本地LLM部署的民主化
局限性
- 仅评估Mixtral-8x7B模型,需扩展到其他MoE架构
- 假设非专家层适合GPU内存,未处理更大模型
- 未考虑连续批处理场景
- 专家流行度基于离线分析,未动态适应工作负载变化