Minuet: Accelerating 3D Sparse Convolutions on GPUs
面向GPU的3D稀疏卷积加速引擎
Minuet: Accelerating 3D Sparse Convolutions on GPUs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Minuet: Accelerating 3D Sparse Convolutions on GPUs |
| 作者 | Jiacheng Yang, Christina Giannoula, Jun Wu, Mostafa Elhoushi, James Gleeson, Gennady Pekhimenko |
| 机构 | University of Toronto & Vector Institute, Meta, Amazon, Samsung AI Centre Toronto, CentML |
| 论文 | arXiv:2401.06145 |
| 代码 | GitHub |
| 领域 | cs.DC, cs.CV, cs.LG, cs.PF |
二、核心思想
问题定义
稀疏卷积(Sparse Convolution, SC)广泛用于处理天然稀疏的3D点云数据。与密集卷积不同,SC通过只允许在特定位置产生输出来保持输入点云的稀疏性。
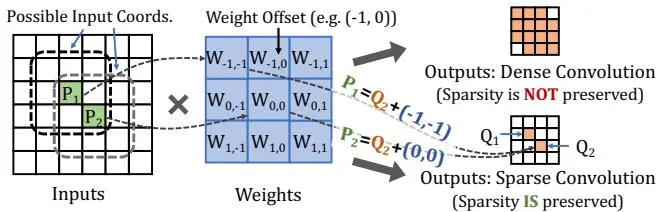
SC执行流程:
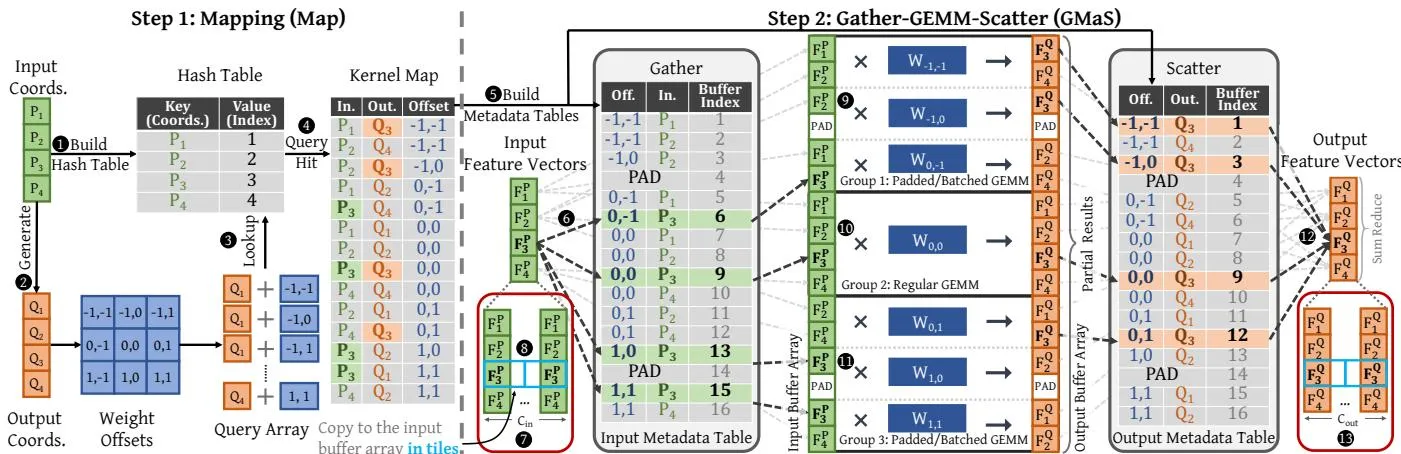
| 步骤 | 说明 | 现有方法问题 |
|---|---|---|
| Map步骤 | 构建kernel map,存储必要的GEMM操作 | 哈希表导致不规则内存访问,缓存命中率低 |
| GMaS步骤 | Gather-GEMM-Scatter执行GEMM操作 | 固定tile大小,GEMM分组padding开销大 |
现有SC引擎的三大缺陷
| 缺陷 | 说明 | 影响 |
|---|---|---|
| 哈希表内存效率低 | 大量查询导致不规则全局内存访问 | 缓存命中率低,数据访问成本高 |
| 固定tile大小 | 无法适应不同SC层、数据集和GPU架构 | Gather/Scatter性能次优 |
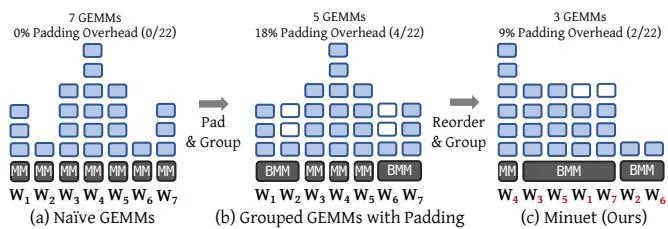
| GEMM分组padding开销 | 按weight offset顺序分组,padding比例高 | 冗余数据访问和计算 |
解决方案概述
Minuet提出三个关键优化:
| 优化 | 说明 | 效果 |
|---|---|---|
| 分段排序双遍历二分搜索 | 替换哈希表,利用GPU片上缓存 | Map步骤加速15.8× |
| 自适应tile大小 | 轻量级自动调优Gather/Scatter的tile大小 | 适应不同层和架构 |
| Padding高效GEMM分组 | 按GEMM大小重排后分组 | 减少padding和内核启动开销 |
三、技术架构
整体框架
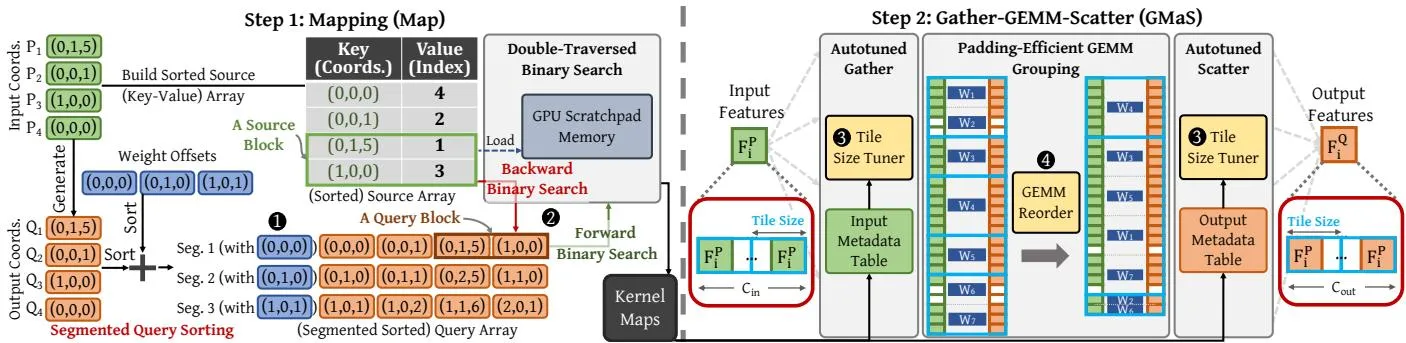
分段排序双遍历二分搜索
核心观察:当执行排序查询时,二分搜索可以利用连续排序查询之间的数据局部性。
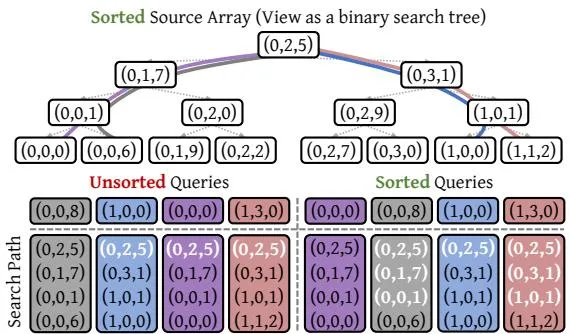
算法设计:
1. 分段查询排序(而非全排序):
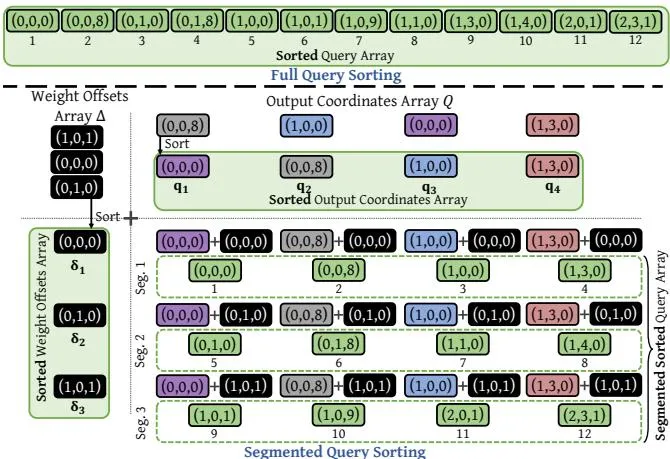
- 全排序:需要全局同步,开销大
- 分段排序:按weight offset分段排序,减少同步开销
2. 排序开销优化:
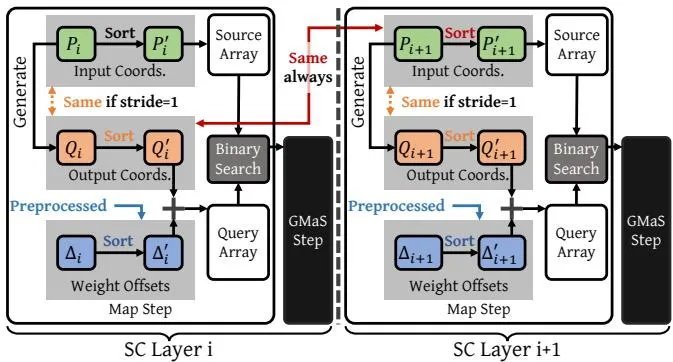
- 相邻SC层的weight offset和output coordinates可复用排序结果
- 减少重复排序开销
3. 反向二分搜索:
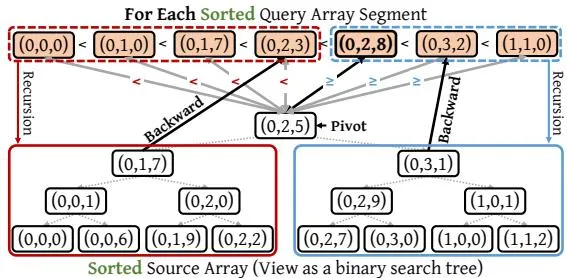
- 在源数组的每个块中,用反向搜索找到pivot在查询数组段中的下界
- 减少比较次数
4. 双遍历执行:
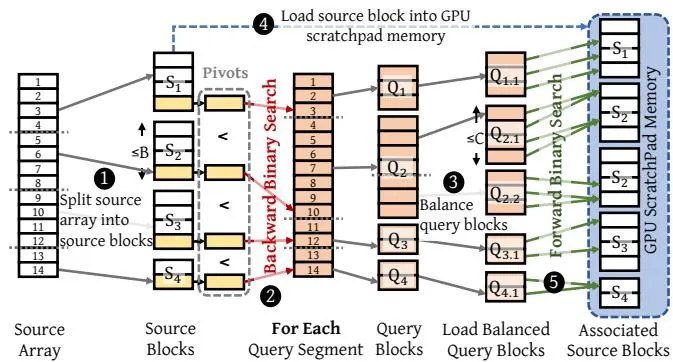
- 第一遍:反向搜索,找到每个源块对应的查询段范围
- 第二遍:正向搜索,在scratchpad中执行高效二分搜索
计算复杂度:
配置和后,复杂度接近哈希表。
L2缓存命中率:Minuet > 95%(vs 哈希表随点数增加显著下降)。
自适应Tile大小
问题:固定tile大小(如128字节)在不同SC层、数据集和GPU架构下性能差异大。
解决方案:轻量级自动调优
- 在Gather和Scatter操作前,动态测试不同tile大小
- 选择最优tile大小适应当前层特性
- 调优开销可忽略(< 2分钟完成所有数据集)
Padding高效GEMM分组
问题:按weight offset顺序分组GEMM,padding比例高(TorchSparse平均11%)。
解决方案:
- 按GEMM操作的输入/输出特征向量大小重排weight
- 相邻weight具有相似大小,减少padding需求
- 排序开销 < 4%层执行时间
效果:
- Minuet padding开销:8.2%(vs TorchSparse 11%)
- Minuet GEMM内核数:7.76(vs TorchSparse 11.1)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分段排序二分搜索 | 替换哈希表,利用缓存局部性 | L2命中率>95%,Map加速15.8× |
| 双遍历搜索 | 反向+正向搜索减少比较 | 复杂度接近哈希表 |
| 自适应tile大小 | 动态调优Gather/Scatter | 适应不同层和架构 |
| GEMM重排分组 | 按大小重排后分组 | padding从11%降至8.2% |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| GPU | RTX 2070, RTX 2080 Ti, RTX 3090, A100 |
| 数据集 | SemanticKITTI, nuScenes, ScanNet, S3DIS, 合成数据集 |
| 网络 | ResNet, UNet (MinkowskiNet, SpUNet) |
| 基线 | MinkowskiEngine, TorchSparse |
| 指标 | 端到端加速比, Map步骤加速, GMaS步骤加速 |
端到端性能
关键结果:
| 对比 | 平均加速比 | 最高加速比 |
|---|---|---|
| vs MinkowskiEngine | 1.74× | 2.19× |
| vs TorchSparse | 1.74× | 2.22× |
关键发现:
- Minuet在所有网络、数据集和GPU架构上一致优于基线
- UNet在RTX 2070/2080 Ti/3090上接近2×加速(vs MinkowskiEngine)
- MinkowskiEngine在小通道层(ResNet)更优,TorchSparse在大通道层更优,Minuet在所有配置下最优
不同点云密度
| 密度范围 | 平均加速比 | 最高加速比 |
|---|---|---|
| 10^4 - 10^6 点 | 1.68× | 1.90× |
Minuet在各种输入密度下一致优于现有SC引擎。
加速分解
各优化贡献:
| 优化 | 贡献 |
|---|---|
| 分段查询排序 | 最显著(Map步骤核心优化) |
| 反向二分搜索 | 减少比较次数 |
| 自适应tile大小 | GMaS步骤优化 |
| GEMM重排分组 | 减少padding开销 |
Map步骤性能
L2缓存命中率:Minuet > 95%
加速比:
| 对比 | 平均加速比 | 最高加速比 |
|---|---|---|
| vs MinkowskiEngine | 19.2× | 26.8× |
| vs TorchSparse | 13× | 24.6× |
关键发现:
- 哈希表实现的缓存命中率随点数增加显著下降
- Minuet的二分搜索提供鲁棒解决方案,性能收益在各种输入规模下保持
GMaS步骤性能
不同通道配置下的加速比:
| 对比 | 平均加速比 | 最高加速比 |
|---|---|---|
| vs MinkowskiEngine | 1.40× | 2.38× |
| vs TorchSparse | 1.37× | 1.59× |
Padding开销对比:
- Minuet:8.2% padding,7.76 GEMM内核
- TorchSparse:11% padding,11.1 GEMM内核
六、相关工作
| 方法类别 | 代表方法 | 特点 | 与Minuet的区别 |
|---|---|---|---|
| SC引擎 | MinkowskiEngine | 小通道优化 | 哈希表效率低 |
| SC引擎 | TorchSparse | 批量GEMM | 固定tile,高padding |
| SC引擎 | SpConv | 数据局部性 | 未优化Map步骤 |
| 稀疏编译 | UCFF, SparseTIR | 编译器方法 | 通用性 vs 专用优化 |
七、总结
核心贡献
- 分段排序双遍历二分搜索:首次在GPU SC中用二分搜索替代哈希表,Map步骤加速15.8×
- 自适应tile大小:动态调优Gather/Scatter操作,适应不同层和架构
- Padding高效GEMM分组:按GEMM大小重排后分组,减少padding和内核启动
- 显著端到端加速:平均1.74×(最高2.22×)
技术影响
- 内存效率:L2缓存命中率>95%,显著减少全局内存访问
- 计算效率:减少冗余padding和GEMM内核启动
- 通用性:适用于各种点云网络、数据集和GPU架构
- 开源:代码公开可复现
局限性
- 排序开销:虽然<4%,但在极小层上可能成为瓶颈
- 自适应调优:需要预运行调优过程(<2分钟)
- GEMM库依赖:仍依赖cuBLAS等外部库
- 稀疏模式:主要针对3D点云,其他稀疏模式需适配
八、参考资源
- 论文:arXiv:2401.06145
- 代码:GitHub - Minuet
- 相关项目:MinkowskiEngine, TorchSparse, SpConv