Fairness in Serving Large Language Models
提出 Virtual Token Counter (VTC) 公平调度算法,实现 LLM 推理服务的 token 粒度公平共享,证明 2x 紧上界
Fairness in Serving Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Fairness in Serving Large Language Models |
| 作者 | Ying Sheng*, Shiyi Cao, Dacheng Li, Banghua Zhu, Zhuohan Li, Danyang Zhuo, Joseph E. Gonzalez, Ion Stoica† |
| 机构 | UC Berkeley, Stanford University, Duke University |
| 论文 | arXiv:2401.00588 |
| 代码 | GitHub |
| 发布 | 2023-12-31 (v1), 2024-06-05 (v2) |
| 许可 | arXiv nonexclusive-distrib/1.0 |
二、核心思想
问题定义
当前 LLM 推理服务(如 ChatGPT、BARD)面临公平性挑战:
- FCFS 调度缺乏隔离: 发送大量请求的客户端会拖慢其他所有客户端的服务
- RPM 限流导致资源浪费: 即使系统有空闲容量,超限客户端的请求仍被拒绝
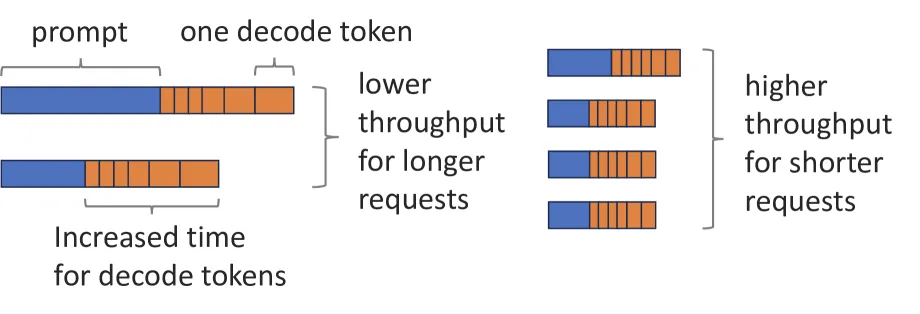
- LLM 服务的独特挑战: 请求长度未知、token 成本可变(输入 vs 输出)、服务器有效容量动态变化
解决方案概述
本文提出 Virtual Token Counter (VTC) 公平调度算法:
- Token 粒度公平: 在 token 级别(而非请求级别)实现公平共享,避免请求异构性导致的不公平
- 虚拟计数器跟踪: 为每个客户端维护虚拟 token 计数器,优先服务计数器最低的客户端
- 计数器提升机制: 客户端重新加入队列时提升计数器,防止低负载期积累的”信用”被滥用
- 理论保证: 证明 backlog 客户端间服务差异的 2x 紧上界
三、技术架构
整体框架图
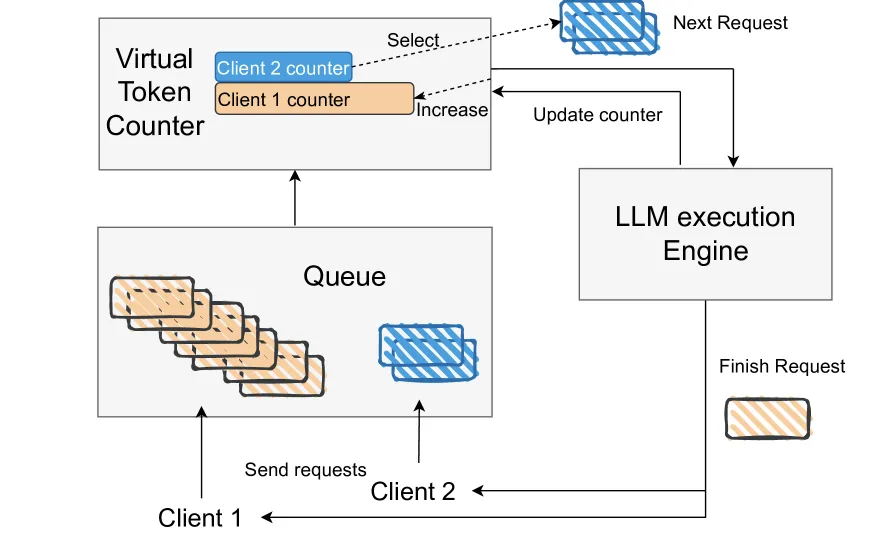
VTC 架构包含两个并行流:
- 监控流: 监听新请求,加入等待队列,处理计数器提升
- 执行流: 基于连续批处理,选择计数器最低的客户端请求加入批次
核心公式
加权 Token 服务度量:
其中 为输入 token 权重, 为输出 token 权重, 为输入 token 数, 为输出 token 数。
VTC 公平性上界 (Theorem 4.4):
对于任意两个 backlog 客户端 和 ,在时间区间 内:
其中 为请求最大输入 token 数, 为批次最大 token 数。
计数器不变量 (Lemma 4.3):
响应时间上界 (Theorem 4.11):
对于非 backlog 客户端 ,下一个请求的响应时间:
其中 为服务器容量下界。
公平性三性质
| 性质 | 说明 | 形式化 |
|---|---|---|
| Backlog 客户端公平 | 两个持续 backlog 的客户端应获得相同服务 | |
| 非 backlog 客户端保护 | backlog 客户端不应比非 backlog 客户端获得更少服务 | |
| Work-conservation | 只要队列非空,服务器不应空闲 | 最大化资源利用 |
VTC 算法流程
算法 2 (VTC) 关键步骤:
- 初始化: 所有客户端计数器
- 监控流:
- 新请求到达时加入等待队列
- 若客户端是 中唯一代表,执行计数器提升(防止低负载期信用累积)
- 执行流:
- 选择计数器最小的客户端请求加入批次
- 更新计数器:
- 每次解码后更新:
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个 LLM 公平服务定义 | 基于加权 token 的服务度量 | Section 3 |
| VTC 调度算法 | token 粒度公平 + 计数器提升 | Algorithm 2 |
| 2x 紧上界证明 | backlog 客户端服务差异上界为最优的 2 倍 | Theorem 4.4 + 4.8 |
| Work-conservation 保证 | 不拒绝可容纳的请求 | Theorem 4.8 |
| 非 backlog 客户端延迟界 | 响应时间与其他客户端请求率无关 | Theorem 4.11 |
| Weighted VTC | 支持客户端优先级权重 | Section 4.3 |
| VTC + 长度预测 | 利用历史输出长度预测减少服务差异 | Algorithm 3 |
五、代码实现分析
实现基础: S-LoRA (LightLLM 后端),包含连续批处理和 PagedAttention
代码量: VTC 调度器约 100 行代码,薄层封装现有调度器
基线对比:
- FCFS: 默认调度策略
- RPM: 请求速率限制
- LCF (Least Counter First): 无计数器提升的 VTC 变体
- VTC (predict): 使用最近 5 个请求的平均输出长度预测
- VTC (oracle): 100% 准确率的理想预测器
六、实验结果
合成工作负载
实验设置: Llama-2-7b, A10G (24GB), KV cache 内存池 100008
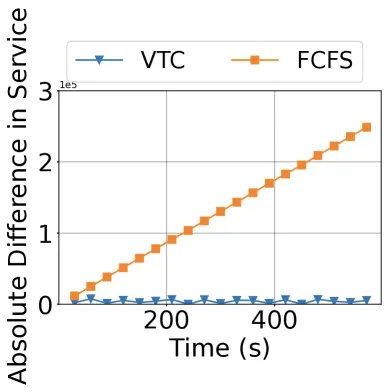
恒定请求率 (2 客户端):
- Client 1: 90 rpm, Client 2: 180 rpm,均 backlog
- VTC: 服务差异保持有界
- FCFS: 服务差异随时间增长
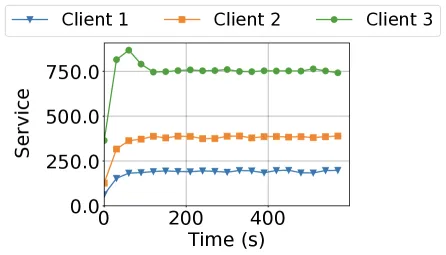
Work-conservation (3 客户端):
- Client 1: 15 rpm, Client 2: 30 rpm (均 < 1/2 容量), Client 3: 90 rpm (> 1/2 容量)
- Client 1/2 立即获得服务,Client 3 消耗剩余容量
ON/OFF 模式
- Client 2 始终 ON (120 rpm), Client 1 周期性 ON/OFF (30 rpm during ON)
- Client 1 ON 阶段请求基本立即处理
- OFF 阶段 Client 1 获得全部容量(work-conservation)
可变长度 + 泊松到达
- Client 1: 短请求 (64+64), 480 rpm
- Client 2: 长请求 (256+256), 90 rpm
- VTC 保持服务差异有界,FCFS 无法维持公平
真实工作负载
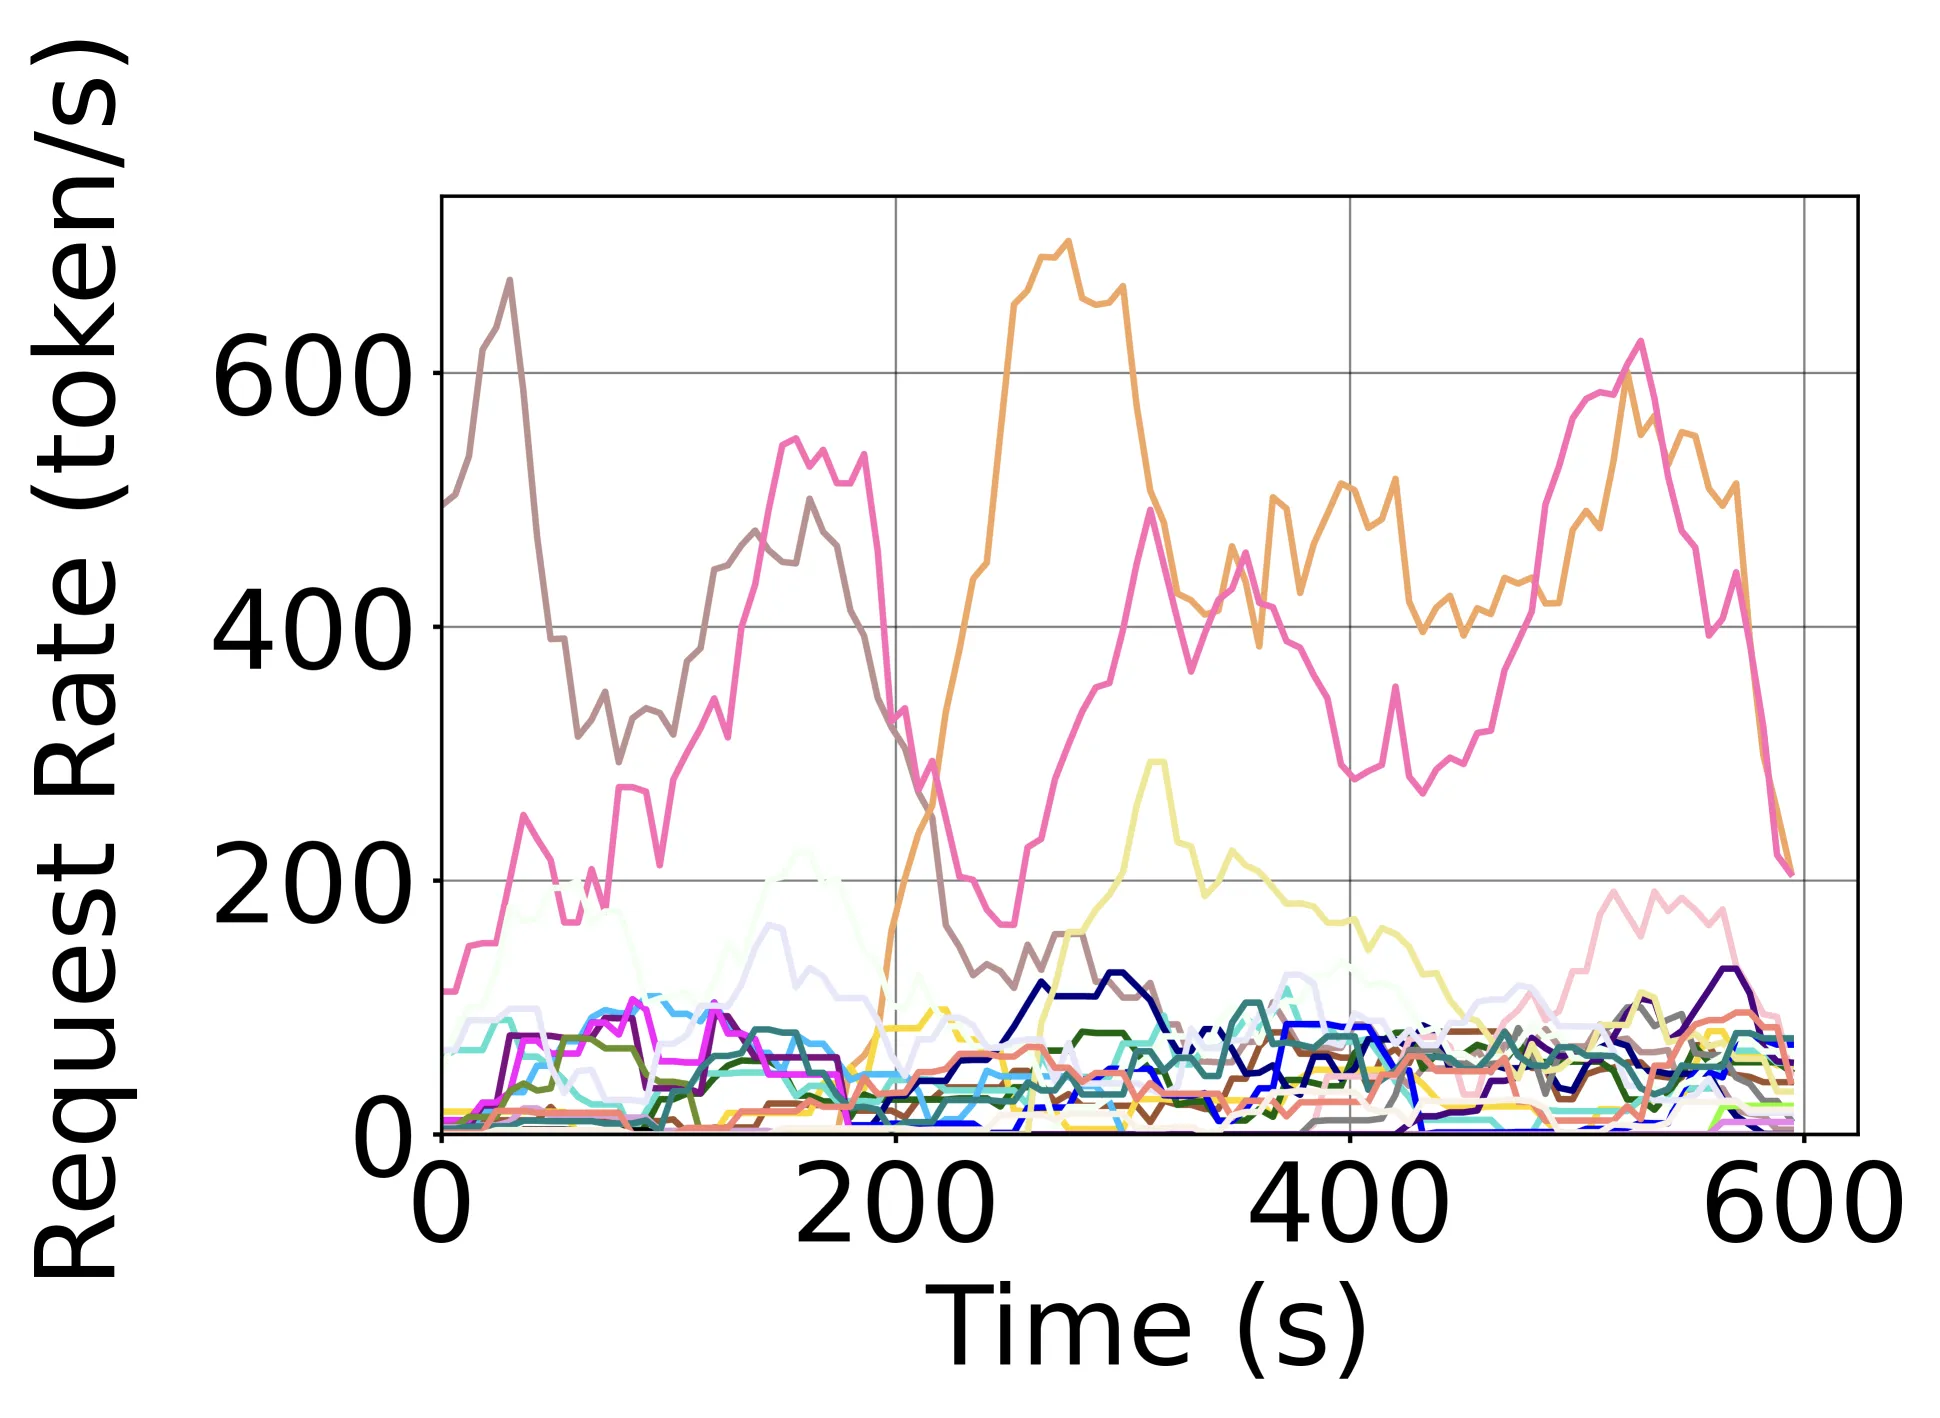
实验设置: LMSYS Chatbot Arena 10 分钟 trace, 27 个客户端 (每个 LLM 作为独立客户端), Llama-2-7b, A10G
平均输入长度: 136 tokens, 平均输出长度: 256 tokens
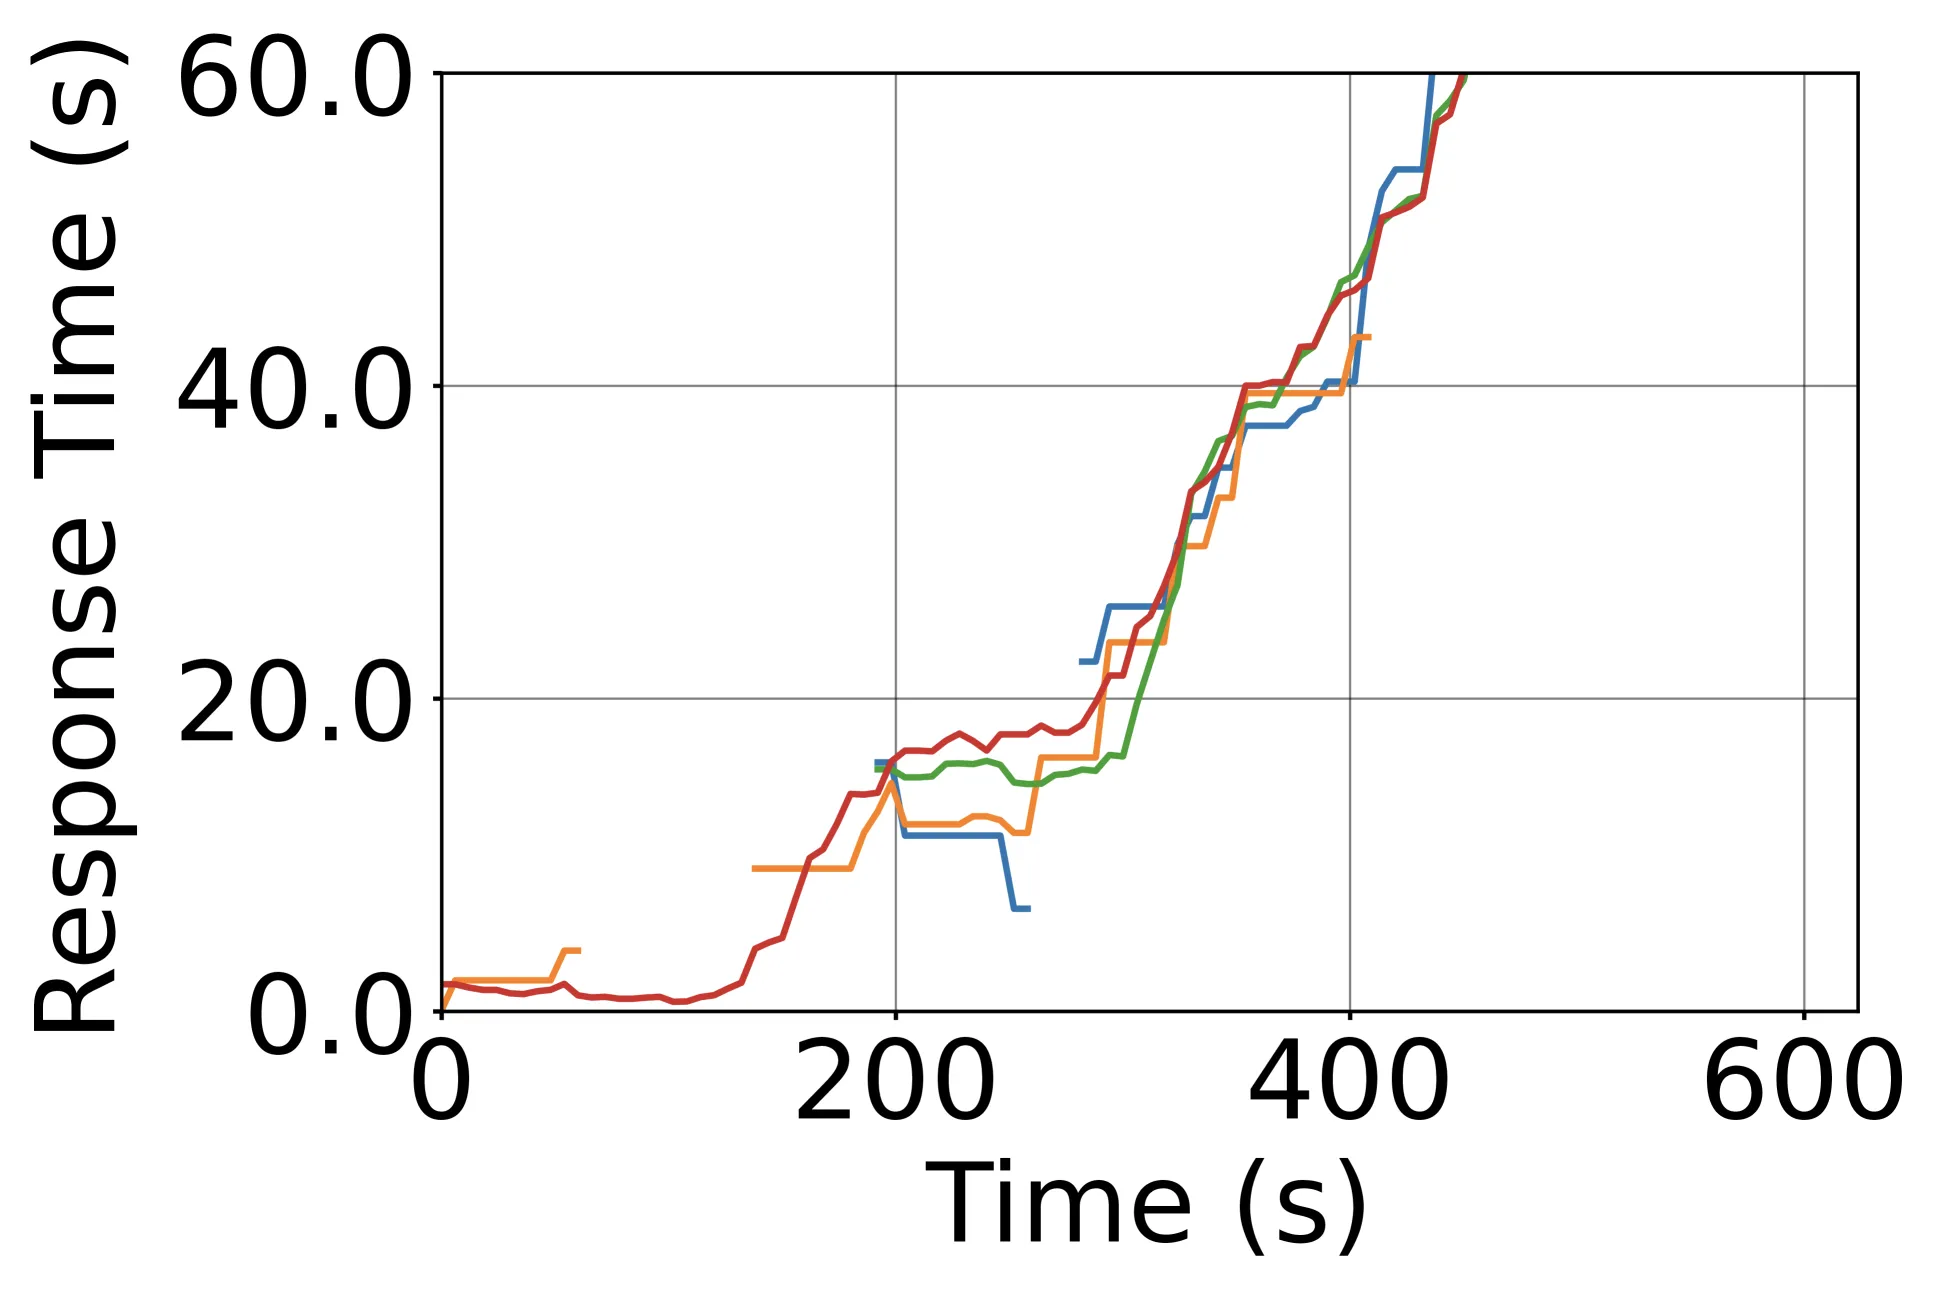
| 调度器 | Max Diff | Avg Diff | Diff Var | Throughput (tok/s) | Isolation |
|---|---|---|---|---|---|
| FCFS | 759.97 | 433.53 | 32112.00 | 777 | No |
| LCF | 750.49 | 323.82 | 29088.90 | 778 | Some |
| VTC | 368.40 | 251.66 | 6549.16 | 779 | Yes |
| VTC(predict) | 365.47 | 240.33 | 5321.62 | 773 | Yes |
| VTC(oracle) | 329.46 | 227.51 | 4475.76 | 781 | Yes |
| RPM(5) | 143.86 | 83.58 | 1020.46 | 340 | Some |
| RPM(20) | 446.76 | 195.71 | 7449.79 | 694 | Some |
| RPM(30) | 693.66 | 309.45 | 24221.31 | 747 | Some |
关键发现:
- VTC 的 Max Diff 比 FCFS 降低 51.5%
- VTC 的 Throughput 与 FCFS 相当(779 vs 777 tok/s)
- RPM 在公平性与吞吐量间存在根本矛盾:RPM(5) 公平但吞吐量仅 340 tok/s
消融实验
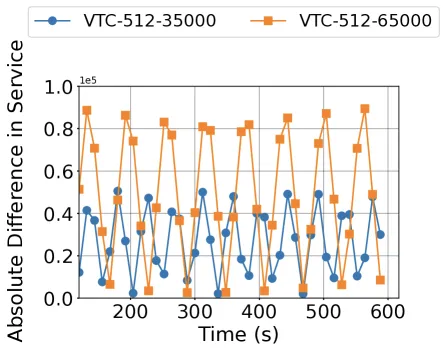
内存池大小影响:
- 35000 vs 65000: 更大内存池 → 更大批次 → 更大服务差异变化
请求长度影响:
- 2562 vs 5122 vs 768*2: 更长请求 → 更大服务差异(未知输出长度的过度补偿)
七、相关工作
| 工作 | 方法 | 本文改进 |
|---|---|---|
| Fair Queueing (网络) | 虚拟时间 + Start/Finish 标签 | 适应 LLM 的未知长度和可变成 |
| CFS (CPU) | vruntime + 最小 vruntime 优先 | 考虑并发批处理特性 |
| DRR | Deficit counter + 量子调度 | 无需预先知道请求长度 |
| RPM (工业界) | 固定速率限制 | Work-conservation + 更高吞吐量 |
| FastServe | 抢占式调度最小化 JCT | 关注公平性而非完成时间 |
| Themsis/Pollux | ML 训练公平 | 区分 serving 与 training 的公平性 |
八、总结
核心贡献
- 首个 LLM 服务公平性定义: 基于加权 token 的服务度量,适应 LLM 推理特性
- VTC 调度算法: token 粒度公平 + 计数器提升,约 100 行代码实现
- 2x 紧上界理论证明: backlog 客户端服务差异上界为最优的 2 倍
- 全面实验验证: 合成 + 真实工作负载,证明公平性、work-conservation 和隔离性
技术影响
- VTC 可作为 LLM 推理服务的标准公平调度器: 简单、高效、理论保证
- RPM 的局限性被形式化证明: RPM 在公平性与吞吐量间存在根本矛盾
- Token 粒度公平的重要性: 请求粒度公平因请求异构性而失效
- 计数器提升机制: 防止低负载期信用累积,保证长期公平
局限性
- 无抢占机制: 当前实现不支持请求抢占,留作未来工作
- 长度预测依赖: VTC(predict) 效果依赖预测精度
- 单 GPU 验证: 未验证多 GPU / 张量并行场景
- 批处理约束: 假设连续批处理(无抢占),实际可能需要更灵活的调度
九、参考资源
- 论文链接: arXiv:2401.00588
- PDF 下载: arXiv PDF
- 代码仓库: GitHub
- 实现基础: S-LoRA, LightLLM, PagedAttention, Continuous Batching
- 测试模型: Llama-2-7b, Llama-2-13b
- 测试硬件: A10G (24GB), A100 (80GB)
- 工作负载: LMSYS Chatbot Arena trace (27 客户端)