EE-LLM: Large-Scale Training and Inference of Early-Exit Large Language Models
基于3D并行的大规模Early-Exit LLM训练与推理框架
EE-LLM: Large-Scale Training and Inference of Early-Exit Large Language Models with 3D Parallelism
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | EE-LLM: Large-Scale Training and Inference of Early-Exit Large Language Models with 3D Parallelism |
| 作者 | Yanping Chen, Xiang Meng, et al. |
| 机构 | Alibaba Group |
| 论文 | arXiv:2312.04916 |
| 代码 | GitHub |
| 发布 | 2023-12-08 (v1), 2024-06-16 (v3) |
| 会议 | ICML 2024 |
| 许可 | Apache-2.0 |
二、核心思想
问题定义
大语言模型(LLM)的推理成本随着模型规模增长而急剧上升。Early exiting是一种有前景的推理加速方法:对于简单问题,模型可以在中间层提前退出,无需运行完整的前向传播。然而,现有工作面临三个关键挑战:
- 扩展性瓶颈:最大的early-exit LLM仅有13B参数,无法充分利用大规模模型的能力
- 训练效率:Early exit包含大型输出嵌入矩阵,朴素实现会导致显著的计算开销
- KV缓存冲突:自回归生成中,early exit会导致后续层的KV缓存缺失,阻碍未来token的生成
解决方案概述
EE-LLM是首个支持大规模early-exit LLM训练和推理的框架,基于Megatron-LM构建:
- 轻量级反向传播算法:在pipeline并行下正确计算early-exit训练目标的梯度,无需额外通信开销
- 空闲资源利用:利用原始pipeline调度中的空闲时间进行early-exit层的计算
- Pipeline并行推理:提出新的pipeline并行方案,兼容KV缓存的early-exit推理
三、技术架构
整体框架图
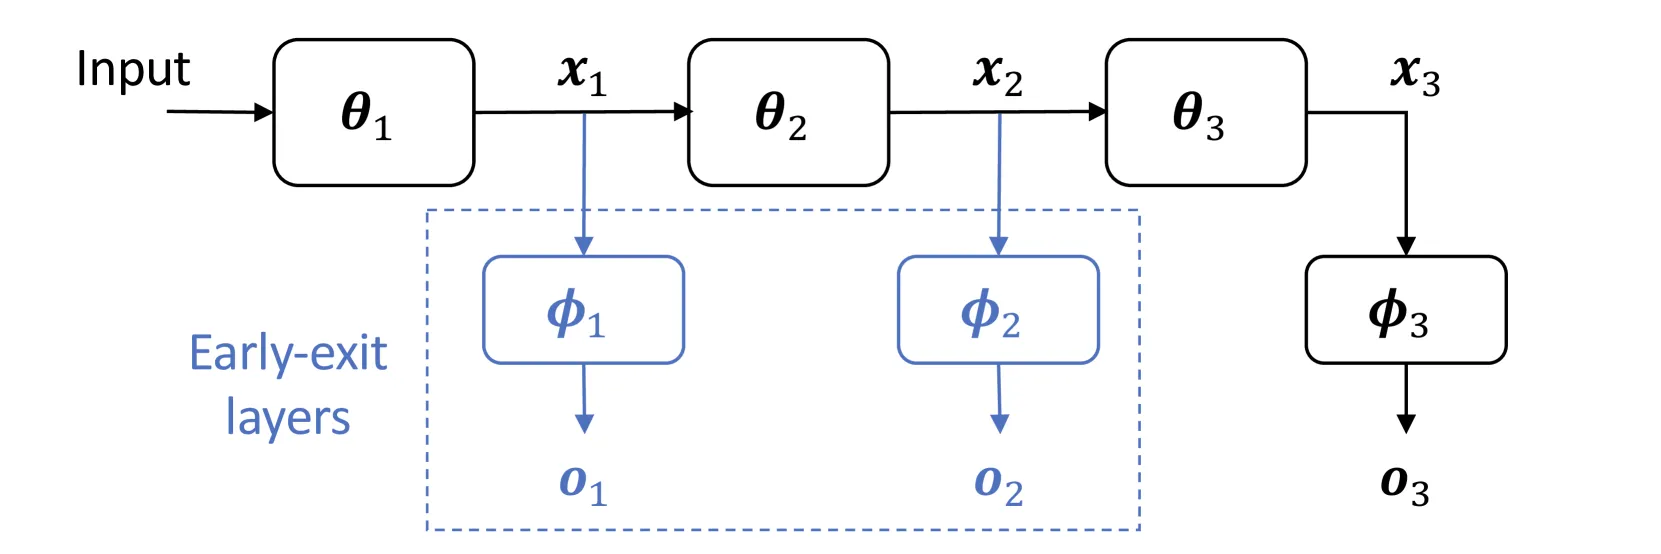
Figure 1: Early-Exit LLM模型架构。相比标准LLM,额外的early-exit层将中间隐藏状态转换为输出。
核心公式
Early-Exit训练目标函数:
其中:
- :N个exit(包括最终exit)
- :第i个exit的标准LLM预训练损失(如next-token prediction的负对数似然)
- :用户指定的损失权重超参数
Pipeline并行下的梯度分解:
其中K是pipeline stage数量,每个是Stage i中一个或多个exit损失的加权和。
Proposition 3.1(核心定理): 在无参数共享的假设下,每个pipeline stage可以独立计算其本地损失的梯度,无需跨stage通信。具体而言:
- 每个stage计算其本地损失相对于该stage输出的梯度
- 梯度通过标准反向传播在stage间传递
- 最终得到的梯度等价于端到端训练的梯度
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Early-Exit层 | 将中间隐藏状态转换为输出logits | 包含输出嵌入矩阵、LayerNorm(可选) |
| Pipeline Stage | 模型沿深度维度分区的stage | 支持1F1B调度 |
| FusedGate | 融合的门控计算 | 产生路由表和亲和度分数 |
训练流程
1F1B Pipeline调度:
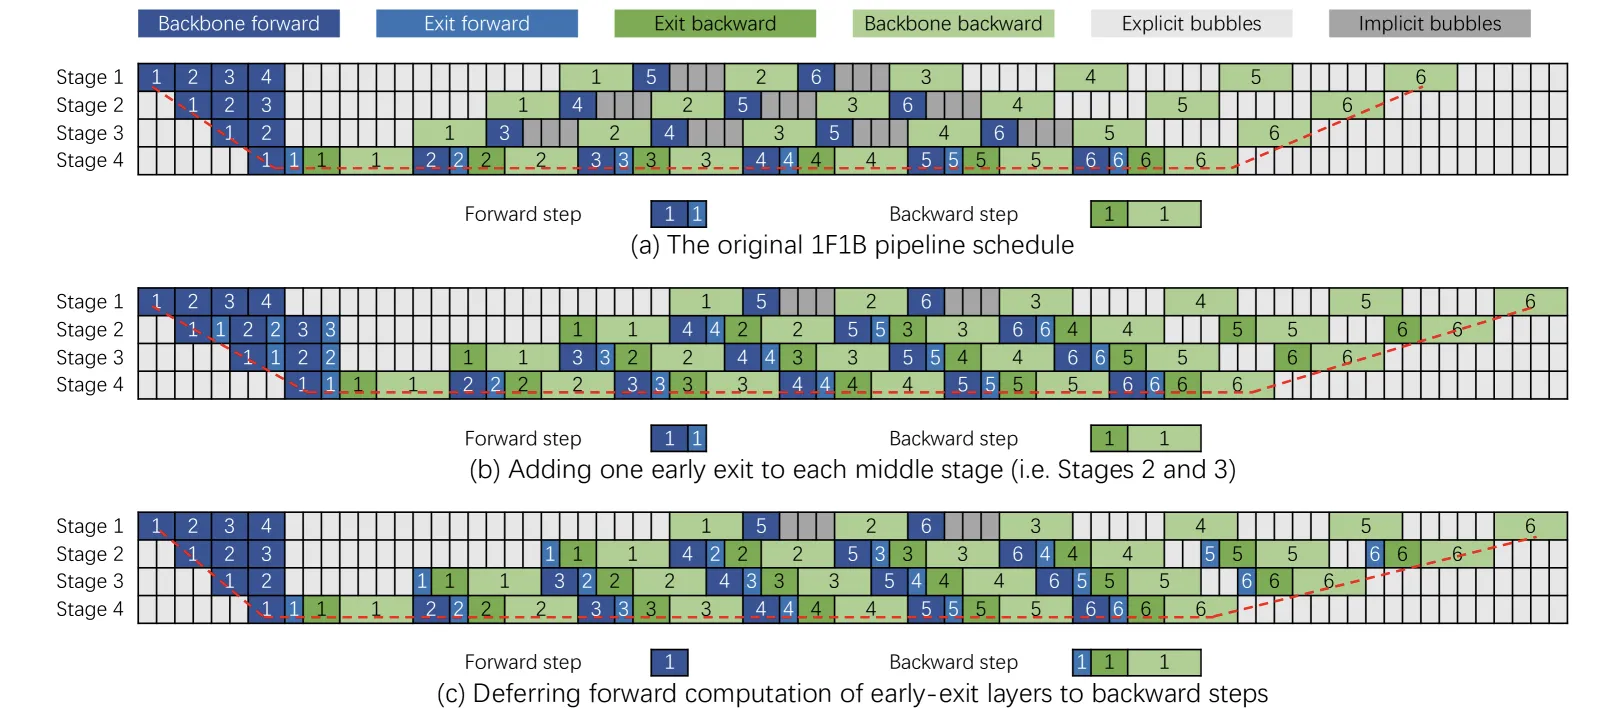
Figure 3: 1F1B pipeline调度示例(P=4 pipeline stages, M=6 microbatches)。
空闲资源利用:
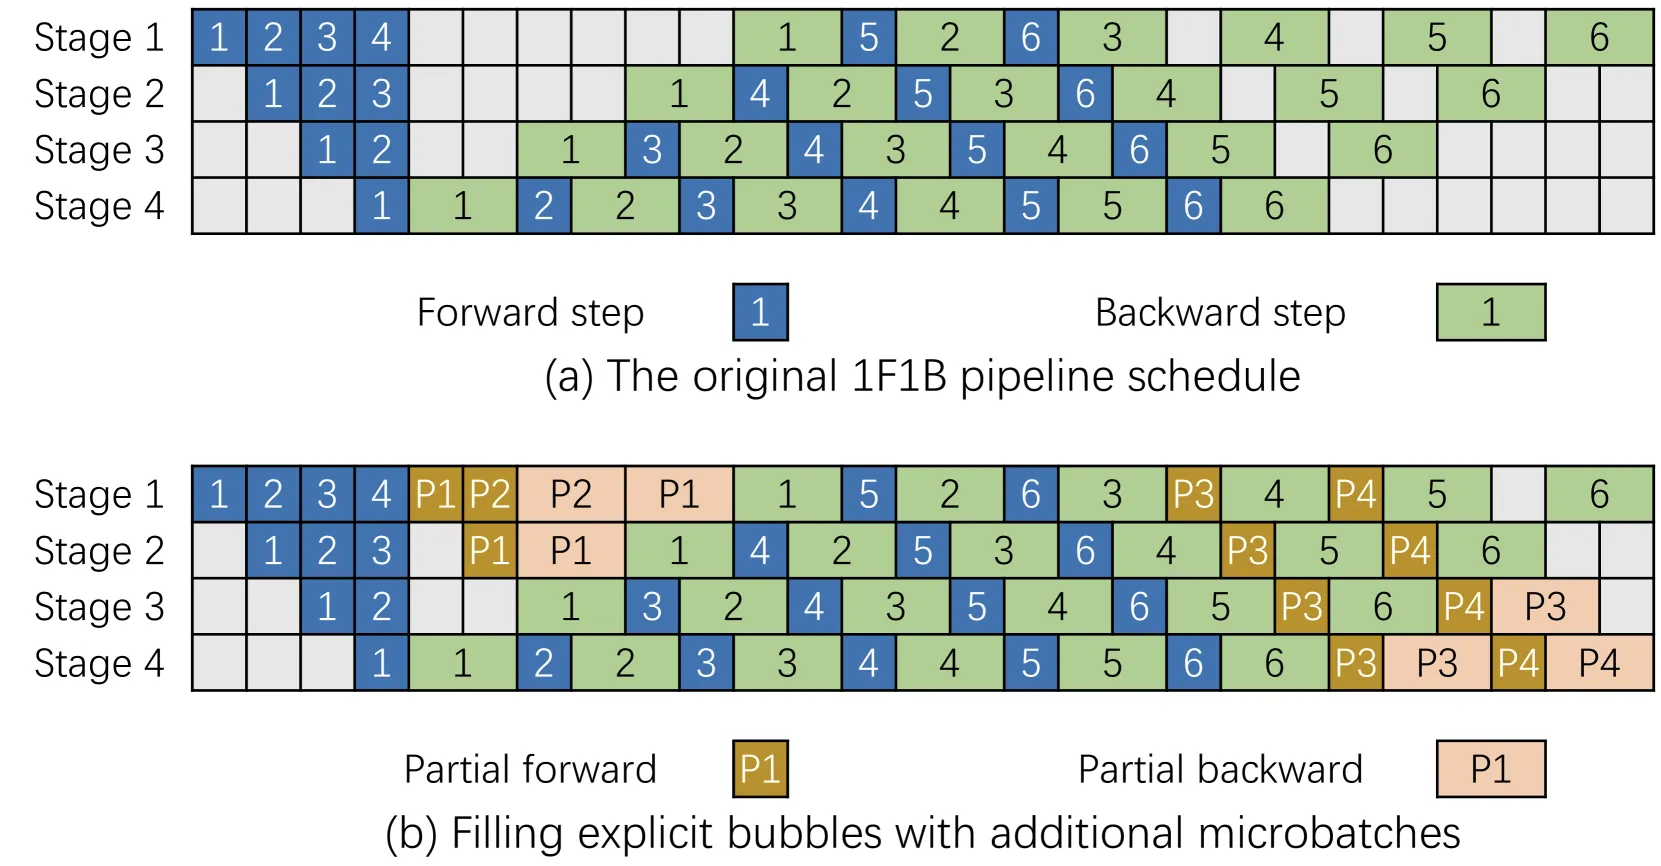
Figure 4: 利用额外microbatch填充pipeline bubble。P1和P2在空闲时间执行early-exit相关计算。
关键设计选择:
- Embedding共享:可选择tie或untie early-exit层的输入/输出嵌入矩阵
- Exit位置:支持在任意Transformer层添加early exit
- 损失权重:灵活配置各exit的损失权重
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 轻量级反向传播 | 在pipeline并行下正确计算early-exit梯度,无额外通信 | 基于Proposition 3.1的理论保证 |
| 空闲资源利用 | 利用pipeline bubble执行early-exit计算 | 训练开销可忽略不计 |
| Pipeline并行推理 | 新的pipeline并行方案兼容KV缓存 | 与标准推理延迟匹配 |
| KV重计算 | 对early-exit token重新计算KV缓存 | 解决KV缓存冲突问题 |
五、代码实现分析
项目结构
EE-LLM/
├── examples/
│   └── ee_training/        # 训练脚本
│       ├── 1-3B.sh
│       ├── 7B.sh
│       ├── 13B.sh
│       └── 30B.sh
├── megatron/               # 基于Megatron-LM的修改
│   ├── model/
│   │   └── transformer.py  # Transformer层修改
│   └── ...
└── README.md
关键配置参数
--exit-layer-nums 6 12      # 在第6和第12层添加early exit
--pre-exit                   # 在Transformer层前放置exit模块
--exit-loss-weights 0.25 0.5 1.0  # 各exit的损失权重
--untie-embedding            # 解绑嵌入矩阵

--micro-batch-size 1
--global-batch-size 2048
--seq-length 2048
--max-lr 3e-4
--lr-decay-style cosine
环境要求
- 容器:NGC PyTorch 22.12 (
nvcr.io/nvidia/pytorch:22.12-py3) - 硬件:16× NVIDIA A100-80G GPU或更高
- 框架:Megatron-LM(兼容3D并行)
六、实验结果
实验设置
- 硬件:8节点,每节点8× NVIDIA A100-80G GPU(共64 GPU)
- 模型规模:1.3B、7B、13B、30B
- 优化器:Adam(β₁=0.9, β₂=0.95, ε=10⁻⁸)
- 学习率:3×10⁻⁴,余弦退火
- 数据:Data-Juicer预训练数据子集
训练收敛性
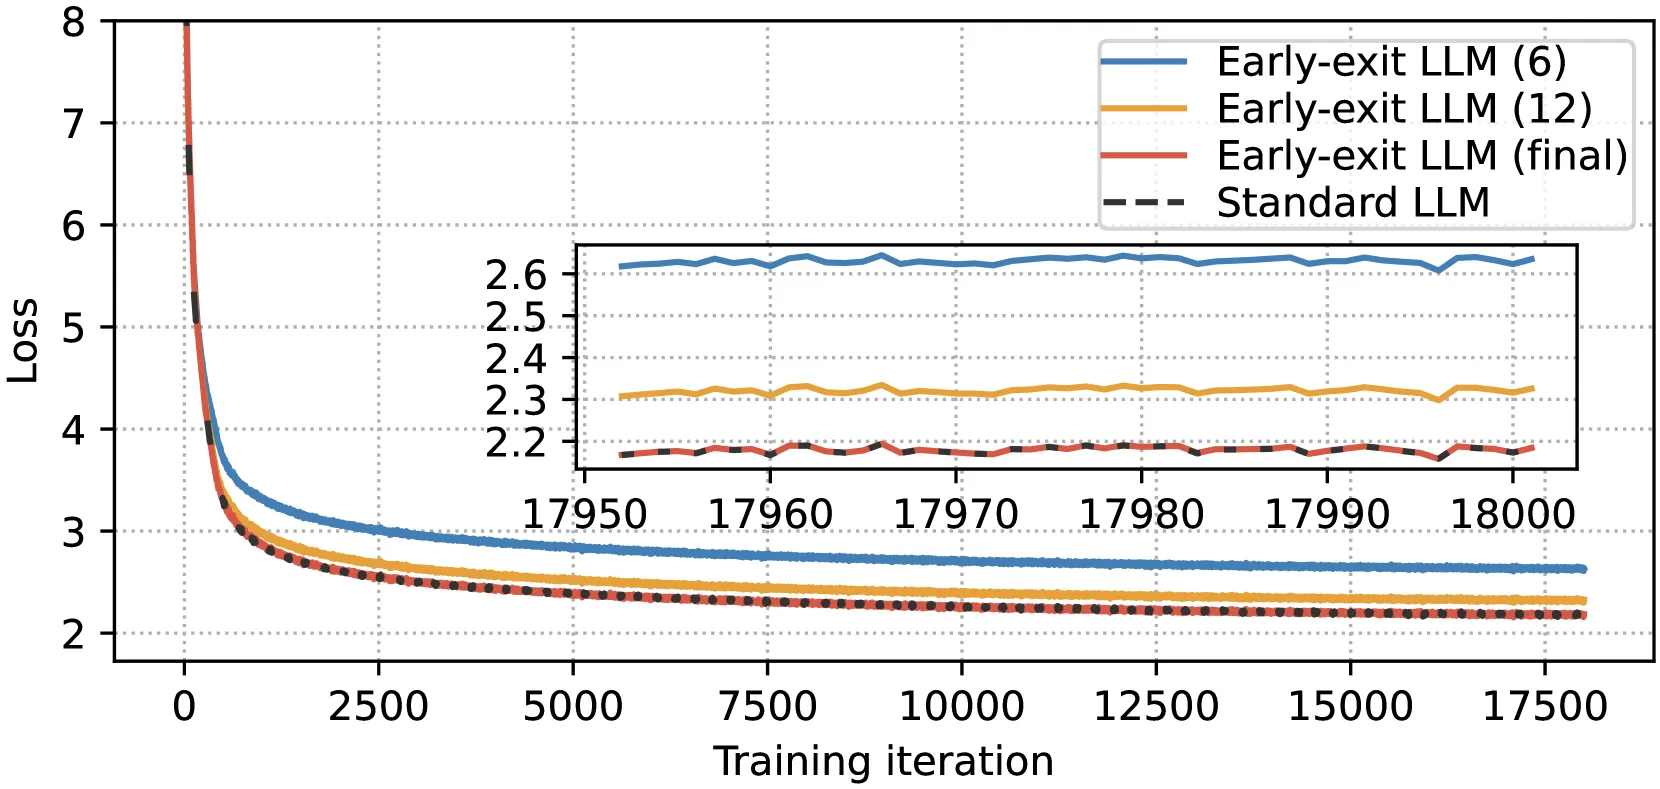
Figure 6(a): 1.3B模型训练损失收敛。Early-exit损失与final-exit损失同步下降。
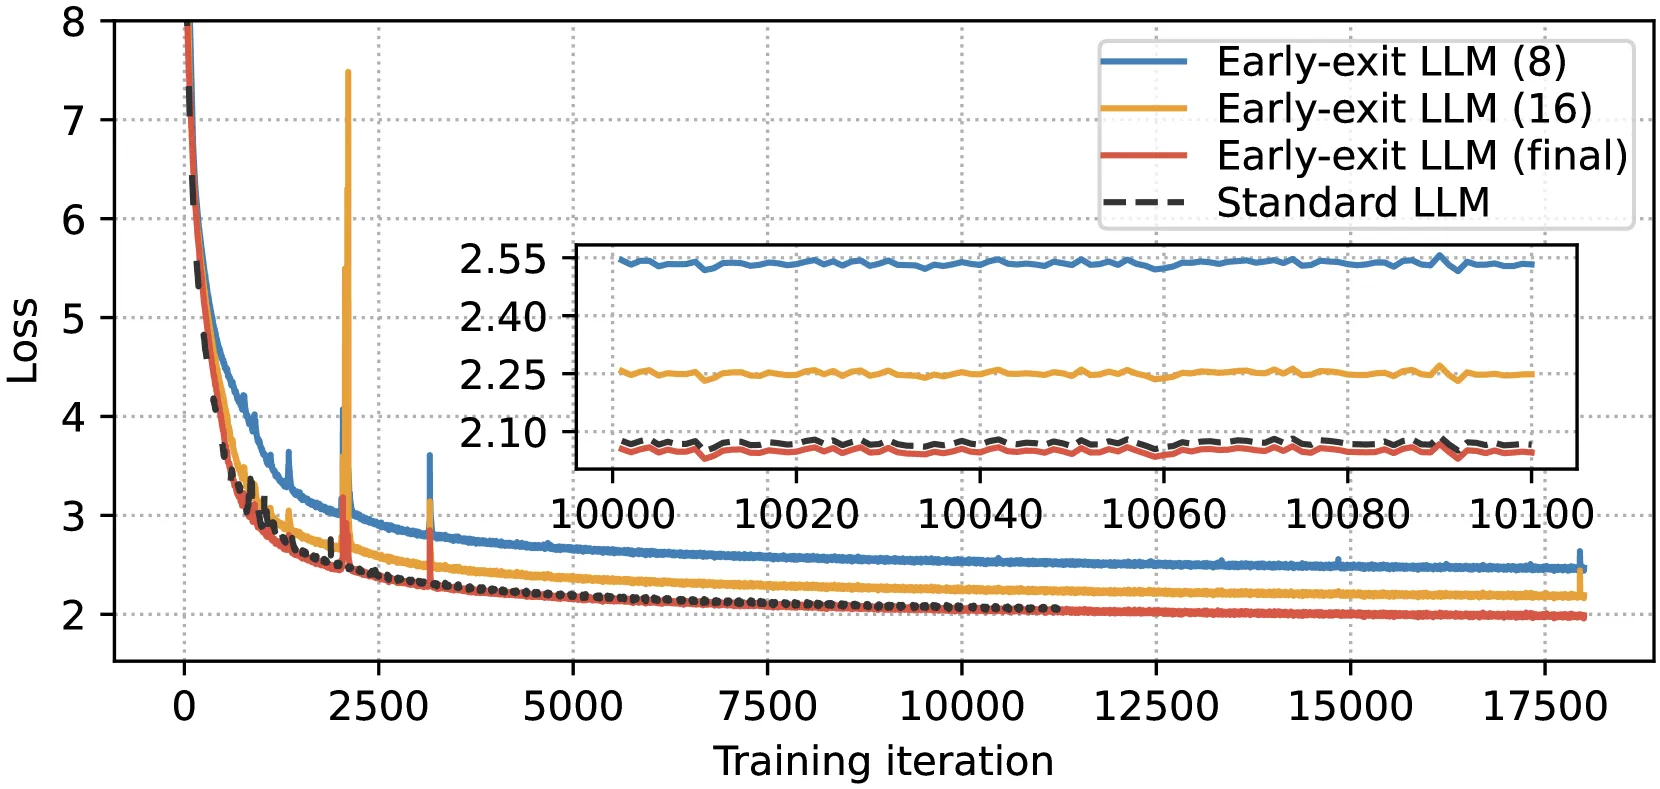
Figure 6(b): 7B模型训练损失收敛。Early-exit模型的final-exit损失接近甚至略低于标准模型。
关键发现:
- 所有损失曲线以相似速度下降
- Early-exit损失略高于final-exit损失
- Early-exit训练不会损害final-exit的输出质量
训练效率
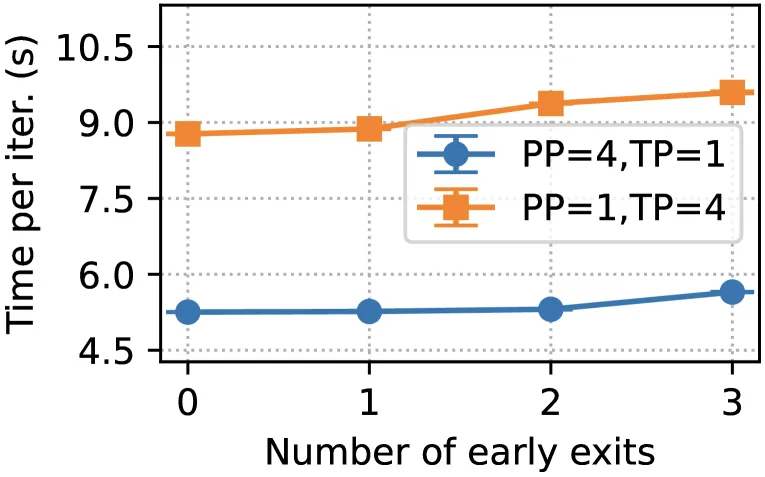
Figure 7(a): 1.3B模型每次迭代训练时间和峰值GPU内存。
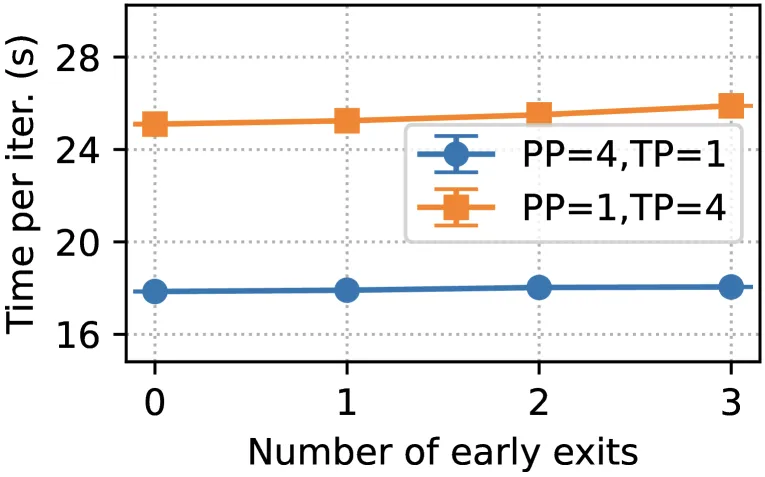
Figure 7(b): 7B模型每次迭代训练时间和峰值GPU内存。
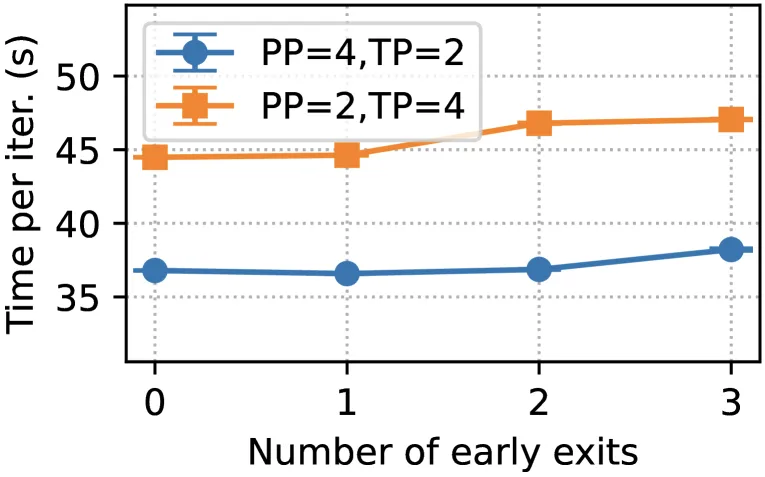
Figure 7(c): 13B模型每次迭代训练时间和峰值GPU内存。
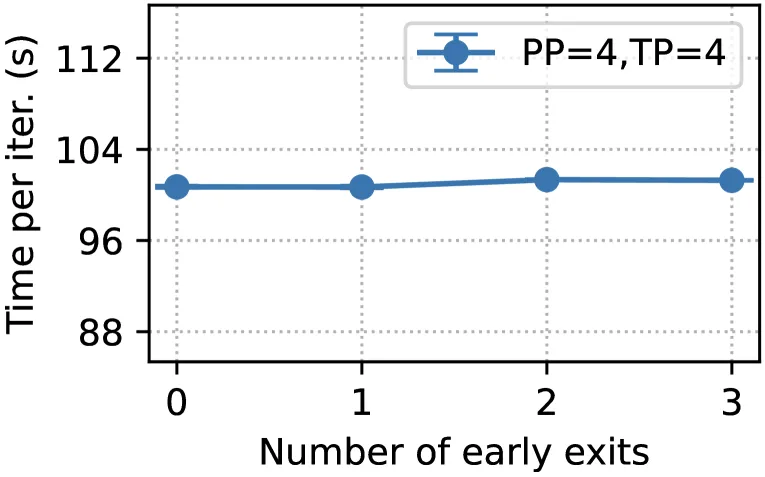
Figure 7(d): 30B模型每次迭代训练时间和峰值GPU内存。
关键结论:
- 增加early exit的数量对训练时间和内存的影响可忽略不计
- 30B模型在添加3个early exit后,训练开销几乎为零
推理加速
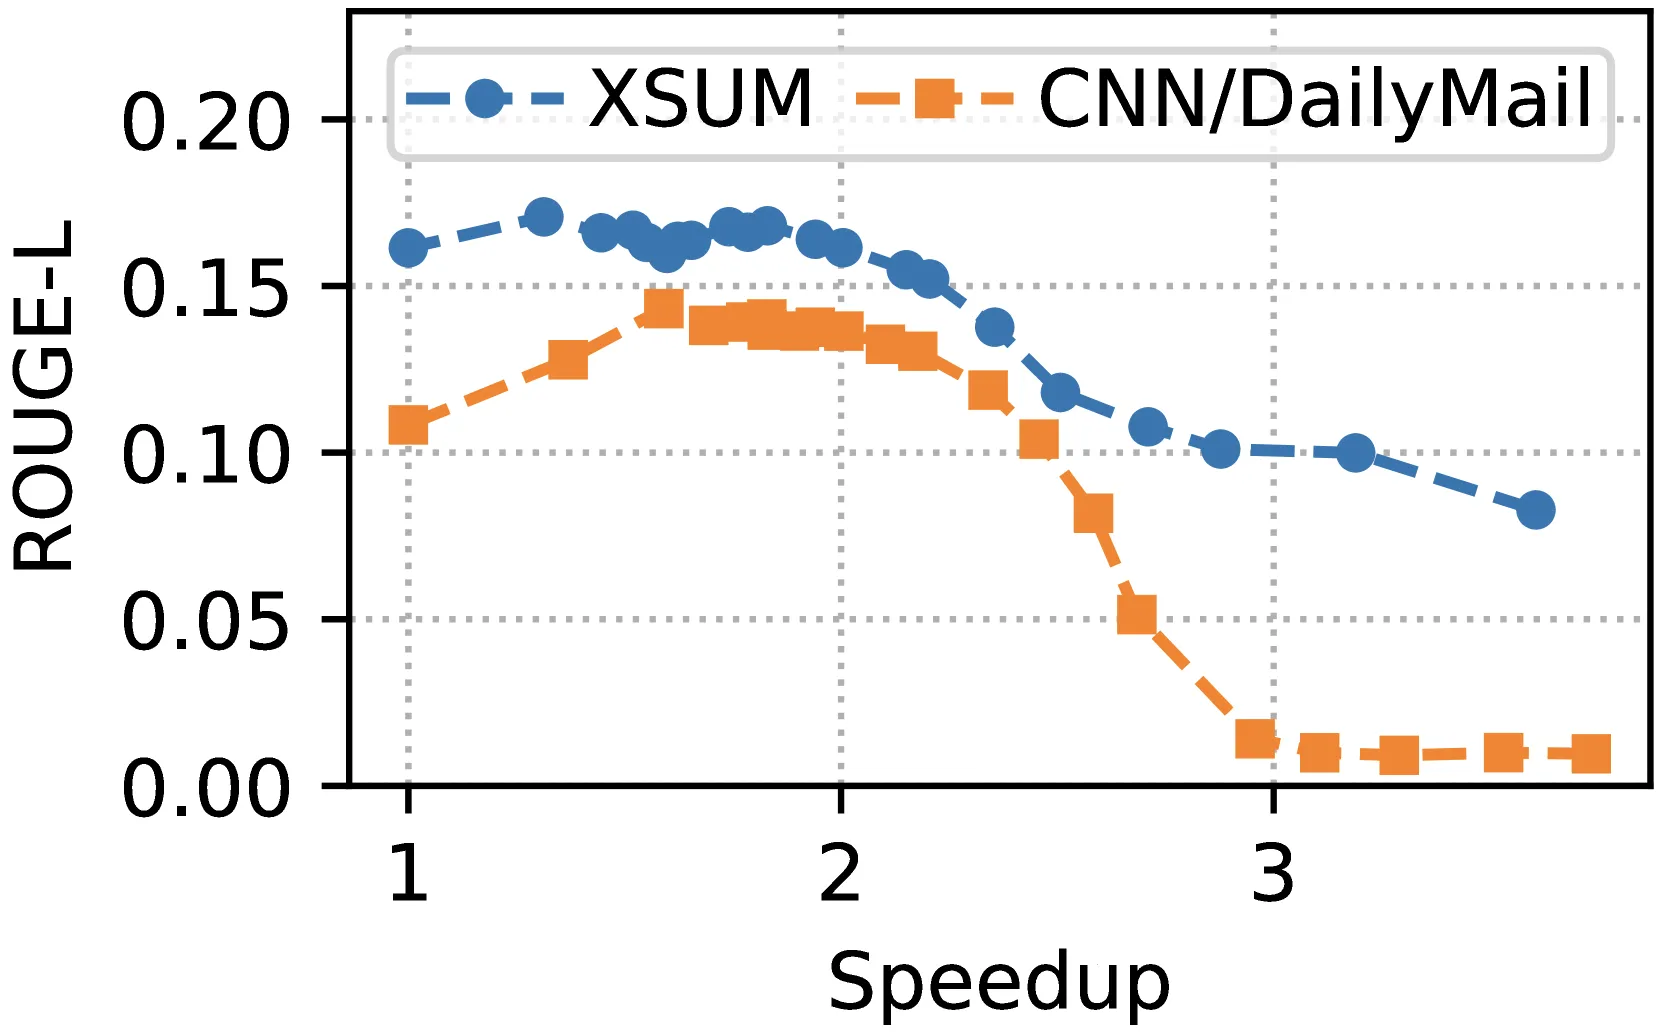
Figure 8(a): 1.3B模型推理加速比。
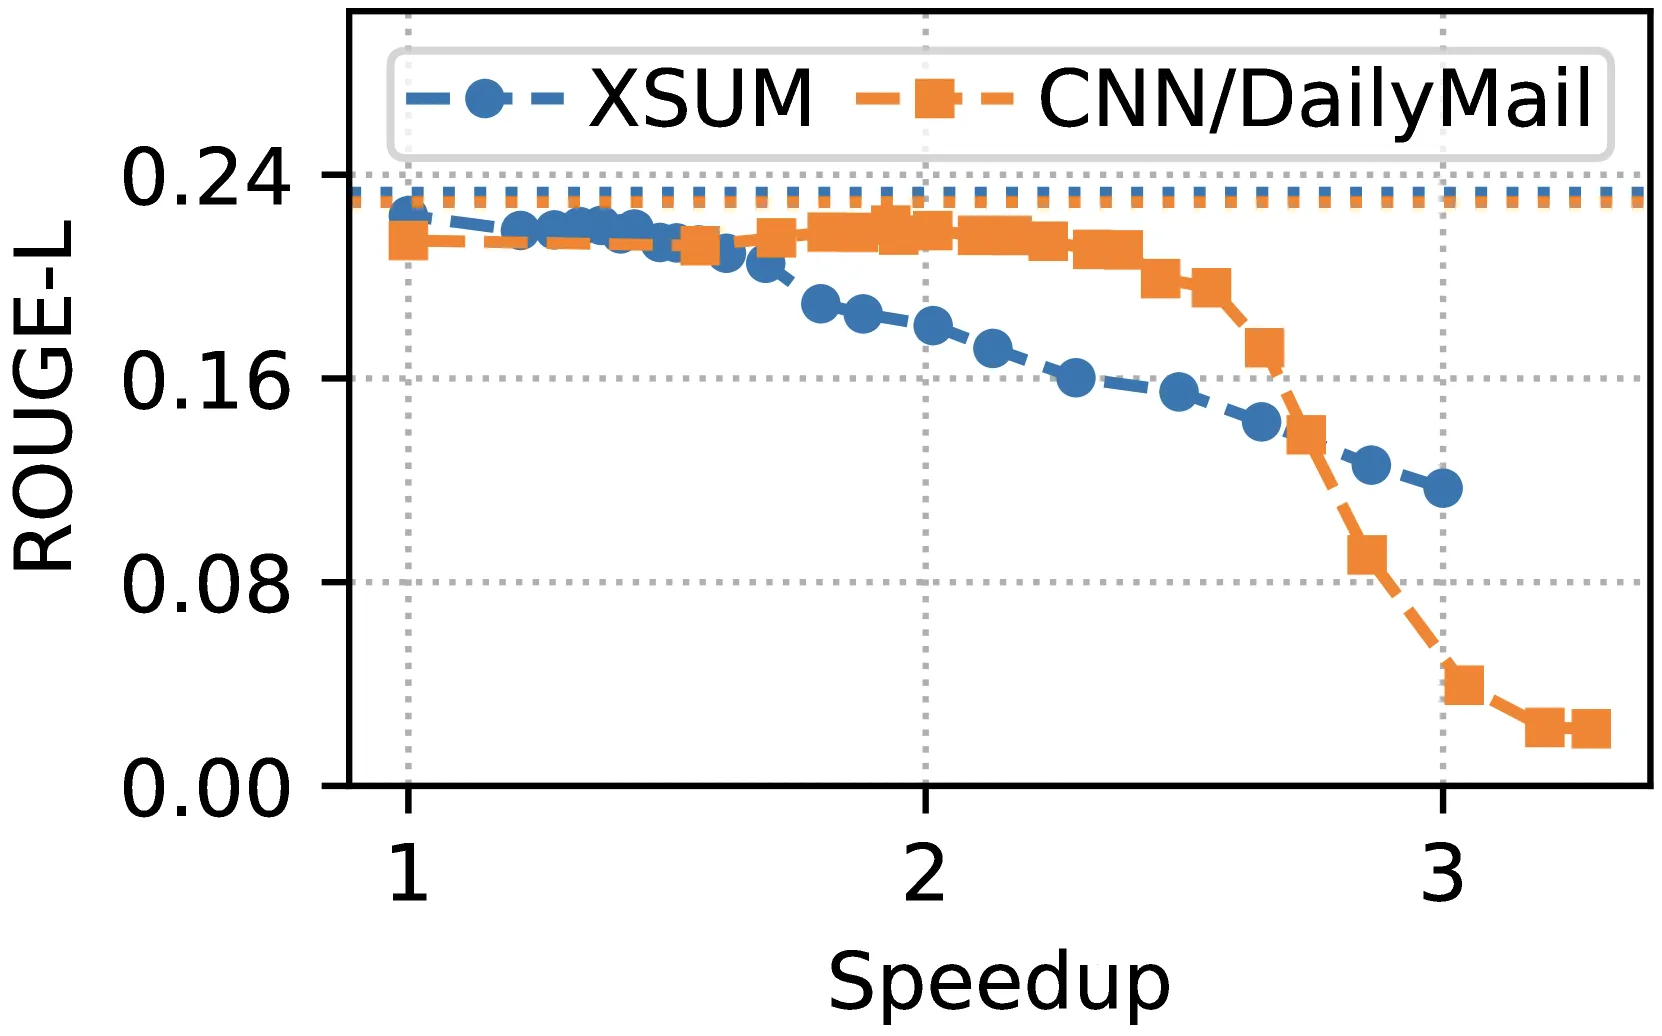
Figure 8(b): 7B模型推理加速比。
与现有方法对比
| 方法 | 模型规模 | KV缓存兼容 | 训练支持 | 推理加速 |
|---|---|---|---|---|
| EE-LLM | 30B+ | ✓ | ✓ | ✓ |
| Varshney et al. | 13B | ✗ | ✓ | ✓ |
| SkipDecode | - | ✓ | ✗ | ✓ |
| State Propagation | - | ✓ | ✗ | ✓ |
七、相关工作
| 方法 | 特点 | EE-LLM优势 |
|---|---|---|
| Megatron-LM | 3D并行训练框架 | 原生支持early-exit LLM |
| SkipDecode | Early-exit推理方法 | 兼容KV缓存,支持训练 |
| State Propagation | KV缓存传播方法 | 无额外传播开销 |
| DeepSpeed | 分布式训练框架 | 支持pipeline并行下的early-exit |
八、总结
核心贡献
- 首个大规模Early-Exit LLM框架:支持高达30B参数的early-exit LLM训练和推理
- 轻量级反向传播算法:在pipeline并行下正确计算梯度,无额外通信开销
- 空闲资源利用:利用pipeline bubble执行early-exit计算,训练开销可忽略
- Pipeline并行推理:新的推理方案兼容KV缓存,实现真正的加速
技术影响
EE-LLM证明了early exiting在大规模LLM中的可行性和有效性:
- 训练效率:增加early exit几乎不增加训练成本
- 推理加速:对于简单问题可实现显著加速
- 输出质量:early-exit训练不会损害最终模型的输出质量
局限性
- 推理加速依赖于问题难度:简单问题加速明显,复杂问题可能需要完整模型
- 硬件要求:需要大规模GPU集群(16+ A100-80G)
- Early-exit层设计:需要仔细选择exit位置和损失权重
未来方向
- 扩展到更大规模模型(100B+)
- 探索更优的early-exit策略
- 与其他推理加速技术(如量化、蒸馏)结合
九、参考资源
- 论文: arXiv:2312.04916
- 代码: GitHub - EE-LLM
- Megatron-LM: GitHub - Megatron-LM
- Data-Juicer: GitHub - Data-Juicer