DeepCache: Accelerating Diffusion Models for Free
免训练扩散模型加速框架,利用U-Net高层特征的时间冗余实现缓存复用
DeepCache: Accelerating Diffusion Models for Free
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DeepCache: Accelerating Diffusion Models for Free |
| 作者 | Xinyin Ma, Gongfan Fang, Xinchao Wang |
| 论文 | arXiv:2312.00858 |
| 发布 | 2023-12-01 |
| 主题 | cs.CV (Computer Vision and Pattern Recognition) |
| 引用 | 高影响力论文,后续工作(PostDiff等)广泛引用 |
二、核心思想
问题定义
扩散模型在图像合成领域展现出卓越的生成能力,但其顺序去噪过程和庞大模型规模导致高昂的计算成本。传统压缩方法需要大量重训练,面临成本和可行性挑战。
核心问题:如何在不进行额外训练的情况下,显著减少每个去噪步骤的计算开销?
核心观察
高层特征的时间冗余性:
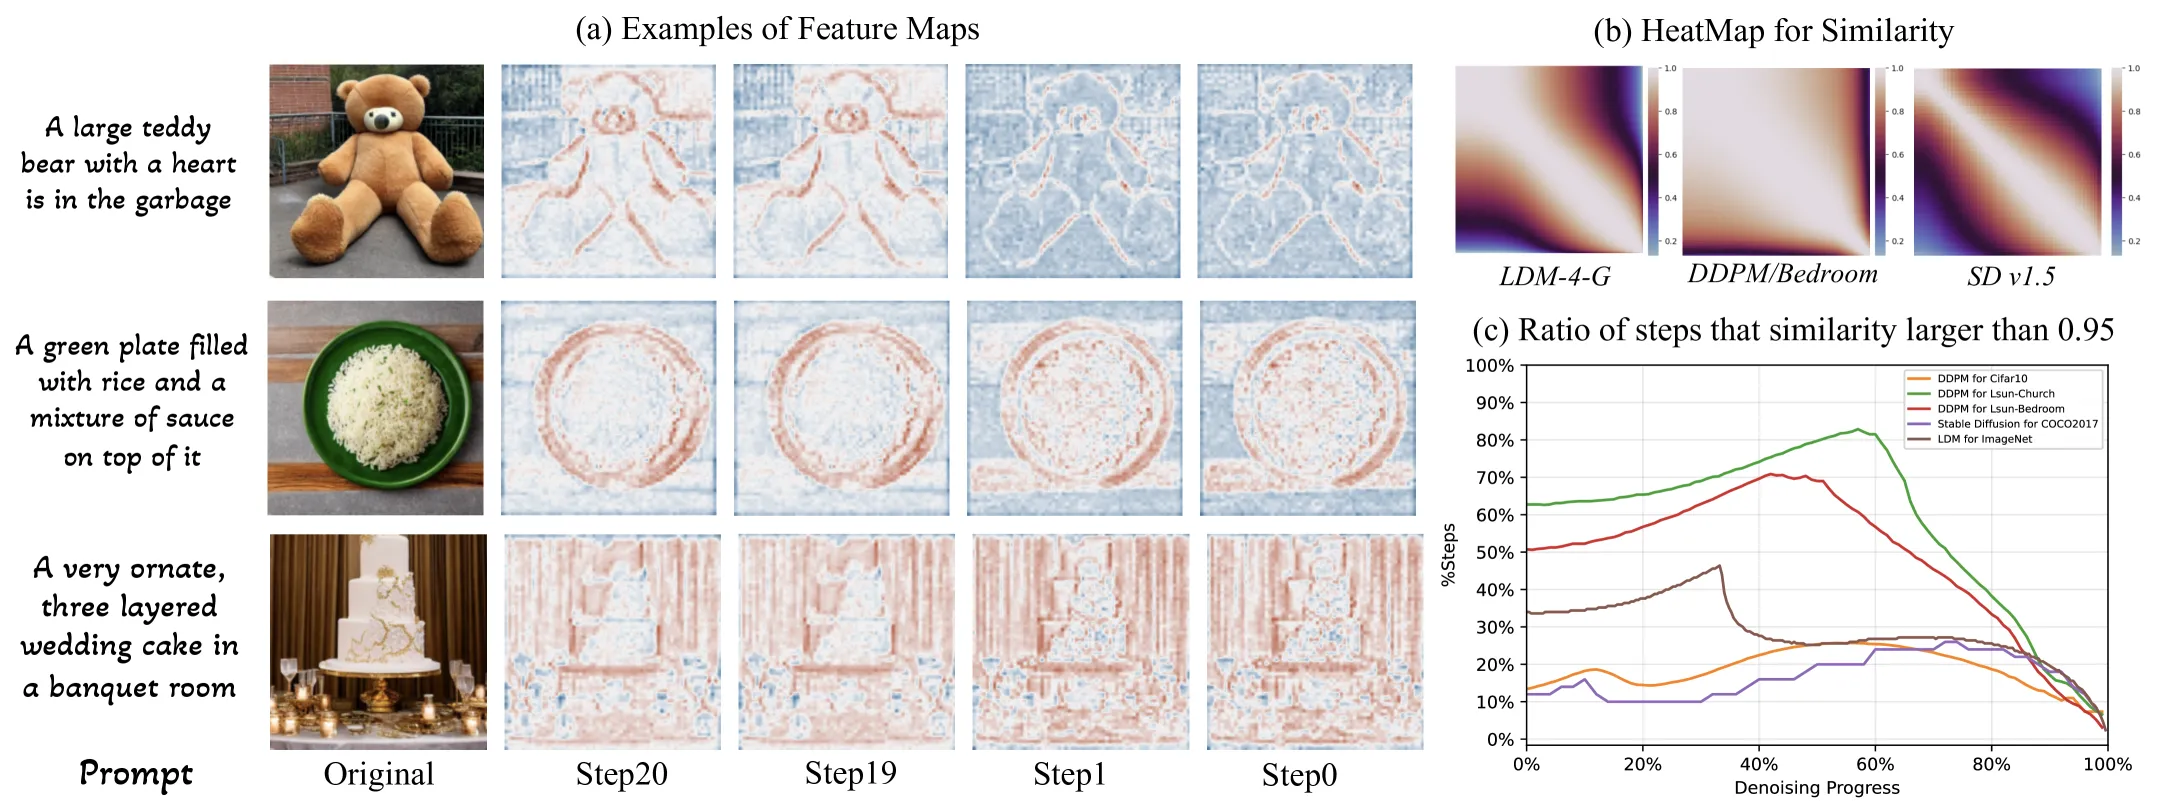
Figure 2: U-Net上采样块U₂中的特征图示例,展示了相邻去噪步骤之间的显著时间相似性。
关键发现:
- 相邻去噪步骤之间存在显著的时间特征相似性
- 无论使用哪种扩散模型,至少10%的相邻时间步具有>0.99的余弦相似度
- 主分支的高层特征变化微小,存在大量冗余计算
解决方案概述
DeepCache:一种免训练的扩散模型加速范式,从模型架构角度加速扩散模型。
核心思想:
- 利用U-Net的skip connection结构特征
- 缓存主分支的高层特征,跳过冗余计算
- 仅在skip branch执行浅层计算
三、技术架构
DeepCache原理
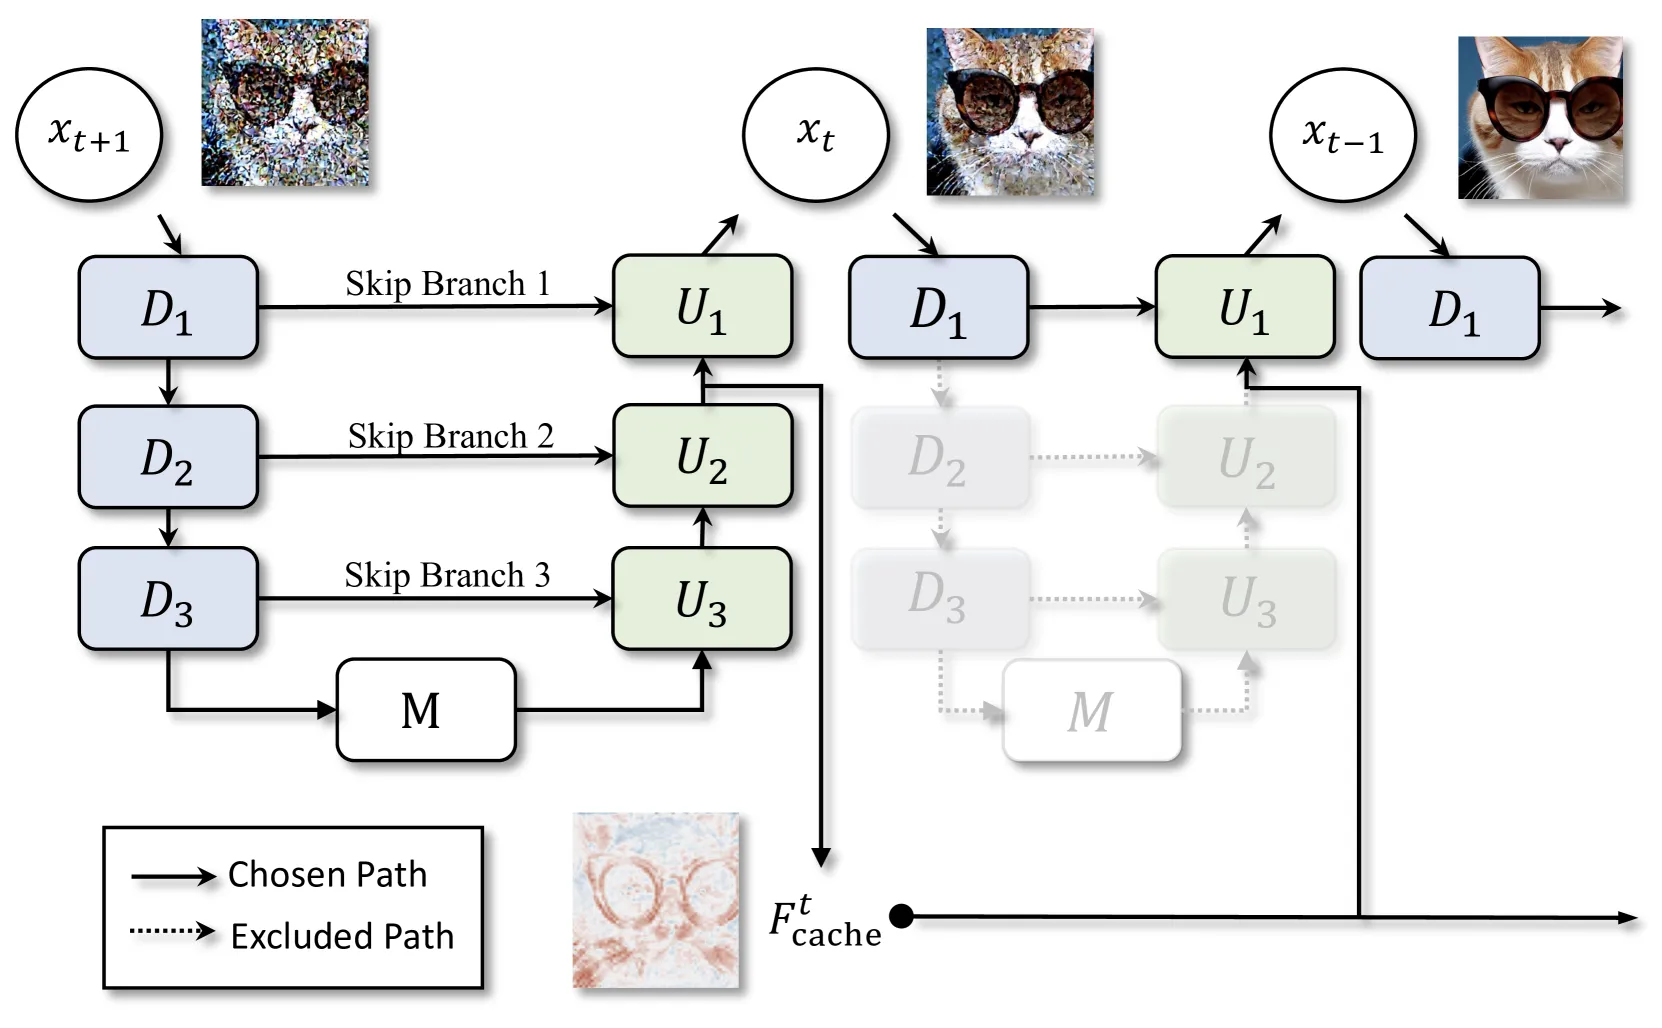
Figure 3: DeepCache原理示意图。
U-Net结构分析
U-Net由堆叠的下采样和上采样块组成,通过skip connections连接:
其中:
- 主分支:需要大量计算遍历整个网络
- skip分支:仅需经过浅层,计算量很小
核心算法
基本缓存策略(1:2):
对于连续时间步 和 :
-
在时间步 ,执行完整推理,缓存主分支特征:
-
在时间步 ,跳过主分支计算,复用缓存特征:
扩展到1:N策略:
缓存特征计算一次,复用于连续 步:
其中 是缓存更新次数。
非均匀1:N策略:
针对长缓存间隔的优化:
其中 是幂次参数, 是中心偏移。
复杂度分析
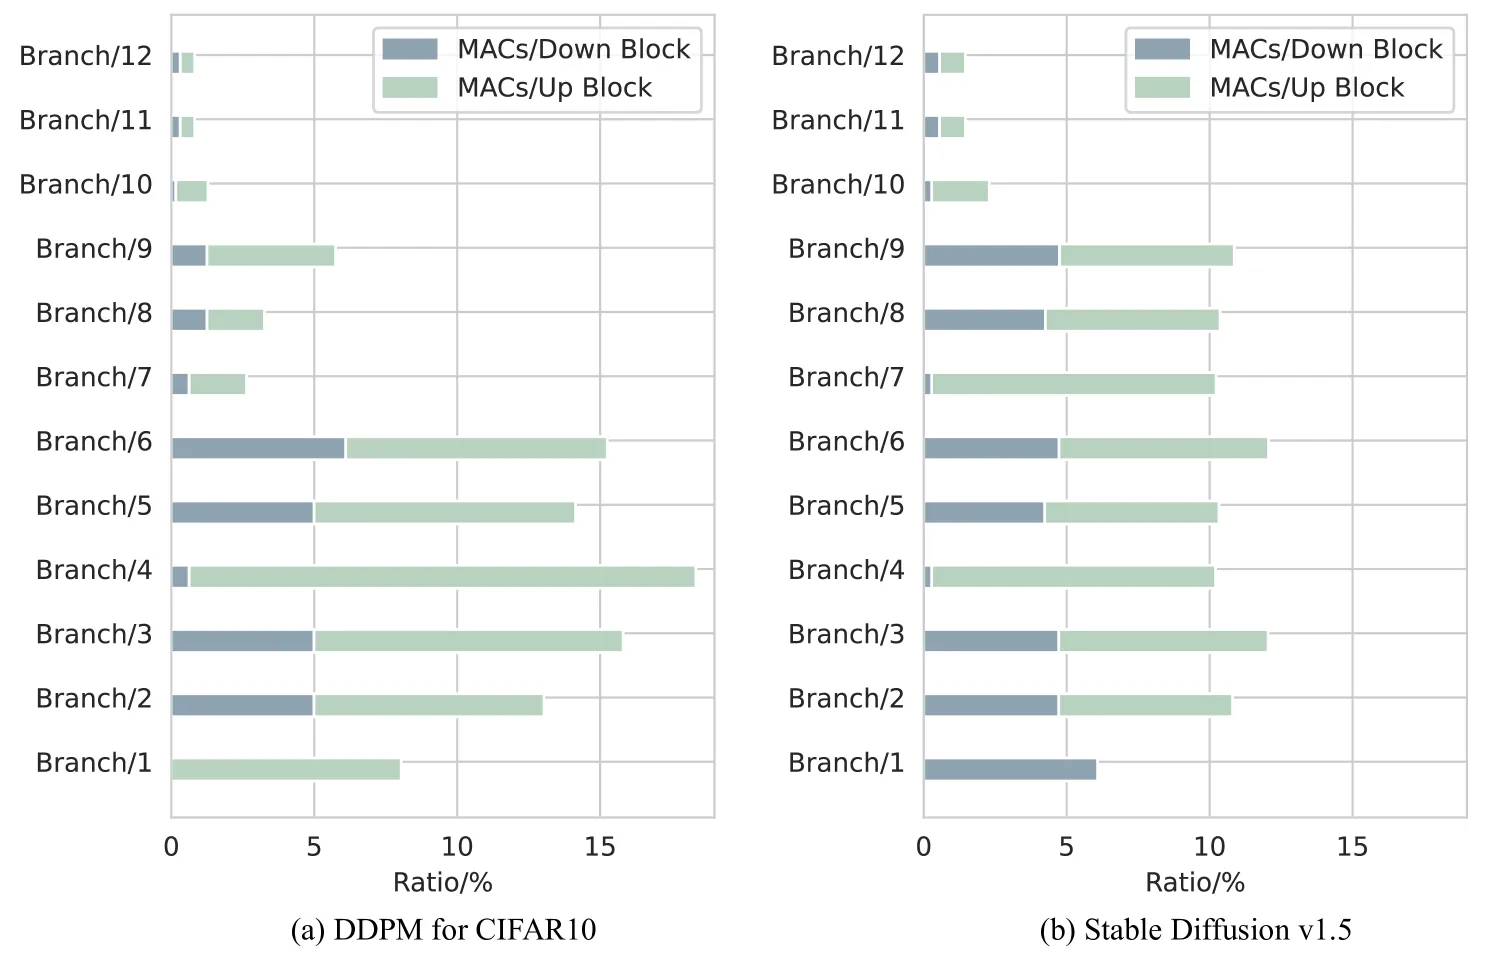
Figure 4: 每个skip branch的MACs分析。
关键洞察:
- skip branch的计算量远小于主分支
- 缓存策略主要节省主分支的计算开销
- 选择合适的 (缓存层深度)可平衡速度和质量
四、实验结果
主要结果
Table 1: ImageNet LDM-4-G 类条件生成质量
| 方法 | MACs ↓ | 吞吐量 ↑ | 加速比 ↑ | 重训练 | FID ↓ | sFID ↓ |
|---|---|---|---|---|---|---|
| LDM-4 | 99.82G | 0.178 | 1× | ✗ | 3.37 | 5.14 |
| Diff-Pruning | 52.71G | 0.269 | 1.51× | ✓ | 9.27 | 10.59 |
| DeepCache N=2 | 52.12G | 0.334 | 1.88× | ✗ | 3.39 | 5.11 |
| DeepCache N=3 | 36.48G | 0.471 | 2.65× | ✗ | 3.44 | 5.11 |
| DeepCache N=5 | 23.50G | 0.733 | 4.12× | ✗ | 3.59 | 5.16 |
| DeepCache N=10 | 13.97G | 1.239 | 6.96× | ✗ | 4.41 | 5.57 |
关键结果:
- N=5时,4.12倍加速,FID仅从3.37增至3.59
- 显著优于需要重训练的Diff-Pruning
Table 2: CIFAR-10, LSUN-Bedroom, LSUN-Churches结果
| 数据集 | 方法 | MACs ↓ | 吞吐量 ↑ | 加速比 ↑ | FID ↓ |
|---|---|---|---|---|---|
| CIFAR-10 | DDPM | 6.1G | 9.79 | 1× | 4.16 |
| Diff-Pruning | 3.4G | 13.45 | 1.37× | 5.29 | |
| DeepCache N=2 | 4.15G | 13.73 | 1.40× | 4.35 | |
| DeepCache N=5 | 3.01G | 18.11 | 1.85× | 5.73 |
Stable Diffusion结果
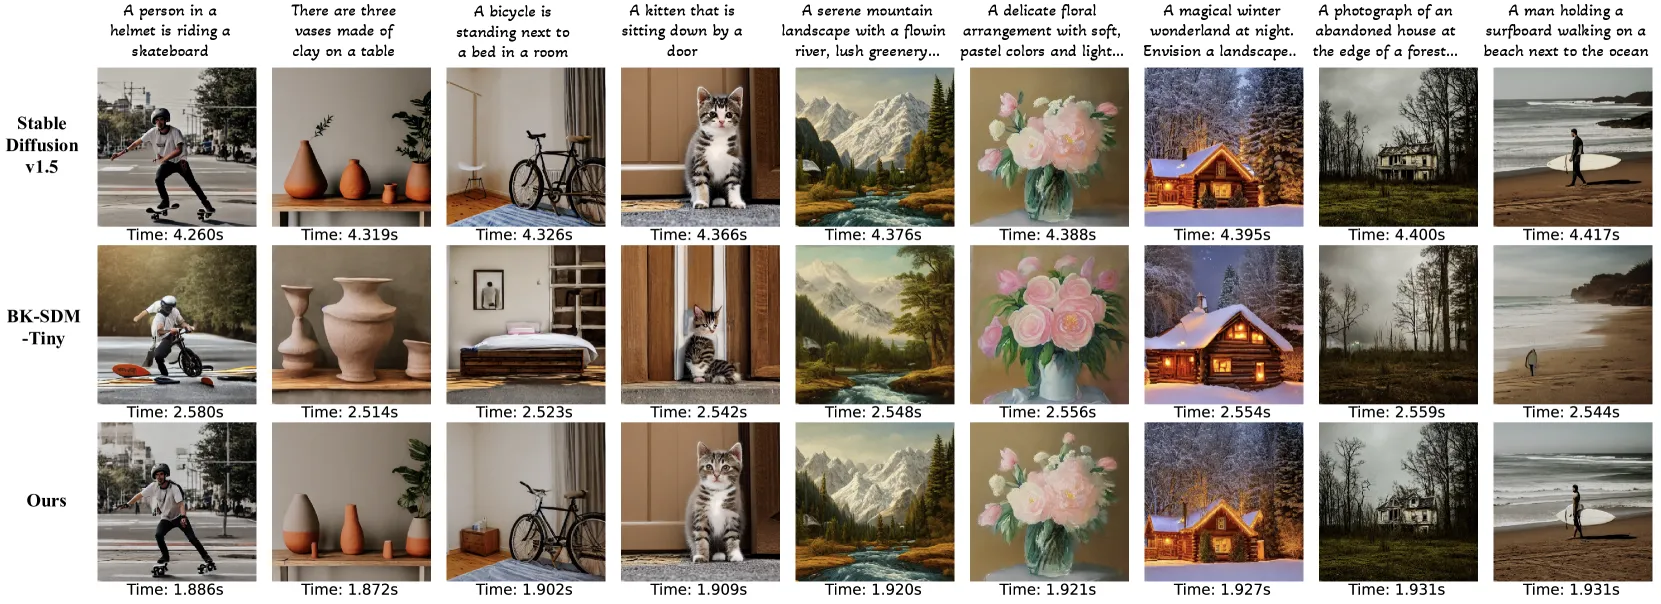
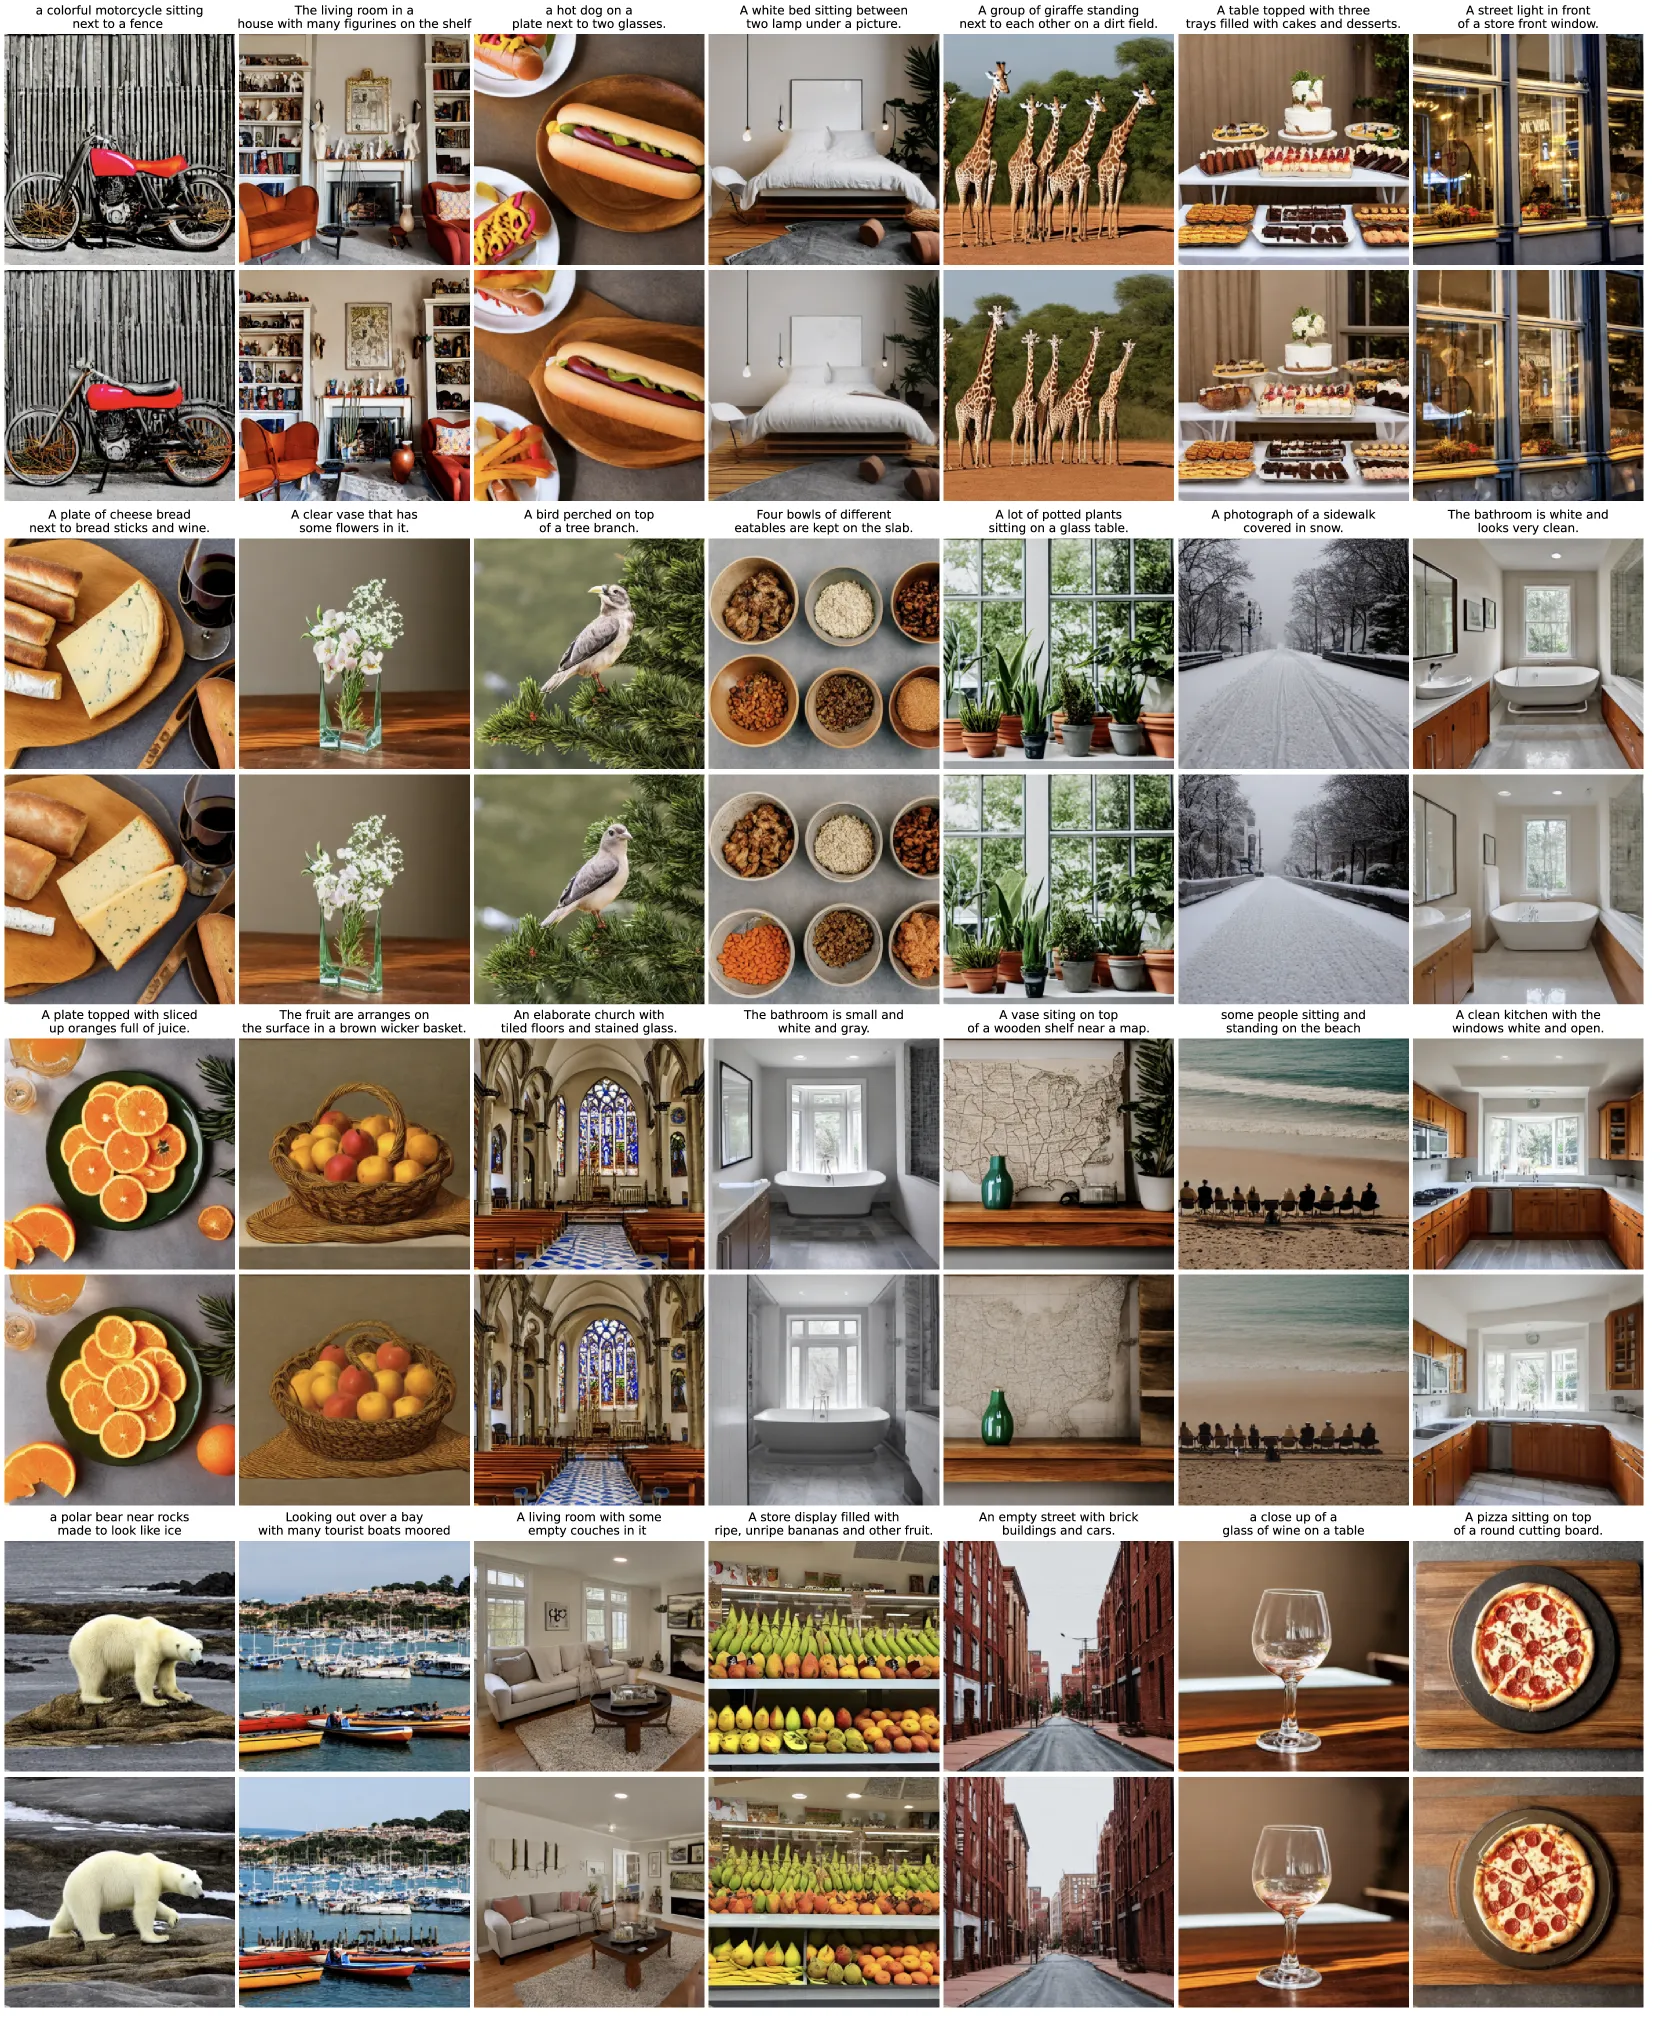
Figure 5: BK-SDM-Tiny和DeepCache生成图像的对比。
Table 3: 与PLMS和BK-SDM的对比
| 方法 | 吞吐量 ↑ | 加速比 ↑ | CLIP Score ↑ |
|---|---|---|---|
| PLMS - 50 steps | 0.230 | 1.00× | 29.51 |
| PLMS - 25 steps | 0.470 | 2.04× | 29.33 |
| BK-SDM - Base | 0.343 | 1.49× | 28.88 |
| BK-SDM - Small | 0.402 | 1.75× | 27.94 |
| BK-SDM - Tiny | 0.416 | 1.81× | 27.36 |
| DeepCache | 0.494 | 2.15× | 29.46 |
关键结果:
- DeepCache以2.15倍加速超越所有BK-SDM变体
- CLIP Score保持在29.46,接近原始PLMS的29.51
非均匀策略对比
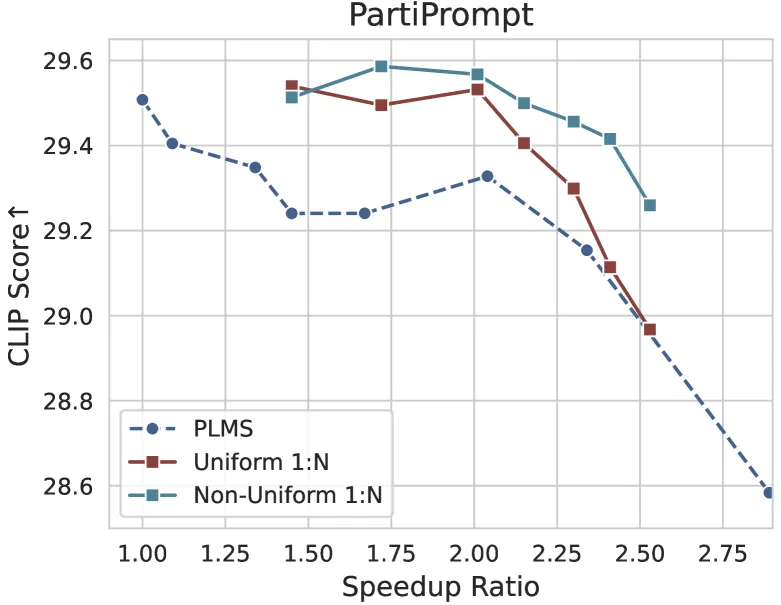
Figure 6: PLMS与DeepCache均匀/非均匀策略的对比。
Table 4: 与DDIM的同等吞吐量对比
| 方法 | 吞吐量 ↑ | FID ↓ | sFID ↓ |
|---|---|---|---|
| DDIM - 59 steps | 0.727 | 3.59 | 5.14 |
| DeepCache | 0.733 | 3.59 | 5.16 |
| DDIM - 91 steps | 0.436 | 3.46 | 50.6 |
| DeepCache | 0.471 | 3.44 | 5.11 |
缓存间隔影响
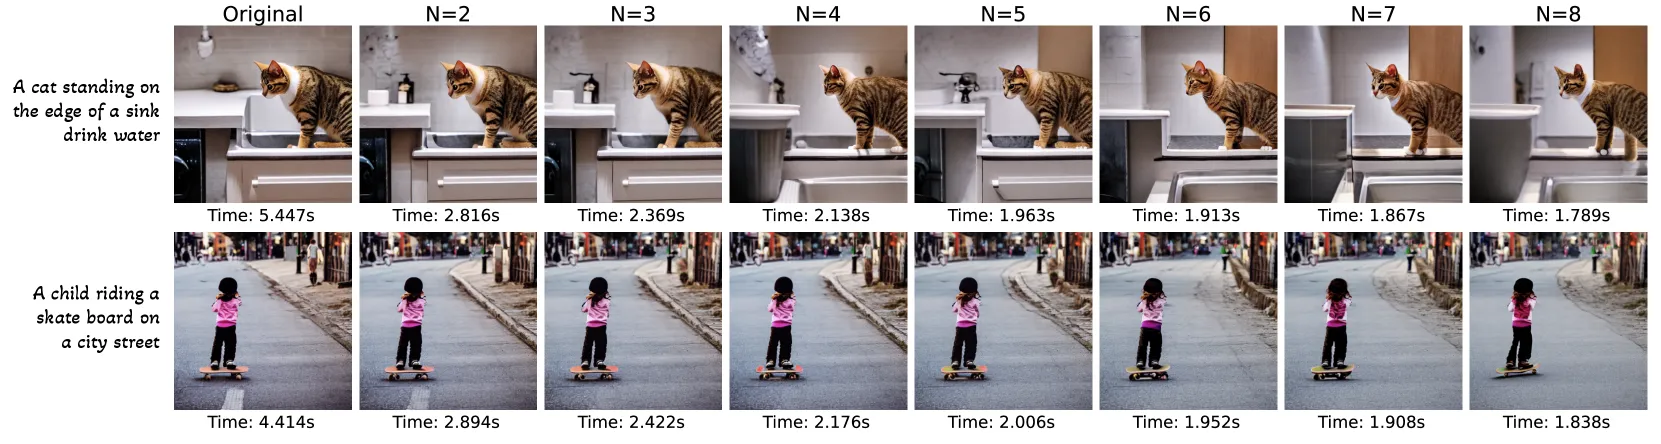
Figure 7: 随缓存间隔增加的生成图像演化。
Table 10: 缓存间隔消融(ImageNet)
| 间隔 N | MACs ↓ | 吞吐量 ↑ | 加速比 ↑ | FID ↓ |
|---|---|---|---|---|
| 1 (原始) | 99.82G | 0.178 | 1× | 3.37 |
| 2 | 52.12G | 0.334 | 1.88× | 3.39 |
| 3 | 36.48G | 0.471 | 2.65× | 3.44 |
| 5 | 23.50G | 0.733 | 4.12× | 3.59 |
| 10 | 13.97G | 1.239 | 6.96× | 4.41 |
| 20 | 7.59G | 2.034 | 11.43× | 8.23 |
关键发现:
- 缓存间隔越大,加速比越高,但质量下降
- N=5是速度-质量的最佳平衡点
质量可视化
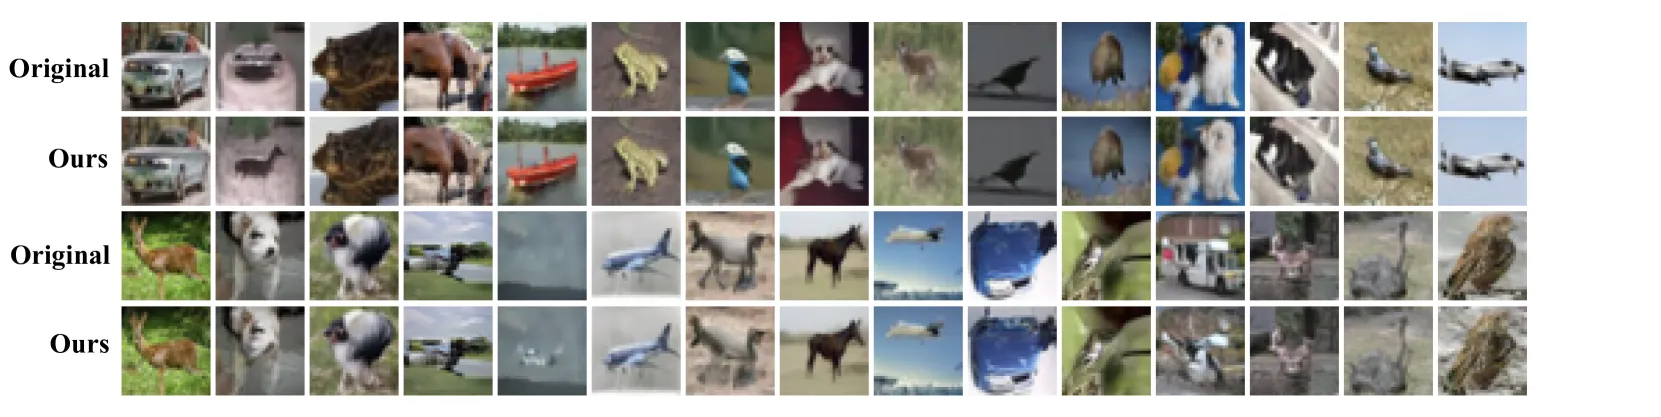
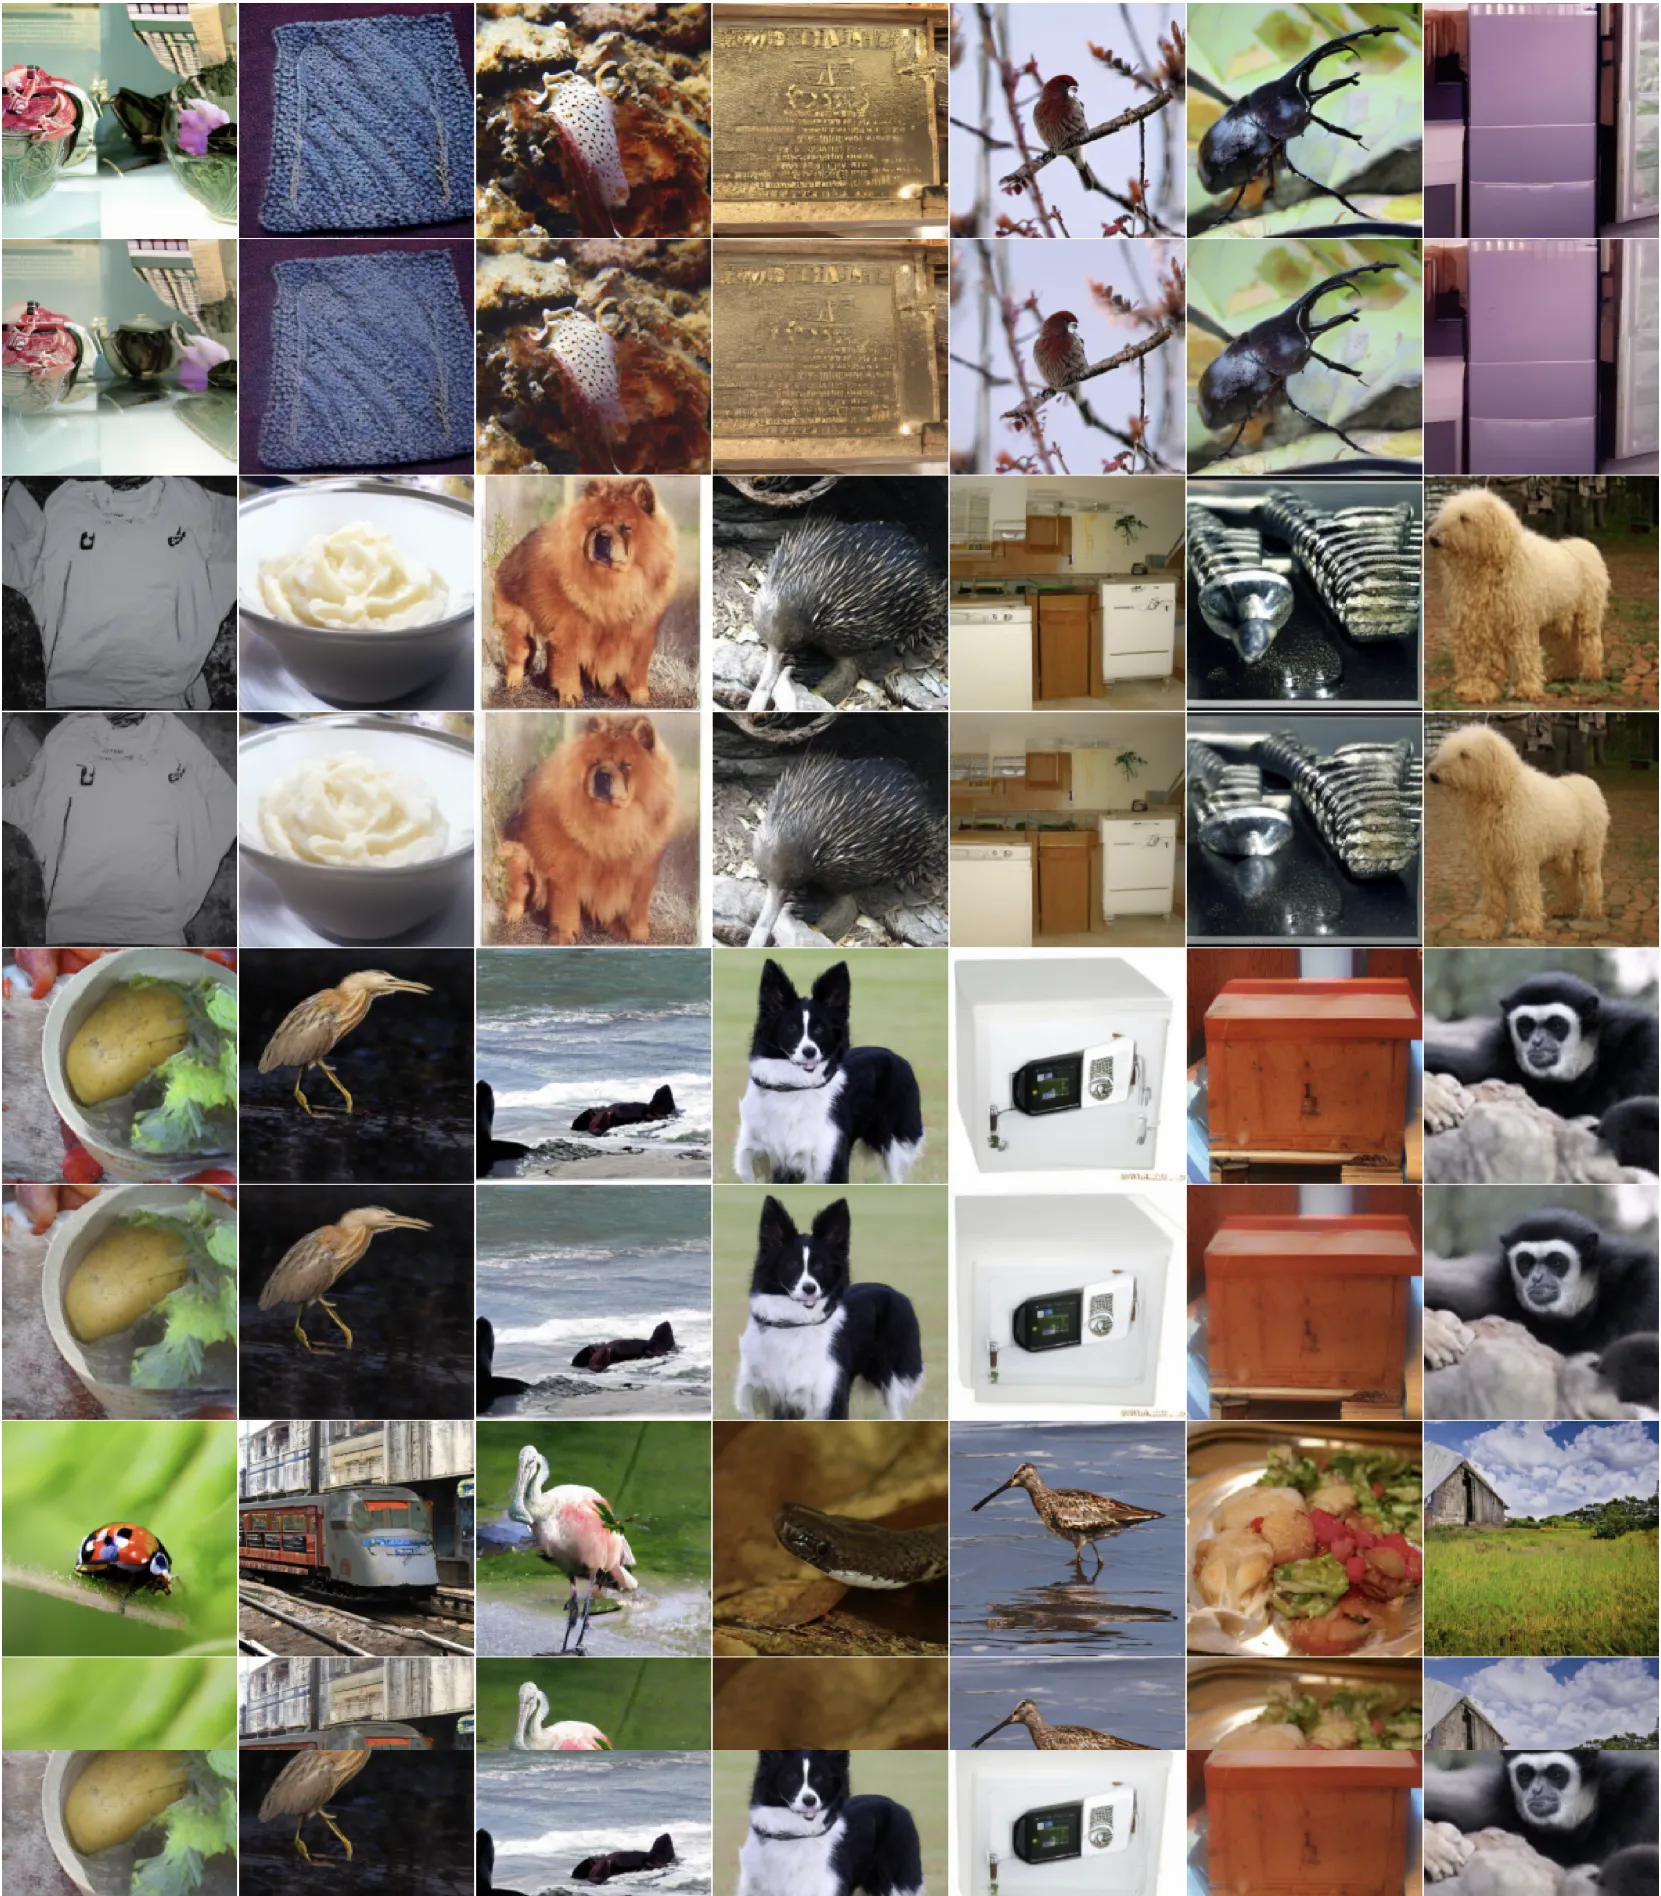
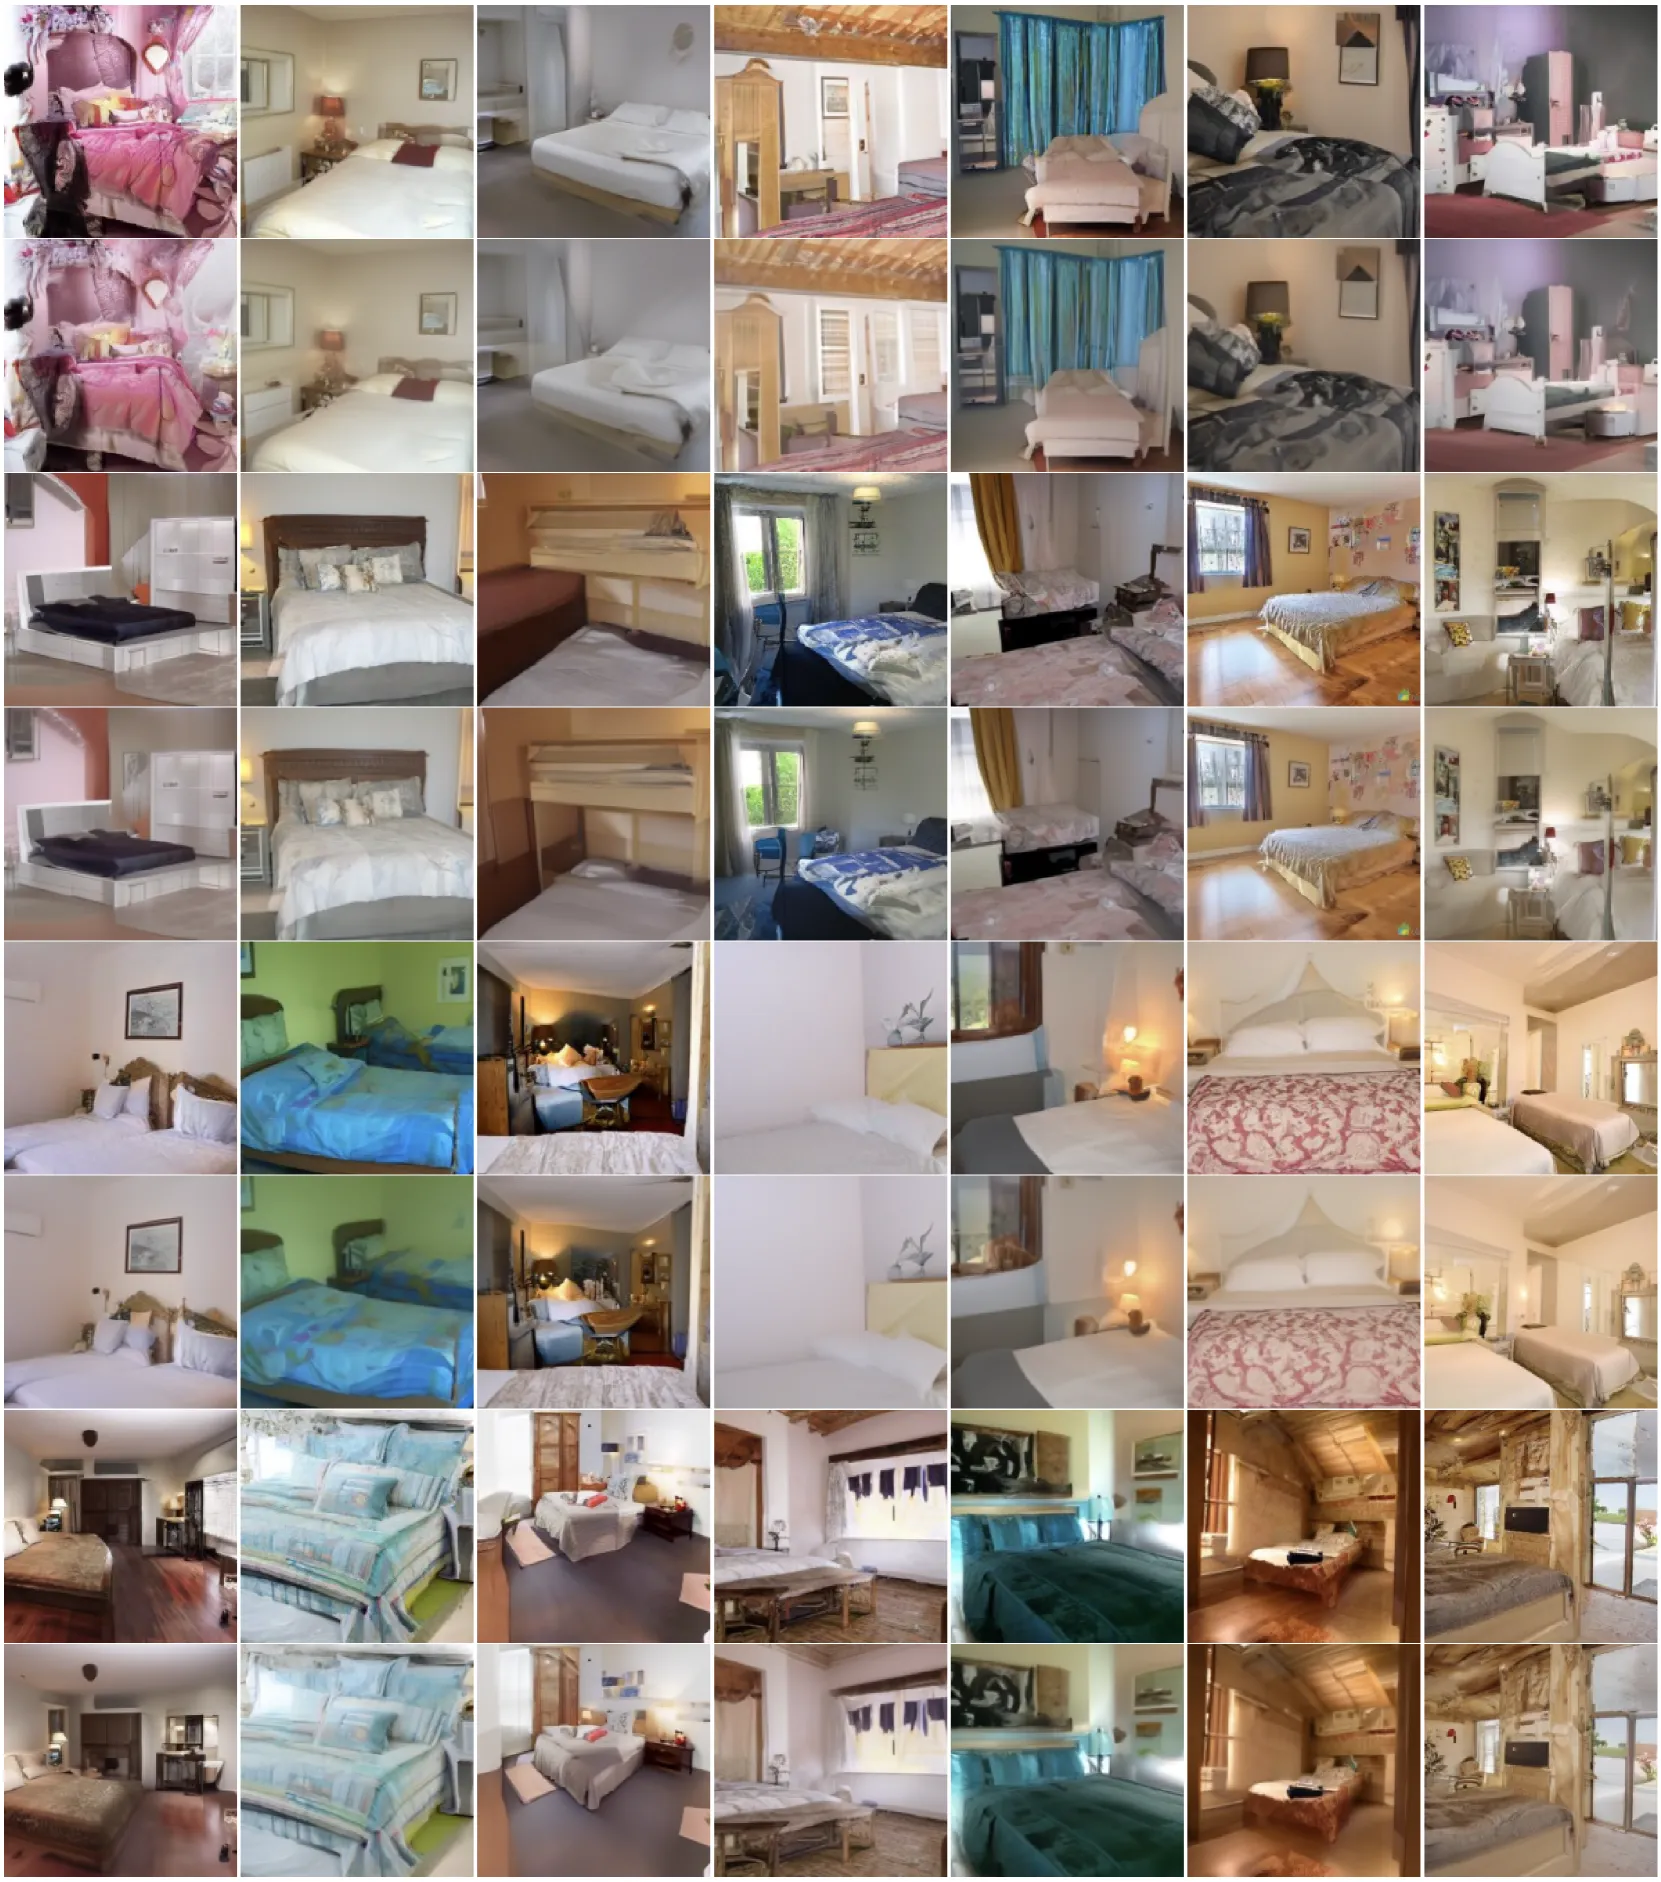
Figure 8-12: 不同数据集的生成样本对比
缓存特征有效性验证
Table 5: 缓存特征的有效性
| 模型 | 数据集 | DeepCache | 无缓存特征 |
|---|---|---|---|
| DDPM | CIFAR-10 | 9.74 | 192.98 |
| LDM-4-G | ImageNet | 7.36 | 312.12 |
关键发现:
- 移除缓存特征导致FID急剧恶化(192.98 vs 9.74)
- 证明缓存特征对生成质量至关重要
浅层推理有效性
Table 6: 浅层推理的有效性
| DDIM步数 | DDIM FID↓ | DeepCache FID↓ | 改善 Δ |
|---|---|---|---|
| 50 | 4.67 | 4.35 | -0.32 |
| 20 | 6.84 | 5.73 | -1.11 |
| 10 | 13.36 | 10.38 | -2.98 |
关键发现:
- 浅层推理不仅减少计算,还可能改善生成质量
- 步数越少,改善效果越明显
非均匀策略超参数
Table 7-8: 非均匀策略超参数分析
| 中心 c | FID ↓ | sFID ↓ | IS ↑ |
|---|---|---|---|
| 10 | 8.26 | 8.47 | 160.3 |
| 80 | 7.36 | 7.76 | 166.21 |
| 120 | 7.11 | 7.34 | 167.85 |
| 200 | 8.09 | 7.79 | 160.50 |
| 幂次 p | FID ↓ | sFID ↓ | IS ↑ |
|---|---|---|---|
| 1.05 | 7.36 | 7.52 | 166.12 |
| 1.2 | 7.11 | 7.34 | 167.85 |
| 1.4 | 7.13 | 7.39 | 167.68 |
最优超参数:c≈120, p≈1.3-1.4
五、核心创新
| 创新点 | 说明 | 实验验证 |
|---|---|---|
| 免训练加速 | 无需任何重训练或微调 | 所有实验均为零训练成本 |
| 时间冗余利用 | 缓存相邻步的高层特征 | Table 5验证缓存特征有效性 |
| U-Net结构利用 | 利用skip connection的双路径特性 | Figure 4的MACs分析 |
| 非均匀策略 | 针对长间隔的自适应缓存 | Table 7-8的超参数分析 |
| 通用性 | 适用于DDPM/LDM/Stable Diffusion | 多模型验证 |
六、与其他方法对比
| 方法 | 特点 | DeepCache优势 |
|---|---|---|
| Diff-Pruning | 结构剪枝,需重训练 | 免训练,效果更好 |
| BK-SDM | 知识蒸馏,需训练 | 免训练,速度更快 |
| DDIM/PLMS | 减少采样步数 | 可叠加使用,进一步加速 |
| Spectral DPM | 频率先验,需重训练 | 免训练,更通用 |
| SnapFusion | 结构优化 | 更简单,无需架构修改 |
七、局限性
- 依赖预训练模型结构:当最浅skip branch计算量占比过大(如50%)时,加速比受限
- 非均匀策略开销:对于大缓存间隔,非均匀策略引入不可忽略的额外计算
- 质量-速度权衡:大缓存间隔(N>10)会导致明显质量下降
八、总结
核心贡献
- 新范式提出:首次提出从模型架构角度免训练加速扩散模型
- DeepCache算法:利用U-Net高层特征的时间冗余实现缓存复用
- 非均匀策略:针对长缓存间隔的自适应优化
- 广泛验证:在DDPM、LDM、Stable Diffusion上验证有效性
性能总结
| 指标 | LDM-4-G | Stable Diffusion | CIFAR-10 |
|---|---|---|---|
| 最大加速比 | 6.96× | 2.15× | 2.07× |
| 质量保持 | FID 3.37→4.41 | CLIP 29.51→29.46 | FID 4.16→5.73 |
| 训练成本 | 零 | 零 | 零 |
技术影响
DeepCache开创了免训练扩散模型加速的研究方向:
- 后续工作:PostDiff、TGATE、ToDo、ToMe等均受其启发
- 工业应用:已集成到多个扩散模型推理框架
- 研究范式:证明了利用时间冗余的有效性
九、参考资源
- 论文: arXiv:2312.00858
- 代码: GitHub - horseee/DeepCache
- 后续工作:
- PostDiff (2508.06160) - 混合分辨率去噪+模块缓存
- TGATE - 时间门控加速
- ToDo - Token丢弃加速