Efficient Streaming Language Models with Attention Sinks
发现Attention Sink现象,提出StreamingLLM框架实现无限长度流式推理
Efficient Streaming Language Models with Attention Sinks
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Efficient Streaming Language Models with Attention Sinks |
| 作者 | Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, Mike Lewis |
| 机构 | MIT, Meta AI |
| 论文 | arXiv:2309.17453 |
| 代码 | GitHub |
| 发布 | 2023年9月29日(v1),2024年4月7日(v4) |
| 引用 | 1000+ |
二、核心思想
StreamingLLM发现了Transformer模型中的Attention Sink现象——初始token会吸收大量注意力分数,即使它们在语义上并不重要。基于这一发现,提出了一种简单高效的流式推理框架,只需保留初始token的KV缓存和最近token的滑动窗口,即可实现无限长度的流式推理。
关键发现
- Attention Sink现象:LLM在几乎所有层和头中都会对初始token分配异常高的注意力分数
- 窗口注意力失败原因:移除初始token的KV缓存会导致softmax分布崩溃,困惑度急剧上升
- 简单解决方案:保留4个初始token作为attention sinks + 最近token的滑动窗口
- 预训练优化:在预训练时添加专用sink token,可将所需sink数量从4个减少到1个
问题定义
流式LLM部署的两大挑战:
| 挑战 | 说明 |
|---|---|
| 内存消耗 | 缓存所有token的KV状态随序列长度线性增长 |
| 长度外推 | 主流LLM无法泛化到超过训练长度的文本 |
现有方法的局限:
| 方法 | 优点 | 缺点 |
|---|---|---|
| 密集注意力 | 精度最高 | 内存线性增长,超长序列OOM |
| 窗口注意力 | 恒定内存 | 超过缓存大小后困惑度崩溃 |
| 滑动窗口+重计算 | 精度高 | 二次方延迟增长,不实用 |
三、技术架构
方法对比
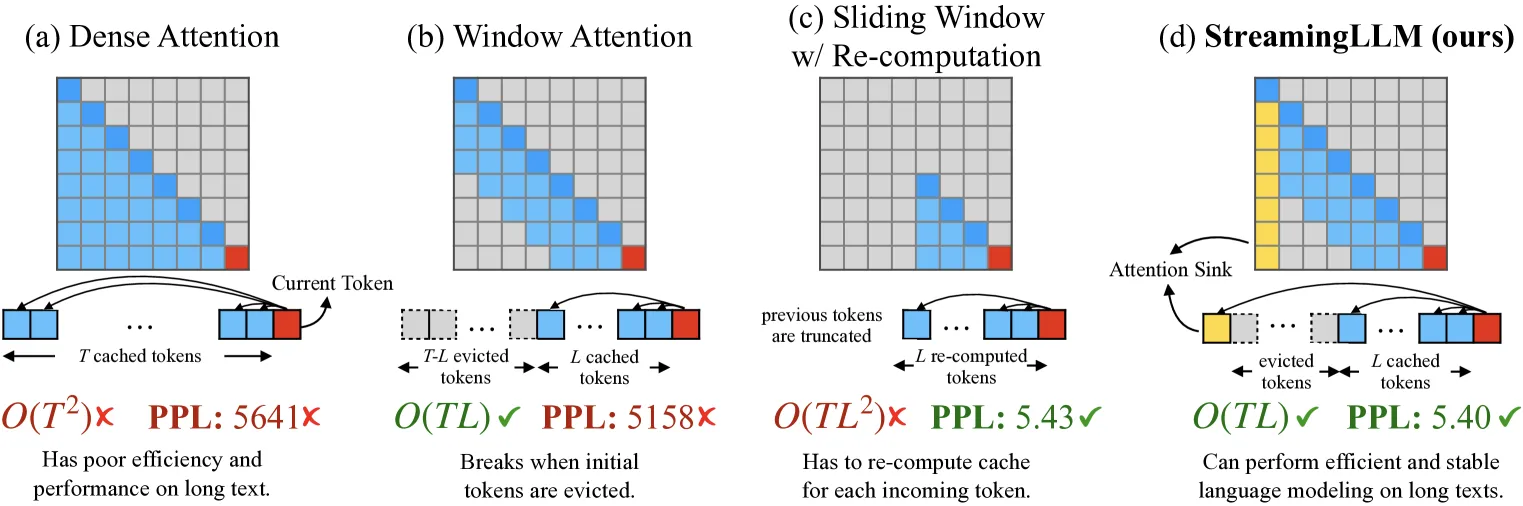
- (a) 密集注意力:缓存所有KV,内存线性增长
- (b) 窗口注意力:仅缓存最近token,超过窗口后崩溃
- (c) 滑动窗口+重计算:每步重新计算,精度高但延迟大
- (d) StreamingLLM:保留attention sinks + 滑动窗口,恒定内存且稳定
Attention Sink现象
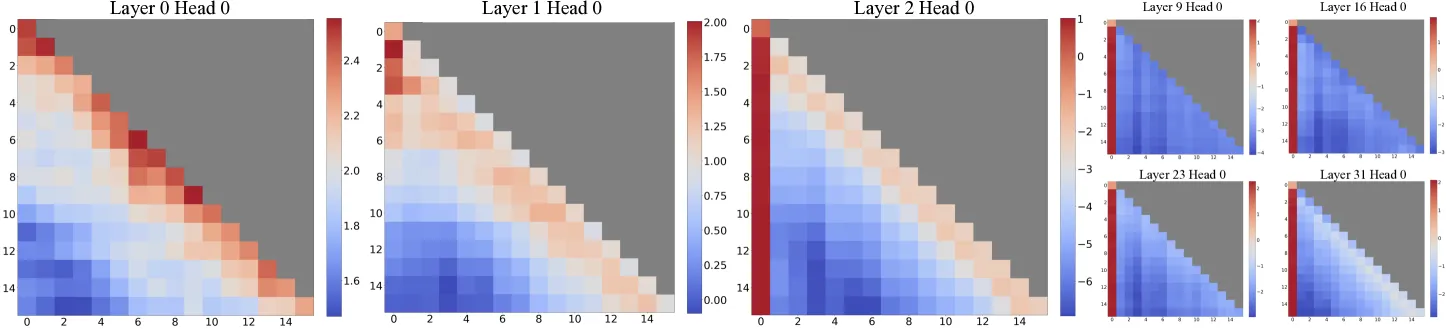
在Llama-2-7B上的观察:
- 超过底部2层后,模型在所有层和头中持续关注初始token
- 初始token的注意力分数远高于其他token,无论其语义相关性如何
- 这种现象在不同模型规模(7B-70B)和不同位置编码(RoPE、ALiBi)中普遍存在
数学解释:
SoftMax要求注意力分数总和为1。当模型不需要从其他token获取信息时,会将”多余”的注意力分数dump到初始token上。
StreamingLLM的KV缓存设计
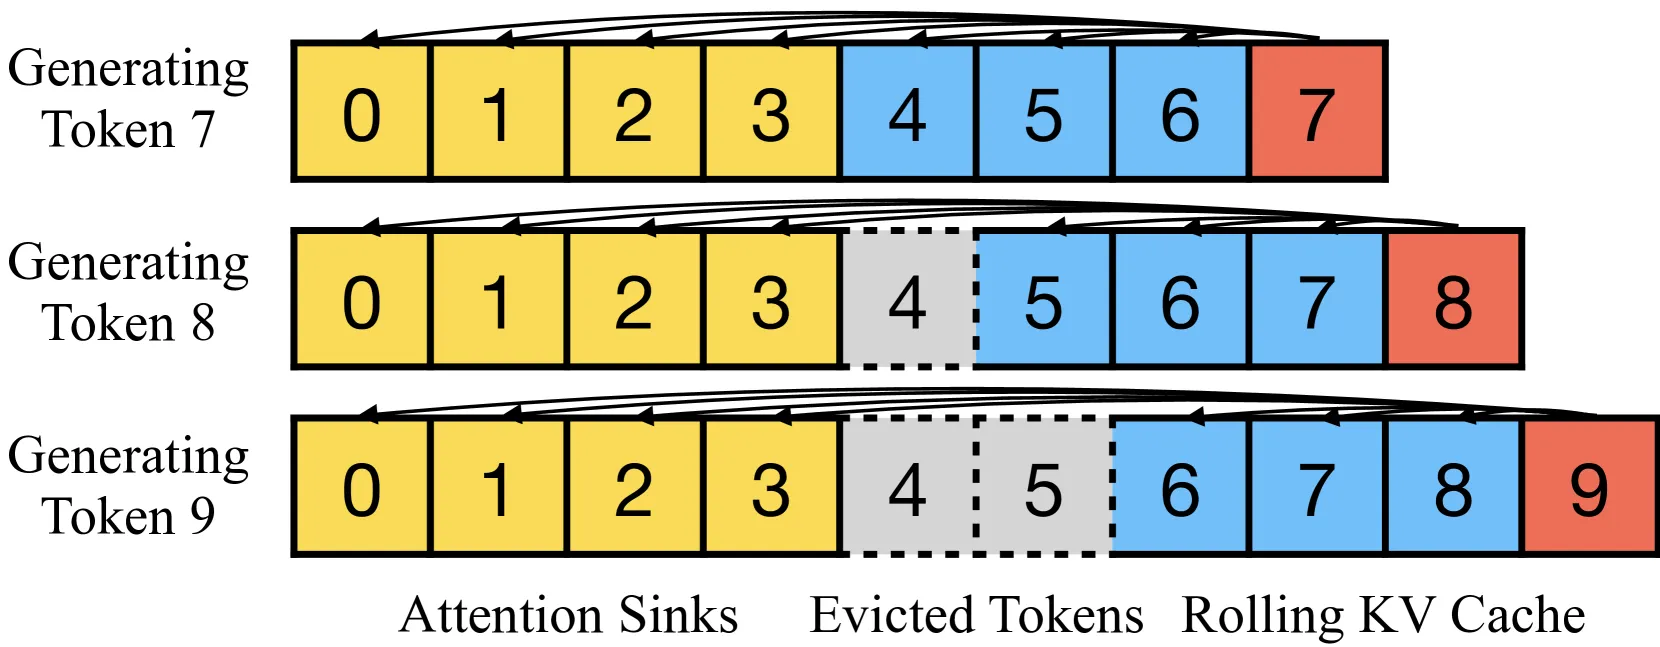
StreamingLLM的KV缓存分为两部分:
- Attention Sinks(4个初始token):稳定注意力计算
- Rolling KV Cache(最近token):保持语言建模能力
位置编码处理:
- RoPE:缓存旋转前的Key,解码时对rolling cache中的Key重新应用位置变换
- ALiBi:使用连续线性偏置而非”跳跃”偏置
困惑度对比
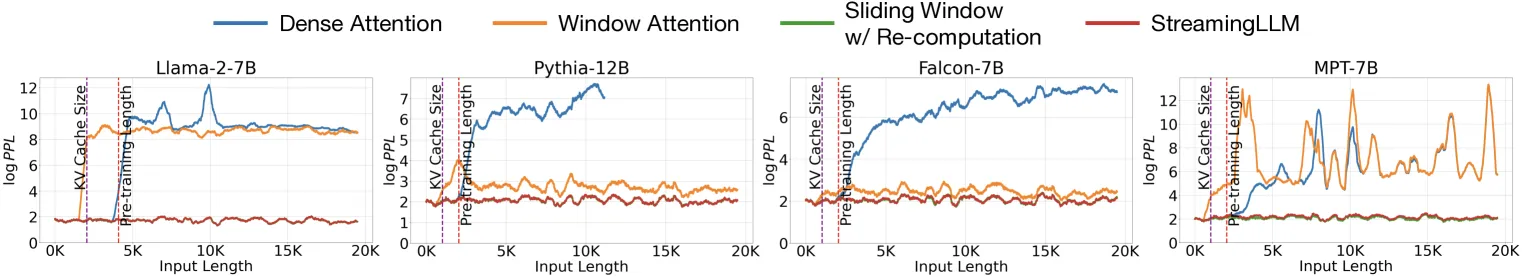
在20K token文本上的困惑度:
- 密集注意力:超过训练窗口后失败
- 窗口注意力:超过缓存大小后困惑度飙升(移除初始token)
- 滑动窗口+重计算:作为oracle基线
- StreamingLLM:匹配oracle基线,稳定处理无限长度
百万级token验证
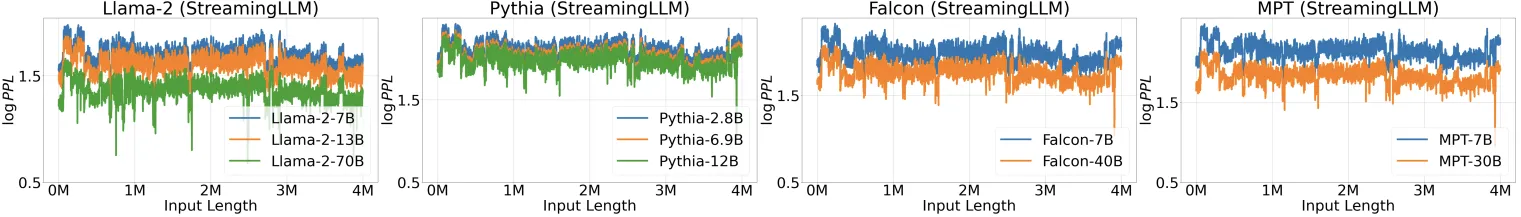
StreamingLLM在多个模型家族和规模上稳定处理超过400万token:
- Llama-2(7B/13B/70B)
- Falcon(7B/40B)
- Pythia(2.8B/12B)
- MPT(7B/30B)
预训练Sink Token
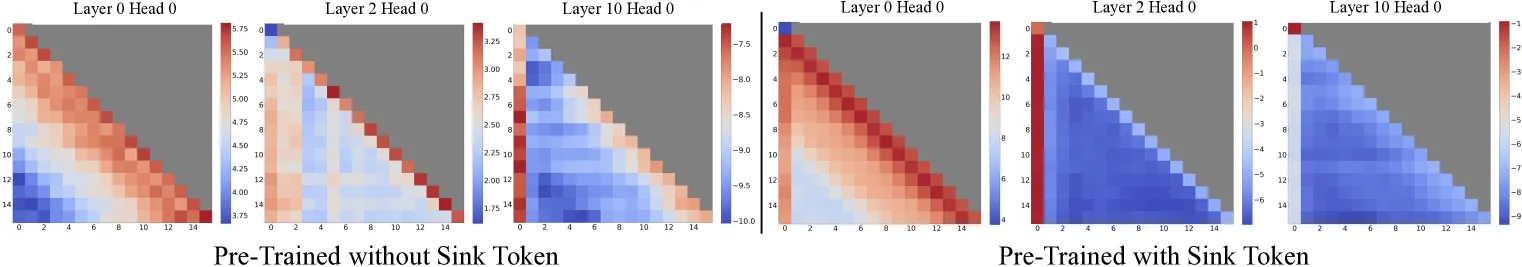
预训练优化:
- 在所有训练样本开头添加一个可学习的sink token
- 模型学会将多余注意力集中到这个专用token上
- 流式推理时只需保留1个sink token(而非4个初始token)
注意力模式对比:
- 无sink token:模型依赖多个初始token作为sinks
- 有sink token:模型一致地关注专用sink token,减少对其他初始token的依赖
StreamEval基准
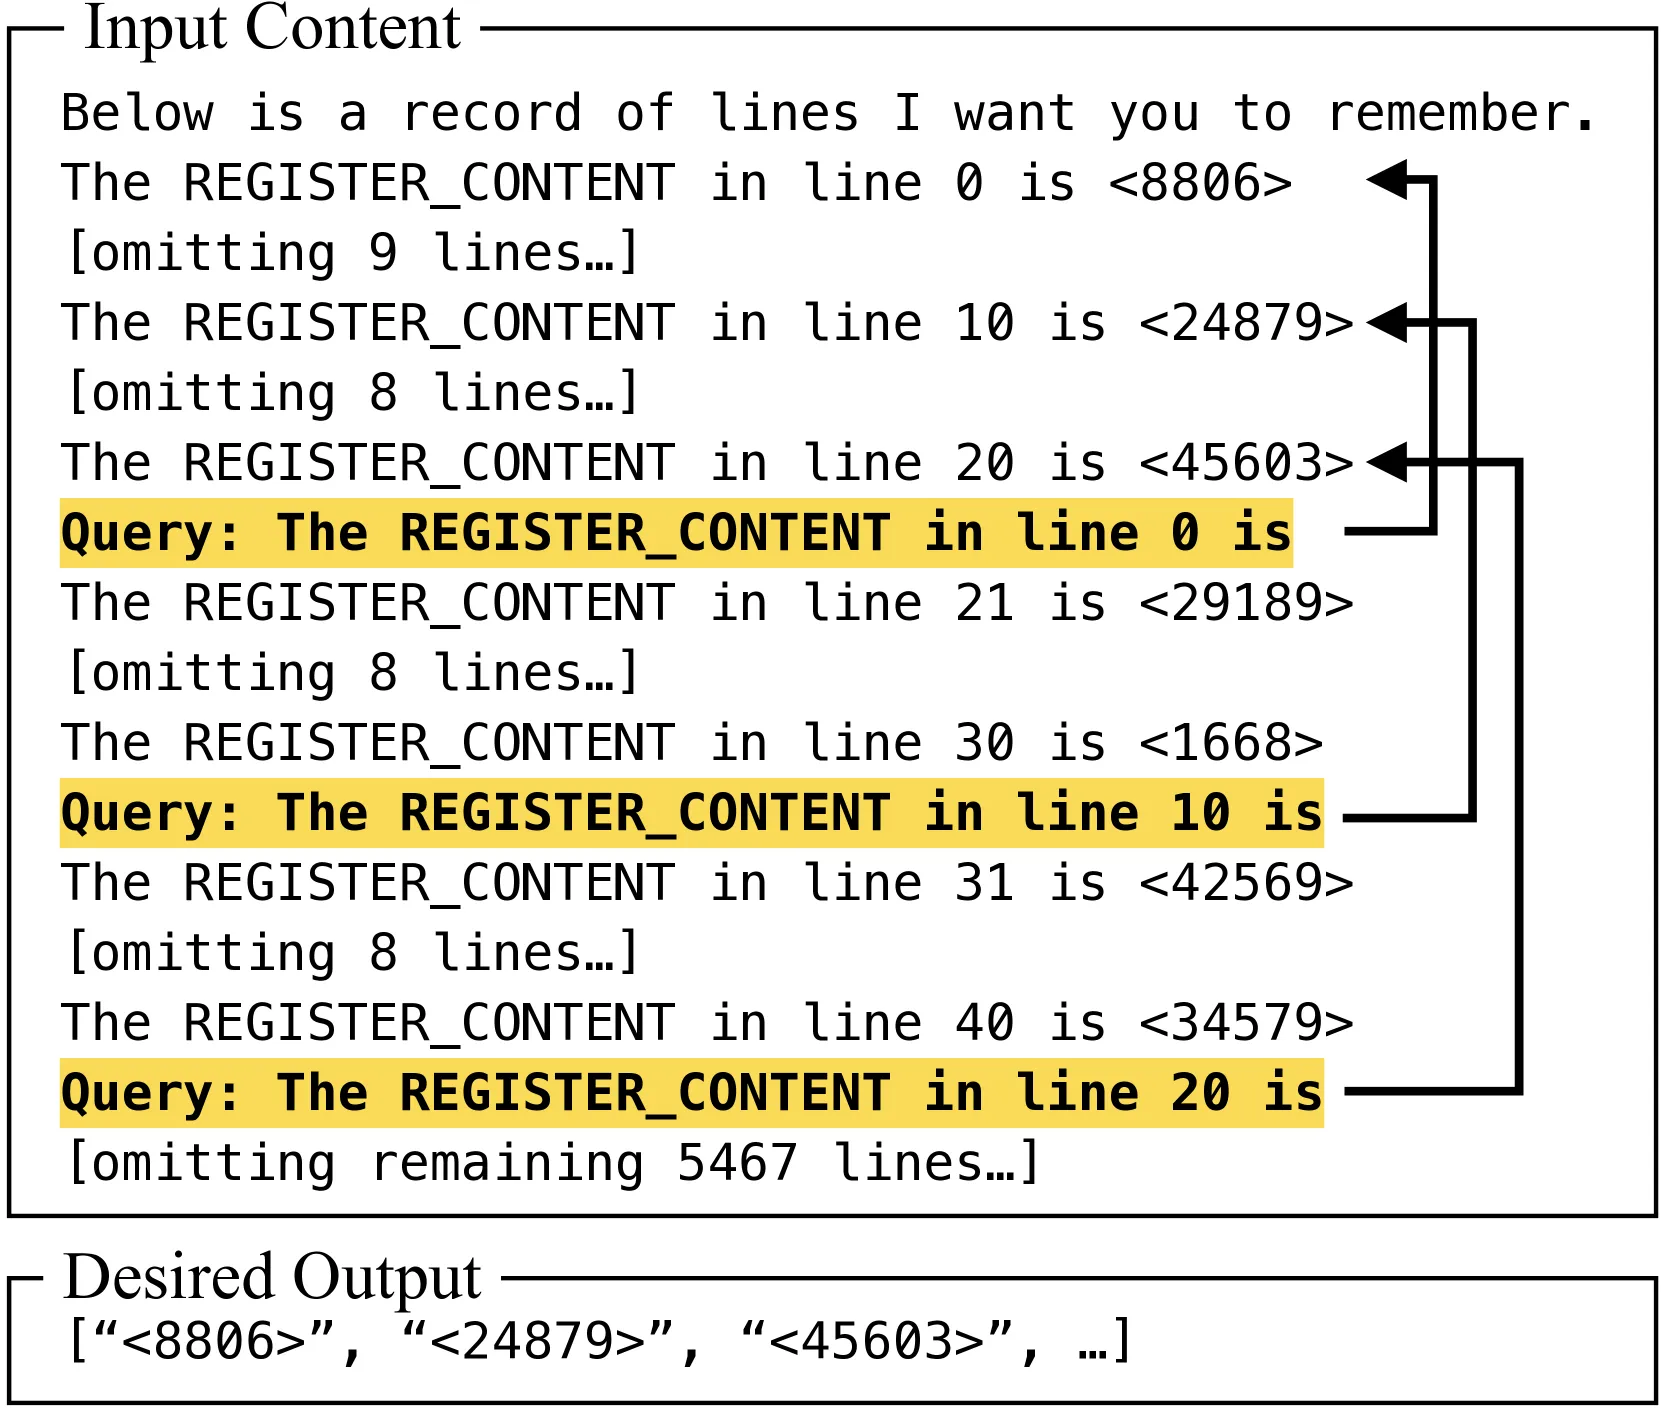
设计灵感来自LongEval,但更贴近真实场景:
- 每10行新信息后查询模型
- 答案始终在20行之前
- 模拟真实场景中问题通常涉及近期信息
四、核心创新
| 创新点 | 说明 | 意义 |
|---|---|---|
| 发现Attention Sink | 初始token吸收大量注意力 | 解释了窗口注意力失败的根本原因 |
| StreamingLLM框架 | sinks + 滑动窗口 | 简单高效,无需微调 |
| 位置编码适配 | 缓存内相对位置 | 确保超长序列的位置编码正确性 |
| 预训练Sink Token | 专用可学习token | 将所需sinks从4个减少到1个 |
| StreamEval基准 | 流式评估框架 | 更贴近真实流式应用场景 |
与现有方法对比
| 方法 | 恒定内存 | 无限长度 | 无需微调 | 实际可用 |
|---|---|---|---|---|
| 密集注意力 | ✗ | ✗ | ✓ | ✗ (OOM) |
| 窗口注意力 | ✓ | ✗ | ✓ | ✗ (崩溃) |
| 滑动窗口+重计算 | ✗ | ✓ | ✓ | ✗ (延迟) |
| 长度外推方法 | ✓ | 部分 | 部分 | 有限 |
| StreamingLLM | ✓ | ✓ | ✓ | ✓ |
五、实验结果
评估设置
| 项目 | 配置 |
|---|---|
| 模型 | Llama-2 (7B/13B/70B), Falcon (7B/40B), Pythia (2.8B/12B), MPT (7B/30B) |
| 基准 | PG19 (困惑度), ARC (流式QA), StreamEval (长距离评估) |
| 硬件 | NVIDIA A6000 GPU |
| 缓存大小 | Llama-2: 2048, 其他: 1024(均为训练窗口的一半) |
困惑度结果
在PG19测试集(100本长书)上:
- StreamingLLM匹配滑动窗口+重计算(oracle基线)的困惑度
- 窗口注意力在超过缓存大小后困惑度飙升
- 密集注意力在超过训练窗口后失败
流式问答
Table 5: ARC数据集准确率(%)
| 方法 | Llama-2-7B-Chat | Llama-2-13B-Chat | Llama-2-70B-Chat |
|---|---|---|---|
| Arc-E | Arc-C | Arc-E | |
| One-shot | 71.25 | 53.16 | 78.16 |
| 密集注意力 | OOM | OOM | OOM |
| 窗口注意力 | 3.58 | 1.39 | 0.25 |
| StreamingLLM | 71.34 | 55.03 | 80.89 |
关键发现:
- 密集注意力导致OOM
- 窗口注意力准确率接近0(超过缓存大小后输出随机)
- StreamingLLM匹配甚至超越one-shot基线
StreamEval结果
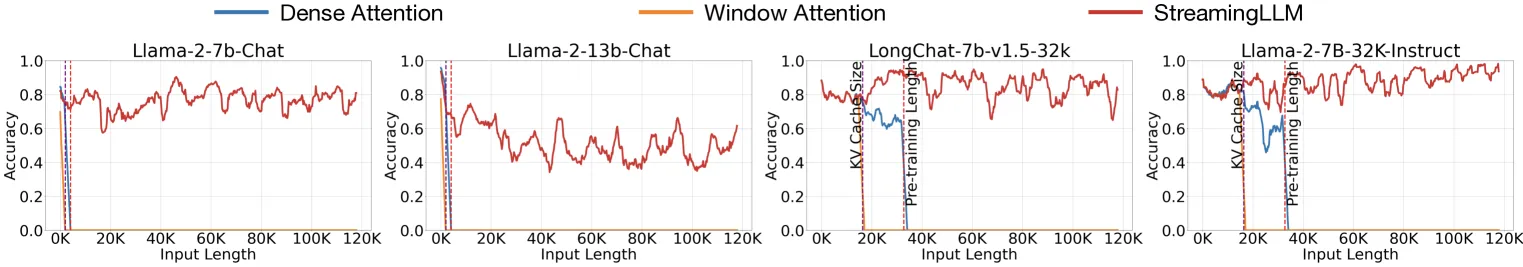
- StreamingLLM在输入长度接近120K token时仍保持合理准确率
- 密集注意力和窗口注意力在超长序列上均失败
Table 7: 不同查询-答案距离下的准确率(%)
| 行距离 | Token距离 | 4+2044 | 4+4092 | 4+8188 | 4+16380 |
|---|---|---|---|---|---|
| 20 | 460 | 85.80 | 84.60 | 81.15 | 77.65 |
| 40 | 920 | 80.35 | 83.80 | 81.25 | 77.50 |
| 60 | 1380 | 79.15 | 82.80 | 81.50 | 78.50 |
| 80 | 1840 | 75.30 | 77.15 | 76.40 | 73.80 |
| 100 | 2300 | 0.00 | 61.60 | 50.10 | 40.50 |
关键发现:
- StreamingLLM在token距离小于缓存大小时保持高准确率
- 超出缓存大小后准确率下降(无法访问历史信息)
LongBench结果
Table 8: Llama-2-7B-Chat在LongBench上的表现
| 方法 | 单文档QA | 多文档QA | 摘要 |
|---|---|---|---|
| NarrativeQA | Qasper | HotpotQA | |
| 截断 1750+1750 | 18.7 | 19.2 | 25.4 |
| StreamingLLM 4+3496 | 11.6 | 16.9 | 21.6 |
| StreamingLLM 1750+1750 | 18.2 | 19.7 | 24.9 |
关键发现:
- StreamingLLM不适用于需要长距离依赖的任务(如长文档QA)
- 在与截断相同缓存大小下,StreamingLLM性能相当
解码性能
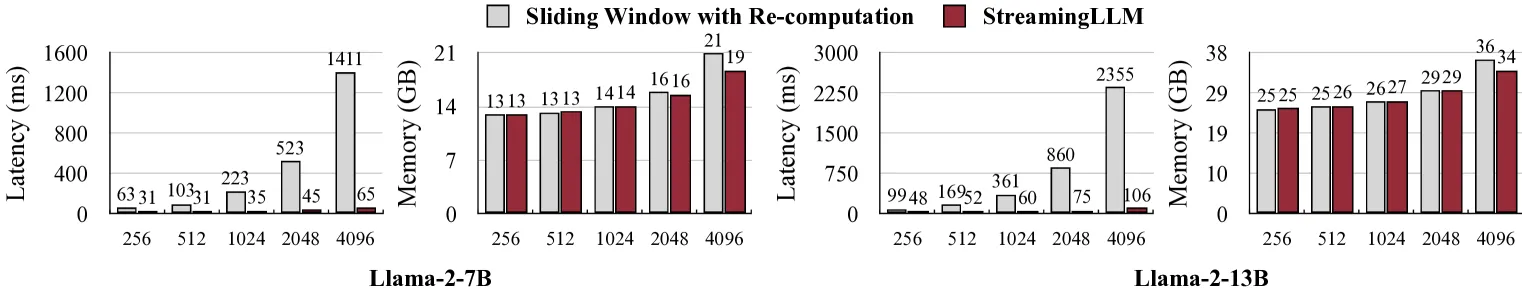
- StreamingLLM的解码速度随缓存大小线性增长
- 滑动窗口+重计算的延迟二次方增长
- StreamingLLM实现高达**22.2×**加速
Sink Token消融
Table 3: Sink Token效果(困惑度)
| 缓存配置 | 0+1024 | 1+1023 | 2+1022 | 4+1020 |
|---|---|---|---|---|
| Vanilla | 27.87 | 18.49 | 18.05 | 18.05 |
| Zero Sink | 29214 | 19.90 | 18.27 | 18.01 |
| Learnable Sink | 1235 | 18.01 | 18.01 | 18.02 |
关键发现:
- Vanilla模型需要4个初始token作为sinks
- Zero Sink(SoftMax₁)部分缓解问题,但仍需多个token
- Learnable Sink Token仅需1个即可稳定流式困惑度
缓存大小影响
Table 6: 缓存大小对困惑度的影响
| 缓存 | Falcon-7B | MPT-7B | Pythia-12B | Llama-2-7B |
|---|---|---|---|---|
| 4+252 | 13.61 | 14.12 | 13.17 | - |
| 4+508 | 12.84 | 14.25 | 12.52 | 9.73 |
| 4+1020 | 12.34 | 14.33 | 12.08 | 9.32 |
| 4+2044 | 12.84 | 14.99 | 12.09 | 9.08 |
| 4+4092 | - | - | - | 9.59 |
关键发现:
- 增加缓存大小并不总能降低困惑度
- 模型可能无法充分利用所有可用上下文
六、相关工作
| 方向 | 代表工作 | StreamingLLM优势 |
|---|---|---|
| 长度外推 | RoPE, ALiBi, NTK-aware | 无需修改模型,即插即用 |
| 上下文扩展 | FlashAttention, Ring Attention | 无需重新训练,无限长度 |
| 高效推理 | Sparse Transformer, LongFormer | 保持完整注意力模式 |
| KV缓存压缩 | H2O, SnapKV | 更简单,无需额外计算 |
| 流式LLM | LMQL, LangChain | 底层高效框架 |
七、总结
核心贡献
- 发现并解释了Attention Sink现象——初始token吸收大量注意力分数
- 提出StreamingLLM框架,仅需4个attention sinks + 滑动窗口即可实现无限长度流式推理
- 证明预训练时添加专用sink token可将所需sinks从4个减少到1个
- 设计StreamEval基准,更贴近真实流式应用场景
- 代码开源,已被NVIDIA TensorRT-LLM、HuggingFace Transformers等广泛采用
技术影响
- 为流式LLM部署提供了简单高效的解决方案
- 揭示了Transformer注意力机制的重要特性
- 影响了后续KV缓存压缩和高效推理的研究方向
局限性
- 不扩展模型的上下文窗口,仅在缓存窗口内工作
- 不适用于需要长距离依赖的任务(长文档QA、摘要)
- 增加缓存大小并不总能提升性能,模型可能无法充分利用上下文
- 不增强模型的长期记忆能力
应用场景
适合:
- 多轮对话
- 实时助手
- 流式代码补全
- 短文档QA
不适合:
- 长文档摘要
- 长距离问答
- 需要全文档理解的任务