Efficient Memory Management for Large Language Model Serving with PagedAttention
通过 PagedAttention 算法实现高效 KV cache 内存管理,构建 vLLM 高吞吐量 LLM 服务系统
Efficient Memory Management for Large Language Model Serving with PagedAttention
论文信息: arXiv:2309.06180 [cs.LG] 12 Sep 2023
作者: Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph E. Gonzalez, Hao Zhang, Ion Stoica
机构: UC Berkeley, Stanford University, UC San Diego
会议: SOSP 2023
代码: https://github.com/vllm-project/vllm
许可: CC BY 4.0
一、论文概述
1.1 研究背景
高吞吐量的 LLM 服务需要同时处理大量请求。然而,现有系统面临 KV cache 内存管理的挑战:
| 挑战 | 说明 |
|---|---|
| KV cache 巨大 | 13B 模型单个 token 需要 800KB,单请求最大 1.6GB |
| 内存碎片 | 现有系统仅 20.4%-38.2% 的 KV cache 内存有效使用 |
| 无法共享 | 现有系统无法利用 KV cache 共享机会 |
| 动态增长 | KV cache 随时间动态增长和收缩,生命周期不可预测 |
现有系统的内存浪费:
| 浪费类型 | 说明 |
|---|---|
| 预留浪费 | 为最大序列长度预留空间,实际使用可能远小于此 |
| 内部碎片 | 预分配的连续内存块中未使用的部分 |
| 外部碎片 | 分配器产生的碎片,无法被其他请求利用 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| PagedAttention | 受 OS 虚拟内存启发的注意力算法,支持非连续 KV cache 存储 |
| vLLM 系统 | 基于 PagedAttention 的高吞吐量分布式 LLM 服务引擎 |
| 近零内存浪费 | 通过分页管理消除内存碎片和预留浪费 |
| KV cache 共享 | 支持跨请求的内存共享,进一步减少内存使用 |
二、核心思想
2.1 问题定义
如何高效管理 LLM 服务中的 KV cache 内存,以提高服务吞吐量?
现有方案的不足:
- 连续内存存储导致严重的内存碎片
- 预分配策略浪费大量内存空间
- 无法利用不同解码算法中的内存共享机会
2.2 解决方案概述
PagedAttention:受 OS 虚拟内存和分页技术启发的注意力算法
核心思想:
- 将 KV cache 分割为固定大小的块(类似 OS 的页)
- 块可以存储在非连续的物理内存中
- 通过块表映射逻辑块到物理块
- 支持按需分配和动态增长
三、技术架构
3.1 现有系统问题
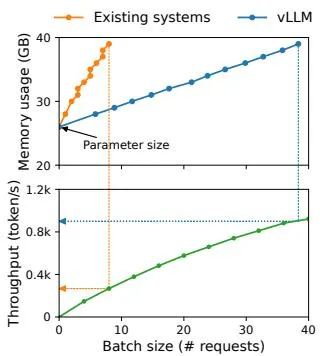 图 1:左图展示 13B 模型在 A100 上的内存分布,右图展示 vLLM 相比现有系统的吞吐量提升。
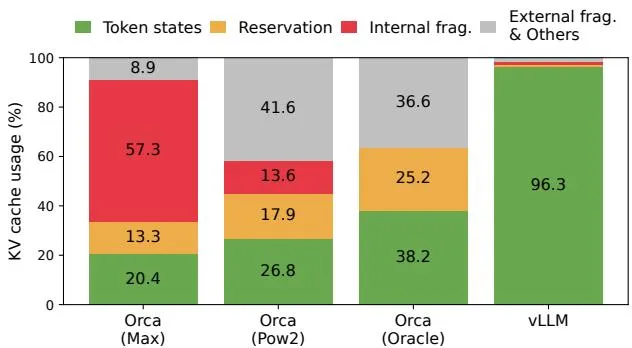 图 2:现有 LLM 服务系统中 KV cache 内存浪费比例。
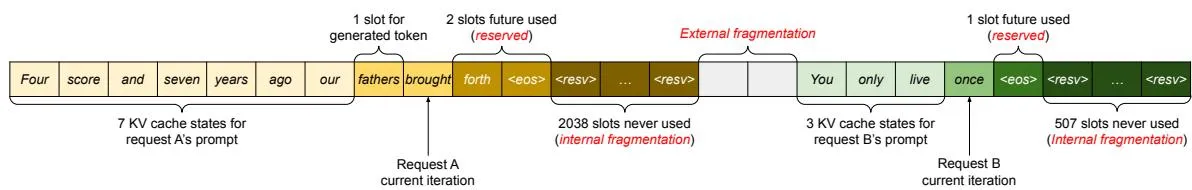 图 3:现有系统内存管理的三种浪费:预留、内部碎片、外部碎片。
关键发现:
- 现有系统仅 20.4%-38.2% 的 KV cache 内存有效使用
- 13B 模型单个请求的 KV cache 可达 1.6GB
- 连续内存存储导致严重的内存碎片
3.2 vLLM 系统架构
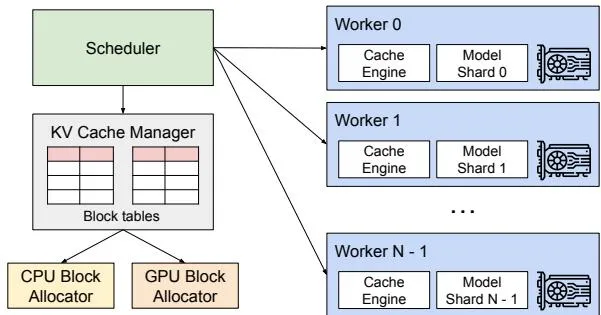 图 4:vLLM 系统架构,包含中央调度器、KV cache 管理器、GPU/CPU 块分配器。
系统组件:
| 组件 | 说明 |
|---|---|
| 中央调度器 | 协调分布式 GPU worker 的执行 |
| KV cache 管理器 | 管理分页的 KV cache 内存 |
| 块引擎 | 在 GPU/CPU 上分配和管理物理块 |
| PagedAttention 内核 | 执行分页注意力计算 |
3.3 PagedAttention 算法
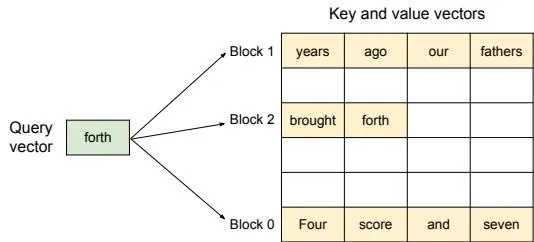 图 5:PagedAttention 算法示意图,KV 块存储在非连续物理内存中。
核心公式:
标准注意力:
PagedAttention(分块计算):
其中:
- :KV 块大小(block size)
- :第 个 key 块
- :第 个 value 块
3.4 Block Table 映射
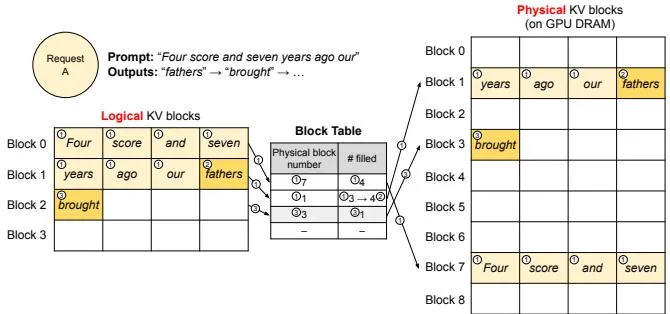 图 6:Block Table 翻译机制,逻辑块到物理块的映射。
映射过程:
- 请求的 KV cache 表示为一系列逻辑 KV 块
- 每个逻辑块映射到一个物理块
- 物理块可以存储在非连续的内存位置
- 块表记录每个请求的逻辑-物理块映射
3.5 内存管理机制
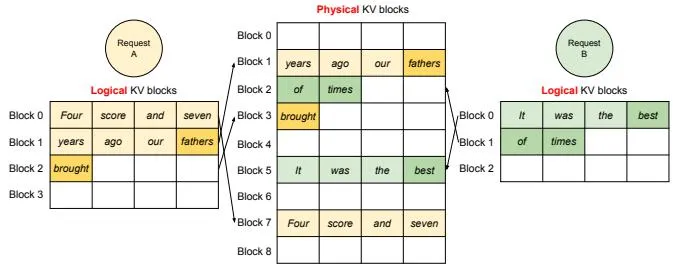 图 7:vLLM 同时管理两个请求的内存。
关键机制:
- 按需分配:仅在需要时分配物理块
- 动态增长:KV cache 可以动态增长,无需预分配
- 块级共享:支持跨请求的块级内存共享
- 引用计数:跟踪每个物理块的引用次数
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| PagedAttention | 分块注意力算法,支持非连续存储 | 内存效率实验 |
| 分页内存管理 | 受 OS 虚拟内存启发的内存管理 | 内存浪费减少实验 |
| Copy-on-Write | 块级写时复制机制 | 并行采样和 Beam Search 实验 |
| 统一内存共享 | 支持多种解码算法的内存共享 | 吞吐量提升实验 |
4.2 解码算法支持
并行采样
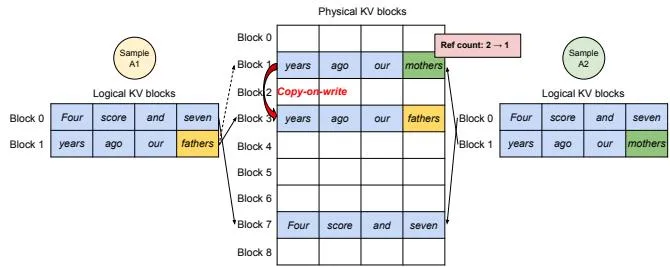 图 8:并行采样中的 copy-on-write 机制。
机制:
- 多个输出序列共享提示的 KV cache
- 当需要修改共享块时,使用 copy-on-write
- 仅复制需要修改的块,减少内存开销
Beam Search
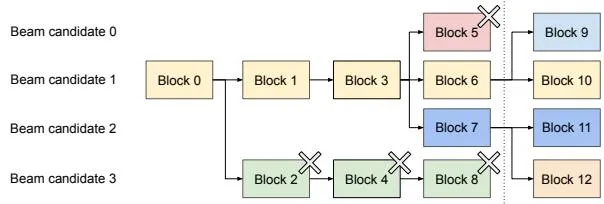 图 9:Beam Search 中的块共享模式。
机制:
- 不仅共享提示块,还共享其他公共块
- 动态调整共享模式
- 释放不再需要的块,分配新块
共享前缀
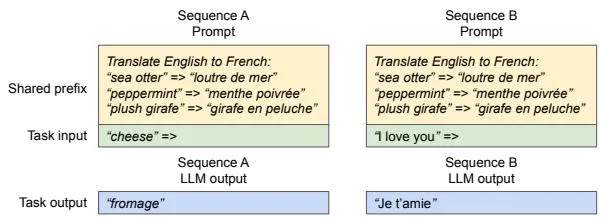 图 10:共享前缀的机器翻译示例。
机制:
- 预定义共享前缀的物理块
- 用户请求映射到共享的物理块
- 仅计算用户任务输入部分
五、实验结果
5.1 实验设置
模型配置:
| 模型 | GPU | 总内存 | 参数大小 | KV cache 内存 | 最大 KV 块数 |
|---|---|---|---|---|---|
| 13B | A100 | 40GB | 26GB | 12GB | 15.7K |
| 66B | 4×A100 | 160GB | 132GB | 21GB | 9.7K |
| 175B | 8×A100 | 640GB | 346GB | 264GB | 60.1K |
工作负载:
- ShareGPT:用户与 ChatGPT 的对话,输入平均 8.4× 更长
- Alpaca:GPT-3.5 生成的指令数据集
基准系统:
- FasterTransformer:优化延迟的推理引擎
- Orca (Oracle):假设已知输出长度的上界
- Orca (Pow2):输出预留最多 2× 空间
- Orca (Max):预留最大序列长度空间
5.2 基本采样性能
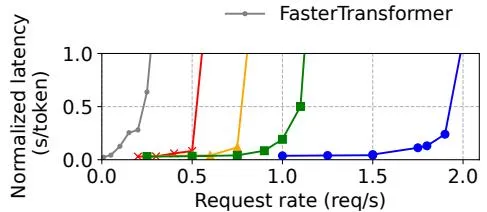 图 12a:OPT-13B 在 ShareGPT 上的性能。
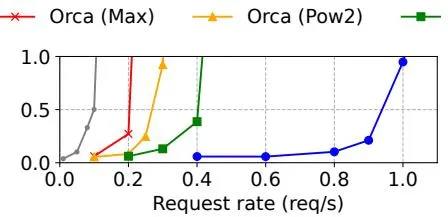 图 12b:OPT-66B 在 ShareGPT 上的性能。
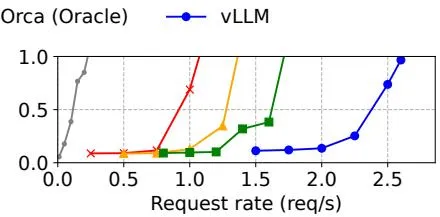 图 12c:OPT-175B 在 ShareGPT 上的性能。
关键发现:
- vLLM 在 ShareGPT 上可维持 1.7×-2.7× 更高的请求率(相比 Orca Oracle)
- 相比 Orca (Max) 提升 2.7×-8×
- 相比 FasterTransformer 提升高达 22×
5.3 批处理请求数对比
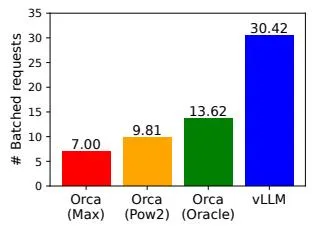 图 13a:ShareGPT 上的平均批处理请求数。
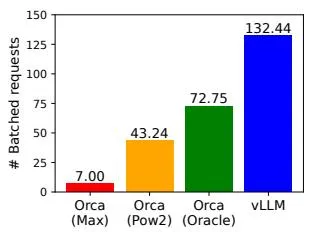 图 13b:Alpaca 上的平均批处理请求数。
关键发现:
- OPT-13B 在 ShareGPT 上,vLLM 同时处理 2.2× 更多请求(相比 Orca Oracle)
- 相比 Orca (Max) 处理 4.3× 更多请求
5.4 并行采样和 Beam Search
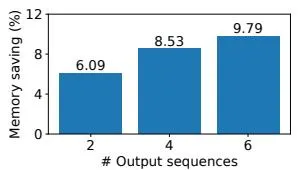 图 14a:并行采样的内存节省。
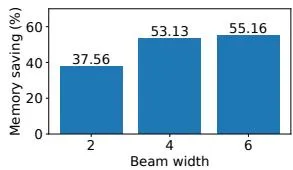 图 14b:Beam Search 的内存节省。
内存节省:
- 并行采样:6.1%-30.5% 内存节省
- Beam Search:37.6%-66.3% 内存节省
性能提升:
- 基本采样:vLLM 比 Orca (Oracle) 提升 1.3×
- Beam Search (width=6):提升 2.3×
5.5 共享前缀性能
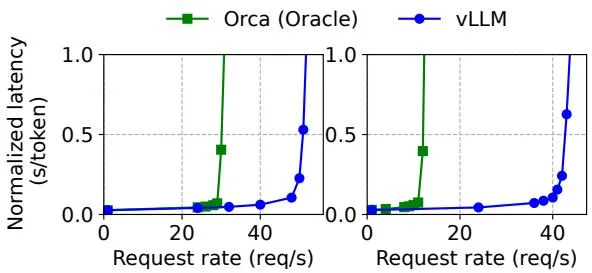 图 16:共享前缀的翻译工作负载性能。
关键发现:
- 1-shot 前缀共享:vLLM 比 Orca (Oracle) 提升 1.67×
- 5-shot 前缀共享:提升 3.58×
- 共享更多示例时,提升更显著
5.6 聊天机器人性能
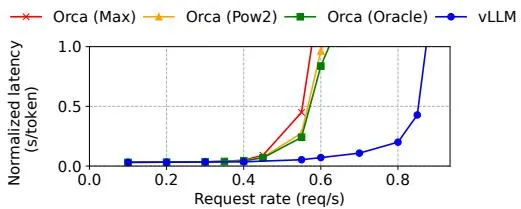 图 17:聊天机器人工作负载性能。
关键发现:
- vLLM 可维持 2× 更高的请求率
- 在长对话场景下优势更明显
- PagedAttention 有效处理长提示
5.7 消融实验
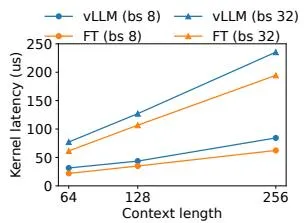 图 18a:注意力内核延迟对比。
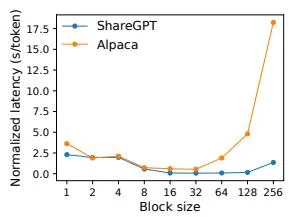 图 18b:不同块大小的端到端延迟。
关键发现:
- PagedAttention 内核开销可忽略不计
- 块大小影响性能:较大块减少内核开销但增加碎片
- 块大小 16 是较好的平衡点
六、代码实现分析
6.1 项目结构
- 前端: FastAPI,扩展 OpenAI API 接口
- 引擎: 8.5K 行 Python + 2K 行 C++/CUDA
- 组件: 调度器、块管理器(Python),PagedAttention 内核(CUDA)
- 模型: 支持 GPT、OPT、LLaMA 等
6.2 内核优化
| 优化 | 说明 |
|---|---|
| 融合 reshape 和块写入 | 最小化内核启动开销 |
| 融合块读取和注意力 | 支持非连续块读取 |
| 融合块复制 | 批量处理 copy-on-write 操作 |
6.3 解码算法实现
| 方法 | 说明 |
|---|---|
| fork | 从现有序列创建新序列 |
| append | 向序列追加新 token |
| free | 删除序列 |
七、相关工作
7.1 LLM 服务系统
| 系统 | 特点 | 局限性 |
|---|---|---|
| FasterTransformer | 优化延迟 | 无调度器,内存管理低效 |
| Orca | 迭代级调度 | 连续内存存储,无法共享 |
| Triton | 动态批处理 | 类似 Orca 的内存管理 |
| vLLM | 分页内存管理 | 近零内存浪费,支持共享 |
7.2 内存管理技术
| 技术 | 来源 | 应用 |
|---|---|---|
| 虚拟内存 | OS | KV cache 分页管理 |
| Copy-on-Write | OS | 并行采样和 Beam Search |
| 块分配 | OS | 按需内存分配 |
八、总结
8.1 核心贡献
- PagedAttention:受 OS 虚拟内存启发的注意力算法,支持非连续 KV cache 存储
- vLLM 系统:基于 PagedAttention 的高吞吐量分布式 LLM 服务引擎
- 内存效率:实现接近零的 KV cache 内存浪费
- 内存共享:支持跨请求的 KV cache 共享,进一步减少内存使用
8.2 技术影响
- 服务成本:通过提高吞吐量降低 LLM 服务成本
- 系统设计:为 LLM 服务系统提供新的内存管理范式
- 开源生态:vLLM 成为最流行的 LLM 服务框架之一
- 后续研究:启发了大量关于 KV cache 优化的研究
8.3 局限性
- 块大小权衡:较大块减少内核开销但增加内存碎片
- 交换开销:CPU-GPU 内存交换可能成为瓶颈
- 调度策略:FCFS 调度可能不是最优的
- 模型限制:主要评估了 OPT 和 LLaMA 模型
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2309.06180
- PDF: https://arxiv.org/pdf/2309.06180
- 代码: https://github.com/vllm-project/vllm
9.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 内存布局与吞吐量 | figure-1-memory-layout.jpg |
| 图 2 | 内存浪费统计 | figure-2-memory-waste.jpg |
| 图 3 | 现有内存管理 | figure-3-existing-memory-management.jpg |
| 图 4 | vLLM 架构 | figure-4-vllm-overview.jpg |
| 图 5 | PagedAttention | figure-5-pagedattention.jpg |
| 图 6 | Block Table | figure-6-block-table.jpg |
| 图 7 | 双请求管理 | figure-7-two-requests.jpg |
| 图 8 | 并行采样 | figure-8-parallel-sampling.jpg |
| 图 9 | Beam Search | figure-9-beam-search.jpg |
| 图 10 | 共享前缀 | figure-10-shared-prefix.jpg |


9.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Orca | Yu et al. | 2022 | 基准系统 |
| FasterTransformer | NVIDIA | 2022 | 基准系统 |
| Megatron-LM | Shoeybi et al. | 2020 | 模型并行 |
| Virtual Memory | OS | - | 核心思想来源 |
9.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| PagedAttention | PagedAttention | 分页注意力算法 |
| KV Cache | Key-Value Cache | 注意力机制的键值缓存 |
| 块表 | Block Table | 逻辑块到物理块的映射 |
| Copy-on-Write | Copy-on-Write | 写时复制机制 |
| 迭代级调度 | Iteration-level Scheduling | 每个迭代更新批次 |
| 模型并行 | Model Parallelism | 跨 GPU 分布模型参数 |
分析完成时间:2026年6月24日 分析工具:Claude Code + paper-analyzer skill