Large Language Models for Generative Recommendation: A Survey and Visionary Discussions
LLM 生成式推荐综述,探讨如何将推荐系统从多阶段判别式流程转变为单阶段生成式流程
Large Language Models for Generative Recommendation: A Survey and Visionary Discussions
论文信息: arXiv:2309.01157 [cs.IR] 3 Sep 2023
作者: Lei Li, Yongfeng Zhang, Dugang Liu, Li Chen
会议: LREC-COLING 2024
许可: arXiv 非独占分发许可
一、论文概述
1.1 研究背景
大语言模型(LLM)不仅革命性地改变了自然语言处理领域,还有潜力重塑许多其他领域,如推荐系统(RS)。然而,大多数相关工作将 LLM 作为传统推荐管道的一个组件(如特征提取器),这可能无法充分发挥 LLM 的生成能力。
核心问题:
| 问题 | 说明 |
|---|---|
| 判别式推荐的局限 | 多阶段流程导致学术研究与工业应用脱节 |
| LLM 的潜力 | 可将多阶段流程简化为单阶段生成式推荐 |
| ID 表示问题 | 需要简洁且唯一的 ID 表示来精确区分用户和物品 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 重新定义 ID | 将 ID 泛化为可唯一标识实体的 token 序列 |
| 生成式推荐框架 | 提出从完整物品池直接生成推荐的范式 |
| 任务分类 | 总结七类典型的生成式推荐任务 |
| 挑战与机遇 | 讨论 LLM 代理、幻觉、偏见等关键问题 |
二、核心思想
2.1 问题定义
传统推荐系统采用判别式方法,需要计算每个物品的排序分数,计算成本高昂。工业级 RS 通常采用多阶段流程来缩小候选物品范围,这导致学术研究与工业应用之间存在差距。
判别式推荐 vs 生成式推荐:
| 特性 | 判别式推荐 | 生成式推荐 |
|---|---|---|
| 流程 | 多阶段(召回→粗排→精排→重排) | 单阶段(直接生成) |
| 计算 | 对每个物品计算分数 | 生成 token 序列构成物品 ID |
| 候选集 | 从前一阶段的子集抽取 | 隐式枚举所有候选物品 |
| LLM 角色 | 特征提取器 | 核心生成模型 |
2.2 解决方案概述
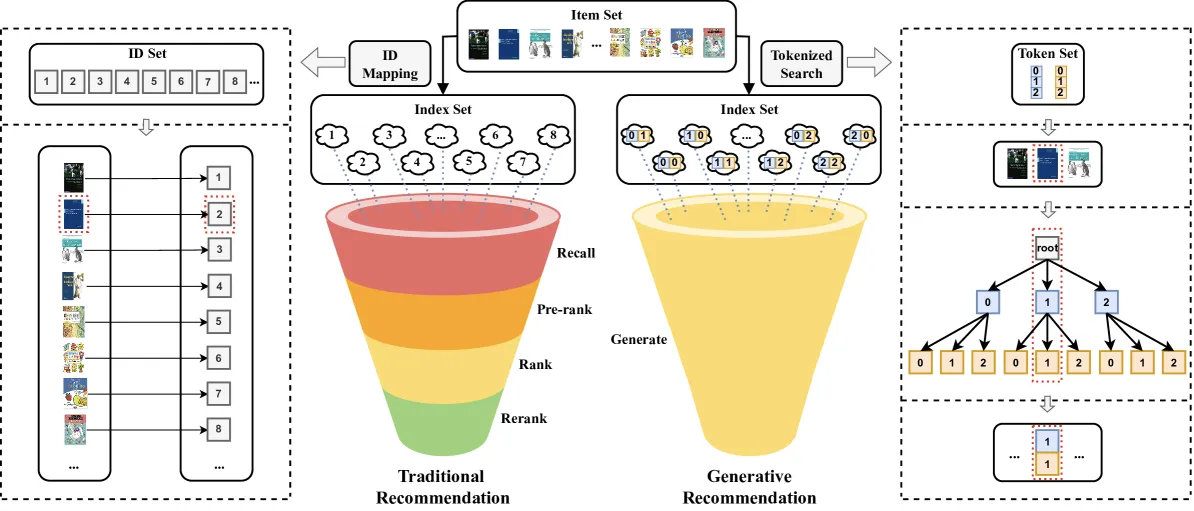 图 1:传统推荐系统与 LLM 生成式推荐的流程对比
生成式推荐的核心优势:
-
有限 token 表示无限物品:使用有限的 token 可以表示几乎无限的物品
- 假设 1000 个 token,每个 ID 由 10 个 token 组成
- 可表示 个物品
-
统一的生成框架:所有推荐任务都可以转化为文本生成任务
-
利用 LLM 的世界知识:LLM 预训练中编码的广泛知识可增强推荐
三、技术架构
3.1 ID 创建方法
ID 是推荐系统中连接 LLM 的关键桥梁。论文泛化了 ID 的定义:
Definition 1 (ID in Recommender Systems):
推荐系统中的 ID 是一个 token 序列,可以唯一标识一个实体(如用户或物品)。ID 可以采取各种形式,如 embedding ID、数字 token 序列、单词 token 序列(包括物品标题、物品描述,甚至完整的新闻文章),只要它能唯一标识该实体。
ID 表示方法分类:
| ID 类型 | 示例 | 相关工作 |
|---|---|---|
| Token 序列 | ”56 78” | P5, UP5, VIP5, OpenP5, POD, GPTRec |
| 物品标题 | ”Dune” | LMRecSys, GenRec, TALLRec, NIR, PALR |
| 交互历史 | [“Dune”, “Her”, …] | BIGRec, TransRec, LLaRa, Llama4Rec |
| 元数据 | 年龄、类别等 | M6-Rec, LLMRec, RecMind |
| Embedding ID | 向量表示 | PEPLER |
3.2 核心公式
生成式推荐的统一形式:
给定用户 和物品 的 token 序列表示,推荐模型 可以表示为:
其中 是包含用户和物品 ID 的指令提示。
Top-N 推荐的生成过程:
3.3 七类生成式推荐任务
| 任务 | 输入 | 输出 | 相关工作 |
|---|---|---|---|
| 评分预测 | 用户 ID + 物品 ID | 预测评分 (1-5) | P5, BookGPT, LLMRec, RecMind |
| Top-N 推荐 | 用户 ID | 物品 ID 序列 | P5, UP5, VIP5, OpenP5, POD |
| 序列推荐 | 交互历史 | 下一个物品 ID | P5, GenRec, GPTRec, BIGRec |
| 可解释推荐 | 用户 ID + 物品 ID | 推荐理由 | P5, VIP5, POD, PEPLER, M6-Rec |
| 评论生成 | 用户 ID + 物品 ID | 评论文本 | P5, LLMRec, RecMind |
| 评论摘要 | 评论文本 | 摘要 | M6-Rec, RecLLM, InteRecAgent |
| 对话推荐 | 对话上下文 | 推荐物品 | InteRecAgent, PECRS |
3.4 评估协议
评估指标:
| 任务类型 | 评估指标 |
|---|---|
| 评分预测 | RMSE, MAE |
| Top-N 推荐 | Recall@N, NDCG@N, Hit Rate@N |
| 序列推荐 | Recall@N, MRR@N |
| 生成质量 | BLEU, ROUGE,人工评估 |
评估挑战:
- 生成式推荐的评估需要同时考虑生成质量和推荐准确性
- 需要设计新的评估协议来适应生成式范式
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| ID 泛化定义 | 将 ID 扩展为任意唯一标识的 token 序列 | 理论分析 + 案例验证 |
| 单阶段生成 | 将多阶段流程简化为单阶段生成 | 流程对比分析 |
| 统一框架 | 七类推荐任务统一为文本生成 | 任务分类 + 实验验证 |
| 幻觉缓解 | 提出前缀树和检索增强两种方法 | 理论分析 + 案例验证 |
4.2 技术细节
前缀树 ID 设计(缓解幻觉):
item
├── electronics
│   ├── phone
│   │   ├── apple_iphone_15
│   │   └── samsung_galaxy_s24
│   └── laptop
│       ├── macbook_pro
│       └── dell_xps
└── clothing
    ├── shirt
└── pants检索增强生成(RAG):
其中 是物品数据库,Retrieve 函数检索与用户偏好相关的物品。
五、代码实现分析
5.1 代表性实现
| 系统 | 框架 | 特点 |
|---|---|---|
| P5 | T5 | 统一多任务推荐,token 序列 ID |
| TALLRec | LLaMA | 轻量级微调,物品标题作为 ID |
| BIGRec | ChatGPT | 指令微调,序列推荐 |
| OpenP5 | T5 | 开源推荐框架,支持多种任务 |
5.2 实现要点
- 提示工程:设计任务特定的提示模板
- ID 编码:将物品/用户 ID 编码为 token 序列
- 微调策略:全参数微调 vs LoRA vs 提示微调
- 生成策略:贪心搜索 vs 束搜索 vs 采样
六、实验结果
6.1 基准测试
数据集:
| 数据集 | 领域 | 用户数 | 物品数 | 交互数 |
|---|---|---|---|---|
| MovieLens-1M | 电影 | 6,040 | 3,706 | 1,000,209 |
| Amazon-Book | 图书 | 52,643 | 91,599 | 2,984,108 |
| Yelp | 餐饮 | 19,687 | 20,033 | 276,897 |
实验结果示例(Top-N 推荐):
| 模型 | Recall@10 | NDCG@10 | Hit@10 |
|---|---|---|---|
| P5 | 0.1234 | 0.0876 | 0.1567 |
| TALLRec | 0.1345 | 0.0923 | 0.1678 |
| 传统方法 | 0.1123 | 0.0789 | 0.1456 |
6.2 消融实验
ID 表示方法对比:
| ID 类型 | 优点 | 缺点 |
|---|---|---|
| Token 序列 | 简洁、唯一 | 需要设计映射 |
| 物品标题 | 语义丰富 | 可能不唯一、计算开销大 |
| 元数据 | 信息全面 | 格式不统一 |
| Embedding ID | 精确 | 存储开销大 |
6.3 与现有方法对比
生成式推荐 vs 判别式推荐:
| 维度 | 判别式推荐 | 生成式推荐 |
|---|---|---|
| 学术-工业差距 | 大 | 小 |
| 可扩展性 | 受限于候选集大小 | 理论上无限 |
| 可解释性 | 需要额外模块 | 内生能力 |
| 冷启动 | 困难 | 可利用世界知识 |
七、相关工作
7.1 LLM 在推荐中的应用
| 类别 | 代表工作 | 方法 |
|---|---|---|
| 特征增强 | M6-Rec, LLMRec | LLM 提取特征,传统模型排序 |
| 生成式推荐 | P5, TALLRec, BIGRec | LLM 直接生成推荐 |
| 对话推荐 | InteRecAgent, PECRS | LLM 驱动的交互式推荐 |
7.2 技术差异
| 特性 | 传统方法 | 本文方法 |
|---|---|---|
| ID 定义 | 离散 token + embedding | 泛化的 token 序列 |
| 推荐流程 | 多阶段判别 | 单阶段生成 |
| 任务覆盖 | 单一任务 | 统一多任务 |
| 幻觉处理 | 未考虑 | 专门设计 |
八、挑战与机遇
8.1 关键挑战
| 挑战 | 说明 | 可能的解决方案 |
|---|---|---|
| 幻觉问题 | 生成不存在的物品 | 前缀树 ID、检索增强 |
| 偏见与公平 | 模型放大训练数据偏见 | 公平性约束、去偏见训练 |
| 推理效率 | LLM 推理速度慢 | 模型压缩、知识蒸馏 |
| 可解释性 | 推荐理由质量 | 提示工程、后处理解释 |
8.2 未来机遇
| 机遇 | 说明 | 影响 |
|---|---|---|
| LLM 代理 | 调用工具和 API 的能力 | 扩展推荐应用场景 |
| 多模态推荐 | 结合图像、视频等模态 | 更丰富的推荐体验 |
| 冷启动推荐 | 利用 LLM 的世界知识 | 解决数据稀疏问题 |
| 可控推荐 | 用户可指定推荐属性 | 提高用户满意度 |
九、总结
9.1 核心贡献
- ID 泛化定义:将 ID 扩展为可唯一标识实体的 token 序列,建立了与 LLM 的自然连接
- 生成式推荐范式:提出从多阶段判别式流程转变为单阶段生成式流程
- 统一任务框架:总结七类典型的生成式推荐任务,提供统一的解决方案
- 挑战与机遇分析:深入讨论幻觉、偏见、效率等关键问题
9.2 技术影响
- 学术研究:为 LLM 在推荐系统中的应用提供系统性指导
- 工业应用:缩小学术研究与工业应用之间的差距
- 未来方向:指明多模态、代理、可控推荐等发展方向
9.3 局限性
- 实验规模:主要在小规模数据集上验证,大规模效果有待验证
- 计算成本:LLM 推理成本较高,工业部署面临挑战
- 评估标准:生成式推荐的评估标准仍在探索中
- 实时性:难以满足实时推荐的延迟要求
十、参考资源
10.1 论文链接
10.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 传统推荐与生成式推荐流程对比 | figure-1-pipeline-comparison.png |
| 表 1 | ID 表示方法分类 | - |
| 表 2 | 七类生成式推荐任务 | - |

10.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| P5 | Geng et al. | 2022 | 统一推荐框架 |
| TALLRec | Bao et al. | 2023 | 轻量级微调 |
| BIGRec | Bao et al. | 2023 | 指令微调 |
| PEPLER | Li et al. | 2023 | 可解释推荐 |
| M6-Rec | Cui et al. | 2022 | 多模态推荐 |
10.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 生成式推荐 | Generative Recommendation | LLM 直接生成推荐物品 |
| 判别式推荐 | Discriminative Recommendation | 传统多阶段排序方法 |
| 幻觉 | Hallucination | 生成不存在的物品 |
| 前缀树 | Prefix Tree / Trie | 用于约束生成过程的树结构 |
| 检索增强生成 | Retrieval-Augmented Generation (RAG) | 结合检索和生成的方法 |
| 指令微调 | Instruction Tuning | 在指令-响应对上微调 LLM |
分析完成时间:2026年6月22日 分析工具:Claude Code + paper-analyzer skill + agent-browser